Módulo 24. Experimentos computacionales, muestreo y documentación
232.1. Separar las decisiones para poder revisarlas
Un experimento computacional transforma una pregunta en una secuencia de operaciones (definir entradas, ejecutar reglas, producir observaciones y calcular resultados). Si todas esas operaciones quedan mezcladas en un único bloque, es difícil descubrir por qué cambia una conclusión. Una arquitectura clara permite modificar una decisión y reconocer qué consecuencias proceden de ella. Su función científica es mantener trazable el recorrido entre pregunta, modelo, ejecución y evidencia.
La separación no exige un proyecto informático grande. Un programa breve puede distinguir funciones de generación de entradas, actualización del estado y análisis. Lo esencial es que cada función reciba información explícita y devuelva resultados identificables. Si una rutina cambia parámetros globales sin registrarlo, la trayectoria puede depender de operaciones anteriores que el lector desconoce. La aparente simplicidad de un archivo único puede ocultar una dependencia difícil de reproducir.
Continuaremos con la cola de pedidos del capítulo anterior. Ahora las llegadas serán aleatorias; cada día llegan dieciséis pedidos con probabilidad un medio y ninguno con la probabilidad restante, de forma independiente entre días en el modelo ideal. Compararemos capacidades de diez y doce durante treinta jornadas, comenzando con cola vacía. Haremos doscientas réplicas y conservaremos las trayectorias, de modo que los resúmenes puedan revisarse sin repetir toda la generación.
La pregunta será cuánto cambia el promedio de pedidos pendientes al cierre al aumentar la capacidad y con qué frecuencia el máximo durante treinta días supera cuatro. Estas cantidades describen el período transitorio desde una inicialización vacía. No estamos estimando directamente una distribución estacionaria ni eliminaremos jornadas iniciales como si fueran un calentamiento irrelevante. En este diseño, el comienzo vacío pertenece al escenario estudiado.
Morris, White y Crowther proponen organizar estudios de simulación mediante objetivos, mecanismos generadores, cantidades de interés, métodos y medidas de desempeño [1]. Su propuesta está pensada sobre todo para evaluar métodos estadísticos. Aquí usamos esa distinción como guía en un experimento dinámico para identificar qué se genera, qué se compara y qué cantidad se estima antes de discutir cómo programarlo.
El resultado será una arquitectura pequeña pero completa. Podremos seguir una réplica desde su identificador hasta sus llegadas, verificar cada saldo y reconstruir la comparación final. Esa trazabilidad, más que la sofisticación del programa, permite saber si una diferencia procede de nuevas entradas, de otra regla dinámica, de un resumen distinto o de un error en la ejecución.
232.2. Configuración, unidades y escenario
La configuración reúne las decisiones que definen una ejecución. Incluye horizonte, número de réplicas, distribución de llegadas, capacidades, condición inicial y umbral de interés. Conviene guardarla junto con los resultados, porque un nombre de archivo como «experimento final» no permite reconstruir ninguna de esas decisiones. Dos archivos con tablas parecidas pueden corresponder a preguntas distintas si cambió el horizonte o la inicialización.
En nuestro caso, las llegadas y los saldos se expresan en pedidos; la capacidad, en pedidos procesables por jornada. El horizonte de treinta días define una réplica completa. La cantidad principal de cada réplica será la media de sus treinta saldos al cierre. Después promediaremos esas medias entre réplicas. Como todas tienen igual longitud, ese promedio coincide numéricamente con promediar todos los saldos, pero la estructura por réplica seguirá siendo necesaria para estimar incertidumbre.
El umbral se aplica al máximo dentro de cada réplica. Una réplica recibe valor uno si algún cierre supera cuatro pedidos; en caso contrario, recibe cero. El promedio de estos indicadores estima una probabilidad de excedencia durante treinta días; la proporción de jornadas que superan cuatro es otra cantidad. Ambas pueden ser útiles, pero sus denominadores y significados son distintos.
El identificador del escenario debe cambiar cuando cambian decisiones que afectan su interpretación. Si aumentamos el horizonte a sesenta días, la probabilidad de al menos una excedencia suele cambiar aunque la dinámica diaria sea idéntica. Si sustituimos llegadas independientes por llegadas agrupadas temporalmente, cambiamos el mecanismo generador. Registrar solo la demanda media impediría reconocer esa diferencia.
También necesitamos una versión del modelo. La versión puede distinguir la regla actual, que incorpora llegadas antes de procesar, de otra que las incorpora después. No debe limitarse a una etiqueta escrita manualmente si el código cambia sin actualizarla; un registro de versiones o una huella del archivo ayuda a identificar la implementación exacta. La etiqueta humana explica el significado del cambio y la identificación técnica permite localizarlo.
Una configuración no reemplaza una explicación. Un lector puede conocer todos los números y seguir sin entender por qué elegimos treinta días o un umbral de cuatro. El documento del estudio debe justificar esos valores a partir de la pregunta o reconocer su carácter didáctico. La configuración hace ejecutables las decisiones; la justificación permite evaluar si esas decisiones producen evidencia pertinente.
232.3. Generar entradas sin mezclarlas con la dinámica
La generación de entradas produce una secuencia de treinta llegadas para cada réplica. Una vez generada, esa misma secuencia se usa para las dos capacidades. Así comparamos sus respuestas ante un entorno compartido, sin que la diferencia entre capacidades se confunda con haber recibido demandas distintas. Esta elección introduce una dependencia deliberada entre los dos resultados de una réplica, que conservaremos en el análisis.
Cada réplica es una realización distinta del proceso de llegada; en la idealización estadística, las réplicas se consideran independientes. En la implementación usamos generadores seudoaleatorios inicializados con semillas derivadas de identificadores. Este procedimiento permite repetir exactamente las entradas de una réplica, aunque no demuestra matemáticamente la independencia de todas las secuencias producidas. La calidad del generador y la organización de sus flujos forman parte de la implementación.
Para evitar que el orden de ejecución cambie qué entradas recibe cada réplica, derivamos su semilla de una etiqueta estable que incluye el nombre del experimento, la fuente de aleatoriedad y el número de réplica. Usamos una función de resumen determinista y tomamos una parte definida de su salida como entero. El objetivo es una asignación reproducible; las propiedades criptográficas de esa función no se invocan como argumento de validez estadística.
También conviene separar las fuentes de aleatoriedad. Si más adelante añadimos errores de observación, sus sorteos deberían usar un flujo identificado aparte. De otro modo, introducir una llamada aleatoria para observar un pedido podría desplazar todos los sorteos posteriores de llegadas; la comparación entre versiones cambiaría entonces por una razón informática ajena al mecanismo científico añadido.
La alternativa más transparente para un experimento pequeño es conservar las entradas efectivamente usadas. Una semilla permite regenerarlas bajo condiciones compatibles de implementación, mientras la lista guardada permite inspeccionarlas directamente. En sistemas grandes puede ser costoso almacenar cada evento; entonces debemos definir qué información basta para reconstruirlo y comprobar esa reconstrucción antes de descartar datos intermedios.
Un error especialmente difícil de detectar es reiniciar cada réplica con la misma semilla. El programa puede producir doscientas filas, pero todas contienen la misma realización. Guardar identificadores, semillas y resúmenes de entradas permite descubrir duplicaciones y evita tomar la repetición de una misma secuencia como evidencia de baja variabilidad del proceso.
232.4. Actualizar estados y producir observaciones
La función dinámica recibe llegadas, capacidad y cola inicial. Devuelve dos secuencias, la de saldos al cierre y la de pedidos atendidos. No decide cuántas réplicas ejecutar, no elige parámetros y no calcula el resultado editorial. Esta separación permite verificarla con entradas manuales antes de introducir aleatoriedad y reutilizar exactamente la misma regla con otras secuencias de llegada.
En cada jornada calculamos primero el trabajo disponible, sumando la cola inicial del día y las llegadas. Procesamos el mínimo entre ese total y la capacidad. El saldo restante pasa al día siguiente. Al conservar también los pedidos atendidos podemos verificar el balance completo. Si guardáramos únicamente el saldo final, muchas inconsistencias temporales quedarían ocultas.
Aquí la observación coincide con el estado de interés, porque conocemos exactamente el saldo al cierre. En una aplicación real podría haber retraso, redondeo o ausencia de mediciones. Conviene representar esa transformación mediante una función separada, de modo que el mismo estado pueda producir distintos registros según el protocolo. Así distinguimos un cambio en la dinámica de un cambio en cómo la observamos.
El orden de acontecimientos se puede comprobar con una entrada mínima. Si la cola comienza vacía, llegan dieciséis pedidos y la capacidad es doce, el saldo debe ser cuatro bajo nuestra convención. Si el programa devuelve dieciséis, probablemente incorporó llegadas después del procesamiento. Ambos resultados pueden ser coherentes con reglas distintas, pero solo uno corresponde a la especificación del experimento actual.
La función también debe respetar el dominio de sus entradas. Capacidades negativas o probabilidades fuera del intervalo entre cero y uno no son escenarios válidos de este modelo. El ejemplo usa una configuración fija y válida; una herramienta destinada a aceptar configuraciones externas debería comprobar esos límites explícitamente. Un resultado numérico obtenido con entradas inválidas no se vuelve interpretable porque el programa haya terminado sin errores.
Separar dinámica y observación permite estudiar nuevas preguntas sin cambiar silenciosamente las reglas. Podemos calcular una proporción de días congestionados a partir de los saldos ya guardados o introducir una observación parcial sobre las mismas trayectorias. En cambio, modificar la capacidad durante la ejecución cambia la dinámica y exige una nueva definición del escenario. La arquitectura ayuda a distinguir análisis adicionales de experimentos nuevos.
232.5. Réplicas, fallos y registro de ejecución
Cada réplica debe tener un identificador único dentro del escenario. Ese identificador conecta entradas, resultados de ambas capacidades y cualquier mensaje de ejecución. La unidad de comparación es la pareja de resultados generada bajo las mismas llegadas. Si una capacidad falla y otra termina, no debemos emparejar la superviviente con una réplica diferente ni eliminar el fallo sin dejar registro.
Un fallo puede revelar un error del programa, una región numéricamente difícil o una condición fuera del dominio previsto. Sus consecuencias científicas dependen de la causa. Si las ejecuciones que fallan corresponden sistemáticamente a congestión alta, analizar solo las exitosas puede subestimar el problema. El informe debe registrar cuántas réplicas se intentaron, cuántas terminaron y qué regla se aplicó a las restantes.
En este modelo de enteros y horizonte breve no esperamos dificultades numéricas relevantes. Aun así, podemos comprobar que el número de registros sea exactamente el producto de réplicas y capacidades. También verificamos que cada réplica tenga treinta llegadas y treinta saldos por capacidad. Ambas comprobaciones buscan detectar resultados incompletos o combinaciones omitidas antes de calcular promedios.
El orden en que terminan las réplicas no debe definir su identidad. Si una implementación futura distribuye ejecuciones entre varios procesadores, la primera en finalizar puede no ser la primera en el diseño. Guardar identificadores y ordenar explícitamente para la presentación evita que los tiempos de ejecución modifiquen los emparejamientos.
Reanudar una ejecución requiere distinguir resultados completos, parciales y pendientes. Si un proceso se interrumpe después de calcular una capacidad, repetir solo la otra debe recuperar las mismas entradas. Si se regeneran con una semilla diferente, la pareja deja de corresponder a un entorno compartido. Una configuración guardada y una regla determinista de semillas permiten reanudar sin cambiar la comparación.
No todas las ejecuciones exploratorias pertenecen al resultado final. Podemos usar pilotos para detectar errores, dimensionar costos o elegir el número de réplicas, siempre que queden identificados como tales. Si modificamos el diseño después de observar una conclusión favorable y conservamos solo esa versión, la trazabilidad informática puede ser impecable mientras la selección científica permanece oculta. El registro debe incluir también decisiones sobre qué ejecuciones sostienen la conclusión publicada.
232.6. Resumir sin perder la unidad experimental
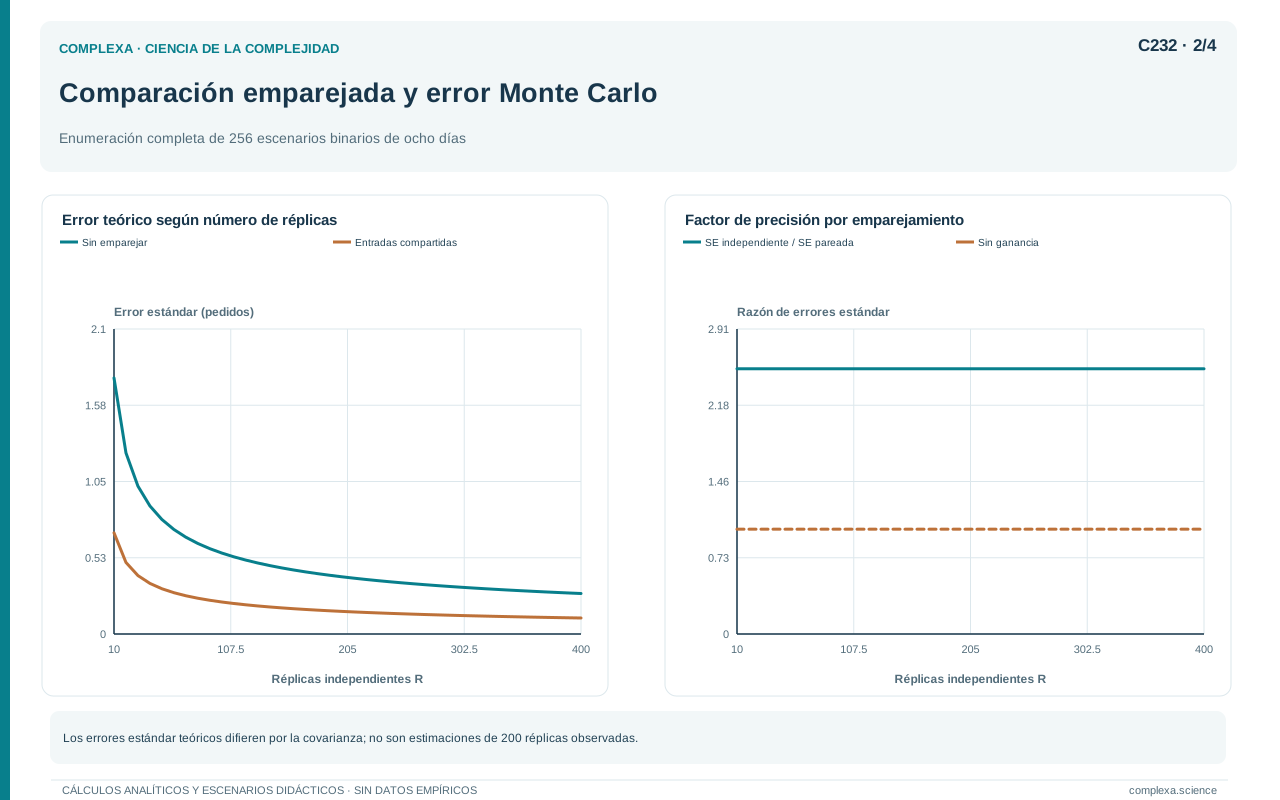
Para cada capacidad calculamos la media de los promedios por réplica. Su error estándar de Monte Carlo se estima mediante la desviación estándar de esos promedios dividida por la raíz del número de réplicas, bajo la aproximación de réplicas independientes. Los treinta saldos dentro de una réplica no son independientes, porque la cola de un día depende de los anteriores. Tratar los seis mil saldos como seis mil réplicas subestimaría o distorsionaría la incertidumbre.
La comparación principal usa diferencias emparejadas. Para cada secuencia de llegadas restamos el promedio con capacidad diez al promedio con capacidad doce. Después calculamos la media y el error estándar de esas doscientas diferencias. Este procedimiento conserva la dependencia creada por compartir entradas. Calcular un error estándar como si los dos grupos fueran independientes descartaría información sobre su covariación.
La ejecución de referencia produce un promedio de aproximadamente nueve coma ochocientos cincuenta y seis pedidos pendientes para capacidad diez y cuatro coma seiscientos trece para capacidad doce. Los errores estándar de Monte Carlo son aproximadamente cero coma cuatrocientos cincuenta y cuatro y cero coma ciento ochenta y ocho. La diferencia emparejada es menos cinco coma doscientos cuarenta y tres, con error estándar cercano a cero coma doscientos ochenta y dos.
| Resultado sobre 200 réplicas | Estimación | Error estándar de Monte Carlo |
|---|---|---|
| Promedio al cierre, capacidad 10 | 9,8560 | 0,4542 |
| Promedio al cierre, capacidad 12 | 4,6133 | 0,1878 |
| Diferencia 12 menos 10 | −5,2427 | 0,2818 |
Estas cifras describen el modelo y el diseño fijados. El error estándar cuantifica la variación de estimación debida al número finito de réplicas; no incorpora incertidumbre sobre la probabilidad de llegada, el tamaño de lote o la adecuación del modelo. Reducirlo mediante más simulaciones no resuelve una especificación incorrecta de esas entradas. La precisión computacional y la credibilidad empírica requieren evaluaciones distintas.
La escala del error orienta la planificación de nuevas ejecuciones. Si la varianza por réplica permanece aproximadamente estable, reducir a la mitad el error estándar exige multiplicar por cuatro el número de réplicas. Pasar de doscientas a ochocientas podría lograr esa reducción aproximada para la media, pero no garantiza representar adecuadamente un evento cuya probabilidad es extraordinariamente pequeña. El costo debe responder a un objetivo de precisión para la cantidad que queremos estimar; una cifra redonda o el tiempo disponible no sustituyen ese objetivo.
En este ejemplo las doscientas réplicas se fijaron antes de calcular los resultados. No se detuvo la simulación al alcanzar una diferencia favorable ni se descartaron trayectorias por tener saldos elevados.
También podemos deducir una propiedad exacta de este modelo, según la cual una capacidad mayor no produce un saldo mayor para la misma secuencia de llegadas y la misma cola inicial. La demostración procede por inducción sobre la actualización mediante el máximo con cero. Si una pareja simulada contradice esa propiedad, hay un error de implementación, emparejamiento o especificación. Esta referencia es más fuerte que esperar que el promedio de muchas réplicas tenga el signo correcto.
232.7. Probabilidades extremas y comprobaciones analíticas
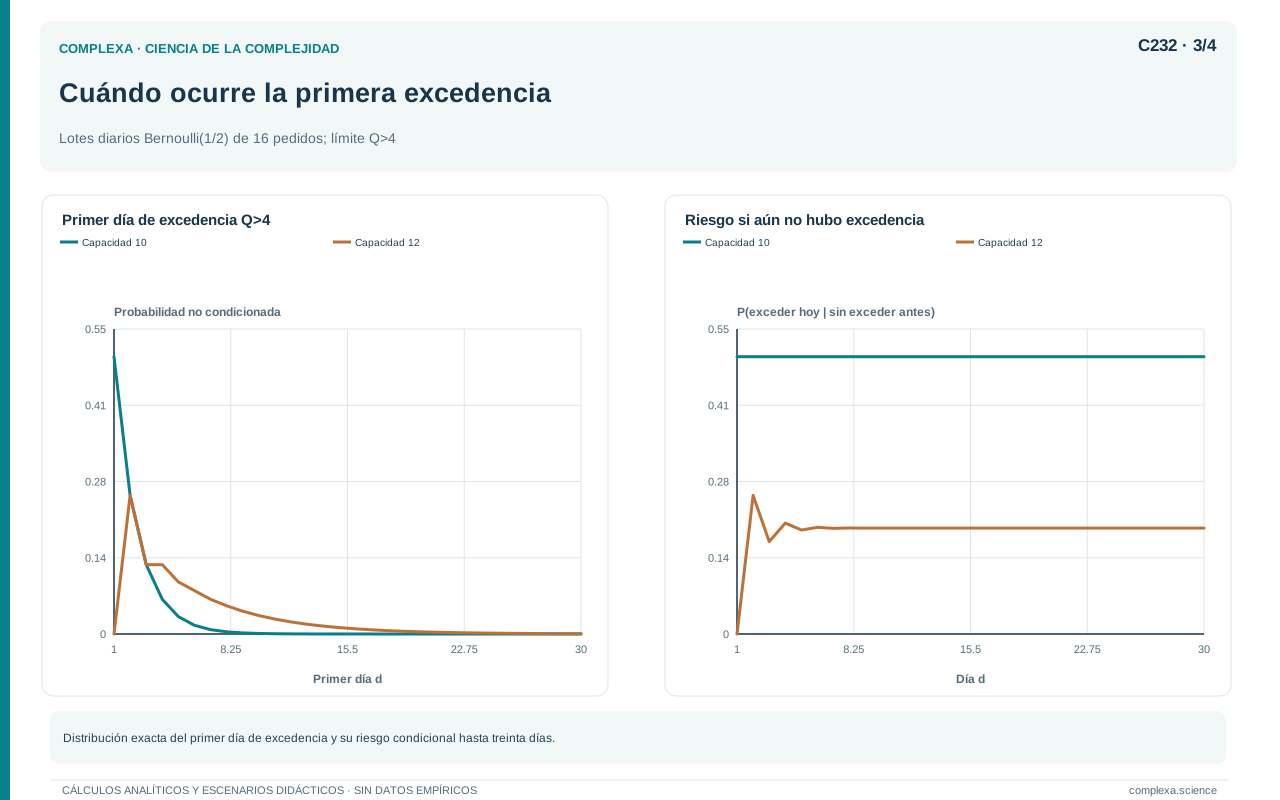
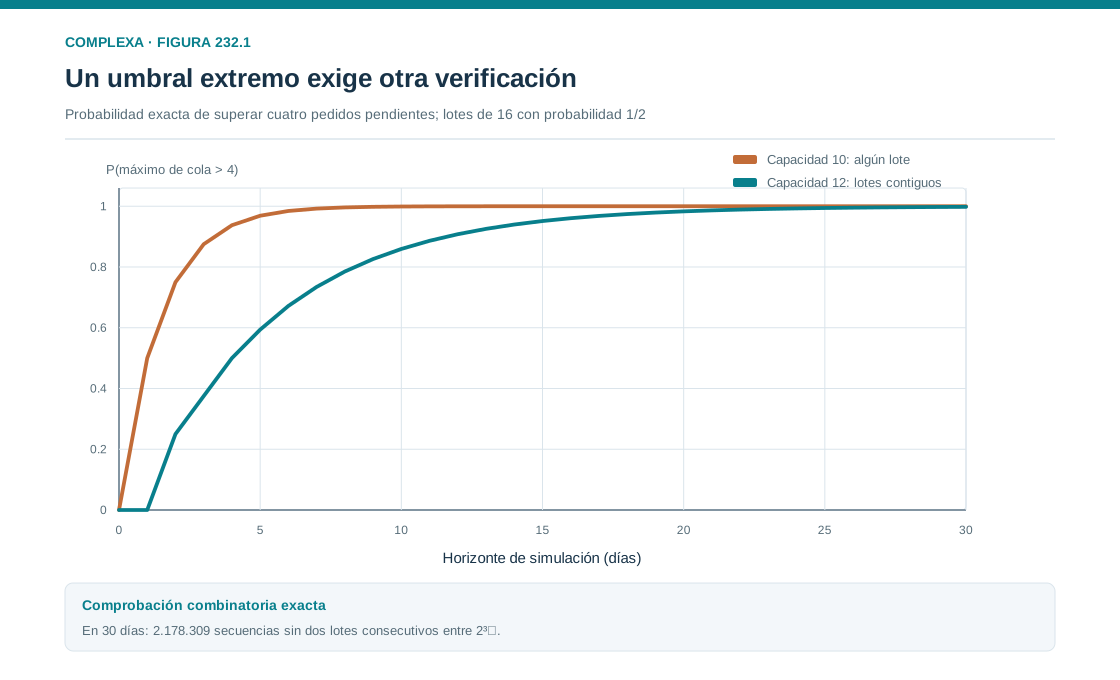
La probabilidad de que el máximo supere cuatro ilustra otra dificultad. En las doscientas réplicas, todas las ejecuciones con capacidad diez excedieron el umbral. Con capacidad doce lo hicieron ciento noventa y nueve. Las estimaciones son uno y cero coma novecientos noventa y cinco. Una fórmula de error estándar que sustituye la probabilidad verdadera por la frecuencia observada devuelve cero cuando la frecuencia es uno, pero ese cero no demuestra certeza.
Podemos calcular la primera probabilidad exactamente. Con capacidad diez, cualquier jornada con dieciséis llegadas deja al menos seis pedidos pendientes si la cola estaba vacía y más si no lo estaba. Por tanto, no superar cuatro durante treinta días exige que no llegue ningún lote. Bajo independencia y probabilidad un medio, ese evento tiene probabilidad dos elevado a menos treinta. La probabilidad de excedencia es uno menos esa cantidad, estrictamente menor que uno.
Con capacidad doce, una llegada aislada deja cuatro pedidos y un día sin llegadas vacía esa cola. Dos jornadas consecutivas con lote producen al menos ocho pendientes. Partiendo de cero, no superar cuatro equivale a que la secuencia binaria de llegadas no contenga dos unos consecutivos. Podemos contar esas secuencias mediante una recurrencia, porque las que terminan en cero admiten cualquier prefijo válido y las que terminan en uno deben estar precedidas por cero, salvo el caso inicial.
Para treinta posiciones hay dos millones ciento setenta y ocho mil trescientas nueve secuencias válidas entre dos elevado a treinta posibilidades equiprobables. La probabilidad exacta de excedencia es aproximadamente cero coma novecientos noventa y siete mil novecientos setenta y uno. La estimación simulada de cero coma novecientos noventa y cinco es compatible con la fluctuación de una muestra pequeña. La comparación muestra que, cuando el modelo lo permite, una simulación puede comprobarse con conteos analíticos.
El conteo puede reproducirse sin generar todas las secuencias. Para la cantidad de secuencias válidas de longitud n, los valores iniciales son uno para longitud cero y dos para longitud uno. Cada valor siguiente es la suma de los dos anteriores. La recurrencia clasifica las secuencias según terminen en cero o en cero uno, con los casos iniciales tratados por separado. Enumerar todas las secuencias hasta una longitud pequeña y comprobar la recurrencia da una referencia independiente para el cálculo de treinta días.
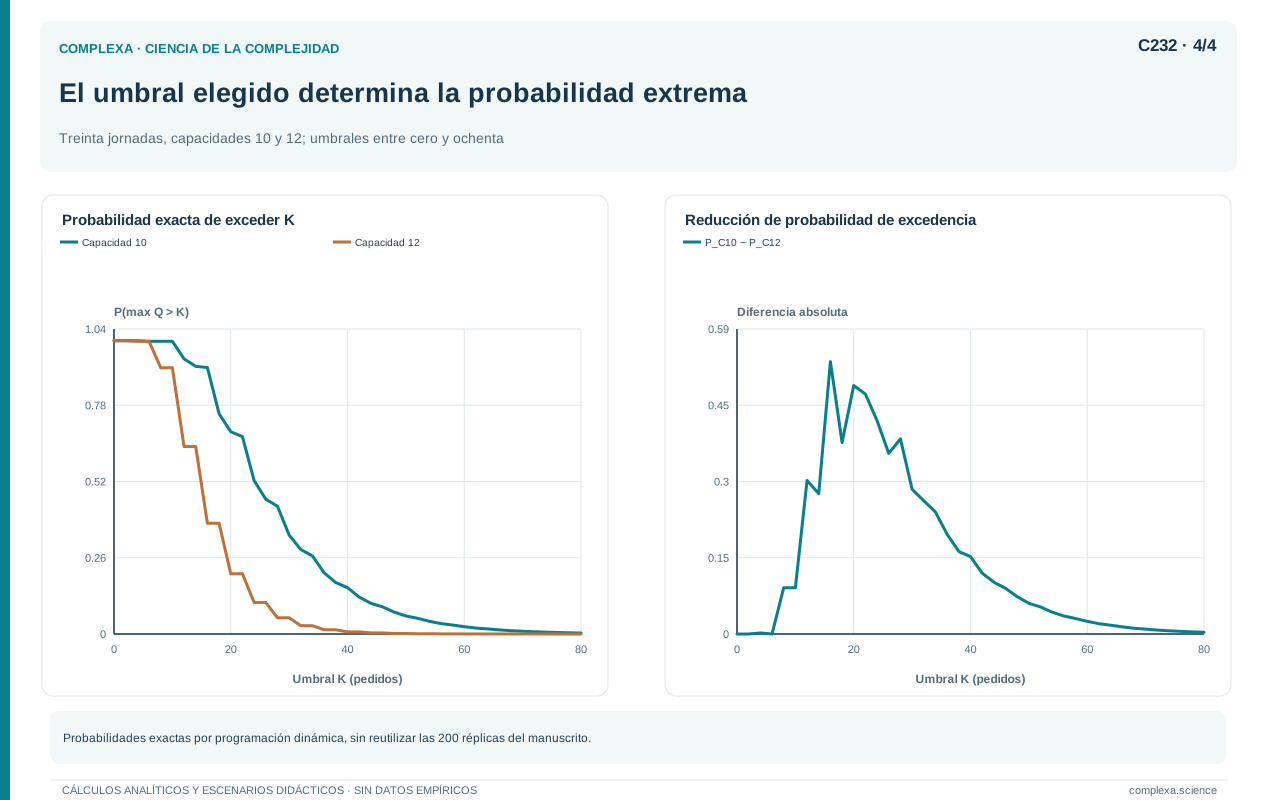
El ejemplo también distingue entre la mejora media y el cumplimiento de un objetivo extremo. Aumentar la capacidad reduce considerablemente el saldo promedio, pero ambas probabilidades de exceder cuatro durante treinta días siguen siendo muy altas. Presentar solo la reducción media ocultaría el fracaso respecto de ese umbral. La arquitectura conserva las trayectorias para calcular ambas medidas y evita que el resultado más favorable sustituya silenciosamente al criterio inicialmente declarado.
Las probabilidades cercanas a cero o uno requieren métodos de estimación y comunicación adecuados. Aquí tenemos una solución exacta; en problemas mayores quizá necesitemos más réplicas, intervalos apropiados o técnicas específicas de eventos raros. El diseño debe anticipar esa dificultad. Un número de réplicas suficiente para una media puede ser completamente insuficiente para estudiar una probabilidad muy pequeña.
232.8. Un programa completo y sus límites
El siguiente programa separa configuración, entradas, dinámica, ejecución y resumen. Guarda un archivo con todos los registros y la configuración, además de imprimir los resultados agregados. Usa solo la biblioteca estándar de Python y se ejecutó con la versión 3.12.14. La función de resumen está pensada para comparar exactamente dos capacidades, como en el diseño presentado; ampliarla a más alternativas requiere definir las comparaciones pertinentes.
La configuración aparece en un único lugar para que los parámetros visibles correspondan a los realmente ejecutados. La semilla depende del identificador de réplica; las llegadas se generan una sola vez antes de recorrer las capacidades. Esta estructura implementa la comparación emparejada. Si el generador se llamara nuevamente dentro del bucle de capacidades con otro estado aleatorio, cambiaría el diseño aunque el resto del código permaneciera igual.
Código reproducible
from hashlib import sha256
from math import sqrt
from random import Random
from statistics import mean, stdev
from pathlib import Path
import json, platform

CONFIG = {"replicas": 200, "dias": 30, "prob_llegada": 0.5,
          "tamano_lote": 16, "capacidades": [10, 12],
          "cola_inicial": 0, "umbral": 4,
          "version_modelo": "cola-diaria-1"}
def semilla(replica):
    etiqueta = f"complexa232|llegadas|{replica}".encode("utf-8")
    return int.from_bytes(sha256(etiqueta).digest()[:8], "big")
def entradas(replica, config):
    rng = Random(semilla(replica))
    return [config["tamano_lote"] if rng.random() < config["prob_llegada"]
            else 0 for _ in range(config["dias"])]
def dinamica(llegadas, capacidad, inicial):
    q = inicial
    saldos, atendidos = [], []
    for a in llegadas:
        d = min(q+a, capacidad)
        q = q+a-d
        saldos.append(q)
        atendidos.append(d)
    return saldos, atendidos
def ejecutar(config):
    registros = []
    for r in range(config["replicas"]):
        a = entradas(r, config)
        for c in config["capacidades"]:
            q, d = dinamica(a, c, config["cola_inicial"])
            registros.append({"replica": r, "capacidad": c,
                "semilla": semilla(r), "llegadas": a,
                "saldos": q, "atendidos": d, "media": mean(q),
                "maximo": max(q), "supera_umbral": max(q)>config["umbral"]})
    return registros
def resumir(registros, config):
    resumen = {}
    for c in config["capacidades"]:
        grupo = [r for r in registros if r["capacidad"] == c]
        medias = [r["media"] for r in grupo]
        p = mean(r["supera_umbral"] for r in grupo)
        resumen[str(c)] = {
            "media_del_promedio": mean(medias),
            "ee_monte_carlo": stdev(medias)/sqrt(len(medias)),
            "prob_max_mayor_umbral": p,
            "ee_probabilidad_plugin": sqrt(p*(1-p)/len(grupo))}
    menor, mayor = sorted(config["capacidades"])
    diferencias = []
    for r in range(config["replicas"]):
        par = {x["capacidad"]:x["media"] for x in registros if x["replica"] == r}
        diferencias.append(par[mayor]-par[menor])
    resumen[f"diferencia_{mayor}_menos_{menor}"] = {
        "media": mean(diferencias),
        "ee_monte_carlo": stdev(diferencias)/sqrt(len(diferencias))}
    return resumen
registros = ejecutar(CONFIG)
resumen = resumir(registros, CONFIG)
salida = {"configuracion": CONFIG, "python": platform.python_version(),
          "resumen": resumen, "replicas": registros}
Path("c232_resultados.json").write_text(
    json.dumps(salida, ensure_ascii=False, indent=2), encoding="utf-8")
print(json.dumps(resumen, ensure_ascii=False, indent=2))
El archivo conserva cada secuencia de llegadas junto con los saldos y los pedidos atendidos. Esa redundancia deliberada facilita la inspección en un ejemplo pequeño. Para un experimento grande podríamos almacenar las entradas una sola vez por réplica y referenciarlas desde cada condición. La optimización del almacenamiento debe preservar explícitamente la correspondencia entre los datos, porque las posiciones implícitas pueden cambiar al ordenar archivos.
El campo del error estándar de la probabilidad identifica explícitamente una estimación por sustitución. Su valor cero para frecuencia uno debe interpretarse con la advertencia y el cálculo exacto de la sección anterior. Guardar ese campo no obliga a usarlo como intervalo de incertidumbre. Una arquitectura responsable conserva el método de cálculo y permite sustituir una aproximación inadecuada sin alterar las realizaciones que dieron origen al resultado.
La reproducción exacta depende también del entorno que ejecuta los sorteos y las operaciones. Guardar la versión de Python y las entradas permite comprobar si una diferencia futura procede del generador o del análisis. Una semilla aislada no asegura necesariamente resultados iguales en cualquier lenguaje, versión o implementación, de modo que buscamos dejar disponibles las condiciones necesarias para repetir y comparar.
El código no intenta ser una biblioteca general de colas; su escala y sus restricciones responden a este experimento. Antes de reutilizarlo con valores externos conviene verificar dominios, longitud positiva y al menos dos réplicas para calcular desviaciones estándar. El programa mostrado ya permite ejecutar y auditar el caso definido sin introducir infraestructura que oculte sus decisiones científicas.
232.9. Procedencia y niveles de reproducibilidad
Repetir un cálculo con los mismos datos y código es una forma de comprobación. Implementar las mismas reglas de manera independiente es otra. Obtener una conclusión compatible con nuevos datos o bajo alternativas plausibles es una evaluación adicional. Conviene describir qué operación se hizo, porque el término reproducibilidad se usa con convenciones distintas entre disciplinas. Una etiqueta única puede ocultar diferencias importantes en la fuerza de la evidencia.
Sandve y colaboradores recomiendan conservar el recorrido computacional, las versiones y la información necesaria para rehacer los análisis [2]. En nuestro ejemplo, eso supone una cadena concreta que va de la configuración y la semilla a las llegadas, la dinámica, los saldos, el resumen y la tabla. Cada eslabón debe poder identificarse. Una tabla copiada manualmente y corregida sin registro rompe esa cadena aunque el código original siga disponible.
La procedencia también incluye transformaciones editoriales. Las cifras de las tablas están redondeadas después del cálculo; los archivos conservan valores con mayor precisión. Si se aplica un filtro a réplicas o se cambia una unidad, esa transformación debe formar parte del análisis reproducible. Editar una cifra directamente para que coincida con una expectativa impide distinguir entre la corrección de un error y una modificación injustificada del resultado.
Un valor ausente tampoco debe convertirse automáticamente en cero. Cero pedidos pendientes es un resultado válido y favorable; un saldo no registrado significa que desconocemos el resultado. Si ambos se almacenan igual, un fallo de captura puede parecer una mejora. La representación de datos debe distinguir ausencia, ejecución fallida y valor numérico observado; el resumen debe declarar cómo trata cada situación.
Wilson y colaboradores recomiendan para la programación científica código legible, control de versiones y comprobaciones orientadas a detectar errores [3]. Aquí seguimos esas recomendaciones mediante funciones breves y referencias analíticas. Repetir cada línea del programa en otro archivo es una prueba menos pertinente que contrastar balances, casos límite y propiedades que provienen del modelo. Esos contrastes pueden revelar errores aunque el código parezca internamente coherente.
Una implementación independiente es útil cuando cambia la forma de calcular. Podemos enumerar todas las secuencias de pocos días para obtener probabilidades exactas y compararlas con la simulación, o derivar recurrencias para eventos particulares. Si dos programas comparten el mismo error de especificación, su concordancia no lo revela. La independencia útil incluye razonamiento sobre el modelo y los observables, además de diferencias en el lenguaje usado.
La documentación debe permitir entender tanto lo que funcionó como lo que cambió. Si una revisión corrige el orden de llegadas y procesamiento, los resultados anteriores deben identificarse como pertenecientes a otra implementación. Conservar un historial permite explicar qué versión sostiene la conclusión actual y por qué una cifra difiere de una ejecución previa, sin obligar a presentar todas las versiones en el texto principal.
232.10. Una arquitectura al servicio de la pregunta
El experimento produjo una comparación verificable entre dos capacidades y reveló que una mejora del promedio no implica controlar un máximo durante un horizonte prolongado. Esa conclusión fue posible porque conservamos las trayectorias y definimos ambos observables. Si hubiéramos guardado únicamente una media agregada, la probabilidad de excedencia habría quedado fuera del análisis o habría exigido repetir la simulación.
Separar entradas y dinámica permitió atribuir las diferencias a la capacidad bajo entornos compartidos. Al distinguir réplicas de jornadas pudimos calcular la incertidumbre sobre la unidad correcta; gracias a la separación entre resultados y presentación, pudimos redondear sin perder los datos originales. Cada decisión de arquitectura resolvió un problema científico concreto, además de facilitar el mantenimiento del programa.
La comparación analítica mostró también los límites de una rutina estándar. Un error estándar calculado por sustitución puede ser cero en una muestra con todos los eventos presentes, mientras la probabilidad verdadera sigue siendo menor que uno. Sin el razonamiento estadístico, el programa no decide qué interpretación corresponde; la arquitectura hace visible el cálculo para que ese razonamiento pueda corregir o complementar su presentación.
En investigaciones mayores aparecerán muestreadores, simuladores costosos, modelos sustitutos y combinaciones de fuentes de incertidumbre. Seguirá siendo útil exigir que cada etapa declare qué recibe, qué produce y qué supuestos introduce. Cuando una conclusión cambia, esa estructura permite localizar la decisión responsable y diseñar una comparación que la examine.
El siguiente capítulo estudia el muestreo mediante cadenas de Markov más allá del algoritmo de Metropolis. Allí la generación de muestras será en sí misma un problema dinámico, con dependencia entre estados y necesidad de diagnosticar la exploración. La arquitectura desarrollada aquí será la base de ese trabajo, con objetivos definidos, ejecuciones identificables y resultados cuyo significado no se pierde entre el código y la tabla final.
Referencias
- Morris, T. P., White, I. R., y Crowther, M. J. (2019). Using simulation studies to evaluate statistical methods. Statistics in Medicine, 38(11), 2074–2102. DOI: 10.1002/sim.8086.
- Sandve, G. K., Nekrutenko, A., Taylor, J., y Hovig, E. (2013). Ten simple rules for reproducible computational research. PLOS Computational Biology, 9(10), e1003285. DOI: 10.1371/journal.pcbi.1003285.
- Wilson, G., Aruliah, D. A., Brown, C. T., Chue Hong, N. P., Davis, M., y colaboradores. (2014). Best practices for scientific computing. PLOS Biology, 12(1), e1001745. DOI: 10.1371/journal.pbio.1001745.
Nota del experimento. El modelo de pedidos, la simulación, las semillas y los cálculos de referencia son desarrollos didácticos propios. Sus resultados describen el escenario especificado.