Módulo 24. Experimentos computacionales, muestreo y documentación
231.1. Una pregunta antes de una simulación
Un modelo computacional comienza por seleccionar qué aspecto del mundo queremos representar y para qué necesitamos esa representación. La selección ocurre incluso cuando no se formula explícitamente. Elegir variables, escalas temporales y reglas de actualización determina qué diferencias podrán aparecer en los resultados. Por eso, el primer trabajo científico consiste en convertir una inquietud amplia en una pregunta cuya respuesta pueda cambiar al comparar hipótesis, datos o decisiones.
«Comprender la congestión» es una aspiración, pero todavía no define un experimento. Podemos preguntar cuánto trabajo pendiente se acumula al final de cada jornada, qué proporción de solicitudes supera cierto tiempo de espera o cómo cambia el rendimiento cuando aumenta la capacidad. Estas preguntas se relacionan, aunque requieren observaciones y modelos diferentes. Un registro diario de trabajo pendiente puede responder la primera y ser insuficiente para reconstruir la distribución de esperas individuales.
Usaremos un ejemplo de procesamiento de pedidos. Los pedidos llegan a un equipo que tiene cierta capacidad diaria. Queremos comparar dos capacidades bajo patrones de llegada definidos. El ejemplo es deliberadamente pequeño para que podamos calcular resultados a mano, localizar supuestos y ver cómo una decisión de modelado cambia una conclusión. No describe una empresa real ni pretende recomendar una capacidad operativa fuera de las condiciones indicadas.
La pregunta inicial es qué capacidad diaria mantiene el trabajo pendiente al cierre por debajo de un umbral durante diez jornadas, bajo dos patrones de demanda. Esta formulación identifica una intervención, una variable de respuesta, un horizonte y condiciones de entrada. Todavía faltan criterios de comparación e incertidumbre, pero ya sabemos qué resultado podría contradecir una propuesta (que la acumulación supere el umbral en uno de los escenarios, porque entonces la capacidad no satisface allí el objetivo declarado).
El modelo también puede tener una finalidad explicativa. Podríamos preguntar si la variabilidad de las llegadas basta para producir congestión cuando la capacidad media supera la demanda media. Esa pregunta busca demostrar un mecanismo posible, sin pronosticar el comportamiento de una organización específica. Un mismo simulador puede servir para ambas tareas, pero la evidencia necesaria cambia. Identificar el mecanismo responsable de un patrón empírico exige más que un ejemplo que muestre su posibilidad.
Box defendió una práctica científica iterativa en la que las discrepancias entre modelos y observaciones orientan nuevas preguntas [1]. Adoptaremos esa idea de manera operacional. Cada supuesto debe tener una consecuencia examinable y cada resultado debe conservar el alcance de la pregunta que lo produjo. La simulación será una herramienta para razonar sobre alternativas, con criterios que permitan reconocer tanto un resultado favorable como una limitación del planteamiento.
231.2. Definir el sistema y sus fronteras
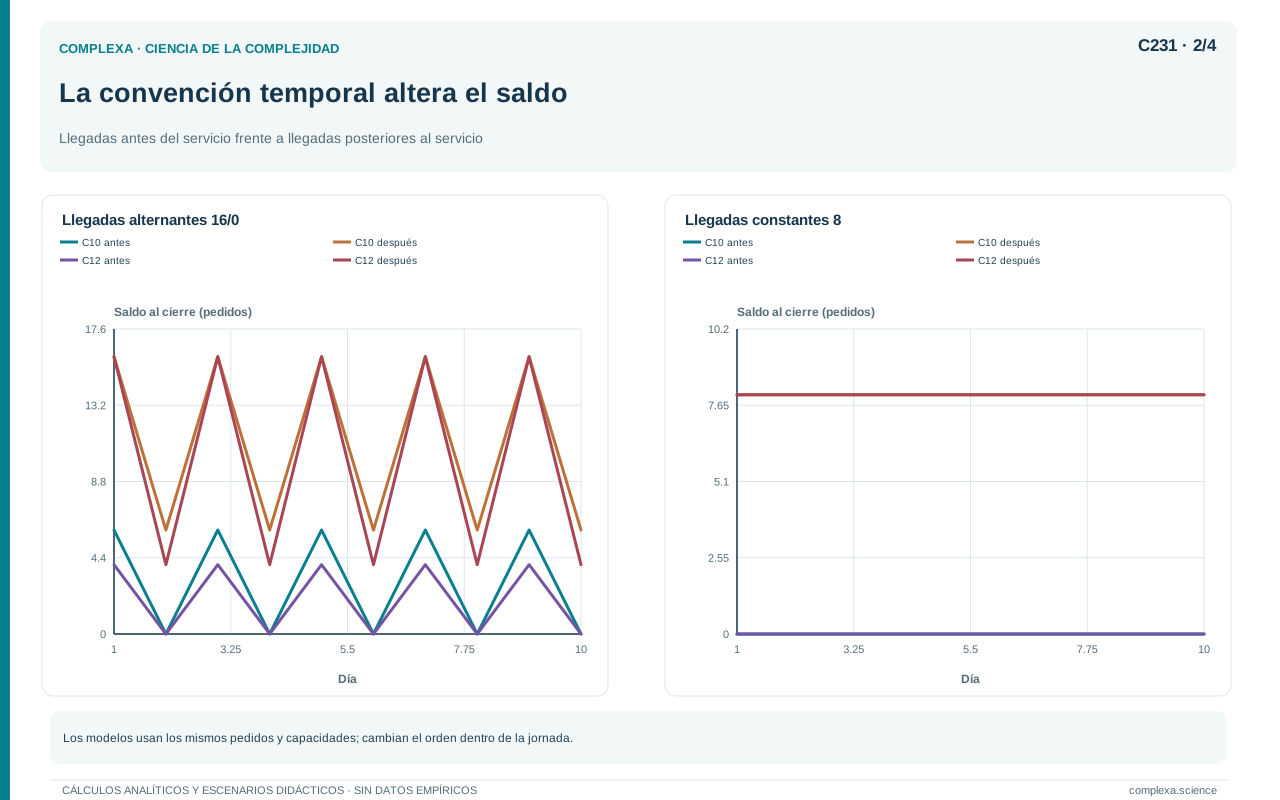
La frontera del modelo separa lo que describimos mediante reglas internas de lo que introducimos como condición externa. En nuestro ejemplo incluimos pedidos pendientes y capacidad de procesamiento. Inicialmente tratamos las llegadas como una secuencia dada desde fuera. Esta decisión permite estudiar cómo responde el equipo a distintos patrones, pero excluye una posible retroalimentación (clientes que dejan de enviar pedidos cuando observan demoras). Si esa respuesta importa para la pregunta, la frontera deberá ampliarse.
Denotemos por Q la cantidad pendiente al comienzo de una jornada, por A las llegadas de esa jornada y por C su capacidad. Todos los pedidos requieren una unidad de trabajo y pueden procesarse el mismo día en que llegan. Suponemos que las llegadas están disponibles antes del procesamiento diario. La cantidad atendida es el mínimo entre el trabajo disponible y la capacidad. El saldo se conserva para la jornada siguiente.
La ecuación contiene una decisión temporal concreta. Si los pedidos llegaran después de usar la capacidad diaria, no podrían procesarse hasta la jornada siguiente. La misma lista de llegadas produciría saldos diferentes. Si ambas convenciones están bien implementadas, los dos programas son correctos y la discrepancia se debe a que son modelos distintos. Antes de comparar resultados debemos comprobar que ambos siguen el mismo orden de acontecimientos.
La unidad de cada variable también debe estar fijada. Q, A y D cuentan pedidos, mientras que C es la cantidad máxima procesable durante una jornada. Si unos pedidos requieren diez veces más trabajo que otros, contarlos como unidades equivalentes puede distorsionar la respuesta. Podríamos sustituir pedidos por unidades de esfuerzo o introducir clases de tamaño. La elección depende de si la heterogeneidad modifica el resultado que nos interesa medir.
La frontera espacial puede importar de forma semejante. Dos equipos con capacidad total de veinte pedidos diarios no equivalen siempre a un único equipo de capacidad veinte. Si cada uno recibe una demanda diferente y los pedidos no pueden transferirse, puede haber capacidad ociosa en uno y acumulación en el otro. Agregar equipos supone implícitamente una regla de intercambio de trabajo, que debe justificarse antes de interpretar una capacidad conjunta.
Finalmente, debemos declarar qué queda fuera, en este caso los tiempos dentro de cada jornada, las prioridades entre pedidos, las interrupciones, el aprendizaje, los errores de procesamiento y el abandono. Excluirlos es defendible si no afectan materialmente a la comparación prevista y deja de serlo cuando la conclusión depende de ellos. Una frontera útil conserva las diferencias necesarias para responder una pregunta y permite identificar qué observaciones obligarían a revisarla.
231.3. Traducir propósitos en cantidades observables
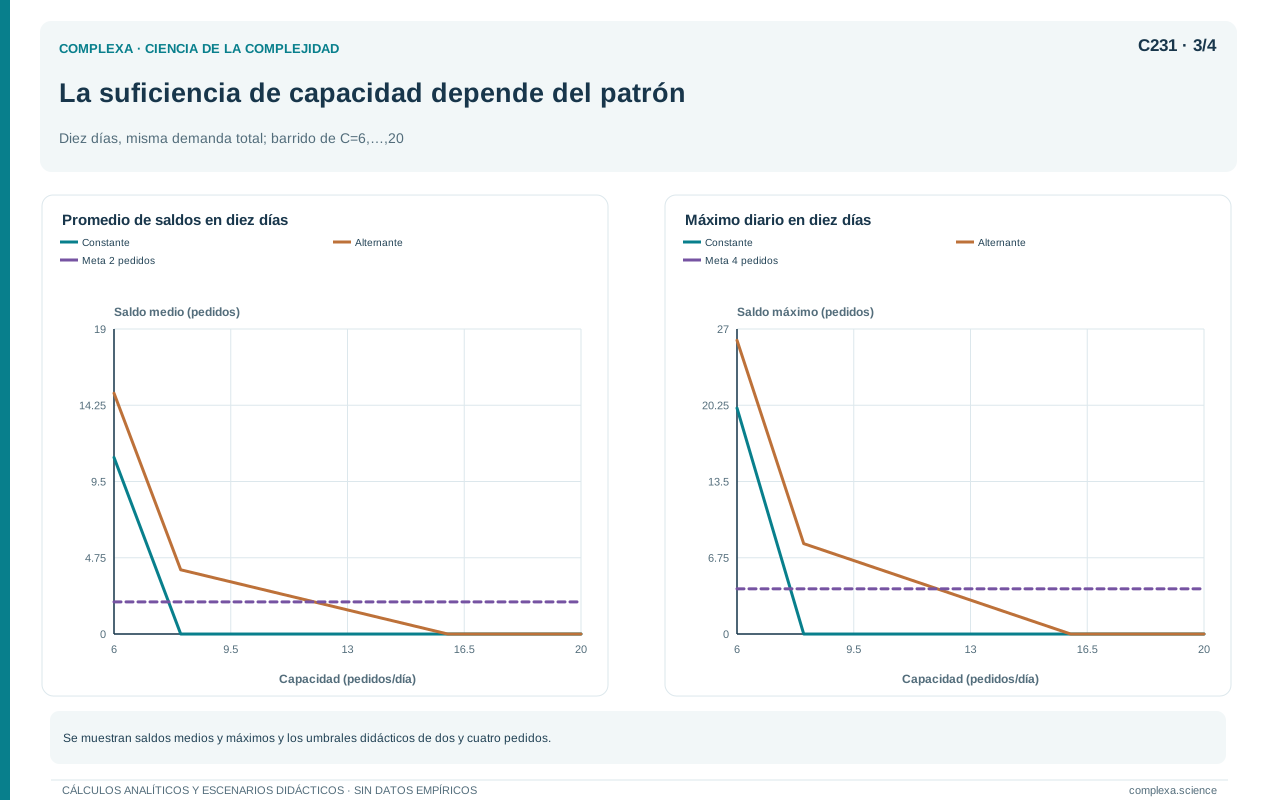
La variable de respuesta debe corresponder a la pregunta. Si nos preocupa la acumulación al cierre, podemos medir el promedio de los diez saldos diarios, el saldo máximo o la cantidad de días que superan un umbral. Estas medidas pueden ordenar las capacidades de manera diferente cuando cambian costos, restricciones o patrones de demanda. El informe debe nombrarlas antes de presentar un indicador compuesto que oculte sus diferencias.
Fijemos dos objetivos didácticos. El promedio de trabajo pendiente no debe superar dos pedidos y el máximo no debe superar cuatro. No afirmamos que esos umbrales sean razonables para una aplicación concreta; su función es establecer una regla de éxito verificable. Una capacidad será suficiente para el escenario considerado si satisface ambos objetivos. Si solo cumple el promedio, el máximo seguirá siendo una razón explícita para rechazarla dentro de este diseño.
Los objetivos deben indicar qué población de circunstancias cubren. «Máximo de cuatro» puede significar el máximo observado en una realización, el máximo posible dentro de un conjunto finito de escenarios o un cuantil de una distribución estocástica. Son garantías distintas. Un resultado obtenido en diez jornadas no demuestra un límite para un año; tampoco un máximo observado equivale a un máximo matemático sobre todas las secuencias admisibles.
También debemos distinguir entre cantidades latentes y medidas disponibles. El modelo puede conservar el número exacto de pedidos pendientes, mientras que el sistema real registra una auditoría parcial o un total con retraso. Comparar directamente ambos números atribuiría a la dinámica discrepancias del proceso de observación. Cuando esa diferencia sea relevante, el modelo necesita una regla que transforme su estado interno en la observación efectivamente recogida.
La elección de escala afecta al criterio. Un promedio diario puede ocultar congestión durante unas horas; un promedio semanal puede ocultar varios cierres críticos. Agregar observaciones reduce detalle y puede facilitar la estimación, pero también cambia qué significa cumplir un objetivo. Si el daño operativo depende de episodios breves, una medida suavizada puede resultar inadecuada aunque se ajuste bien a los datos disponibles.
Una ficha de resultados puede separar tres capas. La primera contiene las variables que produce directamente la simulación, como saldos y pedidos atendidos; la segunda, resúmenes como medias y máximos; la tercera, juicios relativos a objetivos, como satisfacer ambos umbrales. Conservar esa separación permite recalcular una decisión cuando cambian los criterios sin modificar retrospectivamente las trayectorias ni presentar el nuevo juicio como si fuera el resultado original.
231.4. Un ejemplo mínimo que ya responde algo
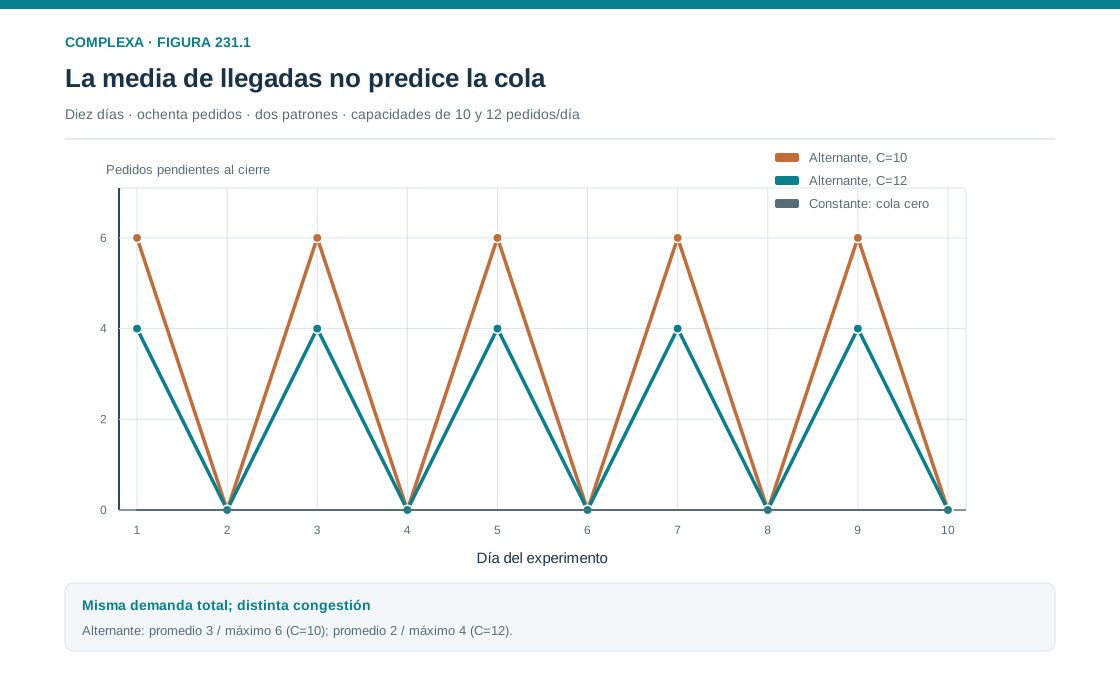
Comparemos dos patrones de llegada durante diez días. En el primero llegan ocho pedidos cada jornada. En el segundo alternan dieciséis y cero, comenzando por dieciséis. Ambos suman ochenta pedidos y tienen demanda media de ocho por día. Partimos de una cola vacía y fijamos una capacidad de diez. Estas condiciones bastan para calcular todos los saldos sin aleatoriedad, de manera que cada diferencia procede del patrón temporal.
Con ocho llegadas diarias se atienden todos los pedidos antes del cierre. Los diez saldos son cero. En el patrón alternante, el primer día quedan seis pedidos; el segundo se atienden esos seis y la cola vuelve a cero. La pareja de saldos se repite cinco veces. El promedio de trabajo pendiente al cierre es tres, el máximo es seis y el saldo final también es cero.
Por tanto, una demanda media inferior a la capacidad no garantiza ausencia de acumulación en cada jornada. El ejemplo lo demuestra con una construcción explícita que no requiere invocar comportamiento caótico, decisiones irracionales ni una distribución de colas compleja. La interacción entre llegadas agrupadas, capacidad diaria limitada y conservación del trabajo pendiente basta para generar la diferencia observada.
Ahora elevamos la capacidad a doce. El patrón constante mantiene saldos nulos. En el alternante aparecen cuatro pedidos pendientes después de cada día con llegadas y cero después del siguiente. El promedio es dos y el máximo cuatro. La nueva capacidad satisface exactamente los dos objetivos didácticos en ambos escenarios. La conclusión depende de que esos sean los patrones evaluados y de que todas las llegadas estén disponibles antes del procesamiento.
El saldo final revela otro problema de medición, porque las cuatro combinaciones de patrón y capacidad terminan con cola vacía. Si observáramos únicamente el último día, perderíamos todas las diferencias de acumulación. Un buen ajuste del saldo final no identificaría el patrón de llegadas ni demostraría que el modelo reproduce la experiencia durante el período. La variable que usemos para validar debe poder discriminar las diferencias relevantes.
El ejemplo tampoco calcula tiempos individuales de espera. Para hacerlo tendríamos que especificar el orden de atención y la posición temporal de las llegadas dentro del día. Convertir automáticamente seis pedidos pendientes en seis días de demora sería incorrecto. La interpretación debe respetar lo que es el estado, una cantidad de trabajo restante en instantes definidos. Las preguntas sobre duración exigen información adicional, aunque usen el mismo sistema como punto de partida.
231.5. Supuestos que pueden cambiar la conclusión
Un supuesto es importante cuando modificarlo dentro de un rango plausible cambia una conclusión relevante. En el ejemplo, elevar las llegadas alternantes de dieciséis a veinte, manteniendo días intermedios sin llegadas, produce ocho pedidos pendientes en los días de carga con capacidad doce. El promedio pasa a cuatro y el máximo a ocho. La capacidad que cumplía los objetivos deja de cumplirlos. La respuesta anterior era válida para su escenario, pero no era una garantía frente a cualquier agrupamiento.
La condición inicial también importa. Si comenzamos con trabajo acumulado, los primeros días incluyen una carga heredada. El horizonte de diez jornadas puede ser demasiado corto para que desaparezca su efecto. Una cola inicial vacía tiene sentido si la operación estudiada empieza realmente vacía; en una operación establecida, fijarla sin evidencia puede introducir un optimismo artificial. La elección del estado inicial es una decisión de modelado como las demás.
La capacidad constante puede ser otra simplificación decisiva. Ausencias, mantenimiento o cambios de turno introducen variabilidad. Dos organizaciones con la misma capacidad media pueden responder de manera distinta si las interrupciones coinciden con jornadas de alta demanda. Una simulación que genera demanda y capacidad de forma independiente descarta esa asociación por construcción. Si existe una causa común que afecta a ambas, debemos representarla o explorar su efecto mediante escenarios.
También podemos modificar la regla de conservación. Si algunos pedidos se cancelan mientras esperan, la cola puede reducirse sin que aumente el procesamiento. Un indicador basado solamente en trabajo pendiente podría interpretar esa reducción como mejora. Para evitarlo necesitamos contabilizar por separado las salidas por atención y por abandono. La ecuación de balance se amplía y la evaluación incorpora consecuencias que antes permanecían fuera del estado.
La heterogeneidad de tamaño introduce otra posibilidad. Con pedidos de una y de cuatro unidades de esfuerzo, una capacidad de doce unidades no significa doce pedidos atendidos. La composición de la demanda y la regla de prioridad afectan tanto al saldo como a la distribución de demoras. Si la pregunta trata de pedidos urgentes, un promedio sobre todos puede ocultar el resultado del grupo pertinente.
Estos cambios no obligan a añadir cada mecanismo a la primera versión. Conviene registrar una lista breve de supuestos con su función, evidencia y posible consecuencia. Después damos prioridad a aquellos cuya modificación puede invertir la decisión o revelar un error sustantivo. La sofisticación se justifica por la pregunta y por el efecto del supuesto sobre la respuesta.
231.6. Verificar, contrastar y calibrar
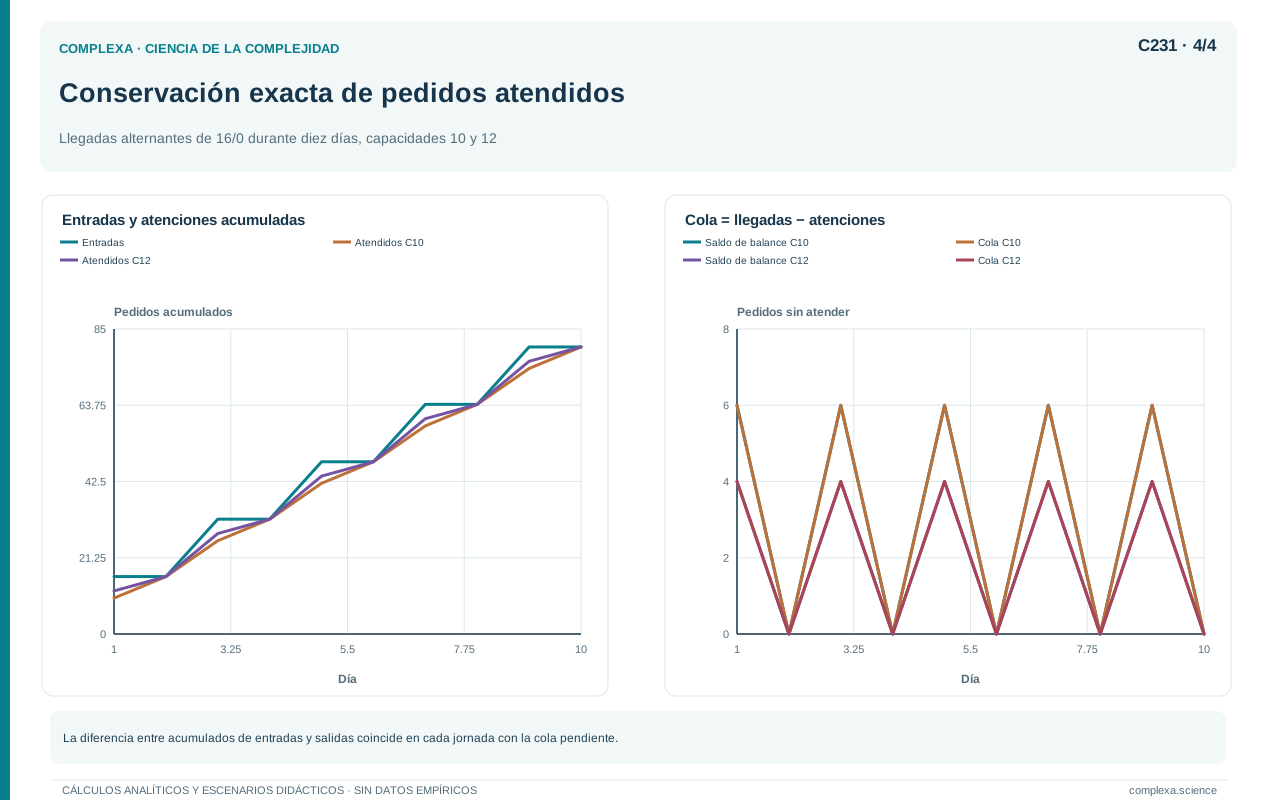
La verificación pregunta si el programa implementa el modelo especificado. En nuestro ejemplo podemos comprobar la conservación del trabajo, es decir, que el saldo siguiente sea igual al anterior más las llegadas menos los pedidos atendidos. También verificamos que ninguna cantidad sea negativa y que el procesamiento no supere la capacidad ni el trabajo disponible. Estas propiedades detectan errores concretos, aunque no demuestran que las reglas describan una organización real.
Los casos calculables a mano son otra referencia. La secuencia de ocho pedidos diarios con capacidad diez debe mantener vacía la cola si esta empieza vacía. La secuencia alternante debe producir los saldos ya enumerados. Si el programa discrepa, debemos explicar la discrepancia antes de estudiar escenarios complejos. Puede haber un error de índices, una convención temporal distinta o una implementación incorrecta de la capacidad.
El contraste empírico pregunta si las consecuencias del modelo son adecuadas para el propósito declarado. Sargent distingue aspectos de validez conceptual, datos, implementación y comportamiento operacional dentro del desarrollo de simulaciones [2]. Aquí usamos esa separación para evitar un error frecuente, que es tomar la superación de las pruebas de software como evidencia de adecuación empírica. Un programa impecable puede ejecutar fielmente supuestos que no describen el sistema de interés.
Calibrar es ajustar parámetros con datos. Si escogemos capacidad efectiva o probabilidades de llegada para reproducir una serie observada, esa coincidencia informa sobre el ajuste, pero todavía no es una evaluación independiente. Podemos reservar otros períodos o usar propiedades no empleadas en el ajuste. La estrategia depende del objetivo y de la cantidad de información disponible, pero la reutilización de datos debe quedar explícita.
Oreskes, Shrader-Frechette y Belitz señalaron los límites de una verificación absoluta de modelos de sistemas abiertos y la diferencia entre confirmación parcial y demostración de verdad [3]. Esta advertencia no impide evaluar modelos, pero exige evaluaciones acotadas que digan qué observaciones son compatibles con la representación, qué discrepancias aparecen y para qué usos basta la evidencia. La etiqueta «validado» necesita un dominio y un propósito.
Una conclusión de alcance limitado diría que el programa conserva pedidos y reproduce los casos analíticos y que, con parámetros fijados a partir de ciertos registros, aproxima los saldos diarios de otros períodos dentro de una tolerancia especificada. Esta afirmación permite examinar cada componente. Decir que el modelo «funciona» no distingue entre corrección del código, ajuste a datos y utilidad para una decisión; además, dificulta saber qué revisar cuando cambian las condiciones.
231.7. Identificabilidad y explicaciones alternativas
Dos modelos pueden reproducir el mismo resultado observado mediante mecanismos diferentes. En nuestro ejemplo, una cola final vacía es compatible con llegadas constantes, llegadas agrupadas y varias capacidades. El dato final no contiene información suficiente para distinguir esas posibilidades. La dificultad no desaparece con un optimizador más potente, porque, si diferentes configuraciones producen exactamente la misma observación, la ambigüedad pertenece al problema de identificación.
La identificabilidad estructural considera si, bajo observaciones ideales y el diseño especificado, parámetros o mecanismos distintos pueden distinguirse. La identificabilidad práctica considera además ruido, cantidad de datos y precisión. Aunque una diferencia sea distinguible en principio, puede ser demasiado pequeña para detectarla en el registro disponible. Conviene separar ambos problemas porque el primero pide cambiar el diseño y el segundo, mejorar la información.
Podemos aumentar la información observando los saldos cada día y registrando por separado llegadas y procesamiento. El patrón alternante deja entonces una señal visible. Sin embargo, si la capacidad declarada incluye tiempo ocioso no disponible para pedidos, todavía puede haber una diferencia entre capacidad nominal y efectiva. Medir con más frecuencia mejora la resolución, pero una definición ambigua de las variables exige además asegurar la correspondencia entre medición y concepto.
Comparar mecanismos alternativos puede ser más informativo que perfeccionar uno solo. Un modelo atribuye la acumulación a llegadas agrupadas; otro, a interrupciones de capacidad; un tercero, a pedidos de tamaño variable. Si todos ajustan la misma serie de saldos, debemos preguntar qué observación adicional produce predicciones diferentes. Registros de esfuerzo, horarios de interrupción o distribución de tamaños pueden discriminar las propuestas de manera más directa que otra medida global de ajuste.
Una intervención diseñada también puede ayudar. Cambiar temporalmente la capacidad bajo condiciones controladas produce respuestas distintas si la congestión depende de un cuello de botella modificable o de una restricción situada fuera del equipo. La interpretación causal requiere que el diseño y los supuestos sostengan esa comparación. La intervención simulada muestra consecuencias dentro del modelo, mientras que la intervención empírica da evidencia sobre el sistema.
La multiplicidad de explicaciones no vuelve inútil el modelado. Permite distinguir conclusiones robustas a varias representaciones de conclusiones que dependen de una elección específica. Si todas las alternativas plausibles predicen que cierta capacidad fracasa bajo una demanda extrema, esa coincidencia puede ser informativa. Si discrepan sobre una decisión cercana al umbral, la prioridad puede ser obtener datos que separen sus predicciones antes de aumentar el detalle de cualquiera de ellas.
231.8. Incertidumbre y criterios de decisión
En un experimento computacional aparecen incertidumbres diferentes. La variabilidad de llegadas entre jornadas pertenece al proceso representado; la incertidumbre sobre su distribución pertenece a nuestro conocimiento; la elección entre reglas alternativas pertenece a la estructura del modelo. Además, una simulación con número finito de réplicas introduce error de Monte Carlo al estimar valores esperados. Mezclar estas fuentes en una única banda puede impedir saber cómo reducir la incertidumbre que realmente importa.
En el ejemplo determinista no hay error de Monte Carlo, porque, dadas las entradas y las reglas, los saldos se calculan exactamente con enteros. La incertidumbre aparece al preguntar si esos escenarios corresponden a circunstancias pertinentes. Repetir miles de veces el mismo cálculo no mejora esa representatividad. Para ampliar el alcance necesitamos otras entradas, evidencia sobre su frecuencia o mecanismos adicionales, según la pregunta que queramos responder.
Si introducimos llegadas aleatorias, debemos definir la cantidad que compararemos. Podemos estimar el saldo medio esperado, la probabilidad de superar cuatro pedidos o un cuantil del máximo durante diez días. El promedio sobre muchas réplicas no sustituye a una probabilidad de excedencia. Una política puede tener buen promedio y, aun así, producir episodios de acumulación inaceptables bajo el criterio elegido.
La tolerancia numérica debe distinguirse de la relevancia sustantiva. Una diferencia de una centésima de pedido en una media estimada puede calcularse con gran precisión y ser irrelevante para la decisión. Otra diferencia pequeña puede resultar decisiva si cruza un umbral operativo. El criterio de éxito necesita justificar qué magnitud importa, cómo se trata la incertidumbre alrededor del umbral y qué consecuencias tienen los errores de clasificación.
Los costos también pueden cambiar la comparación. Si aumentar la capacidad de diez a doce tiene un costo, no basta mostrar que reduce el trabajo pendiente. Podemos presentar ambos resultados por separado o formular una función de decisión que explicite el intercambio entre recursos y acumulación. Esa función incorpora valoraciones y restricciones que no se deducen de la ecuación dinámica. Hacerlas visibles evita presentar una preferencia como si fuera un teorema del modelo.
Una conclusión robusta especifica el conjunto de condiciones bajo las cuales se mantiene. Podemos informar que una capacidad cumple los objetivos en todos los escenarios examinados, junto con los límites de ese conjunto. Si el conjunto se seleccionó después de observar resultados favorables, la robustez queda comprometida. Por eso conviene definir escenarios, rangos de parámetros y criterios principales antes de hacer la comparación final y conservar las revisiones posteriores como parte del historial del estudio.
231.9. Un documento de diseño antes del código extenso
El documento inicial puede ser breve, pero debe contener decisiones suficientes para que otra persona reconozca el problema. Comienza con la pregunta, el uso previsto y la unidad de análisis; en nuestro caso, comparar capacidades diarias para controlar los pedidos pendientes al cierre durante diez jornadas. Después fija la frontera del sistema, las variables, sus unidades y el orden de actualización. Esta información convierte una idea general en una especificación reproducible.
La siguiente parte registra los supuestos y sus alternativas prioritarias. Llegadas externas, pedidos de igual esfuerzo, ausencia de abandono, capacidad constante e inicialización vacía son elecciones explícitas. Para cada una puede anotarse qué dato la respalda y qué cambio podría afectar a la decisión. Una lista de supuestos sin consecuencias examinables se convierte fácilmente en una formalidad; ligar cada supuesto a una comparación orienta el trabajo posterior.
El documento define también los observables y el criterio de éxito. Se guardarán saldos diarios, llegadas y procesamiento; con ellos se calcularán promedio, máximo y saldo final. Los umbrales didácticos serán dos y cuatro para promedio y máximo, respectivamente. Se distinguirán resultados por escenario y no se promediarán escenarios sin una regla de ponderación justificada, ya que una media entre situaciones no tiene una interpretación probabilística automática.
Antes de programar conviene escribir algunos resultados esperados. Son casos de referencia deducidos de las reglas; confirmarlos a cualquier costo desvirtuaría su función. Si llegan cero pedidos y la cola está vacía, debe permanecer vacía. Si la capacidad es cero, el saldo acumula todas las llegadas. Si capacidad y demanda constante coinciden desde una cola vacía, el saldo al cierre es cero bajo nuestra convención temporal.
La planificación de datos separa ajuste y evaluación. Identifica qué registros se usarán para estimar entradas o parámetros, qué períodos se reservarán y cómo se tratarán ausencias o cambios de protocolo. También registra qué información no está disponible. Reconocer una limitación de datos antes del ajuste permite diseñar una conclusión compatible con ella; descubrirla después de seleccionar el resultado favorable favorece interpretaciones difíciles de auditar.
Finalmente, el documento fija productos y condiciones de revisión (código, configuración, resultados por réplica cuando corresponda y explicación de las discrepancias). No necesita anticipar cada detalle técnico. Debe conservar las decisiones que conectan pregunta, representación y evidencia, para que el proyecto pueda evolucionar sin borrar su trayectoria. Un cambio justificado de pregunta es parte legítima de la investigación; presentarlo como si hubiera sido el objetivo inicial oculta información necesaria para evaluar el resultado.
231.10. Una conclusión proporcional a la evidencia
Nuestro ejemplo permite concluir con precisión que, con capacidad diaria fija y llegadas disponibles antes del procesamiento, agrupar pedidos puede producir acumulación al cierre aunque la demanda media sea inferior a la capacidad. También permite comparar dos capacidades bajo dos patrones definidos. No identifica una ley universal de congestión, no calcula esperas individuales ni establece qué capacidad debería contratar una organización real. El valor del resultado está en que sus premisas y su alcance son visibles.
Una buena conclusión puede incluir condiciones de fracaso. Si las llegadas máximas cambian, si aparecen pedidos de tamaños distintos o si la capacidad no está disponible cuando se necesita, la evaluación debe repetirse con una representación adecuada. Estas condiciones proceden de los mecanismos que el modelo incluye y de los que deja fuera, por lo que orientan directamente la siguiente observación o el siguiente experimento.
El modelado también puede revelar que la pregunta estaba mal planteada. Si dos políticas tienen saldos finales idénticos pero experiencias temporales distintas, quizá el saldo final nunca fue el resultado pertinente. Si una medida de mejora se obtiene mediante abandono de pedidos, quizá el objetivo omitía una consecuencia central. Detectar estas inconsistencias antes de construir un simulador grande ahorra trabajo y mejora la interpretación científica.
La complejidad del sistema no exige que la primera versión del modelo sea compleja. Un modelo pequeño puede demostrar un mecanismo, refutar una interpretación demasiado general o identificar qué información falta. Su suficiencia depende del propósito. Añadir detalle es útil cuando modifica una predicción relevante, incorpora una heterogeneidad necesaria o permite contrastar una explicación que antes quedaba fuera.
El próximo capítulo desarrollará la arquitectura de un experimento computacional. Allí separaremos generación de entradas, dinámica, observación, análisis y registro para que las decisiones formuladas aquí puedan ejecutarse y revisarse de manera consistente. La calidad de esa arquitectura empieza con este trabajo previo, es decir, con una pregunta definida, supuestos trazables y criterios que permitan reconocer qué se aprendió y qué sigue sin resolverse.
Referencias
- Box, G. E. P. (1976). Science and statistics. Journal of the American Statistical Association, 71(356), 791–799. DOI: 10.1080/01621459.1976.10480949.
- Sargent, R. G. (2013). Verification and validation of simulation models. Journal of Simulation, 7, 12–24. DOI: 10.1057/jos.2012.20.
- Oreskes, N., Shrader-Frechette, K., y Belitz, K. (1994). Verification, validation, and confirmation of numerical models in the Earth sciences. Science, 263(5147), 641–646. DOI: 10.1126/science.263.5147.641.
Nota del caso. El sistema de pedidos, sus umbrales y los escenarios numéricos son construcciones didácticas propias. No corresponden a datos empíricos ni a una recomendación de operación.