Módulo 23. Complejidad algorítmica, computacional y estadística
230.1. Una comparación con preguntas separadas
Una secuencia puede ser difícil de comprimir, fácil de generar y poco informativa acerca de su futuro. Otra puede admitir una descripción muy breve y requerir que el observador recuerde una fase para predecirla. Una tercera puede combinar innovaciones aleatorias con restricciones temporales. Las tres situaciones impiden ordenar todos los procesos mediante una única escala de complejidad. El propósito de este caso resuelto es convertir esa advertencia conceptual en una comparación que el lector pueda reproducir.
Trabajaremos con seis procesos binarios conocidos. Dos generan símbolos independientes, uno equilibrado y otro sesgado. Un tercero conserva con frecuencia el símbolo anterior. El cuarto repite un patrón periódico de cuatro posiciones. Los dos últimos son las máquinas Golden Mean y Even, estudiadas en el capítulo 228. Elegimos procesos pequeños para calcular exactamente algunas propiedades y confrontarlas con mediciones sobre registros finitos. Así podemos distinguir una diferencia matemática de una fluctuación producida por la simulación.
Las preguntas serán explícitas. ¿Cuánta incertidumbre contiene un símbolo aislado? ¿Cuánta permanece por símbolo después de conocer el pasado? ¿Cuánta información debe conservar un predictor causal mínimo? ¿Cuánta información comparten pasado y futuro? ¿Qué regularidades explotan dos procedimientos concretos de compresión? No esperamos que las respuestas coincidan, porque cada pregunta define un objeto distinto. La comparación será útil precisamente cuando muestre desacuerdos explicables entre las medidas.
El experimento usa una sola realización de cada proceso, con longitud común y semillas documentadas. Eso basta para obtener ejemplos reproducibles, aunque es insuficiente para estimar distribuciones de resultados sobre muchas realizaciones. Las cifras empíricas no llevan intervalos de confianza ni son promedios universales. Las cantidades derivadas analíticamente de los modelos, en cambio, tienen valores exactos bajo sus supuestos. Mantener separadas ambas columnas evita atribuir al simulador una precisión que no tiene.
Tampoco intentaremos calcular complejidad de Kolmogorov, profundidad lógica o complejidad efectiva de las cadenas producidas. Los capítulos anteriores explicaron por qué un compresor disponible no resuelve esos problemas generales. Aquí medimos resultados de algoritmos concretos y propiedades de procesos especificados. Este alcance permite concluir, con firmeza y de forma verificable, que determinados indicadores responden de maneras distintas ante las mismas secuencias y que sus diferencias pueden entenderse a partir de las reglas de generación.
230.2. Seis generadores y sus condiciones iniciales
El primer proceso produce ceros y unos con probabilidad un medio, independientemente en cada instante. El segundo mantiene la independencia, pero asigna probabilidad dos décimas al uno. En ambos, observar el pasado no cambia la distribución del siguiente símbolo. El sesgo reduce la incertidumbre marginal y la tasa de entropía, sin introducir memoria predictiva. Esta pareja permite separar desigualdad de frecuencias y dependencia temporal, dos propiedades que una comparación superficial puede confundir.
El tercer proceso es una cadena de Markov simétrica que permanece en el símbolo anterior con probabilidad ocho décimas y cambia con probabilidad dos décimas. La iniciamos con ceros y unos igualmente probables para usar su distribución estacionaria. Cada símbolo aislado tiene entonces máxima entropía binaria, igual que en el primer proceso. Sin embargo, el último símbolo permite anticipar mejor el siguiente. La regularidad está en las transiciones.
El cuarto proceso repite cero cero uno uno. Para obtener una ley estacionaria elegimos inicialmente una de las cuatro fases con igual probabilidad. Una vez conocida la fase, todo el futuro queda determinado. El símbolo aislado vuelve a ser equilibrado y conocer solamente el anterior tampoco determina el siguiente, porque después de un cero puede venir cero o uno. Conocer dos símbolos consecutivos sí permite identificar la fase dentro del ciclo.
Golden Mean tiene dos estados. Desde A emite uno y permanece en A con probabilidad un medio, o emite cero y pasa a B con la misma probabilidad. Desde B emite uno y vuelve a A con certeza. No puede producir dos ceros consecutivos. Even también tiene dos estados. Desde A emite cero y permanece en A con probabilidad un medio, o emite uno y pasa a B; desde B emite uno y vuelve a A. Entre ceros consecutivos aparecen cantidades pares de unos.
Ambas máquinas tienen distribución estacionaria de estados de dos tercios en A y un tercio en B. Aunque comparten esa distribución y la matriz de transición entre estados sin etiquetas, los símbolos que emiten en cada transición son diferentes. Por eso producen leyes observacionales distintas. La simulación comienza sorteando el estado con esas probabilidades; empezar siempre en A produciría un transitorio inicial diferente. Este detalle afecta las probabilidades de palabras cortas y la interpretación de las primeras predicciones.
230.3. Lo que podemos calcular sin simular
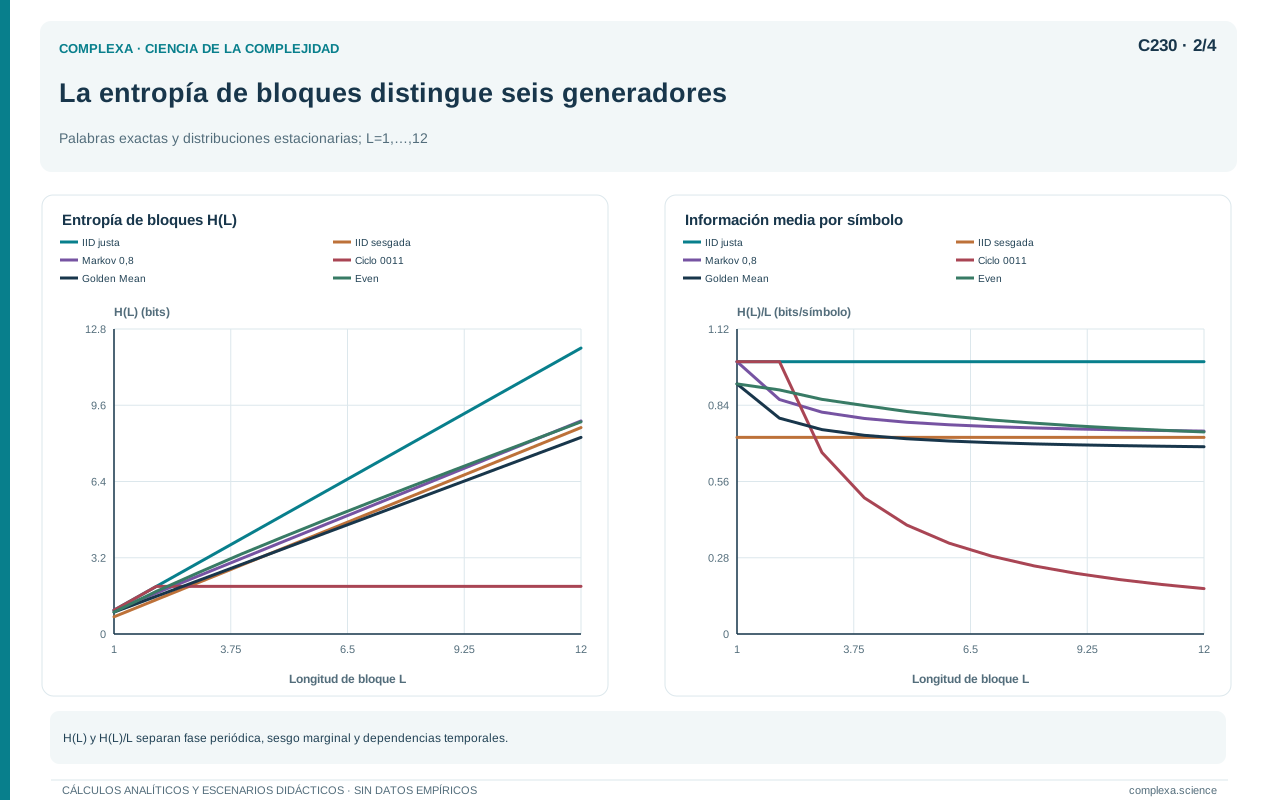
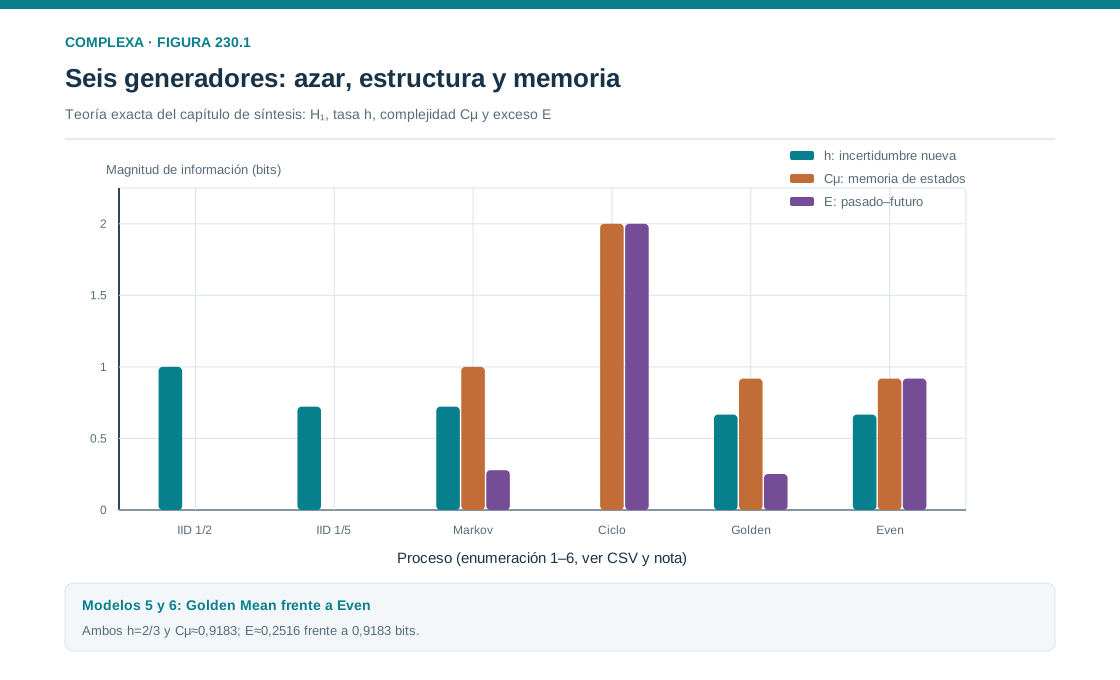
Denotemos por H la entropía de un símbolo, por h la tasa de entropía, por C la complejidad estadística y por E la información mutua entre pasado y futuro completos. Todas las cantidades se expresan en bits, salvo h, que se mide en bits por símbolo. Las distribuciones estacionarias y las máquinas predictivas de estos ejemplos dan los valores siguientes. Los decimales redondean expresiones exactas; ninguno se estimó a partir de las secuencias simuladas.
| Proceso estacionario | H | h | C | E |
|---|---|---|---|---|
| Independiente equilibrado | 1 | 1 | 0 | 0 |
| Independiente, probabilidad de uno 0,2 | 0,721928 | 0,721928 | 0 | 0 |
| Markov, permanencia 0,8 | 1 | 0,721928 | 1 | 0,278072 |
| Periódico 0011, fase uniforme | 1 | 0 | 2 | 2 |
| Golden Mean | 0,918296 | 0,666667 | 0,918296 | 0,251629 |
| Even | 0,918296 | 0,666667 | 0,918296 | 0,918296 |
Los procesos independientes requieren un único estado predictivo; todos los pasados conducen a la misma distribución futura. Por ello su complejidad estadística es nula, aunque produzcan cadenas que un compresor no consiga reducir. La cadena de Markov necesita distinguir el último símbolo; sus dos estados equiprobables almacenan un bit. Su tasa de entropía es la entropía de una decisión de cambiar con probabilidad dos décimas, igual a la tasa del proceso independiente sesgado.
El proceso periódico necesita distinguir cuatro fases predictivas. Cada fase conduce a una continuación determinista diferente y las cuatro son equiprobables, por lo que su complejidad estadística es dos bits. El pasado y el futuro identifican la misma fase, de modo que comparten esos dos bits. El proceso no genera, sin embargo, información nueva de manera sostenida; la entropía de un bloque suficientemente largo permanece en dos bits mientras su longitud aumenta sin límite.
Podemos comprobarlo enumerando palabras. Los bloques de longitud dos son cero cero, cero uno, uno uno y uno cero, cada uno con probabilidad un cuarto. Cada bloque identifica una fase y determina cualquier extensión posterior. Por tanto, la entropía de un símbolo es un bit y la de cualquier bloque de longitud al menos dos es dos bits. La primera ampliación añade un bit; las siguientes no añaden incertidumbre. Este cálculo explica exactamente por qué la memoria de primer orden falla mientras la de segundo orden resulta suficiente.
En la cadena persistente, en cambio, cada ampliación posterior al primer símbolo añade la misma entropía binaria de una probabilidad de cambio de dos décimas. La entropía de un bloque es un bit más esa contribución multiplicada por su longitud menos uno. La pendiente asintótica mide la innovación sostenida; el término constante que queda después de descontar esa pendiente es la información compartida entre pasado y futuro. Las dos geometrías de crecimiento de la incertidumbre son distintas, aunque ambas secuencias tengan símbolos marginalmente equilibrados.
Golden Mean y Even permiten una comparación más sutil. Comparten entropía marginal, tasa de entropía y complejidad estadística, pero difieren en E. En Golden Mean, parte de la información del estado no puede recuperarse del futuro observado. En Even, la posición del primer cero futuro revela la paridad necesaria para identificar el estado inicial, salvo un evento de probabilidad cero. La diferencia muestra que memoria almacenada e información compartida con el futuro no son cantidades intercambiables [1, 2].
La tabla también evita una falsa oposición entre azar y organización. El proceso independiente equilibrado tiene la mayor tasa de entropía y memoria predictiva nula. El periódico tiene tasa nula y la mayor memoria entre estos ejemplos. Las dos máquinas combinan innovación y restricciones. Ninguno de estos ordenamientos mide utilidad, capacidad adaptativa, valor biológico o dificultad computacional universal; para hablar de esas propiedades haría falta formular tareas y modelos adicionales.
230.4. Medidas sobre registros finitos
Generamos ocho mil ciento noventa y dos símbolos por proceso, longitud que permite empaquetar exactamente ocho símbolos en cada byte y facilita comparar codificaciones. Calculamos primero la entropía empírica de símbolos y una entropía condicional empírica de primer orden. Esta última se obtiene contando parejas consecutivas, estimando las distribuciones del siguiente símbolo para cada símbolo previo y promediando sus entropías según las frecuencias de esos contextos. Describe transiciones observadas y, como estimación de la tasa de entropía, solo es adecuada en algunos procesos.
Calculamos también el número de frases de la descomposición Lempel–Ziv de 1976, con la convención de reproducción recursiva y el tratamiento de la frase terminal especificados en el capítulo 223. Su normalización multiplica ese número por el logaritmo binario de la longitud y divide por la longitud. La cifra puede superar uno en muestras finitas. No la truncamos, porque hacerlo escondería una propiedad del estimador y sugeriría equivocadamente que es una probabilidad o una entropía binaria exacta.
Como segundo procedimiento comprimimos cada registro con zlib, nivel nueve. Aplicamos el mismo compresor a una cadena de caracteres ASCII, en la que cada cero o uno ocupa un byte antes de comprimir, y a una representación que empaqueta ocho símbolos en un byte. Informamos los bits del resultado comprimido por símbolo original. El denominador común permite comparar resultados, aunque la diferencia entre entradas sigue siendo relevante, porque el algoritmo busca patrones en bytes y estos dependen de la codificación de los símbolos.
La longitud comprimida incluye la envoltura y los metadatos propios de zlib. Por eso una secuencia empaquetada de apariencia aleatoria puede terminar ligeramente más larga que su entrada. Ese aumento solo indica que este procedimiento, con esta representación y este tamaño, no produjo ahorro neto. No mide la complejidad de Kolmogorov de la secuencia.
Finalmente evaluamos la pérdida logarítmica del modelo generador conocido. El cálculo usa solamente la secuencia observada para actualizar una distribución sobre los estados; no entrega al predictor la trayectoria interna sorteada por el simulador. Sí le entrega, en cambio, la topología y las probabilidades verdaderas. Por tanto, es una referencia ideal con parámetros conocidos, sin etapa de aprendizaje. Esta condición será decisiva al interpretar la ventaja predictiva del modelo Even sobre una descripción de primer orden.
230.5. Resultados y desacuerdos informativos
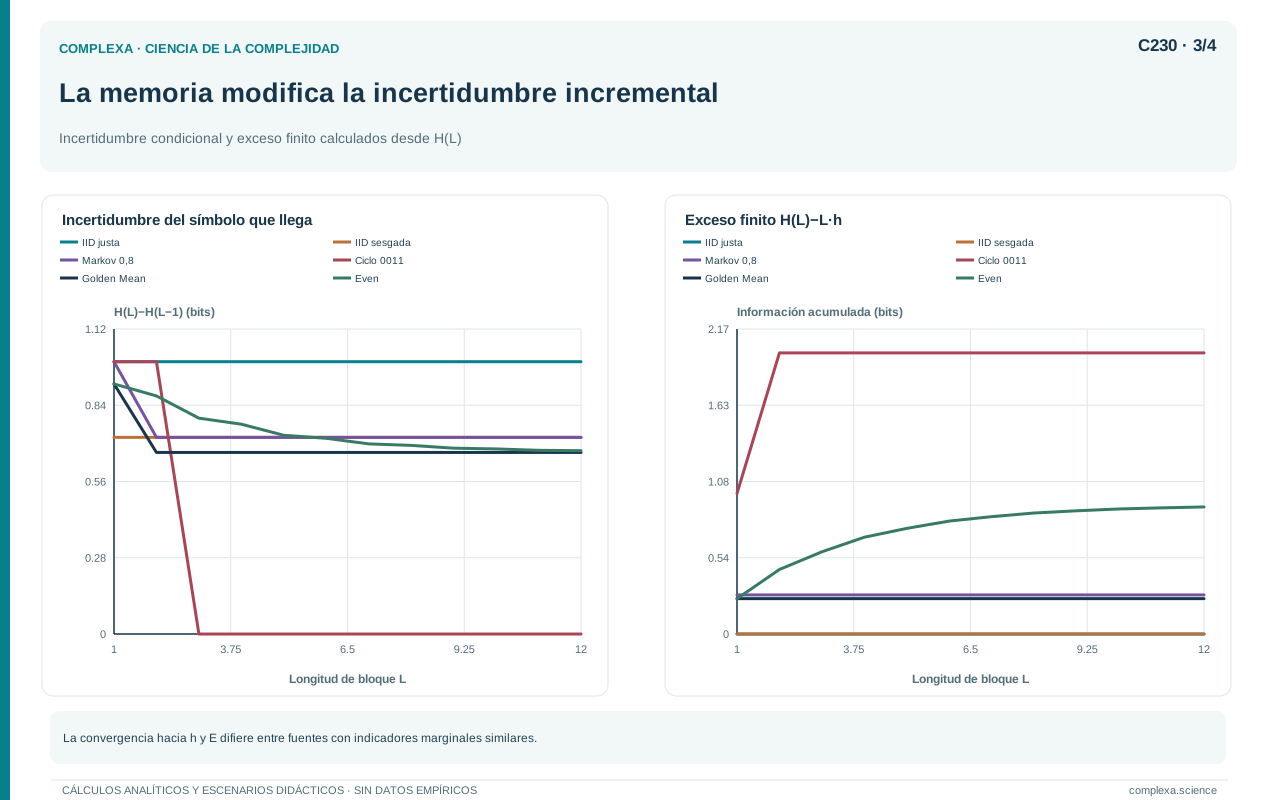
La ejecución de referencia usó Python 3.12.14 y zlib 1.3.2. Las semillas, en el orden de presentación de los procesos, fueron doscientos treinta a doscientos treinta y cinco. La tabla siguiente redondea a cuatro decimales. La columna condicional usa exclusivamente parejas; la última corresponde al modelo generador conocido, con incertidumbre inicial sobre su estado. Las discrepancias respecto de los valores teóricos pueden deberse al muestreo y a los efectos de borde de una secuencia finita.
| Proceso | H empírica | Condicional de primer orden | LZ normalizada | Pérdida del modelo conocido |
|---|---|---|---|---|
| Independiente equilibrado | 0,9995 | 0,9995 | 1,0251 | 1,0000 |
| Independiente sesgado | 0,7267 | 0,7264 | 0,7332 | 0,7267 |
| Markov persistente | 0,9999 | 0,7132 | 0,7347 | 0,7134 |
| Periódico 0011 | 1,0000 | 1,0000 | 0,0063 | 0,0002 |
| Golden Mean | 0,9161 | 0,6689 | 0,7046 | 0,6689 |
| Even | 0,9221 | 0,8787 | 0,7554 | 0,6687 |
El proceso independiente sesgado y la cadena persistente tienen entropías marginales diferentes y tasas teóricas iguales. En estas realizaciones, la normalización Lempel–Ziv produce cifras cercanas para ambos. Sus mecanismos, sin embargo, son distintos; uno reduce incertidumbre mediante frecuencias desiguales y el otro mediante memoria temporal. Una sola cifra de compresibilidad puede resumir oportunidades de predicción diferentes.
El proceso periódico expone el límite de una memoria demasiado corta. Su entropía marginal y su entropía condicional de primer orden son prácticamente un bit, igual que las del proceso independiente equilibrado. Sin embargo, su tasa real es cero. El compresor Lempel–Ziv reconoce repetición a mayor distancia y produce solamente cuatro frases en esta realización. El predictor con la estructura conocida paga dos bits iniciales para resolver la fase, repartidos sobre todo el registro.
Even también exige más que el último símbolo. Su entropía condicional teórica de primer orden es aproximadamente cero coma ochocientos setenta y cuatro bits, superior a su tasa de dos tercios. El pasado contiene información sobre paridad que una descripción de parejas pierde. La pérdida del modelo conocido recupera esa información y se aproxima a dos tercios. De este resultado no se sigue que cualquier algoritmo de inferencia pueda descubrir la máquina con la misma longitud de datos.
Las diferencias entre Golden Mean y Even en Lempel–Ziv tampoco contradicen su igualdad de tasas de entropía. La normalización es finita y su convergencia depende de cómo aparecen las regularidades en los datos. El resultado exige distinguir una propiedad asintótica compartida de la eficiencia de un procedimiento en registros concretos. Elegir únicamente la cifra menor y llamar al proceso correspondiente «menos complejo» borraría precisamente la diferencia estructural que buscamos comprender.
230.6. La codificación también participa
Los resultados del compresor práctico muestran que la representación de entrada cambia la medida. Las longitudes comprimidas se expresan en bits por símbolo original, de modo que un valor cercano a uno equivale aproximadamente a un bit comprimido por cada cero o uno observado. El archivo ASCII sin comprimir usa ocho bits por símbolo; el empaquetado, uno. Esta diferencia inicial explica por qué una gran reducción porcentual del archivo de texto puede coexistir con escaso ahorro frente a la representación binaria natural.
| Proceso | zlib sobre ASCII | zlib sobre bits empaquetados |
|---|---|---|
| Independiente equilibrado | 1,3672 | 1,0107 |
| Independiente sesgado | 1,0576 | 0,8203 |
| Markov persistente | 1,0342 | 0,8447 |
| Periódico 0011 | 0,0332 | 0,0166 |
| Golden Mean | 0,9844 | 0,7549 |
| Even | 1,0117 | 0,8486 |
En el proceso independiente equilibrado, comprimir la representación ASCII reduce considerablemente el tamaño inicial porque el alfabeto de bytes usado es muy limitado. Ese ahorro no revela necesariamente dependencia temporal. Al empaquetar previamente los símbolos eliminamos gran parte de esa redundancia de representación y el resultado comprimido supera ligeramente un bit por símbolo. Ambos resultados pertenecen a la misma secuencia, pero responden a entradas informáticas distintas.
En el proceso periódico, las dos representaciones permiten reconocer la repetición y producen archivos pequeños. Aun así, las cifras no son cero porque debemos codificar una descripción finita y sus convenciones. La tasa de entropía nula describe el crecimiento asintótico de la incertidumbre por símbolo; no exige que un archivo finito carezca de contenido o de encabezado. Esta distinción remite a la diferencia entre la complejidad de un objeto y la tasa de información de un proceso.
La comparación entre el proceso sesgado y el persistente cambia ligeramente según la representación. No debemos transformar esa inversión local en una afirmación general sobre sus complejidades. El compresor toma decisiones de diccionario, ventanas y codificación que interactúan con patrones concretos. Para comparar estudios conviene fijar formato, longitud, implementación y parámetros, además de conservar una referencia sin comprimir. Una razón de tamaños carece de significado completo si no sabemos qué bytes entraron en el cálculo.
La portabilidad tiene límites explícitos. Las reglas de generación y las cantidades analíticas son independientes de zlib. Las longitudes comprimidas pueden cambiar con versiones o implementaciones que produzcan flujos diferentes aunque todos se descompriman correctamente. El objetivo reproducible es identificar el procedimiento usado y permitir su repetición; otro compresor u otra versión pueden arrojar enteros distintos. La comparación científica debe separar la estabilidad conceptual de la estabilidad exacta del archivo generado.
230.7. Controles que modifican una propiedad a la vez
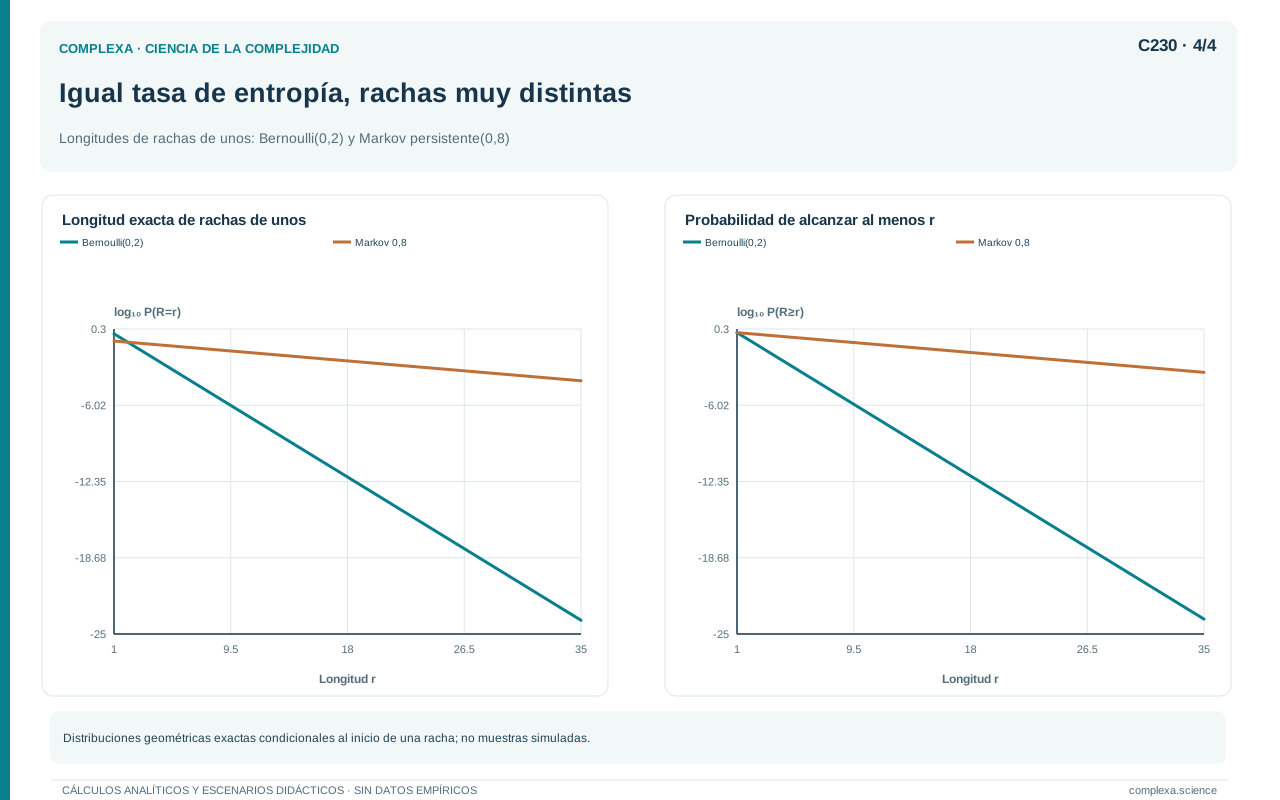
Un control útil consiste en permutar aleatoriamente el orden de los símbolos conservando sus cantidades. Esta operación mantiene exactamente la entropía empírica de símbolos, pero altera las dependencias temporales. No produce una muestra independiente ideal en sentido estricto, porque las cantidades totales quedan fijadas y el muestreo es sin reemplazo. Sin embargo, es una referencia concreta para preguntar cuánto dependen las medidas del orden dentro del registro observado.
Aplicamos ese control al patrón periódico y al registro Even, con semillas separadas. En el primero, la entropía marginal permanece exactamente en un bit, mientras la normalización Lempel–Ziv pasa de aproximadamente cero coma cero cero seis a uno coma cero treinta y nueve. En Even, la entropía marginal permanece en cero coma novecientos veintidós, mientras Lempel–Ziv pasa de cero coma setecientos cincuenta y cinco a cero coma novecientos cuarenta y cuatro. El orden contiene regularidades que la permutación destruye.
Llamar «complejidad organizada», en sentido general, a toda diferencia sería ir más allá del control, porque la permutación elimina simultáneamente muchas propiedades temporales, incluidas dependencias simples y restricciones de largo alcance. Si queremos distinguirlas, necesitamos controles más específicos. Por ejemplo, una referencia de primer orden ajustada al registro puede conservar aproximadamente las probabilidades de transición y eliminar otras dependencias. Su construcción y su evaluación deben declarar qué propiedades se preservan exactamente y cuáles solamente en promedio.
Otra prueba conceptual es modificar la resolución temporal. Muestrear cada segundo símbolo del patrón cero cero uno uno produce una alternancia, con una fase que depende del origen del muestreo. La tasa de entropía sigue siendo nula, pero el número de fases predictivas se reduce de cuatro a dos y la complejidad estadística, bajo la ley estacionaria inducida, pasa de dos bits a uno. El cambio afecta al proceso observado y puede ocurrir sin que el sistema generador se haya simplificado.
También podemos añadir errores de observación. Si cada símbolo periódico se invierte de forma independiente con una probabilidad pequeña, aparecen innovaciones observacionales y se dificulta la identificación de fase. No calcularemos aquí la máquina predictiva exacta de ese proceso ruidoso, que puede requerir una representación diferente. Si después de añadir ruido medimos más entropía o más frases, eso no demuestra un aumento de organización interna, porque hay que distinguir la información del sistema de la incertidumbre introducida por el canal de medida.
230.8. Código y alcance de la reproducción
El programa siguiente contiene los generadores, el filtrado predictivo, las medidas y los controles de permutación. Usa únicamente la biblioteca estándar de Python. Cada modelo es un conjunto de probabilidades conjuntas de emitir un símbolo y pasar al estado siguiente. Esta representación permite usar el mismo cálculo de probabilidad de palabras para procesos independientes, cadenas observables y máquinas con estados ocultos. Las semillas se asignan por proceso para que añadir otro ejemplo no cambie automáticamente las realizaciones anteriores.
La generación sí usa un estado interno sorteado, porque necesita producir datos conforme al modelo. El cálculo de pérdida no recibe esa trayectoria; comienza con la distribución estacionaria y actualiza las probabilidades de estado después de cada símbolo. Normaliza en cada paso para evitar que el producto de muchas probabilidades pequeñas se convierta en cero numérico. La suma de los logaritmos de los factores de normalización es la probabilidad logarítmica de la secuencia observada.
La función Lempel–Ziv es deliberadamente directa y poco optimizada. Su propósito es hacer visible la convención de segmentación y permitir reproducir los ejemplos cortos del capítulo 223; no está pensada para millones de observaciones. La función de empaquetado exige que la longitud sea múltiplo de ocho. Si se modifica esa condición, habrá que registrar el relleno y la longitud original para conservar una representación inequívoca.
Código reproducible
from collections import Counter
from math import log2
from random import Random
import json,zlib,sys
N=8192
def entropy(counts):
    total=sum(counts)
    return -sum((v/total)*log2(v/total) for v in counts if v)
def pick(weights,rng):
    u=rng.random()
    for i,w in enumerate(weights):
        u-=w
        if u<0:return i
    return len(weights)-1
def model(name):
    if name=="IID_05":return [1.0], [[[.5]],[[.5]]]
    if name=="IID_02":return [1.0], [[[.8]],[[.2]]]
    if name=="Markov_08":return [.5,.5], [[[.8,0],[.2,0]],[[0,.2],[0,.8]]]
    if name=="Periodo_0011":
        mats=[[[0.0]*4 for _ in range(4)] for _ in range(2)]
        for s,a in enumerate([0,0,1,1]):mats[a][s][(s+1)%4]=1.0
        return [.25]*4,mats
    if name=="Golden_Mean":return [2/3,1/3], [[[0,.5],[0,0]],[[.5,0],[1,0]]]
    if name=="Even":return [2/3,1/3], [[[.5,0],[0,0]],[[0,.5],[1,0]]]
    raise ValueError(name)
def generate(pi,mats,n,seed):
    rng=Random(seed);s=pick(pi,rng);out=[]
    for _ in range(n):
        edges=[(a,t,p) for a in [0,1] for t,p in enumerate(mats[a][s]) if p]
        a,s,_=edges[pick([e[2] for e in edges],rng)];out.append(a)
    return out
def loss(x,pi,mats):
    w=pi[:];total=0.0
    for a in x:
        v=[sum(w[s]*mats[a][s][t] for s in range(len(w))) for t in range(len(w))]
        p=sum(v);assert p>0
        total-=log2(p);w=[q/p for q in v]
    return total/len(x)
def lz76(x):
    s="".join(map(str,x));i=0;c=0
    while i<len(s):
        j=i+1
        while j<=len(s) and s[i:j] in s[:j-1]:j+=1
        i=min(j,len(s));c+=1
    return c
def pack(x):
    assert len(x)%8==0
    return bytes(sum(x[i+j]<<(7-j) for j in range(8)) for i in range(0,len(x),8))
def metrics(x):
    pairs=Counter(zip(x[:-1],x[1:]))
    cond=sum(sum(pairs[a,b] for b in [0,1])*entropy([pairs[a,b] for b in [0,1]]) for a in [0,1] if sum(pairs[a,b] for b in [0,1]))/(len(x)-1)
    c=lz76(x)
    return {"H1":entropy(list(Counter(x).values())),"h_order1":cond,
            "c76":c,"q76":c*log2(len(x))/len(x),
            "zlib_ascii_bits_per_symbol":8*len(zlib.compress("".join(map(str,x)).encode(),9))/len(x),
            "zlib_packed_bits_per_symbol":8*len(zlib.compress(pack(x),9))/len(x)}
names=["IID_05","IID_02","Markov_08","Periodo_0011","Golden_Mean","Even"]
rows=[]
for k,name in enumerate(names):
    pi,mats=model(name);x=generate(pi,mats,N,230+k)
    row={"process":name,"seed":230+k,"n":N,**metrics(x),"known_model_loss":loss(x,pi,mats)}
    rows.append(row)
controls=[]
for name in ["Periodo_0011","Even"]:
    k=names.index(name);pi,mats=model(name);x=generate(pi,mats,N,230+k)
    Random(500+k).shuffle(x)
    controls.append({"process":name+"_shuffled",**metrics(x)})
out={"python":sys.version.split()[0],"zlib":zlib.ZLIB_RUNTIME_VERSION,"rows":rows,"controls":controls}
print(json.dumps(out,indent=2))
El programa imprime resultados suficientes para reconstruir las tablas; el redondeo editorial se aplica después. No ajusta parámetros, no selecciona topologías y no ejecuta CSSR. Por ello, el rendimiento del modelo conocido debe seguir identificado como referencia. Para convertir el ejercicio en un estudio de inferencia habría que crear segmentos de entrenamiento y prueba, estimar cada modelo candidato y repetir la evaluación con sus parámetros aprendidos.
Una extensión razonable sería repetir cada condición con muchas semillas y estudiar la distribución, el sesgo y la dispersión de las medidas. Otra sería aumentar gradualmente la longitud para observar tendencias de convergencia. Esas extensiones responderían preguntas nuevas y exigirían registrar costos de cómputo y criterios de comparación. El experimento actual ya cumple su objetivo principal, que era producir contraejemplos concretos a la idea de que la entropía marginal, la compresibilidad y la memoria predictiva deben ordenar los procesos de la misma manera.
230.9. Interpretar sin convertir indicadores en esencias
Supongamos que un estudio observa menor compresibilidad en una condición que en otra. El resultado puede proceder de mayor innovación aleatoria, de un cambio de frecuencias, de dependencias más difíciles de explotar por el algoritmo o de ruido de medida. Para discriminar estas posibilidades conviene acompañar el indicador con distribuciones marginales, referencias temporales y documentación de la adquisición. Una etiqueta como «mayor complejidad» reúne explicaciones diferentes si no se especifica qué medida cambió y bajo qué controles.
Algo semejante ocurre con la memoria predictiva. El patrón periódico requiere dos bits de estado en nuestra descripción estacionaria, más que cualquiera de los otros ejemplos. Sin embargo, su regla generadora es breve y sus futuros son deterministas. Tener mayor complejidad estadística dentro de esta comparación no significa ser más difícil de describir algorítmicamente ni de simular. La medida cuantifica la información promedio del estado causal, con una definición que debe conservarse al interpretar el resultado.
La comparación de Golden Mean y Even añade una distinción entre cantidades iguales y estructuras iguales. Tres indicadores teóricos coinciden, pero existen palabras permitidas en un proceso e imposibles en el otro. Ninguna coincidencia en un vector pequeño de resúmenes garantiza igualdad de distribuciones completas. Si la pregunta depende de tiempos de retorno, paridades o secuencias específicas, debemos examinar esas propiedades directamente, sin suponer que las medidas globales las recogen.
Tampoco debemos asignar profundidad lógica a partir de una simulación lenta. Un programa ineficiente puede generar una secuencia sencilla y un programa rápido puede producir una cadena difícil de comprimir para un algoritmo particular. La profundidad definida mediante programas cercanos a la descripción mínima requiere comparar alternativas que el experimento no explora. Del mismo modo, la complejidad efectiva depende de conjuntos de modelos, tolerancias y criterios algorítmicos que no se reducen al número de estados de una máquina ajustada.
Finalmente, los datos sintéticos tienen una función delimitada. Permiten demostrar mediante un contraejemplo que una interpretación universal es falsa y comprobar si un procedimiento recupera propiedades en condiciones controladas. No establecen automáticamente la relevancia de esas propiedades para un sistema biológico, social o clínico; ese paso exige una pregunta sustantiva, observaciones apropiadas y comparación de mecanismos alternativos. La claridad matemática fortalece esa investigación cuando delimita qué evidencia adicional hace falta.
230.10. De las medidas al diseño de experimentos
El módulo comenzó preguntando cómo describir objetos mediante programas y terminó comparando procesos mediante predicción. Entre ambos extremos aparecieron límites de computabilidad, clases de costo, algoritmos de compresión y representaciones de memoria. El caso resuelto muestra que esos enfoques pueden combinarse sin confundirse. Cada uno conserva una pregunta, una unidad y un conjunto de supuestos que determinan qué conclusiones admite.
Para estudiar una secuencia nueva, el primer paso es decidir cuál de esas preguntas importa. Si interesa almacenar datos, debemos medir tamaños y costos de algoritmos concretos. Si interesa anticipar eventos, necesitamos evaluación predictiva fuera de muestra. Si interesa reconstruir organización temporal, debemos comparar modelos y examinar incertidumbre estructural. Si interesa una propiedad algorítmica ideal, debemos reconocer qué aproximaciones son computables y qué garantías les faltan.
El segundo paso es construir comparadores. Una referencia independiente separa frecuencias y orden; una referencia de primer orden distingue dependencias inmediatas de otras más largas; una simulación de mecanismo conocido permite probar sensibilidad y errores. Estos comparadores deben diseñarse según la hipótesis, porque ninguna permutación o modelo nulo conserva todas las propiedades irrelevantes mientras destruye exactamente una propiedad de interés. Documentar esa elección forma parte de la explicación científica.
El tercer paso es hacer auditable el resultado. Longitud de registro, representación, estado inicial, semillas, reglas de estimación y unidades pueden modificar la lectura de una tabla. En este ejercicio, declarar esas decisiones permitió explicar por qué el patrón periódico parece impredecible para una memoria corta y trivial para un predictor con fase. También permitió comprender por qué dos procesos con la misma tasa de entropía producen longitudes comprimidas diferentes en muestras finitas.
Los próximos capítulos desarrollarán experimentos computacionales, muestreo, sensibilidad y documentación. Allí volverá una exigencia que este caso hace visible, la de relacionar cada resultado computacional con una pregunta y con condiciones de validez. La ciencia de la complejidad gana precisión cuando describe qué regularidad fue observada, qué modelo la explica, qué cálculo la sostiene y qué comparación podría refutar esa explicación.
Referencias
- Shalizi, C. R., y Crutchfield, J. P. (2001). Computational mechanics: Pattern and prediction, structure and simplicity. Journal of Statistical Physics, 104, 817–879. DOI: 10.1023/A:1010388907793.
- Ellison, C. J., Mahoney, J. R., y Crutchfield, J. P. (2009). Prediction, retrodiction, and the amount of information stored in the present. Journal of Statistical Physics, 136, 1005–1034. DOI: 10.1007/s10955-009-9808-z.
- Lempel, A., y Ziv, J. (1976). On the complexity of finite sequences. IEEE Transactions on Information Theory, 22(1), 75–81. DOI: 10.1109/TIT.1976.1055501.
Nota del experimento. Las simulaciones, controles, tablas y cálculos comparativos son desarrollos propios. Los valores empíricos corresponden a la ejecución documentada; las propiedades teóricas corresponden a las leyes estacionarias especificadas.