Módulo 23. Complejidad algorítmica, computacional y estadística
226.1. Cuando mucha información no significa mucha organización
Una cadena sin regularidades aprovechables puede necesitar una descripción casi tan larga como ella misma. En ese sentido tiene alta complejidad algorítmica, aunque intuitivamente se parezca a ruido.
Una estructura organizada puede admitir una descripción mucho más breve y, sin embargo, requerir un proceso elaborado para producirse. La longitud mínima no registra directamente ese esfuerzo de producción.
Estas observaciones motivan medidas diferentes. La profundidad lógica considera el tiempo necesario para generar un objeto mediante descripciones suficientemente concisas. La complejidad efectiva intenta separar la información de sus regularidades de la de sus detalles contingentes.
Las dos medidas no designan la misma cantidad. Una mide el tiempo de cálculo bajo una restricción descriptiva; la otra, el tamaño de una parte estructurada de la descripción. Tampoco reemplazan la complejidad algorítmica. Usan sus ideas para responder preguntas adicionales y heredan varias de sus dificultades de cálculo e interpretación.
La intuición puede ilustrarse con una larga secuencia constante, una realización de ruido y un registro con regularidades extensas pero no triviales.
La secuencia constante tiene una regla breve y suele poder generarse directamente. El ruido puede requerir muchos bits específicos, pero copiarlos no exige descubrir una arquitectura. El tercer objeto invita a preguntar cuánto trabajo y cuánta estructura contiene su descripción.
Esa clasificación intuitiva no es todavía una medición. Una secuencia que parece organizada puede tener un atajo inesperado; una regla que parece breve puede esconder datos auxiliares.
Hay que fijar la máquina, los recursos y la representación, además de distinguir una propiedad matemática del objeto de una hipótesis sobre su historia física real.
Un objeto pudo producirse lentamente aunque exista un procedimiento rápido para reproducirlo. Su edad o el tiempo empleado por quien lo construyó no determinan automáticamente su profundidad lógica.
Separar regularidad y azar también exige criterios; no basta señalar qué partes nos parecen interesantes y asignarles una cantidad de bits.
Este capítulo presentará las definiciones, construirá ejemplos con formatos explícitos y examinará qué puede sostener una aplicación empírica. El propósito es ampliar el vocabulario de complejidad sin convertir intuiciones sugerentes en cifras supuestamente universales.
226.2. Profundidad como tiempo entre descripciones concisas
Fijemos una máquina universal óptima y usemos la complejidad simple C del objeto x. Para cada programa que produce x y termina, podemos medir su tiempo de ejecución en pasos de esa máquina.
Si minimizáramos el tiempo sin restricción de longitud, normalmente podríamos almacenar x literalmente y copiarlo. Esa solución omite la pregunta de cómo se obtiene el objeto desde una descripción concisa.
La profundidad lógica introduce una tolerancia b de longitud respecto del mínimo. Una formulación estándar para cadenas finitas define
El conjunto incluye los programas que producen exactamente x, terminan y no exceden en más de b bits la descripción mínima. Entre ellos escogemos el de menor tiempo.
La tolerancia se denomina nivel de significación en esta literatura. No es un nivel de significación estadística ni una probabilidad de error.
Bennett desarrolló varias formulaciones relacionadas de profundidad. La expresión anterior, usada también por Ay, Müller y Szkoła, permite estudiar la relación entre longitud y tiempo sin atribuir a todas las variantes una identidad exacta.
Para un objeto fijo y una tolerancia no negativa, hay programas admisibles, porque existe una descripción mínima. Sus tiempos son enteros finitos y el mínimo temporal está bien definido.
Sin embargo, conocer la definición no da un algoritmo universal que calcule el valor. La condición de admisibilidad depende de C, cuyo cálculo exacto general es imposible.
Medir el tiempo de un programa encontrado solo informa sobre ese programa y no demuestra que los demás programas igualmente concisos sean más lentos.
Un programa que se demora por instrucciones inútiles no vuelve profundo al objeto. Si existe otra descripción admisible que elimina esas instrucciones y produce rápidamente la misma salida, la minimización temporal la favorece.
La profundidad expresa así una dificultad de producción que resiste las alternativas descriptivas permitidas.
Los pasos dependen del modelo de máquina. Comparar máquinas exige considerar costos de simulación y cambios de tolerancia; no hay una invariancia numérica exacta en segundos físicos.
La definición conecta dos restricciones diferentes (cuánto podemos decir inicialmente y cuánto trabajo debemos hacer después). Su interés está precisamente en esa combinación.
226.3. La tolerancia puede cambiar radicalmente el resultado
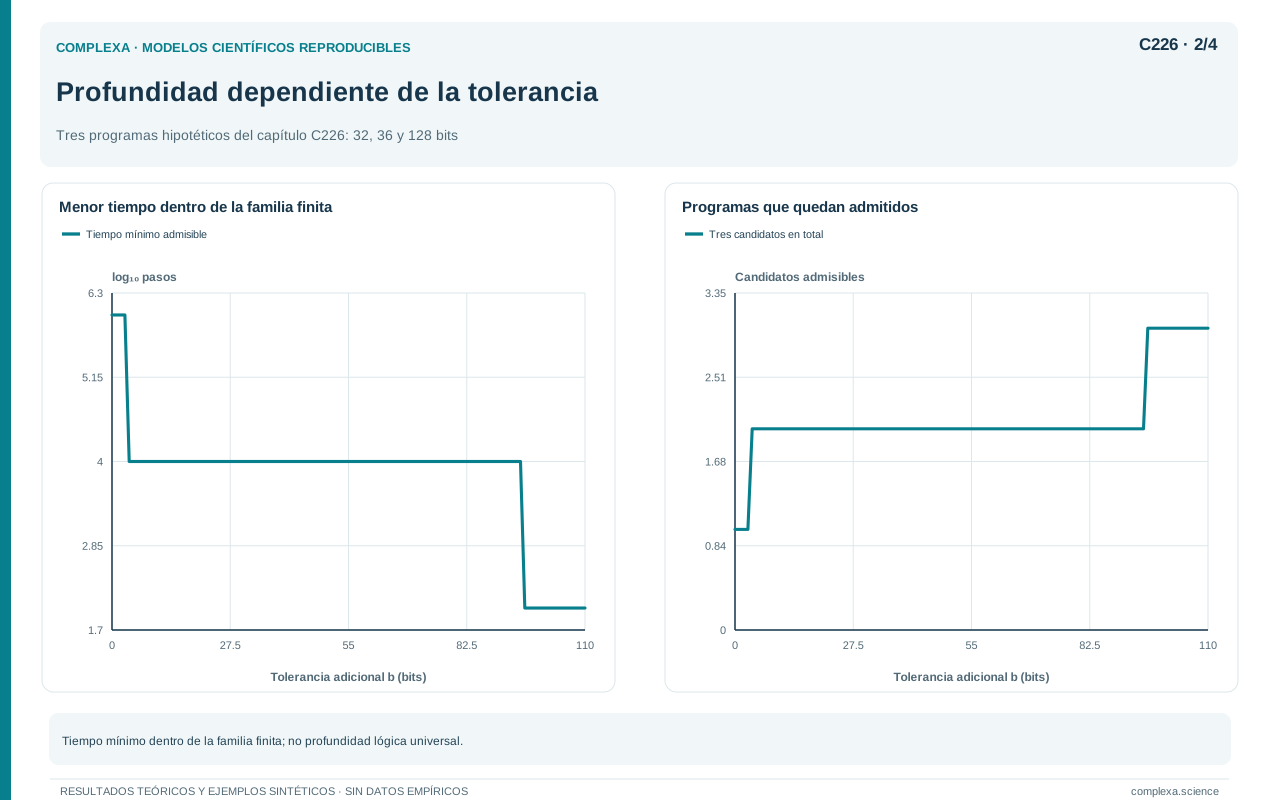
Cuando aumentamos b, admitimos más programas. Como el mínimo se toma entonces sobre un conjunto más amplio, la profundidad no puede aumentar.
Puede permanecer igual o disminuir bruscamente si entra una descripción algo más larga pero mucho más rápida. Ese comportamiento obliga a informar la tolerancia junto con el valor.
Lo ilustra una familia finita hipotética de tres descripciones de la misma cadena, con longitudes y tiempos medidos en un formato común. La descripción A ocupa 32 bits y tarda 1.000.000 de pasos; la B, 36 bits y 10.000 pasos; la C, 128 bits y 100 pasos.
Dentro de esta familia, la longitud mínima es treinta y dos bits. Si admitimos cero bits adicionales, solo entra A. Con cuatro bits adicionales entra B y el menor tiempo baja a diez mil pasos.
Con noventa y seis bits adicionales también entra C y el tiempo mínimo baja a cien. La caída se produce sin modificar el objeto, solo por la cantidad de información que permitimos incorporar en la descripción.
Este cálculo es exacto para las tres opciones, pero no da la profundidad lógica universal, porque desconocemos qué otros programas podrían producir la cadena y cuál sería su longitud mínima absoluta.
En un experimento, una curva de tiempo frente a tamaño de código puede estudiar un intercambio práctico sin certificar los mínimos universales de la definición.
La dependencia de b también explica por qué exigir únicamente el programa más corto puede ser frágil. Un pequeño ahorro descriptivo puede obligar a un cálculo muchísimo más largo.
En una aplicación quizá prefiramos almacenar algunos resultados intermedios para acelerar la reconstrucción. Eso aumenta el código o los datos auxiliares, pero puede mejorar notablemente la utilidad.
La profundidad usa ese intercambio para preguntar qué trabajo sigue siendo necesario cuando restringimos la información inicial.
El costo de salida sigue presente, porque producir una cadena extensa exige escribir sus símbolos en un modelo de salida explícita. Ser superficial significa aquí poder generarse dentro del marco en un tiempo relativamente pequeño, aunque nunca nulo.
Comparar objetos de longitudes muy distintas requiere considerar esa base de costo. Una cadena enorme puede tardar más en copiarse que una pequeña en calcularse sin que esa diferencia refleje una organización más profunda.
También conviene registrar una frontera de soluciones disponibles, con el menor tiempo encontrado para cada longitud permitida. Una descripción queda dominada si otra es simultáneamente más corta y más rápida. Eliminar opciones dominadas simplifica la comparación sin cambiar ningún mínimo dentro de la familia. En el ejemplo, ninguna de las tres domina a las otras, porque cada ahorro temporal exige más bits. Esa frontera es calculable cuando el conjunto de candidatos está delimitado, aunque sigue siendo distinta de la profundidad universal.
226.4. Ruido, espera artificial e historia física
Una cadena casi incomprimible suele tener una descripción literal cuya longitud está cerca del mínimo. Si la tolerancia cubre esa diferencia, el programa de copia es admisible y la genera rápidamente respecto del tamaño de salida.
Podemos expresar la condición con la complejidad simple. Si C de x es al menos n menos d y el programa literal tiene longitud como máximo n más una constante c, una tolerancia de al menos c más d permite esa descripción.
El argumento no asigna profundidad pequeña a cualquier cadena que pase una prueba estadística. Necesita la condición descriptiva indicada, que esas pruebas no certifican universalmente.
Una secuencia constante también puede tener un procedimiento directo. La descripción comunica el símbolo y la longitud; el programa escribe las repeticiones.
Así, la regularidad trivial y la ausencia de compresión pueden acompañarse de poca profundidad en condiciones apropiadas. La medida intenta distinguir otra dimensión de la organización.
Imaginemos ahora un programa que espera millones de pasos antes de imprimir una cadena sencilla. El tiempo observado es grande, pero la espera puede eliminarse sin perder la salida.
Por eso una simulación prolongada no prueba profundidad; habría que descartar descripciones comparables que eviten el trabajo.
La historia física plantea otra dificultad. Una piedra pudo permanecer millones de años en un entorno, pero describir ciertas propiedades observadas quizá no requiera reconstruir toda esa historia.
La profundidad se calcula sobre el objeto representado. Si registramos solo masa y tamaño, descartamos muchos detalles que podrían contener rastros de su formación.
Que un sistema evolucione durante mucho tiempo tampoco garantiza que su estado final conserve información de ese proceso, porque la dinámica puede borrar diferencias y acercarse a un estado sencillo.
Bennett relacionó profundidad y procesos de organización mediante resultados de crecimiento bajo hipótesis formales. Esa relación no autoriza a convertir tiempo cronológico, edad evolutiva o duración de entrenamiento en una medida directa de profundidad.
Una inferencia histórica necesita evidencia sobre mecanismos y alternativas. La reproducción algorítmica del objeto puede sugerir una analogía, pero sin esa evidencia no identifica la causa que realmente lo produjo.
La utilidad conceptual consiste en separar un resultado cargado de detalles de otro cuya generación concisa exige trabajo. Esa separación debe mantenerse aunque una narrativa histórica resulte atractiva.
226.5. Describir regularidades y describir residuos
La complejidad efectiva, propuesta por Gell-Mann y Lloyd, busca cuantificar la descripción de regularidades sin contar de la misma manera todos los detalles contingentes.
Imaginemos una descripción en dos partes. La primera especifica un modelo que recoge restricciones o patrones; la segunda identifica el objeto concreto entre las posibilidades que ese modelo permite.
Si el modelo es muy general, cuesta poco describirlo, pero deja muchos detalles por especificar. Si incorpora cada detalle del objeto, el residuo desaparece y el modelo puede volverse tan largo como los datos.
Interesa separar ambas contribuciones con un criterio que evite los extremos triviales. No basta minimizar solo el tamaño del modelo, porque un modelo que permite cualquier cadena sería muy barato.
Tampoco basta minimizar solo el residuo, porque podemos definir un modelo que asigne probabilidad uno al objeto observado. En ese caso toda la información queda escondida en el modelo.
La información total combina un costo descriptivo del modelo con una medida de la incertidumbre que deja. La complejidad efectiva mide la parte regular bajo restricciones que controlan esa información total y la adecuación del objeto.
La estadística algorítmica estudia problemas relacionados mediante modelos, códigos en dos partes y nociones de suficiencia para objetos individuales. Gács, Tromp y Vitányi desarrollaron ese marco con distinciones formales entre modos de descripción.
En ese contexto, la tipicidad de un dato dentro de un conjunto no garantiza que el conjunto sea una explicación descriptiva eficiente, porque también hay que contabilizar cuánto cuesta especificarlo. Un conjunto que contiene únicamente el dato lo hace trivialmente típico, pero puede esconder toda su información en la descripción del propio conjunto. La suficiencia algorítmica exige controlar el costo conjunto de modelo y residuo.
Estas conexiones no hacen idénticas todas las medidas. Un criterio de selección de modelos aplicado a una familia limitada, una estadística suficiente clásica y una complejidad efectiva universal responden a definiciones diferentes.
Una regularidad también puede depender de la escala. Un registro microscópico incluye variaciones que una descripción macroscópica agrupa, mientras que otra pregunta puede exigir conservarlas.
Por eso el objeto, las restricciones y la información auxiliar deben especificarse antes de interpretar la separación entre modelo y residuo.
Un modelo puede capturar frecuencias sin capturar orden temporal; otro puede capturar transiciones y omitir amplitudes. Sus costos estructurales corresponden a regularidades distintas.
La pregunta adecuada es qué estructura se necesita para describir el objeto de manera económica bajo un criterio declarado. Una cifra aislada de tamaño de modelo no dice cuánto de la organización relevante hemos comprendido.
226.6. Una formalización mediante distribuciones computables
Ay, Müller y Szkoła precisaron una versión de complejidad efectiva mediante distribuciones sobre cadenas finitas. Cada distribución, llamada conjunto estadístico o ensemble, es una propuesta sobre regularidades y variación residual.
Usaremos aquí K para la complejidad de prefijo, distinta de la complejidad simple C de la definición de profundidad. La diferencia de convención no debe ocultarse al combinar fórmulas.
El marco exige distribuciones computables con entropía finita y computable. El costo K del modelo incluye describir tanto la distribución como su entropía con la precisión requerida, ya que en dominios infinitos disponer de un procedimiento para aproximar probabilidades individuales no garantiza disponer de uno para calcular la entropía.
La información total del modelo E es la suma de su costo algorítmico y su entropía
Una condición de tipicidad exige que el objeto x no tenga una probabilidad demasiado pequeña respecto de la entropía del modelo. Con un parámetro no negativo delta, la condición es
Después se busca el menor costo de modelo entre los que satisfacen esa condición y cuya información total no supera K de x más una tolerancia Delta
Si no hay modelos admisibles, esta definición asigna infinito. Las tolerancias forman parte de la medida y deben comunicarse con cada resultado.
Aumentar cualquiera de las dos tolerancias amplía, o deja igual, el conjunto admisible, de modo que el mínimo estructural no puede aumentar por ese cambio. Sin embargo, las tolerancias actúan sobre condiciones diferentes; delta modifica qué sorpresa aceptamos para el objeto y Delta, el presupuesto de información total. Obtener la misma cifra con dos pares de valores no significa que se hayan aceptado los mismos modelos. Un análisis de sensibilidad debe examinar tanto el costo como la identidad y las propiedades de las descripciones seleccionadas.
La primera restricción relaciona el objeto con el modelo. La segunda impide aceptar una descripción total arbitrariamente derrochadora solo para reducir el costo estructural.
Se minimiza el costo del modelo para medir las regularidades una vez controlada la adecuación descriptiva; la información total solo interviene como restricción.
Para un modelo uniforme sobre un conjunto finito S, la entropía es el logaritmo del número de elementos. Cada miembro tiene exactamente esa sorpresa, por lo que cumple la condición de tipicidad con delta igual a cero.
Sin embargo, pertenecer al conjunto no garantiza cumplir el límite de información total. Un conjunto enorme puede incluir x y resultar demasiado costoso como descripción conjunta frente a una alternativa más precisa.
La formulación es matemática. Incluye complejidades algorítmicas desconocidas y una optimización sobre modelos muy generales, así que no puede ejecutarse como una receta universal. Sus versiones prácticas necesitan restricciones y garantías propias.
226.7. Un ejemplo finito de modelo y detalle
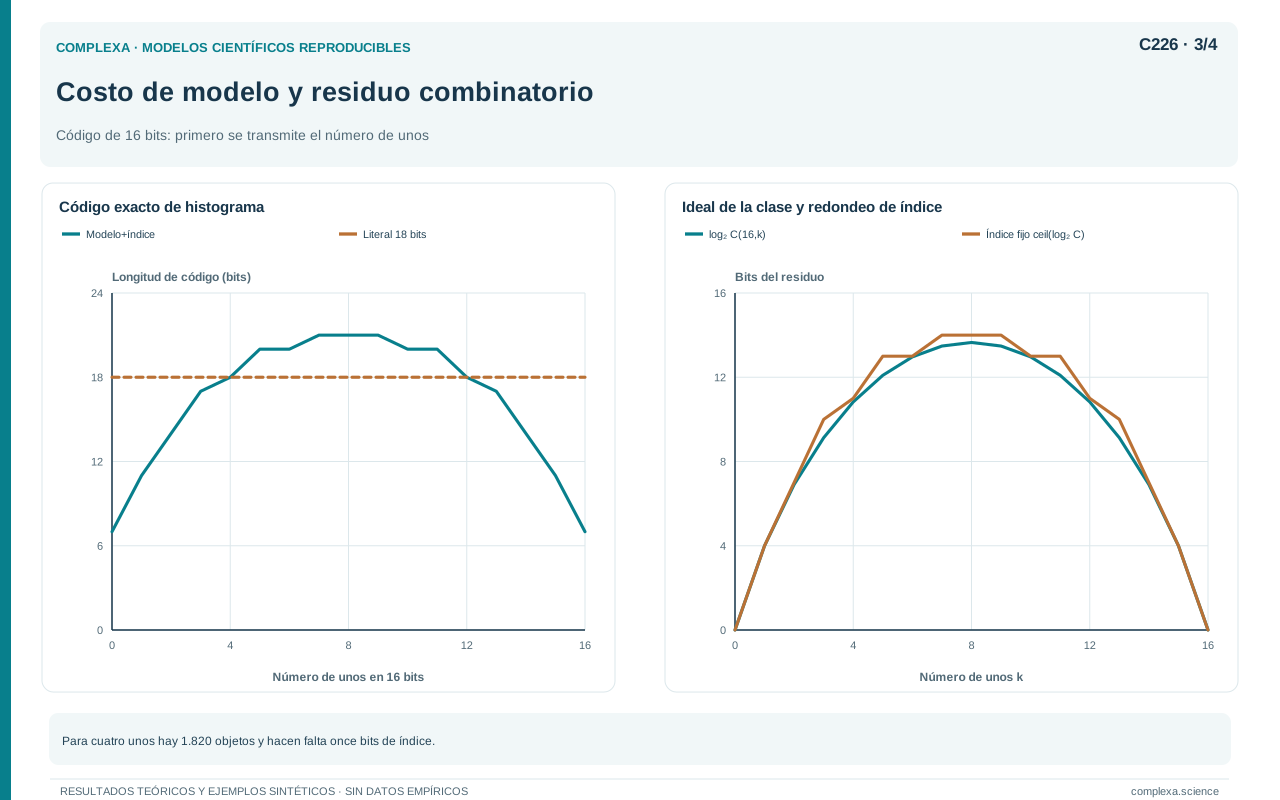
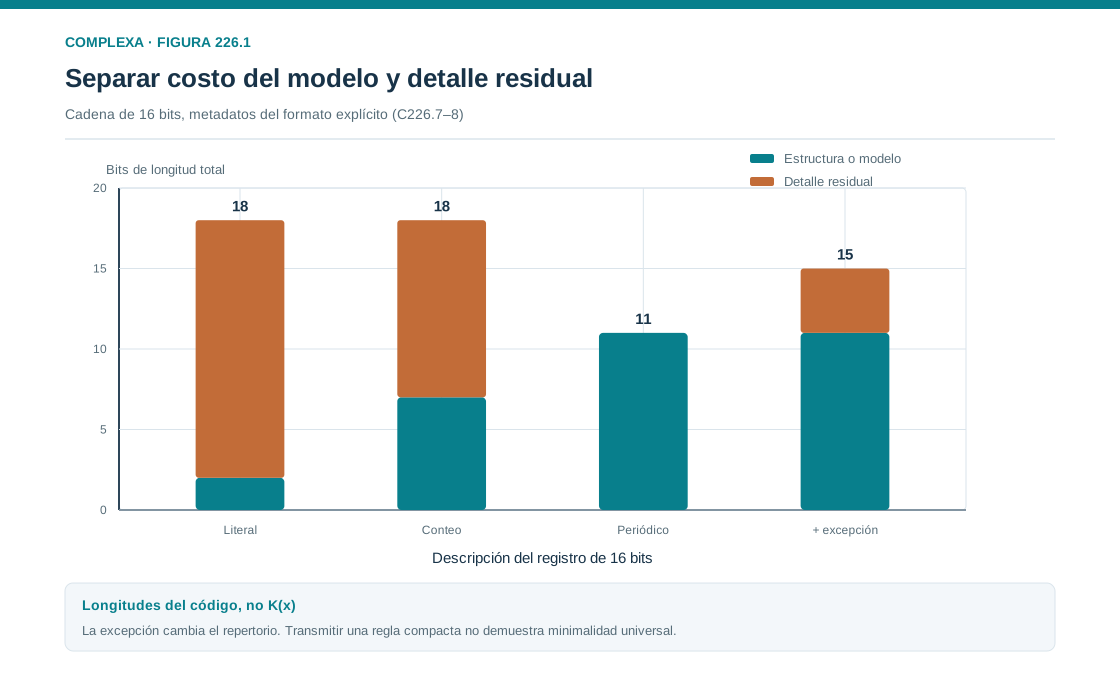
Construyamos un ejemplo explícito con una cadena de dieciséis bits. Supongamos que emisor y receptor conocen la longitud y que usamos etiquetas de dos bits para distinguir tres formatos.
El primer formato admite cualquier cadena de esa longitud; tras la etiqueta transmitimos los dieciséis bits literalmente, con un costo total de dieciocho bits.
Podemos interpretar la etiqueta como la descripción de un modelo uniforme sobre todas las cadenas y los dieciséis bits restantes como la identificación de la realización.
El segundo formato declara cuántos unos contiene la cadena. Reservamos cinco bits para comunicar ese número, que puede ir de cero a dieciséis. Después enviamos su posición en una enumeración de las cadenas compatibles.
Si hay cuatro unos, existen 1.820 cadenas posibles. Un índice de longitud fija requiere once bits, porque diez bits no alcanzan para distinguirlas y once sí.
El costo total es entonces de dieciocho bits (dos de etiqueta, cinco para el número de unos y once para el índice). El residuo baja de dieciséis a once bits, pero el modelo sube de dos a siete.
El tercer formato declara un bloque periódico. Usamos cinco bits para su longitud y después transmitimos los símbolos del bloque, que debe repetirse exactamente hasta completar dieciséis posiciones.
Para la cadena formada por cuatro repeticiones de 0010, el bloque ocupa cuatro bits. El costo total es dos más cinco más cuatro, es decir, once bits, que corresponden íntegramente a la regla.
Estas longitudes dependen de los códigos elegidos y de convenciones compartidas (las etiquetas, la longitud conocida y el orden de enumeración); ninguna mide la complejidad universal de la cadena.
El modelo con menor costo estructural es el primero, pero no tiene el menor costo total. El formato periódico incorpora más estructura y describe mejor esta cadena particular.
La entropía del modelo uniforme con cuatro unos es aproximadamente 10,830 bits. El índice usa once porque una palabra de longitud fija necesita un número entero de bits.
Este detalle separa entropía ideal y longitud de un código concreto. Confundirlas puede introducir errores incluso en un ejemplo pequeño.
La comparación ilustra el intercambio entre regularidad y residuo. Los once bits no son, sin embargo, una medida certificada de la complejidad efectiva de la cadena.
226.8. Qué cambia al perturbar o restringir el objeto
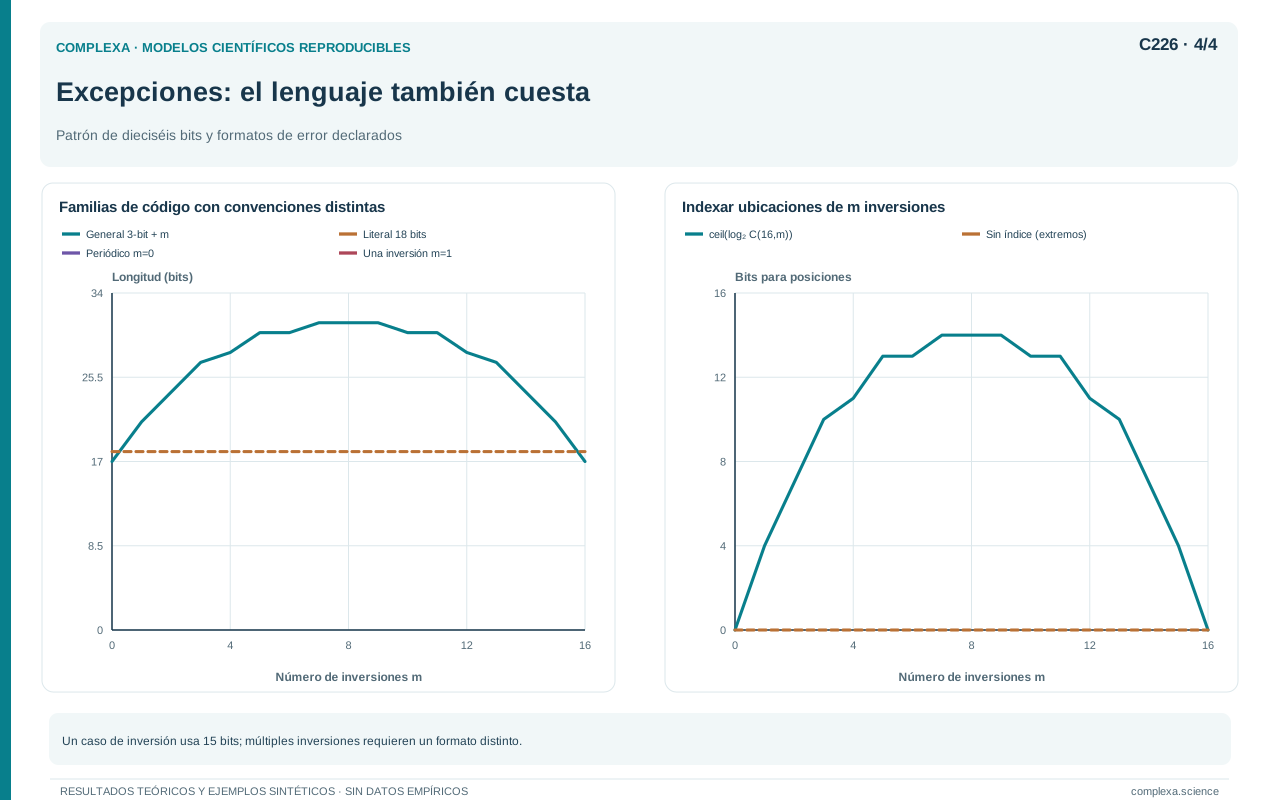
Si alteramos un símbolo del patrón periódico, el tercer formato deja de reconstruir la cadena. Podemos añadir una instrucción de excepción, pero hay que pagar su posición y su nuevo valor.
La modificación crea una nueva familia de modelos, cuya conveniencia depende de cuánto ahorra frente a describir literalmente todo el registro.
Una excepción aislada puede ser barata; muchas excepciones pueden volver ineficaz la regla periódica. El punto de cambio depende del formato, la longitud y la forma de codificar las posiciones.
En nuestro ejemplo podemos reservar la cuarta etiqueta de dos bits para una repetición con exactamente una inversión de símbolo. Conservamos los cinco bits de longitud del bloque y sus cuatro bits de contenido; añadimos cuatro bits para indicar una de las dieciséis posiciones. No hace falta transmitir el nuevo símbolo porque invertir un bit lo determina. El total es quince bits. Esta ampliación describe una perturbación concreta con menos costo que los dieciocho bits literales, pero la ventaja depende de conocer de antemano la convención de una única inversión.
Una excepción no tiene por qué ser ruido físico. Puede corresponder a una regularidad de escala mayor que nuestro modelo todavía no representa.
Si las alteraciones aparecen cada cierto número de bloques, quizá exista una descripción jerárquica más corta. Un modelo de periodicidad simple las trataría como residuo; otro podría incorporarlas como estructura.
La frontera entre regularidad y detalle depende, por tanto, del repertorio de modelos considerado. Una familia insuficiente puede asignar demasiado contenido al residuo.
Una familia excesivamente flexible puede memorizar datos y presentar esa memoria como estructura. El costo de describir parámetros y excepciones ayuda a controlar ese problema.
La información auxiliar modifica el balance. Si el receptor ya dispone del bloque 0010, no necesitamos transmitirlo, aunque entonces medimos una descripción condicional.
Comparar dos objetos con conocimientos auxiliares distintos requiere ajustar la interpretación. El ahorro puede proceder de lo que el receptor ya sabe, sin que haya una diferencia intrínseca entre los objetos.
La resolución también cambia el resultado. Redondear valores puede revelar repeticiones exactas que no existían en el registro original. Aumentar la precisión puede incorporar detalles de medición difíciles de comprimir.
Una medida útil debe conservar la trazabilidad entre el sistema, el registro y la representación final; de otro modo, una diferencia en complejidad puede reflejar únicamente una decisión de codificación.
Los modelos estadísticos permiten tolerar variación sin registrar cada excepción de manera determinista, pero deben evaluarse tanto por su ajuste como por el costo y la estructura de sus supuestos.
La complejidad efectiva invita a examinar esa separación, pero no elimina el trabajo científico de decidir qué modelos representan mecanismos plausibles y qué predicciones permiten contrastarlos.
226.9. Relaciones entre profundidad y estructura
La profundidad lógica y la complejidad efectiva comparten una preocupación por la organización, pero sus unidades y operaciones son distintas. La primera minimiza tiempo bajo restricciones descriptivas; la segunda minimiza costo estructural bajo restricciones de adecuación.
No debemos esperar una relación lineal universal entre ellas. Añadir unos pocos bits a una descripción puede reducir mucho el tiempo, mientras que cambiar una tolerancia de modelo puede alterar la separación entre estructura y residuo.
Ay, Müller y Szkoła demostraron relaciones formales entre ambas nociones bajo parámetros y condiciones específicos. Entre sus resultados, una complejidad efectiva suficientemente elevada implica gran profundidad en el sentido de sus teoremas.
Esa afirmación no autoriza a convertir cualquier indicador aplicado de estructura en una estimación temporal. Las hipótesis, los umbrales y las definiciones exactas sostienen la relación.
Tampoco implica que todos los objetos visualmente organizados sean profundos. Una trama geométrica extensa puede generarse mediante una regla corta y rápida.
El ejemplo periódico de dieciséis bits tiene estructura reconocible y un código compacto, pero nada indica que su generación desde descripciones concisas sea difícil.
Una tabla aleatoria extensa puede tener muchos bits específicos y poca estructura descriptiva bajo un modelo uniforme adecuado. Eso no la vuelve inútil, porque utilidad y organización son propiedades diferentes.
Una clave aleatoria puede ser funcionalmente importante en un sistema aunque su distribución sea sencilla. La complejidad efectiva no mide valor práctico ni relevancia semántica.
Del mismo modo, un objeto profundo no tiene por qué ser adaptativo, vivo o causalmente central, ya que la medida trata de una relación formal entre descripción y cálculo.
En aplicaciones podemos estudiar aproximaciones limitadas, como la longitud de los modelos seleccionados, el tiempo de reconstrucción y la sensibilidad a las tolerancias. Esas cantidades pueden ser informativas si conservamos sus nombres y garantías.
Una afirmación empírica sólida debe explicar qué aspecto de la definición ideal aproxima el procedimiento y qué partes permanecen fuera de alcance.
Por ejemplo, el tiempo de entrenamiento de un modelo no equivale al tiempo mínimo de generación admisible. Puede incluir búsquedas fallidas, repeticiones y decisiones de optimización que otro procedimiento evitaría. El tiempo de reconstrucción desde el modelo entrenado responde a una pregunta distinta y también depende de cuánto contenido quedó almacenado en sus parámetros.
Comparar varias dimensiones puede ser más útil que forzarlas a una escala única. Un mismo registro puede combinar alta entropía residual, un modelo breve y una reconstrucción costosa, o cualquier otra combinación compatible con sus mecanismos.
Se trata de reconocer esas diferencias sin ordenar los sistemas en una jerarquía universal mediante una sola palabra.
226.10. Una interpretación útil sin promesas excesivas
La profundidad lógica plantea la pregunta exigente de cuánto trabajo necesita la producción de un objeto cuando no permitimos esconder demasiada información en su descripción inicial.
La complejidad efectiva pregunta cuánto cuesta describir las regularidades de un objeto una vez que controlamos el tratamiento de sus detalles restantes.
Ambas ideas ayudan a explicar por qué aleatoriedad, compresibilidad y organización no son equivalentes. También muestran que una medida puede ser rigurosa sin ser un instrumento directamente calculable para cualquier dato.
La aplicación empieza por definir el objeto. Después debemos fijar la representación, la máquina o familia de modelos, los recursos y las tolerancias.
Los ejemplos finitos dan resultados verificables dentro de esos límites. Una tabla de programas puede mostrar un intercambio entre longitud y tiempo; un código en dos partes puede mostrar qué regularidades compensan su costo.
Esos resultados no deben presentarse como valores universales si solo exploramos una familia restringida. Su utilidad puede sostenerse sin esa exageración.
También necesitamos separar descripción de causalidad. Un modelo económico puede reproducir observaciones sin identificar el mecanismo que las generó; una reproducción lenta tampoco demuestra una historia física única.
La evaluación causal requiere comparar explicaciones, examinar intervenciones cuando corresponda y analizar qué información se pierde en la representación.
La palabra «efectiva» tampoco significa necesariamente operativa o fácil de calcular. En esta teoría designa una noción específica de contenido regular, con restricciones formales que pueden ser computacionalmente inaccesibles.
Conviene comprobar también la estabilidad de la conclusión ante pequeños cambios de tolerancia. Un resultado que cambia abruptamente puede ser matemáticamente válido, pero necesita una interpretación que explique por qué se eligió precisamente esa tolerancia y qué alternativas quedan excluidas.
Una práctica transparente conserva varias cifras cuando responden a preguntas distintas (costo del modelo, costo residual, tiempo de reconstrucción y error predictivo). Comprimirlas en un índice único puede ocultar el mecanismo de una diferencia.
Los capítulos siguientes abordarán la estructura predictiva. Dejaremos de buscar programas mínimos para un objeto individual y preguntaremos qué información del pasado necesita un modelo para anticipar distribuciones del futuro.
Ese cambio de pregunta permitirá definir estados predictivos y estudiar su memoria. Mantendremos la misma disciplina de especificar qué complejidad se mide, bajo qué condiciones y qué interpretación permite realmente.
Referencias
- Bennett, C. H. (1988). Logical Depth and Physical Complexity. En R. Herken, ed., The Universal Turing Machine: A Half-Century Survey, 227–257. Oxford University Press. Texto del capítulo.
- Gell-Mann, M., y Lloyd, S. (1996). Information Measures, Effective Complexity, and Total Information. Complexity, 2(1), 44–52. Artículo y DOI editorial.
- Ay, N., Müller, M., y Szkoła, A. (2010). Effective Complexity and Its Relation to Logical Depth. IEEE Transactions on Information Theory, 56(9), 4593–4607. DOI: 10.1109/TIT.2010.2053892. Prepublicación de 2008.
- Gács, P., Tromp, J., y Vitányi, P. M. B. (2001). Algorithmic Statistics. IEEE Transactions on Information Theory, 47(6), 2443–2463. DOI: 10.1109/18.945257. Texto de los autores.
- Gács, P., Tromp, J., y Vitányi, P. M. B. (2002). Correction to “Algorithmic statistics”. IEEE Transactions on Information Theory, 48(8), 2427. DOI: 10.1109/TIT.2002.800462.