COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 23. Complejidad algorítmica, computacional y estadística
221.1. Describir un objeto individual
Una secuencia de mil ceros puede describirse escribiendo todos sus símbolos o indicando que se repita el cero mil veces. La segunda opción se apoya en una regularidad. Una secuencia sin regularidades utilizables puede exigir una descripción casi tan larga como ella misma.
La complejidad algorítmica formaliza esta diferencia mediante programas que generan objetos individuales. Su pregunta central es cuántos bits necesita el programa más corto que produce exactamente el objeto y termina.
No necesitamos comenzar asignando una distribución de probabilidades a todas las secuencias posibles. Podemos preguntar por una cadena particular, aunque no sepamos qué mecanismo la produjo.
Esto la distingue de la entropía de Shannon, que se define para una distribución. Dos cadenas igualmente largas pueden pertenecer a una misma distribución uniforme y tener longitudes descriptivas muy distintas.
Por ejemplo, una cadena constante es uno de los resultados posibles de una fuente de bits independientes. Su probabilidad es tan pequeña como la de cualquier otra cadena de la misma longitud y, sin embargo, tiene una regla descriptiva evidente.
Una probabilidad baja no implica, entonces, que la descripción mínima de un resultado individual sea larga. Para conectar probabilidad y complejidad algorítmica necesitamos especificar un modelo y distinguir afirmaciones sobre promedios de afirmaciones sobre objetos concretos.
Los trabajos de Solomonoff, Kolmogorov y Chaitin establecieron diferentes aspectos de esta perspectiva. Aquí usaremos una notación moderna y separaremos las variantes de complejidad que difieren en cómo se delimitan los programas.
El objetivo inmediato es comprender la medida y sus límites interpretativos. La imposibilidad general de calcularla exactamente será el tema central del capítulo siguiente; las herramientas de compresión práctica se estudiarán después como aproximaciones con capacidades concretas.
Describir exige un acuerdo previo, porque una cadena de símbolos solo es un programa si hay un lenguaje y una máquina capaces de interpretarla. El costo de ese acuerdo no puede desaparecer mediante una elección oportunista hecha después de ver los datos.
Por eso empezaremos fijando una máquina de referencia. Después veremos por qué distintas máquinas universales producen cantidades relacionadas, aunque sus valores para objetos pequeños puedan diferir mucho.
221.2. Programas, máquinas y convenciones de longitud
Sea una máquina universal de referencia U que recibe un programa binario y puede producir una cadena binaria finita. La complejidad algorítmica simple se define como
La longitud del programa se mide en bits. El mínimo se toma sobre todos los programas que generan exactamente la cadena, incluidos los que no conocemos o no podemos ejecutar con nuestros recursos actuales.
Que la máquina sea universal significa que puede simular otras máquinas mediante una descripción adecuada. Eso no implica que todo programa termine ni que toda simulación sea rápida.
Siempre existe una descripción literal, formada por la cadena y una instrucción para imprimirla. Con una convención de complejidad simple apropiada, esto da una cota superior igual a la longitud de la cadena más una constante.
Para una cadena finita, la complejidad nunca es infinita cuando la máquina de referencia es universal y dispone de esa capacidad, aunque pueda ser difícil de conocer.
Otra variante exige que los programas válidos formen un conjunto libre de prefijos (ningún programa válido es prefijo de otro). Esa propiedad permite reconocer dónde termina cada descripción sin depender de un marcador externo.
La complejidad correspondiente suele escribirse con K y llamarse complejidad de prefijo. En ese contexto, describir literalmente una cadena requiere también resolver su delimitación. Una cota habitual incluye su longitud y la complejidad de describir esa longitud.
No debemos mezclar fórmulas exactas de C y K como si fueran la misma cantidad. Ambas expresan longitud descriptiva algorítmica, pero los términos de delimitación intervienen en identidades, cotas y resultados sobre secuencias infinitas.
En este capítulo usaremos C para argumentos de complejidad simple y mencionaremos K cuando la propiedad de prefijo sea relevante. La expresión informal «complejidad de Kolmogorov» puede referirse a distintas convenciones; un texto técnico debe declarar la suya.
Como salida pedimos la cadena exacta y la terminación. Un programa que imprime la cadena correcta y continúa indefinidamente con otros símbolos responde a otra tarea y no cumple esta definición.
La entrada auxiliar, si existe, debe declararse por separado. Un programa que recupera un archivo desde una base de datos ya disponible puede ser corto porque parte de la información estaba fuera del programa. Ese caso corresponde a la complejidad condicional; la información total no se reduce gratuitamente.
221.3. Un lenguaje pequeño para medir descripciones concretas
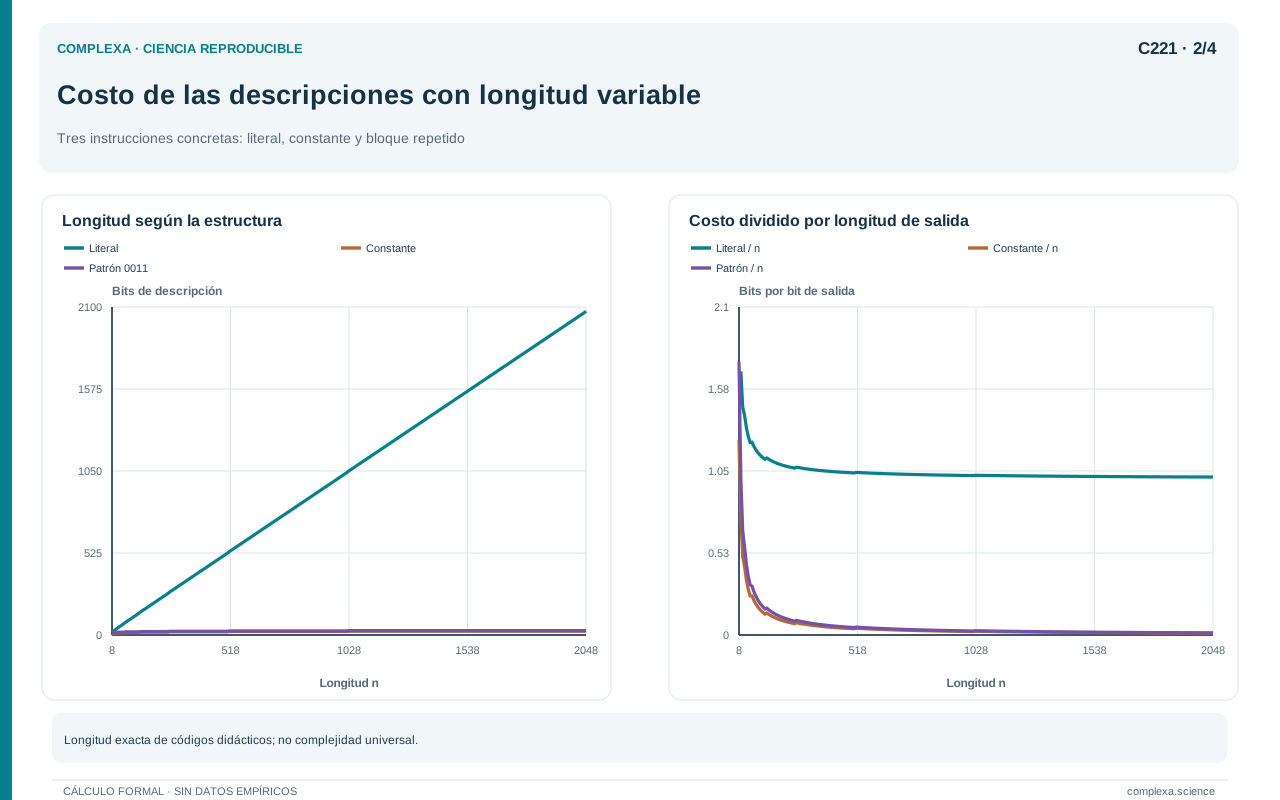
Antes de buscar programas mínimos universales, construyamos un formato limitado y completamente especificado. Nos permitirá demostrar ahorros reales sin afirmar que hemos encontrado la mejor descripción imaginable.
Necesitamos representar enteros positivos. Para un entero n, escribimos primero tantos ceros como bits adicionales tiene su representación binaria respecto del primero y después la representación binaria completa.
Por ejemplo, el código del uno es un solo uno. El dos, cuya representación binaria tiene dos posiciones, recibe un cero seguido de uno cero. El cuatro recibe dos ceros seguidos de uno cero cero.
El lector cuenta los ceros iniciales y sabe cuántos bits debe leer después. La longitud de este código entero es
Usaremos tres instrucciones, cada una identificada por una etiqueta de dos bits. La primera almacena una cadena literal mediante la etiqueta, la longitud codificada y todos los símbolos de la cadena.
La segunda almacena una constante (etiqueta, bit que se repite y longitud codificada). La tercera almacena una repetición de bloque (etiqueta, longitud del bloque, número de repeticiones y bloque literal).
La cuarta etiqueta posible queda reservada. El formato solo admite tres familias de descripciones que un decodificador fijo puede interpretar.
Para una cadena de longitud n, el formato literal usa dos bits de etiqueta, el código de n y los n bits de contenido. Para una constante usa tres bits más el código de n.
Para un bloque de longitud m repetido k veces, usa dos bits, los códigos de ambos enteros y los m bits del bloque. La longitud final reconstruida es el producto de m por k.
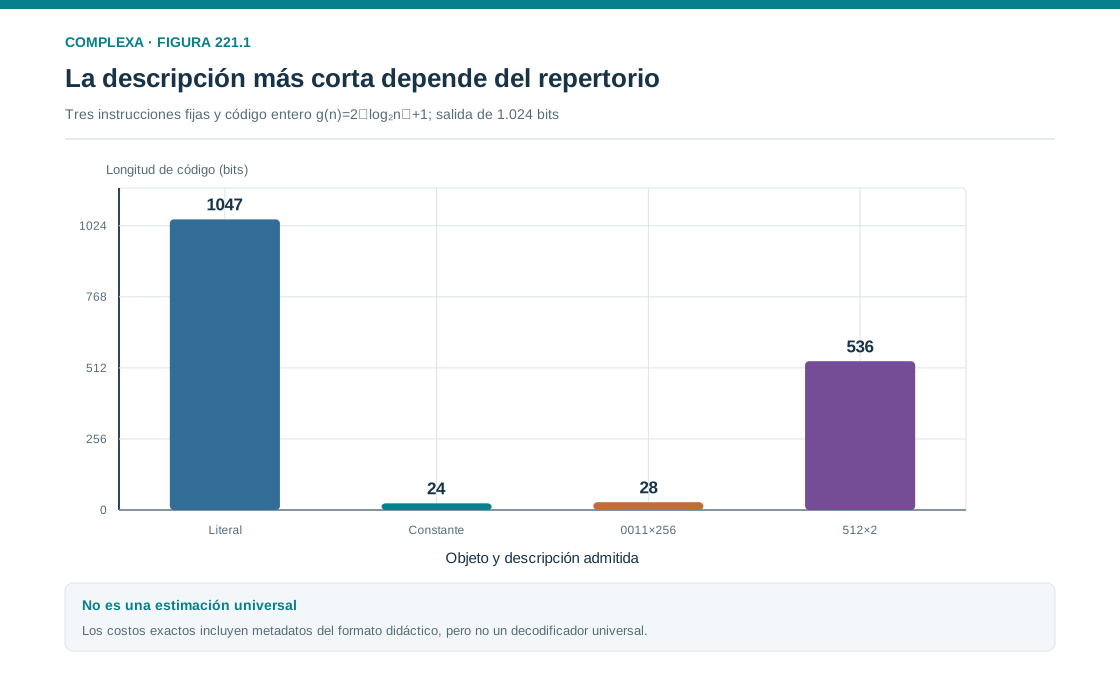
Con mil veinticuatro símbolos, el código entero de la longitud ocupa veintiún bits. La descripción literal ocupa mil cuarenta y siete bits, mientras que una constante de esa longitud requiere veinticuatro.
El patrón cero cero uno uno repetido doscientas cincuenta y seis veces ocupa veintiocho bits (dos de etiqueta, cinco para la longitud del bloque, diecisiete para el número de repeticiones y cuatro de contenido).
Si tomamos un bloque arbitrario de quinientos doce bits y lo duplicamos, la instrucción de repetición necesita quinientos treinta y seis bits. El ahorro existe aunque no encontremos regularidad dentro del bloque original.
Estas cifras son longitudes exactas del formato definido, que una máquina universal debe interpretar mediante un programa decodificador de longitud fija. Por tanto, cada resultado es solo una cota superior, pues la complejidad de Kolmogorov del objeto no supera la longitud de esta descripción más el costo fijo de interpretación, bajo una traducción adecuada.
El ejemplo muestra además el peso de los metadatos. Una cadena corta puede crecer al comprimirla porque la etiqueta y la longitud ocupan más bits de los que ahorra la regularidad. Al evaluar un archivo concreto, esos bits deben contarse.
La descripción de una constante también muestra que la longitud de salida puede contener información. Para generar n ceros necesitamos especificar n de alguna manera; al recibir esos ceros, podemos recuperar n contándolos. Así, la complejidad de la constante y la del entero que indica su longitud difieren a lo sumo en una cantidad fija.
No todas las longitudes tienen la misma dificultad descriptiva. Un entero expresable mediante una potencia sencilla puede describirse con menos bits que su expansión binaria literal. Nuestro formato usa una codificación particular de enteros y no intenta explotar todas esas regularidades aritméticas.
221.4. El lenguaje de referencia y el teorema de invariancia
Podríamos diseñar un lenguaje con una instrucción especial que significara imprimir exactamente una cadena elegida. En ese lenguaje, la cadena tendría una descripción muy corta.
Si escogemos el lenguaje después de conocer la cadena y no contamos el costo de describir esa elección, cualquier objeto puede parecer sencillo. La información se ha trasladado al intérprete.
El teorema de invariancia controla este problema entre máquinas universales óptimas fijadas de antemano. Para dos referencias de ese tipo, sus complejidades difieren como máximo en una constante que depende de las máquinas, pero es la misma para todas las cadenas.
La razón es la existencia de un simulador. Una máquina puede ejecutar programas de la otra si anteponemos una descripción fija de cómo interpretarlos. Ese costo se paga una vez y no crece con el objeto particular.
En una dirección obtenemos
Si ambas referencias son óptimas, existe también una desigualdad en la otra dirección, de modo que la diferencia queda acotada por constantes de traducción.
Esto justifica resultados asintóticos que no dependen de un lenguaje particular. Si estudiamos familias de cadenas cada vez más largas, una diferencia constante puede volverse pequeña en comparación con su longitud.
Sin embargo, el teorema no afirma que la constante sea pequeña para todas las parejas de máquinas. Tampoco garantiza que las clasificaciones de objetos cortos sean idénticas.
Un lenguaje especializado puede contener una biblioteca extensa de objetos o procedimientos. Si esa biblioteca es parte fija de la referencia, ciertos objetos tendrán descripciones cortas. Compararlos con objetos evaluados bajo otra biblioteca exige reconocer el cambio.
En aplicaciones, el acuerdo de representación incluye versiones de decodificadores, diccionarios, modelos y formatos. Un archivo comprimido puede depender de información compartida que no está contenida en sus propios bytes.
La distinción entre costo fijo y costo variable depende de la pregunta. Si enviamos un solo objeto a alguien sin el decodificador, necesitamos transmitirlo o establecerlo. Si enviamos millones de objetos mediante un formato ya acordado, su costo puede amortizarse.
La invariancia da una estabilidad teórica precisa, pero no permite ignorar las convenciones; en comparaciones pequeñas y operacionales, las longitudes concretas y los recursos compartidos siguen siendo esenciales.
Una transformación computable fija da otra cota útil. Si tenemos un programa para una cadena, podemos añadir un procedimiento fijo que transforme su salida. La complejidad del objeto transformado no supera la original más el costo de ese procedimiento.
Si la transformación es invertible y su inversa también es computable de manera fija, obtenemos cotas en ambas direcciones. Cambiar reversiblemente una representación no crea una cantidad ilimitada de información algorítmica.
En cambio, permitir que la transformación contenga datos nuevos específicos de cada objeto cambia la contabilidad. Debemos describir esos datos o incluirlos explícitamente como condición. La palabra «transformación» no justifica esconder información en una regla elegida para un caso particular.
221.5. Por qué abundan las cadenas incomprimibles
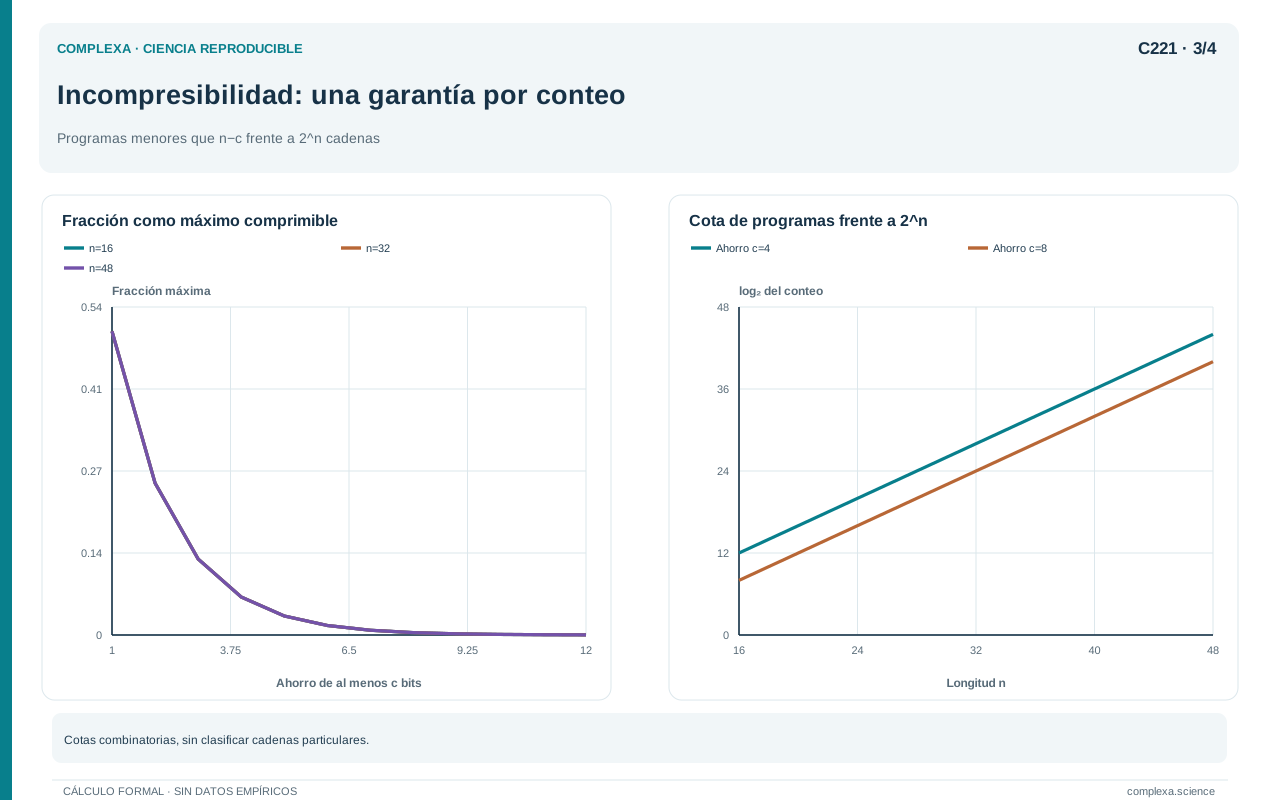
Existen muchas más cadenas largas que programas cortos. Esta observación combinatoria permite demostrar que la mayoría de las cadenas no admiten un ahorro grande respecto de su descripción literal.
Consideremos todas las cadenas binarias de longitud n. Hay dos elevado a n posibilidades. El número de programas de longitud menor que un umbral m es
La suma incluye el programa vacío como una posibilidad de longitud cero. Cada programa que termina produce como máximo una cadena de salida.
Algunos programas no terminan y otros producen la misma cadena. Por tanto, el número de cadenas que pueden describirse con menos de m bits no puede superar el número de esos programas.
Si exigimos un ahorro superior a c bits, mediante la condición estricta de complejidad menor que n menos c, obtenemos
La fracción correspondiente es menor que dos elevado a menos c. Para una referencia fija, solo una pequeña parte de las cadenas puede tener una descripción mucho más corta que su longitud.
Con cadenas de dieciséis bits y un umbral de complejidad menor que doce, existen como máximo 4.095 cadenas que cumplen la condición, entre 65.536 posibles. La fracción es inferior a un dieciseisavo.
La afirmación es una cota. No identifica exactamente cuáles son esas cadenas ni garantiza que cada programa corto produzca una salida diferente de dieciséis bits.
Con un ahorro de veinte bits, la fracción correspondiente es menor que uno entre aproximadamente un millón. El argumento no requiere suponer que las cadenas se originaron mediante un mecanismo físico aleatorio.
Si elegimos una cadena uniformemente entre todas las de una longitud dada, el conteo se convierte en una afirmación probabilística; es muy probable que esa cadena no tenga una descripción mucho más corta.
Aun así, probar que abundan las cadenas incomprimibles no da un algoritmo general que certifique la incomprimibilidad de cualquier cadena concreta. Esa diferencia entre existencia y procedimiento será central en el capítulo siguiente.
La aleatoriedad algorítmica finita se formula con un margen de compresibilidad respecto de una referencia. No es una etiqueta independiente de toda convención ni una afirmación sobre cómo se generó físicamente el objeto.
Una cadena producida por azar puede resultar excepcionalmente simple. Una cadena producida por un procedimiento determinista puede parecer irregular para muchas pruebas. La longitud mínima de descripción y la historia causal de producción son preguntas relacionadas, pero distintas.
221.6. Descripciones que utilizan información auxiliar
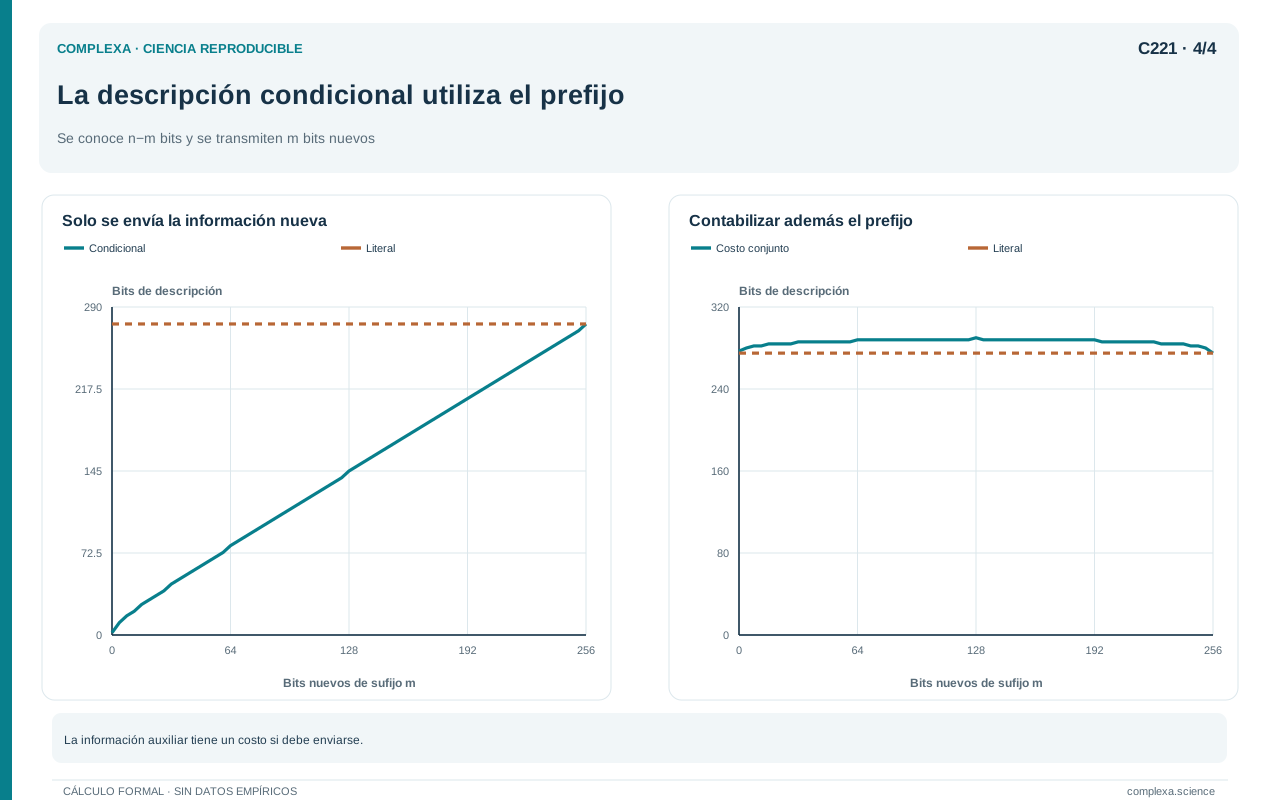
La complejidad condicional pregunta cuántos bits adicionales necesitamos para describir una cadena cuando otra información ya está disponible para la máquina. Se define como
Si la entrada auxiliar contiene exactamente la cadena que queremos producir, basta una instrucción fija para copiarla. Su complejidad condicional queda acotada por una constante, aunque la complejidad sin esa información pueda ser grande.
Esto no destruye información, porque la cadena ya estaba en la condición; la medida cuantifica lo que falta por describir después de disponer de ella.
Un ejemplo es actualizar un documento. Si el receptor tiene la versión anterior, puede bastar una lista de cambios. Si no la tiene, esa lista puede ser insuficiente para reconstruir la nueva versión.
Otro ejemplo es una cadena formada por dos copias de un bloque. Si el bloque original es conocido, describir la duplicación requiere una regla breve. Si es desconocido, debemos transmitirlo o generarlo mediante otra descripción.
La duplicación no duplica necesariamente la complejidad algorítmica. Un programa que genera el bloque puede conservarlo y producirlo dos veces con un costo fijo adicional, sin importar cuánto tiempo requiera la generación.
A la inversa, de una duplicación exacta podemos recuperar el bloque tomando la primera mitad. Así, ambas complejidades difieren a lo sumo en constantes de traducción para la operación definida.
La información auxiliar puede ser un modelo, un diccionario, una longitud o una convención de codificación. Debe indicarse con precisión, porque diferentes condiciones cambian qué se considera novedoso.
Conocer solo la longitud de una cadena elimina el costo de delimitarla, aunque la mayoría de las cadenas de esa longitud todavía necesita una descripción larga.
En cambio, conocer un programa generador y sus parámetros puede volver muy corta la descripción adicional de una secuencia extensa. La información nueva que contiene la salida respecto de ese conocimiento puede ser mucho menor que su longitud física.
La complejidad condicional no equivale a la entropía condicional. La primera trata de objetos y programas; la segunda, de una distribución y un promedio de incertidumbre. Hay relaciones teóricas entre ambas, pero solo bajo condiciones especificadas.
221.7. Relación con la información de Shannon
La teoría de Shannon estudia, entre otras cosas, longitudes promedio de códigos para distribuciones de mensajes. La teoría algorítmica estudia la descripción de mensajes individuales mediante procedimientos generales.
Si conocemos una distribución computable, podemos diseñar códigos que favorezcan sus resultados probables. Un programa puede implementar ese código y producir un mensaje a partir de su descripción codificada.
La complejidad algorítmica de un objeto queda entonces acotada por el costo de describir el modelo y el costo de identificar el objeto dentro de ese modelo, más los términos de interpretación y delimitación pertinentes.
Esta idea conecta regularidad estadística y compresión. Un modelo sencillo que asigna alta probabilidad a los datos puede dar una descripción breve, mientras que un modelo extremadamente complejo puede anular el ahorro logrado en la parte de datos.
La comparación debe incluir ambos costos. Un modelo que contiene una copia completa del objeto y después lo identifica con una etiqueta mínima no es una compresión gratuita.
Consideremos la distribución uniforme sobre cadenas de longitud n. Su entropía es n bits. El argumento de conteo muestra que la mayoría de sus resultados tiene complejidad simple cercana a n, mientras que algunas excepciones, como las constantes, tienen descripciones mucho más cortas.
La coincidencia típica no significa igualdad exacta entre complejidad de cada resultado y entropía. La entropía pertenece al conjunto probabilístico; la complejidad puede variar entre sus miembros.
Para una fuente sesgada, una descripción basada en el número de unos y en la posición de la cadena dentro del conjunto de secuencias con ese conteo puede ser más corta que almacenar literalmente todos los bits de una cadena típica.
Conocer el conteo, sin embargo, no determina el orden. El número de cadenas compatibles es un coeficiente binomial; especificar cuál ocurrió todavía requiere información cuando no hay una regularidad adicional.
Con dieciséis posiciones y exactamente ocho unos, existen 12.870 cadenas compatibles. Si esa longitud y ese conteo ya son conocidos, un índice de catorce bits basta para identificar cualquiera de ellas mediante una enumeración acordada.
Si el receptor desconoce la longitud y el conteo, debemos transmitirlos o incorporarlos al modelo compartido. Parte del ahorro condicionado puede desaparecer, entonces, cuando hacemos explícita toda la descripción.
Las secuencias del capítulo anterior ilustran otra diferencia. Una fuente independiente tiene poca memoria predictiva y, típicamente, descripciones individuales largas. Una secuencia periódica puede tener memoria de fase y una regla descriptiva corta.
En consecuencia, mucha incertidumbre estadística nueva puede coexistir con mucha complejidad algorítmica típica, pero ninguna de ellas equivale automáticamente a organización funcional. Un ruido sin estructura puede ser difícil de describir de forma exacta.
Modelos, longitud y datos volverán a aparecer juntos al estudiar complejidad efectiva y selección de modelos. Por ahora basta llevar la cuenta de la descripción del mecanismo propuesto, de sus parámetros y del residuo que todavía debe especificarse.
221.8. Un programa corto puede tardar mucho
La definición de complejidad algorítmica mide longitud e ignora el tiempo de ejecución. Un programa pequeño puede hacer una búsqueda enorme antes de producir la cadena solicitada.
Podemos describir una salida mediante una regla que enumere candidatos y se detenga cuando encuentre uno con determinada propiedad decidible. Si esa búsqueda termina, la descripción es válida aunque sea impracticable. Por eso una descripción breve no garantiza una predicción rápida ni una simulación eficiente.
También existe la situación contraria. Una cadena extensa almacenada literalmente puede imprimirse con un procedimiento sencillo y rápido respecto de su tamaño, aunque no admita una descripción mucho más corta.
La complejidad de cálculo estudia recursos como tiempo y memoria en función del tamaño de una entrada. La complejidad algorítmica estudia la longitud mínima de una descripción de una salida individual.
Confundirlas produce afirmaciones equivocadas, como concluir que todo objeto incomprimible requiere un cálculo largo. Si el objeto está dado literalmente como entrada, copiarlo no exige descubrir una regla oculta.
Un generador pseudoaleatorio es un buen ejemplo. Si su algoritmo es fijo, su salida queda determinada por la semilla y por cuántos símbolos pedimos. Esos dos datos forman una descripción, a la que hay que sumar el costo de codificarlos adecuadamente.
La salida puede superar pruebas estadísticas de aleatoriedad y seguir teniendo una descripción breve respecto de su longitud. No necesitamos afirmar que toda semilla produce una cadena simple en términos absolutos; el punto es la cota que da el generador.
Si mantenemos fija una semilla y hacemos crecer la longitud solicitada, el costo adicional de describir esa longitud puede crecer lentamente, mientras que la salida crece de manera lineal.
Esta observación no invalida la utilidad de los generadores ni demuestra una debilidad práctica de cualquier construcción criptográfica. La posibilidad de una descripción corta y la capacidad de un observador limitado para predecir o recuperar sus parámetros son problemas diferentes.
Las nociones que combinan longitud y tiempo, como la profundidad lógica, intentan captar aspectos adicionales de organización y producción. Su interpretación exige otra definición; no están contenidas automáticamente en el valor de C.
221.9. Qué demuestra un compresor concreto
Un compresor sin pérdida produce una descripción que su descompresor puede invertir exactamente. Si una cadena se comprime mucho, hemos encontrado una regularidad utilizable por ese procedimiento.
La longitud comprimida, junto con el costo fijo del descompresor y las convenciones necesarias, da una cota superior de su complejidad algorítmica. No demuestra que esa sea la descripción mínima.
Si un compresor no logra reducir la cadena, tampoco demuestra que no exista una regla breve. Puede no reconocer el tipo de regularidad presente.
Un procedimiento orientado a repeticiones locales puede fallar ante una secuencia generada por una fórmula aritmética sencilla. Otro puede usar un diccionario especializado que el primero no tiene.
La comparación entre compresores debe controlar formatos, cabeceras, tamaños y datos auxiliares. Para objetos pequeños, esos costos pueden dominar el resultado.
El lenguaje de tres instrucciones que construimos es un ejemplo transparente. Reconoce constantes y repeticiones exactas de bloques, pero no contiene una instrucción general para producir cualquier secuencia calculable. Por ello, su fallo ante una cadena solo significa que ninguna de las descripciones ensayadas resultó ventajosa.
La compresión con pérdida responde a otra pregunta. Si permitimos reconstrucciones aproximadas, necesitamos especificar qué diferencias se toleran. Una descripción breve de una aproximación no es una descripción exacta del objeto original.
Tampoco hay que confundir tamaño en caracteres y tamaño en bits. Un símbolo de texto puede ocupar varios bytes; una expresión matemática breve puede depender de una biblioteca o de un lenguaje de interpretación considerable.
Un experimento de compresibilidad puede ser científicamente útil si declara el procedimiento y su alcance. Podemos comparar cómo cambia la longitud comprimida bajo transformaciones, condiciones o escalas, sin presentarla como un valor exacto de complejidad universal.
También debemos comprobar la reconstrucción. Una salida breve que no recupera todos los símbolos no es una compresión sin pérdida, aunque su nombre de archivo sugiera lo contrario. El par formado por codificador y decodificador define la evidencia operacional; ambos deben coincidir sobre el objeto que se pretende describir.
Las aproximaciones de Lempel–Ziv desarrollarán esta perspectiva para secuencias. Sus resultados teóricos valen bajo condiciones específicas sobre fuentes y longitudes crecientes; sus implementaciones finitas requieren una evaluación propia.
221.10. Alcance de una medida descriptiva
En la complejidad algorítmica, una cadena es descriptivamente sencilla cuando existe un programa corto que la produce. La fuerza de esta medida proviene de admitir cualquier procedimiento computable dentro de una referencia universal.
Esa generalidad también impone límites. La medida no trae consigo un algoritmo eficiente para encontrar la mejor descripción ni garantiza que una descripción corta sea una explicación causal correcta.
Un programa puede reproducir observaciones mediante una tabla, una simulación o una regla matemática sin identificar el mecanismo físico que las generó. La adecuación explicativa requiere contrastar consecuencias y supuestos.
La medida tampoco evalúa significado, utilidad o importancia. Un mensaje decisivo puede ser corto y una cadena de ruido irrelevante puede tener una descripción mínima larga.
Esto afecta el uso de la palabra «complejidad» en un informe. Si una intervención reduce la longitud comprimida de una serie, todavía falta explicar qué propiedad cambió. Tal vez aparecieron repeticiones, disminuyó el alfabeto registrado o se alteró la resolución de medida. Esas posibilidades no equivalen a una pérdida de capacidad adaptativa del sistema observado. Una interpretación defendible relaciona la medida con el mecanismo del registro y con una hipótesis contrastable. El nombre matemático de la medida no sustituye ese trabajo conceptual, aunque dé una forma precisa de formularlo.
Para hablar de organización necesitamos a menudo separar regularidades del residuo aleatorio. Dos objetos pueden tener una longitud descriptiva total semejante y distribuirla de maneras diferentes entre estructura y detalles.
Los ejemplos de repetición, duplicación e información auxiliar muestran cómo una descripción puede reducirse. El conteo muestra por qué esos ahorros grandes no están disponibles para la mayoría de las cadenas de una longitud dada.
El teorema de invariancia explica qué estabilidad podemos esperar entre referencias universales, mientras que la distinción entre complejidad simple y de prefijo recuerda que los términos de delimitación deben contarse.
En términos operacionales, una descripción encontrada demuestra una cota superior; la ausencia de compresión en un procedimiento limitado, en cambio, no demuestra minimalidad. Mantener esa diferencia permitirá abordar los límites de computación sin convertir una herramienta práctica en una afirmación que no puede sostener.
Referencias
- Kolmogorov, A. N. (1965). Three approaches to the definition of the concept “quantity of information”. Problemy Peredachi Informatsii, 1(1), 3–11, publicación original rusa. Registro original. Versión inglesa reimpresa en 1968 como Three approaches to the quantitative definition of information, International Journal of Computer Mathematics, 2, 157–168. DOI: 10.1080/00207166808803030.
- Solomonoff, R. J. (1964). A Formal Theory of Inductive Inference. Part I. Information and Control, 7(1), 1–22. DOI: 10.1016/S0019-9958(64)90223-2.
- Chaitin, G. J. (1966). On the Length of Programs for Computing Finite Binary Sequences. Journal of the ACM, 13(4), 547–569. DOI: 10.1145/321356.321363.
- Chaitin, G. J. (1975). A Theory of Program Size Formally Identical to Information Theory. Journal of the ACM, 22(3), 329–340. DOI: 10.1145/321892.321894.