Módulo 23. Complejidad algorítmica, computacional y estadística
223.1. Reconocer repeticiones sin buscar todos los programas
La imposibilidad de calcular una descripción mínima universal no impide construir procedimientos de compresión. Una estrategia muy productiva consiste en reutilizar fragmentos que ya aparecieron en la secuencia.
Si el receptor conserva lo que ha reconstruido, el emisor puede indicarle que copie un fragmento anterior sin transmitirlo otra vez. El ahorro depende de la longitud de la coincidencia y del costo de señalar dónde empieza y cuánto dura.
Lempel y Ziv desarrollaron medidas y algoritmos basados en esta idea durante la década de 1970. Sus trabajos conectaron reglas concretas de procesamiento con resultados sobre compresión y fuentes de información.
Sin embargo, la expresión «complejidad de Lempel–Ziv» no identifica una única operación. Puede designar una partición de la secuencia en frases, una normalización de su número o la longitud producida por un compresor emparentado.
Esas cantidades deben distinguirse. Un número de frases no es una cantidad de bits hasta que se especifica cómo se codifican las referencias, los símbolos nuevos y las terminaciones.
También debemos separar tres desarrollos históricos. El trabajo de 1976 introduce una medida de complejidad de secuencias finitas; el algoritmo de 1977 usa referencias a fragmentos previos y el de 1978 construye una estructura incremental de frases.
Las implementaciones posteriores pueden añadir ventanas, diccionarios limitados, códigos de longitud variable y otras decisiones. Compartir una familia de ideas no hace idénticos sus resultados.
Nuestro objetivo será comprender qué regularidad detectan estos procedimientos y qué significa una cifra obtenida con ellos. Usaremos ejemplos pequeños que permitan verificar cada paso y discutiremos después las condiciones necesarias para interpretar registros largos.
La pregunta operacional será cuánta novedad encuentra una regla concreta al recorrer una secuencia. Cuántos bits necesita cualquier programa imaginable para generarla es otra pregunta.
Una cadena puede contener una regularidad matemática breve que un algoritmo de repetición no explote. En ese caso, una puntuación alta no demuestra que falte una descripción corta.
En sentido contrario, una compresión importante es evidencia directa de redundancia utilizable. Si conservamos el decodificador y recuperamos exactamente el original, el ahorro no depende de una apreciación visual.
Esa combinación de reglas transparentes, capacidad de reconstrucción y resultados teóricos explica la utilidad de la familia. Para usarla con rigor científico necesitamos mantener visibles las convenciones que transforman la secuencia en una puntuación.
223.2. Frases nuevas y copia recursiva en LZ76
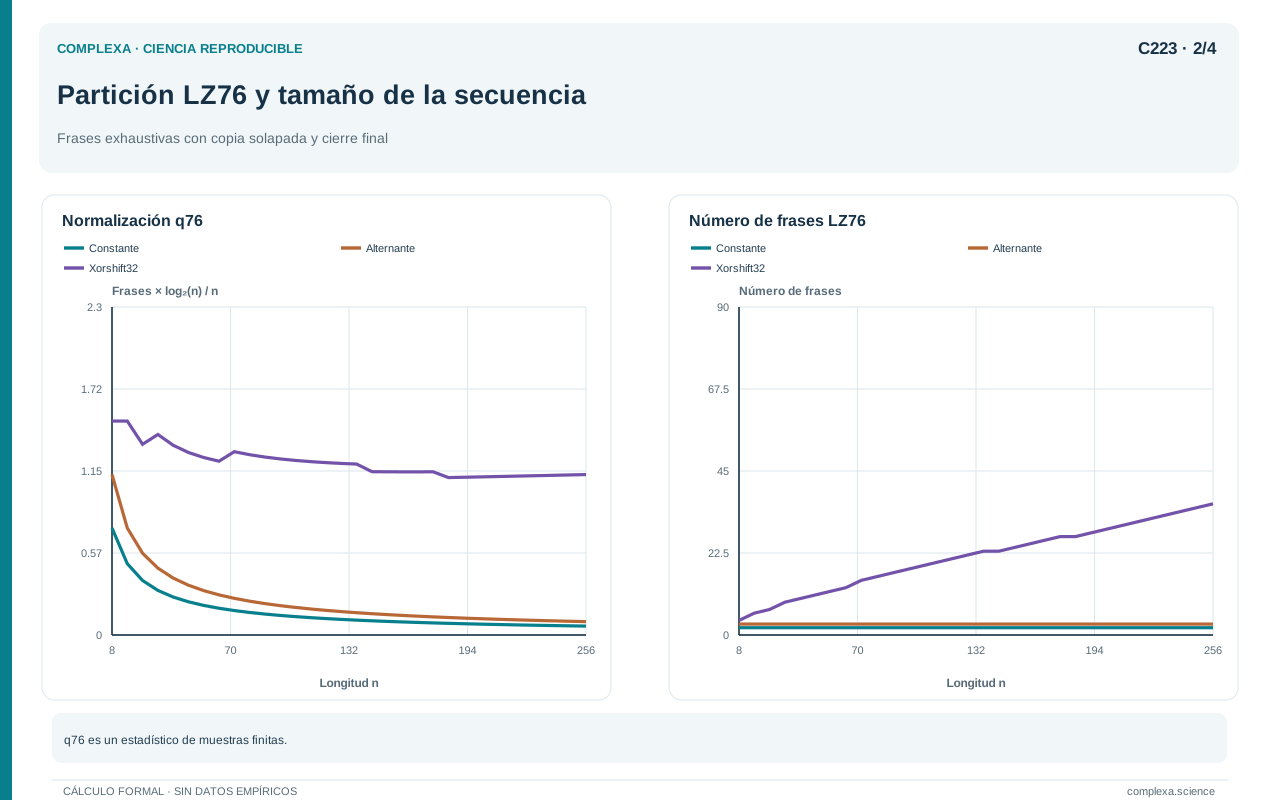
Una forma de construir la partición exhaustiva de LZ76 recorre la cadena desde la izquierda. En cada posición buscamos el fragmento más corto que todavía no pueda reproducirse a partir de una coincidencia iniciada antes de esa posición.
La copia puede solaparse con lo que se está produciendo, un detalle esencial porque los símbolos recién copiados pueden servir para continuar la misma reproducción.
Para expresarlo sin ambigüedad, consideremos una frase candidata que empieza en i y termina en j. Preguntamos si aparece como subcadena en el prefijo que termina en j menos uno. Como la longitud es la misma, cualquier coincidencia comienza antes de i.
Mientras la respuesta sea afirmativa, extendemos la candidata. La primera extensión que deja de aparecer cierra una frase nueva. Si llegamos al final sin encontrar novedad, conservamos el fragmento restante como última frase.
Esa excepción terminal debe declararse porque afecta a las secuencias cortas. No todas las frases contabilizadas tienen que ser nuevas, pues el último residuo puede ser reproducible.
Tomemos ocho ceros. El primer cero forma una frase porque no hay historia previa. Los siete restantes pueden copiarse mediante solapamiento, ya que el cero disponible permite producir otro y ambos permiten continuar.
Con esta convención, la partición es un cero seguido de una frase de siete ceros, es decir, dos frases. Un algoritmo que prohíba el solapamiento puede producir una partición distinta.
Para la cadena alternante de ocho símbolos, la partición es cero, uno y el bloque final de seis símbolos alternantes. El último fragmento se reproduce prolongando el patrón ya disponible.
Consideremos ahora la cadena 01001101. Su partición es 0, 1, 00, 11 y 01. Las cuatro primeras frases se cierran por novedad y la última es el residuo terminal.
Estos ejemplos muestran por qué no basta contar símbolos distintos ni buscar palabras completas en un diccionario de frases. La búsqueda de LZ76 considera subcadenas y permite la reproducción recursiva descrita.
Llamaremos c76 al número de frases obtenido con esta convención. Reservaremos C para la complejidad algorítmica universal de capítulos anteriores, para que una misma letra no sugiera una identidad inexistente.
La implementación puede optimizarse mediante estructuras de búsqueda, pero la optimización debe conservar la definición. Dos programas que discrepan en los ejemplos mínimos necesitan revisar sus convenciones antes de comparar registros extensos.
Para una comprobación inicial podemos usar búsquedas directas de subcadenas, aunque resulten lentas. Esa implementación transparente permite contrastar una versión optimizada con todas las cadenas binarias de longitudes pequeñas. La coincidencia en esos casos no demuestra corrección para cualquier longitud, pero detecta errores frecuentes de índices, solapamiento y cierre terminal. La demostración del algoritmo y la verificación de su implementación cumplen funciones complementarias.
223.3. Un ejemplo de diccionario incremental en LZ78
LZ78 usa otra construcción. Comenzamos con un diccionario que contiene la cadena vacía con índice cero. Desde la posición actual buscamos la frase más larga ya presente en ese diccionario.
Si queda un símbolo después de ella, emitimos el índice de la frase y el símbolo siguiente. La concatenación se incorpora como una nueva entrada y el recorrido continúa desde la posición posterior.
El receptor puede reconstruir el mismo diccionario porque recibe exactamente la información necesaria para agregar cada entrada, de modo que no hace falta transmitir la tabla por separado.
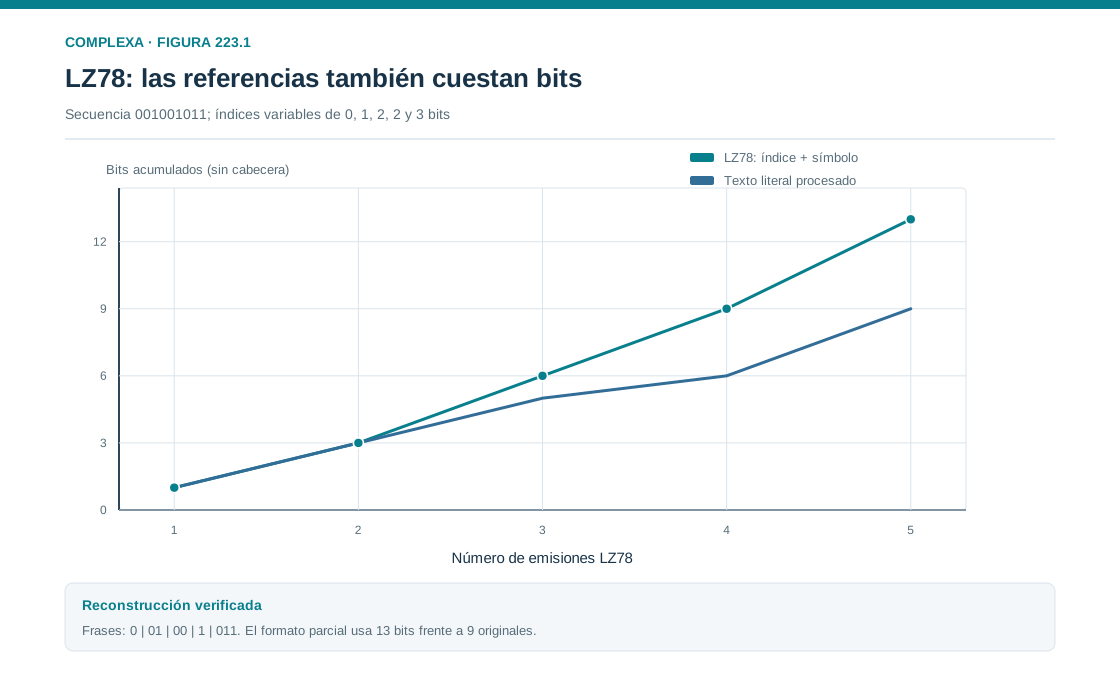
Usemos la secuencia 001001011, de nueve símbolos. Su recorrido genera las frases 0, 01, 00, 1 y 011, cuya concatenación recupera el original.
La primera emisión contiene el índice cero y el símbolo cero. Se crea la entrada uno, correspondiente a la frase 0. La segunda emisión usa esa entrada y añade un uno, con lo que se crea 01.
En la tercera emisión volvemos a la entrada uno y añadimos cero, por lo que aparece 00. La cuarta usa la cadena vacía y añade uno. La quinta toma la entrada correspondiente a 01 y añade otro uno.
| Paso | Índice previo | Símbolo añadido | Entrada nueva |
|---|---|---|---|
| 1 | 0 | 0 | 0 |
| 2 | 1 | 1 | 01 |
| 3 | 1 | 0 | 00 |
| 4 | 0 | 1 | 1 |
| 5 | 2 | 1 | 011 |
Los índices de la tabla numeran entradas del diccionario, mientras que una referencia directa a una ventana anterior señala posiciones del texto original.
Si el final de la secuencia coincide exactamente con una frase ya conocida, necesitamos una convención terminal. Podemos emitir una referencia marcada como final o usar otra regla inequívoca. Su costo pertenece al formato.
Este ejemplo no garantiza que los nueve bits se compriman, porque las referencias, las marcas y las longitudes pueden ocupar más que el original. El objetivo es verificar la reconstrucción y entender cómo se aprende un repertorio de frases.
El número de entradas crece conforme aparecen combinaciones nuevas. Para transmitir índices cada vez mayores necesitamos más bits o una codificación variable adecuada.
Por eso una comparación basada solo en el número de frases omite parte del costo. Cinco referencias largas pueden costar más que seis referencias cortas.
Tampoco debemos llamar LZ76 a esta partición. En la misma secuencia, la convención anterior produce 0, 01, 00101 y 1, es decir, cuatro frases frente a las cinco del diccionario incremental.
Ambas operaciones son reproducibles, pero responden a reglas diferentes.
223.4. De una referencia a una longitud comprimida
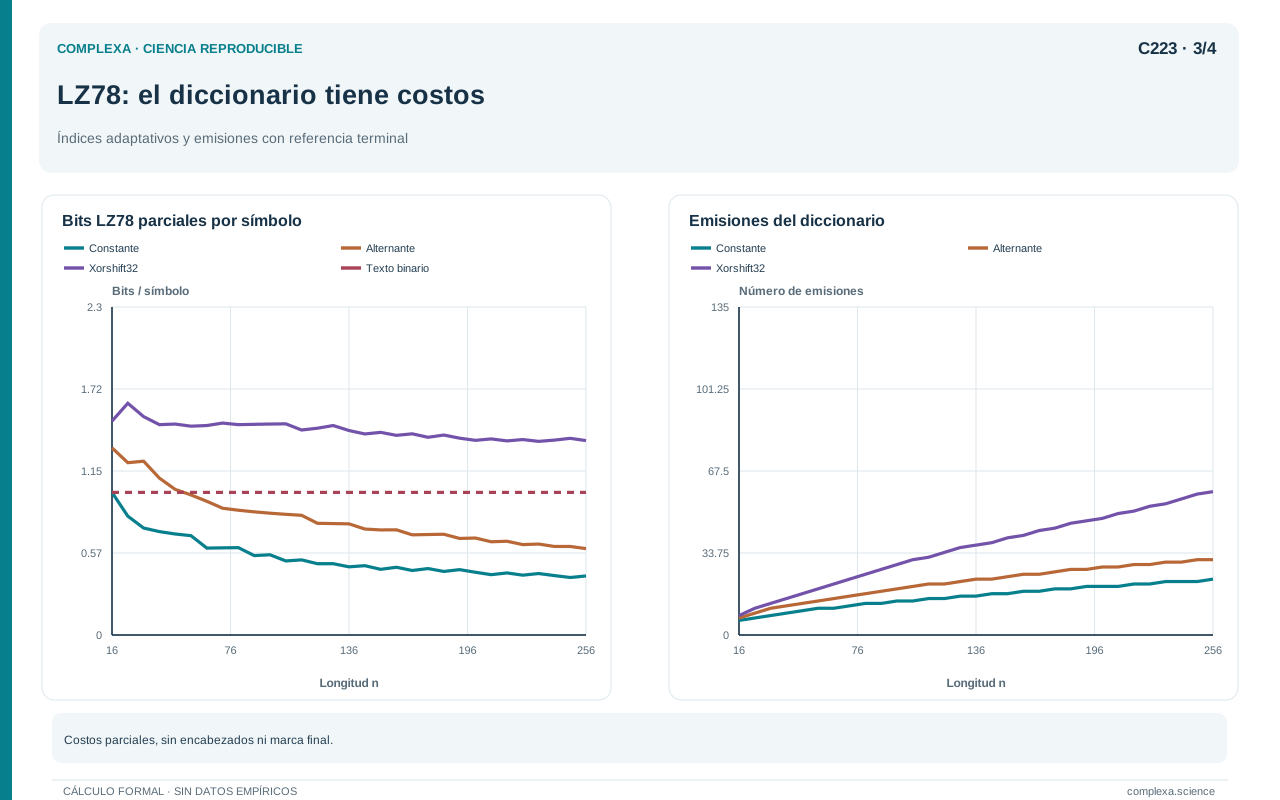
Una referencia necesita convertirse en bits para formar un código. Si un diccionario tiene cierto número de entradas disponibles, un índice de longitud fija debe disponer de suficientes combinaciones para distinguirlas.
Podemos usar la cantidad mínima de bits que cubra ese número de entradas, pero el decodificador debe saber cuándo cambia la longitud del índice. Una regla compartida puede resolverlo sin transmitir cada cambio explícitamente.
También necesitamos codificar los símbolos del alfabeto, distinguir emisiones especiales y señalar dónde termina el mensaje. En archivos reales hay además cabeceras, comprobaciones de integridad y metadatos.
Podemos calcular un costo parcial del ejemplo de nueve símbolos. Antes de las cinco emisiones, el diccionario tiene respectivamente una, dos, tres, cuatro y cinco entradas. Si usamos índices de longitud fija adaptada a cada tamaño, requieren cero, uno, dos, dos y tres bits; el primer índice no requiere bits porque solo hay una opción. Los cinco símbolos binarios añadidos consumen otros cinco bits, de modo que el total es de trece incluso antes de añadir cualquier información necesaria para cerrar el mensaje, frente a los nueve bits de la secuencia original. El ejemplo ilustra el aprendizaje del diccionario, pero con esta codificación concreta no produce ahorro.
Un compresor basado en referencias a posiciones anteriores necesita indicar distancia y longitud de copia. Una ventana limitada restringe qué coincidencias puede usar.
Si una repetición reaparece después de haber salido de la ventana, puede dejar de producir ahorro. Aumentar la ventana modifica tanto las oportunidades de compresión como los costos de memoria y búsqueda.
En procesos con escalas temporales largas, una regularidad puede existir en el registro y quedar fuera del alcance de una implementación concreta.
El tamaño del archivo comprimido debe compararse con una representación inicial especificada. Una secuencia binaria almacenada como caracteres de texto ocupa normalmente muchos más bits que una representación empaquetada.
Si comprimimos el texto formado por los caracteres cero y uno, parte del ahorro puede provenir de la codificación redundante de esos caracteres, ajena a la dependencia temporal del proceso.
Una comparación válida puede usar siempre la misma representación, pero debe interpretar correctamente su denominador. Dividir bytes comprimidos por número de muestras no produce automáticamente bits de información por muestra.
La prueba fundamental sigue siendo la reconstrucción exacta. El archivo comprimido y su decodificador deben devolver la secuencia original, incluidos los detalles que el análisis afirma conservar.
Si se elimina precisión numérica antes de comprimir, la transformación puede ser útil, pero el objeto evaluado ya es una representación discretizada. La pérdida introducida por esa etapa no desaparece porque el compresor posterior sea sin pérdida.
La longitud final es una cota descriptiva dentro del formato, siempre que el costo de la maquinaria de decodificación se trate de manera consistente. No certifica una descripción mínima universal.
Al comparar diferentes compresores, conviene registrar tanto el ahorro como el tiempo y la memoria empleados. Esas dimensiones permiten evaluar la utilidad práctica sin confundirla con una propiedad absoluta del objeto.
223.5. Qué promete la teoría asintótica
Los resultados de universalidad de la familia Lempel–Ziv no significan que un archivo finito siempre alcance su menor longitud posible. Tratan de comparaciones y límites definidos bajo condiciones precisas.
Para fuentes estacionarias y ergódicas sobre un alfabeto finito, hay algoritmos de esta familia cuyas tasas de codificación se aproximan a la tasa de entropía en el régimen asintótico correspondiente.
El codificador no necesita conocer previamente la fuente. Este es un sentido de universalidad estadística, en el que una regla puede adaptarse a una clase amplia de fuentes sin recibir sus probabilidades exactas.
La universalidad computacional de una máquina de Turing, que consiste en poder simular cualquier programa, es una propiedad diferente de la capacidad de alcanzar una tasa de compresión para una clase de fuentes.
El trabajo de Ziv y Lempel de 1978 también estudia secuencias individuales mediante su compresibilidad frente a codificadores de estados finitos. Esa referencia competitiva debe mantenerse visible; no equivale a minimizar sobre todos los programas sin restricciones.
Para LZ76 se usa con frecuencia una normalización del número de frases que incorpora el crecimiento logarítmico de la longitud. En un alfabeto binario, una forma habitual es
Esta expresión se motiva asintóticamente por su relación con la tasa de entropía, pero no es una identidad exacta entre una estadística finita y una propiedad desconocida de la fuente.
Hay que especificar la variante del teorema y sus límites. Un resultado sobre longitud codificada no puede trasladarse automáticamente al conteo de frases; una afirmación sobre un límite superior asintótico tampoco debe reescribirse como una garantía finita.
La estacionariedad evita que la ley del proceso cambie con el origen temporal; la ergodicidad permite relacionar propiedades de una realización larga con promedios de la fuente. Un registro empírico no satisface esas condiciones simplemente por contener muchas muestras.
Una mezcla de regímenes, una tendencia o una modificación del instrumento puede producir patrones que alteren la interpretación. El algoritmo sigue devolviendo una cifra, pero el teorema invocado podría dejar de justificarla.
Tampoco hay una longitud universal a partir de la cual todos los procesos se comporten como su límite. La velocidad de aproximación depende de la fuente y del procedimiento.
La teoría orienta la interpretación y sugiere controles, pero no reemplaza la evaluación del sesgo, la variabilidad y la sensibilidad en el tamaño de muestra realmente disponible.
223.6. Normalizar no elimina el efecto del tamaño
La expresión anterior puede superar uno en secuencias binarias finitas. Eso no implica que una variable binaria produzca más de un bit de entropía por símbolo bajo la definición usual.
En los ejemplos de ocho símbolos, el logaritmo en base dos de ocho es tres. Multiplicar el número de frases por tres y dividir por ocho da los resultados siguientes.
| Secuencia | c76 | q76 |
|---|---|---|
| 00000000 | 2 | 0,750 |
| 01010101 | 3 | 1,125 |
| 01001101 | 5 | 1,875 |
La cadena alternante, perfectamente periódica, obtiene más de uno con esta normalización y esta longitud. No hay paradoja, porque lo observado es una estadística finita con costos de inicio y terminación, distinta de la tasa de entropía exacta de un proceso periódico.
Si prolongamos la repetición, el comportamiento relativo cambia. El número de frases crece de otra manera que la longitud total y los efectos iniciales pesan menos.
Este ejemplo muestra por qué no conviene interpretar una puntuación aislada mediante etiquetas universales como «máxima complejidad». El tamaño y la convención forman parte del significado.
Podemos comparar con secuencias sustitutas de igual longitud y composición. Esa normalización responde a una pregunta relativa, la de cuánto difiere el resultado de un conjunto de referencia construido bajo ciertas restricciones.
Dividir por la media de puntuaciones sustitutas tampoco garantiza que el cociente esté entre cero y uno. Una muestra puede superar esa media, que no es un máximo matemático.
El trabajo de Estevez-Rams y colaboradores examina precisamente la diferencia entre alta complejidad LZ finita, aleatoriedad y normalizaciones. Sus resultados advierten contra identificar secuencias típicamente aleatorias con máximos exactos de la medida.
Podemos entender la separación mediante un argumento elemental. Para una longitud fija, enumeramos todas las cadenas, calculamos c76 y elegimos la primera que alcanza el máximo.
Ese procedimiento es computable, aunque costoso. La cadena seleccionada queda descrita por la rutina y la longitud. Por tanto, maximizar una estadística computable de novedad no garantiza maximizar complejidad algorítmica universal.
La normalización debe elegirse según la comparación buscada (entre longitudes, entre alfabetos o frente a una hipótesis nula). Una única división no resuelve a la vez todos esos problemas.
Si una puntuación se recorta artificialmente al intervalo entre cero y uno, también cambia la estadística. Dos resultados distintos pueden convertirse en el mismo valor máximo. Esa decisión puede facilitar una visualización, pero elimina información y debe declararse; no corrige el sesgo ni transforma la cifra original en una entropía demostrada.
Conviene conservar el valor bruto junto con el normalizado. Así podemos identificar si un cambio proviene del conteo, del tamaño del registro o del denominador de referencia.
223.7. La simbolización decide qué secuencia observamos
Muchos registros científicos son numéricos y requieren una transformación antes de aplicar un conteo de frases. Podemos dividir valores por un umbral, formar intervalos, usar rangos ordinales o discretizar una precisión.
Cada decisión conserva ciertas diferencias y elimina otras. Una binarización por la mediana aproxima el equilibrio entre símbolos en muchas muestras, mientras que un umbral fijo conserva información sobre desplazamientos de nivel.
Ninguna de esas opciones es universalmente superior. Si interesa detectar cambios de amplitud, reajustar el umbral en cada segmento puede ocultarlos. Si interesa el orden temporal independiente de la escala, un umbral adaptado puede resultar pertinente.
Los empates requieren una regla explícita. Una señal constante no puede dividirse arbitrariamente en dos símbolos equilibrados sin introducir una estructura que no estaba en los datos.
Un alfabeto con más símbolos permite distinguir estados que antes se agrupaban, pero aumenta las combinaciones posibles y la cantidad de datos necesaria para observar repeticiones.
Comparar directamente una puntuación binaria y otra con decenas de símbolos puede mezclar organización temporal y resolución de medida. El logaritmo usado para normalizar debe ser coherente con las unidades y el alfabeto.
La frecuencia de muestreo es otra decisión. Registrar muchas veces un proceso lento puede generar largas repeticiones; reducirlas mediante submuestreo cambia la escala temporal de la pregunta.
Un aumento de novedad tras submuestrear no indica necesariamente un aumento de complejidad del sistema físico. Puede reflejar que eliminamos observaciones redundantes a una escala determinada.
Los valores ausentes necesitan tratamiento separado. Reemplazarlos siempre por cero puede crear bloques artificialmente compresibles, mientras que interpolar puede suavizar el registro e introducir regularidades deterministas.
La concatenación de episodios también produce fronteras. Si unimos registros independientes sin marcas, aparecen coincidencias y transiciones que ningún episodio contenía por separado.
Podemos analizar cada episodio, declarar separadores o definir un formato que conserve sus límites. La opción debe corresponder a la unidad científica de interés.
En registros multivariados, ordenar canales uno detrás de otro y alternar sus muestras son transformaciones diferentes. Una medida unidimensional responde al orden elegido y, aislada, no representa todas las relaciones del sistema.
La interpretación comienza, por tanto, antes del algoritmo. Debe documentar cómo las observaciones se convirtieron en símbolos, qué relaciones temporales se conservaron y qué información se descartó.
223.8. Comparaciones, sustitutos y preguntas contrastables
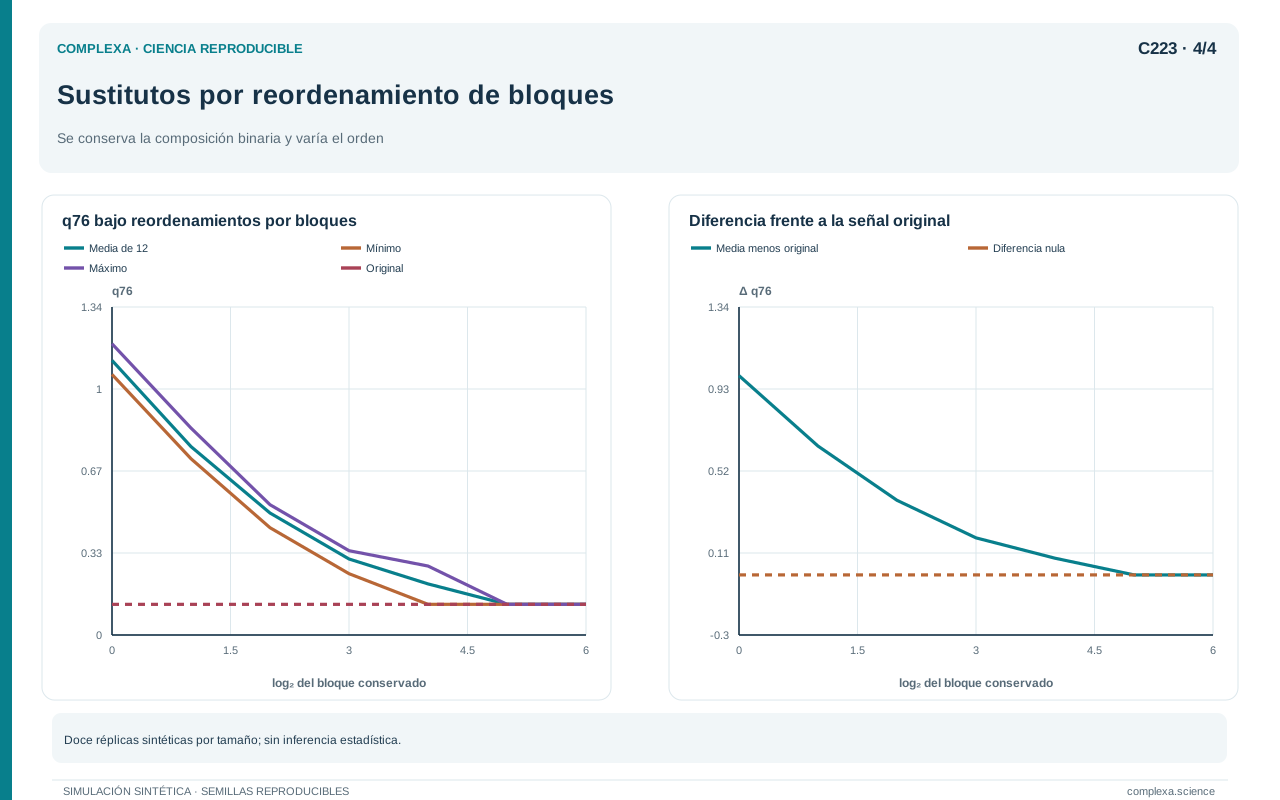
Una aplicación defendible formula primero una hipótesis sobre regularidad. Por ejemplo, podemos preguntar si el orden temporal de un registro contiene más repetición que una reorganización aleatoria de sus mismos símbolos.
Permutar la secuencia conserva las frecuencias marginales y destruye gran parte de su organización temporal. La comparación ayuda a separar el efecto de una composición desequilibrada del efecto del orden.
Sin embargo, la permutación también altera autocorrelaciones, duraciones de episodios y dependencias locales. Un cambio de puntuación no identifica cuál de esas propiedades fue responsable.
Si necesitamos conservar dependencias de corto alcance, podemos diseñar sustitutos por bloques o usar un modelo que reproduzca determinadas transiciones. Eso modifica la hipótesis nula.
Los bloques largos conservan más estructura y reducen las oportunidades de reorganización; los cortos destruyen más relaciones.
La comparación debe incluir varios sustitutos para caracterizar la variabilidad. Una sola permutación puede dar una referencia accidentalmente alta o baja.
También hay que evitar tratar ventanas solapadas como observaciones independientes. Dos ventanas que comparten casi todos sus símbolos pueden producir puntuaciones similares por construcción.
La unidad de replicación debe corresponder al diseño (una realización independiente, un episodio o un sistema observado). Multiplicar ventanas no crea automáticamente información independiente sobre una diferencia entre condiciones.
En un estudio de simulación podemos generar fuentes conocidas y evaluar si el procedimiento recupera el orden esperado. Conviene incluir controles con sesgo marginal, periodicidad, memoria y cambios de régimen.
Esos controles revelan sensibilidades concretas. Si la puntuación cambia cuando solo modificamos la frecuencia de un símbolo, debemos considerar esa vía antes de atribuir una diferencia a organización temporal.
Un generador determinista con salida aparentemente irregular puede ser otro control. Muestra que el algoritmo detecta patrones dentro de su alcance, sin certificar una propiedad universal de aleatoriedad.
La selección posterior del umbral, la ventana o la normalización puede favorecer un resultado deseado. Por eso resulta útil definir las decisiones principales antes de comparar condiciones y presentar la sensibilidad a alternativas razonables.
El ruido de observación puede romper repeticiones sin que cambie la dinámica subyacente. Si registramos una alternancia exacta y algunos símbolos se alteran por errores de lectura, el algoritmo analiza la mezcla de señal y error. Para distinguir ambas contribuciones podemos simular el mecanismo de medida con tasas de error conocidas y examinar el rango de puntuaciones que produce. Ese control no recupera la secuencia original, pero permite evaluar si la diferencia observada podría explicarse por la calidad del registro.
El resultado debe enunciarse con esa especificidad, como una diferencia en la repetición detectable bajo esta representación y esta regla. Su relevancia para un mecanismo más amplio requiere argumentos y datos adicionales.
223.9. Un protocolo reproducible de cálculo
Podemos organizar un experimento pequeño empezando por tres secuencias de control (una constante, una periódica y otra obtenida mediante una fuente estocástica o un generador declarado).
Elegimos longitudes comparables y mantenemos fijo el alfabeto. Para las realizaciones estocásticas registramos cómo se generaron y usamos varias réplicas para no depender de una muestra aislada.
Aplicamos primero el conteo de frases definido en este capítulo. Guardamos la partición, además del número, porque permite inspeccionar discrepancias entre implementaciones.
La verificación básica comprueba que concatenar las frases devuelve la cadena original. Después revisamos que cada frase no terminal se cierre en la primera extensión no reproducible según la regla de solapamiento.
En LZ78 podemos verificar además que cada nueva entrada se forme con una entrada anterior y un símbolo. El decodificador debe reconstruir el diccionario en el mismo orden.
Si incorporamos un compresor de archivos, registramos por separado su tamaño de salida. No sustituimos el conteo de frases por bytes sin cambiar el nombre de la variable.
Repetir el análisis para varias longitudes permite observar efectos de inicio, crecimiento del diccionario y dependencia de la ventana. Las curvas pueden ser más informativas que una puntuación final.
Después introducimos perturbaciones controladas. Cambiar algunos símbolos de una secuencia periódica muestra cuánto aumenta la novedad detectada. El efecto depende de dónde ocurren los cambios y de cómo interrumpen repeticiones.
Podemos comparar perturbaciones dispersas y un bloque alterado que tengan el mismo número de cambios. La composición puede ser similar y la organización temporal distinta.
También examinamos el efecto de invertir el orden del registro. Una partición secuencial usa la historia disponible desde un extremo, de modo que no debemos presuponer que su conteo finito sea invariante ante la inversión.
El informe conserva los datos o una regla que los regenere, la versión del procedimiento, los parámetros y las convenciones terminales. Una tabla de resultados sin esos elementos dificulta distinguir un hallazgo de una diferencia de implementación.
Finalmente, relacionamos cada control con una limitación concreta. Cada simulación añadida busca resolver una duda sobre representación, tamaño, dependencia o reconstrucción que podría cambiar la conclusión.
La calidad del análisis depende de esa correspondencia entre pregunta y comprobación más que de acumular muchas cifras bajo una etiqueta amplia de complejidad.
223.10. Qué podemos concluir de la compresibilidad observada
La familia Lempel–Ziv permite estudiar regularidades mediante procedimientos finitos y verificables. Sus variantes identifican repeticiones, construyen frases y convierten parte de esa estructura en códigos.
Una compresión sin pérdida demuestra que la representación usada contiene redundancia utilizable. Un conteo alto de frases indica mucha novedad respecto de una regla concreta de reproducción.
Ninguno de esos resultados da por sí solo la complejidad algorítmica exacta. Un programa breve basado en una regularidad diferente puede describir una secuencia que el algoritmo no logra comprimir bien.
Tampoco podemos identificar automáticamente novedad con organización funcional. El ruido puede aumentar un conteo, mientras que una estructura coordinada puede introducir repeticiones y reducirlo.
La interpretación depende de qué dimensión de complejidad necesitamos. Para estudiar la imprevisibilidad estadística puede ser pertinente la conexión con las tasas de entropía; para estudiar la memoria predictiva o la arquitectura causal necesitamos otras herramientas.
Los resultados asintóticos dan fundamento a la interpretación, siempre que conservemos la clase de fuentes, el tipo de algoritmo y el régimen de límites. No convierten una muestra corta en una estimación exacta.
Las normalizaciones facilitan ciertas comparaciones, pero no eliminan automáticamente el efecto de la longitud ni garantizan intervalos universales. Los ejemplos de ocho símbolos muestran explícitamente ese límite.
La simbolización, las ventanas y los límites entre episodios forman parte del experimento. Documentarlos permite evaluar si una diferencia corresponde al proceso observado o a la forma de representarlo.
El uso más sólido combina una definición precisa, reconstrucción comprobada, controles pertinentes y una conclusión ajustada al alcance del procedimiento.
Podemos afirmar que una secuencia es más difícil de comprimir para un formato o que genera más frases bajo una convención. Para avanzar desde allí hacia una explicación del sistema necesitamos conectar esa observación con hipótesis sobre sus mecanismos.
Los próximos capítulos examinarán otra dimensión, el costo de calcular una respuesta. La brevedad de una descripción, la tasa de compresión y el tiempo necesario para producir o predecir un resultado pueden diferir considerablemente.
Referencias
- Lempel, A., y Ziv, J. (1976). On the Complexity of Finite Sequences. IEEE Transactions on Information Theory, 22(1), 75–81. DOI: 10.1109/TIT.1976.1055501.
- Ziv, J., y Lempel, A. (1977). A Universal Algorithm for Sequential Data Compression. IEEE Transactions on Information Theory, 23(3), 337–343. DOI: 10.1109/TIT.1977.1055714.
- Ziv, J., y Lempel, A. (1978). Compression of Individual Sequences via Variable-Rate Coding. IEEE Transactions on Information Theory, 24(5), 530–536. DOI: 10.1109/TIT.1978.1055934.
- Estevez-Rams, E., Lora Serrano, R., Aragón Fernández, B., y Brito Reyes, I. (2013). On the non-randomness of maximum Lempel Ziv complexity sequences of finite size. Chaos, 23(2), 023118. DOI: 10.1063/1.4808251. Versión de los autores.