Módulo 23. Complejidad algorítmica, computacional y estadística
224.1. La dificultad pertenece a una pregunta
Decir que un sistema es difícil de predecir resulta incompleto. Necesitamos saber qué queremos predecir, con qué información inicial, durante cuánto tiempo y con qué precisión.
Reconstruir cada componente de una trayectoria no es la misma tarea que calcular una media, detectar una transición o determinar si cierta configuración aparecerá alguna vez.
La complejidad computacional estudia los recursos necesarios para resolver problemas formulados con precisión. La palabra problema designa una familia de entradas y respuestas, más amplia que una simulación particular que tarda mucho.
Una regla dinámica breve puede generar una evolución extensa. La brevedad del programa que implementa la regla no garantiza que cualquier pregunta sobre ella tenga una respuesta igualmente rápida.
Podemos escribir una instrucción que repita una actualización un billón de veces. La descripción ocupa poco espacio, pero ejecutarla literalmente exige hacer un billón de actualizaciones.
Quizá exista una fórmula que salte directamente al resultado. Quizá podamos usar álgebra, simetrías, conservación o una representación más conveniente. La simulación directa es un procedimiento, pero puede no ser el más rápido posible.
La irreducibilidad computacional es, en términos generales, la ausencia de atajos sustanciales para determinadas tareas de predicción. Para convertirla en una afirmación matemática necesitamos definir qué atajos se permiten y qué recurso comparamos.
También debemos distinguirla de la incomputabilidad. Un problema puede admitir un algoritmo que siempre termina y requerir recursos enormes; otro puede carecer de cualquier algoritmo general que termine correctamente en todos los casos.
Una tercera dificultad aparece cuando no conocemos con suficiente precisión las condiciones iniciales. Aunque el cálculo fuera rápido, la incertidumbre de entrada puede impedir una predicción detallada.
Estas tres fuentes de limitación pueden coexistir, pero no deben confundirse. Más potencia de cálculo puede ayudar ante un costo elevado; mejores mediciones, ante la incertidumbre inicial; pero frente a una imposibilidad algorítmica demostrada ninguna de las dos basta.
El capítulo organiza esas diferencias mediante ejemplos concretos. Empezaremos con una dinámica local que admite atajos exactos y después veremos qué cambia al buscar propiedades de largo plazo.
Para modelar, clasificar sistemas completos como predecibles o impredecibles ayuda poco. Lo útil es aprender a formular tareas cuya dificultad podamos analizar y cuya respuesta dé la información científica necesaria.
224.2. Simular paso a paso da una cota superior
Consideremos un sistema discreto cuyo estado en el instante siguiente se obtiene aplicando una función F al estado actual. Si F es computable y el estado tiene una representación finita adecuada, podemos iterarla un número finito de veces.
Para calcular el estado después de t actualizaciones, la estrategia inmediata aplica F exactamente t veces. Su costo depende del trabajo de cada actualización y del tamaño de los estados intermedios.
Si cada estado contiene N componentes y cada componente consulta un número fijo de vecinos, una implementación directa suele hacer un trabajo proporcional a N por paso. Con N fijo durante t pasos, el costo es proporcional a Nt.
Esa estimación describe un algoritmo concreto y no es una cota inferior para todos los algoritmos posibles. Podría existir una transformación que dé el mismo resultado con menos operaciones.
A veces la tarea no requiere el estado completo. Si preguntamos por una sola celda de un autómata local, basta considerar su cono de dependencia, cuyo tamaño crece con el horizonte temporal.
En una dimensión y con alcance vecinal uno, una celda después de t pasos depende como máximo de un intervalo inicial de dos t más uno celdas. Simular su cono de dependencia exige un número de actualizaciones que crece cuadráticamente con t.
Con paralelismo podemos actualizar simultáneamente las celdas de una misma capa temporal. Eso reduce la profundidad de ejecución, pero usa más procesadores y no elimina el trabajo total.
Por tanto, debemos declarar si medimos operaciones secuenciales, tiempo paralelo, memoria o comunicación. Un algoritmo rápido con millones de procesadores puede ser costoso según otra medida.
La representación de t también es relevante. Escrito en binario, ocupa un número de bits proporcional a su logaritmo, de modo que un procedimiento lineal en el valor de t puede ser exponencial respecto de la longitud de esa parte de la entrada.
La representación del estado inicial añade otras restricciones. Si recibimos un archivo de N símbolos y necesitamos leerlos todos, el costo de lectura ya crece con N.
Si el estado está descrito por una fórmula breve, quizá podamos consultar ciertas posiciones sin expandirlo por completo, aunque evaluar esa fórmula puede tener su propio costo.
La simulación directa sigue siendo una referencia útil, porque da respuestas y permite validar alternativas y medir mejoras. Establece lo que sabemos hacer y deja abierta la búsqueda de procedimientos mejores.
224.3. Un atajo exacto en la regla 90
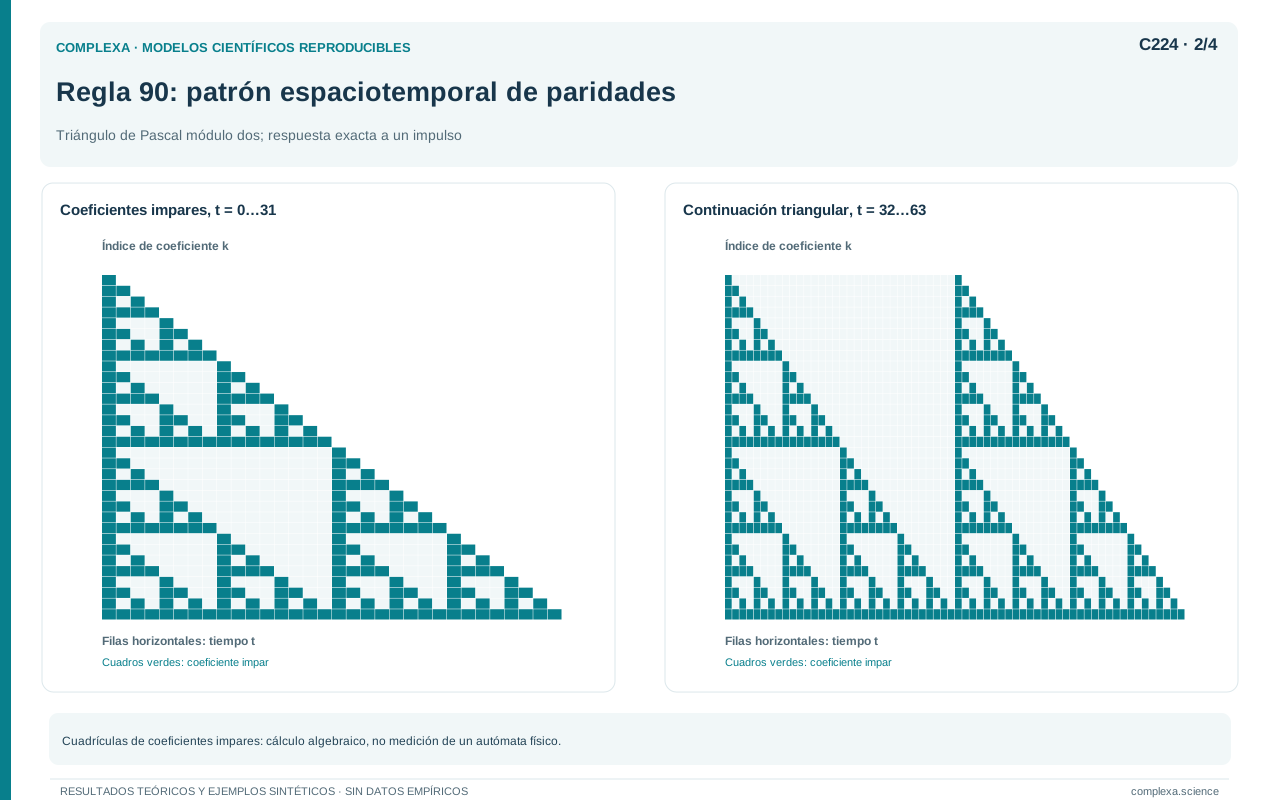
La regla 90 es un autómata celular binario unidimensional. Cada celda toma el valor de la suma módulo dos de sus dos vecinas del paso anterior. La operación equivale al o exclusivo.
Si ambas vecinas coinciden, el resultado es cero; si difieren, es uno. La actualización puede escribirse como
La regla es local y produce patrones visuales elaborados desde algunas condiciones iniciales. Sin embargo, su estructura algebraica permite evitar muchas actualizaciones intermedias.
Apliquemos la regla dos veces. La celda de la izquierda depende de dos valores iniciales y la de la derecha de otros dos. El valor central aparece dos veces en la suma módulo dos y se cancela.
Por tanto, después de dos pasos solo necesitamos los valores iniciales situados a distancia dos de la celda objetivo, pues
Podemos repetir el argumento. Cuatro pasos equivalen a combinar posiciones a distancia cuatro; ocho pasos, posiciones a distancia ocho. Para una potencia de dos obtenemos
El resultado es exacto en una línea infinita con estados iniciales definidos. También admite una versión sobre un anillo si interpretamos los índices módulo su longitud y respetamos las cancelaciones.
Para conocer una celda en el paso 1.024 basta consultar dos valores iniciales y hacer una operación de o exclusivo, además del trabajo de calcular y acceder a sus direcciones.
No reconstruimos las 1.024 capas intermedias, porque la pregunta solo pide el valor final de una celda. Si necesitáramos imprimir toda la trayectoria, seguiríamos pagando el costo de producir esa salida.
El ahorro tampoco significa tiempo absolutamente constante en cualquier modelo computacional. Manipular índices grandes y acceder a posiciones remotas puede costar más que una operación elemental.
Lo que desaparece, para esa consulta, es la obligación de ejecutar las actualizaciones locales intermedias. El ejemplo refuta la inferencia frecuente de que una figura complicada no admite atajos de predicción.
La cancelación algebraica es el mecanismo del atajo. No depende de aproximar, entrenar un predictor ni ignorar errores pequeños.
Al evaluar la irreducibilidad hay que buscar precisamente este tipo de estructura y especificar para qué entradas y observables funciona.
224.4. El horizonte y el acceso a los datos cambian el costo
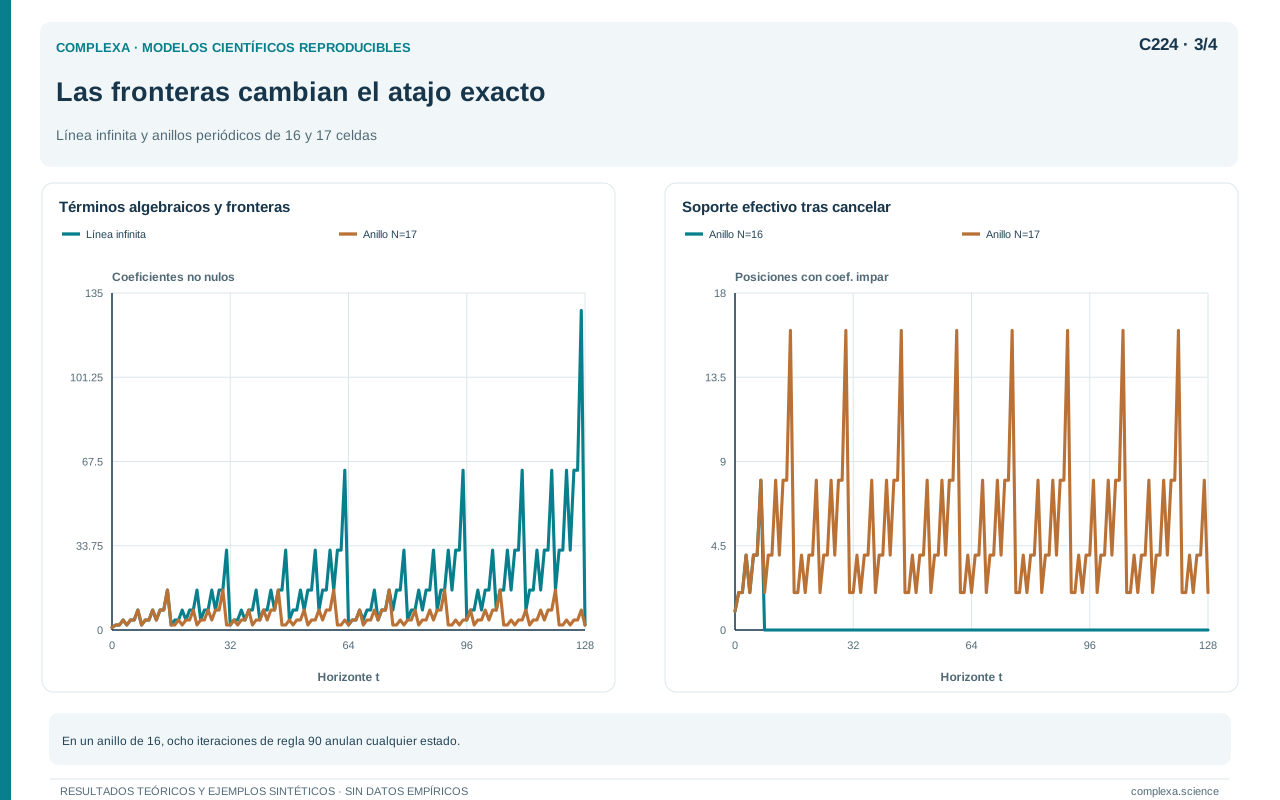
El atajo de la regla 90 no se limita a potencias de dos, aunque esos horizontes son especialmente simples. Podemos representar la actualización como una suma módulo dos de desplazamientos a izquierda y derecha.
Al componer t actualizaciones aparecen coeficientes binomiales. Solo importan los coeficientes impares, porque los pares se anulan en la suma módulo dos.
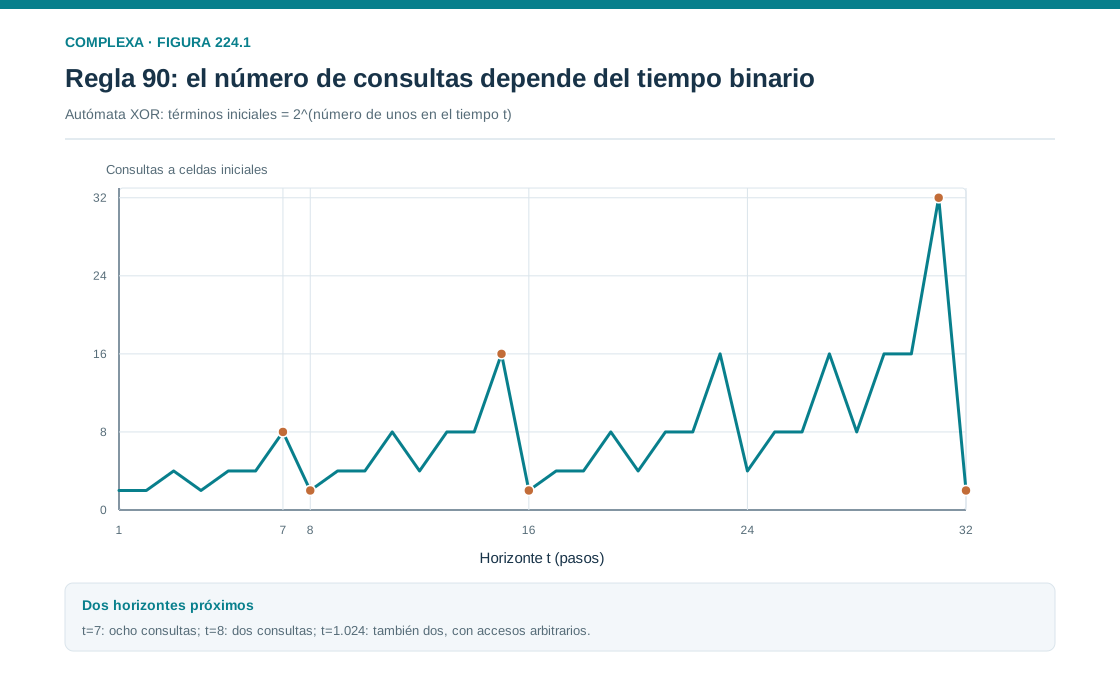
Si escribimos t en binario, cada bit igual a uno introduce una elección entre dos desplazamientos. El número de términos antes de posibles coincidencias espaciales es dos elevado al número de unos de esa escritura binaria.
Para t igual a ocho hay un solo bit activo y aparecen dos términos. Para t igual a siete hay tres bits activos y aparecen ocho términos.
Podemos comprobar un horizonte intermedio. Cinco se escribe como cuatro más uno. La actualización de cuatro pasos combina desplazamientos de cuatro celdas; aplicar además un paso introduce desplazamientos de una celda en ambos sentidos. El resultado usa las posiciones situadas a distancias cinco y tres, a izquierda y derecha. Son cuatro consultas iniciales. Para tres pasos aparecen las distancias tres y uno. Ambos horizontes tienen dos bits activos y generan cuatro términos, aunque sus posiciones difieren. Esta expansión permite construir el atajo sin formar todos los coeficientes binomiales ni almacenar las capas intermedias.
Así, dos horizontes cercanos pueden requerir cantidades distintas de consultas con esta representación. El costo no depende únicamente de cuántas cifras decimales tiene el tiempo.
En una línea infinita, las posiciones correspondientes a esos términos son distintas. Si sus valores iniciales son arbitrarios y solo podemos conocerlos mediante consultas individuales, calcular su paridad exacta requiere examinarlos todos en el peor caso.
La razón es sencilla. Si queda una posición sin leer, cambiar solo ese bit modifica el resultado y deja iguales todas las respuestas ya observadas. Un algoritmo determinista que no lo consulte no puede garantizar la respuesta correcta para ambas entradas.
Esta es una cota inferior en un modelo de consultas claramente definido y no vale para cualquier representación posible del estado.
Si el estado inicial es constante, periódico o descrito por una regla que permite calcular conjuntamente las contribuciones, el costo puede reducirse. La estructura de la entrada también forma parte del problema.
Para t igual a una potencia de dos menos uno, todos sus bits binarios son unos y aparecen t más uno posiciones iniciales. El atajo algebraico evita simular el cono de dependencia completo, pero sigue necesitando información sobre esas posiciones arbitrarias.
En un anillo finito, distintos desplazamientos pueden coincidir y cancelarse. Las condiciones de frontera cambian el cálculo y deben incorporarse antes de usar la fórmula.
La comparación permite distinguir tres costos (derivar la expresión, acceder a los datos y producir la respuesta). Reducir uno no garantiza reducir los otros en la misma proporción.
Un análisis de eficiencia convincente los mantiene separados y declara qué parte de la estructura está disponible gratuitamente como información inicial.
224.5. Sensibilidad a condiciones iniciales no equivale a indecidibilidad
Consideremos el mapa que duplica un número del intervalo unitario y conserva su parte fraccionaria. En una representación binaria, cada iteración desplaza la secuencia de dígitos una posición hacia la izquierda.
Después de t pasos, el primer dígito observado corresponde al dígito t más uno del estado inicial. La operación dinámica es sencilla, pero exige información inicial cada vez más profunda.
Dos estados que coinciden durante muchas cifras pueden separarse cuando una diferencia antes remota alcanza la parte visible. Esta sensibilidad limita la predicción si solo medimos un prefijo finito.
No necesitamos invocar indecidibilidad para explicar esa limitación. Si conocemos el dígito relevante y la representación permite acceder a él, la consulta puede ser directa.
La dificultad proviene del acceso y la precisión de la entrada. Ningún método de cálculo puede recuperar automáticamente información que la medición nunca registró.
En sistemas continuos, la forma de representar números reales importa. Tratar un real arbitrario como si todos sus infinitos dígitos estuvieran disponibles en una operación oculta un recurso ilimitado.
Los modelos computacionales efectivos suelen pedir aproximaciones con precisión especificada o permitir consultas a una representación cuyo costo debe considerarse. Esa disciplina evita atribuir al algoritmo información incorporada artificialmente en un número.
También debemos distinguir predicción puntual y estadística. Aunque no podamos seguir una trayectoria con precisión prolongada, quizá podamos describir distribuciones, frecuencias o propiedades invariantes.
Esas posibilidades requieren sus propias hipótesis y métodos. Perder la trayectoria detallada puede dejar accesibles otras preguntas sobre el sistema.
El trabajo de Moore sobre sistemas dinámicos construidos para simular computación universal muestra, en cambio, que ciertas preguntas de largo plazo pueden heredar la indecidibilidad incluso cuando la representación inicial se especifica de manera efectiva.
De esas construcciones no se sigue que todo sistema sensible a condiciones iniciales tenga la misma propiedad. Tampoco una semejanza visual entre trayectorias establece una reducción computacional.
Para justificar indecidibilidad necesitamos una correspondencia formal entre el problema dinámico y un problema ya demostrado indecidible. Para justificar una limitación de precisión basta analizar cómo se propagan las diferencias iniciales.
Mantener esa separación permite elegir la respuesta adecuada a la dificultad realmente presente, ya sea mejorar mediciones, reformular observables, cambiar algoritmos o reconocer una imposibilidad general.
224.6. Preguntar por un tiempo finito o por alguna vez
En un modelo discreto computable, una pregunta sobre un horizonte finito puede resolverse mediante simulación si la representación permite ejecutar los pasos necesarios. El costo puede ser alto, pero el procedimiento termina.
Preguntar si un evento ocurrirá alguna vez elimina el límite temporal. Simular hasta observarlo da una respuesta afirmativa cuando aparece, pero no garantiza una respuesta negativa cuando nunca ocurrirá.
Si un sistema puede simular una máquina universal y el evento corresponde a su parada, decidir universalmente si ese evento aparecerá permitiría resolver el problema de la parada.
La reducción exige construir efectivamente el estado inicial correspondiente a cada programa y garantizar que el evento dinámico ocurre exactamente cuando termina la ejecución simulada. Sin esa equivalencia, la analogía no demuestra nada.
La universalidad permite representar una gran familia de cálculos; eso no implica que toda condición inicial haga un cálculo difícil ni que cada observable herede el problema de la parada.
Dentro de una misma regla puede haber estados iniciales que desaparecen rápidamente, ciclos simples y configuraciones diseñadas para hacer cálculos complejos.
Las preguntas negativas de largo plazo requieren especial cuidado. No observar un patrón durante un millón de pasos demuestra su ausencia en ese intervalo, pero deja abierta su aparición posterior.
Hay excepciones justificadas por estructura adicional. En un sistema determinista con un número finito conocido de estados, una repetición completa de estado establece un ciclo y permite descartar eventos que no aparecieron en la parte recorrida.
Un autómata binario sobre un anillo de N celdas tiene como máximo dos elevado a N estados. Si seguimos una trayectoria durante suficientes transiciones, encontraremos una repetición o habremos observado el evento.
El procedimiento es finito, pero su cota puede crecer exponencialmente con N. La diferencia entre decidibilidad y eficiencia vuelve a aparecer.
En una línea sin límite espacial, o en una familia donde la memoria puede crecer sin cota fija, ese argumento finito ya no se aplica de la misma manera.
Las condiciones de frontera y el tamaño del dominio pueden cambiar la clase matemática de la pregunta. Por ello, una afirmación de imposibilidad debe declarar si trata un dominio infinito idealizado, una familia de tamaños crecientes o un dispositivo finito concreto. Transferir conclusiones entre esos casos sin justificación puede producir errores importantes.
224.7. Qué tendría que demostrar una irreducibilidad
Una afirmación de irreducibilidad debe identificar entradas, salida, modelo de cálculo y recurso. También debe aclarar si describe el peor caso, casos típicos bajo una distribución o una instancia particular.
Que varios métodos conocidos no mejoren una simulación es evidencia sobre esos métodos; algún procedimiento futuro podría todavía hacerlo.
Una demostración de cota inferior necesita abarcar toda una clase de algoritmos. En ocasiones podemos obtenerla mediante argumentos de información, como la necesidad de consultar todos los bits de una paridad arbitraria.
Otras veces usamos una reducción para mostrar que un predictor resolvería un problema cuya dificultad está establecida o cuya solución eficiente implicaría una consecuencia teórica importante.
En el estudio de la predicción paralela se usa la clasificación como problema completo para tiempo polinómico. Bajo reducciones apropiadas, esa clasificación es evidencia contra una paralelización extremadamente eficiente si se cumplen ciertas conjeturas de separación de clases.
Esa conclusión es condicional y específica. No implica que cada actualización de una simulación particular sea indispensable ni descarta mejoras constantes, subfamilias fáciles o aproximaciones útiles.
También hay resultados positivos. Moore y Pnin mostraron cómo ciertas estructuras algebraicas permiten predecir autómatas no lineales mediante circuitos paralelos de poca profundidad respecto del horizonte.
Así, ni siquiera la no linealidad garantiza la ausencia de atajos; hay que examinar la estructura concreta del problema.
El trabajo de Wolfram de 1985 impulsó la discusión sobre límites computacionales en física mediante ejemplos y propuestas generales. Conviene distinguir los problemas formalmente construidos de la hipótesis más amplia de que dificultades semejantes son frecuentes. La palabra irreducible puede orientar la investigación, pero como conclusión necesita precisión.
El tamaño de la salida da otra cota elemental. Si pedimos una trayectoria completa de N componentes durante t pasos y exigimos escribir cada símbolo, producirla ya necesita un trabajo proporcional a su longitud.
La garantía probabilística también debe declararse. Permitir errores con una probabilidad controlada puede cambiar el costo de ciertas tareas, sin que eso equivalga a resolverlas exactamente en todas las entradas. Una reducción de tiempo debe evaluarse junto con el tipo de error permitido y sus consecuencias para la pregunta científica.
La cota de salida no impide representar la trayectoria de manera comprimida ni responder consultas parciales con menos trabajo. Cambiar el formato de salida cambia la tarea.
La pregunta científica más productiva suele ser qué información necesitamos realmente. A veces una exigencia excesiva de detalle crea una dificultad que desaparece al formular un observable pertinente.
224.8. Descripciones agregadas y cierre dinámico
Una descripción agregada transforma muchos estados microscópicos en una misma categoría. Llamemos pi a esa transformación. Buscamos una regla G que permita actualizar la categoría sin reconstruir todos los detalles.
Un cierre exacto para intervalos de k pasos exige que agregar después de evolucionar coincida con evolucionar la descripción agregada
Aquí una aplicación de G equivale a un intervalo completo de k pasos microscópicos. Si se define G para otra unidad temporal, cambia el exponente necesario en la identidad. La convención del reloj debe acompañar a la ecuación.
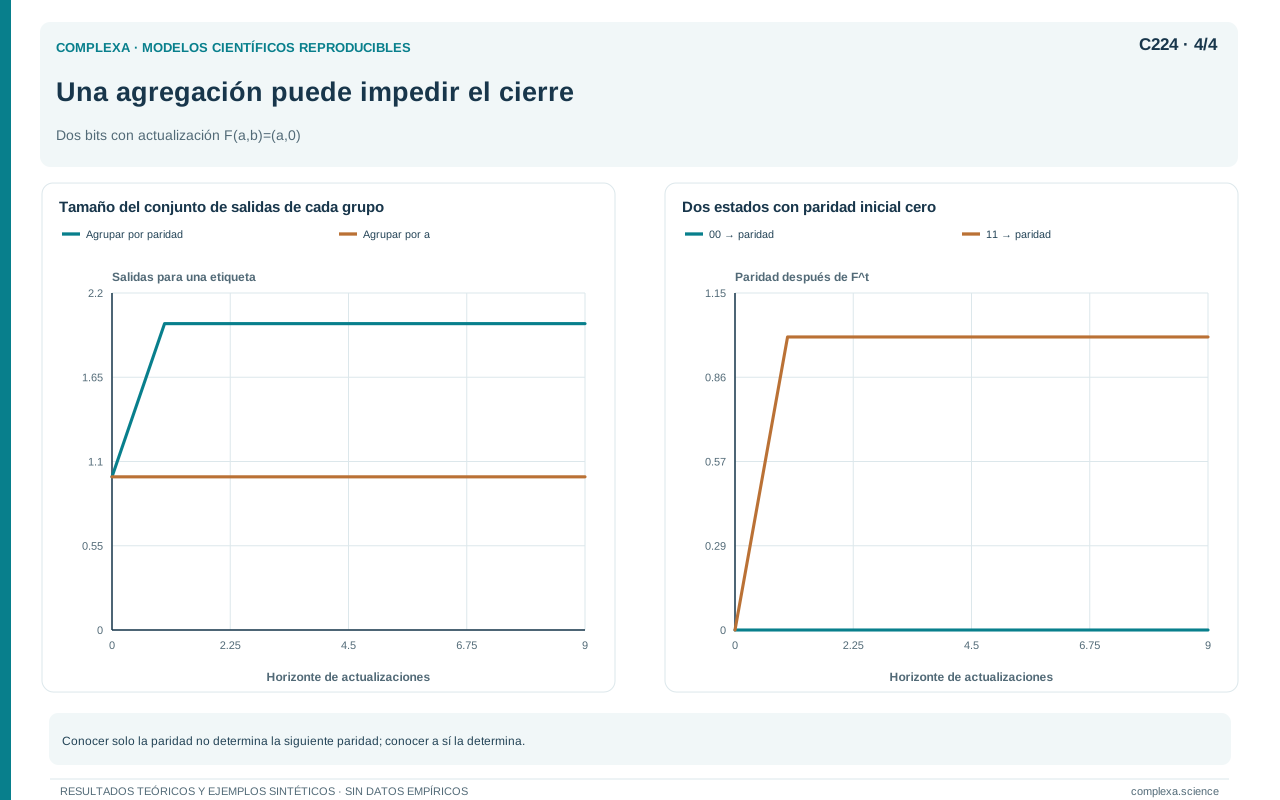
La igualdad debe cumplirse para todos los estados de la clase declarada. Si dos estados con la misma categoría producen categorías futuras distintas, esa representación no contiene información suficiente para una actualización determinista cerrada.
Un sistema de dos bits permite verificarlo directamente. Supongamos que la actualización conserva el primer bit y reemplaza el segundo por cero. Si agregamos mediante la paridad de ambos bits, los estados 00 y 11 pertenecen inicialmente a la misma categoría (paridad cero). Después de actualizar, se convierten en 00 y 10, con paridades distintas. No hay una regla determinista del valor agregado que prediga ambos resultados sin información adicional. Ningún algoritmo ingenioso lo remedia, porque la representación solicitada perdió una distinción necesaria. Conservar el primer bit como parte del estado agregado resolvería este ejemplo, a costa de cambiar la descripción.
Podemos ampliar el estado agregado, introducir memoria o usar una descripción probabilística. En cada alternativa cambia qué se conserva y cómo se representa la incertidumbre.
Un ejemplo sencillo usa un estado de dos partes, u y v. La primera avanza una unidad en un reloj modular; la segunda sigue una dinámica más complicada que puede depender de ambas.
Si observamos solo u, su futuro se calcula sumando el tiempo y tomando el resto correspondiente. La dificultad de reconstruir v no impide esa predicción.
Nada asegura que todo sistema tenga una descripción agregada interesante. Una categoría constante siempre sería fácil de predecir, pero podría descartar justamente la información que necesitamos.
La elección del observable debe justificarse por la pregunta. Una simplificación útil conserva diferencias relevantes para predecir, comparar o intervenir, aunque elimine otras.
Israeli y Goldenfeld construyeron descripciones agregadas de autómatas celulares que ilustran cómo comportamientos de gran escala pueden resultar más tratables que detalles microscópicos. Son ejemplos concretos; la simplificación no está garantizada para cualquier variable.
En modelos empíricos, el cierre suele ser aproximado. Entonces debemos medir errores, examinar su acumulación y comprobar si dependen de regiones del espacio de estados que el entrenamiento representó mal.
Un promedio puede predecirse bien mientras eventos raros permanecen mal descritos. Si esos eventos son el objetivo del estudio, una buena media no basta.
También puede haber una escala temporal en la que la descripción agregada funciona y otra en la que pierde validez. El intervalo k forma parte del modelo.
Frente a costos elevados, la agregación permite reducir el detalle solicitado y verificar qué capacidad predictiva permanece. Su éxito se evalúa respecto de una tarea explícita; que las ecuaciones resultantes parezcan simples no lo acredita.
224.9. Cómo estudiar un posible atajo
Un experimento computacional puede comparar una simulación directa y un predictor alternativo, pero necesita entradas y criterios comunes. Primero definimos qué respuesta deben producir ambos.
Para la regla 90 podemos pedir el valor de una celda en horizontes que sean potencias de dos. Generamos estados iniciales finitos suficientemente amplios para cubrir la dependencia y comparamos la fórmula con la simulación.
Después examinamos horizontes con distintos números de bits activos. Así comprobamos la predicción sobre el número de términos y evitamos evaluar el método solo en horizontes favorables.
La prueba debe controlar las fronteras. Si la simulación usa un anillo y la fórmula una línea infinita, una discrepancia puede deberse a modelos diferentes.
También separamos tiempo de preparación y tiempo de consulta. Un predictor puede construir una tabla costosa una sola vez y responder rápidamente muchas preguntas posteriores.
Ese intercambio puede ser útil cuando repetimos consultas, pero la tabla no es gratuita. Su tamaño, construcción y validez ante nuevas entradas pertenecen al costo total.
Los métodos aprendidos requieren otra distinción. Pueden aproximar respuestas dentro de una distribución de entrenamiento sin dar una solución exacta para todas las entradas.
Una buena evaluación usa casos no vistos y examina cambios de régimen. El error promedio debe acompañarse de información sobre fallos relevantes para la tarea.
Si una hipótesis afirma una garantía universal, unos cuantos casos acertados no la demuestran. Si afirma utilidad empírica en una distribución específica, una evaluación representativa puede ser la evidencia adecuada.
También conviene distinguir una aceleración por hardware de una reducción del número de operaciones. Ejecutar la misma simulación en un dispositivo más rápido puede ser una mejora decisiva para el proyecto, pero no altera su dependencia asintótica del horizonte; una transformación algebraica sí puede cambiarla. Ambas mejoras merecen documentarse, porque responden a mecanismos distintos y permiten extrapolaciones diferentes al aumentar el tamaño del problema.
El costo de la entrada debe medirse con cuidado. Comparar un método que recibe un estado comprimido con otro que recibe todos sus componentes puede atribuir al algoritmo una ventaja originada en el formato.
También necesitamos informar la precisión. Un método aproximado puede ser mucho más rápido, pero su comparación con un cálculo exacto exige explicar qué error tolera y por qué.
Finalmente, las curvas de costo deben abarcar tamaños que permitan distinguir tendencias. Una ventaja en ejemplos pequeños puede desaparecer al crecer el estado o el horizonte.
El objetivo es identificar una clase de tareas donde una estructura permite ahorrar trabajo y determinar los límites de ese ahorro, algo que un caso favorable aislado no consigue.
224.10. Elegir entre exactitud, detalle y recursos
La dificultad computacional depende de la pregunta, la representación, los recursos y la garantía solicitada. Sin precisar esos elementos, no podemos asignarla a todo un sistema como una propiedad única.
Una dinámica local puede tener atajos algebraicos exactos y una trayectoria sensible a perturbaciones puede admitir estadísticas útiles; incluso un modelo capaz de computación universal puede contener observables sencillos.
También hay problemas generales sin algoritmo decisor y tareas computables con costos demasiado altos para un uso determinado. Reconocer esas diferencias permite buscar soluciones pertinentes.
Si el problema es la precisión inicial, podemos mejorar el registro o predecir distribuciones. Si el problema es el costo, podemos explotar la estructura, aproximar, paralelizar o reducir la salida.
Si existe una demostración de indecidibilidad para la formulación general, podemos restringir la clase de entradas o aceptar procedimientos parciales. Esas modificaciones dejan intacto el teorema, porque crean un problema diferente.
La irreducibilidad es más informativa cuando se expresa como una afirmación delimitada sobre una tarea. Decir qué recurso no puede reducirse, bajo qué supuestos, ayuda a decidir cómo continuar.
Los ejemplos de la regla 90 muestran además que apariencia y dificultad pueden separarse. Una figura complicada puede surgir de una estructura algebraica que permite respuestas directas.
El argumento sobre la paridad muestra el reverso; incluso una fórmula breve puede requerir información sobre muchas entradas arbitrarias. La simplicidad de la expresión no elimina el costo de obtener sus argumentos.
La agregación es otra vía, siempre que preserve la información necesaria. Su valor depende de la pregunta científica y de una validación que examine los errores pertinentes.
Conviene ampliar la pregunta de si un sistema es predecible y formular qué podemos calcular de él, a qué costo y con qué garantías. Esa formulación convierte una etiqueta amplia en un programa de investigación.
El siguiente capítulo desarrollará las clases de costo y las reducciones que permiten comparar problemas. Allí distinguiremos con mayor detalle un algoritmo lento, un problema difícil y una dificultad que todavía no sabemos demostrar.
Referencias
- Wolfram, S. (1985). Undecidability and Intractability in Theoretical Physics. Physical Review Letters, 54(8), 735–738. DOI: 10.1103/PhysRevLett.54.735.
- Moore, C. (1990). Unpredictability and Undecidability in Dynamical Systems. Physical Review Letters, 64(20), 2354–2357. DOI: 10.1103/PhysRevLett.64.2354.
- Moore, C., y Pnin, T. (1998). Predicting Non-linear Cellular Automata Quickly by Decomposing Them into Linear Ones. Physica D, 111(1–4), 27–41. DOI: 10.1016/S0167-2789(97)80003-6. Registro de los autores.
- Israeli, N., y Goldenfeld, N. (2006). Coarse-graining of cellular automata, emergence, and the predictability of complex systems. Physical Review E, 73(2), 026203. DOI: 10.1103/PhysRevE.73.026203.