Módulo 23. Complejidad algorítmica, computacional y estadística
225.1. Del tiempo de una ejecución al crecimiento del costo
Un programa puede tardar diez segundos en una entrada y una hora en otra. Esas mediciones son útiles, pero de ellas solas no se deduce cómo crecerá el trabajo cuando aumente el problema.
La complejidad de cálculo describe esa relación. Elegimos una medida de tamaño de entrada y contamos recursos como operaciones, memoria o profundidad paralela en función de ese tamaño.
El tamaño debe corresponder a la representación. Una lista de mil enteros pequeños no contiene necesariamente tanta información como una lista de mil enteros con millones de dígitos.
Si los valores numéricos pueden crecer, contar solo cuántos números hay puede ocultar una parte decisiva del costo. La teoría basada en bits usa la longitud total de la codificación.
También debemos distinguir un algoritmo de un problema. El algoritmo es un procedimiento particular, mientras que el problema especifica qué respuesta corresponde a cada entrada válida y puede admitir muchos procedimientos diferentes.
Que una implementación use tiempo cuadrático no demuestra que el problema lo necesite. Quizá exista un algoritmo lineal que todavía no hemos considerado.
Una cota superior establece un costo alcanzable mediante algún procedimiento. Una cota inferior demuestra que ninguna solución dentro de un modelo y una clase declarados puede usar menos de cierto recurso.
La distancia entre ambas cotas es conocimiento pendiente. No debemos llenarla con una afirmación de imposibilidad basada solo en la lentitud del método disponible.
Los trabajos fundacionales de Hartmanis y Stearns ayudaron a organizar clases de problemas según recursos de cálculo. Esa perspectiva permite comparar tareas sin depender exclusivamente de un computador concreto.
La abstracción no elimina la ingeniería. Constantes, acceso a memoria, representación y paralelismo siguen determinando qué método funciona mejor en tamaños reales.
El estudio del crecimiento asintótico sirve para entender la escalabilidad; la medición de implementaciones, para decidir dentro del rango de interés.
En sistemas complejos esta distinción aparece continuamente. Simular agentes, inferir parámetros, optimizar intervenciones y comparar modelos son tareas diferentes, aunque se ejecuten sobre los mismos datos.
Un modelo científicamente sencillo puede exigir una inferencia costosa. Un modelo con muchas variables puede admitir actualizaciones locales baratas. El tamaño de la descripción y el costo de responder una pregunta no tienen por qué coincidir.
El objetivo de este capítulo es dar un lenguaje para reconocer esas diferencias y decidir qué estrategias son razonables ante un problema difícil.
225.2. Qué significan las cotas asintóticas
Escribimos que un costo es O de una función cuando queda acotado por una constante multiplicada por esa función, a partir de un tamaño suficientemente grande.
La notación no afirma igualdad exacta ni describe necesariamente el comportamiento en entradas pequeñas. Tampoco indica qué costo se acota, de modo que debemos declarar si se trata del peor caso u otro.
Si un algoritmo hace como máximo tres n al cuadrado más cinco n operaciones, su costo es O de n al cuadrado. Los términos menores y la constante dejan de dominar el crecimiento.
La notación Omega expresa una cota inferior asintótica, mientras que Theta indica que existen cotas superior e inferior del mismo orden. Ninguna de ellas reemplaza la especificación del modelo de operaciones.
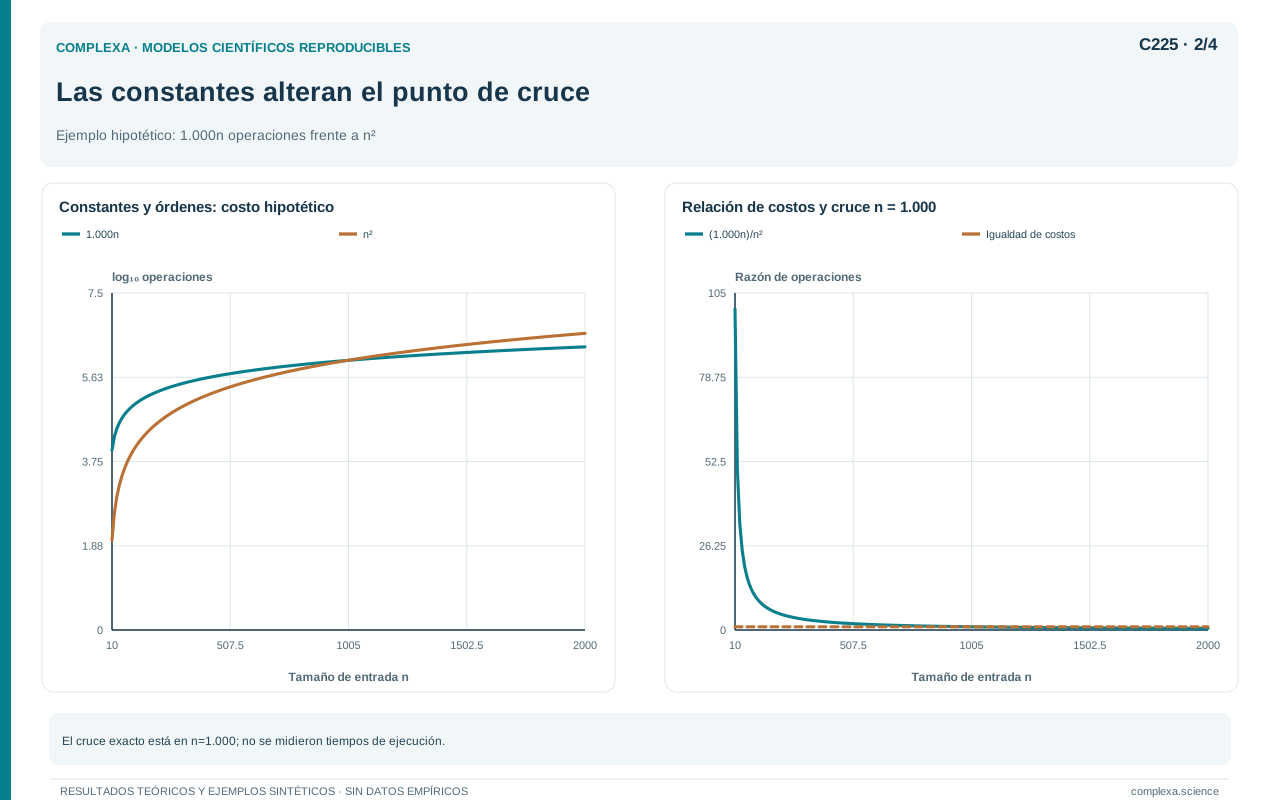
Comparemos dos procedimientos hipotéticos. El primero necesita mil n operaciones y el segundo n al cuadrado. Para tamaños pequeños, el segundo puede ser más barato; al superar cierto rango, el primero crece más lentamente.
El punto de cruce de esas expresiones está en n igual a mil. Esa comparación exacta pertenece al ejemplo; en programas reales aparecen otros costos y variaciones entre entradas.
La complejidad espacial añade otra dimensión. Un algoritmo puede ahorrar tiempo almacenando resultados intermedios, mientras otro recalcula para usar menos memoria.
Si la memoria disponible se agota, un método teóricamente rápido puede volverse impracticable. La transferencia de datos entre niveles de almacenamiento también puede dominar el tiempo medido.
Sumar dos enteros de miles de bits no debe tratarse siempre como una operación de costo constante si el tamaño de esos enteros forma parte del crecimiento.
En algunos modelos de ingeniería se consideran palabras de tamaño fijo y operaciones elementales sobre ellas. Esa aproximación puede ser adecuada dentro de un rango, pero debe revisarse cuando aparecen números de precisión creciente.
La salida también cuenta. Enumerar todas las soluciones de un problema puede requerir tiempo exponencial simplemente porque hay exponencialmente muchas respuestas que escribir.
Eso no significa que decidir si existe alguna solución tenga el mismo costo; la cantidad de información solicitada puede cambiar drásticamente la tarea.
Una exposición clara distingue tamaño de entrada, recurso, tipo de garantía y formato de salida. Sin esos elementos, una etiqueta como «rápido», «polinómico» o «eficiente» puede resultar engañosa.
La ordenación de elementos distintos mediante comparaciones da una cota inferior instructiva. Cada comparación binaria produce dos posibles respuestas. Un árbol de decisiones de profundidad d distingue como máximo dos elevado a d desenlaces. Para ordenar correctamente n elementos distintos necesitamos distinguir sus n factorial órdenes posibles. Por tanto, alguna ejecución requiere al menos el logaritmo en base dos de n factorial comparaciones, redondeado hacia arriba.
La conclusión vale en el modelo de comparación y no descarta algoritmos que aprovechen que las claves son enteros dentro de un intervalo pequeño y usen operaciones adicionales. Toda cota debe formularse junto con sus reglas, porque una demostración correcta puede volverse falsa si la extendemos a un modelo más potente sin revisar el argumento.
Las cotas asintóticas ayudan a organizar comparaciones siempre que se usen como afirmaciones precisas, sin reemplazar la pregunta que intentamos resolver.
225.3. Polinomios, exponenciales y tamaños alcanzables
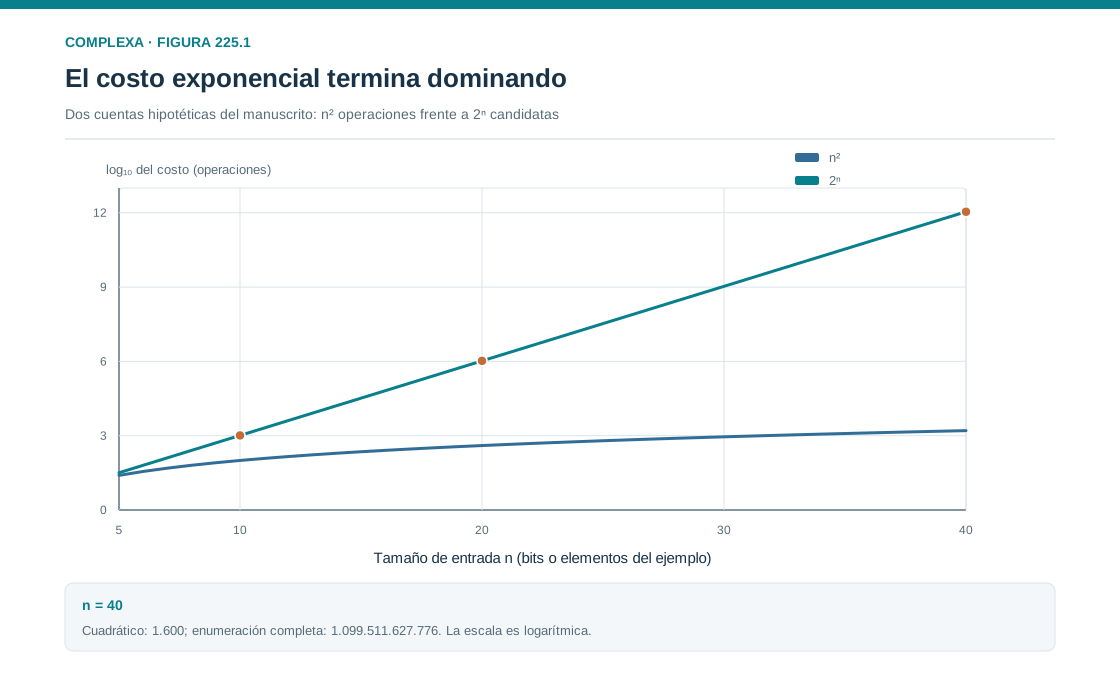
Un costo polinómico tiene una cota de la forma n elevado a una constante fija, multiplicada por otra constante. Un costo exponencial como dos elevado a n crece mucho más rápido cuando n aumenta.
Comparemos, sin hablar de computadores concretos, una cuenta cuadrática con una enumeración de todas las cadenas binarias de longitud n. Para n igual a 10, 20 y 40, n al cuadrado vale 100, 400 y 1.600, mientras que dos elevado a n vale 1.024, 1.048.576 y 1.099.511.627.776.
Duplicar n de veinte a cuarenta multiplica por cuatro el costo cuadrático. En la enumeración binaria, el número de candidatos se eleva al cuadrado.
Una mejora constante del hardware puede ampliar mucho un cálculo polinómico y muy poco una enumeración exponencial. Si duplicamos la velocidad de una búsqueda que examina todas las cadenas, solo ganamos un bit adicional de longitud al mantener el tiempo.
Este ejemplo no demuestra que un problema con muchas soluciones candidatas necesite enumerarlas, porque un espacio grande puede tener una estructura que permita evitar la búsqueda exhaustiva.
Ordenar una lista, encontrar un camino mínimo o resolver ciertos sistemas de ecuaciones involucra muchas posibilidades abstractas, pero admite procedimientos que no las examinan una por una.
Tampoco debemos identificar «polinómico» con «cómodo». Un algoritmo de grado muy alto o con una constante enorme puede ser inútil para tamaños accesibles.
Por otra parte, un método exponencial puede funcionar bien cuando el parámetro relevante es pequeño, cuando poda muchas ramas o cuando las instancias reales tienen estructura favorable.
La frontera polinómica interesa por su robustez teórica bajo muchas codificaciones y composiciones razonables, pero no garantiza buen desempeño en cualquier proyecto.
Si componemos una cantidad polinómica de tareas, cada una de costo polinómico y con tamaños controlados, el costo total sigue siendo polinómico. Esa estabilidad facilita construir teorías de reducción.
La representación numérica puede cambiar la interpretación. Un entero W necesita aproximadamente el logaritmo de W bits en binario. Un algoritmo cuyo costo crece linealmente con W puede ser exponencial respecto de la longitud de esa codificación.
Por eso debemos leer cada expresión de costo junto con sus variables; la palabra «polinómico» solo tiene significado cuando sabemos en qué tamaño está expresado el polinomio.
225.4. Decidir, encontrar y verificar
Un problema de decisión solicita una respuesta afirmativa o negativa. Por ejemplo, podemos preguntar si un grafo contiene un conjunto de k vértices sin aristas entre ellos.
Un problema de búsqueda pide exhibir ese conjunto cuando existe. Un problema de optimización pide encontrar el mayor conjunto posible o determinar su tamaño.
Las tres versiones están relacionadas sin ser idénticas. Muchas clasificaciones de complejidad se formulan primero para decisión; las relaciones con búsqueda y optimización se estudian después.
La clase P contiene problemas de decisión resolubles por algoritmos deterministas en tiempo polinómico respecto de la longitud de entrada.
La clase NP contiene problemas de decisión cuyas respuestas afirmativas tienen certificados de longitud polinómica que pueden verificarse en tiempo polinómico mediante un procedimiento determinista.
La sigla NP no significa «no polinómico». Todo problema de P pertenece también a NP, porque un verificador puede resolver directamente la pregunta sin necesitar un certificado informativo.
Consideremos la satisfacibilidad booleana. La entrada es una fórmula lógica y la pregunta es si existe una asignación de valores que la haga verdadera.
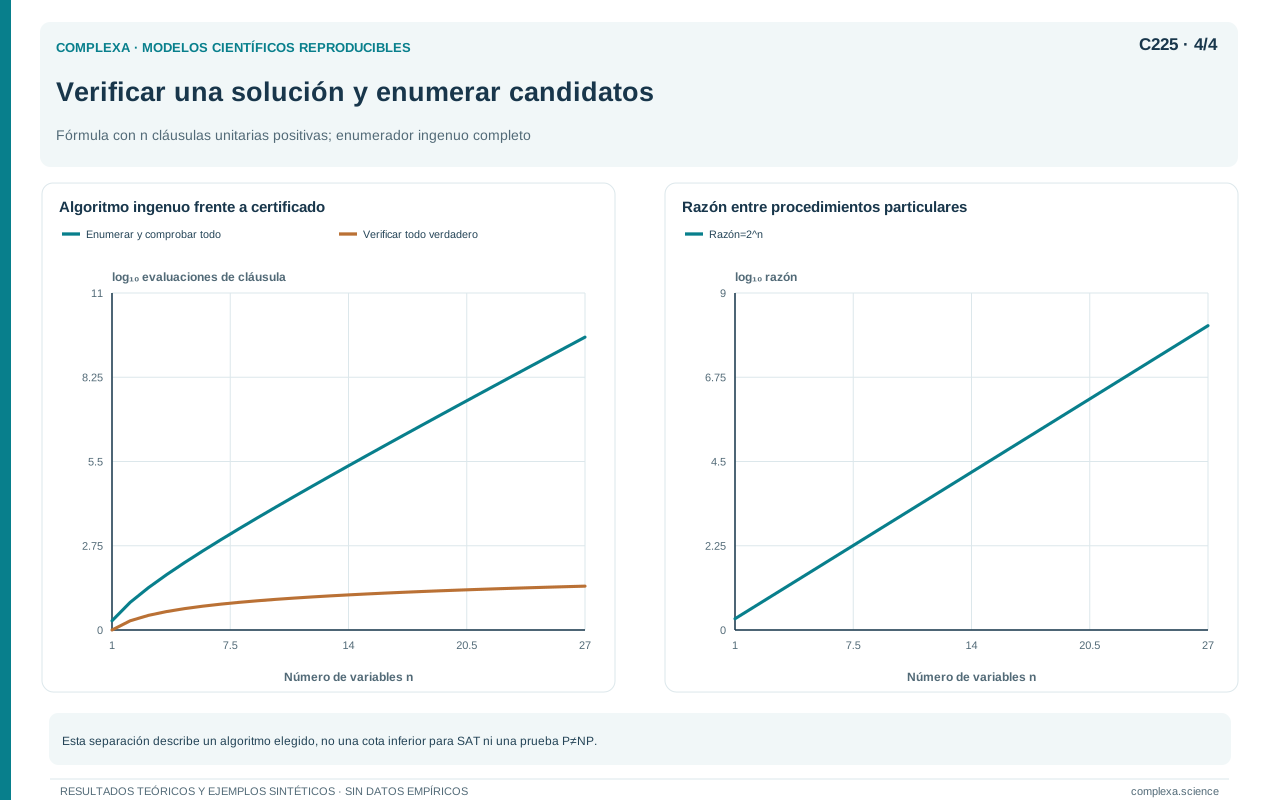
El certificado afirmativo es una asignación de valores. Podemos sustituir los valores y evaluar la fórmula en un tiempo controlado por su longitud, sin enumerar todas las asignaciones posibles.
La fórmula con las cláusulas «x o y», «no x o z» y «no y o no z» admite, por ejemplo, la asignación x verdadera, y falsa y z verdadera.
Con tres variables hay ocho asignaciones posibles; con n variables hay dos elevado a n. Que una asignación pueda verificarse sin recorrer ese conjunto no demuestra que encontrar una asignación satisfactoria exija enumerarlas todas. Precisamente la relación entre encontrar y verificar forma parte del problema general.
La definición de NP tampoco exige certificados cortos para respuestas negativas. Probar que ninguna asignación funciona puede requerir otra estructura de demostración.
Un programa que encuentra muchas soluciones rápidamente no resuelve por ello todas las instancias. Para que un problema pertenezca a P necesitamos un algoritmo con garantía polinómica para cualquier entrada válida.
Al informar resultados aplicados conviene conservar esta distinción, porque verificar una intervención candidata, encontrar una intervención y demostrar que no existe ninguna mejor son tareas con exigencias diferentes.
225.5. Reducciones y problemas completos
Una reducción transforma instancias de un problema en instancias de otro preservando la respuesta. Si la transformación puede calcularse eficientemente, permite transferir algoritmos y resultados de dificultad.
Supongamos que A se reduce a B en tiempo polinómico y que disponemos de un algoritmo polinómico para B. Podemos resolver A transformando su entrada, resolviendo la instancia de B y traduciendo la respuesta.
Por tanto, B es al menos tan difícil como A en el sentido de esa reducción. Por la misma razón, transformar un problema difícil conocido en el nuevo problema ayuda a demostrar la dificultad del nuevo.
La transformación en sentido contrario, del nuevo problema a uno difícil conocido, no basta para probar que el nuevo sea difícil, ya que podría corresponder solo a una subfamilia fácil del problema de destino.
Un problema es NP difícil, bajo las reducciones polinómicas pertinentes, si todos los problemas de NP se reducen a él. Es NP completo si además pertenece a NP.
Los resultados de Cook y Levin establecieron la centralidad de la satisfacibilidad; Karp mostró reducciones entre muchos problemas combinatorios. Esa red de equivalencias reunió en una teoría común problemas que parecían distintos.
Podemos ilustrar una reducción elemental con grafos. Un conjunto de vértices es una cobertura si toda arista tiene al menos un extremo dentro del conjunto.
El complemento de una cobertura es un conjunto independiente, porque si dos vértices del complemento estuvieran unidos, esa arista no tendría ningún extremo cubierto.
La relación funciona también en sentido inverso. El complemento de un conjunto independiente cubre todas las aristas, porque una arista con ambos extremos fuera de la cobertura violaría la independencia.
Así, en un grafo de N vértices, existe una cobertura de tamaño como máximo k si y solo si existe un conjunto independiente de tamaño como mínimo N menos k.
La transformación conserva el grafo y modifica el umbral. Es fácil de verificar y muestra cómo una solución de una tarea puede resolver la otra.
En un ciclo de cinco vértices, el mayor conjunto independiente tiene dos vértices y la menor cobertura tiene tres. La suma de ambos tamaños es cinco, conforme a la relación.
Las reducciones permiten razonar sobre familias completas, pero no garantizan que las implementaciones transferidas sean las mejores en la práctica. Una transformación puede aumentar constantes o destruir estructura que otro algoritmo explotaría directamente.
225.6. Qué sabemos y qué no sabemos sobre P y NP
La pregunta P frente a NP sigue abierta, pues no se conoce una demostración de igualdad ni de desigualdad. El registro del Clay Mathematics Institute la mantiene como problema no resuelto según la consulta hecha para este capítulo.
Sabemos que P está contenida en NP. La cuestión es si toda verificación afirmativa eficiente puede acompañarse de un método eficiente para decidir la existencia del certificado.
Si algún problema NP completo tuviera un algoritmo polinómico, las reducciones implicarían que todos los problemas de NP pertenecen a P.
Si P fuera distinta de NP, ningún problema NP completo admitiría un algoritmo determinista polinómico para todas sus entradas. Esa afirmación no implicaría una cota exponencial específica, porque entre el crecimiento polinómico y muchas formas exponenciales hay otras posibilidades.
La completitud NP tampoco implica que cada instancia sea difícil. Un problema NP completo puede contener familias triviales, casos pequeños y estructuras que permiten soluciones rápidas.
La dificultad de peor caso exige que no exista un único algoritmo polinómico que resuelva toda la familia. No afirma que una muestra típica de cualquier distribución sea difícil.
Por eso un solucionador que procesa con éxito miles de instancias no contradice la clasificación. Podría explotar regularidades de esas instancias sin dar una garantía universal.
Del mismo modo, el fracaso de un programa en unas pocas entradas no demuestra una separación de clases. Tal vez otro algoritmo resuelva precisamente esos casos.
La diferencia entre una conjetura aceptada como guía y un teorema demostrado debe permanecer visible. Podemos diseñar estrategias asumiendo ciertas dificultades, pero debemos indicar cuándo una conclusión depende de esa hipótesis.
No necesitamos resolver P frente a NP para trabajar con problemas combinatorios. Podemos demostrar garantías condicionales, encontrar algoritmos para casos restringidos, diseñar aproximaciones o evaluar heurísticas.
Si nuestra formulación general contiene un problema NP completo, es razonable buscar estructura adicional antes de prometer una solución exacta universalmente escalable.
Sin embargo, esa orientación no sustituye el análisis específico. Puede existir un parámetro pequeño, una distribución favorable o una tolerancia de error que cambie radicalmente la utilidad práctica.
La precisión conceptual evita tanto prometer eficiencia general sin fundamento como declarar imposible un cálculo concreto solo porque su familia tiene una clasificación difícil.
225.7. Peor caso, distribuciones y evidencia experimental
El costo de peor caso toma, para cada tamaño, la entrada que exige más recursos al algoritmo. Da una garantía uniforme, aunque esa entrada sea rara en una aplicación.
El costo promedio requiere especificar una distribución de entradas, sin la cual «promedio» no tiene un significado matemático determinado.
Una distribución uniforme sobre codificaciones tampoco tiene por qué reflejar el entorno científico. Puede asignar mucho peso a casos artificiales y poco a las estructuras observadas.
Los datos reales pueden contener modularidad, restricciones geométricas, repetición o desigualdad de grados. Un algoritmo puede aprovechar esas propiedades y superar ampliamente su comportamiento de peor caso.
También puede ocurrir que un conjunto de evaluación omita justo los casos difíciles. Una conclusión sobre eficiencia práctica exige examinar cómo se seleccionaron las instancias.
Si comparamos algoritmos, debemos mantener criterios de corrección, presupuestos y formatos compatibles. Un método que devuelve cualquier solución factible no hace la misma tarea que otro que certifica optimalidad.
Los tiempos interrumpidos requieren tratamiento explícito. Registrar el límite de tiempo como si fuera el tiempo real de resolución subestima el costo de los casos que no terminaron.
Podemos informar la fracción resuelta dentro del presupuesto, la calidad de las soluciones encontradas y las cotas disponibles. Esas medidas describen la utilidad del método sin inventar una terminación.
La aleatoriedad interna del algoritmo introduce otra fuente de variabilidad. Repetir ejecuciones con distintas semillas permite distinguir una mejora sistemática de un resultado afortunado.
Si el algoritmo puede equivocarse, debemos medir además la frecuencia y el tipo de error. Un método que siempre entrega una respuesta rápidamente, pero falla en una fracción desconocida de casos, no da la misma garantía que uno que verifica cada solución antes de devolverla.
Muchas ejecuciones con distintas semillas sobre una única instancia no estiman el desempeño sobre toda una distribución de problemas.
También debemos medir preparación, lectura y posprocesamiento cuando forman parte del uso real. Excluir etapas costosas puede ser adecuado para estudiar un núcleo algorítmico, pero debe declararse.
Una curva de tiempo frente a tamaño puede sugerir un crecimiento, aunque un rango corto rara vez distingue de manera concluyente entre varias funciones cercanas.
Las mediciones muestran constantes, variabilidad y comportamiento en distribuciones de interés, mientras que los teoremas dan garantías que no dependen de haber observado todas las entradas.
Una evaluación sólida usa ambos cuando están disponibles y evita presentar una extrapolación empírica como una cota demostrada para tamaños arbitrarios.
225.8. Parámetros pequeños y costos seudopolinómicos
Una estrategia frente a problemas difíciles es identificar un parámetro que permanezca pequeño aunque la entrada total crezca. El costo puede ser exponencial en ese parámetro y polinómico en el resto.
La cobertura de vértices es un ejemplo sencillo. Elegimos una arista con extremos u y v. Cualquier cobertura válida debe contener al menos uno de ellos.
La búsqueda se ramifica en dos. En una rama incluimos u y eliminamos sus aristas incidentes; en la otra incluimos v. En ambos casos reducimos en uno el presupuesto k de vértices permitidos.
Si no quedan aristas, hemos encontrado una cobertura. Si el presupuesto se vuelve negativo antes de cubrirlas, esa rama fracasa.
La profundidad del árbol de búsqueda no supera k antes de alcanzar el límite y cada paso crea como máximo dos ramas, de modo que obtenemos una cota del tipo dos elevado a k multiplicado por un factor polinómico del tamaño del grafo.
El algoritmo puede ser útil cuando k es pequeño. No garantiza tiempo polinómico en el tamaño total para k arbitrariamente grande, por lo que no contradice la dificultad general.
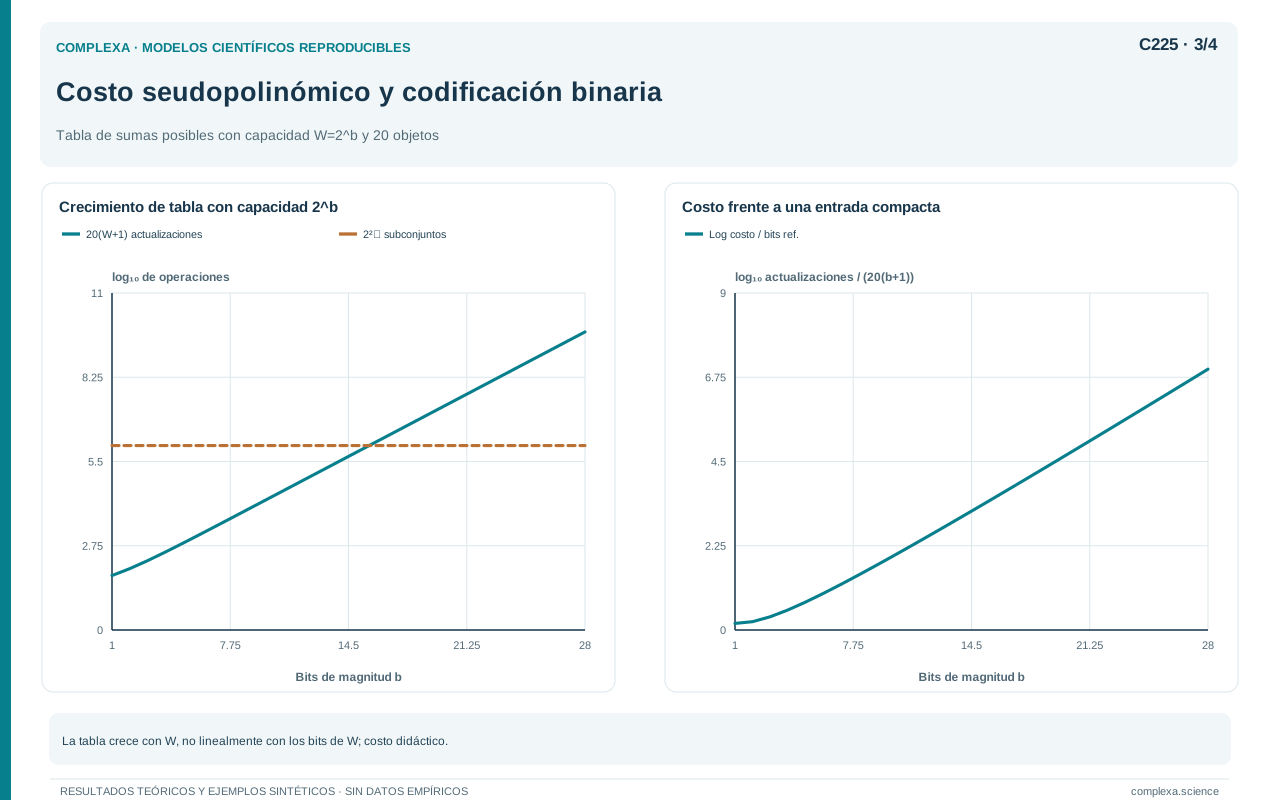
Otro fenómeno aparece en problemas con números enteros. Una programación dinámica puede recorrer todos los valores desde cero hasta una capacidad W, con un costo proporcional al número de objetos multiplicado por W.
Si W está codificado en binario, ese costo no es necesariamente polinómico en la longitud de entrada. Se llama seudopolinómico porque es polinómico en el valor numérico, que puede ser mucho mayor que su codificación.
Una capacidad de aproximadamente un millón requiere alrededor de veinte bits para representar su magnitud. Recorrer un millón de posiciones no equivale a un costo lineal en esos veinte bits.
La distinción no resta utilidad al método, que puede ser excelente si las capacidades son moderadas; solo evita clasificar mal su garantía.
Podemos verlo en una búsqueda de suma exacta. Con objetivo ocho y pesos tres, cinco y seis, mantenemos una tabla de sumas alcanzables entre cero y ocho. Al incorporar un peso, una suma queda marcada si ya era alcanzable o si puede obtenerse añadiendo ese peso a una suma anterior. Usar una copia de la tabla previa evita reutilizar el mismo objeto dentro de una actualización. El objetivo se alcanza mediante tres más cinco. La tabla contiene nueve posiciones, independientemente de cuántos subconjuntos distintos hayan conducido a ellas. Esta fusión de subproblemas explica el ahorro frente a enumerar todos los subconjuntos, pero el número de posiciones sigue dependiendo del valor del objetivo.
En modelos de sistemas complejos podemos buscar parámetros análogos, como el número de componentes acoplados, el ancho de una estructura, el horizonte efectivo o la cantidad de restricciones activas.
Sin embargo, el parámetro debe justificarse en las instancias relevantes. Declararlo pequeño sin medirlo puede convertir una ventaja teórica en una promesa impracticable.
La pregunta útil es qué propiedad limita realmente la explosión combinatoria y si esa propiedad permanece controlada en el dominio donde queremos aplicar el algoritmo.
225.9. Aproximar, buscar heurísticamente y certificar
Cuando la solución exacta es costosa, podemos cambiar la garantía. Un algoritmo de aproximación asegura, bajo condiciones especificadas, una relación demostrada entre el valor obtenido y el óptimo.
Una heurística puede encontrar buenas soluciones sin esa garantía universal. Su valor se evalúa mediante resultados empíricos, conocimiento del dominio y, cuando sea posible, cotas independientes.
Una solución cercana al mejor valor observado no demuestra cercanía al óptimo verdadero si desconocemos ese óptimo.
En un problema de minimización, cualquier solución factible da una cota superior del óptimo y una relajación válida puede dar una cota inferior.
La distancia entre ambas permite cuantificar lo que todavía no sabemos. Si coinciden, tenemos una certificación de optimalidad, aunque el procedimiento de búsqueda haya usado heurísticas.
Supongamos que encontramos una solución de costo 120 y demostramos que ninguna puede costar menos de 100. Sabemos que el óptimo está en ese intervalo.
La solución encontrada cuesta como máximo 1,2 veces el óptimo, porque el óptimo no puede bajar de cien.
Si después mejoramos la cota inferior a 115, la misma solución recibe una garantía más fuerte sin cambiar su contenido. Mejorar la evidencia puede ser tan importante como mejorar la solución.
En algunos problemas las aproximaciones también tienen límites de dificultad; renunciar a la exactitud no vuelve fácil cualquier tarea.
La tolerancia debe expresarse en una magnitud científicamente pertinente. Un pequeño error promedio puede ocultar errores grandes en casos raros que importan para la pregunta.
También podemos usar algoritmos que entregan resultados progresivos. A medida que disponen de más tiempo, mejoran soluciones o cotas; al detenerlos, informan el estado alcanzado.
Ese enfoque es adecuado cuando el presupuesto es flexible y existe una noción clara de calidad. El informe debe conservar las garantías disponibles al momento de detener la ejecución.
En investigación, la decisión entre exactitud y aproximación debe responder al objetivo. Si una conclusión cambia dentro de la brecha todavía abierta, necesitamos más cálculo o una formulación más robusta.
Si todas las soluciones compatibles con las cotas sostienen la misma conclusión, quizá el esfuerzo adicional no aporte información relevante.
Esta evaluación debe considerar también los supuestos del modelo. Certificar el óptimo de una función mal alineada con el objetivo científico no garantiza que la decisión obtenida sea pertinente para ese objetivo.
225.10. Diseñar cálculos que respondan preguntas útiles
El análisis de complejidad comienza antes de programar. Debemos definir qué es una entrada, qué respuesta necesitamos y qué garantía permitirá sostener la conclusión científica.
Después podemos identificar un procedimiento básico, calcular una cota de recursos y buscar estructura que permita mejorarla. La lentitud de ese primer procedimiento no debe confundirse con una imposibilidad demostrada.
Las reducciones ayudan a reconocer dificultades heredadas. Los parámetros y las restricciones muestran dónde puede existir una vía práctica a pesar de una clasificación general difícil.
La precisión numérica, la memoria y el formato de salida deben incluirse desde el principio. Una formulación que omite esos costos puede parecer eficiente únicamente porque desplaza trabajo fuera de la cuenta.
Las mediciones sobre instancias pertinentes permiten decidir entre implementaciones. Sus conclusiones deben limitarse al rango y a la distribución evaluados, salvo que exista una garantía teórica adicional.
Cuando usamos aproximaciones o heurísticas, necesitamos informar qué sabemos sobre la calidad de la respuesta. Una cota verificable puede convertir un resultado provisional en evidencia suficiente para una decisión.
La clasificación P o NP describe problemas computacionales formalizados, de modo que no sirve como escala de complejidad de organismos, sociedades o experiencias. Aplicarla a un modelo exige especificar la tarea correspondiente.
Tampoco debemos equiparar dificultad de optimización con complejidad del objeto optimizado. Un patrón sencillo puede resultar difícil de encontrar dentro de un espacio grande, mientras que una estructura extensa puede generarse mediante reglas eficientes.
La relación entre descripción y producción seguirá siendo relevante. Una salida puede tener un programa breve que tarda mucho, o un programa más largo que la imprime rápidamente.
El siguiente capítulo usará esa tensión para presentar profundidad lógica y complejidad efectiva. Ambas intentan distinguir organización de simple cantidad de información, pero necesitan definiciones distintas y cautela al transformarse en medidas empíricas.
El resultado de este recorrido es una disciplina de formulación, que consiste en hablar del costo de una tarea bajo condiciones explícitas. Esa precisión permite reconocer límites reales y descubrir simplificaciones que una etiqueta general de dificultad habría ocultado.
Referencias
- Hartmanis, J., y Stearns, R. E. (1965). On the Computational Complexity of Algorithms. Transactions of the American Mathematical Society, 117, 285–306. DOI: 10.1090/S0002-9947-1965-0170805-7.
- Cook, S. A. (1971). The Complexity of Theorem-Proving Procedures. Proceedings of the Third Annual ACM Symposium on Theory of Computing, 151–158. DOI: 10.1145/800157.805047.
- Karp, R. M. (1972). Reducibility among Combinatorial Problems. En Complexity of Computer Computations, 85–103. DOI: 10.1007/978-1-4684-2001-2_9.
- Clay Mathematics Institute. P vs NP. Registro del problema y descripción oficial. Consultado el 21 de octubre de 2026. Página institucional.