Módulo 24. Experimentos computacionales, muestreo y documentación
239.1. Aprender una respuesta para ahorrar evaluaciones
Un simulador puede ser demasiado costoso para ejecutar todas las configuraciones que requiere un análisis. Optimizar una decisión, propagar incertidumbre o estimar sensibilidad puede necesitar miles de evaluaciones, mientras una sola ejecución tarda horas. Un modelo sustituto aproxima la relación entre entradas y salidas a partir de un conjunto limitado de ejecuciones del simulador original.
El ahorro depende de que el sustituto sea barato de evaluar y suficientemente preciso para la tarea. No necesita reproducir todos los detalles internos si la pregunta es sobre una salida concreta. Sin embargo, aproximar una media no garantiza aproximar una probabilidad extrema, una derivada o el lugar de un óptimo. La finalidad debe definir qué significa precisión suficiente.
Podemos escribir el simulador determinista como una función f y el sustituto como una función aproximada. La diferencia entre ambas es el error de emulación. Si f representa a su vez un sistema empírico, hay otra diferencia entre el simulador y ese sistema. Un sustituto exacto de un modelo inadecuado reproduce con fidelidad esa inadecuación.
La tradición de experimentos computacionales estudia cómo elegir entradas y usar sus salidas para predecir el comportamiento de un código. Sacks y colaboradores desarrollaron para este problema un enfoque estadístico que incluye modelos de proceso estocástico aplicados a respuestas deterministas [1]. La aleatoriedad del emulador puede expresar desconocimiento de una función, sin afirmar que el simulador tenga ruido interno.
Los sustitutos incluyen polinomios, interpoladores, procesos gaussianos, árboles, redes y aproximaciones basadas en mecanismos simplificados. Su conveniencia depende de la dimensión, la suavidad, los datos disponibles y las propiedades que debemos conservar. No hay una familia universalmente superior. Un modelo muy flexible puede ajustarse bien y comportarse mal en regiones poco exploradas.
El conjunto de entrenamiento debe reflejar el dominio de uso. Si solo contiene configuraciones cercanas a un punto, no respalda predicciones globales. Si fue seleccionado para optimizar, puede concentrarse en regiones prometedoras y dejar otras casi vacías. La distribución de entradas usada después para propagar incertidumbre debe compararse con la cobertura que realmente recibió el emulador.
Este capítulo resolverá ejemplos pequeños para mostrar qué se gana y qué puede perderse. Examinaremos interpolación, incertidumbre predictiva, ruido de simulación, validación y diseño secuencial. La pregunta central será siempre qué evidencia permite sustituir el modelo original por una aproximación en una decisión concreta.
239.2. Ajustar perfectamente no identifica la función
Consideremos un simulador cuya respuesta es el cuadrado de x en el intervalo entre cero y uno. Al evaluarlo en cero, una mitad y uno obtenemos cero, un cuarto y uno. Un polinomio cuadrático interpolador recupera exactamente la función porque sabemos que pertenece a esa familia. Sin ese conocimiento, los tres puntos admiten muchas funciones distintas.
Construyamos otra función sumando al cuadrado de x ocho veces el producto de x, x menos una mitad y x menos uno. El término añadido se anula en los tres puntos observados. Por tanto, ambas funciones producen exactamente los mismos datos de entrenamiento y ninguna comparación hecha solo sobre esos puntos puede distinguirlas.
En un cuarto, la primera función vale cero coma cero seis dos cinco y la segunda cero coma cuatro tres siete cinco. La diferencia es tres octavos. En tres cuartos, la primera vale cero coma cinco seis dos cinco y la segunda cero coma uno ocho siete cinco. El ajuste perfecto en entrenamiento coexiste con diferencias importantes en el interior.
Incluso las derivadas pueden discrepar en un punto observado. En una mitad, la derivada de f es uno y la de g es menos uno. Si usamos el sustituto para optimización o sensibilidad local, no basta con comprobar los valores de entrenamiento.
El ejemplo muestra que toda interpolación descansa en supuestos sobre regularidad o familia funcional; los interpoladores no son por ello inútiles. Si sabemos que la función es cuadrática, tres puntos distintos bastan para identificarla. Si admitimos oscilaciones de grado superior, necesitamos más información o una restricción que las haga menos plausibles.
En problemas reales, esa información puede proceder de mecanismos, límites, monotonía, conservación o conocimiento de escalas. Incorporarla puede mejorar la eficiencia y evitar predicciones imposibles, aunque también puede introducir sesgo si el supuesto es incorrecto. Debemos tratar las restricciones como supuestos verificables del modelo sustituto.
La validación necesita puntos nuevos cuya selección permita examinar el uso previsto. Un punto en un cuarto distinguiría las dos funciones del ejemplo; otro en una ubicación donde coinciden no resolvería la diferencia. Por eso diseñar la validación exige pensar qué comportamientos alternativos siguen siendo compatibles con los datos disponibles.
239.3. Interpolación y errores que pueden calcularse
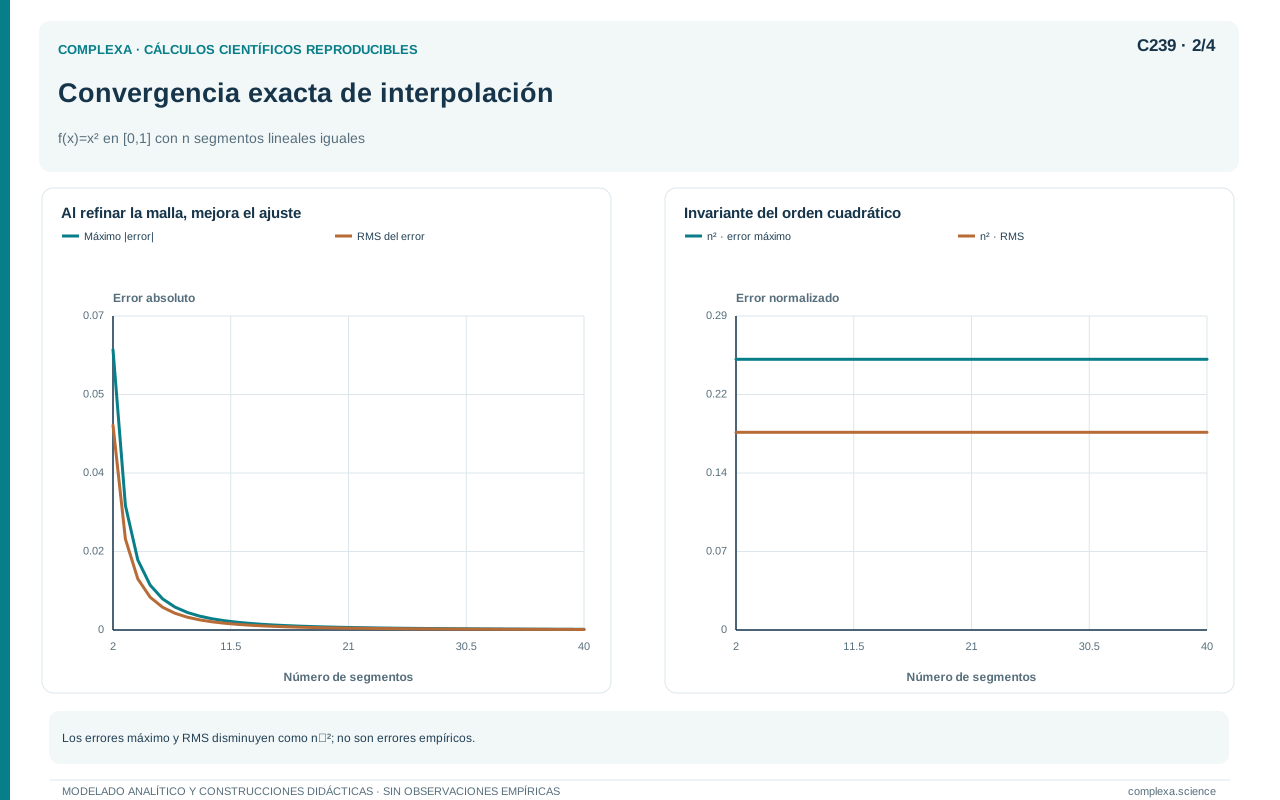
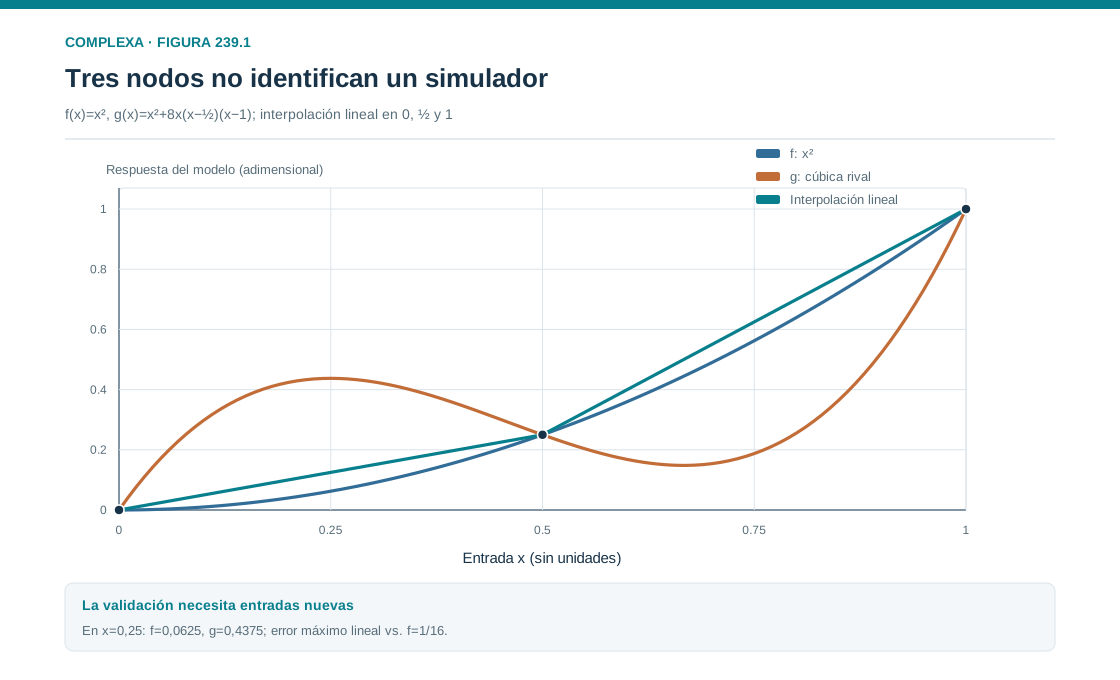
Una aproximación sencilla conecta mediante segmentos rectos los valores observados del cuadrado en cero, una mitad y uno. El resultado coincide exactamente en los nodos, pero sobreestima la función dentro de cada intervalo porque el cuadrado es convexo. Podemos calcular el error sin recurrir a un conjunto aleatorio de pruebas.
Entre dos nodos a y b, el interpolador lineal del cuadrado menos la función original es el producto de x menos a por b menos x. Ese producto es no negativo y alcanza en el punto medio su máximo, que vale el cuadrado de la longitud del intervalo dividido por cuatro.
Con intervalos de longitud una mitad, el error máximo es un dieciseisavo, igual a cero coma cero seis dos cinco. En un cuarto, el interpolador vale un octavo mientras el valor exacto es un dieciseisavo. Conocer una cota uniforme da una garantía distinta de observar un error promedio pequeño en unos pocos puntos.
Si X es uniforme entre cero y uno, la integral exacta de la función es un tercio. La integral del interpolador equivale a sumar áreas de trapecios y vale tres octavos. El sesgo de la media aproximada es un veinticuatroavo, aproximadamente cero coma cero cuatro uno siete. Generar millones de entradas y evaluar solo el interpolador no elimina ese sesgo.
La cota uniforme también limita el error absoluto de la esperanza, que bajo cualquier distribución con soporte en el dominio no puede superar el máximo error puntual. La cota puede ser conservadora, pero deja claro qué parte del error permanece aunque el promedio Monte Carlo sea muy preciso. Aumentar muestras del sustituto reduce el error de integración y deja intacta su discrepancia con f.
Para probabilidades de superar un umbral, una cota puntual tiene otra interpretación. Si el error es como máximo epsilon, las clasificaciones solo pueden discrepar donde la respuesta verdadera esté a distancia no mayor que epsilon del umbral. La probabilidad de esa región limita el error de probabilidad. Si mucha masa está cerca del umbral, un error de aproximación pequeño puede cambiar muchas clasificaciones.
No siempre disponemos de cotas exactas. Aun así, el ejemplo orienta la validación hacia los errores en las regiones y respuestas que sostienen la conclusión. Una medida global de ajuste puede ser suficiente para una media y claramente insuficiente para un umbral estrecho. La precisión debe juzgarse según la tarea final, sin limitarse a una puntuación general.
239.4. Un proceso gaussiano como modelo de la función
Un proceso gaussiano especifica distribuciones normales conjuntas para los valores de una función en cualquier conjunto finito de entradas. Se define mediante una función de media y una función de covarianza. Esta última describe cómo se relacionan valores en puntos distintos y expresa supuestos sobre escala, suavidad y semejanza.
Tras observar ejecuciones del simulador, condicionamos esa distribución para obtener predicciones en puntos nuevos. La media condicionada es la aproximación puntual y la varianza condicionada resume la incertidumbre dentro del modelo probabilístico elegido. Rasmussen y Williams desarrollan las fórmulas de regresión de procesos gaussianos [2]; aquí examinaremos un caso de una sola observación para hacer visible su significado.
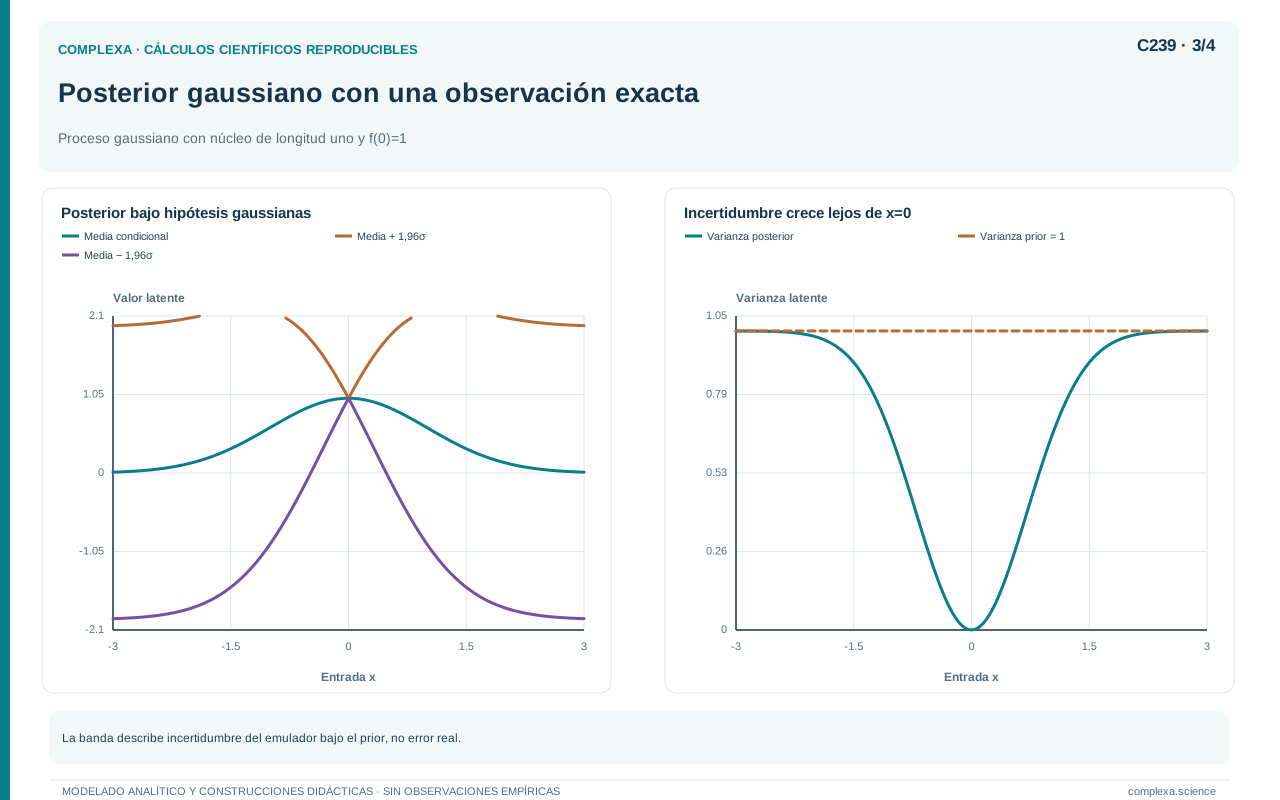
Supongamos media previa cero y covarianza entre dos entradas igual a la exponencial del negativo de la mitad de su distancia al cuadrado. La varianza previa en cualquier punto es uno. Observamos sin ruido que la función vale uno en cero. La covarianza entre el punto nuevo x y cero determina cuánto se transmite esa observación.
En cero, la media condicionada vale uno y la varianza cero, así que el modelo interpola la observación exacta. En uno, la media es aproximadamente cero coma seis cero seis cinco y la varianza cero coma seis tres dos uno. Lejos de cero, la media regresa hacia cero y la varianza hacia uno, porque la covarianza con el punto observado se vuelve pequeña.
Estas cifras se deducen solo de la distribución previa y de la observación. Con otra longitud de correlación, la propagación sería distinta. Una longitud grande supone cambios lentos y transmite información a mayor distancia; una pequeña permite variaciones rápidas y reduce esa influencia. Estimar esa longitud con pocos puntos puede ser difícil.
Con varias observaciones, las expresiones usan una matriz de covarianzas y exigen resolver sistemas lineales. La implementación debe cuidar el condicionamiento numérico y los puntos casi duplicados. Es preferible resolver los sistemas apropiados que formar explícitamente una inversa por rutina, porque una matriz mal condicionada puede distorsionar tanto medias como varianzas.
Un intervalo gaussiano estrecho indica una buena aproximación solo si los supuestos del emulador son adecuados, porque de ellos depende su calibración. Si el simulador tiene una discontinuidad y el modelo impone suavidad excesiva, puede producir una predicción segura pero equivocada. La evaluación en ejecuciones nuevas sigue siendo necesaria.
Un proceso gaussiano sin restricciones puede asignar probabilidad a valores negativos aunque la respuesta sea necesariamente positiva. Transformar la salida, por ejemplo mediante un logaritmo cuando es estrictamente positiva, cambia el problema de regresión. Al volver a la escala original, exponenciar la media transformada no equivale en general a calcular la media de la respuesta. La transformación puede ser útil, pero sus predicciones y resúmenes deben interpretarse y validarse en la escala pertinente.
239.5. Ruido de simulación y respuesta media
En un simulador estocástico, repetir la misma entrada produce salidas distintas. El emulador puede buscar la media condicionada, una varianza, un cuantil o toda una distribución. Debemos decidir cuál de esas funciones aprende. Ajustar una superficie a realizaciones individuales sin representar su ruido puede confundir la fluctuación interna con cambios sistemáticos de la respuesta.
Ankenman, Nelson y Staum desarrollaron el kriging estocástico, que distingue la incertidumbre interna de la simulación de la incertidumbre sobre la superficie de respuesta [3]. Esa separación permite diseñar tanto las ubicaciones de entrada como el número de réplicas. Las dos fuentes no se reducen del mismo modo; las nuevas réplicas precisan la estimación en un punto, mientras que las nuevas ubicaciones informan sobre regiones distintas.
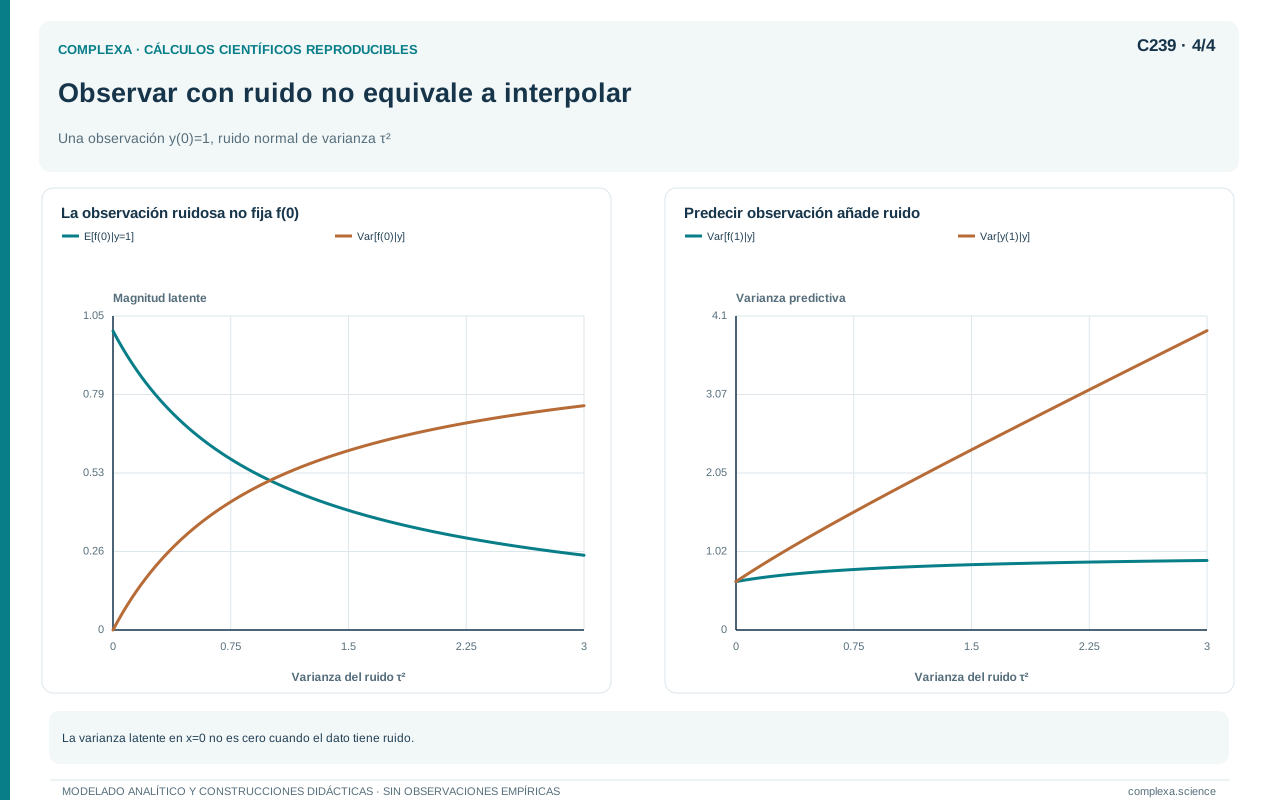
Volvamos al ejemplo gaussiano de una observación en cero, ahora con ruido independiente de media cero y varianza conocida de un cuarto. El valor observado sigue siendo uno, pero ya no conocemos exactamente la función latente en ese punto. La varianza de la observación suma uno de la función y un cuarto del ruido.
La media condicionada de la función latente en cero es uno dividido por uno coma veinticinco, igual a cero coma ocho. Su varianza es uno menos el inverso de uno coma veinticinco, igual a cero coma dos. El emulador no interpola el dato porque admite que parte de su valor proceda del ruido.
Si predecimos una nueva observación ruidosa en cero, debemos añadir la varianza del ruido nuevo. La varianza predictiva pasa de cero coma dos para la función latente a cero coma cuarenta y cinco para la observación. Confundir ambas cantidades produce intervalos demasiado estrechos cuando la pregunta es sobre futuras realizaciones del simulador.
Con R réplicas independientes en una entrada, la media observada tiene una varianza de ruido igual a la varianza individual dividida por R. Si esa varianza cambia con la entrada, el modelo debe reflejar esa heterogeneidad. Una región congestionada puede mostrar fluctuaciones mucho mayores que otra estable; imponer el mismo ruido en todas partes puede asignar mal la incertidumbre.
Las réplicas también pueden estar correlacionadas si se usan números aleatorios comunes entre entradas. Entonces la covarianza del ruido entre medias no es necesariamente diagonal. Las ventajas de emparejar contrastes no autorizan a ignorar esa estructura al ajustar el emulador. El diseño de simulación y el modelo estadístico deben describir la misma relación entre observaciones.
239.6. Validar donde se utilizará la aproximación
La validación compara el sustituto con ejecuciones que no se usaron para ajustarlo. Su diseño debe representar el uso previsto y examinar regiones vulnerables. Si todas las pruebas están muy cerca de puntos de entrenamiento, pueden subestimar el error en huecos grandes. Si solo incluyen extremos, pueden dejar sin estudiar una transición interior importante.
En simuladores estocásticos, repartir réplicas de una misma entrada entre entrenamiento y prueba evalúa la predicción en ubicaciones ya conocidas. Eso puede ser pertinente para una tarea, pero no prueba que el emulador interpole bien en ubicaciones nuevas. Para evaluar la interpolación debemos reservar configuraciones completas, con todas sus réplicas, y comparar la respuesta media con precisión suficiente.
El error cuadrático medio resume discrepancias promedio en una distribución de puntos. El error máximo observado informa sobre el peor punto probado, pero no es necesariamente una cota uniforme. Los errores relativos pueden volverse enormes o indefinidos cerca de respuestas nulas. Las métricas elegidas deben conservar unidades y responder a las tolerancias de la aplicación.
Una validación puede parecer buena porque la respuesta varía mucho en términos absolutos. Un error de una unidad sería pequeño respecto de una salida entre cero y mil, pero podría cambiar una decisión basada en distinguir cien de ciento uno. Conviene evaluar también errores de contrastes, clasificación de umbrales o ubicación de óptimos, según el uso final.
Si el emulador produce intervalos, podemos examinar la cobertura en datos nuevos y comparar errores con anchuras predichas. La evaluación debe distinguir valores latentes de observaciones ruidosas. Un intervalo para la media condicionada no tiene por qué contener cada realización individual. Una cobertura deficiente puede proceder tanto de un modelo de función inadecuado como de una representación incorrecta del ruido.
La selección de hiperparámetros y familias usa información de los datos. Si probamos muchas opciones y elegimos la que mejor funciona en un mismo conjunto de validación, ese conjunto participa en la selección. Una evaluación final independiente permite estimar el rendimiento posterior a esa elección. Cuando el presupuesto limita esa separación, debemos declarar el procedimiento y moderar el alcance de la conclusión.
Los fallos también son datos sobre el dominio. Una ejecución que no converge numéricamente no debe reemplazarse silenciosamente por una salida plausible del emulador. Puede indicar una región inadmisible, una dificultad del código o un régimen no representado. Clasificar el fallo y decidir si el sustituto puede usarse allí forma parte de la validación, especialmente cuando la optimización tiende a buscar fronteras.
239.7. Elegir nuevas ejecuciones de manera secuencial
Un diseño inicial distribuye evaluaciones por el dominio y permite ajustar una primera aproximación. Después podemos elegir nuevos puntos según lo aprendido. La selección secuencial intenta que cada ejecución costosa resuelva una incertidumbre relevante.
Si el objetivo es aproximar globalmente una función, pueden interesar regiones con gran incertidumbre predictiva o errores de validación grandes. Si el objetivo es estimar una esperanza, importa también cuánta probabilidad de entrada reciben esas regiones. Si buscamos un óptimo, necesitamos equilibrar lugares prometedores con zonas poco conocidas donde podría existir una alternativa mejor.
Una selección dirigida únicamente al mayor valor predicho puede quedar atrapada en errores del emulador. Una aproximación que sobreestima una región atraerá más búsqueda, mientras otra región prometedora pero subestimada puede quedar ignorada. Incorporar incertidumbre y reservar exploración ayuda, aunque no elimina la dependencia de los supuestos sobre la función.
Para un evento definido por un umbral, suelen ser informativos los puntos donde la respuesta podría caer a cualquiera de sus lados. Sin embargo, una frontera incierta situada en una región de probabilidad casi nula puede contribuir poco a la probabilidad total. La regla de selección debe combinar dificultad local y relevancia para la cantidad que queremos estimar.
En simuladores estocásticos hay que elegir además entre evaluar un punto nuevo y añadir réplicas a uno existente. Si el ruido impide conocer su media, repetir puede ser útil. Si ya conocemos bien los puntos disponibles pero hay grandes huecos, conviene explorar. Las varianzas internas y la incertidumbre sobre la superficie ayudan a distinguir ambas necesidades.
Cada etapa debe registrar qué criterio eligió los puntos y qué información estaba disponible. Así podemos reconstruir la diferencia entre diseño inicial y adaptación posterior. Si usamos una región de validación para decidir nuevas evaluaciones, deja de ser una prueba completamente ajena al ajuste; necesitamos reconocer su nuevo papel y, cuando corresponda, reservar una comprobación adicional.
La regla de parada debe tener en cuenta la precisión útil y el costo. Podemos detenernos cuando los errores relevantes estén por debajo de una tolerancia comprobada o cuando nuevas ejecuciones aporten poco frente al presupuesto restante. Como una varianza predictiva pequeña puede ser engañosa si el modelo de emulación está mal especificado, la parada debe combinar diagnósticos internos con evidencia del simulador original.
239.8. Propagar la incertidumbre del propio sustituto
Una vez ajustado el emulador, podemos evaluar miles de entradas con poco costo. Esa facilidad puede crear una ilusión de certeza, porque el error de Monte Carlo se vuelve pequeño mientras el error de aproximación permanece. Debemos conservar ambas fuentes cuando la conclusión depende de diferencias comparables al error del sustituto.
Una estrategia probabilística considera distintas funciones compatibles con el emulador ajustado y calcula la cantidad de interés para cada una. La variación entre resultados refleja la incertidumbre de emulación bajo ese modelo. Dentro de cada función puede haber además error de integración. Separar ambas fuentes permite examinar si conviene aumentar las muestras baratas o solicitar más evaluaciones costosas.
Las predicciones en entradas distintas están correlacionadas. Si generamos valores predictivos independientes punto por punto, sin tener en cuenta la covarianza del proceso, no obtenemos una función coherente del emulador. Eso puede distorsionar la incertidumbre de integrales, diferencias y máximos. Para propagar incertidumbre funcional debemos respetar las relaciones conjuntas que el modelo especifica.
Un ejemplo conceptual es un desplazamiento desconocido que afecta de manera semejante a todo el dominio. Promediar muchas entradas no elimina ese desplazamiento, porque sus errores están correlacionados. Tratar cada error como independiente haría que la incertidumbre de la media disminuyera artificialmente.
En análisis de sensibilidad, el sustituto debe conservar interacciones y variación relevante. Una aproximación aditiva puede ajustar razonablemente una media y eliminar una interacción importante. Si calculamos índices sobre ella, describiremos la sensibilidad del sustituto. Comparar predicciones y contrastes en puntos diseñados para detectar interacciones ayuda a comprobar si esa descripción corresponde al simulador.
Las derivadas requieren validación propia. El ejemplo de las dos funciones que coincidían en tres puntos mostró pendientes opuestas en el centro. Sin condiciones adicionales de regularidad, un error pequeño en los valores no implica necesariamente un error pequeño en las derivadas. Usar gradientes del emulador para optimizar o interpretar mecanismos exige revisar esa propiedad específica.
La incertidumbre de los hiperparámetros también puede ser relevante cuando hay pocos datos. Fijarlos en una estimación puntual suele simplificar el cálculo, pero puede omitir variación sobre escala y suavidad. Si incorporamos esa incertidumbre o la evaluamos mediante alternativas, debemos describirlo. Ninguna banda predictiva debe presentarse como universal sin indicar qué parámetros y supuestos se trataron como conocidos.
239.9. Emulación, calibración y discrepancia del modelo
Emular un código es aproximar sus salidas. Calibrarlo es usar observaciones para aprender valores de entradas desconocidas. Evaluar su adecuación requiere comparar sus predicciones con el sistema de interés. Las tres tareas pueden integrarse, pero sus errores tienen orígenes diferentes y no deben reunirse bajo una sola etiqueta de incertidumbre.
Kennedy y O’Hagan desarrollaron un enfoque bayesiano de calibración que incluye incertidumbre paramétrica y discrepancia entre modelo y observaciones [4]. Aquí interesa que incluso la mejor configuración de un simulador puede no reproducir completamente el sistema. Un emulador preciso facilita el cálculo, pero no elimina esa discrepancia estructural.
Podemos escribir una observación real como la salida del simulador en ciertos parámetros, más una discrepancia y un error de observación. Si reemplazamos el simulador por un sustituto, aparece además error de emulación. Cada término necesita una interpretación y datos o supuestos que lo sostengan. Hacer todos los términos muy flexibles puede dificultar identificar qué explica cada diferencia.
Supongamos, para ver la ambigüedad, que el simulador predice theta por x y que permitimos una discrepancia a por x. La respuesta total depende solamente de theta más a. Aunque observemos muchos valores de x sin ruido, esos datos no separan ambas pendientes. Necesitamos información adicional o restricciones para identificar el parámetro del simulador y la discrepancia.
Un emulador más preciso no resuelve esta dificultad, porque conocer exactamente la función del simulador deja intacta la ambigüedad. Atribuir toda diferencia a parámetros puede producir valores que compensan errores estructurales; atribuirla toda a discrepancia puede dejar parámetros poco informados. La calibración debe examinar qué cantidades pueden aprenderse y qué predicciones siguen siendo útiles.
Los modelos de distinta fidelidad son otra fuente de información. Una versión barata puede usar una discretización gruesa o simplificaciones del mecanismo. Si su relación con la versión costosa es estable y aprendible, podemos combinar muchas evaluaciones baratas con pocas caras. Esa relación debe comprobarse, porque una aproximación gruesa puede omitir precisamente el régimen o umbral que interesa.
La validación final debe dejar claro el referente. Comparar el sustituto con el código evalúa la emulación; comparar el código o su sustituto corregido con datos independientes evalúa la predicción empírica bajo los supuestos adoptados. Una cadena de aproximaciones puede ser útil, pero cada enlace necesita su propia evidencia.
239.10. Decidir cuándo merece la pena sustituir
Construir un sustituto tiene un costo inicial, porque hay que ejecutar el modelo, organizar los datos, ajustar la aproximación y validarla. El ahorro aparece cuando las evaluaciones posteriores evitadas superan ese gasto y la precisión es adecuada. Para una consulta aislada a un simulador rápido, desarrollar un emulador complejo puede no tener sentido. La comparación de alternativas debe incluir el mantenimiento posterior, especialmente cuando cambian versiones, dominios o preguntas y hay que generar nuevas ejecuciones de referencia.
En un presupuesto ilustrativo, si una ejecución cuesta una hora, cien puntos de entrenamiento y treinta de validación requieren ciento treinta horas de simulación. Si después necesitamos dos mil evaluaciones dentro del mismo dominio, el ahorro potencial puede ser importante. Esas horas no incluyen el ajuste, el mantenimiento ni nuevas validaciones, costos que también deben contarse antes de afirmar eficiencia.
El dominio de validez puede cambiar con una nueva versión del código. Modificar una regla, una discretización o una salida rompe la correspondencia con los datos de entrenamiento anteriores. Debemos identificar qué versiones generaron cada ejecución y decidir si el sustituto sigue siendo pertinente. Reutilizarlo sin revisar esa correspondencia puede producir resultados reproducibles de un simulador que ya no existe en esa forma.
También puede cambiar el uso sin que cambie el código. Un emulador validado para promedios en la región central puede resultar insuficiente cuando una nueva pregunta se concentra en extremos. En ese caso, el entrenamiento sigue siendo correcto como registro, pero la evidencia de adecuación ya no cubre la tarea nueva. Revisar la finalidad evita reutilizar una aprobación técnica fuera del contexto que la justificó.
Un paquete reproducible conserva entradas, salidas, versiones, semillas cuando correspondan, transformaciones, hiperparámetros y puntos de validación. También registra la cantidad que el emulador aproxima y sus limitaciones conocidas. Estos elementos permiten distinguir un fallo del sustituto de un cambio del código o de una modificación en la distribución de entradas.
Conservar unas pocas ejecuciones de referencia permite comprobar, antes de iniciar análisis extensos, que las entradas nuevas siguen correspondiendo en formato, unidades y transformación a las que el sustituto recibió durante su construcción.
Los ejemplos del capítulo mostraron tres advertencias concretas. El ajuste perfecto no identificó la función entre observaciones. Millones de evaluaciones baratas no eliminaron el sesgo de un interpolador. Una varianza predictiva para la media latente no representó la dispersión de nuevas observaciones ruidosas. Cada advertencia señala una comprobación que puede incorporarse al trabajo.
Un sustituto útil conserva lo necesario para una tarea y declara dónde necesita apoyo del simulador original. Puede acelerar la exploración, la propagación y las decisiones, mientras las evaluaciones costosas se reservan para validar y resolver regiones importantes. Ese reparto funciona mientras la precisión se compruebe para el objetivo y dentro del dominio validado. El caso del siguiente capítulo reunirá estas ideas en la reproducción y revisión crítica de un resultado computacional.
Referencias
- Sacks, J., Welch, W. J., Mitchell, T. J., y Wynn, H. P. (1989). Design and analysis of computer experiments. Statistical Science, 4(4), 409–423. DOI: 10.1214/ss/1177012413.
- Rasmussen, C. E., y Williams, C. K. I. (2006). Gaussian processes for machine learning. MIT Press, capítulo 2. Texto de los autores.
- Ankenman, B., Nelson, B. L., y Staum, J. (2010). Stochastic kriging for simulation metamodeling. Operations Research, 58(2), 371–382. DOI: 10.1287/opre.1090.0754. Publicación anticipada en línea: 2009.
- Kennedy, M. C., y O’Hagan, A. (2001). Bayesian calibration of computer models, con discusión. Journal of the Royal Statistical Society: Series B, 63(3), 425–464. DOI: 10.1111/1467-9868.00294.
Nota de los ejemplos. Las funciones interpoladas, los cálculos gaussianos de una observación y la ambigüedad entre pendientes son construcciones propias. El presupuesto de ejecución es ilustrativo; no corresponde a horas de cálculo consumidas para este capítulo.