Módulo 24. Experimentos computacionales, muestreo y documentación
240.1. Una cifra reproducida y una conclusión por revisar
Reproducir un resultado computacional significa recuperar una cantidad mediante un procedimiento suficientemente especificado. Esa comprobación es necesaria, pero no demuestra que la conclusión sobreviva a cambios razonables del modelo. Un cálculo correcto y repetible puede ser sensible a un supuesto que parecía secundario. Este caso separará esas cuestiones mediante un experimento pequeño y verificable.
El capítulo 232 comparó dos capacidades de procesamiento de pedidos. Con las mismas llegadas en cada par de trayectorias, aumentar la capacidad de diez a doce redujo la cola media en aproximadamente cinco coma doscientos cuarenta y tres pedidos. Repetiremos exactamente ese diseño y después cambiaremos la dependencia temporal de las llegadas sin alterar su distribución diaria.
Primero preguntaremos, en términos estrictamente computacionales, si el nuevo programa recupera las medias y diferencias anteriores. Después formularemos una pregunta sustantiva dentro del modelo (¿sigue siendo la misma la capacidad preferida cuando valoramos conjuntamente cola y costo de capacidad?), que necesita un criterio adicional ausente en la simple comparación de colas.
Usaremos una función de costo didáctica, declarada antes de calcular el contraste entre modelos. La cola media tendrá peso uno y cada unidad adicional de capacidad sobre diez tendrá peso tres. No se trata de precios reales ni de una recomendación empresarial; el criterio permite mostrar cómo una decisión depende tanto de las reglas dinámicas como de la valoración de sus consecuencias.
En el modelo original, cada día recibe independientemente un lote de dieciséis pedidos con probabilidad una mitad. En la alternativa, los días se agrupan en pares y, con igual probabilidad, los dos días de un par reciben lote o ninguno lo recibe. Los pares son independientes entre sí. La demanda media diaria sigue siendo ocho.
Además de simular doscientas réplicas por modelo, calcularemos las expectativas mediante una recursión exacta sobre estados. Así podremos distinguir el error de Monte Carlo de un cambio real en las implicaciones de las reglas. El ejemplo es lo bastante sencillo para disponer de esa referencia, aunque muchos simuladores reales no la permitan.
La literatura sobre verificación y validación distingue la corrección de una implementación de su adecuación para un propósito [1]. Los trabajos sobre estudios de simulación y reproducibilidad también insisten en especificar objetivos, generación y análisis [2,3]. Aplicaremos esas ideas a un caso propio, cuyos valores numéricos proceden del programa incluido y de su cálculo exacto complementario.
240.2. Especificación del experimento
El sistema comienza sin pedidos pendientes y funciona durante treinta días. Cada jornada recibe primero los pedidos y después procesa hasta su capacidad; lo que no alcanza a procesar queda pendiente para el día siguiente. No hay cancelaciones, prioridades, tiempos individuales ni cambios de capacidad dentro de una trayectoria. La salida principal es el promedio de los treinta saldos al cierre.
Si Q es el saldo anterior, A la llegada y C la capacidad, la atención diaria es el mínimo entre Q más A y C. El saldo nuevo es la suma disponible menos lo atendido. Esta regla conserva pedidos y evita saldos negativos. Equivale a tomar el máximo entre cero y Q más A menos C.
Comparamos únicamente las capacidades diez y doce. Dentro de cada réplica, ambas reciben exactamente las mismas llegadas. Las diferencias se calculan por réplica antes de promediarlas, de modo que el error estándar incorpora el emparejamiento. Las semillas de las doscientas réplicas se definen a partir de su identificador.
Para recuperar el experimento original, la semilla usa los primeros ocho bytes de un resumen SHA256 de una etiqueta fija con el número de réplica, interpretados como entero sin signo en orden de bytes grande. La etiqueta y el procedimiento aparecen en el programa. Así no dependemos de una selección manual de semillas ni del orden en que se ejecutan los escenarios.
Cada réplica genera treinta uniformes. El modelo independiente usa una por día. La alternativa de bloques usa una uniforme por par y repite su resultado durante ambos días, por lo que necesita las primeras quince. Este acoplamiento entre modelos facilita reproducir entradas, pero cada modelo conserva su propia ley temporal.
El horizonte y la fase de los bloques están fijados; el primer bloque corresponde a los días uno y dos, el segundo a los días tres y cuatro, etcétera. No afirmamos que la alternativa sea un proceso estacionario respecto de cualquier desplazamiento de un día; la construcción describe exactamente el entorno simulado con esa fase inicial.
El presupuesto y las respuestas se fijan antes de revisar los resultados. Además de la cola media, calculamos la probabilidad de que el máximo supere cuatro pedidos. Esta segunda respuesta permitirá comprobar identidades exactas, aunque el criterio de decisión usará la cola media y el costo de capacidad. Así evitamos que un resultado parezca responder todas las preguntas.
240.3. Recuperar el resultado original
La nueva ejecución reproduce las cifras del capítulo 232. La cola media estimada con capacidad diez es nueve coma ochocientos cincuenta y seis; con capacidad doce es cuatro coma seiscientos trece. La diferencia de doce menos diez es menos cinco coma doscientos cuarenta y tres, con un error estándar de Monte Carlo de aproximadamente cero coma doscientos ochenta y dos.
| Modelo de llegadas | Media con C=10 | Media con C=12 | Diferencia C=12−C=10 | Error estándar |
|---|---|---|---|---|
| Independientes | 9,8560 | 4,6133 | −5,2427 | 0,2818 |
| Bloques de dos | 14,8507 | 7,4000 | −7,4507 | 0,4318 |
La primera fila verifica la continuidad entre capítulos. El programa usa la misma regla, semillas, horizonte y respuesta. Recuperar solo una cifra redondeada sería una comprobación débil; durante la auditoría también contrastamos trayectorias y resúmenes completos. La comparación puede detectar cambios inadvertidos de orden de eventos, denominadores o inicialización.
Bajo llegadas independientes, la reducción estimada respecto de la cola con capacidad diez es aproximadamente cincuenta y tres coma diecinueve por ciento. Esa proporción describe las medias estimadas de este diseño; no implica que cada trayectoria mejore exactamente en ese porcentaje ni que otras distribuciones de llegadas produzcan la misma reducción.
El error estándar se calcula a partir de doscientas diferencias entre trayectorias. No trata los seis mil saldos diarios como observaciones independientes, porque los saldos de una trayectoria dependen de lo ocurrido antes; la unidad que se repite independientemente es la réplica completa. Ignorar esa estructura podría producir una incertidumbre artificialmente pequeña.
La coincidencia de resultados no evalúa todavía el realismo del modelo; solo confirma que las instrucciones producen las mismas salidas en la ejecución realizada. Si la regla omitiera un mecanismo importante, ambas implementaciones podrían coincidir y conservar esa omisión. Reproducibilidad y adecuación son, pues, complementarias.
También debemos distinguir entre repetir el mismo diseño y obtener una nueva muestra independiente. Usar las mismas semillas reproduce los mismos valores aleatorios y, por tanto, el mismo error de Monte Carlo. Para estudiar la variabilidad entre ejecuciones independientes necesitaríamos otra serie definida de semillas. Aquí la referencia exacta permitirá evaluar el error sin confundir esa tarea con la reproducción inicial.
La segunda fila ya muestra que la dependencia temporal cambia las magnitudes. Ambas capacidades tienen colas mayores bajo bloques. La reducción absoluta al aumentar capacidad también es mayor, aunque la reducción porcentual estimada es cercana a cincuenta coma diecisiete por ciento. Porcentajes y diferencias absolutas pueden dar impresiones distintas; el criterio de decisión debe aclarar cuál es pertinente.
240.4. Conservar la media y cambiar la secuencia
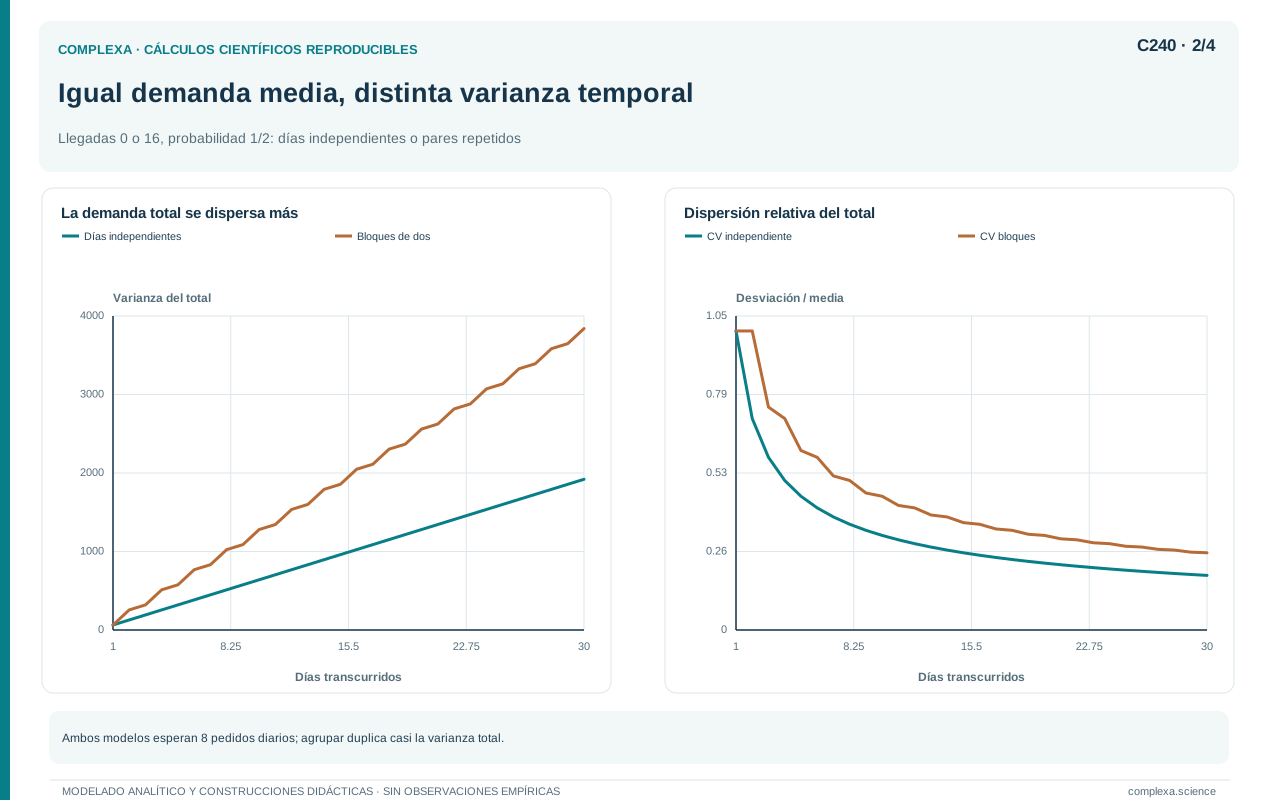
Los dos modelos asignan probabilidad una mitad a una llegada de dieciséis pedidos en cualquier día. Ambos tienen demanda media ocho y varianza diaria sesenta y cuatro. La diferencia está en la relación entre jornadas. En los bloques, una jornada con lote garantiza otro lote al día siguiente dentro del mismo par; en el modelo independiente no da esa información.
Durante treinta días, la demanda esperada total es doscientos cuarenta pedidos en ambos casos. Su varianza es mil novecientos veinte bajo independencia y tres mil ochocientos cuarenta bajo bloques. En la alternativa, cada uno de los quince bloques recibe cero o treinta y dos pedidos con igual probabilidad, de modo que la suma mantiene su media y duplica su varianza.
El sistema acumula pedidos cuando varias llegadas próximas exceden la capacidad disponible. Una jornada sin lote puede vaciar parte de la cola, pero dos jornadas cargadas consecutivas producen acumulación antes de la siguiente oportunidad de recuperación. El orden y la agrupación afectan la cola porque la regla contiene un máximo con cero y una capacidad limitada por jornada.
No afirmamos que toda dependencia positiva tenga el mismo efecto ni que cualquier agrupación aumente todas las respuestas. Hemos definido una alternativa precisa y calculado sus consecuencias. Otros patrones podrían incluir rachas largas, periodicidad, cambios de probabilidad o dependencia del estado. Cada uno requiere su propia especificación y comparación.
El caso también permite identificar una propiedad que sí sobrevive. Para cualquier secuencia compartida de llegadas y la misma cola inicial, la capacidad doce produce un saldo menor o igual que la capacidad diez en cada jornada. La afirmación se demuestra por inducción usando la monotonía del máximo y no depende de que las llegadas sean independientes.
Esa propiedad garantiza que, bajo estas reglas, aumentar la capacidad no empeora la cola, pero no determina cuánto mejora, si la mejora compensa su costo ni qué capacidad conviene entre todas las posibles. Una conclusión cualitativa robusta puede coexistir con una magnitud sensible y con una decisión que cambia de signo. El análisis debe identificar cuál de esas afirmaciones está evaluando.
La alternativa de bloques, que no pretende describir datos observados, es una prueba de sensibilidad estructural; conserva estadísticas marginales fáciles de confundir con una especificación completa. Si una decisión real dependiera de esta comparación, necesitaríamos investigar la dependencia temporal empírica y su incertidumbre, además de estimar correctamente la demanda media.
La inicialización vacía también delimita el resultado. Calculamos la media de una operación de treinta días que empieza sin trabajo pendiente, distinta de la media estacionaria tras un tiempo ilimitado. Eliminar los primeros días como supuesto calentamiento cambiaría la respuesta definida y su denominador. Si interesara una operación que comienza con carga acumulada, deberíamos especificar esa carga o su distribución y repetir la comparación. Aunque la capacidad supere la demanda media, elegir entre análisis transitorio y prolongado requiere una pregunta temporal y una justificación del procedimiento. Aquí conservamos la condición inicial para aislar el cambio de dependencia y la anotamos como otra dimensión que una investigación posterior podría examinar por separado.
240.5. Una decisión que cambia con la dependencia
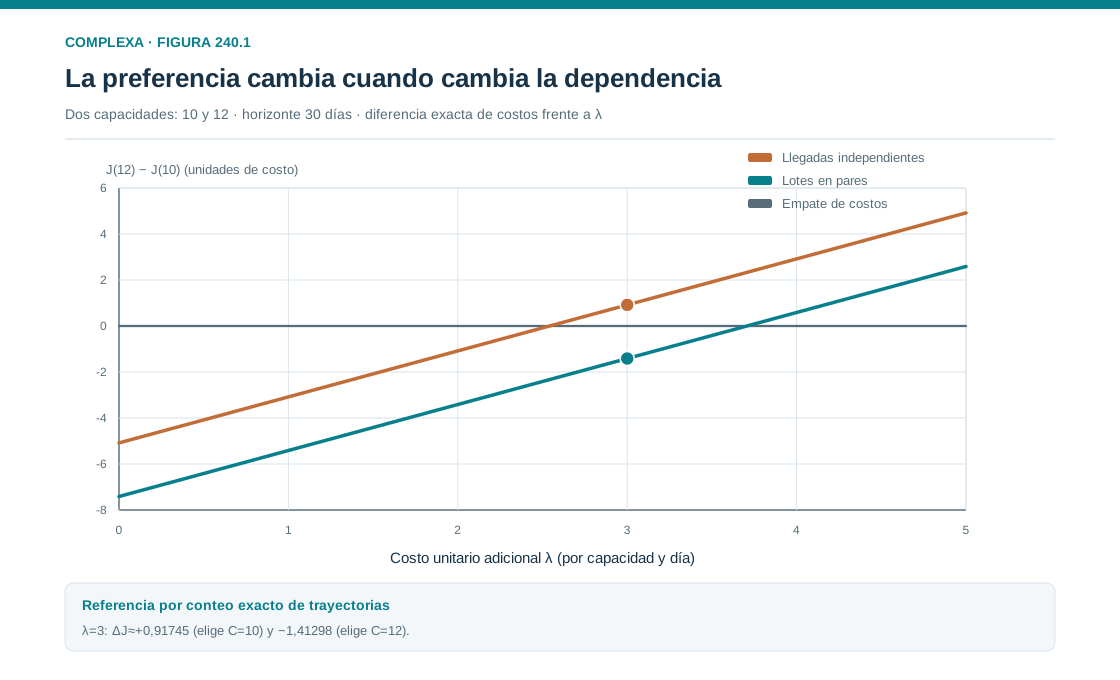
Definimos el costo J como la esperanza de la cola media más tres veces la capacidad adicional respecto de diez. El segundo término expresa una valoración didáctica en unidades compatibles con las del primero. Al comparar doce con diez, el incremento de costo de capacidad es seis. La decisión depende de si la reducción esperada de cola supera esas seis unidades.
Con llegadas independientes, la diferencia estimada de costos es cero coma setecientos cincuenta y siete, positiva; según este criterio y entre estas dos capacidades, diez tiene menor costo. Con bloques de dos, la diferencia es menos uno coma cuatrocientos cincuenta y uno, negativa, por lo que el criterio prefiere doce. La decisión cambia aunque ambas alternativas mantengan la misma demanda media diaria.
La incertidumbre de Monte Carlo del contraste de costos es la misma que la de la diferencia de colas, porque añadimos una constante. Un intervalo normal aproximado del noventa y cinco por ciento va de cero coma doscientos cinco a uno coma trescientos diez bajo independencia y de menos dos coma doscientos noventa y siete a menos cero coma seiscientos cuatro bajo bloques.
Estos intervalos describen el error de estimación bajo los modelos definidos y una aproximación normal. No incorporan incertidumbre sobre el peso tres, sobre reglas omitidas ni sobre la correspondencia con una organización real. La comparación exacta de la sección siguiente comprobará que el cambio de decisión no es un accidente de las doscientas réplicas.
También podemos despejar el peso crítico de capacidad. Si la diferencia esperada de colas es delta, el empate ocurre cuando lambda es menos delta dividido por dos. Un valor menor favorece la capacidad doce, porque su mejora cuesta relativamente poco; uno mayor favorece diez. El umbral convierte una recomendación puntual en una relación explícita entre valoración y dinámica.
No debemos llamar óptima a la capacidad elegida sin limitar el conjunto de alternativas. Solo hemos comparado diez y doce durante treinta días y con una función de costo específica. Una capacidad once, una política variable o una modificación de las llegadas podrían dar otros resultados.
La fragilidad descubierta es precisa. La conclusión sobre cuál de dos capacidades minimiza este costo cambia al modificar la dependencia temporal con las marginales fijas, mientras que la conclusión de que una capacidad mayor reduce la cola sigue siendo válida. Separar ambas evita convertir el hallazgo en una crítica indiscriminada del modelo o, en sentido contrario, ocultarlo detrás de una propiedad que sí permanece.
240.6. Una referencia exacta para separar errores
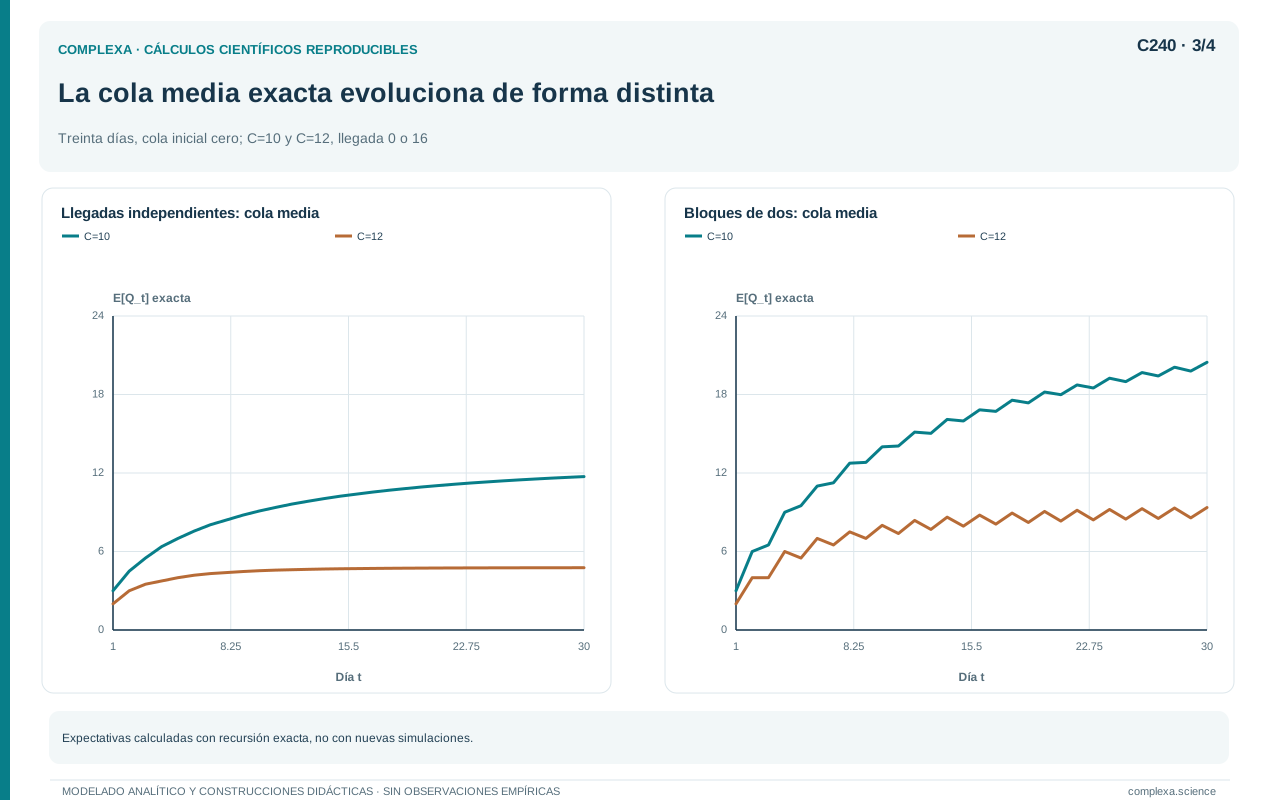
El horizonte finito y las llegadas binarias permiten calcular expectativas sin muestreo. No necesitamos enumerar explícitamente las más de mil millones de secuencias independientes posibles, porque podemos agrupar las historias que terminan en el mismo saldo y en el mismo estado respecto de haber superado el umbral. Para cada grupo conservamos su número de historias y la suma de áreas de cola acumuladas.
El estado contiene el saldo actual y un indicador de excedencia previa; su registro guarda el contador de historias y la suma de sus saldos a lo largo del tiempo. Al añadir una llegada posible, todas las historias del grupo reciben la misma actualización de saldo. Sus contribuciones anteriores se conservan y se añade el nuevo saldo multiplicado por el número de historias.
En el modelo independiente damos treinta pasos binarios; en el de bloques, quince, cada uno de los cuales actualiza dos jornadas. Todas las secuencias de decisiones tienen igual probabilidad dentro de cada modelo. Al final dividimos la suma de áreas por el número total de secuencias y por treinta para obtener la esperanza de la cola media.
Los contadores y las áreas se acumulan como enteros; la conversión a decimal ocurre al dividir para presentar los resultados. Por eso hablamos de cálculo exacto de las probabilidades discretas y mostramos aproximaciones decimales redondeadas. No hay error de Monte Carlo en esta referencia; puede haber errores de implementación, que examinamos mediante comparaciones y casos pequeños.
| Modelo | E[cola media], C=10 | E[cola media], C=12 | Diferencia exacta de costos |
|---|---|---|---|
| Independientes | 9,495447 | 4,412897 | +0,917450 |
| Bloques de dos | 15,054012 | 7,641032 | −1,412980 |
Las cifras simuladas no coinciden exactamente con estas expectativas, como corresponde a una muestra finita. Con llegadas independientes, la diferencia de colas estimada fue menos cinco coma doscientos cuarenta y tres; la exacta es menos cinco coma cero ochenta y tres. Bajo bloques, la estimada fue menos siete coma cuatrocientos cincuenta y uno y la exacta, menos siete coma cuatrocientos trece.
La referencia confirma el signo de ambas decisiones. También fija pesos críticos más precisos, de aproximadamente dos coma cinco cuatro uno tres bajo independencia y tres coma siete cero seis cinco bajo bloques. Para cualquier lambda estrictamente entre esos valores, los dos modelos prefieren capacidades distintas. Fuera de ese intervalo pueden coincidir, aunque sus colas esperadas sigan siendo diferentes.
Esta solución exacta no implica que toda simulación deba evitarse, porque en modelos mayores la cantidad de estados puede crecer hasta impedir la recursión. Aquí es una referencia para aprender qué reproduce una simulación, cómo se interpreta su error y qué comprobaciones pueden hacerse cuando una parte del problema admite un análisis independiente.
240.7. Qué significa haber encontrado fragilidad
El resultado muestra que la elección entre las capacidades diez y doce depende de una propiedad temporal que se omite si solo describimos la media y la distribución diaria; no indica que alguna de ellas sea buena en términos absolutos. La fragilidad pertenece a una afirmación concreta bajo un criterio concreto y señala qué información adicional puede cambiar la decisión.
Si el peso de capacidad fuera dos, ambos modelos preferirían doce; si fuera cuatro, ambos preferirían diez. Con esos valores la decisión sería estable frente a esta perturbación particular, aunque su costo esperado y la magnitud de la cola seguirían cambiando. La robustez de una elección y la de sus consecuencias cuantitativas son propiedades diferentes.
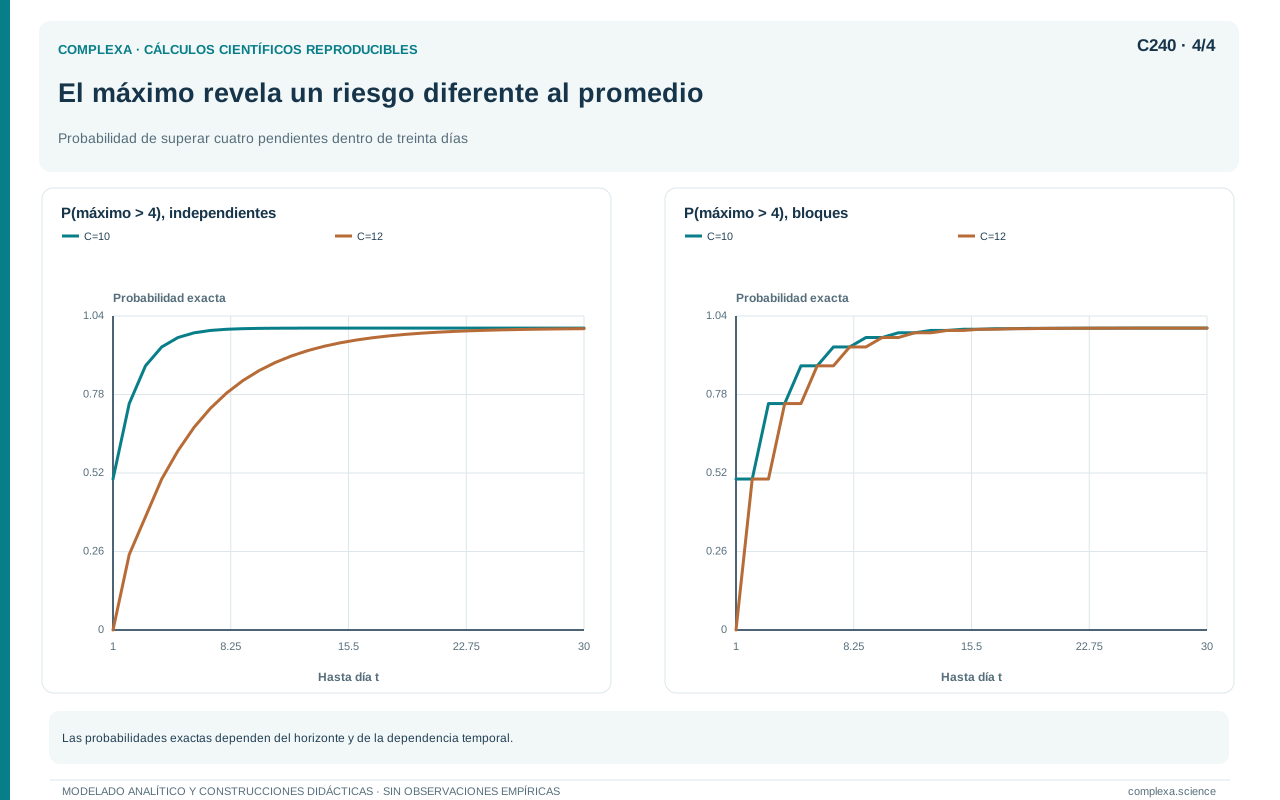
La probabilidad de superar cuatro pedidos da otro contraste. Con capacidad diez y llegadas independientes basta que llegue un lote cualquiera durante el horizonte, de modo que la probabilidad de no superar el umbral es dos elevado a menos treinta. Con capacidad doce, una llegada aislada deja cuatro y dos llegadas consecutivas producen ocho; evitar la excedencia requiere una secuencia sin dos llegadas consecutivas.
El conteo de esas secuencias da la probabilidad ya calculada en el capítulo 232, aproximadamente cero coma nueve nueve siete nueve siete uno, de superar cuatro con capacidad doce. En los bloques, cualquier bloque activo provoca excedencia con ambas capacidades, así que la probabilidad es uno menos dos elevado a menos quince, aproximadamente cero coma nueve nueve nueve nueve seis nueve.
Por tanto, mejorar la cola media no equivale a satisfacer ese umbral con alta probabilidad. Si una decisión exigiera una garantía sobre el máximo, tendríamos que reformular las alternativas y el objetivo. La simulación no puede compensar una pregunta mal alineada con la necesidad que pretende resolver.
El experimento tampoco determina cuál de los modelos temporales describe mejor los datos reales. Para eso necesitaríamos observar secuencias, evaluar alternativas plausibles y examinar rachas, dependencia y cambios de contexto. Los bloques solo ponen a prueba un supuesto de manera controlada, sin inferir nada sobre la organización de las llegadas en un sistema empírico.
Lo útil del hallazgo es que identifica una pregunta de investigación (qué estructura temporal de demanda es relevante para la decisión y cuánto sabemos de ella), que puede orientar la recolección de datos o un modelo más detallado. Así, la fragilidad informa sobre el límite actual del conocimiento.
240.8. Programa reproducible y lectura de sus salidas
El programa siguiente, que solo usa la biblioteca estándar de Python, contiene generación, dinámica, resumen y recursión exacta. Al ejecutarlo desde un archivo, escribe un documento JSON con la configuración, la versión del intérprete, los resúmenes y todas las trayectorias simuladas. También imprime los resultados agregados.
La función de semillas coincide con la del capítulo 232. La función de trayectoria aplica atención y saldo de manera explícita; la recursión exacta usa la expresión equivalente mediante un máximo. Esa diferencia de implementación permite contrastar dos caminos de cálculo sin depender de una única rutina compartida para todas las comprobaciones.
El programa está escrito para el experimento fijado, con dos capacidades, horizonte treinta y bloques que dividen exactamente ese horizonte; no pretende ser una biblioteca general de simulación. Si se amplía a otros horizontes o probabilidades, también deben revisarse el conteo exacto, los pesos de las secuencias y las comprobaciones. La división por una potencia de dos solo es válida si las ramas tienen igual probabilidad.
from collections import defaultdict
from hashlib import sha256
from math import sqrt
from random import Random
from statistics import mean, stdev
from pathlib import Path
import json, platform

R, T, LOTE, LAMBDA = 200, 30, 16, 3.0
CAPACIDADES = (10, 12)

def semilla(replica):
    return int.from_bytes(sha256(
        f"complexa232|llegadas|{replica}".encode("utf-8")).digest()[:8], "big")

def trayectoria(llegadas, capacidad):
    q, saldos = 0, []
    for a in llegadas:
        d = min(q+a, capacidad)
        q = q+a-d
        saldos.append(q)
    return saldos

def exacto(capacidad, bloque, dias=T):
    assert dias % bloque == 0
    estados = {(0, False): (1, 0)}
    for _ in range(dias//bloque):
        nuevos = defaultdict(lambda: [0, 0])
        for (q, hit), (numero, area) in estados.items():
            for a in (0, LOTE):
                qq, hh, incremento = q, hit, 0
                for _ in range(bloque):
                    qq = max(0, qq+a-capacidad)
                    hh = hh or qq>4
                    incremento += qq
                nuevos[(qq, hh)][0] += numero
                nuevos[(qq, hh)][1] += area+numero*incremento
        estados = nuevos
    total = 2**(dias//bloque)
    return {"media": sum(v[1] for v in estados.values())/(total*dias),
            "prob_max_mayor_4": sum(v[0] for k,v in estados.items()
                                    if k[1])/total}

def ejecutar():
    registros, resumen = [], {}
    for nombre, bloque in (("independientes", 1), ("bloques_de_dos", 2)):
        por_cap = {c: [] for c in CAPACIDADES}
        diferencias = []
        for r in range(R):
            rng = Random(semilla(r))
            u = [rng.random() for _ in range(T)]
            a = [LOTE if u[t//bloque]<0.5 else 0 for t in range(T)]
            par = {}
            for c in CAPACIDADES:
                q = trayectoria(a,c)
                par[c] = mean(q)
                por_cap[c].append(par[c])
                registros.append({"modelo": nombre, "replica": r,
                    "capacidad": c, "llegadas": a, "saldos": q,
                    "media": par[c], "maximo": max(q)})
            diferencias.append(par[12]-par[10])
        ex = {str(c): exacto(c,bloque) for c in CAPACIDADES}
        delta = mean(diferencias)
        delta_ex = ex["12"]["media"]-ex["10"]["media"]
        resumen[nombre] = {
            "medias": {str(c): mean(por_cap[c]) for c in CAPACIDADES},
            "diferencia": delta,
            "ee_diferencia": stdev(diferencias)/sqrt(R),
            "diferencia_costo": delta+2*LAMBDA,
            "lambda_critica_estimada": -delta/2,
            "exactos": ex, "diferencia_exacta": delta_ex,
            "diferencia_costo_exacta": delta_ex+2*LAMBDA,
            "lambda_critica_exacta": -delta_ex/2}
    return registros, resumen

if __name__ == "__main__":
    registros, resumen = ejecutar()
    assert abs(resumen["independientes"]["medias"]["10"]-9.856)<1e-12
    salida = {"configuracion": {"replicas": R,"dias": T,"lote": LOTE,
              "capacidades": CAPACIDADES,"lambda": LAMBDA,
              "prob_llegada": 0.5,"cola_inicial":0},
              "python":platform.python_version(),
              "resumen":resumen,"replicas":registros}
    Path("c240_resultados.json").write_text(
        json.dumps(salida,ensure_ascii=False,indent=2),encoding="utf-8")
    print(json.dumps(resumen,ensure_ascii=False,indent=2))
Las columnas de diferencias siguen siempre el orden capacidad doce menos capacidad diez. Un valor negativo de la diferencia de colas indica reducción con capacidad doce. Un valor negativo de la diferencia de costos indica que esa reducción compensa el costo adicional bajo el lambda elegido. Conservar el signo y su definición evita invertir la recomendación al leer las tablas.
El campo de pesos críticos separa valores estimados y exactos. Los primeros dependen de las doscientas réplicas; los segundos proceden de la recursión. El archivo conserva ambas versiones para que el lector pueda comparar la precisión sin confundir un cálculo determinista con una ejecución de Monte Carlo. Los decimales impresos no añaden precisión empírica sobre ningún sistema real.
Las trayectorias almacenadas permiten recalcular resúmenes y detectar errores de agregación. No contienen tiempos de espera individuales, porque el modelo no los incluye; obtener esa respuesta requeriría ampliar el estado y registrar el orden de atención. Disponer de muchos saldos diarios no autoriza a inferir automáticamente variables omitidas.
240.9. Auditoría del resultado y de su interpretación
La primera parte de la auditoría comprueba invariantes. Los saldos deben ser no negativos; lo atendido no puede superar la capacidad ni el trabajo disponible; la suma de pedidos iniciales y llegadas debe coincidir con lo atendido más el saldo final. Estas relaciones detectan errores que una media agregada puede ocultar.
La segunda compara implementaciones y referencias. La reproducción independiente debe recuperar las trayectorias del capítulo 232 para las mismas entradas. La recursión exacta se contrasta con una enumeración completa en horizontes pequeños, donde todas las secuencias pueden examinarse directamente. Las probabilidades especiales del umbral son comprobaciones adicionales que no dependen del resumen de colas.
También comprobamos la monotonía en la capacidad para cada trayectoria emparejada. Si alguna jornada mostrara más cola con capacidad doce que con diez, el programa violaría una propiedad demostrada de estas reglas. Esa comprobación es más fuerte que observar una media menor, porque una media podría parecer correcta aunque algunos registros estuvieran emparejados o actualizados incorrectamente.
La auditoría estadística revisa las unidades independientes, el error estándar y la comparación entre estimaciones y expectativas exactas. No exige que toda estimación caiga arbitrariamente cerca de su referencia ni toma una sola coincidencia como prueba de corrección; examina si la magnitud del error es compatible con el diseño y si las fórmulas de incertidumbre corresponden al estimador usado.
La revisión conceptual comprueba qué cambió entre modelos. La distribución diaria y la media se conservaron; la dependencia temporal y la varianza del total cambiaron. El horizonte, la cola inicial, las capacidades y el criterio se definieron de la misma manera. Esta trazabilidad permite atribuir la diferencia, dentro del experimento, a la perturbación estructural especificada.
La revisión bibliográfica sostiene los conceptos metodológicos; los números del caso, que no figuran en ningún artículo citado, se verifican contra su código y sus derivaciones. Así no usamos las referencias como respaldo aparente de un resultado que debe poder reproducirse por sí mismo.
Por último, revisamos el lenguaje de la conclusión. Sustituimos afirmaciones amplias como «más capacidad es mejor» por enunciados que indican respuesta, alternativas, horizonte y costo. También distinguimos una propiedad demostrada para cualquier secuencia de un resultado calculado bajo dos distribuciones concretas. Esa precisión editorial también mejora el resultado científico, porque delimita lo que el lector puede inferir.
240.10. Reproducir para poder cuestionar
La reproducción recuperó exactamente el experimento previo bajo sus semillas y reglas. La comparación estructural mostró que mantener la demanda media y las marginales diarias no conserva necesariamente una decisión. El cálculo exacto confirmó que el cambio de preferencia entre capacidades no procede del ruido de Monte Carlo. Las tres comprobaciones responden preguntas distintas y se refuerzan mutuamente.
Una parte del resultado fue robusta (con las mismas llegadas, la capacidad mayor no incrementa la cola en este modelo). Otra dependió del entorno, pues la magnitud de la reducción fue diferente bajo independencia y bajo bloques. Una tercera combinó dinámica y valoración; la capacidad preferida cambió para un intervalo explícito de pesos de costo.
Esta distinción permite mejorar una conclusión sin descartar todo el trabajo anterior. El resultado original sigue siendo correcto bajo sus supuestos; lo que cambia es el alcance con que podemos usarlo. Una afirmación condicional bien documentada informa más que una recomendación amplia apoyada solo en una configuración reproducible.
El caso muestra también la utilidad de las referencias analíticas. Las expectativas exactas permitieron medir el error de simulación, comprobar decisiones y localizar umbrales de costo. Cuando no existe una solución completa, todavía podemos buscar casos reducidos, límites, invariantes o probabilidades especiales. Esas referencias parciales ayudan a auditar simuladores cuya salida total no podemos calcular a mano.
Un estudio más realista necesitaría datos sobre secuencias de demanda, costos y reglas operativas. También podría representar prioridades, cancelaciones, capacidad variable o tiempos individuales. Añadir detalle tendría que responder a una pregunta y justificar su costo. La complejidad adicional no garantiza mejores decisiones si no mejora la correspondencia entre modelo, información y objetivo.
La lección final del módulo es formular una pregunta, diseñar comparaciones, conservar el procedimiento, medir su error y perturbar los supuestos que podrían cambiar la conclusión. La reproducibilidad hace posible ese examen; la sensibilidad indica dónde investigar más. En el siguiente módulo aplicaremos este enfoque a autómatas celulares y modelos de agentes, donde las reglas locales y las decisiones de actualización pueden transformar los patrones colectivos.
Referencias
- Sargent, R. G. (2013). Verification and validation of simulation models. Journal of Simulation, 7, 12–24. DOI: 10.1057/jos.2012.20.
- Morris, T. P., White, I. R., y Crowther, M. J. (2019). Using simulation studies to evaluate statistical methods. Statistics in Medicine, 38(11), 2074–2102. DOI: 10.1002/sim.8086.
- Sandve, G. K., Nekrutenko, A., Taylor, J., y Hovig, E. (2013). Ten simple rules for reproducible computational research. PLOS Computational Biology, 9(10), e1003285. DOI: 10.1371/journal.pcbi.1003285.
Nota del caso. Experimento original de esta obra, ejecutado con el programa incluido. Las cifras de Monte Carlo utilizan doscientas réplicas; las referencias exactas agregan todas las historias mediante recursión de estados. El costo de capacidad es un supuesto didáctico.