Módulo 24. Experimentos computacionales, muestreo y documentación
234.1. Tres preguntas que no deben confundirse
Una cadena de Markov puede producir miles de valores sin dar una estimación confiable. Para evaluarla debemos separar tres preguntas. La primera es si el algoritmo conserva la distribución objetivo; la segunda, si la ejecución disponible parece haber explorado sus regiones relevantes; la tercera, con qué precisión estima una cantidad concreta. Los diagnósticos empíricos se ocupan principalmente de las dos últimas, mientras que una densidad mal definida o una transición inválida exigen otros controles.
La distinción es necesaria aun cuando una trayectoria tiene buen aspecto visual. Una cadena puede moverse continuamente dentro de un modo y no visitar otro. También puede alternar entre puntos de manera que su media sea correcta mientras su varianza es completamente errónea; el ejemplo del oscilador del capítulo anterior mostró precisamente esa posibilidad. Una apariencia dinámica y una media plausible, aun juntas, no bastan para declarar que el muestreo reproduce la distribución.
La convergencia es una propiedad de un límite, mientras que nuestros resultados proceden de ejecuciones finitas. Salvo situaciones especiales con garantías adicionales, no observamos directamente cuánto falta para ese límite. Buscamos señales de incompatibilidad entre cadenas, cambios dentro de ellas, dependencia persistente y precisión insuficiente. La ausencia de esas señales aumenta la confianza bajo el diseño usado, pero no demuestra que todas las regiones posibles hayan sido visitadas.
Imaginemos un objetivo formado por una mezcla equiprobable de dos normales, una centrada en menos diez y otra en diez, ambas de varianza uno. Su media es cero. Si todas las cadenas locales permanecen durante el registro en la primera región, pueden producir medias cercanas a menos diez, concordar entre sí y mostrar dependencia moderada dentro de esa región. Ese acuerdo no revela la mitad de la distribución que ninguna visitó. Conocer analíticamente el objetivo permite detectar el problema; con un objetivo desconocido necesitamos inicializaciones y comparaciones capaces de ponerlo a prueba.
El tamaño efectivo de muestra responde a una pregunta diferente, la de cuánta información contienen las observaciones correlacionadas para estimar una función determinada. Su valor puede cambiar entre la media, una probabilidad y un cuantil del mismo parámetro. Una cifra global de tamaño efectivo puede ser cómoda como resumen, pero hay que definir qué precisión mide para poder interpretarla.
Trabajaremos con ejemplos calculables y distinguiremos fórmulas pedagógicas de diagnósticos modernos. Primero compararemos la variación dentro y entre cadenas; después, la autocorrelación, el error de Monte Carlo y el tamaño efectivo. Finalmente construiremos un protocolo de revisión que conecte cada advertencia con una acción y que no use los umbrales como certificados automáticos.
El objetivo práctico es informar cantidades cuya precisión y limitaciones sean visibles. Decir «la cadena convergió» suele ser demasiado general. Una afirmación más útil especifica qué cadenas se compararon, qué funciones se examinaron, qué diagnósticos se calcularon y qué incertidumbre de Monte Carlo permanece en los resultados relevantes para la pregunta científica.
234.2. Preparar cadenas comparables
Los diagnósticos necesitan saber qué muestras pertenecen a cada cadena y a qué fase de la ejecución corresponden. Concatenar todas las muestras antes de guardar identificadores elimina información sobre discrepancias entre trayectorias. También debemos distinguir las iteraciones de adaptación de las obtenidas con la configuración usada para inferencia. Una tabla final que mezcla ambas fases puede ocultar cambios en el mecanismo de transición.
Las inicializaciones deben ser válidas y suficientemente diversas para poner a prueba la exploración. Si todas las cadenas comienzan en la misma región y nunca salen, pueden coincidir entre sí sin representar el objetivo completo. Inicializaciones distintas no garantizan descubrir todos los modos, pero permiten detectar dependencias respecto del punto de partida. La diversidad debe respetar el soporte y las escalas del modelo y excluir valores arbitrariamente extremos que hagan imposible la evaluación.
Cada cadena necesita su propio flujo aleatorio correctamente organizado. Copiar el estado del generador al iniciar varias cadenas puede producir trayectorias idénticas, especialmente en implementaciones que duplican procesos. El acuerdo entre copias no es evidencia independiente. Registrar semillas, identificadores y algunos controles de duplicación permite distinguir coincidencia estadística de repetición informática.
La fase de adaptación puede ajustar escalas, matrices o longitudes de trayectoria. Sus muestras normalmente se excluyen del resumen inferencial cuando así lo define el método. Eliminar automáticamente una proporción fija del registro, sin atender al algoritmo ni a su comportamiento, no demuestra que el resto esté equilibrado. El descarte tiene que corresponder al diseño y acompañarse de una evaluación de la fase conservada.
Una cadena muy corta contiene poca información para estimar dependencia temporal. Si no observamos cambios lentos, puede ser porque no existen o porque todavía no hubo tiempo de verlos. Alargar la cadena aumenta la oportunidad de detectarlos, pero es más útil cuando el algoritmo ya puede recorrer las regiones pertinentes. Ejecutar durante más tiempo una transición reducible no resuelve su falta de comunicación.
Finalmente, debemos seleccionar cantidades derivadas relevantes. En un modelo con parámetros correlacionados, una combinación lineal puede mezclarse mucho peor que cada coordenada por separado. En un modelo jerárquico, una escala o una predicción extrema puede ser más difícil de estimar que una media global. El conjunto de diagnósticos debe seguir la pregunta del estudio e incluir las funciones que intervienen directamente en las conclusiones.
234.3. Comparar variación dentro y entre cadenas
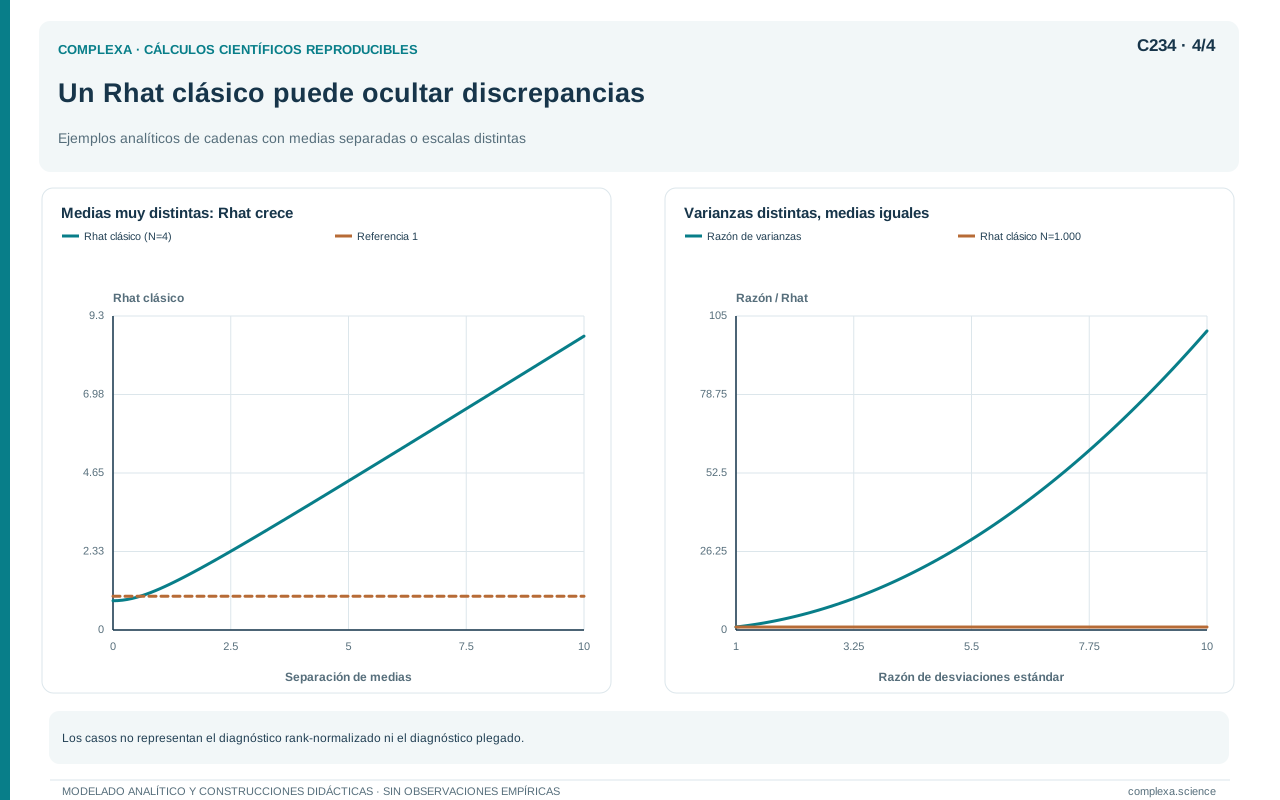
La idea clásica de R con sombrero compara la variación dentro de cada cadena con una estimación que incorpora diferencias entre sus medias. Si las cadenas permanecen en regiones distintas, reunirlas produce una dispersión mayor que la observada dentro de cada una. Esa discrepancia advierte que todavía no dan representaciones compatibles de una misma distribución. Presentaremos una fórmula clásica como instrumento didáctico, distinta de las versiones modificadas que se usan actualmente.
Para M cadenas de longitud N, calculamos la media y la varianza muestral de cada cadena. W es el promedio de las varianzas internas. B multiplica por N la varianza de las medias entre cadenas. Una combinación ponderada de W y B estima la variación marginal; su cociente con W da el cuadrado del diagnóstico.
Consideremos dos secuencias artificiales de cuatro valores, una formada por menos uno, cero, uno y cero, otra por nueve, diez, once y diez. Sus medias son cero y diez; ambas varianzas muestrales valen dos tercios y la media conjunta es cinco. B vale doscientos y la estimación combinada de varianza vale cincuenta coma cinco. El diagnóstico es de aproximadamente ocho coma setecientos tres e indica una discrepancia enorme entre las regiones ocupadas.
El ejemplo es solo una comprobación aritmética; con cuatro observaciones por cadena no conviene hacer inferencia. También muestra que el diagnóstico necesita conservar la identidad de cada secuencia. Si solo observáramos los ocho valores mezclados, reconoceríamos dispersión, pero perderíamos la evidencia de que cada cadena permanece en una región diferente.
Un valor cercano a uno tampoco garantiza igualdad de distribuciones. Dos secuencias pueden tener medias iguales y escalas muy distintas. Si B es cero, la fórmula anterior depende esencialmente del factor que corrige la longitud, aunque una cadena fluctúe diez veces más que otra. Para secuencias de mil valores con medias exactamente iguales, el cociente puede dar aproximadamente cero coma novecientos noventa y nueve cinco y ocultar así esa diferencia de escala.
Este fracaso indica que una comparación basada solo en medias y varianzas originales puede ser insuficiente, aunque la idea de comparar cadenas sigue siendo válida. Necesitamos examinar cambios temporales, colas y diferencias de escala de manera más robusta. Los diagnósticos posteriores responden a estos contraejemplos y a dificultades que aparecen sobre todo en distribuciones asimétricas o de colas pesadas.
234.4. Dividir, transformar rangos y examinar escalas
Dividir cada cadena en dos mitades permite comparar el comienzo y el final de la fase conservada. Si una trayectoria cambia lentamente de región, sus mitades pueden mostrar discrepancias aunque la media total coincida con la de otra cadena. Las mitades siguen siendo partes dependientes de una misma ejecución; la división es una herramienta diagnóstica para detectar falta de estabilidad temporal dentro del material disponible.
Vehtari y colaboradores desarrollaron una versión que combina división, normalización mediante rangos y una transformación plegada para examinar escalas [1]. Los rangos conjuntos se transforman a puntuaciones normales para que el diagnóstico dependa menos de momentos originales que pueden ser inestables. La versión plegada usa distancias a una mediana conjunta y ayuda a detectar diferencias de dispersión que una comparación de ubicación puede pasar por alto.
Su propuesta usa conjuntamente los diagnósticos sobre valores transformados y sobre valores plegados. Los autores recomiendan, como referencia práctica, al menos cuatro cadenas y un R con sombrero inferior a uno coma cero uno. También proponen examinar tamaños efectivos del centro y de las colas [1]. Estas referencias son criterios de revisión empírica que no garantizan la exactitud en todos los casos ni eximen de exigir una precisión adecuada para cada aplicación.
Para el resumen recomendado se toma el mayor de los dos diagnósticos, de modo que una discrepancia de ubicación o de escala pueda activar la revisión.
La lógica del plegado puede comprenderse sin memorizar una fórmula. Si una cadena contiene valores cercanos a cero y otra contiene valores mucho más alejados, ambas pueden tener media cero. Al mirar distancias respecto de una ubicación central, la diferencia deja de cancelarse entre signos positivos y negativos. Lo que parecía acuerdo de medias se vuelve así una discrepancia visible de magnitudes.
Los rangos también permiten gráficos comparativos. Si cada cadena recorre de manera semejante la distribución conjunta, debería aportar observaciones a diferentes zonas del ordenamiento sin un patrón sistemático exclusivo. Una cadena concentrada en rangos bajos y otra en rangos altos revelan separación. El gráfico conserva información que puede desaparecer en un resumen único, aunque su interpretación siga dependiendo de la longitud y de la dependencia temporal.
Los empates y las variables discretas requieren convenciones explícitas para asignar rangos. Una implementación debe declarar qué diagnóstico calcula y cómo trata casos degenerados, como cadenas constantes. Si la variación interna es cero, un cociente puede ser indefinido o revelar un problema extremo. Convertir ese resultado automáticamente en uno para completar una tabla borraría precisamente la advertencia que necesitamos examinar.
La división de cadenas debe conservar la secuencia temporal original. Ordenar los valores antes de dividirlos fabricaría diferencias entre mitades; barajarlos antes de calcular autocorrelación borraría dependencia. Los rangos transforman los valores sin autorizar a reordenar las observaciones en el tiempo. Por esa razón, al implementar diagnósticos desde archivos tabulares, el identificador de cadena y el índice de iteración deben acompañar a cada muestra durante todas las transformaciones.
234.5. Autocorrelación y tamaño efectivo
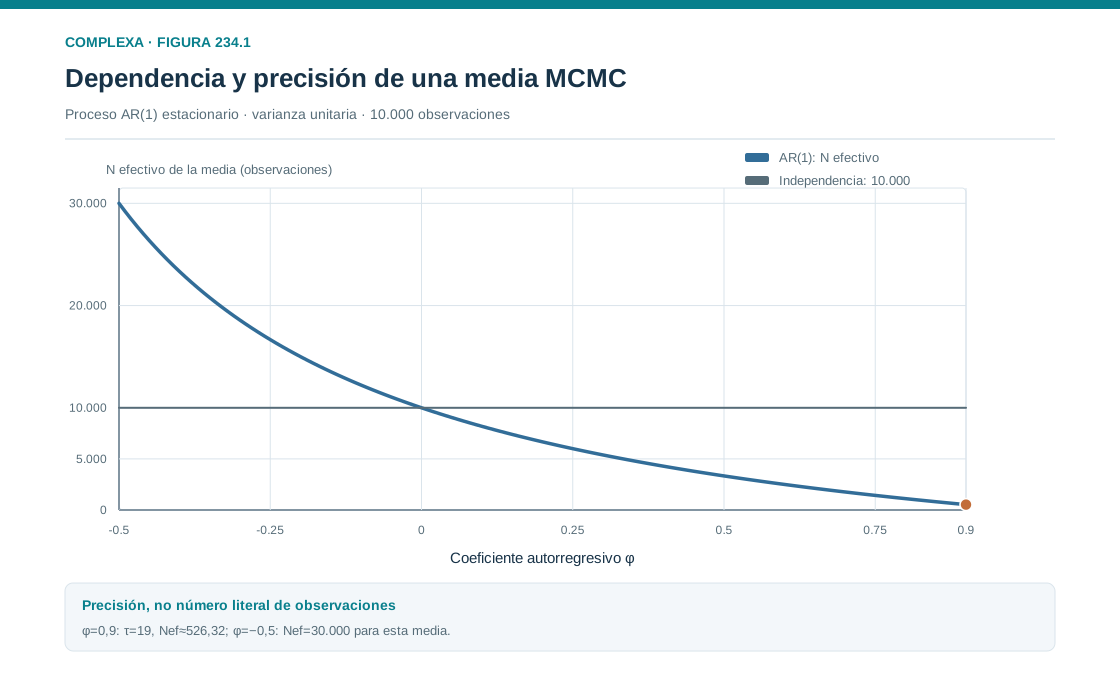
Sea una función f de los estados de una cadena estacionaria. Su promedio estima una esperanza respecto de la distribución objetivo. Cuando existe una varianza asintótica finita y se cumplen condiciones apropiadas de un teorema central del límite, la varianza del promedio depende de la varianza marginal de f y de la suma de sus autocorrelaciones. La dependencia puede aumentar o reducir esa varianza respecto de observaciones independientes.
La expresión define una equivalencia de precisión para esa función. No significa que podamos seleccionar del archivo exactamente ese número de muestras independientes, ni permite reemplazar cualquier análisis por un cálculo independiente del mismo tamaño. Relaciona la dependencia temporal y el error de estimación dentro de las condiciones que justifican la aproximación.
Consideremos un proceso normal autorregresivo estacionario de varianza uno, con coeficiente phi. Su autocorrelación a retraso k es phi elevado a k. Al sumar la serie geométrica obtenemos un factor igual a uno más phi dividido por uno menos phi. Esta construcción es una referencia exacta para entender la dependencia, aunque no reproduzca todos los comportamientos de una cadena MCMC compleja.
Con diez mil observaciones y phi igual a cero coma nueve, el factor es diecinueve y el tamaño efectivo asintótico de la media es aproximadamente quinientos veintiséis. El error estándar correspondiente, para varianza marginal uno, es aproximadamente cero coma cero cuarenta y cuatro. Tratar las observaciones como independientes produciría un error estándar de una centésima.
Para diez mil observaciones, un coeficiente nulo da un factor de autocorrelación igual a 1 y un tamaño efectivo de 10.000. Con phi igual a 0,5, el factor es 3 y el tamaño efectivo, 3.333,33; con 0,9, son 19 y 526,32; con −0,5, son 1/3 y 30.000. El último caso muestra que el tamaño efectivo puede superar el número de observaciones. Una correlación negativa puede reducir la varianza del promedio mediante compensación entre valores sucesivos. Esto no crea observaciones adicionales ni implica eficiencia superior para todas las funciones. En el mismo proceso, los cuadrados tienen otra autocorrelación. Toda equivalencia debe referirse a la cantidad estimada y a su varianza marginal.
234.6. El diagnóstico depende de la función
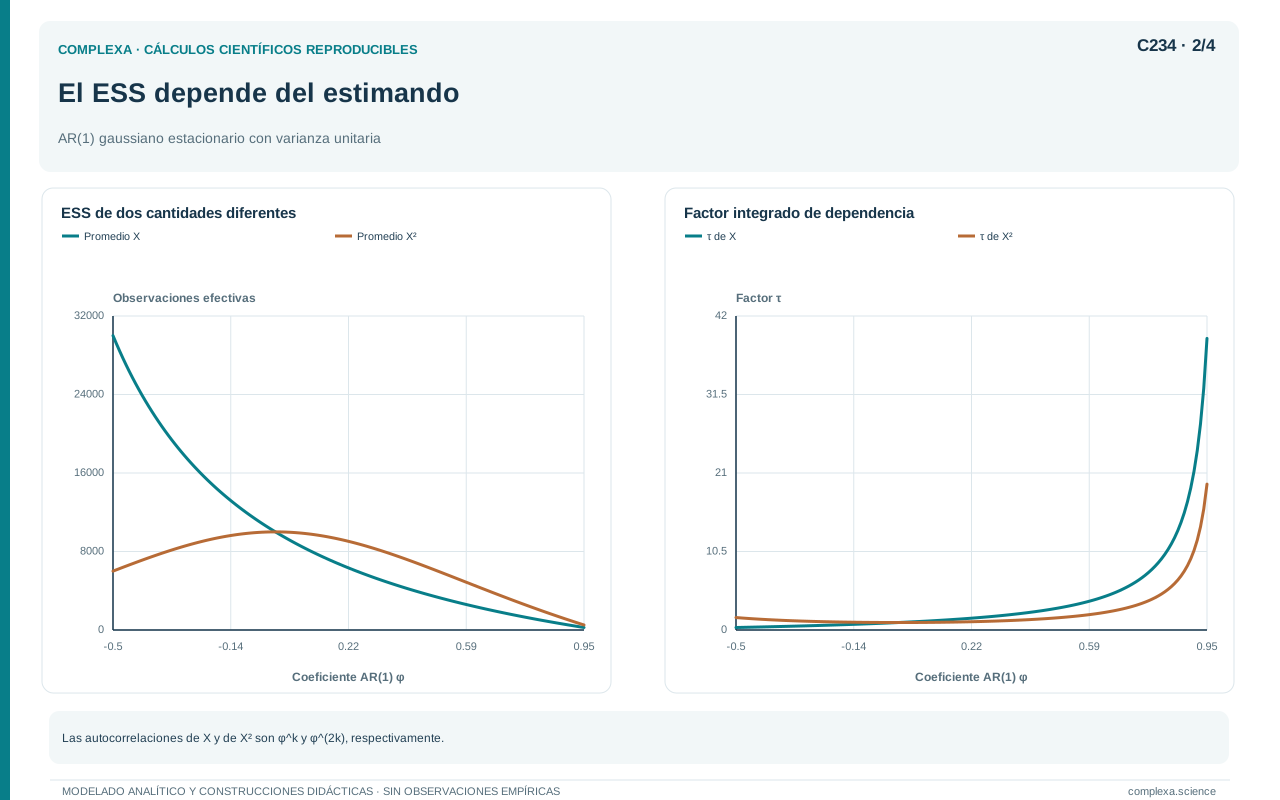
Para el proceso normal autorregresivo, la correlación entre cuadrados separados por k pasos es phi elevado a dos k. Con phi igual a cero coma nueve, el factor de autocorrelación del cuadrado es aproximadamente nueve coma quinientos veintiséis, diferente del factor diecinueve de la media. La varianza marginal del cuadrado también es distinta. Por tanto, comparar tamaños efectivos sin indicar la función puede ocultar diferencias en la precisión final.
Las probabilidades se estiman mediante funciones indicadoras. Si nos interesa que un parámetro supere un umbral, cada muestra vale uno o cero según cumpla la condición. La dependencia de esos indicadores puede ser más persistente que la de la coordenada original, especialmente cuando la cadena visita raramente una región. El tamaño efectivo pertinente para esa probabilidad debe reflejar el comportamiento de las visitas además de la fluctuación central del parámetro.
Los cuantiles requieren otro paso. Estimar una probabilidad acumulada cerca del cuantil ayuda a evaluar la incertidumbre sobre su posición, pero la relación depende de la densidad local. Si la densidad es pequeña, una variación modesta de probabilidad puede corresponder a una diferencia grande en el valor del cuantil. Un tamaño efectivo aceptable para una mediana no implica precisión suficiente para un extremo de la distribución.
Los diagnósticos de centro y colas son resúmenes complementarios. El tamaño efectivo del centro basado en rangos no equivale necesariamente al tamaño efectivo de la media aritmética original. El de colas examina el desempeño en regiones extremas definidas por cuantiles. Si la conclusión científica depende de otra región, conviene calcular directamente la precisión de la función correspondiente.
La distribución de Cauchy muestra por qué hay que verificar que la cantidad exista. Su media poblacional no está definida, aunque podamos calcular la media de cualquier muestra finita. Una trayectoria puede tener un diagnóstico razonable basado en rangos y seguir sin justificar un error estándar convencional para una esperanza inexistente. La mediana y ciertas probabilidades sí están definidas y pueden estudiarse con herramientas adecuadas.
Las conclusiones multivariadas añaden otra dificultad. Un conjunto de medias individuales precisas no determina la precisión de una región conjunta o de una función no lineal de varios parámetros. El análisis multivariado de salida MCMC trata explícitamente la dependencia entre cantidades y la incertidumbre conjunta [2]. En aplicaciones concretas debemos identificar la función o decisión que se publicará y evaluar su error, además de presentar resúmenes por parámetro.
234.7. Estimar el error de Monte Carlo
El factor de autocorrelación teórico contiene una suma infinita que no conocemos en una ejecución real. Sustituirla por todas las autocorrelaciones empíricas disponibles puede introducir mucho ruido, especialmente en retrasos grandes. Por eso se usan estimadores con reglas de truncamiento, ventanas o agrupación. Geyer analizó procedimientos de estimación de varianza para cadenas de Markov y la relación entre dependencia y precisión de Monte Carlo [3].
Una alternativa intuitiva son las medias por bloques. Dividimos una cadena larga en bloques consecutivos, calculamos la media de la función en cada bloque y usamos la variación entre esas medias para estimar el error del promedio global. Los bloques deben ser suficientemente largos para representar la dependencia relevante y suficientemente numerosos para estimar su variabilidad. Elegir su longitud implica un compromiso.
Si hay b bloques de a observaciones, el producto es la longitud total usada. Una estimación básica de la varianza asintótica multiplica por a la varianza muestral de las medias de bloque. El error estándar del promedio global se obtiene dividiendo esa varianza asintótica estimada por el número total de observaciones y tomando la raíz. La justificación requiere condiciones y un régimen de crecimiento apropiado de bloques y longitud.
La fórmula no es un remedio automático para una cadena atrapada. Si todos los bloques permanecen en el mismo modo, su variación puede ser pequeña aunque falte otra región del objetivo. La estimación de precisión depende de que la trayectoria observada represente el comportamiento relevante. Por eso debe acompañarse de comparaciones entre cadenas, examen del objetivo y diagnósticos de exploración.
En el ejemplo autorregresivo podemos calcular también la varianza exacta del promedio para una longitud finita. Cada autocorrelación recibe un peso que disminuye con el retraso, porque hay menos parejas separadas por muchos pasos. Con diez mil observaciones y phi igual a cero coma nueve, el error estándar exacto es aproximadamente cero coma cero cuarenta y tres cinco seis ocho, muy cercano al valor asintótico de cero coma cero cuarenta y tres cinco ocho nueve.
Esa concordancia se da en un ejemplo con dependencia conocida y momentos finitos. En problemas reales podemos comparar estimaciones de error al aumentar la longitud o variar razonablemente el tamaño de los bloques. La estabilidad es informativa, pero no equivale a una prueba de ausencia de sesgo. Debemos informar qué estimador se usó y evitar presentar más cifras decimales de las que su precisión permite sostener.
234.8. Adelgazar cadenas y otros atajos aparentes
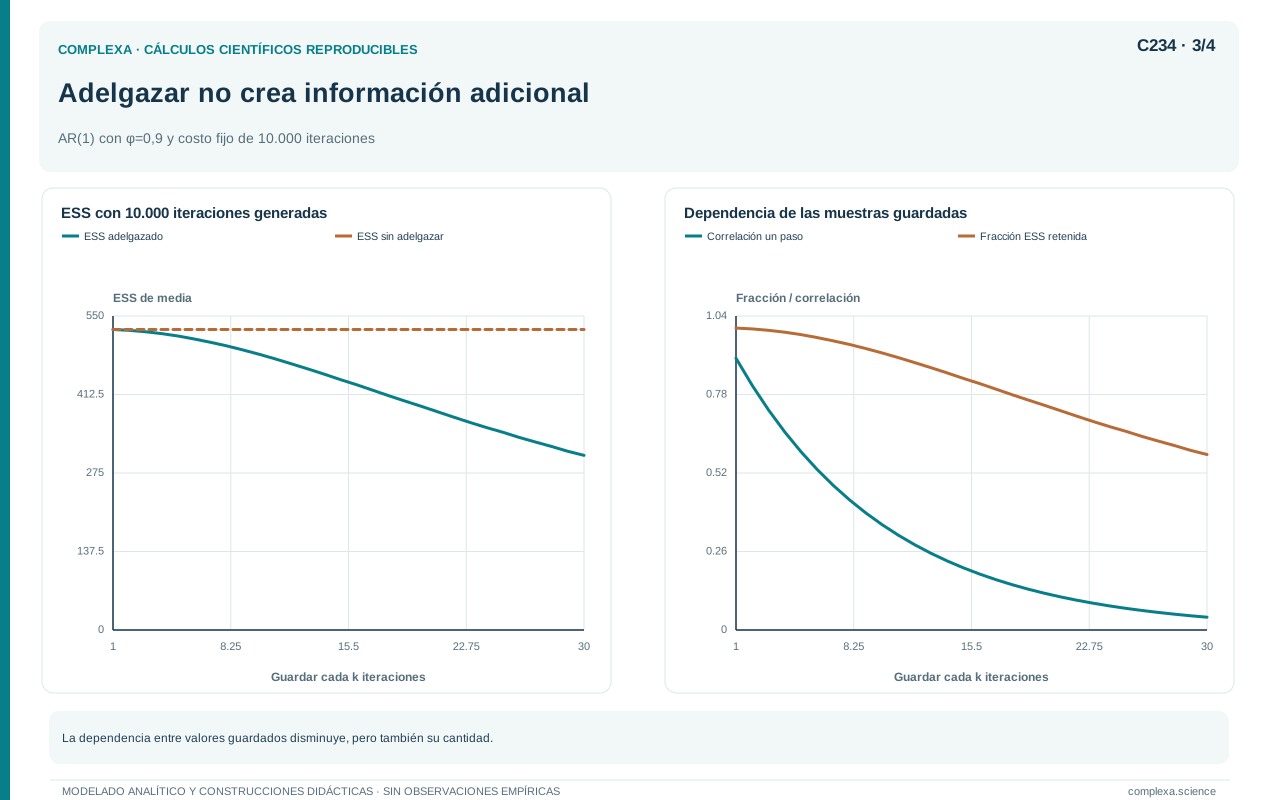
Guardar solo una de cada varias iteraciones reduce la autocorrelación entre las observaciones conservadas, aunque también reduce su cantidad. La pregunta adecuada es cuánto error queda para el mismo costo de generación; una gráfica de autocorrelación que desciende más rápido al redefinir el intervalo entre muestras no la responde. Una cadena más espaciada puede parecer mejor y contener menos información total.
En el proceso autorregresivo con phi igual a cero coma nueve, conservar una observación de cada diez transforma la correlación entre muestras sucesivas en la décima potencia de phi. Si partimos de diez mil iteraciones, guardamos mil. El factor de autocorrelación de las conservadas es aproximadamente dos coma cero setenta y uno; su tamaño efectivo asintótico, aproximadamente cuatrocientos ochenta y tres.
Antes de eliminar muestras, el tamaño efectivo era aproximadamente quinientos veintiséis. Por tanto, el adelgazamiento mejora la eficiencia por muestra guardada, pero empeora la precisión disponible respecto del mismo conjunto de iteraciones generadas. El ejemplo separa dos denominadores que suelen confundirse, el espacio de almacenamiento y el trabajo de simulación. La conveniencia depende de cuál sea la restricción real.
El adelgazamiento puede ser útil si almacenar estados completos es muy costoso o si ciertos análisis posteriores dominan el costo. En ese caso debe justificarse como decisión de recursos y acompañarse de una evaluación de la información perdida. También podemos guardar resúmenes o usar cálculos en línea cuando preserven las cantidades necesarias. Ninguna de estas opciones debe presentarse como garantía de independencia exacta.
Eliminar observaciones porque parecen extremas es otra práctica peligrosa. Las colas forman parte de la distribución objetivo y pueden ser justamente la región que cuesta explorar. Si un valor revela un error de cálculo o una transición inválida, debe investigarse su causa. Si es una muestra válida, descartarlo para estabilizar una media cambia el estimador y puede introducir sesgo.
Tampoco conviene descartar cadenas discrepantes únicamente porque otras coinciden. La discrepancia puede indicar que las cadenas aparentemente buenas comparten una región incompleta. Primero debemos revisar inicializaciones, soporte, adaptación y movimientos entre regiones. Seleccionar después las trayectorias por su parecido puede fabricar acuerdo y producir diagnósticos favorables sobre un conjunto ya filtrado según el resultado deseado.
234.9. Un protocolo de diagnóstico orientado a acciones
La revisión comienza por la distribución y la implementación. Comprobamos que el objetivo sea propio, que las transformaciones incluyan jacobianos cuando correspondan y que las transiciones respeten el soporte. Después verificamos que las cadenas tengan identificadores distintos, flujos aleatorios correctamente organizados y fases de adaptación documentadas. Estos controles evitan atribuir a la estadística un problema básico del cálculo.
A continuación examinamos cadenas y funciones relevantes. Buscamos cambios persistentes, regiones separadas, valores constantes inesperados y diferencias de escala. Calculamos diagnósticos modernos de comparación entre cadenas, junto con tamaños efectivos y errores de Monte Carlo para las cantidades que sostienen las conclusiones. Una tabla puede resumir advertencias, pero debe permitir localizar la cadena, el parámetro o la función afectada.
Si las cadenas discrepan, la acción depende del patrón. Un desplazamiento inicial puede requerir revisar adaptación e inicialización. Una dependencia muy persistente puede sugerir bloques, transformaciones o propuestas diferentes. Regiones separadas pueden requerir un algoritmo capaz de comunicarlas o un análisis explícito de multimodalidad. Alargar las cadenas tiene sentido cuando hay evidencia de que la dinámica puede recorrerlas, pero no es una respuesta universal.
En métodos hamiltonianos, las advertencias sobre integración deben examinarse junto con la geometría del objetivo. Una región estrecha o de gran curvatura puede estar insuficientemente representada aunque otras partes parezcan bien exploradas. Eliminar las transiciones problemáticas del archivo no corrige necesariamente la distorsión. Debemos modificar la parametrización o la configuración mediante un procedimiento válido y volver a evaluar el resultado.
El criterio de precisión debe expresarse en unidades de la conclusión. Si una probabilidad se publicará con dos decimales, su error de Monte Carlo debería ser suficientemente pequeño para sostener esa resolución. Si una decisión depende de superar un umbral, debemos evaluar la incertidumbre cerca de ese umbral. Un tamaño efectivo de referencia puede orientar, pero no fija cuánta precisión necesita una aplicación.
Podemos fijar, por ejemplo, que el error estándar de Monte Carlo sea menor que una décima parte de la incertidumbre posterior de una media, o menor que una tolerancia absoluta derivada de una decisión. Son criterios de diseño que deben justificarse; ninguno es válido para todas las cantidades. Cuando la desviación posterior es muy grande, un criterio relativo puede permitir un error absoluto inconveniente. Cuando la cantidad está cerca de cero, un error relativo a su estimación puede volverse inestable. La escala relevante procede del uso que se dará a la estimación.
Tampoco sumamos tamaños efectivos de cadenas claramente discrepantes para anunciar una gran muestra conjunta. Antes de interpretar esa combinación debemos resolver por qué estiman regiones o escalas diferentes. Agregar información incompatible puede aumentar el número publicado sin corregir el problema de exploración que motivó el diagnóstico.
El informe final conserva tanto resultados como decisiones de diagnóstico. Debe indicar cuántas cadenas se ejecutaron, cuántas muestras se conservaron, qué adaptación se usó, qué advertencias aparecieron y cómo se resolvieron. Si permanece una discrepancia relevante, la conclusión debe limitarse o presentarse como no resuelta. Declarar con claridad esa limitación es más útil que anunciar la convergencia solo porque se alcanzó un número deseado.
234.10. Qué podemos afirmar después de diagnosticar
Un conjunto favorable de diagnósticos permite afirmar que no encontramos ciertas señales de mala exploración en las cadenas y funciones examinadas y que el error de Monte Carlo estimado es adecuado para cantidades definidas. Esa afirmación es más precisa que declarar que el algoritmo descubrió toda la distribución. Conserva el carácter empírico de la evaluación y permite que nuevas ejecuciones o comparaciones la revisen.
Los ejemplos mostraron límites complementarios. La comparación clásica de cadenas detecta diferencias grandes de ubicación, pero puede ocultar diferencias de escala. El tamaño efectivo depende de la función y puede superar el número de muestras cuando hay compensación por correlación negativa. El adelgazamiento reduce la dependencia entre valores guardados sin crear información nueva. Las medias por bloques estiman precisión dentro del comportamiento que la trayectoria consiguió representar.
También distinguimos el error de Monte Carlo de la incertidumbre del modelo. Una posterior puede estar muestreada con enorme precisión y describir mal los datos porque su estructura es inadecuada. Los diagnósticos de muestreo no sustituyen las comprobaciones predictivas ni la evaluación de supuestos. A la inversa, un modelo bien motivado no compensa una ejecución que no explora su posterior.
Un intervalo posterior describe incertidumbre inferencial bajo el modelo; un error de Monte Carlo describe la precisión con que calculamos un resumen de esa posterior. Aumentar las iteraciones puede reducir el segundo sin estrechar sustantivamente el primero. Confundirlos hace parecer que más cómputo equivale a disponer de más observaciones empíricas.
La finalidad de los diagnósticos es orientar decisiones concretas, como revisar el objetivo, cambiar la parametrización, modificar los movimientos, alargar las cadenas o reconocer que una cantidad todavía no está estimada con suficiente precisión. Su valor disminuye cuando se convierten en un trámite para marcar casillas. Cada indicador debe interpretarse según el problema que puede revelar y las limitaciones que conserva.
El siguiente capítulo examina el muestreo de importancia y los eventos raros. Allí encontraremos otra forma de tamaño efectivo, basada en pesos, con un significado distinto del que tiene para la autocorrelación en MCMC. La pregunta seguirá siendo cuánta información útil da el procedimiento para la cantidad que queremos calcular.
Referencias
- Vehtari, A., Gelman, A., Simpson, D., Carpenter, B., y Bürkner, P.-C. (2021). Rank-normalization, folding, and localization: An improved R-hat for assessing convergence of MCMC, with discussion. Bayesian Analysis, 16(2), 667–718. DOI: 10.1214/20-BA1221. Manuscrito de los autores.
- Vats, D., Flegal, J. M., y Jones, G. L. (2019). Multivariate output analysis for Markov chain Monte Carlo. Biometrika, 106(2), 321–337. DOI: 10.1093/biomet/asz002.
- Geyer, C. J. (1992). Practical Markov chain Monte Carlo. Statistical Science, 7(4), 473–483. DOI: 10.1214/ss/1177011137.
Nota didáctica. Las secuencias artificiales, los cálculos autorregresivos y las comparaciones de precisión son desarrollos propios. Las fórmulas clásicas se identifican como tales y no sustituyen una implementación completa de los diagnósticos modernos.