Módulo 24. Experimentos computacionales, muestreo y documentación
235.1. Cuando casi ninguna simulación aporta al resultado
Un evento raro puede ser difícil de estimar aunque el modelo que lo genera sea sencillo. Si su probabilidad es muy pequeña, una simulación directa dedica casi todo el esfuerzo a trayectorias donde el evento no ocurre. Esas trayectorias forman parte de la distribución correcta, aunque dicen poco sobre una probabilidad extrema. El remedio está en usar mejor las observaciones disponibles, algo que simular más rápido no garantiza.
Supongamos que queremos estimar la probabilidad de que una normal estándar supere cinco. Su valor es aproximadamente dos coma ochocientos sesenta y siete por diez elevado a menos siete. Con un millón de observaciones independientes esperaríamos menos de un tercio de excedencia. La probabilidad de no observar ninguna es aproximadamente cero coma setecientos cincuenta y uno. Un resultado empírico igual a cero sería, por tanto, muy frecuente aunque la probabilidad verdadera sea positiva.
La frecuencia de excedencias sigue siendo un estimador insesgado bajo muestreo directo. Su problema es la precisión relativa. La varianza de una proporción es la probabilidad multiplicada por su complemento y dividida por el número de observaciones. Cuando la probabilidad es diminuta, el error estándar puede ser pequeño en términos absolutos y enorme respecto del valor que queremos estimar.
Si ese millón de observaciones no contiene ninguna excedencia, tampoco corresponde reportar incertidumbre cero. Un límite superior binomial unilateral del noventa y cinco por ciento se obtiene buscando qué probabilidad haría que observar cero eventos tuviera probabilidad cinco por ciento. El resultado es aproximadamente tres por millón, más de diez veces la probabilidad que intentamos estimar. La muestra da una cota válida, pero apenas localiza la magnitud relevante, de modo que contar eventos directamente puede resultar insuficiente.
En este ejemplo, un millón de observaciones produce un error estándar relativo cercano a uno coma ochocientos sesenta y ocho. Para alcanzar aproximadamente diez por ciento de error estándar relativo mediante el mismo procedimiento necesitaríamos unos trescientos cuarenta y nueve millones de observaciones. Esta cifra se deduce de la fórmula teórica, sin haber ejecutado la simulación. Muestra por qué el costo debe fijarse según la cantidad que se estima y la precisión deseada.
El muestreo de importancia modifica la distribución usada para generar observaciones y corrige ese cambio mediante pesos. Buscamos visitar con mayor frecuencia las regiones que contribuyen a la integral sin alterar el valor de la cantidad objetivo. La idea forma parte de la tradición temprana de reducción de varianza en Monte Carlo, ejemplificada por el trabajo de Kahn y Marshall [1].
Simular más eventos y reportar su frecuencia como si perteneciera al modelo original sería estimar otra probabilidad. La corrección requiere conocer cómo cambió la ley de generación y evaluar cocientes de probabilidades o densidades. Si esos cocientes se calculan mal, una estimación aparentemente precisa puede converger de manera estable al valor equivocado.
235.2. Cambiar de distribución sin cambiar la integral
Sea p la densidad objetivo, q una densidad propuesta y f la función cuyo promedio queremos calcular. Multiplicar y dividir por q dentro de la integral permite escribir la esperanza bajo p como una esperanza ponderada bajo q. La identidad requiere que q sea positiva donde el producto de f y p contribuye a la integral. También necesitamos integrabilidad para que la esperanza esté bien definida.
Si generamos observaciones independientes de q y promediamos los productos de f por w, obtenemos un estimador insesgado cuando p está normalizada y se cumplen esas condiciones. Los pesos corrigen el cambio de frecuencia. Un estado visitado más a menudo que bajo p recibe un peso menor; uno visitado menos a menudo puede recibir un peso mayor.
La identidad vale también en espacios discretos si reemplazamos las integrales por sumas. Consideremos tres estados, A, B y C, con probabilidades objetivo de una mitad, tres décimas y dos décimas. La función toma valores cero, uno y diez. Su esperanza objetivo es dos coma tres. Elegimos una propuesta con probabilidades de dos décimas, cuatro décimas y cuatro décimas, que aumenta la frecuencia del estado que más contribuye al promedio.
Los pesos p/q de A, B y C valen dos coma cinco, cero coma setenta y cinco y cero coma cinco; las contribuciones de f por p/q son cero, cero coma setenta y cinco y cinco. Promediar esas contribuciones con probabilidades q da cuatro décimas por cero coma setenta y cinco más cuatro décimas por cinco, igual a dos coma tres. El estado A puede recibir un peso grande, pero su contribución a esta función es cero. La relevancia de un peso depende de su magnitud y también de la cantidad que queremos calcular.
La propuesta no necesita parecerse globalmente a p si el objetivo es una integral específica. Debe representar bien las regiones donde f por p importa y evitar contribuciones ponderadas demasiado variables. Si queremos estimar muchas funciones diferentes con las mismas observaciones, la elección se vuelve más exigente. Una propuesta excelente para una cola puede ser mala para una media central o para la constante de normalización.
235.3. La varianza decide si hubo una mejora
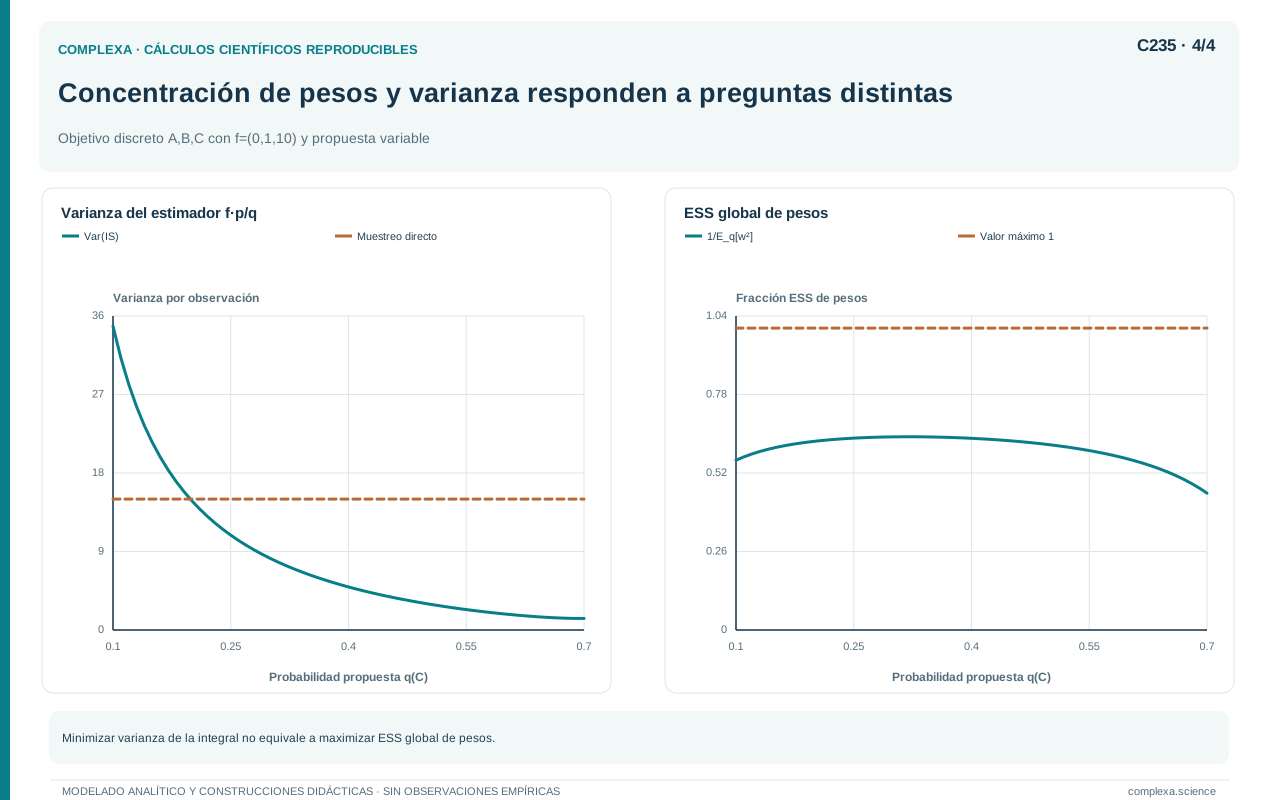
El cambio de distribución conserva la esperanza, pero no garantiza reducir la varianza. Bajo observaciones independientes de q, la varianza del estimador es la varianza de la contribución ponderada dividida por el número de observaciones. Esa varianza es finita solamente si el segundo momento correspondiente lo es. La igualdad de esperanzas tampoco asegura la validez de un intervalo normal aproximado.
En el ejemplo de tres estados, el segundo momento de f bajo p es veinte coma tres. Al restar el cuadrado de dos coma tres, la varianza del muestreo directo es quince coma cero uno por observación. Bajo la propuesta, el segundo momento de la contribución ponderada es diez coma doscientos veinticinco y su varianza es cuatro coma novecientos treinta y cinco. Para el mismo número de observaciones, la varianza se reduce aproximadamente a un tercio.
El cálculo muestra que deben compararse las contribuciones ponderadas completas. Si miráramos solamente la frecuencia del estado C, podríamos constatar que aumentó, pero todavía no sabríamos cuánto varía el estimador. Una propuesta demasiado concentrada en una parte del integrando puede asignar pesos enormes a otra parte que visita raramente. El ahorro aparente durante muchas ejecuciones puede desaparecer cuando llega una contribución excepcional.
Para una función no negativa, la propuesta ideal sería proporcional al producto de f y p. Bajo esa propuesta, la contribución ponderada es constante y la varianza se anula. Sin embargo, normalizarla requiere conocer la integral que intentamos calcular, o resolver un problema equivalente. La propuesta ideal es, así, una orientación conceptual; indica que debemos aproximar la distribución de las contribuciones, sin suponer que la solución óptima está disponible gratuitamente.
Si la función cambia de signo, la propuesta que minimiza el segundo momento es proporcional al valor absoluto de f multiplicado por p. Las contribuciones conservan entonces signos distintos y la varianza no tiene por qué desaparecer. Por ejemplo, una función que vale uno o menos uno en dos estados equiprobables tiene esperanza cero. La propuesta óptima sigue asignando una mitad a cada estado; cada contribución vale uno o menos uno y el segundo momento permanece igual a uno. La cancelación entre aportes positivos y negativos exige otra clase de estructura para obtener un estimador constante.
Cuando f es un indicador de evento, la propuesta ideal coincide con la distribución objetivo condicionada a ese evento. Esto explica por qué interesa simular trayectorias que lo hagan más probable. Para corregir, además de generar trayectorias que cumplan el evento, debemos conocer la densidad o probabilidad de la propuesta usada y su cociente con la original.
La eficiencia también depende del costo por observación. Si una propuesta reduce la varianza a la mitad pero cuesta cien veces más generar y evaluar cada observación, puede ser peor bajo un presupuesto fijo. Por ello conviene comparar varianza, tiempo y estabilidad numérica. La reducción de varianza es una propiedad del estimador bajo un diseño; su utilidad computacional depende además del trabajo que ese diseño exige.
235.4. Pesos normalizados y constantes desconocidas
En muchos problemas conocemos una densidad objetivo solamente hasta una constante. Entonces podemos calcular pesos proporcionales, pero no el cociente normalizado completo. Una solución habitual es dividir la suma ponderada de f por la suma de los pesos. La constante desconocida se cancela en ese cociente. Este procedimiento se llama muestreo de importancia autonormalizado.
El estimador de cociente suele ser sesgado en muestras finitas, aunque puede ser consistente bajo condiciones de cobertura e integrabilidad. La normalización usa datos aleatorios y correlaciona numerador y denominador. Sus propiedades deben analizarse como las de un cociente cuyos pesos finales dependen de la muestra.
Volvamos al ejemplo discreto y supongamos que una muestra de cuatro estados contiene A, B, C y C. La suma de pesos es cuatro coma veinticinco y la suma de contribuciones es diez coma setenta y cinco. El estimador ordinario divide por cuatro y vale dos coma seiscientos ochenta y siete cinco. El autonormalizado divide por cuatro coma veinticinco y vale aproximadamente dos coma quinientos veintinueve. Ninguno coincide exactamente con dos coma tres en esta muestra.
Una sola realización no permite decidir cuál es mejor; para eso necesitamos evaluar sus distribuciones de error o usar resultados teóricos bajo el diseño. La autonormalización puede ser necesaria cuando la constante no está disponible, pero no siempre mejora el estimador. Si p está normalizada y la propuesta se diseñó para una función específica, normalizar de nuevo puede introducir un denominador muy inestable.
La cobertura requerida también cambia de énfasis. Para una integral ordinaria puede bastar cubrir donde f por p es distinto de cero. Para reconstruir esperanzas mediante pesos normalizados necesitamos representar la masa objetivo que determina el denominador. Una propuesta concentrada solamente en un evento puede servir, en principio, para su integral con normalización conocida y ser inadecuada para estimar a la vez toda la distribución.
En implementaciones numéricas conviene calcular logaritmos de pesos y normalizarlos mediante una operación estable. Restar el mayor logaritmo antes de exponenciar evita ciertos desbordamientos y conserva proporciones. Esta transformación resuelve un problema de representación numérica, pero no corrige una propuesta que produce pesos estadísticamente extremos. Estabilidad aritmética y estabilidad del estimador deben evaluarse por separado.
235.5. Resolver una cola normal mediante desplazamiento
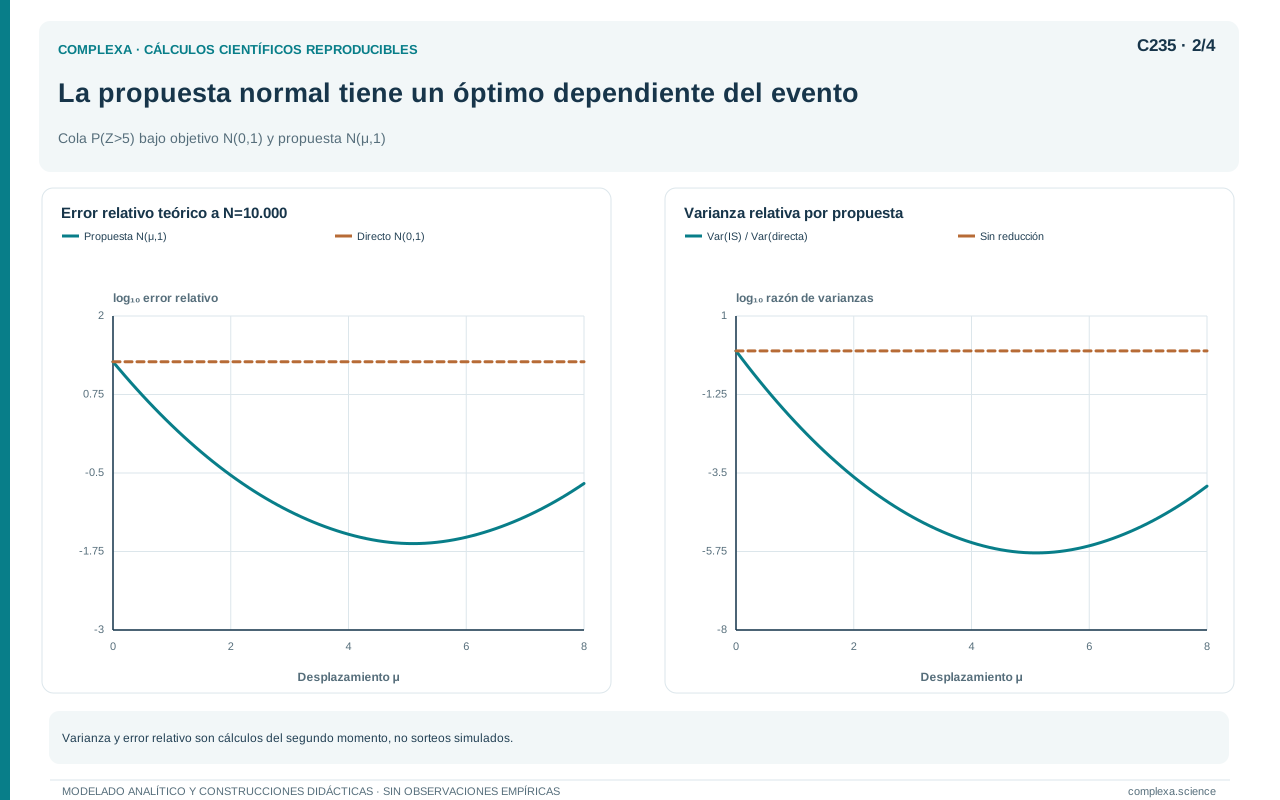
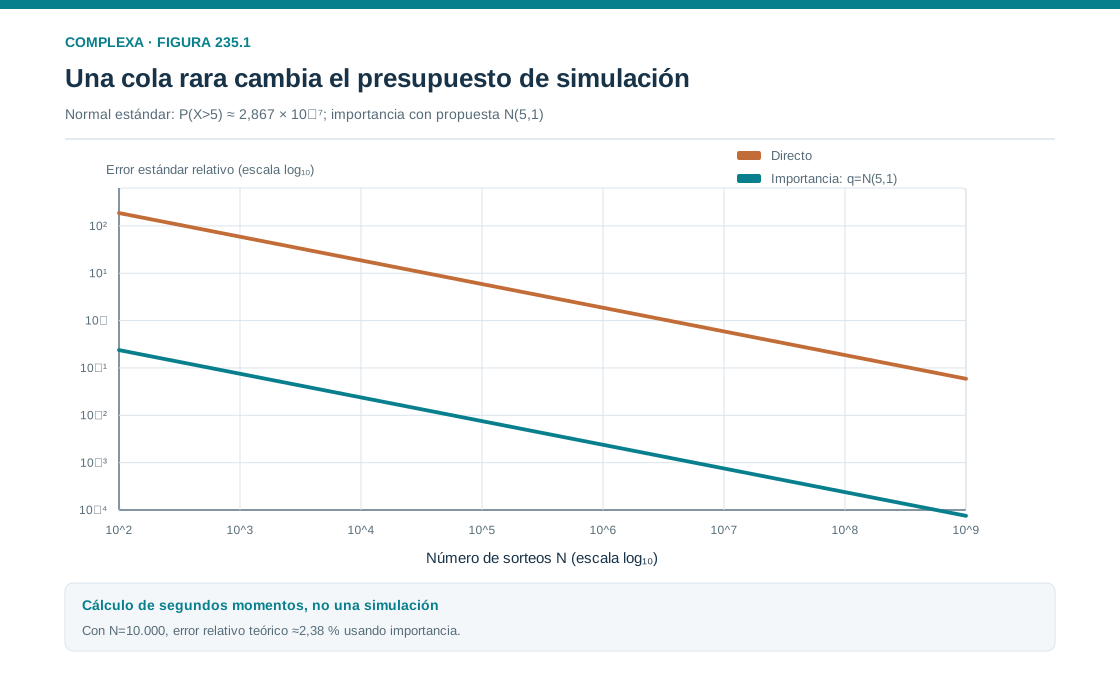
Regresemos al evento de superar cinco bajo una normal estándar. En vez de generar observaciones centradas en cero, usamos una normal de media cinco y varianza uno. Bajo esta propuesta, aproximadamente la mitad de las observaciones supera el umbral. La razón de densidades entre la normal original y la desplazada tiene una expresión sencilla, obtenida al restar sus exponentes cuadráticos.
El estimador ordinario promedia el indicador de superar cinco multiplicado por ese peso. Las observaciones cercanas al umbral ocurren con frecuencia bajo q y reciben un peso pequeño, acorde con su rareza bajo p. Las observaciones que no superan cinco tienen contribución nula a la integral. El procedimiento usa la densidad normalizada conocida y conserva el promedio ordinario, sin recurrir a un cociente autonormalizado.
Podemos calcular su segundo momento exactamente. Para una propuesta normal desplazada una cantidad mu y un umbral a, el segundo momento de la contribución es la exponencial del cuadrado de mu multiplicada por la cola normal por encima de a más mu. Con ambos valores iguales a cinco, resulta aproximadamente cinco coma cuatrocientos ochenta y siete por diez elevado a menos trece.
Al restar el cuadrado de la probabilidad objetivo obtenemos una varianza por observación de aproximadamente cuatro coma seiscientos sesenta y cinco por diez elevado a menos trece. Con diez mil observaciones, el error estándar relativo teórico es aproximadamente dos coma treinta y ocho por ciento. El contraste con los cientos de millones requeridos por muestreo directo para una precisión relativa más modesta muestra una ganancia sustantiva en este caso.
Las cifras son analíticas y valen solo para esta propuesta, este evento y estas distribuciones. Una propuesta demasiado desplazada puede perder regiones que contribuyen mucho y producir otra distribución de pesos. La elección debe examinar el integrando completo y la varianza resultante.
Este ejemplo también advierte contra usar un diagnóstico global de pesos como único criterio. La propuesta centrada en cinco visita poco la región central de la normal original, de modo que estimar la suma esperada de pesos puede ser difícil. Sin embargo, cubre bien la región que contribuye al evento. Una propuesta puede ser eficiente para una integral ordinaria y poco adecuada para reconstruir esperanzas generales mediante autonormalización.
235.6. Ponderar trayectorias completas
En sistemas dinámicos, el evento depende de una trayectoria y la propuesta puede modificar muchas transiciones. El peso correcto compara las probabilidades de las trayectorias completas. Si alteramos la distribución inicial o las reglas de transición, el peso debe incorporar sus cocientes. Ponderar solamente el estado final suele omitir cómo se llegó a él y puede producir una corrección equivocada.
El experimento de pedidos del capítulo 232 es un ejemplo con solución exacta. Bajo el modelo original, cada día llega un lote con probabilidad un medio. Con capacidad diez y cola inicial vacía, no superar cuatro pedidos pendientes durante treinta días exige que no llegue ningún lote. La probabilidad es dos elevado a menos treinta, aproximadamente nueve coma trescientos trece por diez elevado a menos diez.
Diseñemos una propuesta con jornadas independientes y probabilidad diaria de llegada de una décima. El evento sin llegadas tiene ahora probabilidad nueve décimas elevado a treinta, aproximadamente cuatro coma veinticuatro por ciento, de modo que podemos observarlo con frecuencia razonable. Sin embargo, cada trayectoria debe recibir la corrección correspondiente a su número de días con y sin llegada.
Si una trayectoria contiene k llegadas durante treinta días, su peso es el cociente de probabilidades de llegada elevado a k multiplicado por el cociente de probabilidades de ausencia elevado a treinta menos k. Para la trayectoria que contribuye al evento, k es cero. Su peso es cinco novenos elevado a treinta, aproximadamente dos coma ciento noventa y siete por diez elevado a menos ocho.
Multiplicar la probabilidad propuesta del evento por su peso recupera exactamente dos elevado a menos treinta. Con diez mil trayectorias propuestas, el error estándar relativo teórico del estimador es aproximadamente cuatro coma setenta y cinco por ciento. La ganancia procede de hacer frecuente una trayectoria antes extraordinaria y de corregir exactamente esa alteración.
En un modelo con llegadas dependientes, la corrección necesitaría probabilidades condicionales dadas las historias pertinentes. Si una propuesta cambia su comportamiento según el estado de la cola, el producto debe reflejar esas decisiones. Esto afecta a la arquitectura experimental, porque guardar solamente resultados finales puede ser insuficiente para reconstruir los pesos; el diseño debe conservar la información necesaria sobre la ley de generación.
235.7. Cobertura y colas de los pesos
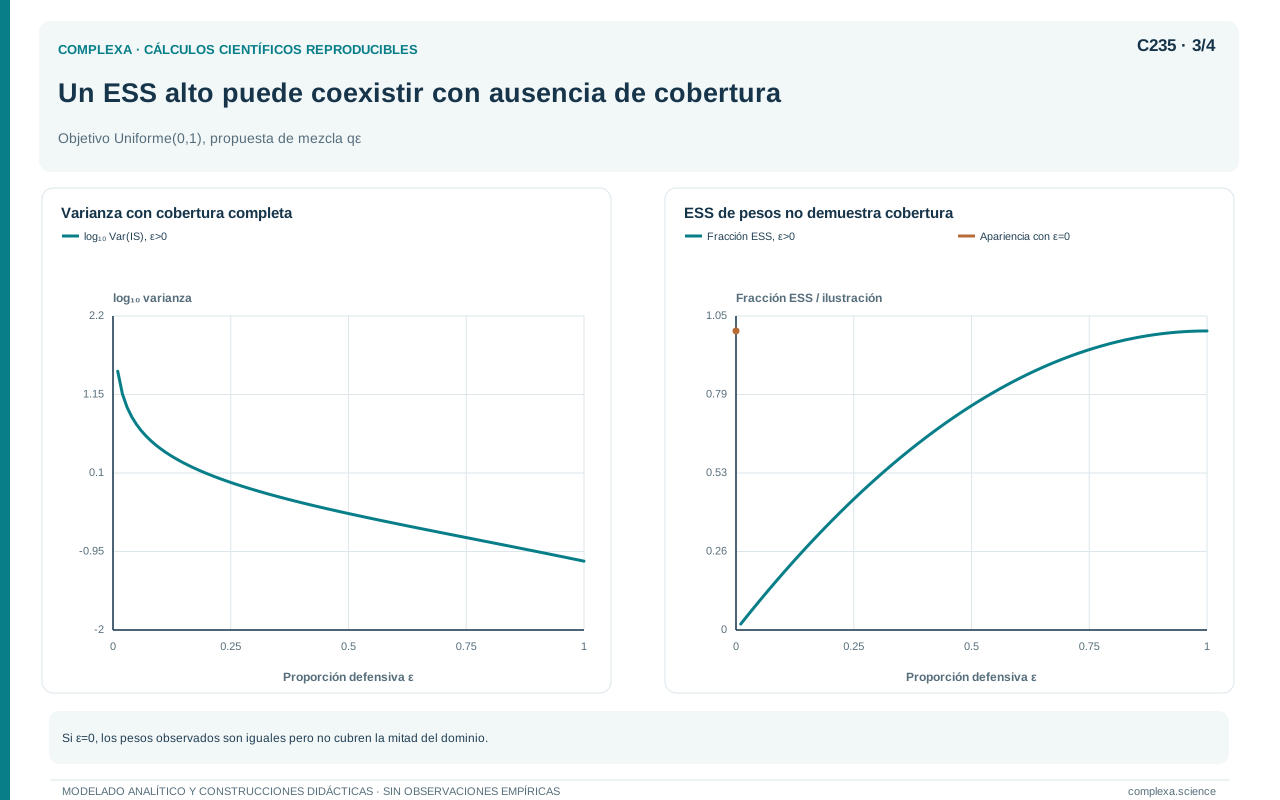
Supongamos, para ver qué ocurre cuando falla la cobertura, que el objetivo es uniforme entre cero y uno y que la propuesta lo es solamente entre cero y una mitad. En la región visitada, el cociente de densidades es una mitad. Si queremos integrar la función constante uno, el promedio ponderado vale siempre una mitad, aunque la integral correcta sea uno. Ningún aumento de muestras recuperará la mitad del dominio que la propuesta excluye.
La autonormalización puede ocultar parcialmente el problema. Para la función constante uno devuelve uno por construcción. Sin embargo, al estimar la media de la coordenada converge a un cuarto, mientras que la media objetivo es una mitad. Los pesos observados son todos iguales y parecen perfectamente equilibrados. El error procede de la masa ausente, que no deja rastro de variabilidad en las observaciones disponibles.
Incluso con cobertura completa podemos tener varianza infinita. Consideremos una densidad exponencial de tasa uno como objetivo y una exponencial de tasa dos como propuesta. Ambas cubren todos los valores positivos, pero la propuesta tiene una cola más ligera. El peso es la mitad de la exponencial de x. Su esperanza bajo la propuesta es uno, mientras que su segundo momento diverge.
Basta elevar el peso al cuadrado y multiplicarlo por la densidad propuesta; los exponentes se cancelan y queda una constante positiva integrada sobre un intervalo infinito. El promedio de pesos conserva una esperanza finita, pero carece de la varianza que requiere un error estándar convencional basado en el teorema central del límite usual. Muchas muestras moderadas pueden dar una impresión engañosa antes de que aparezca un peso enorme.
Las mezclas defensivas buscan reducir esta vulnerabilidad. Si podemos incluir la densidad objetivo normalizada como componente de una propuesta con proporción epsilon, la propuesta es al menos epsilon veces el objetivo. Por tanto, el cociente de importancia queda acotado por el inverso de epsilon. Hesterberg estudió este enfoque mediante distribuciones de mezcla [2].
La construcción exige poder evaluar y generar los componentes correspondientes. En una posterior conocida solamente hasta una constante, incluir directamente el objetivo puede ser tan difícil como el problema original. Otras propuestas de colas amplias pueden ayudar, pero no heredan automáticamente la misma cota. La defensa debe justificarse con la distribución realmente usada.
235.8. Tamaño efectivo de pesos y suavizado
Un resumen habitual de concentración de pesos normalizados es el inverso de la suma de sus cuadrados. Si todos son iguales, el valor coincide con el número de observaciones. Si uno concentra casi toda la masa, el valor se aproxima a uno. Para pesos no negativos normalizados, estos límites se deducen directamente de sus propiedades algebraicas.
Esta cantidad difiere del tamaño efectivo derivado de la autocorrelación en MCMC. Describe la concentración relativa de los pesos y puede calcularse incluso con observaciones independientes. No mide exactamente la precisión para todas las funciones, pues dos integrandos evaluados sobre las mismas observaciones reciben el mismo resumen de pesos y pueden tener errores radicalmente distintos.
En la muestra discreta A, B, C, C, la suma de pesos es cuatro coma veinticinco y la suma de sus cuadrados es siete coma trescientos doce cinco. El tamaño efectivo de pesos resulta aproximadamente dos coma cuarenta y siete. La cifra resume la desigualdad entre esos cuatro pesos, pero el error del promedio de f no tiene por qué coincidir con el de dos coma cuarenta y siete observaciones directas. De hecho, el estado con mayor peso tiene f igual a cero. Por eso, leer la cifra literalmente como un número de observaciones equivalentes puede inducir errores al comparar propuestas.
El ejemplo de cobertura incompleta es el caso extremo, con pesos iguales, tamaño efectivo máximo y una estimación incorrecta de la media. Un diagnóstico calculado únicamente sobre puntos visitados no puede detectar una región que nunca tuvo oportunidad de aparecer. La cobertura debe examinarse mediante el diseño de la propuesta y el conocimiento del objetivo.
Los pesos extremos merecen un análisis propio. Podemos estudiar cuánto contribuyen al resultado, cómo cambia la estimación al aumentar el tamaño de muestra y si diferentes propuestas producen resultados compatibles. Eliminar los pesos grandes sin una regla justificada modifica el estimador y puede introducir sesgo. La estabilidad obtenida por truncamiento debe evaluarse junto con ese cambio, puesto que el procedimiento ya no es el estimador exacto original.
El suavizado de importancia mediante Pareto, desarrollado por Vehtari y colaboradores, ajusta una distribución de Pareto generalizada a la cola superior de los cocientes para estabilizar contribuciones extremas y dar diagnósticos de su comportamiento [3]. Su parámetro estimado de cola ayuda a evaluar la dificultad del muestreo. El método no crea cobertura donde la propuesta asigna probabilidad cero.
La elección de umbrales diagnósticos y la interpretación del suavizado dependen del método y del tamaño de muestra. No usaremos aquí una cifra única como certificado universal. Para un informe reproducible deben registrarse la implementación, la regla de suavizado y, cuando sean pertinentes, los resultados antes y después de suavizar. El diagnóstico complementa el análisis del objetivo y del integrando; el cálculo sigue apoyándose en la identidad de cambio de medida.
235.9. Diseñar y auditar una propuesta
El diseño comienza por identificar qué regiones contribuyen a la cantidad de interés. Para una probabilidad rara, necesitamos comprender qué trayectorias producen el evento y cuáles dominan su probabilidad. Si hay varios mecanismos de fallo, concentrar toda la propuesta en uno puede ocultar otros. Una mezcla de propuestas puede representar alternativas distintas, siempre que su densidad conjunta se evalúe correctamente al calcular pesos.
Una fase piloto puede orientar los parámetros de la propuesta. Conviene separar esa exploración de una evaluación final o usar un procedimiento adaptativo con propiedades conocidas. Ajustar una propuesta a las mismas observaciones que después tratamos como si procedieran de una ley fija requiere cuidado. La dependencia introducida por la adaptación modifica el análisis y debe reflejarse en la justificación del estimador.
La auditoría comprueba primero soporte, normalización y cocientes. En ejemplos pequeños podemos enumerar estados o trayectorias y verificar que la esperanza ponderada coincide con la cantidad objetivo. En ejemplos continuos con integrales conocidas, como la cola normal, contrastamos con valores analíticos. Estas pruebas detectan errores de signo, factores omitidos y confusiones entre densidad de una observación y probabilidad de una trayectoria.
Después examinamos segundos momentos y estabilidad. Si podemos demostrar una cota o calcular la varianza, obtenemos una referencia fuerte. Si no, las réplicas independientes del experimento ayudan a evaluar la dispersión empírica, aunque pueden no revelar colas extremadamente raras.
El informe debe distinguir estimadores ordinarios y autonormalizados, propuestas fijas y adaptativas, muestras independientes y dependientes. También debe declarar si se aplicó truncamiento o suavizado. Estas decisiones cambian las propiedades de sesgo, varianza y error estándar. Una columna titulada «probabilidad estimada» resulta insuficiente si el lector no puede reconstruir qué promedio o cociente produjo la cifra.
La comparación de eficiencia debe usar un presupuesto pertinente. Podemos informar el error relativo teórico o empírico, el tiempo por observación y el costo total para alcanzar una precisión. Los ejemplos del capítulo muestran grandes ganancias, pero también fallos irreparables por soporte incompleto y dificultades por varianza infinita. Una propuesta se justifica por esa evaluación conjunta, más allá de que produzca más eventos que el muestreo original.
También conviene conservar la propuesta descartada y el motivo del descarte cuando la elección se apoyó en resultados piloto. Esa información permite evaluar si el diseño final respondió a una dificultad identificada o si fue seleccionado por producir accidentalmente la cifra que se esperaba encontrar.
235.10. Observar más eventos y corregir su frecuencia
El muestreo de importancia transforma un problema de espera en un problema de diseño de distribución. Bajo una propuesta hacemos más frecuente un evento que aparece raramente bajo el objetivo y corregimos el cambio con pesos. La identidad matemática es simple; la dificultad consiste en elegir una propuesta cuya cobertura y variabilidad permitan estimar la cantidad con precisión útil.
Los casos resueltos separaron varias situaciones. La propuesta discreta redujo la varianza al visitar más el estado que contribuía al promedio. El desplazamiento normal permitió estimar una cola extrema con mucha mayor eficiencia teórica. El cambio de probabilidades de llegada mostró cómo ponderar trayectorias completas. La propuesta uniforme incompleta y la exponencial demasiado estrecha revelaron dos problemas distintos, el sesgo por masa excluida y la ausencia de un segundo momento finito.
También distinguimos la concentración de pesos de la precisión para una función. Una cifra alta de tamaño efectivo no garantiza cobertura; una propuesta adecuada para una integral específica puede ser mala para autonormalizar toda una distribución. El estimador, el objetivo y el integrando deben considerarse juntos al interpretar cualquier diagnóstico.
El conocimiento del mecanismo puede mejorar el cálculo. Identificar qué produce un evento raro orienta propuestas, mezclas y transformaciones. A la vez, una buena propuesta computacional no prueba que el modelo del evento sea correcto en el mundo empírico; podemos estimar con gran precisión una probabilidad definida por supuestos inadecuados. Revisar el modelo y revisar el estimador son tareas distintas.
El siguiente capítulo amplía las estrategias de reducción de varianza mediante comparaciones emparejadas, variables de control y otros recursos. La pregunta será cómo usar estructura conocida para obtener más precisión con el mismo presupuesto. El principio que llevamos de este capítulo es que modificar el procedimiento de simulación puede ahorrar mucho trabajo, siempre que podamos justificar qué cantidad sigue estimando y con qué incertidumbre.
Referencias
- Kahn, H., y Marshall, A. W. (1953). Methods of reducing sample size in Monte Carlo computations. Journal of the Operations Research Society of America, 1(5), 263–278. DOI: 10.1287/opre.1.5.263.
- Hesterberg, T. (1995). Weighted average importance sampling and defensive mixture distributions. Technometrics, 37(2), 185–194. DOI: 10.1080/00401706.1995.10484303.
- Vehtari, A., Simpson, D., Gelman, A., Yao, Y., y Gabry, J. (2024). Pareto smoothed importance sampling. Journal of Machine Learning Research, 25(72), 1–58. Artículo original.
Nota de los cálculos. Los ejemplos discretos, las probabilidades de cola normal, el cambio de medida de trayectorias y las comparaciones de varianza son derivaciones propias. Las precisiones indicadas son teóricas para los diseños especificados.