Módulo 24. Experimentos computacionales, muestreo y documentación
238.1. Dos preguntas que conviene separar
La propagación de incertidumbre pregunta qué variación de resultados produce una incertidumbre especificada en las entradas. El análisis de sensibilidad pregunta cómo se relaciona esa variación con entradas, grupos de entradas o supuestos. La primera tarea describe una distribución de salida; la segunda intenta explicar qué aspectos del planteamiento influyen en ella.
Un intervalo amplio de resultados puede proceder de una tasa mal conocida, de fluctuaciones internas, de alternativas estructurales o de varias fuentes combinadas. Ejecutar muchas simulaciones no distingue automáticamente esas posibilidades. Necesitamos un diseño que conserve el origen de cada variación y defina qué cantidad queremos atribuir. Sin él, un histograma mezcla diferencias que requieren respuestas científicas distintas.
La incertidumbre paramétrica es el desconocimiento o la variabilidad de valores que el modelo recibe como entradas. La incertidumbre estructural concierne a reglas y mecanismos alternativos. La variabilidad interna corresponde a realizaciones distintas bajo una misma configuración estocástica. El error numérico procede de aproximaciones de cálculo. El error de Monte Carlo describe la precisión limitada con que estimamos propiedades de esas distribuciones.
Estas categorías pueden interactuar y su delimitación depende del propósito. Una tasa puede tratarse como fija desconocida para estudiar un sistema particular o como variable entre sistemas de una población. La distribución asignada debe expresar esa interpretación. Usar la misma distribución matemática en ambos casos no hace intercambiables sus conclusiones.
Una medida de sensibilidad tampoco es una propiedad intrínseca de un parámetro aislado. Depende de la respuesta, el dominio, la distribución conjunta de entradas y la definición adoptada. Una entrada con gran derivada puede contribuir poco a la incertidumbre si apenas varía. Otra con efecto moderado puede dominar porque su rango plausible es enorme.
Saltelli y Annoni criticaron los análisis que modifican entradas de forma limitada sin explorar adecuadamente el espacio relevante [1]. La lección práctica que adoptaremos es formular primero la pregunta de sensibilidad, ya sea priorizar mediciones, simplificar el modelo, identificar interacciones, comprobar una decisión o estudiar un umbral. Cada finalidad puede requerir una medida y un diseño diferentes.
Comenzaremos con transformaciones cuya distribución exacta conocemos y después examinaremos descomposiciones de varianza. Los ejemplos permitirán separar sensibilidad local y global, estudiar el efecto de las dependencias y distinguir variación entre parámetros de ruido dentro de cada simulación. Así obtendremos una interpretación más útil que una lista de parámetros ordenados sin contexto.
238.2. Propagar una distribución completa
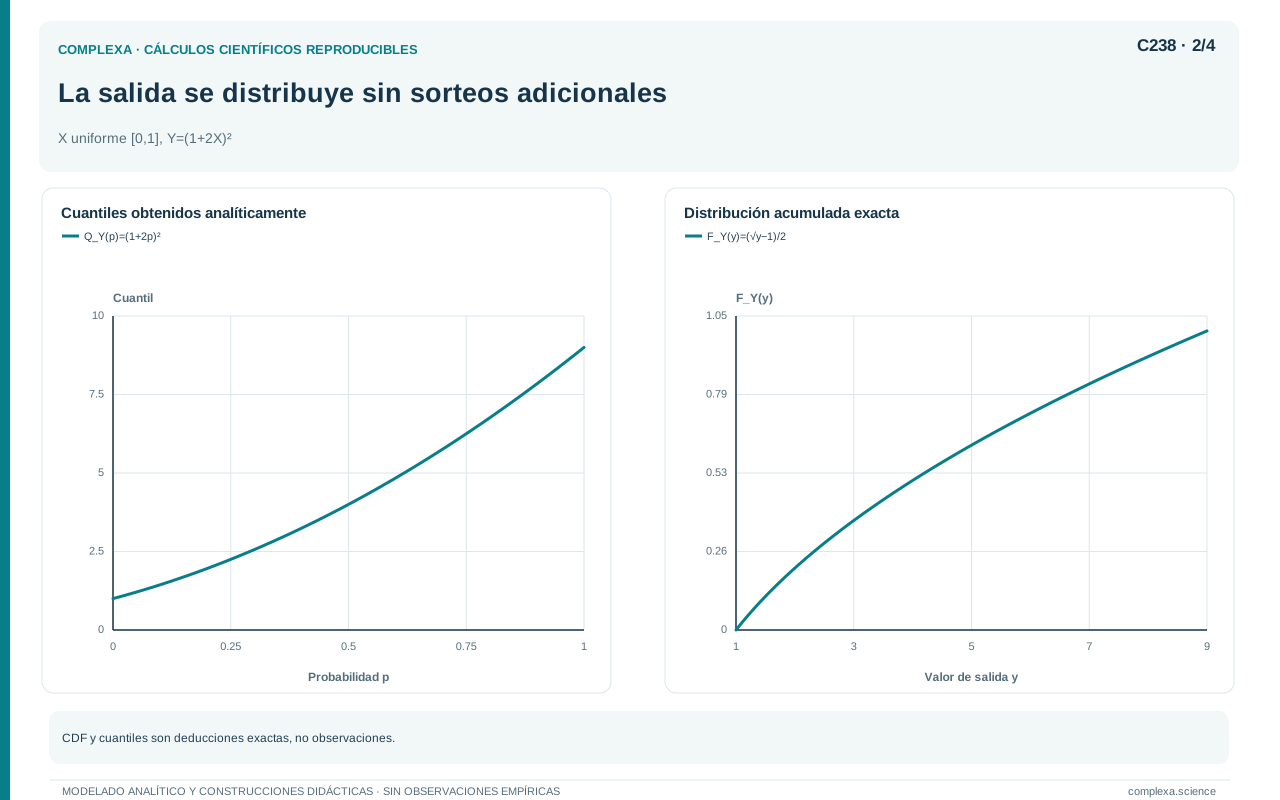
Sea X uniforme entre uno y tres y definamos Y como su cuadrado. La media de X es dos. Sustituir X por su media produce una respuesta de cuatro, pero la media de Y es trece tercios, aproximadamente cuatro coma trescientos treinta y tres. La no linealidad hace que transformar la media y promediar las transformaciones sean operaciones diferentes.
Podemos calcular la distribución completa porque el cuadrado es creciente en este intervalo. Para un valor y entre uno y nueve, que Y sea menor o igual que y equivale a que X sea menor o igual que la raíz de y. La función de distribución es, por tanto, la raíz de y menos uno, dividida por dos.
La mediana es cuatro, mientras que la media es mayor. El percentil cinco vale uno coma veintiuno y el percentil noventa y cinco, ocho coma cuarenta y uno. El intervalo entre ambos contiene el noventa por ciento de la distribución especificada. No es un intervalo de confianza calculado a partir de datos ni una garantía de que el modelo represente una población real.
El segundo momento de Y es ciento veintiuno quintos. Al restar el cuadrado de trece tercios obtenemos una varianza de doscientos cuarenta y cuatro cuarenta y cincoavos, aproximadamente cinco coma cuatrocientos veintidós. Estas cantidades describen la dispersión de salidas bajo la distribución elegida para X, independientemente de cuántas simulaciones usemos para estimarlas.
Una simulación Monte Carlo tomaría valores de X, calcularía sus cuadrados y resumiría los resultados. Su error de estimación disminuiría al aumentar muestras, pero la varianza de Y permanecería igual. Más réplicas mejoran la precisión del cálculo, pero no cambian la amplitud del fenómeno representado.
La distribución de entrada es una afirmación sustantiva. Elegir una uniforme supone que intervalos de igual longitud dentro del rango reciben igual probabilidad. Si solo conocemos límites, esa asignación puede ser una convención de exploración, pero no por ello se convierte en evidencia probabilística. Conviene presentar análisis alternativos cuando la forma de la distribución no está justificada.
También importa la representación de extremos. Una distribución con colas extensas puede producir cuantiles y varianzas muy diferentes aunque su región central se parezca a otra. Si la pregunta trata de superar un umbral, debemos examinar la información que sostiene esas colas. Una media de entrada, aunque esté bien estimada, deja sin determinar la probabilidad de un valor extremo de salida.
Cuando solo disponemos de un intervalo para X, podemos propagar ese conjunto sin asignar probabilidades. En el ejemplo cuadrático, el intervalo entre uno y tres se transforma exactamente en el intervalo entre uno y nueve. Esta afirmación sobre valores posibles no autoriza a decir que la salida tiene media trece tercios o que cierto intervalo contiene noventa por ciento de probabilidad; esas conclusiones requieren además la distribución uniforme. Separar ambas formas de información evita convertir límites de plausibilidad en frecuencias implícitas.
238.3. Sensibilidad local y aproximaciones lineales
La sensibilidad local describe cómo cambia la respuesta cerca de una configuración. Para una función diferenciable de varias entradas, el gradiente reúne las derivadas parciales. Cada derivada expresa una tasa de cambio manteniendo las otras coordenadas fijas. Su interpretación depende de las unidades y de que esa modificación sea admisible dentro del dominio.
Una expansión lineal alrededor de la media de entradas permite aproximar la varianza de salida mediante el gradiente y la matriz de covarianzas. Esta aproximación requiere que la linealización sea adecuada en la región donde se concentra la incertidumbre; no es una identidad general para funciones no lineales ni para distribuciones muy dispersas.
En el ejemplo del cuadrado, la derivada en la media dos vale cuatro y la varianza de X es un tercio. La aproximación produce dieciséis tercios, aproximadamente cinco coma trescientos treinta y tres. El valor exacto era doscientos cuarenta y cuatro cuarenta y cincoavos. La diferencia es pequeña, pero no debemos ocultarla presentando la aproximación como exacta.
La misma expansión de primer orden no corrige la media y predice cuatro. El término cuadrático añade la varianza de X y recupera trece tercios porque la función es exactamente cuadrática. En funciones más complejas, términos superiores pueden contribuir y la calidad de la aproximación debe comprobarse. El orden necesario depende del rango de entradas y de la curvatura.
Comparar derivadas con unidades distintas puede ser engañoso. Cambiar una tasa de horas a minutos altera su valor numérico sin cambiar el sistema. Podemos usar entradas estandarizadas o elasticidades, que expresan cambios relativos. Una elasticidad multiplica la derivada por la entrada y divide por la respuesta, por lo que necesita cuidado cuando alguna es cero o cambia de signo.
Las derivadas tampoco detectan todas las propiedades globales. Una función puede tener derivada cero en un punto y variar mucho fuera de él, como ocurre con el cuadrado cerca del origen. Una función con umbral puede ser localmente constante en casi todas partes y, aun así, cambiar de manera decisiva cuando una pequeña perturbación cruza la frontera.
La sensibilidad local es útil para ajustes pequeños, optimización y aproximaciones alrededor de una configuración bien determinada. Para evaluar incertidumbres amplias o interacciones necesitamos explorar más allá de esa configuración. En simuladores estocásticos, además, una diferencia finita entre dos ejecuciones contiene ruido. Emparejar entradas aleatorias y usar réplicas puede ayudar a estimar la derivada de una respuesta media con precisión suficiente.
238.4. Descomponer la varianza con entradas independientes
Para una función con varianza finita y entradas independientes, podemos descomponer la respuesta en una constante, contribuciones individuales e interacciones ortogonales. La ortogonalidad permite sumar sus varianzas sin términos de covarianza. Los índices de esta descomposición, desarrollados por Sobol, expresan fracciones de la varianza total [2].
El índice de primer orden de una entrada usa la varianza de la respuesta media condicionada a esa entrada. El índice total abarca todos los términos de la descomposición en los que participa la entrada, incluidas sus interacciones. Ambos requieren una varianza total positiva para que el cociente esté definido.
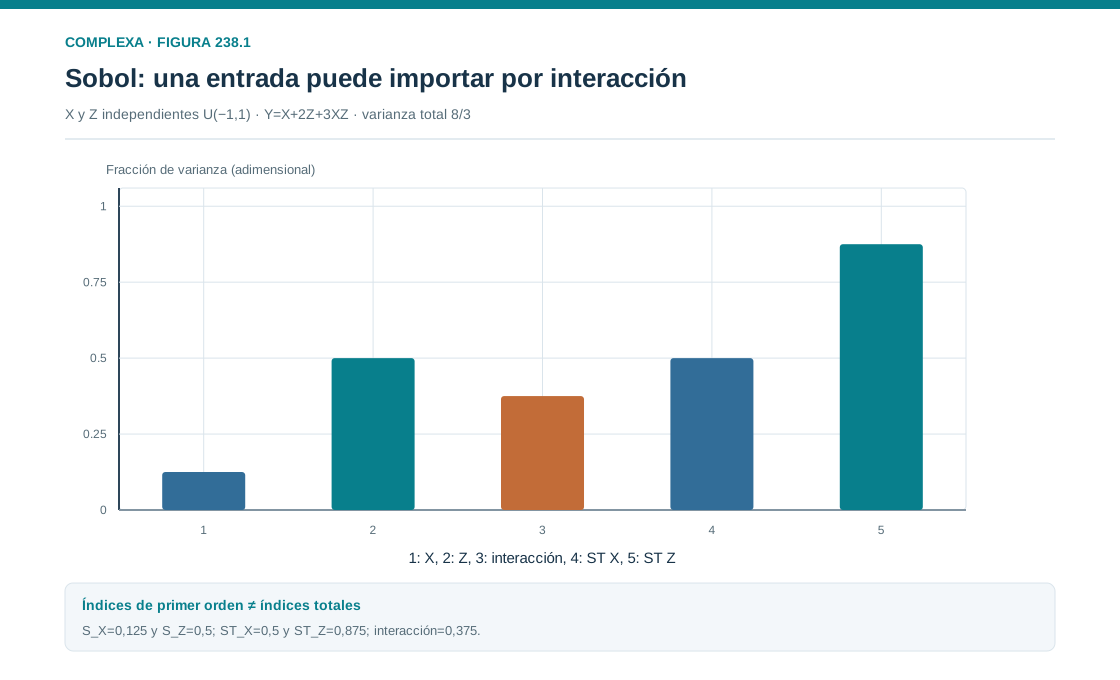
Resolvamos un ejemplo con X y Z independientes y uniformes entre menos uno y uno. Definimos Y como X más dos veces Z más tres veces su producto. Ambas entradas tienen media cero y varianza un tercio. Los tres términos tienen media cero y son ortogonales bajo esta distribución, de modo que podemos calcular cada contribución exactamente.
La varianza de X es un tercio; la de dos Z es cuatro tercios. La varianza de tres XZ es nueve veces el producto de las varianzas, igual a uno. La varianza total es ocho tercios. Estas cantidades son exactas y se deducen de la independencia, de los momentos de la uniforme y de la expresión de la función.
El índice de primer orden de X es un octavo y el de Z, una mitad. Suman cinco octavos; los tres octavos restantes corresponden a la interacción. El índice total de X, que suma su contribución individual y la interacción, vale una mitad. El de Z vale siete octavos. Los índices totales suman once octavos porque cuentan la interacción una vez para cada variable participante.
Ese valor superior a uno no es un error de normalización. Los índices totales responden a preguntas superpuestas y no forman una partición de la varianza. En cambio, los componentes individuales y las interacciones de la descomposición completa sí suman uno después de dividir por la varianza total. Confundir ambas sumas puede llevar a corregir indebidamente resultados válidos.
238.5. Interacciones y prioridades de medición
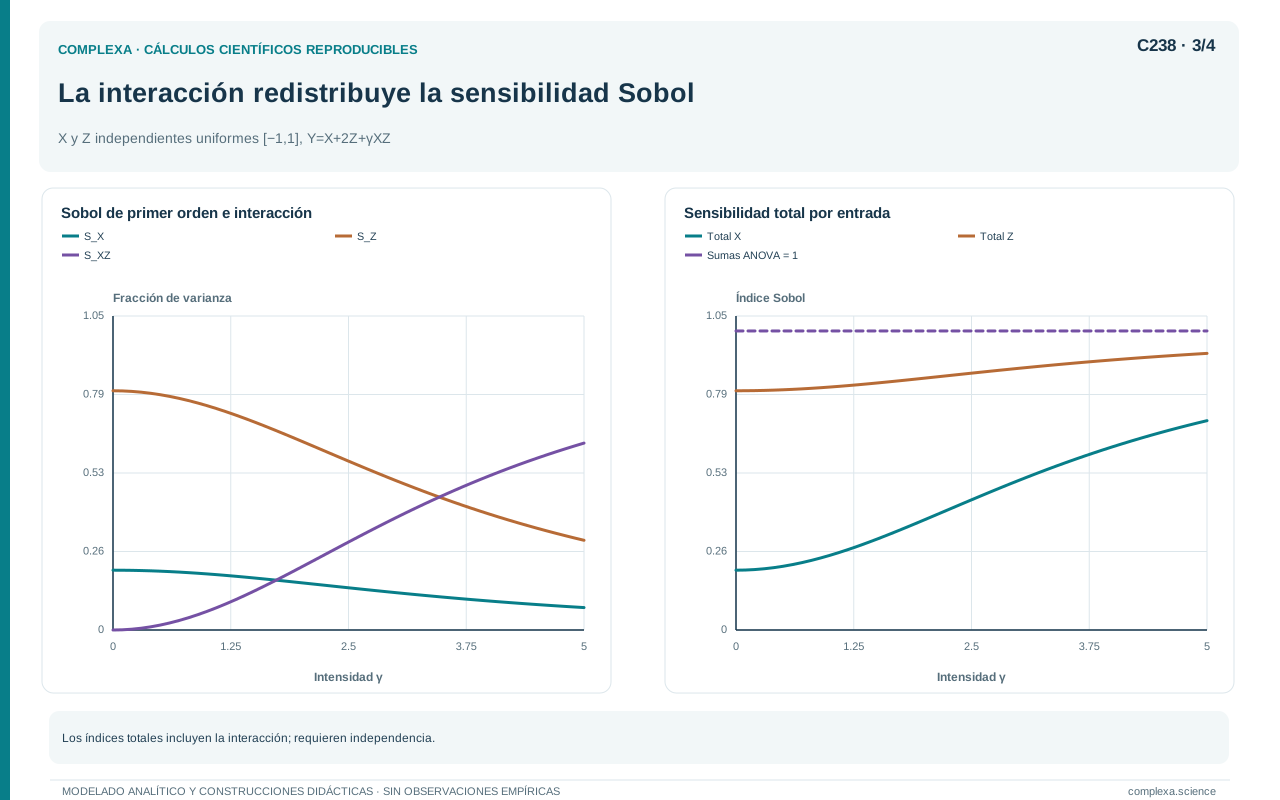
El índice de primer orden puede ser pequeño aunque una entrada sea necesaria para una gran parte de la variación. En el ejemplo anterior, X explica individualmente un octavo, pero participa en la mitad de la varianza cuando contamos su interacción. Un ranking basado solo en índices de primer orden podría subestimar su importancia para simplificar el modelo.
El caso extremo es el producto de dos uniformes independientes centradas. La respuesta media condicionada a cualquiera de ellas es cero porque la otra tiene media cero. Por tanto, ambos índices de primer orden son cero. Sin embargo, cada índice total vale uno, porque toda la variación pertenece a la interacción. Ninguna variable puede eliminarse sin modificar esa estructura.
La medida adecuada depende de la decisión. Si queremos saber cuánto reduciríamos en promedio la incertidumbre de la respuesta al conocer exactamente una entrada, la varianza de su media condicionada mide esa reducción según la ley de varianza total. Si queremos identificar entradas prescindibles en una representación aproximada, necesitamos considerar también sus interacciones y el criterio de error adoptado.
Conocer una variable y fijarla arbitrariamente son operaciones diferentes. Al conocerla, condicionamos sobre su valor real y todavía podemos obtener resultados distintos entre posibles valores. Al fijarla en una constante de conveniencia, reemplazamos el modelo por otro. El error introducido depende del valor escogido y no queda descrito por una simple lectura del índice de primer orden.
Las prioridades de medición dependen además del costo y de cuánto puede reducirse realmente la incertidumbre. Una entrada puede explicar mucha varianza y ser muy difícil de medir. Otra puede tener una contribución menor, pero admitir una medición barata y precisa. Ordenar índices es un punto de partida para decidir dónde aprender, pero no resuelve por completo la asignación de recursos.
La respuesta elegida puede cambiar la prioridad. Una entrada que apenas afecta la media podría controlar la cola de una distribución. Si la decisión depende de superar un umbral, podemos analizar el indicador correspondiente, su probabilidad condicional o una medida orientada a cuantiles. Un análisis de la varianza de la respuesta original no resume todas esas preguntas.
Finalmente, cuando hay dependencia, conocer una entrada puede informar indirectamente sobre otras. La interpretación basada en una partición ortogonal independiente deja entonces de ser suficiente. Antes de usar índices para recomendar mediciones o eliminar parámetros, debemos verificar qué distribución conjunta sostiene el cálculo y qué operación concreta representa la decisión propuesta.
238.6. Dependencias que cambian el resultado
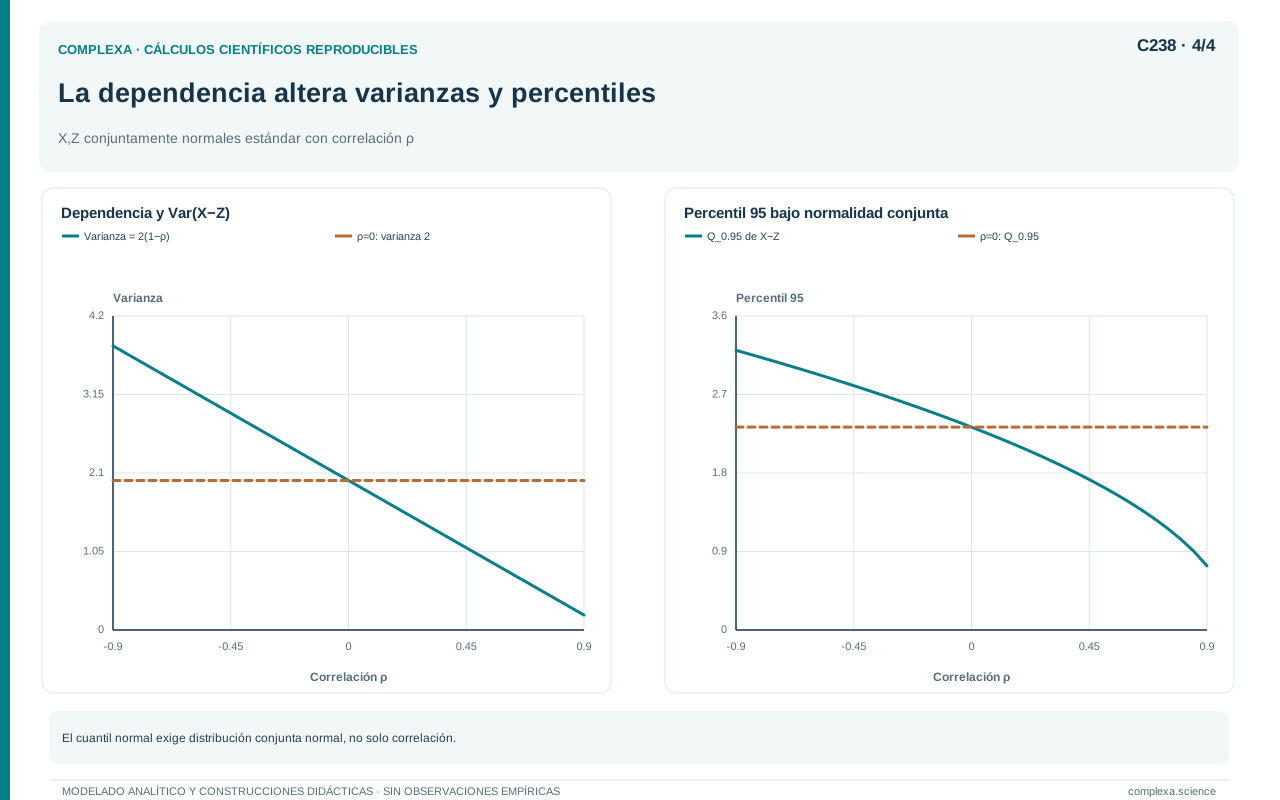
Las distribuciones marginales no determinan la incertidumbre de una función de varias entradas; también hacen falta sus dependencias. Si dos cantidades fluctúan juntas, su diferencia puede ser estable aunque cada una varíe mucho. Si fluctúan en sentidos opuestos, la misma diferencia puede amplificar la variación. Suponer independencia equivale a elegir una relación conjunta concreta.
Consideremos X y Z normales estándar con correlación rho y definamos Y como X menos Z. Ambas marginales tienen varianza uno, pero la varianza de la diferencia es dos multiplicado por uno menos rho. Con correlación cero coma nueve vale cero coma dos; con independencia vale dos. Ignorar la dependencia positiva multiplica por diez la varianza en este caso.
Con correlación menos cero coma nueve, la varianza es tres coma ocho. Las marginales son idénticas en los tres escenarios, de modo que la diferencia de resultados procede solo de la estructura conjunta. Un análisis que variara ambas entradas por separado sin considerar esa estructura podría describir combinaciones muy infrecuentes o imposibles bajo el problema original.
Las esperanzas condicionales y la ley de varianza total siguen siendo válidas con dependencia, pero los cocientes no heredan automáticamente la interpretación de componentes ortogonales independientes. En el ejemplo normal, la media de Y condicionada a X es uno menos rho multiplicado por X. Su varianza es el cuadrado de uno menos rho.
Al dividir por la varianza total, el cociente de primer orden es uno menos rho dividido por dos, tanto para X como para Z. Con correlación cero coma nueve, ambos valen cero coma cero cinco. El cociente basado en la varianza condicional residual vale cero coma noventa y cinco para cada variable. No debemos interpretar esa diferencia como una interacción multiplicativa, porque la función es aditiva y es la dependencia la que explica el comportamiento.
El ejemplo muestra por qué necesitamos métodos e interpretaciones adecuados para entradas dependientes. Algunas medidas describen información compartida, otras distribuyen contribuciones mediante convenciones explícitas y otras estudian intervenciones que rompen una dependencia. Al responder preguntas distintas, pueden producir rankings diferentes sin que ninguno sea necesariamente un error aritmético. La definición debe preceder al cálculo.
Si la dependencia se estima a partir de datos escasos, también es incierta. Podemos comparar estructuras conjuntas plausibles y observar qué conclusiones permanecen. Mantener marginales fijas mientras variamos correlaciones o mecanismos de asociación permite localizar esa fuente de fragilidad. El análisis debe respetar las restricciones que hacen válida una distribución conjunta, de modo que las correlaciones combinadas sean compatibles entre sí.
238.7. Separar parámetros y azar interno
Un simulador estocástico puede escribirse como una función de parámetros theta y de una fuente aleatoria interna. Para cada theta hay una distribución de resultados. Si además theta es incierto, la distribución predictiva mezcla esas distribuciones condicionadas. La ley de varianza total separa la variación entre sus medias de la variación interna promedio.
Resolvamos un ejemplo binario. La probabilidad P de éxito vale cero coma uno o cero coma nueve con igual peso. Condicionado a P, generamos un resultado Y de Bernoulli. La media predictiva es una mitad y la varianza total es un cuarto.
La varianza de P es cero coma dieciséis, porque sus dos valores se apartan cuatro décimas de la media. La varianza condicional de Y es P por uno menos P, igual a cero coma cero nueve en ambos casos. Su suma es cero coma veinticinco. La incertidumbre sobre P explica la variación entre probabilidades condicionadas; el sorteo binario produce la variación restante.
Si para cada P generamos R resultados internos y promediamos, la varianza de esa media, al considerar también el sorteo externo de P, es cero coma dieciséis más cero coma cero nueve dividido por R. Aumentar réplicas internas reduce el segundo término, pero no elimina la diferencia entre los dos valores posibles de P.
Con M valores de P independientes y R réplicas internas para cada uno, el promedio general tiene varianza igual a esa expresión dividida por M. Los resultados internos que comparten P no son marginalmente independientes; tratarlos como M por R observaciones independientes de Bernoulli conduciría a un error estándar inadecuado.
Si queremos estimar la variabilidad de la media condicionada, debemos descontar o modelar el ruido de las réplicas internas. Si queremos una distribución predictiva de nuevos resultados, necesitamos conservar ambos componentes. El mismo conjunto de ejecuciones puede servir para preguntas diferentes, pero sus resúmenes deben reflejar cuál se está respondiendo.
La distinción también orienta el presupuesto. Cuando predomina la variación entre configuraciones, añadir puntos externos puede ser más útil que repetir muchas veces los mismos. Cuando cada media condicionada es muy ruidosa, necesitamos réplicas internas suficientes. Los costos por configuración y por réplica influyen en la asignación; no hay una proporción universal adecuada para cualquier simulador.
238.8. Colas, umbrales y medidas que la varianza no resume
La varianza es una medida útil cuando existe y responde a la pregunta. Sin embargo, una decisión puede depender de una probabilidad de excedencia, de un cuantil o de una duración extrema. Dos distribuciones con medias y varianzas similares pueden asignar probabilidades distintas a un evento relevante. La varianza sola puede omitir esa diferencia.
Supongamos que una salida mide el trabajo pendiente y que el interés es no superar cierto umbral. Podemos transformar la respuesta en un indicador y estudiar su esperanza, que es la probabilidad del evento. La sensibilidad de esa probabilidad puede diferir de la de la cola media. Un parámetro que redistribuye masa cerca del umbral puede ser decisivo sin cambiar mucho el promedio.
Los umbrales también generan respuestas no suaves. Una pequeña perturbación de entrada puede llevar una trayectoria al otro lado del umbral, mientras muchas perturbaciones distintas dejan el indicador igual. Las derivadas locales ordinarias pueden ser poco informativas o inexistentes. Diseños globales y métodos específicos para probabilidades raras pueden ser más adecuados que diferencias finitas en una sola configuración.
Si una distribución tiene varianza infinita, los índices definidos como fracciones de varianza no están disponibles en su forma usual. Calcular una varianza muestral finita no resuelve el problema, porque toda muestra finita puede producir una cifra aunque el momento poblacional no exista. Debemos verificar las propiedades del modelo y elegir resúmenes que tengan sentido para la distribución planteada.
Incluso con varianza finita, las colas pueden exigir muchas observaciones para estimar índices o cuantiles con precisión. Un ranking que cambia con el tamaño de muestra puede indicar un error de Monte Carlo importante. Conviene mostrar la incertidumbre de las medidas y su estabilidad respecto del presupuesto; pequeñas diferencias numéricas no justifican una jerarquía rígida.
Las transformaciones de salida modifican el análisis. Aplicar un logaritmo reduce la influencia de valores grandes y cambia el reparto de la varianza entre entradas. Puede ser apropiado cuando interesan cambios proporcionales, pero debe explicarse. No corresponde elegir una transformación solo porque produce un ranking más cómodo o un gráfico con menos extremos.
Una evaluación completa puede presentar varias respuestas, cada una pertinente para una decisión concreta. La cola media informa sobre carga habitual; una probabilidad de excedencia, sobre el incumplimiento de un límite; un cuantil describe un punto de la distribución. Comparar sus sensibilidades permite reconocer compromisos y evita atribuir a una sola medida la representación de todas las propiedades del sistema.
238.9. Un protocolo para propagar y atribuir incertidumbre
El trabajo comienza con un inventario razonado de entradas inciertas. Para cada una necesitamos unidades, dominio, distribución o conjunto de alternativas, fuente de información y dependencias. Cuando faltan datos, conviene distinguir una distribución respaldada de una elección exploratoria. Ambas pueden usarse, pero sostienen afirmaciones diferentes sobre probabilidades y robustez.
Después definimos la respuesta y el horizonte. En el sistema de pedidos, la incertidumbre sobre la probabilidad de llegada puede propagarse hacia la cola media o hacia el riesgo de excedencia durante treinta días. Si cambiamos el horizonte, cambia la respuesta. Si desconocemos la regla de dependencia temporal de las llegadas, variar solo su probabilidad marginal deja sin explorar una incertidumbre estructural importante.
La tercera decisión es separar fuentes de variación en el diseño. Podemos generar configuraciones externas de parámetros y, dentro de cada una, varias trayectorias. Debemos conservar identificadores que permitan distinguir réplicas internas de configuraciones distintas. Para comparar alternativas bajo incertidumbre común, el emparejamiento puede reducir el error de los contrastes sin eliminar ninguna fuente pertinente de variación predictiva.
La propagación produce distribuciones y resúmenes cuya precisión debe comprobarse. Podemos aumentar el número de configuraciones o hacer ejecuciones independientes del diseño completo. Los diagnósticos deben orientarse a las cantidades que se usan, porque la estabilidad de las medias no demuestra la de un cuantil extremo. Si el método emplea un emulador, su error añade otra capa que debe evaluarse.
El análisis de sensibilidad requiere elegir medidas compatibles con el problema. Con entradas independientes y segundos momentos finitos, los índices de varianza dan una descomposición interpretable. Con dependencias, necesitamos explicitar cómo tratamos la información compartida. Con umbrales o colas, podemos preferir medidas orientadas a eventos. La elección debe responder al uso previsto del resultado.
Los índices estimados también tienen error. Una estimación levemente negativa de una cantidad teóricamente no negativa puede reflejar ruido del estimador. Recortarla silenciosamente a cero oculta esa información. Es preferible explicar el estimador, sus límites y la precisión disponible, así como aumentar el cálculo cuando la diferencia afecte a una conclusión importante.
Si usamos remuestreo para describir esa precisión, debemos respetar los bloques que el diseño mantiene unidos. Remuestrear por separado columnas que fueron emparejadas puede destruir las identidades usadas para estimar un índice. Lo mismo ocurre al separar réplicas internas de su configuración externa. El procedimiento de incertidumbre debe reproducir la estructura del experimento. Conservar identificadores y reglas de generación facilita esa comprobación y permite reconstruir qué unidades son realmente independientes.
Por último, repetimos el análisis bajo alternativas plausibles de distribuciones y reglas. Si el orden de importancia cambia radicalmente, la conclusión adecuada puede ser que la prioridad depende de un supuesto todavía incierto. Esa dependencia es un resultado científico útil, porque identifica qué conocimiento falta para convertir el análisis en una recomendación estable.
238.10. Robustez respecto de qué incertidumbre
Una conclusión es robusta respecto de un conjunto declarado de perturbaciones cuando se mantiene dentro de ese conjunto según un criterio definido. Variar algunos parámetros no autoriza a anunciar una robustez general. Debemos indicar qué cambió, cuánto cambió, qué respuesta se examinó y qué alternativas quedaron fuera. La afirmación no debe ir más allá de las perturbaciones estudiadas ni de la precisión alcanzada.
La propagación describe consecuencias de una distribución conjunta; la sensibilidad relaciona esas consecuencias con partes del planteamiento. Ambas tareas dependen de cómo representamos la incertidumbre. La simulación puede calcular con precisión las implicaciones de una distribución poco justificada. Por eso la calidad de las entradas y de sus dependencias merece tanta atención como el algoritmo que produce los índices.
Los ejemplos mostraron diferencias que alteran interpretaciones. Transformar la media no dio la media de la variable transformada. Una aproximación lineal produjo una varianza cercana a la exacta, pero distinta. Una interacción concentró variación invisible para los índices de primer orden. Una correlación positiva redujo diez veces la varianza de una diferencia frente al supuesto de independencia.
También distinguimos incertidumbre predictiva y precisión computacional. Repetir sorteos internos ayuda a estimar una media condicionada, pero no elimina la incertidumbre paramétrica ni la variabilidad de futuros resultados. La distribución de una salida y el error estándar de un estimador son objetos diferentes. Presentarlos juntos, con nombres y unidades claros, facilita decisiones sin confundir niveles de incertidumbre.
Una buena práctica es vincular cada resultado de sensibilidad con una acción posible, como medir mejor una entrada, conservar una interacción, ampliar un dominio, revisar una dependencia o evaluar otro mecanismo. Si no sabemos qué pregunta responde un ranking, su precisión numérica sirve de poco.
El siguiente capítulo aborda modelos sustitutos para simuladores costosos. Cuando cada evaluación exige mucho cálculo, la propagación y la sensibilidad pueden depender de una aproximación aprendida. Ese ahorro obliga a distinguir la incertidumbre del sistema del error del sustituto y a verificar que la aproximación conserva las propiedades que queremos estudiar.
Referencias
- Saltelli, A., y Annoni, P. (2010). How to avoid a perfunctory sensitivity analysis. Environmental Modelling & Software, 25(12), 1508–1517. DOI: 10.1016/j.envsoft.2010.04.012.
- Sobol’, I. M. (2001). Global sensitivity indices for nonlinear mathematical models and their Monte Carlo estimates. Mathematics and Computers in Simulation, 55(1–3), 271–280. DOI: 10.1016/S0378-4754(00)00270-6.
Nota de los cálculos. Los ejemplos de transformación cuadrática, descomposición polinómica, dependencia normal y simulación binaria anidada son derivaciones propias. Las probabilidades y distribuciones utilizadas son supuestos didácticos, no estimaciones empíricas.