Módulo 24. Experimentos computacionales, muestreo y documentación
237.1. Elegir qué combinaciones merecen una simulación
Cuando un modelo depende de varias entradas, estudiar una sola configuración da una imagen parcial. Podemos obtener una trayectoria convincente y desconocer si cambia al modificar ligeramente una tasa, una condición inicial o una regla. El diseño experimental decide qué combinaciones evaluar para responder una pregunta con un presupuesto limitado, de modo que las comparaciones resultantes puedan interpretarse.
Una entrada puede ser una decisión, una propiedad incierta o una opción de implementación. Aumentar capacidad modifica una intervención dentro del modelo; variar una tasa de llegada explora entornos; cambiar el orden de actualización examina una decisión algorítmica. Todas pueden incluirse como factores, pero la interpretación de su efecto debe conservar esa diferencia.
Los niveles son los valores concretos asignados a cada factor. Elegir niveles próximos a una configuración de referencia estudia comportamiento local. Elegir un intervalo amplio permite buscar cambios cualitativos, pero puede incluir regiones incompatibles con el fenómeno. Un diseño matemáticamente equilibrado no garantiza que sus configuraciones tengan sentido. El dominio debe justificarse antes de interpretar sus promedios.
También necesitamos definir la respuesta. Un mismo modelo puede producir cola media, máximo acumulado, probabilidad de excedencia y tiempo de recuperación. Los factores importantes para una respuesta pueden ser secundarios para otra. Por eso la clasificación de las entradas importantes depende de la cantidad estudiada, del dominio y del modo de resumir los resultados.
Cambiar un factor cada vez alrededor de un único punto es intuitivo y barato. Sin embargo, puede ocultar interacciones, es decir, situaciones en que el efecto de una entrada depende del valor de otra. Si un tratamiento solo funciona cuando existe un recurso complementario, variar cada componente desde una configuración donde falta el otro puede llevar a concluir, erróneamente, que ambos son irrelevantes.
Un diseño factorial cruza niveles de varios factores y permite observar esas dependencias. Un barrido global explora regiones más amplias del espacio de entradas mediante cuadrículas, muestras u otras construcciones. Ninguna de las dos estrategias autoriza a afirmar exhaustividad; si las dimensiones son numerosas, un número grande de ejecuciones puede dejar enormes zonas sin examinar.
Este capítulo desarrolla diseños pequeños que podemos resolver exactamente y después analiza cómo ampliarlos. La meta es que cada ejecución tenga una función dentro del experimento, ya sea estimar un contraste, detectar una interacción, explorar curvatura o comprobar una región incierta. Esa función permite decidir si conviene añadir réplicas en puntos existentes o visitar combinaciones nuevas.
237.2. Un factorial de dos factores y dos niveles
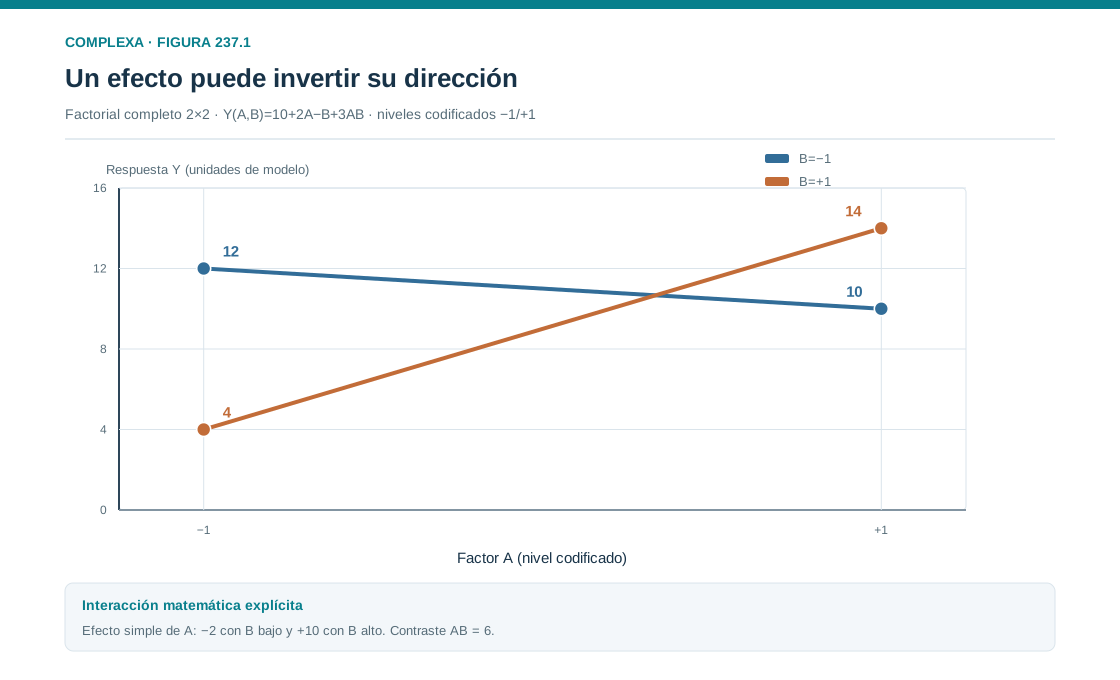
Consideremos dos factores cuantitativos, A y B, codificados con valores menos uno y más uno. Un factorial completo de dos niveles evalúa las cuatro combinaciones. La codificación permite describir contrastes sin confundirlos con unidades físicas; posteriormente debemos explicar qué valor real corresponde a cada nivel.
Usaremos una respuesta determinista construida para este ejemplo, con un nivel basal, dos términos individuales y un producto entre factores. El producto introduce una interacción, ya que hace que el cambio producido por A dependa de B. Como la expresión es artificial, sabemos de antemano lo que el diseño debe recuperar. La respuesta es
| A | B | Y |
|---|---|---|
| −1 | −1 | 12 |
| +1 | −1 | 10 |
| −1 | +1 | 4 |
| +1 | +1 | 14 |
El efecto principal de A se define aquí como la media de las respuestas en su nivel alto menos la media en su nivel bajo, promediando ambos niveles de B con igual peso. Las medias son doce y ocho, por lo que el efecto es cuatro. Para B, las medias son nueve y once; su efecto principal es menos dos.
Estos efectos son el doble de los coeficientes individuales de la expresión, porque pasar de menos uno a más uno es un cambio de dos unidades codificadas. Confundir coeficiente y efecto produce errores frecuentes al comparar tablas y modelos de regresión. La definición del contraste debe acompañar cualquier cifra presentada como efecto factorial.
La interacción puede calcularse comparando respuestas según el signo del producto AB. Cuando el producto es positivo, las respuestas son doce y catorce, cuya media es trece. Cuando es negativo, son diez y cuatro, cuya media es siete. El contraste es seis, el doble del coeficiente del producto en la expresión.
Otra forma de ver la interacción es comparar efectos simples. Con B bajo, aumentar A lleva la respuesta de doce a diez, una disminución de dos; con B alto, la lleva de cuatro a catorce, una subida de diez. La diferencia entre ambos efectos simples es doce. Esa diferencia de diferencias es dos veces el efecto factorial de interacción bajo la convención que acabamos de definir.
Las tres cantidades responden preguntas relacionadas pero distintas; el efecto principal promedia, el efecto simple condiciona y la diferencia de diferencias compara condiciones. Declarar solamente que A tiene un efecto positivo de cuatro escondería que su efecto cambia de signo. La tabla completa permite ver qué decisiones dependen del contexto de otro factor.
237.3. Interacciones, escalas y condiciones de referencia
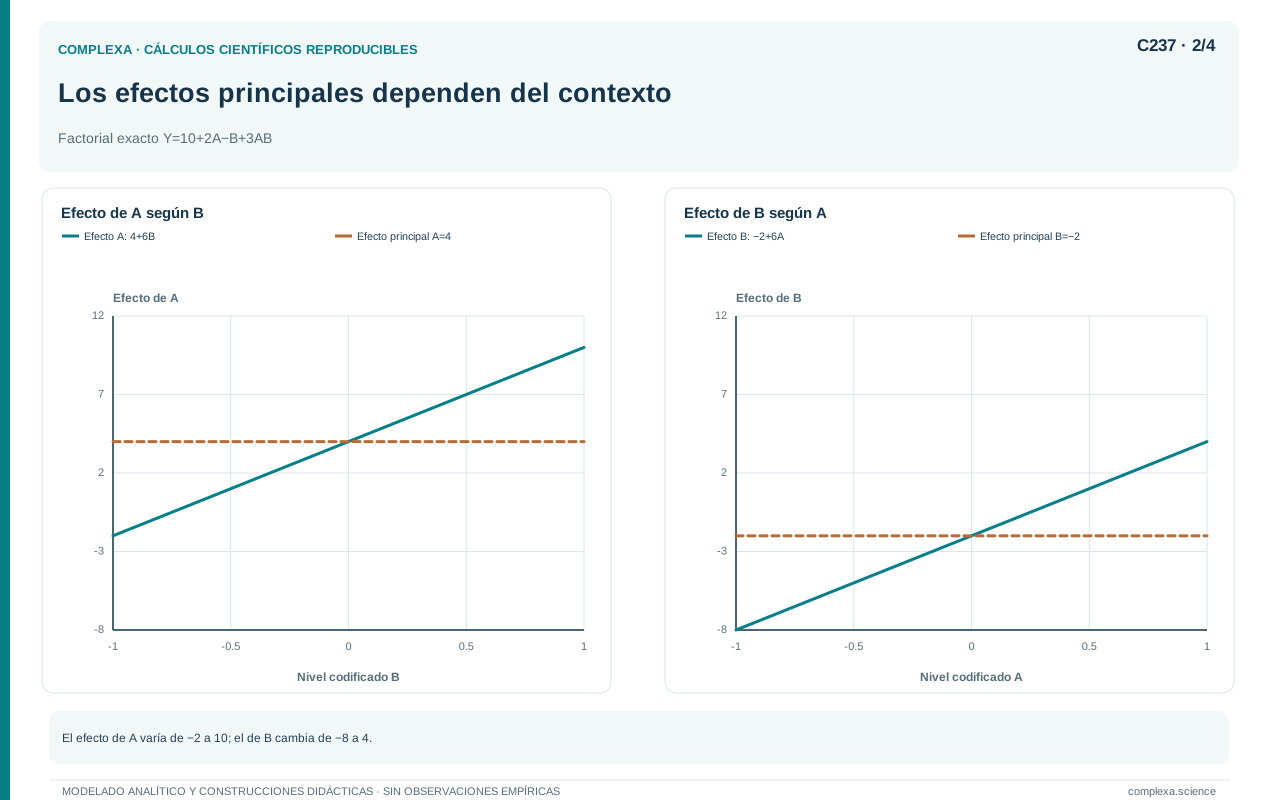
Una interacción solo puede interpretarse si se especifica la escala de respuesta. Dos factores pueden combinarse multiplicativamente en la escala original y volverse aditivos después de aplicar un logaritmo. Si la pregunta trata de diferencias absolutas, una transformación puede ocultar una dependencia relevante; si trata de cambios proporcionales, puede hacerla más interpretable.
Por ejemplo, supongamos que una respuesta positiva es el producto de dos factores positivos. En la escala original, el incremento que produce uno de ellos aumenta cuando el otro es mayor. En escala logarítmica, la respuesta transformada es la suma de los logaritmos y no contiene un término de interacción de esa forma. Ambas descripciones son correctas, cada una en su escala.
El dominio también influye. En una región pequeña, un sistema no lineal puede aproximarse mediante una relación aditiva; al ampliar el rango aparecen saturación, umbrales o cambios de signo. Concluir que no hay interacción a partir de dos niveles concretos solo significa que el contraste definido por esos niveles fue pequeño o nulo; en otras regiones del espacio la interacción puede existir.
Cambiar un factor cada vez desde el origen es especialmente engañoso para la función que multiplica dos entradas entre cero y uno. En el origen, variar cualquiera mientras la otra permanece en cero no cambia la respuesta. Sin embargo, en la esquina donde ambas valen uno la respuesta es uno. El procedimiento local recorrió solamente bordes donde el producto desaparece.
La solución es repetir los cambios individuales desde diferentes contextos y diseñar comparaciones capaces de revelar dependencia. Una trayectoria que modifica una coordenada cada vez puede formar parte de un análisis global si sus puntos de partida cubren el dominio. Lo decisivo es qué relaciones permite identificar el conjunto de trayectorias.
Las interacciones también pueden reflejar restricciones o definiciones. Si una respuesta se calcula dividiendo por una capacidad que figura entre los factores, parte de la dependencia puede proceder de esa fórmula. Si ciertos parámetros solo son admisibles conjuntamente, los contrastes no son cambios libres. Interpretar mecanismos requiere revisar cómo se construyeron entradas y salidas, además de calcular productos en una regresión.
En un simulador intervenimos directamente sobre entradas, por lo que podemos describir efectos causales dentro de sus reglas. Trasladarlos al sistema empírico exige que las intervenciones y mecanismos representados sean pertinentes. Una interacción recuperada exactamente en un programa establece una propiedad del programa; su valor explicativo externo depende de la correspondencia entre ese programa y el fenómeno estudiado.
237.4. Más factores y el costo de cruzarlos
Con k factores de dos niveles, un factorial completo contiene dos elevado a k configuraciones. Con diez factores son mil veinticuatro; con veinte, un millón cuarenta y ocho mil quinientas setenta y seis. Si cada configuración exige cien réplicas o varias horas de cálculo, el costo puede ser prohibitivo. Ese crecimiento procede del cruce de combinaciones; ninguna mejora del software lo elimina.
Agregar niveles aumenta todavía más el número. Tres niveles en diez factores requieren cincuenta y nueve mil cuarenta y nueve configuraciones. A cambio, permiten examinar curvatura que dos niveles no identifican. La decisión depende de cuántas ejecuciones podemos pagar y, sobre todo, de qué propiedades necesitamos distinguir para responder la pregunta.
En un simulador determinista, repetir exactamente una entrada produce el mismo resultado si la implementación es reproducible. Esas repeticiones no informan sobre la forma de la función, aunque pueden servir para comprobar la estabilidad del entorno o detectar errores numéricos. En un simulador estocástico, las réplicas sí ayudan a estimar la respuesta media y su variabilidad condicional.
La asignación entre puntos y réplicas debe considerar esa diferencia. Si el ruido interno es enorme, una sola ejecución por configuración puede confundir variación aleatoria con cambios de respuesta. Si el ruido es mínimo y la función tiene umbrales estrechos, muchas réplicas en pocos puntos pueden desperdiciar capacidad de exploración. Un piloto permite estimar ambos tipos de dificultad.
Los factores categóricos no siempre admiten la geometría de una escala numérica. La comparación entre actualización sincrónica y asincrónica puede codificarse mediante indicadores, pero no hay necesariamente un valor intermedio interpretable. Promediar niveles o buscar una derivada exige que esas operaciones tengan sentido. Los diseños pueden combinar factores cuantitativos y cualitativos siempre que respeten sus diferencias.
Las restricciones del dominio pueden excluir algunas combinaciones de un factorial completo. Por ejemplo, dos proporciones pueden tener que sumar como máximo uno. Simular todos los extremos de un cubo incluiría configuraciones imposibles. Debemos diseñar dentro de la región admisible y reconocer que ciertos contrastes ortogonales del diseño completo dejarán de estar disponibles.
El costo también depende de la salida almacenada. Guardar trayectorias completas para millones de configuraciones puede ser más caro que ejecutar el modelo. Definir resúmenes suficientes para las preguntas previstas y conservar una selección trazable de trayectorias permite equilibrar análisis y almacenamiento. Si después queremos una respuesta que no fue registrada, quizá tengamos que repetir el experimento.
237.5. Fracciones factoriales y efectos confundidos
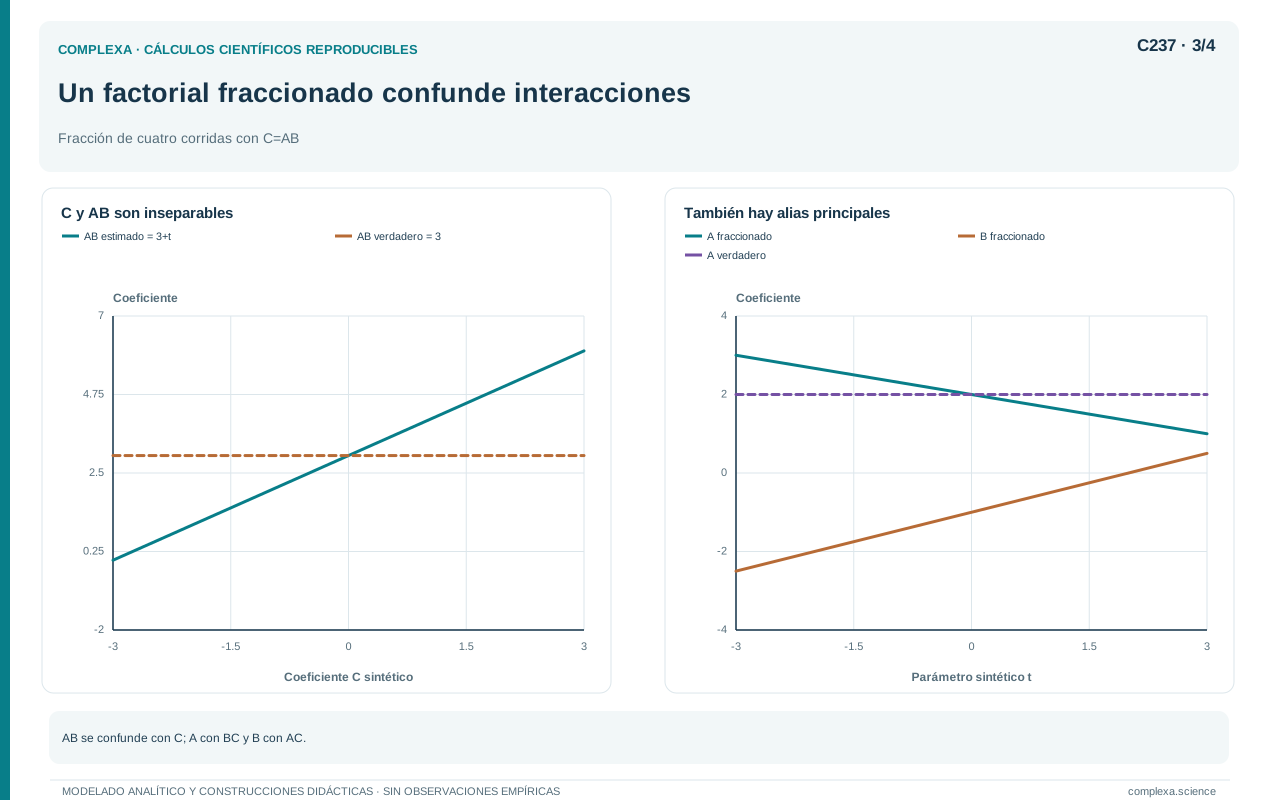
Un diseño factorial fraccionado evalúa una parte cuidadosamente elegida de las combinaciones. El ahorro se obtiene aceptando que algunos efectos no podrán distinguirse entre sí con esos datos. Esa confusión debe conocerse antes de interpretar resultados. Una fracción útil permite estimar lo prioritario bajo supuestos explícitos sobre los efectos que pueden despreciarse.
Consideremos tres factores A, B y C, cada uno con niveles menos uno y más uno. El factorial completo tendría ocho combinaciones. Elegimos solamente las cuatro que satisfacen C igual a AB. En esos puntos el producto ABC vale siempre uno, de modo que A coincide con BC, B con AC y C con AB.
La coincidencia significa que las columnas correspondientes son idénticas dentro del diseño. Si ajustamos una respuesta con términos A y BC, no podemos separar sus coeficientes, porque cualquier redistribución que conserve su suma produce las mismas predicciones observadas. Es un problema estructural de identificación del diseño, que ningún algoritmo de regresión más sofisticado resuelve.
Supongamos que la respuesta verdadera es dos veces A más cinco veces BC. En la fracción elegida, BC es igual a A, de modo que observamos siete veces A. Si atribuimos todo a un efecto individual de A, confundimos su contribución con una interacción que el diseño no puede separar. Aumentar las réplicas en esos mismos cuatro puntos estima siete con mayor precisión, pero no recupera dos y cinco por separado.
Podemos complementar el experimento con la fracción opuesta, donde C es igual a menos AB. Allí BC es igual a menos A y la respuesta se convierte en menos tres veces A. La combinación de ambos resultados permite recuperar el coeficiente individual, igual a dos, como el promedio de siete y menos tres; el coeficiente de interacción, igual a cinco, es la mitad de su diferencia.
Esta ampliación ilustra una estrategia secuencial, que empieza con un diseño económico y añade puntos que resuelvan una ambigüedad relevante. El primer resultado es provisional; se interpreta según su estructura de confusión e indica qué información falta. La selección de la ampliación debe quedar documentada para reconstruir el proceso.
La resolución de un diseño resume, en parte, qué órdenes de efectos quedan confundidos. Sin desarrollar aquí toda su clasificación, la pregunta práctica es si un efecto principal puede confundirse con una interacción que consideramos plausible. Si es así, una conclusión sustantiva requiere datos adicionales o una justificación fuerte del supuesto que descarta esa interacción.
237.6. Curvatura y puntos interiores
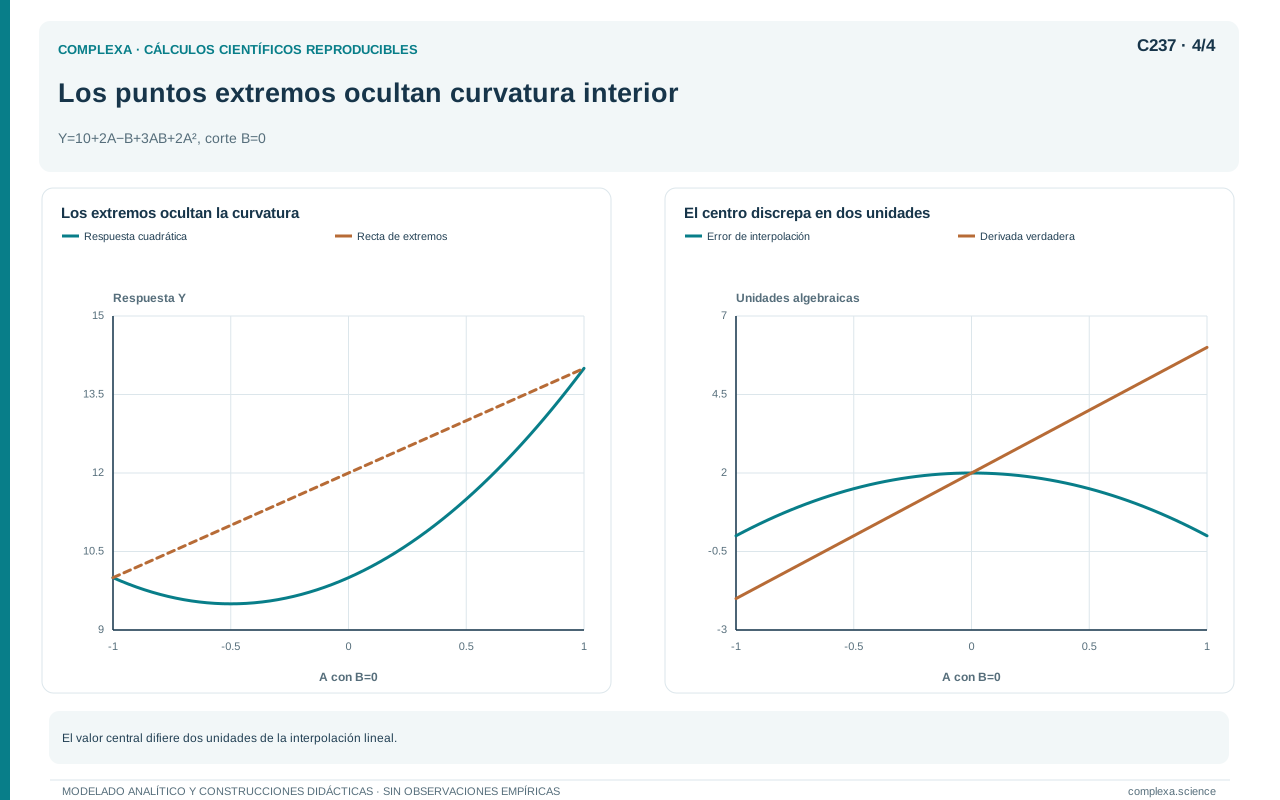
Los dos niveles extremos de un factor permiten estimar un contraste, pero no describen necesariamente lo que ocurre entre ellos. Una respuesta puede ser alta en ambos extremos y baja en el centro, o presentar un umbral estrecho que ninguna esquina revela. Añadir puntos interiores permite contrastar la suficiencia de una aproximación lineal dentro del dominio.
Consideremos la función A al cuadrado más B al cuadrado en el cuadrado comprendido entre menos uno y más uno. En las cuatro esquinas vale dos. Un modelo ajustado solamente a esos puntos podría describir una respuesta constante de dos y concluir que los efectos factoriales principales y la interacción son nulos. En el centro, sin embargo, la respuesta vale cero.
La discrepancia del centro revela curvatura, pero ese punto aislado no indica cómo se reparte entre los factores. Las funciones dos veces A al cuadrado y dos veces B al cuadrado también valen dos en las esquinas y cero en el centro. Para distinguirlas necesitamos puntos donde las coordenadas cambien de manera separada, como los centros de los lados.
El ejemplo ilustra que detectar la insuficiencia de un modelo de respuesta no equivale a identificar el modelo correcto. Los puntos adicionales deben diseñarse para separar explicaciones alternativas. Añadir muchas réplicas en el centro reduce la incertidumbre estocástica sobre su media, pero no da los contrastes geométricos necesarios para distinguir esas tres superficies deterministas.
Una aproximación cuadrática puede incluir términos individuales, cuadrados e interacciones. Su utilidad suele ser local; describe curvatura suave cerca de la región explorada y no garantiza representar discontinuidades, múltiples regímenes ni una frontera compleja. Antes de usarla para optimizar una decisión, conviene comprobar sus predicciones en puntos nuevos que no participaron en el ajuste.
El centro también depende de la parametrización. El promedio aritmético entre dos tasas no coincide con el punto medio en escala logarítmica. Si las tasas varían por órdenes de magnitud, un diseño uniforme en la escala original concentra relativamente pocos puntos en la región pequeña. La escala forma parte del experimento y debe elegirse según la pregunta, al margen de las costumbres del programa utilizado.
Las superficies de respuesta pueden guiar una exploración secuencial hacia regiones prometedoras. Esa búsqueda cambia la distribución de puntos observados y no debe confundirse con una muestra representativa de todo el dominio. Un conjunto orientado a optimizar puede ser excelente para localizar candidatos y pobre para estimar la proporción del espacio que satisface una condición. La finalidad determina cómo interpretar la cobertura.
237.7. Hipercubos latinos y cobertura marginal
Una cuadrícula completa trata de cruzar todos los niveles; otros diseños buscan distribuir un número fijo de puntos de manera eficiente. El muestreo por hipercubo latino divide cada distribución marginal en intervalos de igual probabilidad, toma un valor por intervalo y combina las coordenadas mediante permutaciones. McKay, Beckman y Conover estudiaron esta construcción como alternativa al muestreo aleatorio simple [1].
La propiedad más visible del hipercubo latino es que cada variable queda representada en todos sus intervalos marginales. Esto no significa que todas las combinaciones entre intervalos estén presentes. Con cuatro puntos en dos dimensiones podemos cubrir cuatro intervalos por eje, pero solo visitar cuatro de las dieciséis celdas posibles. En muchas dimensiones, la diferencia entre ambas coberturas crece enormemente.
Para ilustrarlo, usemos los centros de cuatro intervalos iguales y emparejémoslos como indica la tabla. Estos puntos son una construcción didáctica fija; al no ser una realización aleatoria, no permiten afirmar insesgamiento. Permiten ver que cada coordenada aparece una vez en cada intervalo, aunque gran parte del cuadrado quede sin visitar.
| Punto | Primera coordenada | Segunda coordenada |
|---|---|---|
| 1 | 0,125 | 0,625 |
| 2 | 0,375 | 0,125 |
| 3 | 0,625 | 0,875 |
| 4 | 0,875 | 0,375 |
En una versión aleatorizada, los valores dentro de los intervalos y las permutaciones se generan siguiendo el diseño especificado. No debemos calcular errores estándar como si todas las filas fueran observaciones independientes de un muestreo simple, porque la cobertura impuesta introduce dependencia entre ellas. Cuando el presupuesto lo permite, repetir diseños completos independientes es una forma de evaluar la variabilidad entre estimaciones.
La construcción básica con emparejamientos independientes corresponde a entradas independientes. Si el problema exige dependencias, combinaciones imposibles o una distribución conjunta particular, necesitamos representarlas explícitamente. Mantener las marginales correctas no garantiza conservar la respuesta de una función sensible a interacciones, porque dos distribuciones conjuntas con idénticas marginales pueden generar salidas muy distintas.
También debemos distinguir exploración geométrica y propagación probabilística. Dividir un rango en intervalos iguales cubre una escala; dividir una distribución en intervalos de igual probabilidad reproduce una ley. Si la densidad es desigual, ambas decisiones producen puntos diferentes. Una media calculada sobre un diseño geométrico no estima automáticamente la esperanza bajo la distribución empírica que interesa.
El hipercubo latino reduce ciertos desequilibrios de cobertura marginal, pero no garantiza encontrar una región diminuta donde cambie abruptamente el resultado. Una vez detectada una frontera o una interacción relevante, puede ser necesario concentrar puntos alrededor de ella. La cobertura inicial orienta las preguntas; las comprobaciones posteriores deben responder a las limitaciones observadas.
237.8. Explorar efectos individuales desde muchos contextos
Cuando hay muchas entradas, puede ser útil identificar primero cuáles merecen un estudio más detallado. El método de Morris usa cambios de una coordenada cada vez distribuidos por diferentes puntos del dominio y resume los efectos elementales resultantes [2]. Así convierte una operación local en parte de una exploración global, sin evaluar un factorial completo.
Un efecto elemental compara la respuesta antes y después de incrementar una entrada en una cantidad definida, con las demás coordenadas fijas en ese paso. Dividir el cambio de respuesta por el incremento facilita comparar efectos cuando las entradas están codificadas de manera coherente. La distribución de estos efectos depende de los puntos visitados, del tamaño del paso y de los rangos escogidos.
Podemos comprenderlo con la función que multiplica x por y. El efecto elemental respecto de x es y, independientemente del incremento admisible. Si repetimos el cambio de x cuando y es pequeño, el efecto es pequeño; cuando y es grande, es grande. La variación entre contextos revela una dependencia que el análisis desde el origen habría ocultado.
Otro ejemplo separa cancelación e irrelevancia. Sea la respuesta x multiplicado por dos y menos uno, con y uniforme entre cero y uno. El efecto elemental respecto de x es dos y menos uno. Su media es cero, aunque su valor absoluto tiene media una mitad. La media con signo se anula porque los efectos positivos y negativos se compensan, aunque x sí influye en la respuesta.
La media absoluta es aquí un resumen complementario. El artículo original de Morris examina medias con signo y dispersiones de efectos elementales; conviene conservar esa distinción al atribuir cada forma de resumirlos.
La varianza de esos efectos es un tercio. En este ejemplo sabemos que la dispersión procede de una interacción con y. En un modelo desconocido, la variabilidad de los efectos puede reflejar interacciones, curvatura respecto de la propia entrada o ambas. El resumen señala qué requiere investigación; identificar el mecanismo responsable exige análisis adicionales.
Si el simulador es estocástico, un cambio de respuesta también contiene ruido interno. Podemos usar réplicas o emparejar fuentes aleatorias para estimar mejor el cambio medio. Sin esa precaución, una entrada puede parecer interactiva porque sus efectos elementales fluctúan por ruido de simulación. El diagnóstico debe distinguir variación entre contextos de variación entre ejecuciones del mismo contexto.
La selección de factores es provisional. Una entrada con efecto pequeño en el dominio inicial puede volverse decisiva al cambiar condiciones o al estudiar una respuesta distinta. El resultado debe indicar qué factores se priorizan y para qué finalidad. Descartar una entrada del siguiente experimento solo indica que no es prioritaria para esa finalidad.
237.9. Diseñar un barrido para el modelo de pedidos
Volvamos al sistema de pedidos y definamos un experimento nuevo, todavía como propuesta de diseño. Podemos cruzar capacidad diaria de diez o doce, probabilidad de llegada de cero coma cuatro o cero coma seis y tamaño de lote de doce o dieciséis. Son tres factores de dos niveles y, por tanto, ocho configuraciones. No atribuiremos a este diseño resultados que no se hayan ejecutado.
Con doscientas réplicas por configuración, el presupuesto contiene mil seiscientas trayectorias. Si queremos emparejar escenarios, podemos generar una uniforme por día y réplica y declarar llegada cuando sea menor que la probabilidad correspondiente. Así los días con llegada bajo probabilidad baja también la tienen bajo probabilidad alta. Este acoplamiento, definido por acontecimientos equivalentes, es más estricto que compartir una semilla.
El tamaño de lote transforma la llegada binaria en cantidad de pedidos. La capacidad determina el procesamiento y la cola se actualiza según las reglas ya documentadas. Mantener el mismo horizonte de treinta días y cola inicial vacía permite comparar respuestas bajo un contexto común. Cambiar también el horizonte sin declararlo añadiría otro factor y modificaría la interpretación.
Las demandas medias por día serían cuatro coma ocho, seis coma cuatro, siete coma dos y nueve coma seis, según la combinación de probabilidad y tamaño. Todas quedan por debajo de la capacidad menor. Sin embargo, esa comparación de medias no asegura ausencia de cola ni un máximo pequeño durante treinta días. El barrido estudia precisamente cómo la variabilidad y las combinaciones afectan respuestas que no dependen solo de la media de entrada.
Podemos predefinir cola media, máximo y probabilidad de superar un umbral. Cada respuesta requiere su propio análisis factorial y sus errores de Monte Carlo. Para probabilidades cercanas a cero o uno, doscientas réplicas pueden dar poca resolución. El presupuesto deberá revisarse si la precisión necesaria exige distinguir probabilidades mucho menores que una entre doscientas.
La duración podría añadirse después como factor para estudiar sensibilidad al horizonte. Es preferible interpretar esa ampliación como otra pregunta y conservar los resultados originales. Si una diferencia entre capacidades cambia al pasar de treinta a noventa días, necesitamos distinguir acumulación transitoria de comportamiento prolongado. Con una sola duración no podemos separar ambas cosas.
Antes de ejecutar, el diseño debe registrar configuraciones, réplicas, acoplamiento, respuestas y contrastes prioritarios. Después se revisan fallos, precisión y regiones que necesitan nuevas evaluaciones. Esta secuencia mantiene un vínculo verificable entre la pregunta inicial y las decisiones tomadas a partir de los resultados; sin ella, el barrido se reduciría a una colección de cifras sin criterio de interpretación.
237.10. Un mapa de respuestas con límites declarados
Un diseño experimental convierte un espacio de posibilidades en comparaciones interpretables. Los factoriales permiten separar contrastes e interacciones cuando el cruce de niveles lo admite. Las fracciones ahorran ejecuciones a cambio de confusiones conocidas. Los puntos interiores examinan curvatura. Los diseños de cobertura y los efectos elementales distribuyen exploración cuando el número de dimensiones impide cruzarlo todo.
La primera decisión sigue siendo qué necesitamos saber. Para estimar un efecto en condiciones específicas puede bastar un contraste emparejado; estudiar una interacción exige contextos distintos, optimizar una respuesta requiere explorar y comprobar candidatos y propagar incertidumbre necesita una distribución conjunta de entradas. Ningún conjunto de puntos resuelve estas tareas de manera automática. Por eso el archivo del diseño debe acompañar los resultados; sus filas indican qué comparaciones existen y cuáles solo parecen sugeridas por una gráfica.
Los ejemplos mostraron errores que una auditoría puede localizar sin ejecutar millones de simulaciones. Un efecto principal positivo ocultaba efectos simples de signos opuestos y una fracción confundía un factor con una interacción. Cuatro esquinas constantes escondían curvatura interior, mientras que una cobertura marginal completa dejaba sin visitar la mayoría de las combinaciones. Conocer solo el número de ejecuciones no permite juzgar la calidad de la información.
También conviene conservar resultados desfavorables y configuraciones donde el simulador falla. Excluirlos silenciosamente puede sugerir un dominio artificialmente estable. Debemos distinguir combinaciones inadmisibles por definición, fallos numéricos y respuestas extremas válidas. Cada categoría plantea una acción diferente y puede cambiar el alcance de las conclusiones del barrido.
El producto final de un experimento bien diseñado es un mapa acompañado de sus límites, que indican qué rangos cubre, qué efectos distingue, qué ruido contiene y qué regiones requieren nuevas observaciones. Ese mapa puede orientar simplificación, calibración, decisiones o nuevos modelos. Su utilidad aumenta cuando permite reconocer dónde una conclusión deja de estar respaldada.
El siguiente capítulo abordará sensibilidad y propagación de incertidumbre. Pasaremos de decidir dónde ejecutar el modelo a preguntar cómo distribuciones y perturbaciones de entrada se traducen en variación de salida. La conexión es directa. Cualquier medida de sensibilidad exige un dominio y un diseño adecuados; su interpretación depende de las incertidumbres incluidas en ese diseño.
Referencias
- McKay, M. D., Beckman, R. J., y Conover, W. J. (1979). A comparison of three methods for selecting values of input variables in the analysis of output from a computer code. Technometrics, 21(2), 239–245. DOI: 10.1080/00401706.1979.10489755. Se consultó también la reproducción del artículo publicada en 2000, con paginación distinta.
- Morris, M. D. (1991). Factorial sampling plans for preliminary computational experiments. Technometrics, 33(2), 161–174. DOI: 10.1080/00401706.1991.10484804.
Nota de los ejemplos. Las tablas factoriales, los ejemplos de confusión y curvatura y los cálculos de efectos elementales son propios. El barrido de pedidos de la sección 237.9 es un diseño propuesto, no un experimento presentado como ejecutado.