Módulo 24. Experimentos computacionales, muestreo y documentación
236.1. La precisión también se diseña
Una simulación puede consumir mucho tiempo calculando variación que no necesitamos. Cuando comparamos dos decisiones, por ejemplo, parte de la diferencia observada procede de haber enfrentado cada decisión a circunstancias distintas. Si una capacidad de servicio se prueba durante una secuencia tranquila y otra durante una secuencia congestionada, el contraste mezcla el efecto buscado con diferencias accidentales de demanda. Diseñar la relación entre las simulaciones permite separar mejor esas contribuciones.
Reducir varianza significa modificar un estimador o su esquema de generación para que fluctúe menos alrededor de la cantidad objetivo, sin alterar el modelo hasta obtener resultados más homogéneos. La distribución de interés debe conservarse o corregirse mediante una identidad válida. Podemos introducir dependencia entre realizaciones, usar esperanzas conocidas o integrar analíticamente una parte del problema, siempre que expliquemos por qué seguimos estimando la misma cantidad.
La comparación debe fijar también el presupuesto. Un procedimiento que produce estimaciones menos variables por réplica puede exigir muchas evaluaciones adicionales. Si cada réplica cuesta diez veces más y solo reduce la varianza a la mitad, quizá use peor el tiempo disponible. Para estimadores insesgados y réplicas independientes con costo aproximadamente constante, el producto entre varianza por réplica y costo por réplica es una medida útil de eficiencia.
La precisión pertinente depende del objetivo. Estimar una media absoluta, comparar dos medias y localizar un umbral requieren cantidades diferentes. Una técnica que funciona bien para la primera puede ser innecesaria o contraproducente para la segunda. El acoplamiento que reduce la variabilidad de una diferencia, por ejemplo, no modifica necesariamente la precisión de cada media por separado.
El experimento del capítulo 232 comparó capacidades de diez y doce pedidos usando las mismas llegadas dentro de cada réplica. Esa decisión buscaba que cada diferencia describiera qué cambia al modificar la capacidad bajo una historia de demanda común, de modo que las trayectorias de ambos escenarios no eran independientes dentro de una réplica. Las réplicas completas, que contenían ambos escenarios, sí se generaron independientemente unas de otras.
Este capítulo desarrolla esa idea y otras tres (variaciones antitéticas, variables de control y estratificación). Añadiremos la sustitución de sorteos por esperanzas condicionales. Los ejemplos se resuelven analíticamente para distinguir una reducción demostrable de una impresión obtenida al mirar pocas ejecuciones. El objetivo es aprender a usar la estructura conocida del problema; ninguna de estas técnicas debe aplicarse siempre.
Una reducción computacional de incertidumbre tampoco elimina incertidumbre sobre el mundo. Podemos precisar la diferencia entre dos escenarios cuyas reglas sean poco realistas. El beneficio consiste en medir mejor lo que el modelo implica; evaluar si esas implicaciones sirven para una decisión requiere examinar supuestos, datos y alcance. Esa distinción evita confundir una barra de error estrecha con evidencia empírica suficiente.
236.2. Números aleatorios comunes y diferencias emparejadas
Sean A y B los resultados de dos escenarios. Queremos estimar la diferencia entre sus esperanzas. Si generamos pares independientes entre réplicas, la media de las diferencias conserva esa esperanza aunque los dos componentes de cada par sean dependientes. Su varianza depende de la covarianza interna; una covarianza positiva reduce la dispersión de la diferencia.
Los números aleatorios comunes buscan producir esa covarianza positiva al someter los escenarios a perturbaciones comparables. El trabajo de Glasserman y Yao estudia condiciones que justifican la utilidad de esta estrategia, entre ellas propiedades de monotonía y continuidad en sistemas de eventos discretos [1]. La recomendación no es universal; la conveniencia de compartir aleatoriedad debe evaluarse según el contraste y la respuesta de cada sistema.
Un ejemplo elemental permite ver una ganancia extrema. Supongamos que A vale U y B vale U más una constante, donde U es uniforme entre cero y uno. Con el mismo U en ambos escenarios, cada diferencia es exactamente la constante y no tiene varianza. Si usamos dos uniformes independientes, la diferencia conserva la misma esperanza, pero tiene varianza un sexto. La dependencia elimina aquí toda la perturbación irrelevante para el contraste.
Ahora cambiemos B por uno menos U. Ambas medias siguen siendo una mitad. Si usamos el mismo U, la diferencia B menos A vale uno menos dos U y tiene varianza un tercio. Con uniformes independientes, la varianza sería un sexto. El acoplamiento común duplica el error cuadrático por par porque las respuestas se mueven en direcciones opuestas; compartir la fuente aleatoria no garantiza un buen emparejamiento.
En el sistema de pedidos, una misma secuencia de llegadas permite comparar la capacidad bajo condiciones externas idénticas. Para esa secuencia, aumentar la capacidad no incrementa la cola bajo las reglas especificadas. Sin embargo, esa monotonía respecto de la capacidad no basta para demostrar afirmaciones sobre la covarianza entre resultados aleatorios. Conviene examinar también cómo responden ambos resultados a cada componente aleatorio de las llegadas.
Una implementación robusta debe asignar números aleatorios a fenómenos equivalentes. Si un escenario hace sorteos adicionales, usar simplemente la misma semilla puede desalinear todos los sorteos posteriores. La llegada del día siguiente podría depender del número que otro escenario destinó a una duración de servicio. Separar flujos por fenómeno o generar de antemano las entradas compartidas hace explícito el acoplamiento.
El análisis estadístico debe respetar el diseño. Calculamos una diferencia por réplica y estimamos su error estándar a partir de esas diferencias. Tratar después todos los resultados como dos muestras independientes descarta la covarianza que justificó el diseño. Tampoco corresponde considerar cada día de una trayectoria como réplica independiente, porque la unidad experimental sigue siendo el par completo de trayectorias generado bajo una entrada común.
236.3. Variaciones antitéticas y compensación de fluctuaciones
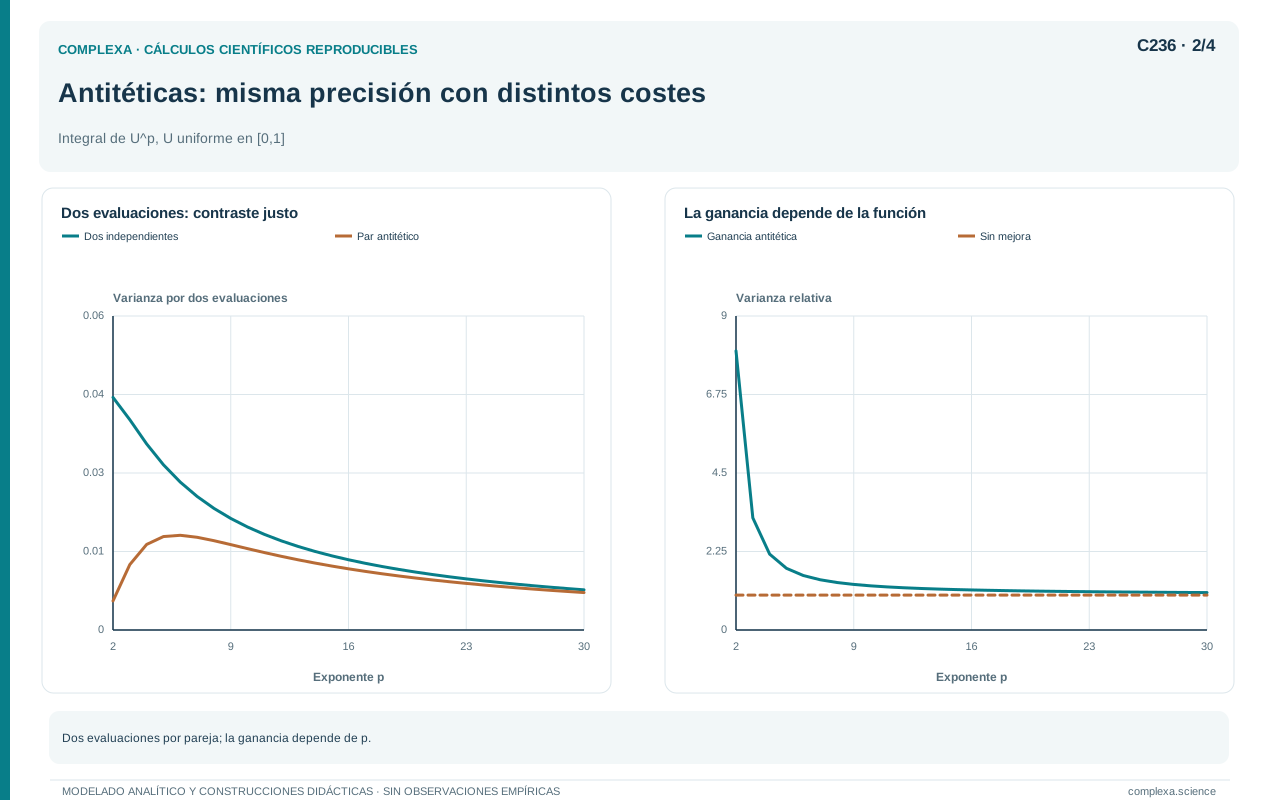
Las variaciones antitéticas crean pares dependientes para estimar una misma esperanza. La construcción clásica transforma una uniforme U en el par U y uno menos U. Cada componente tiene la distribución uniforme correcta, pero sus posiciones en el intervalo se compensan. Evaluamos la función en ambos y promediamos. Hammersley y Morton desarrollaron tempranamente la idea [2].
Si la función es creciente, un valor alto en U tiende a acompañarse de un valor bajo en uno menos U. Esa relación produce covarianza no positiva entre las dos evaluaciones y puede reducir la varianza del promedio. Para una función decreciente ocurre una compensación semejante. La propiedad depende de cómo responde la función; que las entradas sean opuestas es insuficiente.
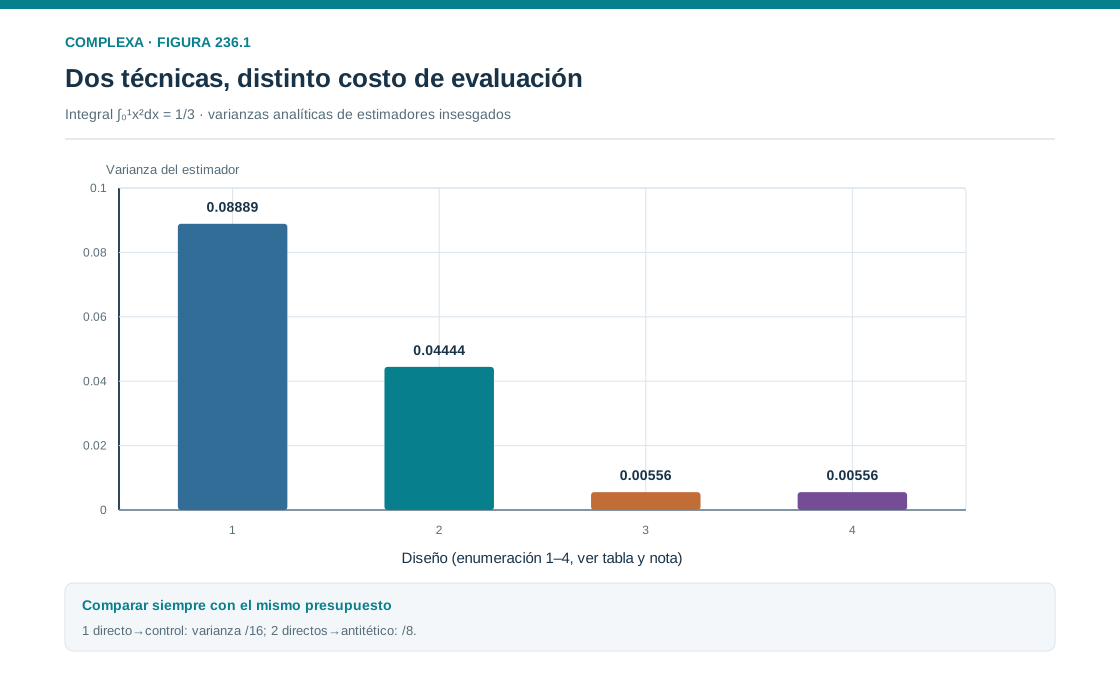
Consideremos la integral de x al cuadrado entre cero y uno. Su valor es un tercio. Una evaluación directa U al cuadrado tiene varianza cuatro cuarenta y cincoavos. El promedio antitético de U al cuadrado y el cuadrado de uno menos U se simplifica a U al cuadrado menos U más una mitad. Su esperanza sigue siendo un tercio.
Podemos verificar la varianza integrando el cuadrado de esa expresión y restando un noveno. El segundo momento resulta siete sesentavos, por lo que la diferencia es un ciento ochentavo. Esa es la varianza de un par, que consume dos evaluaciones; para compararla correctamente con el muestreo directo debemos conceder también dos evaluaciones a ese procedimiento.
Dos evaluaciones directas independientes, promediadas, tienen varianza dos cuarenta y cincoavos. Dividir esa cantidad por un ciento ochentavo da ocho. Por tanto, en este ejemplo el promedio antitético reduce ocho veces la varianza con el mismo número de evaluaciones de la función. La mejora real de tiempo dependerá además de cuánto cuesta generar las entradas y organizar los pares.
Hay un contraejemplo igualmente sencillo. Si la función es el cuadrado de U menos una mitad, sustituir U por uno menos U deja el valor idéntico. El par antitético repite la misma información. Su promedio tiene la misma varianza que una sola evaluación, mientras que dos evaluaciones independientes tendrían la mitad. A igualdad de evaluaciones, la técnica empeora la eficiencia por un factor de dos.
En varias dimensiones, transformar simultáneamente cada coordenada puede funcionar cuando la función tiene una estructura monótona adecuada. Si aparecen umbrales, máximos o respuestas no monótonas, la intuición geométrica resulta menos fiable. Una fase piloto y, cuando sea posible, un argumento de covarianza ayudan a decidir si la transformación compensa variaciones o simplemente duplica regiones similares del comportamiento.
236.4. Variables de control y esperanzas conocidas
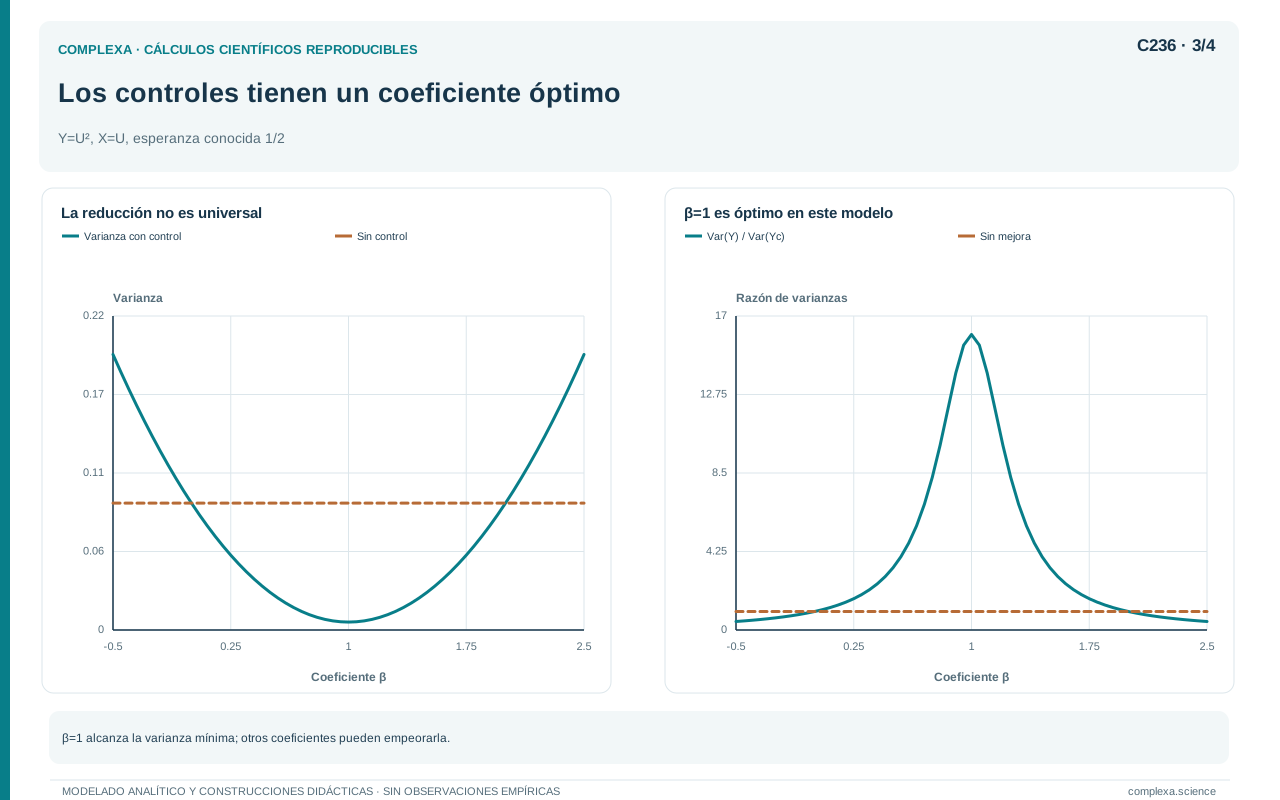
Una variable de control es una cantidad relacionada con el resultado cuya esperanza ya conocemos. Si el resultado Y aumenta cuando el control X aumenta, podemos restar una parte de la fluctuación de X alrededor de su media conocida. Como esa fluctuación tiene esperanza cero, la corrección conserva la esperanza de Y cuando el coeficiente usado es fijo.
La varianza de la variable corregida es la varianza de Y más el cuadrado de beta por la varianza de X, menos dos veces beta por la covarianza. Es una función cuadrática de beta. Cuando la varianza de X es positiva y los segundos momentos son finitos, su mínimo se alcanza dividiendo la covarianza entre Y y X por la varianza de X.
La fórmula admite controles correlacionados positiva o negativamente, porque el signo se incorpora en beta. La mejora ideal depende del cuadrado de la correlación, mientras que el beneficio práctico depende también de obtener el control y conocer su esperanza. Fieller y Hartley son una referencia temprana sobre muestreo con variables de control [3]. Aquí usamos la identidad de varianzas para resolver un caso propio.
Volvamos a Y igual a U al cuadrado y elijamos X igual a U. La esperanza del control es una mitad y su varianza es un doceavo. La covarianza entre U al cuadrado y U es también un doceavo, porque un cuarto menos el producto de un tercio por una mitad da ese valor. El coeficiente óptimo es, por tanto, uno.
La variable corregida es U al cuadrado menos U más una mitad. Coincide exactamente con la expresión del promedio antitético anterior y tiene varianza un ciento ochentavo. Sin embargo, ahora requiere una sola evaluación del cuadrado y conocer el valor de U, que ya se generó. Respecto de una evaluación directa, cuya varianza es cuatro cuarenta y cincoavos, la reducción es de dieciséis veces.
Las dos técnicas comparten aquí una expresión algebraica porque el integrando es muy sencillo; en general no son equivalentes. En un simulador costoso, quizá exista un control barato basado en una aproximación lineal, una conservación conocida o un modelo simplificado. Que el control parezca relacionado con la salida es insuficiente; debemos comprobar que su esperanza sea realmente conocida bajo la misma distribución de entradas.
Usar una esperanza incorrecta introduce sesgo. Si reemplazamos la media verdadera del control por otra cifra, el estimador cambia su esperanza en beta multiplicado por la diferencia entre ambas. Una reducción visible de dispersión puede entonces acompañarse de un error sistemático. Esa es una razón para documentar de dónde procede la media del control y con qué precisión se conoce.
236.5. Estimar el control sin ocultar su costo
En problemas reales, la covarianza óptima casi nunca se conoce de antemano. Podemos estimar beta con un piloto independiente y fijarlo durante la producción. Condicionado al piloto, el coeficiente es una constante para las nuevas observaciones y el estimador mantiene su esperanza correcta, siempre que la media del control sea exacta y existan las esperanzas necesarias.
El piloto consume recursos y añade incertidumbre sobre la eficiencia conseguida. Un coeficiente mal estimado conserva el insesgamiento condicional, pero puede reducir poco la varianza o incluso aumentarla. Conviene registrar el tamaño del piloto, el coeficiente elegido y el costo total, para no evaluar el procedimiento como si su ajuste hubiera sido gratuito.
Estimar beta con las mismas observaciones usadas para calcular el promedio corregido introduce dependencia entre el coeficiente y la media del control. El argumento elemental de insesgamiento con beta fijo deja de aplicarse automáticamente. En muchos diseños el sesgo puede ser pequeño y la mejora práctica importante, pero ambas propiedades requieren análisis. Separar datos o usar particiones cruzadas permite estudiar alternativas con una dependencia mejor controlada.
Los controles múltiples amplían la idea mediante un vector de variables y coeficientes. El ajuste busca explicar la variación de Y con combinaciones de controles cuyas esperanzas conocemos. Si dos controles son casi iguales, la matriz de covarianzas puede resultar mal condicionada y producir coeficientes inestables. Más controles no siempre significan mayor eficiencia fuera de la muestra usada para elegirlos.
También es posible estimar la media de un control barato mediante muchas simulaciones adicionales. En ese caso la media ya no es una constante exacta y su error debe propagarse. Si usamos un estimador independiente de esa media, la varianza total incorpora la incertidumbre del control estimado. El presupuesto debe distribuirse entre evaluaciones caras del resultado y evaluaciones baratas del control de acuerdo con sus costos y variabilidades.
Una aproximación determinista puede usarse como control si conocemos su integral bajo la distribución de entradas. Que aproxime bien la salida punto a punto ayuda, pero la condición decisiva para la corrección es disponer de su esperanza.
Al reportar resultados conviene mostrar el estimador original y el corregido, junto con sus errores y costos. Una discrepancia sistemática entre ambos a medida que aumentan las réplicas puede revelar una media de control incorrecta o un error de implementación. Una coincidencia aproximada no basta para probar la validez, pero la comparación es una comprobación que complementa la identidad matemática.
236.6. Estratificar para cubrir regiones distintas
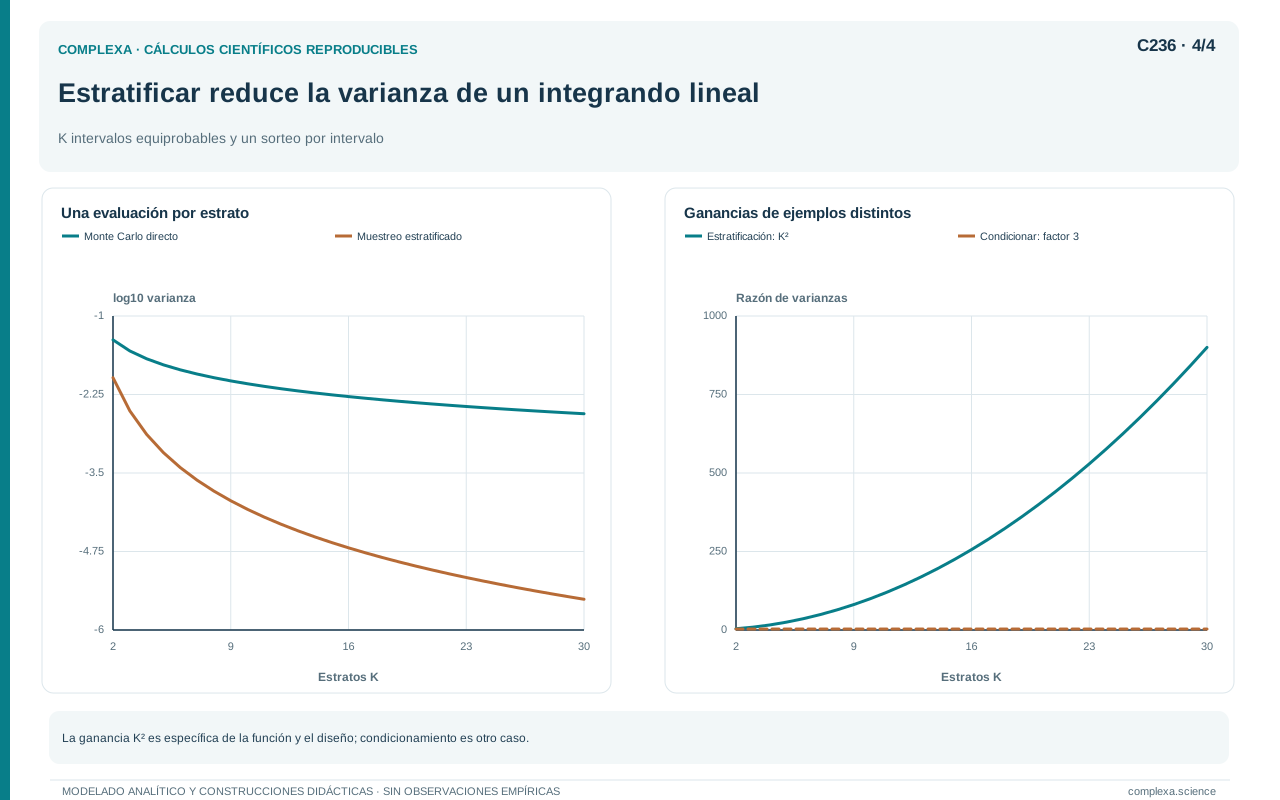
La estratificación divide el espacio de entradas en regiones y reserva muestras para cada una. Así controlamos cuántas observaciones caen en cada región, algo que en el muestreo directo depende del azar, y ponderamos cada promedio por la probabilidad de su región. El estimador conserva la esperanza si las muestras representan correctamente las distribuciones condicionales dentro de los estratos.
Sean p_h las probabilidades de los estratos, n_h sus tamaños de muestra y sigma_h al cuadrado las varianzas condicionales. Con muestras independientes entre estratos, la varianza del estimador es la suma de p_h al cuadrado por sigma_h al cuadrado dividido por n_h. Según la fórmula, la asignación influye en la varianza; una región muy variable o de gran peso puede necesitar más observaciones que otra tranquila.
Consideremos estimar la media de una uniforme entre cero y uno. Dividimos el intervalo en K subintervalos iguales y extraemos una observación uniforme independiente dentro de cada uno. El estimador es la media de esas K observaciones. Cada observación tiene varianza un doceavo multiplicado por el cuadrado de la longitud del subintervalo, es decir, uno dividido por doce K al cuadrado.
Al promediar las K observaciones independientes, la varianza final es uno dividido por doce K al cubo. En cambio, K observaciones directas de todo el intervalo producen varianza uno dividido por doce K. La reducción es de K al cuadrado. Con diez estratos y una observación en cada uno, obtenemos cien veces menos varianza para este integrando lineal y este diseño específico.
La ganancia procede de eliminar fluctuaciones en la cobertura del intervalo. El muestreo directo puede concentrar accidentalmente muchas observaciones cerca de un extremo. El diseño estratificado asegura presencia en cada subintervalo y deja solamente variación local dentro de ellos. Para funciones que oscilan rápidamente dentro de cada subintervalo, esa variación local puede seguir siendo grande y la ganancia será menor.
Si las varianzas condicionales son conocidas y los costos por muestra iguales, la asignación que minimiza la varianza para un presupuesto continuo da tamaños proporcionales a p_h por sigma_h. Los tamaños reales deben ser enteros y satisfacer necesidades mínimas de cobertura. Cuando hay costos distintos, la asignación incorpora también esos costos. Un piloto puede orientar la asignación, pero su incertidumbre y gasto forman parte del diseño.
En muchas dimensiones, una cuadrícula completa crece demasiado rápido. Estratificar cada combinación de diez intervalos en diez variables requeriría diez mil millones de celdas. Por eso conviene elegir dimensiones o particiones ligadas al resultado y considerar diseños que cubran márgenes sin pretender cubrir todas las combinaciones. El capítulo siguiente examinará esa diferencia entre explorar coordenadas y estudiar interacciones.
236.7. Sustituir un sorteo por su esperanza condicional
A veces conocemos exactamente una parte del promedio que estamos simulando y podemos integrarla sin necesidad de sortearla. Si Y es el resultado y X es información disponible, la esperanza condicional de Y dado X tiene la misma esperanza total que Y. Bajo segundos momentos finitos, su varianza no supera la de Y.
La segunda identidad explica la reducción, porque al usar la esperanza condicional eliminamos la variación interna que permanecía después de conocer X. Esta operación suele describirse como condicionamiento o como una forma de Rao–Blackwellización. Para la desigualdad anterior no necesitamos que X sea un estadístico suficiente; basta con la identidad de varianza total bajo las condiciones indicadas.
Supongamos que primero generamos X uniforme entre cero y uno y después una variable binaria Y cuya probabilidad de valer uno, dado X, es X. La probabilidad marginal de éxito es una mitad, de modo que Y tiene varianza un cuarto. Si queremos estimar su esperanza, podemos promediar los resultados binarios o promediar directamente las probabilidades X.
La segunda opción tiene varianza un doceavo por réplica, tres veces menor, y evita el sorteo binario adicional. La reducción es exacta y procede de conocer la probabilidad condicional, que pertenece al mismo modelo; su promedio reproduce exactamente la cantidad objetivo, sin ninguna aproximación arbitraria.
Promediar probabilidades condicionales estima la probabilidad marginal del evento, que es distinta de su frecuencia dentro de una única historia física. Si el interés cambia y queremos estudiar la distribución completa de una trayectoria, quizá necesitemos conservar los eventos sorteados. Integrar una variable es útil para un estimador concreto y puede eliminar información necesaria para otra pregunta.
El costo de calcular la esperanza condicional también cuenta. Si requiere resolver una integral difícil por cada valor de X, el método puede limitarse a trasladar el problema. Una aproximación numérica introduce error adicional; una estimación interna mediante nuevas simulaciones recupera parte de la variación eliminada. Debemos comparar el procedimiento completo, incluido el cálculo de la esperanza condicional.
En sistemas de estados discretos, la oportunidad puede aparecer cerca del final de una trayectoria; allí podemos sustituir el sorteo de la última transición por la suma exacta de los resultados posibles ponderados por sus probabilidades. En otros modelos podemos integrar una perturbación de observación mientras conservamos la dinámica latente. La regla práctica es buscar aleatoriedad que podamos promediar correctamente y a un costo razonable.
236.8. Volver a la comparación de capacidades
El experimento del capítulo 232 permite evaluar una reducción de varianza concreta. Con doscientas réplicas de treinta días, la media de la cola fue aproximadamente nueve coma ochocientos cincuenta y seis con capacidad diez y cuatro coma seiscientos trece con capacidad doce. La diferencia emparejada fue menos cinco coma doscientos cuarenta y tres pedidos pendientes en promedio diario.
El error estándar de esa diferencia fue aproximadamente cero coma doscientos ochenta y dos. Los errores estándar de las medias individuales fueron aproximadamente cero coma cuatrocientos cincuenta y cuatro y cero coma ciento ochenta y ocho. Si combinamos las varianzas marginales como referencia para un diseño independiente con iguales tamaños, obtenemos un error estándar aproximado de cero coma cuatrocientos noventa y uno.
La comparación de varianzas estimadas indica una reducción cercana a tres veces mediante emparejamiento en este experimento. Es una evaluación empírica basada en las réplicas disponibles; con otra duración, otra distribución de llegadas u otra función de resultado, la covarianza puede cambiar. Por eso la ganancia debe informarse junto con la descripción del diseño que la produjo.
Podemos recuperar la covarianza muestral a partir de las varianzas de ambos resultados y de la diferencia. Esta identidad es una comprobación interna útil, porque la covarianza calculada directamente entre pares debe coincidir con el valor reconstruido. Si no coincide dentro del error de redondeo, quizá los resultados fueron ordenados de manera distinta o se mezclaron réplicas que no compartían entradas.
El emparejamiento no modifica las medias marginales esperadas. Cada capacidad sigue recibiendo llegadas con la distribución especificada. Lo que cambia es la relación conjunta entre ambas trayectorias. Esta distinción permite diseñar comparaciones más precisas sin afirmar que la correlación entre escenarios sea una propiedad observada del mundo; es una decisión del experimento computacional.
Para comparar probabilidades de excedencia usaríamos diferencias entre indicadores, una por réplica. Su varianza y la ganancia de emparejamiento serían distintas de las correspondientes a la cola media. En particular, si casi todas las trayectorias exceden el umbral bajo ambos escenarios, muchas diferencias serán cero. Esa comparación no informa necesariamente sobre eventos muchísimo más raros ni sobre umbrales diferentes.
El presupuesto incluye dos ejecuciones dinámicas por réplica, pero las entradas pueden generarse una sola vez y reutilizarse. El análisis debe registrar ese ahorro junto con el costo de almacenar o reconstruir las llegadas. Si el simulador cambia, conviene verificar que la entrada común conserve su significado. La reproducibilidad del acoplamiento depende de la relación entre fenómenos, además del número escrito como semilla.
236.9. Combinar técnicas sin perder la identidad del estimador
Las técnicas pueden combinarse cuando sus condiciones son compatibles. Podemos estratificar una entrada importante, usar un control dentro de cada estrato y compartir las perturbaciones restantes entre escenarios. También podemos integrar analíticamente una transición y aplicar muestreo de importancia a otra parte de la trayectoria. El beneficio potencial aumenta, pero también lo hace la responsabilidad de describir el estimador completo.
Una combinación debe conservar el orden de las esperanzas y las ponderaciones correctas. Si estratificamos regiones con probabilidades desiguales, promediar todos los resultados sin ponderar por el diseño puede cambiar el objetivo. Si aplicamos un control después de un cambio de distribución, su esperanza debe corresponder a la distribución usada o incorporar la corrección pertinente. Dos identidades válidas por separado no se combinan correctamente solo por estar juntas en el código.
Los errores estándar también deben seguir la unidad independiente. Un par antitético es una réplica para el análisis; sus dos componentes no son observaciones independientes. Un grupo de escenarios con números comunes es otra unidad conjunta. En un diseño estratificado, las varianzas se combinan con los pesos de cada estrato. Ignorar estas dependencias puede anular en el informe la validez del diseño original.
La evaluación debe incluir casos donde la técnica fracasa. El integrando simétrico del ejemplo antitético y la comparación de respuestas opuestas mostraron fallos previsibles. Un control con media incorrecta reveló sesgo; un control costoso puede reducir precisión por unidad de tiempo. Estos casos ayudan a identificar qué propiedad concreta sostiene una mejora y qué modificación del problema puede destruirla.
Seleccionar entre muchas técnicas usando las mismas pocas réplicas puede favorecer accidentalmente la que tuvo menor varianza observada. Una evaluación posterior independiente permite distinguir una mejora reproducible de una elección afortunada. Cuando el presupuesto no permite separar etapas amplias, al menos debemos declarar la selección y evitar presentar la estimación de eficiencia como una propiedad conocida con exactitud.
La auditoría termina reconstruyendo la cantidad objetivo, la ley conjunta de generación y la fórmula del estimador. Después comprueba esperanza, varianza o condiciones suficientes, unidades independientes y costo. Esa secuencia es más informativa que preguntar solamente si el resultado parece menos ruidoso. Un estimador concentrado alrededor de una cantidad equivocada puede producir una apariencia excelente de estabilidad.
236.10. Aprovechar estructura, conservar significado
La reducción de varianza convierte conocimiento del problema en precisión computacional. Compartir circunstancias relevantes mejora ciertos contrastes; compensar entradas puede equilibrar fluctuaciones; un control resta variación predecible; la estratificación asegura cobertura; el condicionamiento elimina sorteos que podemos integrar. Cada procedimiento usa una relación específica y exige explicar cómo conserva la esperanza buscada.
Los ejemplos permiten comparar beneficios con límites claros. La diferencia entre una uniforme y su desplazamiento se volvió constante mediante emparejamiento, mientras que con respuestas opuestas el emparejamiento aumentó el error. El cuadrado de una uniforme admitió ganancias antitéticas y un control exacto de media conocida. La función simétrica mostró que una transformación elegante puede limitarse a repetir información.
También vimos que una ganancia por réplica no equivale necesariamente a una ganancia por presupuesto. El control y el promedio antitético produjeron la misma variable algebraica con costos diferentes. La estratificación dio una reducción grande para una función lineal, pero una cuadrícula completa se volvió inviable al aumentar las dimensiones. La evaluación necesita unir precisión, costo y estructura del integrando.
Para comparar decisiones dentro de un modelo, suele ser especialmente útil diseñar las simulaciones como un experimento conjunto. Las entradas compartidas y las diferencias por réplica permiten aislar contrastes de interés. Ese diseño requiere conservar qué eventos fueron emparejados y analizar los pares como unidades. La dependencia bien construida es un recurso; la dependencia ignorada es una fuente de errores.
El siguiente capítulo pasa de la precisión de un contraste a la exploración de múltiples factores. Preguntaremos qué combinaciones conviene simular y cómo detectar interacciones que un cambio aislado puede ocultar. En los dos capítulos, antes de gastar más evaluaciones, conviene decidir qué estructura del problema permite que cada evaluación responda mejor a la pregunta.
Referencias
- Glasserman, P., y Yao, D. D. (1992). Some guidelines and guarantees for common random numbers. Management Science, 38(6), 884–908. DOI: 10.1287/mnsc.38.6.884.
- Hammersley, J. M., y Morton, K. W. (1956). A new Monte Carlo technique: antithetic variates. Mathematical Proceedings of the Cambridge Philosophical Society, 52(3), 449–475. DOI: 10.1017/S0305004100031455.
- Fieller, E. C., y Hartley, H. O. (1954). Sampling with control variables. Biometrika, 41(3–4), 494–501. DOI: 10.1093/biomet/41.3-4.494.
Nota de los ejemplos. Las derivaciones uniformes y binarias son propias. La comparación de capacidades utiliza las réplicas reproducibles del capítulo 232; el contraste de eficiencia corresponde a sus varianzas muestrales y no a una nueva simulación independiente.