Módulo 24. Experimentos computacionales, muestreo y documentación
233.1. Diseñar una dinámica para calcular una integral
Muchos problemas requieren calcular promedios respecto de una distribución que conocemos solamente mediante una expresión proporcional a su densidad. Podemos evaluar qué tan compatible es un parámetro con los datos, pero no integrar fácilmente sobre todas sus posibilidades. Los métodos de Monte Carlo mediante cadenas de Markov construyen una dinámica artificial cuya distribución invariante es la distribución de interés. Las visitas de esa dinámica permiten aproximar integrales, siempre que la exploración y las condiciones matemáticas sean adecuadas.
Escribamos la distribución objetivo como una función no negativa dividida por su constante de normalización, que debe ser finita y positiva. En ciertos algoritmos solo intervienen cocientes en los que la constante se cancela, de modo que no hace falta evaluarla. Esa cancelación no elimina la necesidad de que la distribución sea normalizable; una posterior impropia no se convierte en una distribución válida porque el código produzca una trayectoria aparentemente estable.
La tarea consiste en estimar cantidades como una media, una probabilidad de excedencia o una esperanza de utilidad. Cada una corresponde a una función de los estados muestreados. La calidad de la cadena debe evaluarse respecto de esas funciones, porque una trayectoria puede explorar bien una coordenada y mal una combinación relevante. El número de estados guardados no equivale necesariamente a la información disponible para cada pregunta.
El algoritmo de Metropolis propone un cambio y usa una regla de aceptación que conserva la distribución objetivo bajo condiciones específicas. Por su sencillez es el punto de referencia habitual, pero una propuesta de caminata aleatoria puede avanzar lentamente por regiones estrechas o correlacionadas. Otros métodos usan distribuciones condicionales, variables auxiliares o gradientes para construir movimientos más adecuados a la geometría del problema.
Este capítulo compara tres familias de métodos (Gibbs, muestreo por rebanadas y Monte Carlo hamiltoniano), que no forman una escala universal de sofisticación en la que el último sea siempre mejor. Cada una requiere información distinta y enfrenta dificultades diferentes. La elección depende del tipo de variables, de la estructura de dependencia, del costo de evaluar la densidad y de la posibilidad de construir movimientos válidos.
La distinción principal será entre conservar una distribución y recorrerla de manera útil. Podemos demostrar invariancia y, sin embargo, observar una cadena atrapada; también podemos obtener una tasa alta de aceptación con movimientos insignificantes. Para comprender estas situaciones usaremos ejemplos calculables, de modo que la explicación no dependa solamente de recomendaciones sobre parámetros de un programa.
233.2. Invariancia, comunicación y equilibrio
En un espacio finito, una matriz de transición conserva una distribución cuando multiplicar esa distribución por la matriz la deja igual. Si comenzamos ya distribuidos según el objetivo, un paso mantiene esa ley, pero eso no implica que cualquier estado inicial se transforme rápidamente en una muestra representativa. La invariancia describe compatibilidad entre distribución y transición; la convergencia requiere propiedades adicionales de la dinámica.
La matriz identidad es un contraejemplo inmediato. Conserva cualquier distribución porque nunca cambia de estado, así que, si comenzamos en un punto, todas las muestras son ese punto. Aunque la distribución objetivo sea uniforme sobre muchos estados, el promedio temporal no la reproduce. De ahí que verificar únicamente una ecuación de invariancia sea insuficiente para justificar una simulación.
La comunicación entre regiones es esencial. En una cadena finita irreducible, todos los estados pueden alcanzarse entre sí mediante transiciones de probabilidad positiva. La aperiodicidad permite además la convergencia usual de la distribución del estado hacia la distribución estacionaria. Con los promedios temporales el matiz es distinto, porque una cadena irreducible periódica puede producir promedios consistentes aunque sus distribuciones en tiempos concretos oscilen. Conviene no usar la palabra «convergencia» sin especificar qué objeto converge.
El balance detallado, que exige que el flujo estacionario entre cada pareja de estados se equilibre con el flujo inverso, es una condición suficiente de invariancia. Muchos métodos conocidos lo usan, pero no es necesario para que una cadena sea válida. Una composición de actualizaciones que conservan el objetivo también lo conserva, aunque la composición no sea reversible. Este hecho será relevante para el barrido sistemático de Gibbs.
En espacios continuos, las condiciones se formulan mediante núcleos de transición, conjuntos accesibles y propiedades de recurrencia; los criterios para matrices finitas no se trasladan literalmente. En la práctica debemos conocer qué garantiza el algoritmo para la clase de distribuciones considerada y comprobar si restricciones, discontinuidades o regiones desconectadas afectan esas condiciones. Las trayectorias dan evidencia diagnóstica, pero no reemplazan un argumento de validez.
También debe distinguirse el equilibrio matemático de una fase inicial de adaptación. Una cadena comenzada lejos de regiones relevantes puede tardar en explorarlas; por su parte, una rutina que cambia su transición durante el ajuste todavía no es el mismo proceso que usaremos para resumir muestras. Registrar esas fases ayuda a interpretar resultados y prepara el análisis de diagnósticos del capítulo siguiente.
233.3. Muestreo de Gibbs con distribuciones condicionales
El muestreo de Gibbs actualiza una variable o un bloque mediante su distribución condicional dadas las restantes. Si podemos obtener muestras exactas de esa condicional, la actualización conserva la distribución conjunta objetivo. La idea explota una estructura que puede ser mucho más sencilla que la distribución completa. El trabajo de Geman y Geman es una referencia histórica central para el uso de actualizaciones locales de este tipo en modelos de imágenes [1].
Consideremos dos variables normales, centradas, con varianzas unitarias y correlación positiva. La distribución condicional de la primera, dada la segunda, es normal con media igual a la correlación multiplicada por el valor de la segunda y varianza igual a uno menos el cuadrado de la correlación. La otra condicional tiene la forma simétrica. Podemos alternar sorteos de ambas sin proponer movimientos que luego deban rechazarse.
Un barrido sistemático actualiza primero X y después Y usando el valor recién obtenido de X. Cada actualización conserva el objetivo y su composición también, aunque de ahí no se sigue que el barrido completo satisfaga balance detallado. Otra variante elige aleatoriamente qué coordenada actualizar en cada paso. Ambas requieren definir qué llamamos una iteración antes de comparar costos o autocorrelaciones.
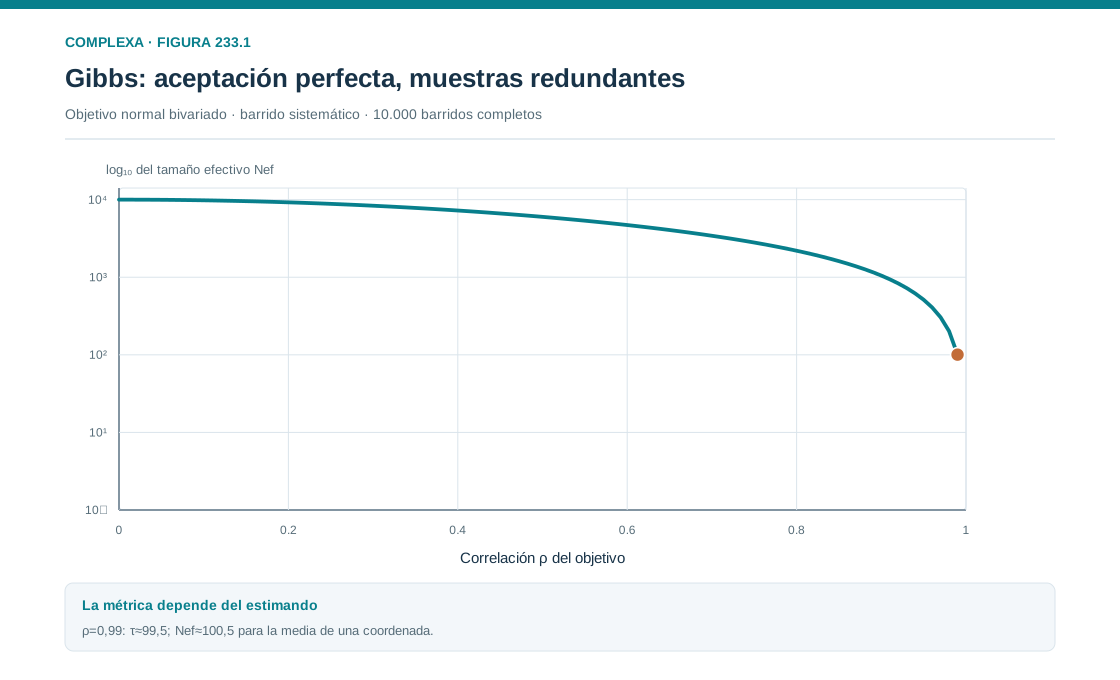
La aceptación de cada sorteo condicional exacto puede describirse informalmente como cien por ciento, pero no mide eficiencia. Cuando la correlación se aproxima a uno, las distribuciones condicionales son estrechas. La cadena cambia poco en la dirección de variación conjunta de X e Y, aunque cada sorteo sea válido. No hay rechazos que adviertan de ese desplazamiento lento.
Podemos cuantificar el problema. Si observamos una coordenada después de cada barrido completo, su autocorrelación a un retraso es el cuadrado de la correlación del objetivo. Para la media de esa coordenada, en régimen estacionario, el factor integrado de autocorrelación es uno más ese cuadrado dividido por uno menos ese cuadrado. Con correlación cero coma noventa y nueve, el factor es aproximadamente noventa y nueve coma cinco. El mismo factor aparece con correlación negativa de igual magnitud, porque el barrido introduce su cuadrado.
Esto significa que, bajo las condiciones de este ejemplo y para esa media, muchas iteraciones equivalen en información a pocas observaciones independientes. Es un cálculo específico, que no describe a Gibbs en general ni a cualquier función de las coordenadas, pero muestra cómo una geometría correlacionada puede degradar un algoritmo aun cuando cada paso se obtenga exactamente de una distribución condicional.
Para entender la dependencia basta sustituir una actualización dentro de la siguiente. El nuevo valor de Y contiene el valor anterior multiplicado por el cuadrado de la correlación, más una innovación normal independiente cuya varianza es uno menos la cuarta potencia de la correlación. Así se mantiene la varianza estacionaria unitaria y la autocorrelación decrece como potencias sucesivas del cuadrado de la correlación; la suma de esa serie geométrica da el factor anterior. Con diez mil barridos y correlación cero coma noventa y nueve, la precisión asintótica de la media equivale aproximadamente a la de cien observaciones independientes, siempre que la fase inicial ya no domine el cálculo.
233.4. Bloques y parametrizaciones
Una respuesta al problema anterior consiste en actualizar conjuntamente variables fuertemente dependientes. En la distribución normal bivariada conocemos un procedimiento directo para sortear el par completo, por lo que ese bloque produce muestras independientes. En problemas más grandes, sortear la distribución condicional de un bloque puede seguir siendo difícil. El beneficio de reducir la dependencia entre iteraciones debe compararse con el costo de generar cada actualización.
Otra estrategia cambia las coordenadas. Para la normal bivariada, combinaciones estandarizadas de la suma y la diferencia transforman la distribución en dos normales independientes. La dirección de la suma tiene varianza proporcional a uno más la correlación, mientras que la de la diferencia tiene varianza proporcional a uno menos ella. La transformación alinea el muestreo con las direcciones de variación del objetivo.
En estas coordenadas, actualizar una variable no obliga a desplazarse mediante pasos minúsculos dentro de una diagonal estrecha. El ejemplo muestra que la eficiencia depende de la combinación de algoritmo, distribución y parametrización. Comparar nombres de métodos sin examinar las coordenadas puede ocultar la principal razón de una diferencia de rendimiento.
Un caso discreto revela una limitación más grave. Supongamos que el objetivo reparte la probabilidad por mitades entre cero cero y uno uno y asigna probabilidad cero a las otras dos combinaciones. Si actualizamos un bit condicionado al otro, su valor queda determinado, porque ambos deben coincidir. Una cadena iniciada en cero cero nunca llega a uno uno. Las condicionales son correctas, pero las actualizaciones individuales no conectan el soporte.
Actualizar ambos bits como bloque, es decir, sortear directamente una de las dos parejas permitidas, resuelve ese ejemplo. Añadir pequeñas perturbaciones a las probabilidades también cambiaría la accesibilidad, pero modificaría el objetivo si no forma parte de un algoritmo que preserve la distribución original.
En modelos jerárquicos, distintas parametrizaciones pueden distribuir de manera diferente la dependencia entre parámetros de grupo y parámetros globales. No existe una transformación universalmente superior, porque la información que dan los datos y las escalas del modelo pueden cambiar qué representación resulta más eficiente. Conviene estudiar la geometría y las restricciones antes de alargar mecánicamente una cadena que se mueve mal.
Cuando no podemos sortear exactamente una condicional, podemos insertar una transición de Metropolis–Hastings que la conserve. Una transición válida de ese tipo, combinada correctamente con las demás actualizaciones, puede conservar el objetivo conjunto sin exigir que una cadena interna alcance equilibrio en cada paso. Lo necesario es la invariancia de la actualización condicional usada. Reemplazarla por una aproximación arbitraria o por el punto de máxima densidad no da la misma garantía.
233.5. Muestreo por rebanadas
El muestreo por rebanadas introduce una variable auxiliar que selecciona una región situada bajo la densidad no normalizada. Si la función objetivo es f, consideramos pares donde la altura auxiliar está entre cero y f del estado. La distribución uniforme sobre esa región tiene como marginal una densidad proporcional a f. Al alternar actualizaciones de altura y posición se obtienen movimientos que conservan el objetivo [2].
Dado el estado actual, sorteamos una altura uniforme entre cero y la altura de la función en ese punto. Después hay que actualizar la posición dentro del conjunto donde la función supera esa altura, que es la rebanada. En casos sencillos podemos muestrear uniformemente toda la rebanada; en otros usamos procedimientos válidos que recorren partes de ella. Elegir cualquier punto admisible no es suficiente, porque la construcción concreta debe preservar la distribución requerida.
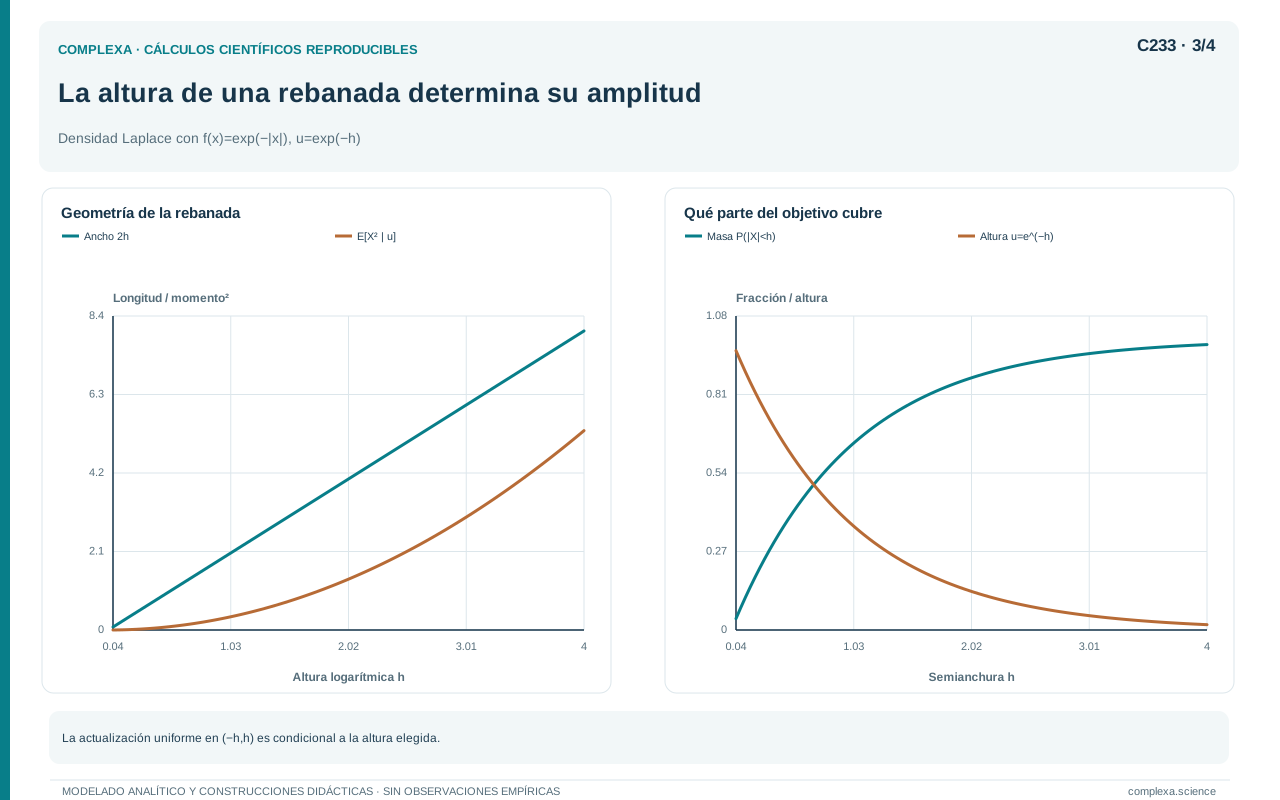
Una densidad proporcional a la exponencial del negativo del valor absoluto permite calcular el procedimiento. Si la altura elegida es u, la rebanada es un intervalo simétrico cuyo extremo positivo es el negativo del logaritmo de u. Sortear uniformemente dentro de ese intervalo da la actualización exacta de posición. La integral de esa función sobre la recta es dos, de modo que la densidad normalizada es su mitad; aun así, el algoritmo puede usar directamente la función sin ese factor, porque la construcción auxiliar conserva la marginal proporcional requerida.
Por ejemplo, desde un estado de valor dos, si el sorteo auxiliar produce una altura igual a la exponencial de menos tres, la rebanada va de menos tres a tres. Un punto situado a tres cuartos del recorrido del intervalo vale uno coma cinco. A diferencia de lo que ocurre con un salto fijo, la extensión disponible depende de la altura sorteada y, por tanto, del objetivo.
Para distribuciones generales, localizar una rebanada puede requerir expansión de intervalos y contracción cuando un candidato no cumple la condición. Las reglas de selección inicial, expansión y contracción condicionan la validez del método. Si la rebanada tiene componentes desconectados, permanecer en uno puede dificultar la exploración global. Un algoritmo local válido no equivale necesariamente a un sorteo uniforme independiente de toda la región.
El método evita ciertos problemas de ajuste de propuestas, pero no elimina todos los parámetros ni garantiza desplazamientos largos útiles. En múltiples dimensiones, actualizar coordenadas por separado puede reproducir la lentitud que observamos en Gibbs; las versiones que usan direcciones o bloques explotan otra información geométrica. Más allá de la ausencia de una tasa convencional de rechazo final, la evaluación debe medir el costo de buscar la rebanada y la información obtenida por unidad de cómputo.
233.6. Dinámica hamiltoniana como propuesta
Monte Carlo hamiltoniano añade variables auxiliares de momento a las coordenadas de interés. Define una energía potencial a partir del negativo del logaritmo de la densidad objetivo y una energía cinética, habitualmente cuadrática, para los momentos. La distribución conjunta combina el objetivo con una distribución normal de momentos. La dinámica asociada usa gradientes para desplazarse por el espacio ampliado [3].
Con una matriz de masa constante y positiva definida, la energía tiene la forma siguiente. La coordenada cambia según el momento transformado por la inversa de la matriz, mientras el momento cambia según el gradiente negativo de la energía potencial. Los momentos son instrumentos del muestreador; no corresponden necesariamente a impulsos físicos del sistema que estamos modelando.
La dinámica exacta conserva energía y volumen. Estas propiedades permiten construir propuestas que recorren distancias grandes sin atravesar continuamente regiones de probabilidad insignificante. Sin embargo, normalmente no podemos resolver las ecuaciones de forma exacta, así que usamos integración numérica y debemos considerar el error que introducen el paso de integración y la duración de la trayectoria.
El integrador leapfrog alterna medio paso de momento, un paso de posición y otro medio paso de momento. Para la forma separable de energía usada aquí conserva volumen y tiene una estructura reversible con el tratamiento adecuado de los momentos. La energía, en cambio, no se conserva exactamente; una corrección de Metropolis basada en el cambio de energía compensa ese error dentro del algoritmo correctamente construido.
Una trayectoria larga no es necesariamente mejor. Puede recorrer regiones relevantes o volver cerca del punto inicial después de gastar muchas evaluaciones de gradiente. Un paso demasiado grande puede producir errores de integración considerables; uno muy pequeño puede elevar el costo sin una ventaja que lo compense. El método reemplaza una caminata aleatoria simple por una propuesta informada, pero conserva un problema de diseño geométrico y numérico.
La diferenciabilidad del objetivo es una condición práctica central para esta versión estándar. Variables discretas, fronteras duras y discontinuidades requieren tratamientos específicos, marginalización u otros algoritmos. Asignarles coordenadas numéricas y calcular un gradiente inexistente no resuelve el problema, porque la información que usa el muestreador debe corresponder a la densidad y al dominio reales que definen la distribución objetivo.
233.7. Un oscilador que explica la longitud de trayectoria
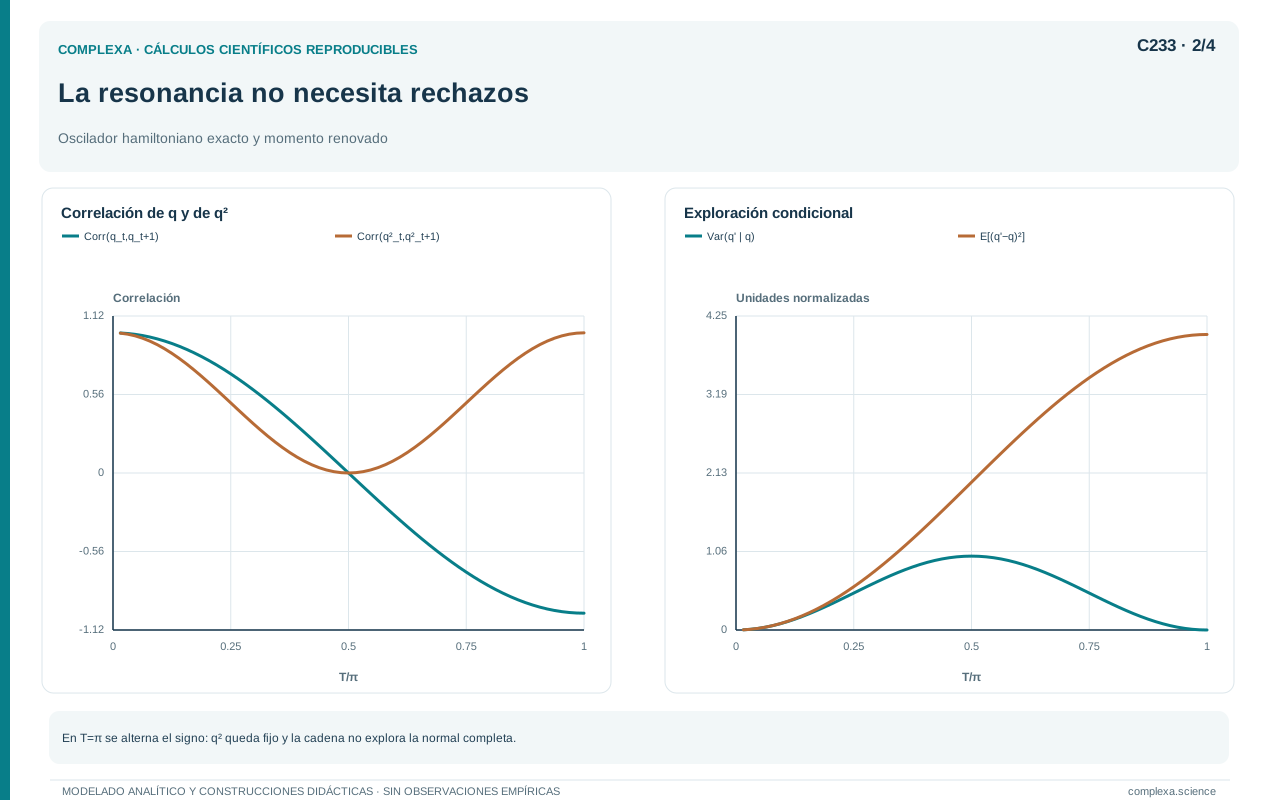
Consideremos una normal estándar unidimensional y un momento también normal estándar. La energía es la mitad de la suma de los cuadrados de posición y momento. Las ecuaciones hamiltonianas describen una rotación, de modo que la posición después de un tiempo T es la posición inicial multiplicada por el coseno de T más el momento inicial multiplicado por el seno de T. Este caso puede resolverse exactamente y permite estudiar la longitud de trayectoria sin error de integración.
Si elegimos un cuarto de período, el coseno es cero y el seno es uno. La nueva posición coincide con el momento recién sorteado, que es independiente de la posición anterior y tiene la distribución objetivo. En este ejemplo particular obtenemos una muestra independiente con cada trayectoria. El resultado depende de la forma normal y de conocer su escala; no se generaliza automáticamente a cualquier distribución.
Si elegimos medio período, la posición cambia de signo y deja de depender del momento. Aunque renovemos el momento en cada iteración, el valor absoluto de la posición permanece fijo y la cadena alterna entre dos puntos. La energía exacta se conserva y no hay motivo para rechazar la propuesta, pero la exploración de la normal es completamente insuficiente desde una inicialización fija.
El contraste muestra que una aceptación perfecta tampoco garantiza un buen muestreo hamiltoniano. La geometría del movimiento y el tiempo de integración pueden producir resonancias. Variar de manera apropiada las longitudes o usar mecanismos adaptativos válidos ayuda a evitar algunas de esas situaciones, aunque ninguna regla elimina todos los problemas posibles. Una propiedad diagnóstica aislada debe interpretarse junto con la trayectoria y con las cantidades que queremos estimar.
En varias dimensiones pueden coexistir direcciones con escalas de oscilación diferentes. Una duración conveniente para una dirección puede ser demasiado corta o resonante para otra. La matriz de masa y la parametrización modifican esas escalas y pueden facilitar una exploración más equilibrada. El ejemplo unidimensional no da una receta universal para elegirlas, aunque muestra por qué evaluar solamente el desplazamiento total puede ocultar una dirección que apenas cambia. Las combinaciones de parámetros relevantes merecen tanta atención como cada coordenada por separado.
Hoffman y Gelman desarrollaron NUTS para construir trayectorias cuya extensión se ajusta mediante un criterio de retorno, sin fijar manualmente un número único de pasos [4]. La selección de candidatos y la construcción de la trayectoria forman parte de la corrección del método. Detener una integración cuando parece regresar y aceptar siempre el último punto no reproduce necesariamente NUTS ni conserva el objetivo.
La adaptación reduce ciertas decisiones manuales, pero no vuelve irrelevante la parametrización ni garantiza transiciones entre modos separados. Un muestreador puede desplazarse eficientemente dentro de un modo y visitar muy raramente otro. El ejemplo del oscilador explica una dificultad local; la multimodalidad añade dificultades globales. Ambas deben examinarse antes de interpretar una colección extensa de muestras como representación completa de la distribución.
233.8. Transformaciones, restricciones y densidades correctas
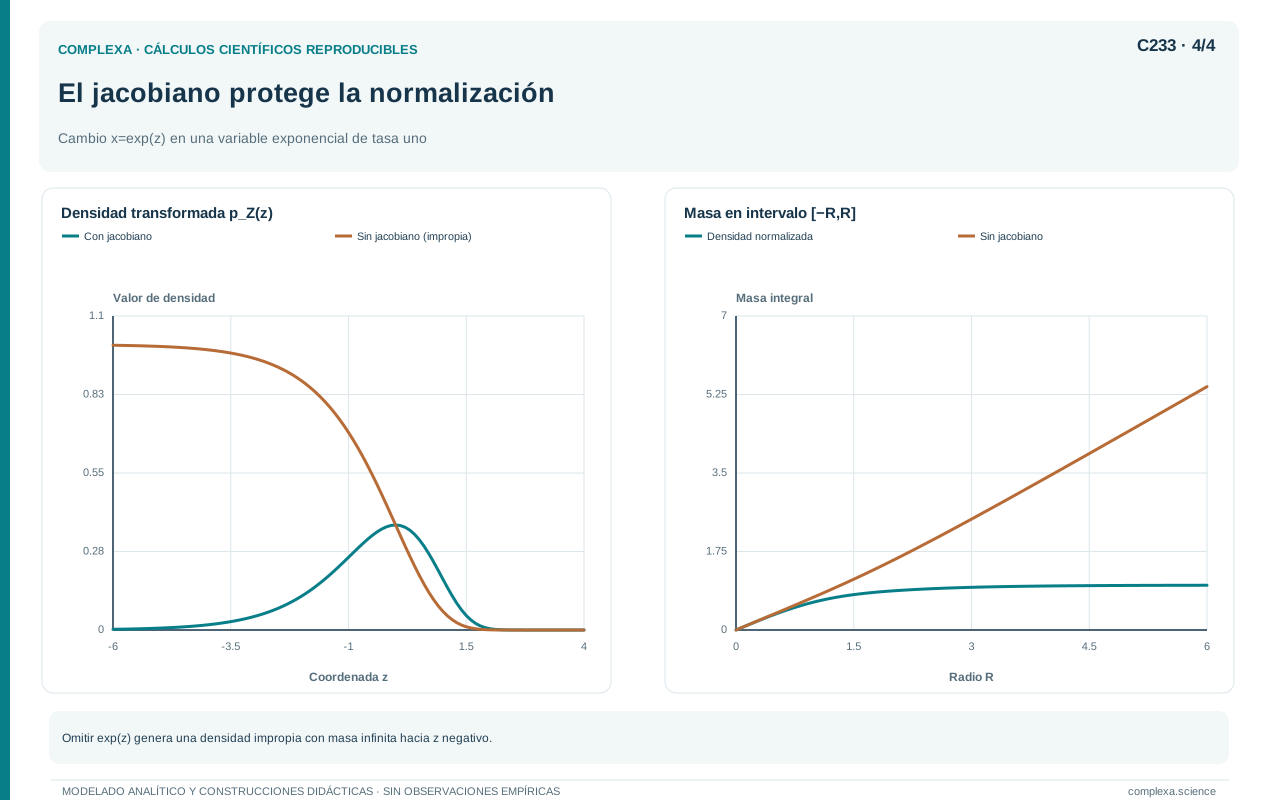
Cambiar coordenadas puede mejorar la exploración, pero exige transformar correctamente la densidad. Si una variable positiva se representa como la exponencial de una coordenada real, el elemento de volumen también cambia y la densidad en la nueva coordenada incluye el valor absoluto del jacobiano. Omitirlo define otro objetivo, que incluso puede dejar de ser normalizable.
Tomemos una variable exponencial de tasa uno, cuya densidad sobre valores positivos es la exponencial del negativo de la variable. Si escribimos la variable como la exponencial de z, la densidad de z es proporcional a la exponencial de z menos la exponencial de z. En notación precisa, el logaritmo de la densidad contiene un término z y un término negativo igual a la exponencial de z.
Sin el factor jacobiano obtendríamos una función que tiende a uno cuando z se dirige hacia menos infinito, de modo que su integral diverge. Un programa podría recorrer valores muy negativos y aparentar problemas de convergencia cuando el error real es haber definido una densidad impropia. Por eso la primera auditoría debe examinar el objetivo antes de ajustar pasos o aumentar iteraciones.
Los jacobianos también explican por qué la ubicación de la máxima densidad depende de la parametrización. El modo en una coordenada no se transforma necesariamente en el modo de la densidad en otra, mientras que las probabilidades de conjuntos sí se conservan cuando la transformación se hace correctamente. Muestrear distribuciones y optimizar densidades son tareas emparentadas, pero se ocupan de objetos distintos.
Las restricciones deterministas pueden reducir la dimensión efectiva del soporte. Si dos variables deben ser exactamente iguales, tratarlas como coordenadas independientes con una penalización muy grande aproxima otro problema y puede producir geometría difícil. Una parametrización que represente directamente la restricción puede ser más adecuada. Al elegir hay que reconocer si la igualdad es exacta, aproximada o una hipótesis empírica incierta.
La validación del objetivo incluye casos simples con distribuciones conocidas, comprobaciones de normalización cuando sean posibles y comparación de gradientes con cálculos independientes en puntos seleccionados. Estas comprobaciones, que no sustituyen una demostración general del algoritmo, sirven para detectar errores concretos de implementación o parametrización antes de atribuir al muestreador una dificultad que pertenece a la expresión probabilística usada.
233.9. Comparar costo e información obtenida
Una comparación de algoritmos debe usar el mismo objetivo y cantidades de interés comunes. Contar iteraciones puede ser engañoso, porque un paso de Gibbs, una búsqueda de rebanada y una trayectoria hamiltoniana requieren trabajos distintos. Conviene registrar tiempo de ejecución, evaluaciones de densidad, evaluaciones de gradiente cuando correspondan y precisión de las estimaciones. El criterio depende de qué recurso limite el estudio.
También debemos separar la adaptación de la producción de las muestras que se usan en el análisis. Una estrategia habitual ajusta parámetros durante una fase inicial y después los fija para ejecutar una transición estable. Existen algoritmos adaptativos con otras garantías, pero cambiar arbitrariamente la propuesta en función de la historia no asegura que la validez se conserve. Si usamos adaptación continua, necesitamos conocer las condiciones del método concreto.
La inicialización debe explorar posibilidades plausibles y permitir detectar regiones separadas. Varias cadenas iniciadas en el mismo punto pueden compartir un atrapamiento y dar una falsa sensación de acuerdo. Inicios distintos no garantizan descubrir todos los modos, pero permiten una comparación informativa. La elección debe respetar el soporte y evitar estados donde la densidad o el gradiente no estén definidos.
Para la normal correlacionada podemos comparar medias de coordenadas, varianzas y combinaciones de suma y diferencia. Un algoritmo puede estimar bien una media por simetría mientras explora mal la escala. Por ejemplo, la alternancia de signos del oscilador tiene media temporal cercana a cero, pero conserva un cuadrado fijo y no reproduce la variabilidad correcta; evaluar solamente la media escondería el fracaso.
El tamaño efectivo de muestra aproxima cuántas observaciones independientes darían una precisión comparable para una cantidad determinada. No transforma las muestras correlacionadas en independientes ni verifica que la cadena haya visitado todas las regiones relevantes. Su estimación presupone que la dependencia observada contiene información útil sobre el comportamiento de largo plazo, de modo que una cadena atrapada puede producir diagnósticos internos engañosamente favorables.
La selección final debe considerar la estabilidad de las estimaciones, el costo y la evidencia de exploración. Una variante que ahorra tiempo pero introduce sesgo por omitir un jacobiano resuelve otro problema. Un cambio que conserva el objetivo y reduce la autocorrelación puede ser útil aunque cada paso sea más costoso. La comparación científica debe conservar el objeto estimado y mostrar dónde se gana precisión o se reduce trabajo.
233.10. Elegir movimientos según la estructura
Gibbs usa distribuciones condicionales accesibles; el muestreo por rebanadas, una representación auxiliar bajo la densidad; Monte Carlo hamiltoniano, gradientes y una dinámica en un espacio ampliado. Cada familia convierte una propiedad del objetivo en una oportunidad de movimiento. Las dificultades aparecen cuando esa oportunidad no conecta regiones relevantes o cuando su implementación altera la distribución que debía conservar.
Los ejemplos permiten reconocer problemas diferentes. Una correlación alta ralentiza las actualizaciones individuales sin invalidarlas, mientras que un soporte formado por dos parejas aisladas vuelve reducible un Gibbs por coordenadas. Una longitud resonante arruina la exploración hamiltoniana aunque la energía se conserve exactamente. Un jacobiano omitido cambia el objetivo antes de que el algoritmo comience. Las respuestas apropiadas son distintas porque las causas también lo son.
Elegir un método implica formular una hipótesis sobre qué estructura facilita la exploración. Podemos probar bloques, nuevas coordenadas o propuestas informadas, pero debemos conservar comparaciones que permitan atribuir una mejora a la decisión correcta. Si cambiamos simultáneamente objetivo, parametrización, inicialización y algoritmo, una trayectoria más atractiva no revela qué componente produjo la diferencia.
La arquitectura del capítulo anterior ayuda a mantener esas decisiones separadas. La densidad objetivo, la transformación de variables, la transición, la adaptación y el análisis deben poder identificarse; guardar muestras sin esa información impide reconstruir el significado de los resultados. El objeto final es una estimación de cantidades definidas mediante un procedimiento cuya validez y rendimiento pueden examinarse.
El próximo capítulo desarrolla diagnósticos de convergencia y tamaño efectivo de muestra. Allí estudiaremos cómo detectar discrepancias entre cadenas y cómo cuantificar precisión sin prometer una certificación absoluta de exploración. Para que la simulación de una distribución se convierta en evidencia útil sobre ella, invariancia, accesibilidad, geometría y costo deben evaluarse conjuntamente.
Referencias
- Geman, S., y Geman, D. (1984). Stochastic relaxation, Gibbs distributions, and the Bayesian restoration of images. IEEE Transactions on Pattern Analysis and Machine Intelligence, PAMI-6(6), 721–741. DOI: 10.1109/TPAMI.1984.4767596.
- Neal, R. M. (2003). Slice sampling. The Annals of Statistics, 31(3), 705–767, incluyendo discusión y respuesta. DOI: 10.1214/aos/1056562461.
- Neal, R. M. (2011). MCMC using Hamiltonian dynamics. En S. Brooks, A. Gelman, G. L. Jones y X.-L. Meng, eds., Handbook of Markov Chain Monte Carlo, 113–162. DOI: 10.1201/b10905-6. Versión del autor depositada en 2012.
- Hoffman, M. D., y Gelman, A. (2014). The No-U-Turn sampler: Adaptively setting path lengths in Hamiltonian Monte Carlo. Journal of Machine Learning Research, 15, 1593–1623. Artículo original.
Nota didáctica. Los ejemplos de normales correlacionadas, soporte discreto, rebanada exponencial, oscilador y cambio de coordenadas son derivaciones propias destinadas a examinar propiedades de los algoritmos.