Módulo 25. Autómatas celulares y modelos basados en agentes
248.1. Simular es más fácil que evaluar una verosimilitud
Un modelo de agentes puede generar una trayectoria mediante reglas locales, encuentros y decisiones aleatorias. Sin embargo, calcular la probabilidad de una observación concreta puede requerir sumar sobre innumerables historias internas no observadas.
El cómputo bayesiano aproximado, conocido por la sigla ABC, usa simulaciones para comparar parámetros con datos cuando evaluar la verosimilitud es difícil. En su forma básica, propone parámetros, genera datos artificiales y conserva las propuestas cuyas salidas se parecen suficientemente a la observación. La semejanza debe definirse mediante resúmenes, una distancia y una tolerancia.
El enfoque conserva una estructura bayesiana, porque combina una distribución previa con la capacidad del modelo para producir observaciones compatibles. No elimina la necesidad de supuestos probabilísticos. La distribución del simulador ocupa el lugar que, en otros procedimientos, tiene una expresión evaluable de la verosimilitud.
El trabajo de Beaumont, Zhang y Balding es una referencia importante en el desarrollo de ABC y de ajustes basados en regresión [1]. Comenzaremos con el rechazo simple, que permite ver con claridad qué distribución se obtiene. Después discutiremos cómo mejorar eficiencia sin confundirla con recuperación de información perdida.
La calibración de agentes plantea dificultades particulares. Parámetros diferentes pueden compensarse; una media colectiva puede ocultar distribuciones individuales distintas; y una regla de observación puede omitir parte del estado simulado. ABC hace abordables computacionalmente esos problemas bajo una comparación definida, sin resolverlos automáticamente.
Usaremos primero un ejemplo de posterior exacta conocida, con diez agentes independientes que comparten una probabilidad de activación y siete activaciones observadas. El ejemplo carece deliberadamente de interacción; es un control para medir el efecto de la tolerancia antes de aplicar el método a un simulador más complejo.
Después volveremos a modelos de interacción y recursos. La pregunta será qué características de los datos permiten distinguir parámetros o mecanismos. Un algoritmo puede funcionar correctamente y devolver una distribución amplia porque la información es insuficiente. Esa amplitud puede ser un resultado adecuado que no hay por qué ocultar.
El propósito del capítulo es separar aproximación computacional, reducción de datos e incertidumbre del modelo. Cada una tiene consecuencias diferentes y requiere comprobaciones específicas. Aumentar el número de simulaciones solo aborda una parte de ese conjunto.
248.2. La distribución objetivo del rechazo ABC
Llamemos theta al conjunto de parámetros y y a los datos. El simulador genera y a partir de theta según una distribución especificada. Antes de observar datos asignamos una distribución previa a theta. En una inferencia bayesiana exacta, la posterior es proporcional a la previa multiplicada por la verosimilitud.
ABC reemplaza la evaluación directa de esa verosimilitud por un evento de proximidad. Calculamos un resumen S para los datos observados y para cada simulación. Aceptamos el parámetro cuando la distancia entre ambos resúmenes no supera una tolerancia positiva o nula, según el tipo de datos.
El procedimiento de rechazo repite tres operaciones (extraer un parámetro de la previa, simular un conjunto de datos y aplicar el criterio de aceptación). Los parámetros aceptados forman una muestra de una distribución definida por ese evento, siempre que las propuestas y simulaciones se generen correctamente.
Esta expresión muestra qué hace la tolerancia. Un parámetro recibe peso según la frecuencia con que produce resúmenes dentro de una región alrededor del observado. Esa ponderación es distinta de buscar el parámetro cuya simulación más cercana tenga menor distancia.
Con datos continuos, exigir igualdad exacta suele tener probabilidad cero. Una tolerancia permite aceptar una región con probabilidad positiva. Al reducirla y bajo condiciones apropiadas, la distribución se aproxima a la posterior condicionada en el resumen observado. Si el resumen pierde información, reducir la tolerancia no la recupera, porque el límite sigue condicionado únicamente en el resumen.
Con datos discretos, una coincidencia exacta puede tener probabilidad positiva. Entonces el rechazo con tolerancia cero puede ser una forma exacta de muestrear la posterior condicionada en el resumen. El costo depende de cuán frecuente sea esa coincidencia bajo la distribución predictiva previa.
La distribución previa debe formar parte del procedimiento. Proponer parámetros uniformemente dentro de límites elegidos por conveniencia equivale a usar esa previa, salvo que incorporemos pesos correctivos.
También debemos fijar el tamaño y el esquema de observación de los datos simulados. Comparar una media de mil agentes simulados con una observación de diez sin representar la diferencia de muestreo cambia la variabilidad de la comparación. El simulador debe generar el tipo de registro que realmente se observó.
248.3. Un ejemplo con posterior exacta
Supongamos diez agentes independientes. Cada uno se activa una sola vez con probabilidad p, común a todos. Observamos siete activaciones. El total K tiene distribución binomial con diez ensayos y parámetro p. Asignaremos a p una previa uniforme entre cero y uno.
La verosimilitud del total observado es proporcional a p elevado a siete multiplicado por uno menos p elevado a tres. Al combinarla con la previa uniforme obtenemos una distribución beta con parámetros ocho y cuatro. Su media es dos tercios.
La varianza de esa posterior es dos dividido por ciento diecisiete, aproximadamente 0,017094. Esta distribución expresa la incertidumbre sobre la probabilidad común bajo independencia, homogeneidad y la previa elegida. No describe heterogeneidad de probabilidades entre los diez agentes.
Para aplicar ABC, extraemos p de la uniforme, simulamos diez activaciones y contamos K simulado. Usamos como distancia la diferencia absoluta entre ese total y siete. Con tolerancia cero, aceptamos únicamente cuando el total simulado es exactamente siete.
El resumen K es suficiente para p en este modelo de ensayos independientes con probabilidad común. Por ello, aceptar la coincidencia exacta del total produce la misma posterior beta que el cálculo analítico. La configuración particular de qué agentes se activaron no contiene información adicional sobre p bajo estas hipótesis.
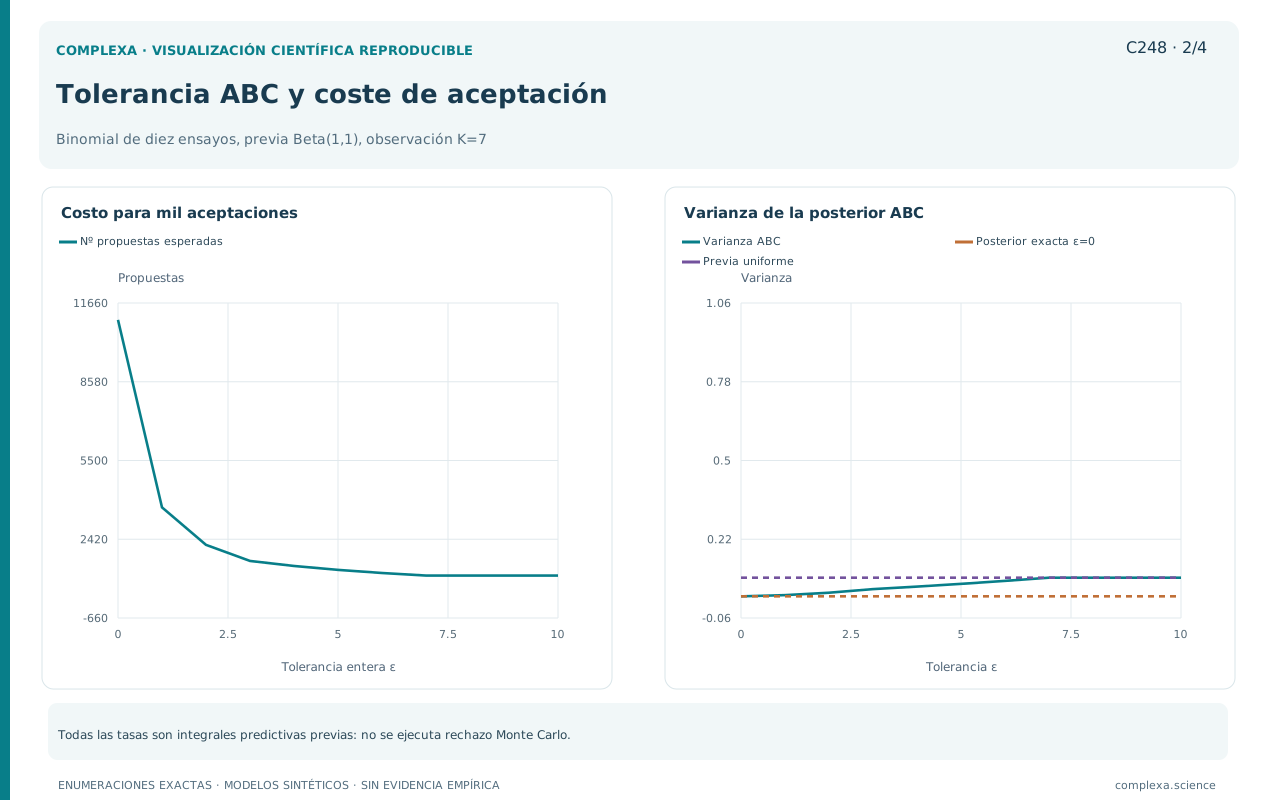
La probabilidad de aceptación puede calcularse integrando la binomial sobre la previa uniforme. Cada total entre cero y diez tiene probabilidad predictiva previa uno sobre once. Por tanto, el rechazo exacto acepta aproximadamente una propuesta de cada once en promedio.
La expresión no afirma que los totales sean equiprobables para un p fijo. Con p igual a un medio, los valores centrales son mucho más probables que los extremos. La uniformidad aparece después de promediar sobre la previa uniforme de p.
Este ejemplo permite comprobar un programa ABC comparando distribución, media, varianza y tasa de aceptación con valores exactos. Si el algoritmo falla aquí, no conviene atribuir discrepancias posteriores a la complejidad de los modelos de agentes.
La comprobación tampoco valida todas las aplicaciones futuras. Solo verifica la generación de parámetros, la simulación binomial, la aceptación y el resumen. Un simulador con redes, memoria u observación incompleta añadirá nuevas fuentes de error que necesitarán controles propios.
248.4. La tolerancia cambia la distribución, aunque no cambie la media
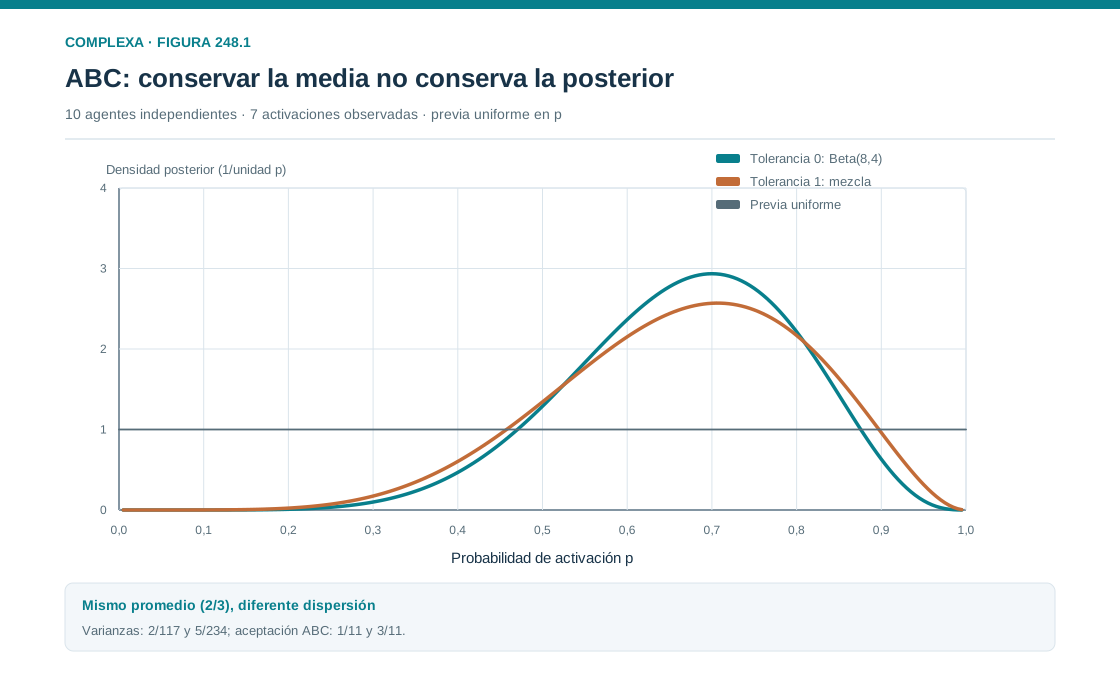
Aumentemos la tolerancia a una unidad. Ahora aceptamos totales simulados de seis, siete u ocho. La tasa de aceptación predictiva previa pasa de uno sobre once a tres sobre once. El procedimiento obtiene más muestras aceptadas por simulación, pero cambia su distribución objetivo.
Condicionada en un total de seis, la posterior es beta con parámetros siete y cinco; en un total de siete, ocho y cuatro; en uno de ocho, nueve y tres. Como los tres totales tienen la misma probabilidad predictiva previa, la posterior ABC es una mezcla de esas distribuciones con pesos iguales.
La media de la mezcla sigue siendo dos tercios. Las tres medias componentes son siete doceavos, ocho doceavos y nueve doceavos, cuyo promedio es ocho doceavos. Si solo comprobáramos la media, concluiríamos equivocadamente que aumentar la tolerancia no tuvo efecto.
La varianza de la mezcla es cinco dividido por doscientos treinta y cuatro, aproximadamente 0,021368. Es mayor que la varianza exacta. Para obtenerla debemos sumar la variación media dentro de los componentes y la variación entre sus medias.
El ejemplo no establece que la tolerancia siempre conserve la media o aumente todas las medidas de dispersión. Es una propiedad de esta observación, esta previa y esta región simétrica de aceptación. En otros casos puede desplazar el centro, modificar asimetría o mezclar regiones diferentes de parámetros.
Si la tolerancia fuera al menos siete, cualquier total entre cero y diez sería aceptado y la posterior ABC coincidiría con la previa, porque la observación ya no excluiría ninguna simulación. Este extremo muestra que la tolerancia limita cuánta información transmite la observación.
Reducir la tolerancia suele aumentar el costo de obtener un número dado de aceptaciones. Por eso conviene estudiar cuánto cambian las inferencias relevantes al reducirla y qué aproximación resulta aceptable para la pregunta. La estabilidad debe examinarse en distribuciones y predicciones, además de en un estimador puntual.
En este ejemplo, obtener mil aceptaciones requiere once mil propuestas en promedio con tolerancia cero, frente a unas tres mil seiscientas sesenta y siete con tolerancia uno. Son valores esperados sobre repeticiones independientes del procedimiento; una ejecución concreta puede apartarse de ellos. Esa reducción de costo viene acompañada del aumento de varianza posterior que acabamos de calcular.
La comparación entre tolerancias separa error de aproximación y error de Monte Carlo. Con infinitas simulaciones y tolerancia uno seguiríamos obteniendo la mezcla, distinta de la posterior exacta. Más cómputo aproxima mejor la distribución elegida sin alterar esa elección.
248.5. Elegir resúmenes que conserven información relevante
En un modelo de agentes, los datos pueden incluir trayectorias individuales, redes, ubicaciones y resultados colectivos. Comparar todos esos registros directamente puede ser costoso o difícil. Los resúmenes reducen dimensión, pero también pueden eliminar diferencias entre parámetros o mecanismos.
El ejemplo binomial usó un resumen suficiente. Esa propiedad es excepcionalmente conveniente y depende del modelo. Si cada agente tuviera una probabilidad distinta o existieran dependencias entre activaciones, el total podría dejar de conservar la información necesaria para las preguntas de interés.
En el modelo de recursos del capítulo anterior, la extracción total durante tres períodos fue ocho bajo tres reglas de reparto. Usar solo ese resumen no permitiría distinguir las reglas. Incorporar cantidades recibidas por agente o una distribución de asignaciones añadiría información que el total descarta.
En un modelo de segregación, una medida final de agrupamiento puede ser compatible con umbrales, restricciones de movilidad o inicializaciones diferentes. Los tiempos de mudanza y las proporciones de agentes bloqueados pueden ayudar a separarlos. La elección de resúmenes debe responder a diferencias previstas entre hipótesis.
Fearnhead y Prangle desarrollaron una construcción semiautomática de resúmenes orientada a inferencias sobre parámetros [2]. El resultado de optimalidad de las medias posteriores se formula para estimación bajo pérdida cuadrática y en el límite de tolerancia nula, bajo las condiciones del análisis. Después aproximan esas medias mediante simulaciones. Esto no establece suficiencia para toda la distribución posterior ni para comparar modelos sin comprobaciones adicionales.
Podemos seleccionar resúmenes mediante conocimiento del mecanismo, simulaciones exploratorias y evaluación de recuperación de parámetros. Hay que evitar ajustar repetidamente el procedimiento a una única observación hasta obtener la conclusión deseada. Conviene conservar datos o simulaciones independientes para comprobar desempeño.
Añadir muchos resúmenes tampoco garantiza una mejora. La región de aceptación puede volverse muy pequeña en dimensiones altas. Resúmenes redundantes pueden aumentar costo sin aportar información, mientras escalas distintas pueden hacer que una variable domine la distancia.
Una estrategia útil es preguntar qué parámetro afecta principalmente a cada resumen y qué compensaciones siguen siendo posibles. Si dos parámetros cambian todos los resúmenes de manera casi idéntica, la posterior puede mostrar una cresta de combinaciones compatibles. Esa estructura informa sobre identificación y debe conservarse en el resultado.
La suficiencia estadística, cuando puede demostrarse, da una garantía precisa. Cuando no puede, la evaluación debe ser empírica y orientada a la pregunta. La ausencia de una garantía no invalida todo uso de ABC, pero limita la interpretación de una aproximación aparentemente precisa.
248.6. Distancia, escala y modelo de observación
Una distancia euclidiana entre resúmenes mezcla sus unidades. Si un resumen se mide en miles y otro entre cero y uno, el primero puede dominar aunque el segundo sea científicamente decisivo. La estandarización es una decisión del análisis que debe declararse y justificarse.
Podemos dividir cada componente por una escala obtenida de simulaciones previas. También podemos usar una matriz de covarianza para considerar dependencia entre resúmenes. En ambos casos, la región de aceptación cambia y con ella la distribución ABC. Una escala estimada de manera inestable puede introducir distorsiones.
La tolerancia debe interpretarse respecto de esa distancia. Un valor de cero coma uno no tiene significado universal. Puede corresponder a una diferencia pequeña después de estandarización y a una discrepancia grande en unidades originales. Informar ejemplos de resúmenes aceptados y rechazados ayuda a hacer concreta la elección.
También hay que modelar la observación. Un simulador puede producir estados completos mientras los datos registran una muestra, con retrasos o errores. Para comparar correctamente, debemos transformar las salidas simuladas mediante un procedimiento de observación equivalente antes de calcular los resúmenes.
Supongamos que solo observamos la mitad de los agentes. Comparar el total observado con el total de toda la población simulada induciría una discrepancia sistemática. Podemos simular el mismo muestreo o definir un resumen corregido bajo supuestos explícitos. La elección afecta la variabilidad y debe incorporarse al análisis.
La tolerancia ABC no debe usarse silenciosamente como sustituto de todos los errores del modelo. Ruido de medición, discrepancia estructural y aproximación por aceptación son conceptos distintos. Una tolerancia amplia puede permitir ajustes aparentemente buenos mientras oculta que el simulador no reproduce características importantes.
Si simulamos varias réplicas por parámetro, debemos definir cómo las usamos. Promediar sus resúmenes y comparar el promedio con una sola observación reduce la variabilidad simulada y cambia el evento de aceptación; con él cambia también la distribución que se estima.
Las réplicas pueden usarse para estimar probabilidades de aceptación o dentro de algoritmos diseñados para ello. También pueden corresponder al diseño real si los datos incluyen varias realizaciones independientes. Lo esencial es que la distribución simulada corresponda al registro observado.
Una comparación adecuada empieza por describir el dato (quién fue observado, cuándo, con qué resolución y mediante qué selección). Sin esa información, un algoritmo técnicamente correcto puede calibrar un proceso de observación imaginario.
248.7. Previa, identificación y mecanismos alternativos
La distribución previa expresa qué parámetros se consideran plausibles antes de usar los datos del análisis. Debe respetar dominios, unidades y dependencias conocidas. Asignar previas independientes a parámetros relacionados puede generar combinaciones físicamente imposibles o difíciles de interpretar.
La simulación predictiva previa permite examinar esas consecuencias. Extraemos parámetros de la previa y observamos qué sistemas producen. Si casi todas las simulaciones son incompatibles con restricciones básicas, quizá la previa o la parametrización necesiten revisión antes de ajustar los datos.
Una posterior amplia puede indicar que los datos no distinguen valores de un parámetro. Una posterior estrecha puede reflejar información fuerte, pero también una previa restrictiva, un resumen que solo permite cierto ajuste o un modelo mal especificado.
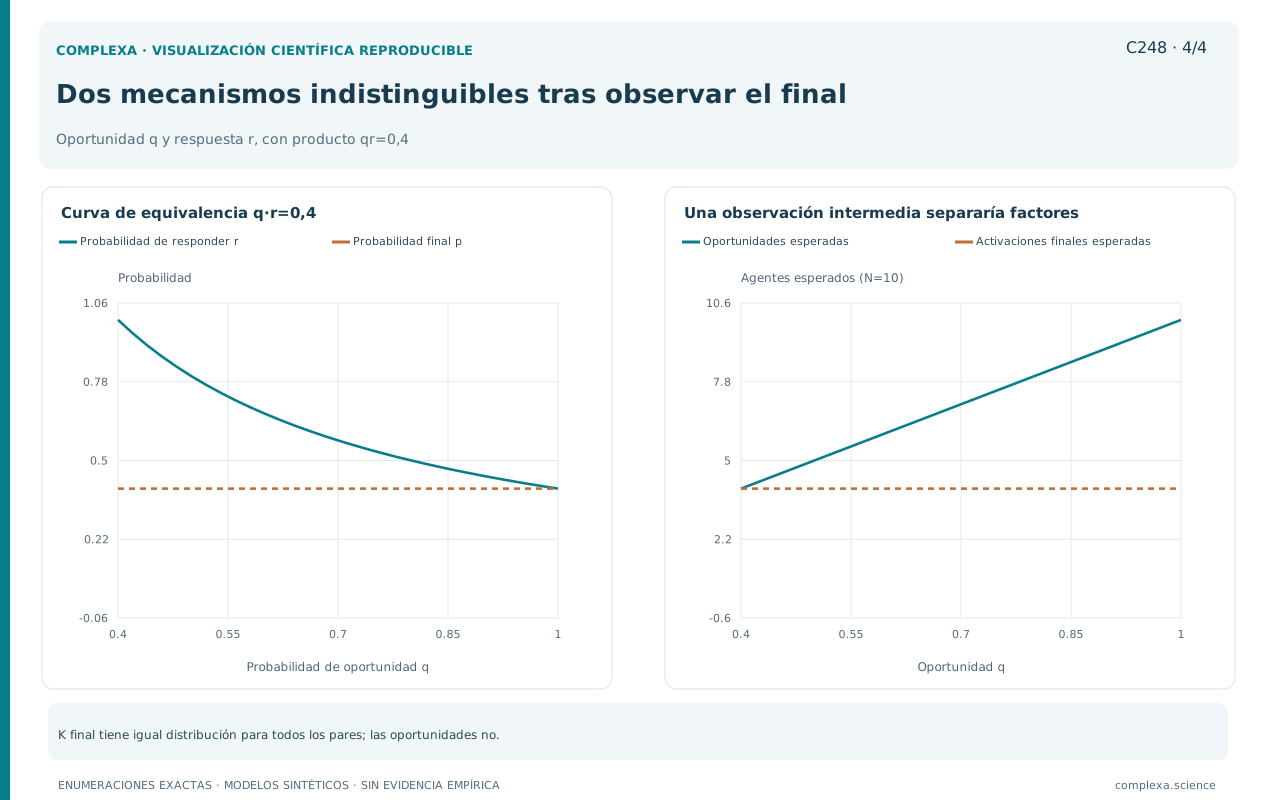
Consideremos una activación en dos etapas, en la que el agente recibe una oportunidad con probabilidad q y responde a ella con probabilidad r. Si ambas etapas se combinan de la forma indicada y solo observamos la activación final, su probabilidad es el producto q por r. Un total de activaciones informa sobre ese producto, pero no separa automáticamente sus factores.
Una población con oportunidad 0,8 y respuesta 0,5 produce la misma probabilidad final, 0,4, que otra con oportunidad 0,5 y respuesta 0,8. Bajo independencia entre agentes, todos los registros binarios finales tienen la misma distribución en ambos modelos. Ningún resumen de esos registros puede distinguirlos, porque la observación disponible ya omitió la etapa que lo permitiría.
Incluso una muestra muy grande puede precisar el producto sin identificar cada factor. ABC debería conservar el conjunto de combinaciones compatibles; elegir una de ellas sería arbitrario. Una previa restrictiva puede concentrar la distribución sobre ciertos factores, pero esa concentración procede parcialmente de información previa y debe reconocerse.
Registrar oportunidades además de activaciones cambia la situación. Podríamos estimar qué proporción recibe la oportunidad y qué proporción responde entre quienes la reciben, siempre que el muestreo y la observación sean adecuados. Así, un problema de calibración puede orientar una medición nueva; un algoritmo más costoso no recuperaría la etapa omitida.
La identificación práctica puede estudiarse generando datos sintéticos con parámetros conocidos y repitiendo la calibración. Si el procedimiento no recupera diferencias relevantes bajo condiciones favorables, será difícil interpretar una estimación puntual en datos reales. Debemos examinar distribuciones, cobertura y sesgos, sin exigir la recuperación exacta de cada valor en muestras pequeñas.
Comparar modelos introduce una dificultad adicional. Un resumen útil para estimar parámetros dentro de cada modelo puede perder información que distingue los modelos entre sí. Robert y colaboradores mostraron que esa pérdida puede comprometer probabilidades de modelos y no desaparecer al aumentar el esfuerzo computacional [3].
La selección de modelos mediante ABC puede seguir siendo viable, pero exige justificar los resúmenes para la comparación, evaluar el desempeño y reconocer qué diferencias se han descartado. La suficiencia dentro de cada modelo no garantiza suficiencia entre modelos.
Podemos comenzar con contrastes predictivos más concretos. Si dos mecanismos ajustan el agrupamiento final, preguntamos cómo responden a una perturbación o qué tiempos de llegada predicen. Una observación que los separa puede ser más útil que una probabilidad de modelo calculada sobre resúmenes poco informativos.
También debemos considerar que todos los modelos comparados pueden ser inadecuados. Elegir el que mejor reproduce ciertos resúmenes no establece que explique correctamente el sistema. La evaluación predictiva y el análisis de discrepancias siguen siendo necesarios después de la calibración.
La conclusión debe conservar la estructura de incertidumbre. Si varias combinaciones de parámetros o mecanismos son compatibles, podemos informar ese conjunto y sus predicciones. Reducirlo a una sola historia por conveniencia narrativa eliminaría información que el análisis ha producido.
248.8. Mejorar eficiencia sin perder la distribución objetivo
El rechazo desde la previa puede desperdiciar muchas simulaciones cuando la región compatible es pequeña. Una alternativa propone parámetros cerca de valores previamente aceptados. Esa estrategia puede aumentar eficiencia, pero cambia la distribución de propuestas y exige corregir la ponderación.
Si proponemos desde una densidad q y aplicamos el mismo criterio de simulación y aceptación, las propuestas aceptadas quedan ponderadas por q. Bajo condiciones de soporte apropiadas, pesos proporcionales a la previa dividida por q permiten recuperar la ponderación de la previa deseada.
Los métodos secuenciales usan poblaciones de parámetros y tolerancias progresivamente menores. Pueden construir una propuesta como mezcla de perturbaciones alrededor de partículas anteriores. En ese caso, los pesos deben usar la densidad completa de la mezcla, aunque cada propuesta se haya generado desde un solo componente.
La implementación requiere controlar degeneración de pesos, diversidad de partículas y soporte. Una población aparentemente numerosa puede concentrar casi todo el peso en pocos parámetros. Contar partículas sin examinar los pesos puede exagerar la información efectiva de la aproximación.
Los ajustes por regresión son otra familia de mejoras. Buscan corregir la relación entre parámetros y discrepancias de resúmenes dentro de la región aceptada. Su utilidad depende de supuestos locales y puede verse afectada por no linealidad, límites del parámetro o heterogeneidad de varianza.
Ninguna mejora algorítmica recupera automáticamente información eliminada por los resúmenes. Un método más eficiente puede estimar con gran precisión la posterior condicionada en una representación insuficiente. Por eso debemos evaluar por separado costo computacional y pertinencia estadística.
También podemos usar un modelo sustituto para aproximar salidas o probabilidades de aceptación. Entonces aparece una fuente adicional de error. Debemos comprobar el sustituto en la región relevante y evitar tratar su predicción como si fuera una simulación exacta del modelo original.
El criterio práctico es empezar con un caso pequeño verificable, comprobar el objetivo y después introducir aceleraciones. Una mejora que produce resultados distintos puede estar corrigiendo una aproximación o cambiando inadvertidamente la distribución. La comparación con el ejemplo binomial ayuda a distinguir ambas posibilidades.
La documentación debe identificar propuestas, tolerancias, pesos, número de simulaciones y criterios de adaptación. Informar únicamente el número final de partículas aceptadas no permite reconstruir el procedimiento ni evaluar su eficiencia.
248.9. Evaluación posterior y recuperación de información
Después de obtener una posterior aproximada, generamos nuevas simulaciones a partir de sus parámetros y examinamos sus predicciones. La comparación puede incluir los resúmenes usados para calibrar y otras características reservadas para evaluación. Las segundas son una comprobación más exigente de la estructura del modelo.
Reproducir los resúmenes de calibración es necesario para muchos objetivos, pero parcialmente esperado por construcción. Si aceptamos parámetros porque producen cierta media, observar después medias cercanas no es una validación independiente. Debemos buscar discrepancias en distribuciones, tiempos o relaciones no impuestas directamente.
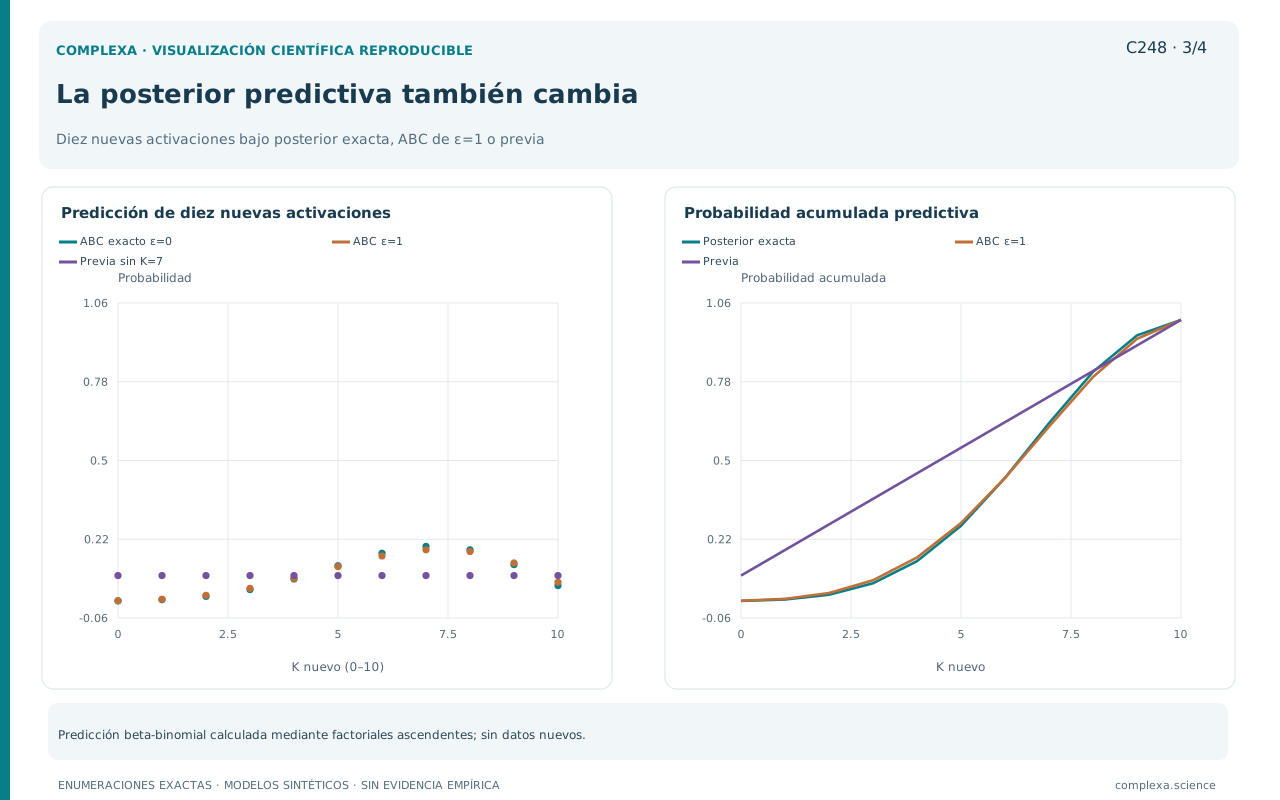
En el ejemplo binomial, podemos verificar la posterior analítica, la tasa de aceptación y la mezcla que aparece con tolerancia uno. También podemos simular nuevos grupos de diez agentes para estudiar la distribución predictiva de activaciones. Esa predicción incorpora incertidumbre sobre p y variación binomial condicional.
Con la posterior exacta beta de parámetros ocho y cuatro, el número esperado de activaciones en un grupo nuevo es veinte tercios. Su varianza predictiva es cuatrocientos cuarenta dividido por ciento diecisiete, aproximadamente 3,7607. Podemos derivarla sumando la varianza binomial media a la variación de la media condicional entre valores posibles de p.
Si sustituyéramos p por su media posterior y simuláramos siempre con ese valor fijo, obtendríamos la misma esperanza, pero una varianza de veinte novenos, aproximadamente 2,2222. La diferencia procede de haber eliminado incertidumbre sobre el parámetro. Usar una estimación puntual puede producir predicciones demasiado estrechas incluso cuando esa estimación central es correcta.
Este cálculo añade una comprobación independiente de la distribución de parámetros aceptados. Una implementación puede informar correctamente su media y, sin embargo, generar predicciones con un valor fijo de p, sin extraer parámetros de la posterior. Comparar ambas varianzas permite detectar esa sustitución y precisar qué incertidumbre conserva la salida predictiva.
En un modelo de agentes complejo, conviene repetir la calibración con datos sintéticos generados en distintas regiones de parámetros. La recuperación puede ser buena en unas y débil en otras.
La sensibilidad a la previa, a los resúmenes y a la tolerancia debe examinarse respecto de las conclusiones relevantes. Si una predicción se mantiene mientras los parámetros cambian, puede estar mejor identificada que el mecanismo. Esa distinción permite informar qué parte del resultado es más estable.
La incertidumbre de Monte Carlo requiere suficientes aceptaciones y, en métodos ponderados, diversidad efectiva. Repetir el algoritmo con aleatoriedad independiente puede revelar inestabilidad computacional. Sin embargo, la coincidencia entre repeticiones no elimina sesgo por tolerancia o por especificación.
También debemos conservar simulaciones rechazadas cuando sean útiles para diagnosticar discrepancias. Si ningún parámetro produce simultáneamente varios patrones observados, aumentar la tolerancia puede ocultar un problema estructural. Examinar qué combinaciones fallan ayuda a formular una revisión del modelo.
Una auditoría final comprueba identidad de datos, código del simulador, distribución previa, procedimiento de observación y definición de distancia. Las ecuaciones de la posterior objetivo deben corresponder al algoritmo ejecutado. Esa correspondencia es lo que permite interpretar las muestras aceptadas como inferencia; sin ella, son solo un conjunto de escenarios cercanos.
248.10. Calibrar sin confundir ajuste y explicación
ABC permite hacer inferencia mediante simulación cuando evaluar una verosimilitud resulta difícil. Su resultado depende de la previa, el simulador, los resúmenes, la distancia y la tolerancia. Cada componente debe aparecer en la explicación de lo que se ha estimado.
El ejemplo exacto mostró que aumentar tolerancia puede conservar una media y cambiar la distribución. También mostró que más aceptaciones no significan automáticamente mayor fidelidad a la posterior original. La eficiencia y la aproximación responden a criterios diferentes.
En modelos de agentes, los resúmenes deben conservar las diferencias relevantes entre parámetros y mecanismos. Los totales colectivos pueden ocultar distribuciones individuales y los patrones finales, trayectorias. La calibración debe apoyarse en observaciones capaces de restringir esas alternativas.
Una posterior concentrada necesita evidencia adicional para sostener una explicación causal; la evaluación predictiva, los datos sintéticos y la comparación de mecanismos permiten examinar su alcance. Cuando la información no distingue alternativas, conservar esa incertidumbre es parte del resultado científico.
El siguiente capítulo abordará el protocolo ODD. Su función será hacer explícitos los componentes del modelo para que otra persona pueda comprender qué se simuló y reproducir el mecanismo. Una inferencia sofisticada pierde valor si las reglas y convenciones que generan sus datos artificiales permanecen ambiguas.
Referencias
- Beaumont, M. A., Zhang, W. y Balding, D. J. (2002). Approximate Bayesian computation in population genetics. Genetics, 162(4), 2025–2035. https://doi.org/10.1093/genetics/162.4.2025
- Fearnhead, P. y Prangle, D. (2012). Constructing summary statistics for approximate Bayesian computation: Semi-automatic approximate Bayesian computation. Journal of the Royal Statistical Society: Series B, 74(3), 419–474. https://doi.org/10.1111/j.1467-9868.2011.01010.x
- Robert, C. P., Cornuet, J.-M., Marin, J.-M. y Pillai, N. S. (2011). Lack of confidence in approximate Bayesian computation model choice. Proceedings of the National Academy of Sciences, 108(37), 15112–15117. https://doi.org/10.1073/pnas.1102900108