Módulo 25. Autómatas celulares y modelos basados en agentes
242.1. Representar individuos para estudiar un sistema
Un modelo basado en agentes describe entidades que tienen estados propios e interactúan según reglas explícitas. Las entidades pueden representar organismos, hogares, empresas, vehículos o componentes de un sistema artificial. La palabra agente identifica una unidad de la representación; no implica conciencia, autonomía moral ni capacidad de deliberación. Una entidad que responde de manera determinista a dos vecinos también puede ser un agente.
El enfoque interesa cuando la identidad de las unidades, sus diferencias y sus relaciones influyen en la evolución colectiva. En algunos problemas basta una ecuación para una media; en otros, necesitamos saber quién encuentra a quién, quién conserva memoria o dónde se acumula un recurso. La elección entre representaciones depende de la pregunta y de la información que cada una conserva.
La revisión de Bonabeau presenta los modelos basados en agentes como una forma de estudiar consecuencias colectivas de conductas e interacciones individuales [1]. Ese principio no exige reproducir todos los detalles del sistema. Un modelo útil selecciona las diferencias relevantes y descarta otras. Añadir características individuales sin una función clara puede aumentar el costo de implementación sin mejorar la explicación.
La relación con los autómatas celulares es estrecha, pero las fronteras entre familias no son absolutas. Podemos interpretar una celda como una entidad que interactúa con posiciones vecinas. En muchos modelos de agentes, sin embargo, las entidades se desplazan, mantienen identidades persistentes, cambian sus conexiones o actúan en tiempos diferentes. La cuadrícula fija deja de ser una condición necesaria.
La elección tampoco establece una jerarquía de realismo. Un modelo con millones de agentes puede describir mal una decisión elemental; un modelo agregado puede predecir adecuadamente una cantidad de interés. Conviene preguntar qué diferencias observables produce cada representación y cuánto cuestan sus supuestos. Contar los objetos simulados no basta para juzgar la calidad del conocimiento.
En este capítulo usaremos seis agentes conectados en un anillo. Cada uno puede activarse después de observar a sus vecinos. Algunos necesitan un vecino activo; otros necesitan dos. Aun con esa descripción mínima veremos que el promedio de los umbrales no determina el resultado y que una misma composición poblacional puede generar trayectorias distintas.
El ejemplo es una construcción matemática para aprender a razonar sobre mecanismos. No describe una población observada ni permite calcular la difusión de una conducta concreta. Su ventaja es que podemos inspeccionar todas las transiciones, enumerar todas las distribuciones que estudiaremos y separar los resultados de la regla de las afirmaciones sobre el mundo.
242.2. Qué debe contener una especificación
Una especificación comienza identificando las entidades y sus estados. Un agente puede tener atributos fijos, como un umbral asignado al inicio, y variables dinámicas, como su posición o su decisión actual. Debemos distinguir ambos tipos porque responden a preguntas diferentes. Cambiar un estado durante la simulación no equivale a cambiar la distribución inicial de un atributo.
Después se describe el entorno. Puede ser una red, una cuadrícula, un espacio continuo, una lista de mercados o una combinación de estructuras. El entorno determina qué interacciones son posibles y qué información está disponible. Si una entidad solo observa sus conexiones inmediatas, no debemos permitir que su regla use una media global salvo que un mecanismo explícito le comunique esa información.
También necesitamos reglas de transición. Expresiones como «el agente busca una opción conveniente» o «imita a sus contactos» son insuficientes para reproducir una simulación. Debemos precisar qué opciones considera, qué medida usa, cómo resuelve empates y qué ocurre cuando ninguna alternativa cumple sus condiciones. Cada excepción omitida puede convertirse en una decisión silenciosa del programador.
El calendario forma parte de la especificación. Puede haber pasos simultáneos, activaciones en un orden fijo, selección aleatoria de un agente o eventos con tiempos continuos. Dos programas con las mismas reglas individuales pueden producir procesos diferentes si uno permite reaccionar de inmediato a los cambios ajenos y el otro obliga a esperar al paso siguiente.
La inicialización determina desde dónde comienza el proceso. Incluye estados, atributos, conexiones y recursos. Si hay azar, debemos indicar sus distribuciones y dependencias. Asignar por separado ingreso y localización no equivale a generar localizaciones condicionadas por ingreso. Ambas inicializaciones pueden tener los mismos histogramas marginales y organizar de manera distinta las oportunidades de interacción.
Finalmente, hay que definir lo que se medirá. Podemos observar estados individuales, tiempos de espera, tamaños de grupos, concentración espacial o una media poblacional. El observador puede disponer de información que los agentes no tienen, pero esa ventaja debe quedar fuera de sus reglas de decisión. De lo contrario, una medida destinada al análisis termina actuando sobre la dinámica.
Una especificación reproducible puede leerse como un contrato que, dadas las entradas y las convenciones, indica qué salidas son posibles y cómo se generan. El código implementa ese contrato, pero no lo reemplaza completamente. El lector necesita entender por qué existe cada operación y qué significa, incluso cuando no domina el lenguaje de programación.
La prueba práctica es imaginar una segunda implementación independiente. Si para escribirla hubiera que preguntar por fronteras, desempates, disponibilidad de información o criterios de detención, todavía faltan decisiones. Resolverlas antes de interpretar resultados evita atribuir significado científico a elecciones accidentales.
242.3. Por qué la heterogeneidad no se reduce a una media
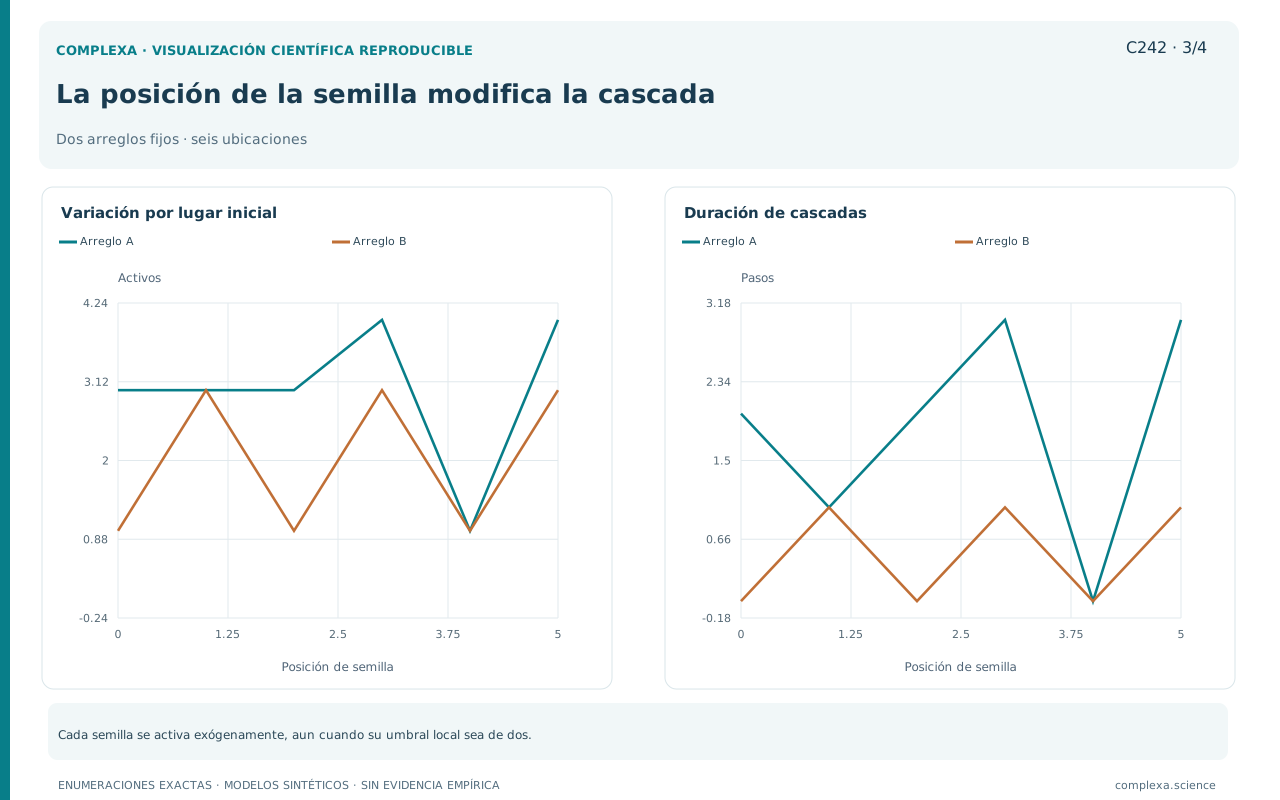
Supongamos que una respuesta individual depende de un atributo mediante una función no lineal. En general, evaluar esa función en el atributo promedio no produce la respuesta promedio de la población. La diferencia puede surgir incluso sin interacción. Con interacción, además, importa cómo se distribuyen los atributos entre posiciones y relaciones.
Un umbral es un ejemplo directo. Si algunos agentes reaccionan después de un contacto y otros después de dos, sustituirlos por un agente cuyo umbral es uno y medio cambia la regla efectiva cuando el número de contactos es entero. Ese agente representativo necesitaría dos contactos. La sustitución elimina precisamente a quienes respondían a una sola exposición.
No hay una prohibición general contra los agentes representativos. Pueden ser aproximaciones útiles si reproducen las cantidades y los regímenes de interés. Su validez, sin embargo, no puede derivarse únicamente de que conserven una media. Necesitamos comparar sus predicciones con las de una representación que mantenga las diferencias cuya importancia está en discusión.
La varianza tampoco contiene toda la heterogeneidad relevante. Dos poblaciones pueden compartir media, varianza e incluso el histograma completo de atributos, pero colocar sus tipos en posiciones distintas. Cuando la interacción es local, esa organización modifica las secuencias de influencia. La descripción adecuada puede requerir correlaciones entre atributos y conexiones, o entre atributos de agentes vecinos.
Pensemos en tres agentes que responden rápidamente y tres que exigen mayor exposición. Si los primeros están agrupados, una activación puede recorrer su grupo. Si cada uno está separado por agentes más exigentes, la misma activación puede detenerse. La proporción de tipos se mantiene y cambia el acceso de cada tipo a los estímulos que necesita.
También importa quién recibe la perturbación inicial. Un resultado puede depender de iniciar el proceso en un agente central, periférico o perteneciente a cierto tipo. Al estudiar el efecto de la composición poblacional no debemos confundirlo con el de elegir semillas distintas. La inicialización puede controlarse o variarse sistemáticamente, pero debe aparecer en la comparación.
En aplicaciones empíricas, la heterogeneidad relevante no siempre coincide con categorías disponibles en los datos. Dos personas clasificadas en el mismo grupo pueden tener recursos y exposiciones diferentes. El modelo debe justificar por qué usa ciertas diferencias y cómo trata las que no observa. Una clasificación conveniente para almacenar datos no es automáticamente una clasificación de mecanismos.
Podemos organizar el análisis mediante comparaciones sucesivas (conservar individuos, homogeneizar atributos, redistribuir atributos y modificar conexiones). Cada comparación elimina una dimensión diferente. Si los resultados cambian, sabremos qué información perdió la simplificación. Si permanecen estables dentro del dominio estudiado, tendremos evidencia concreta para una representación más económica.
242.4. Seis agentes y dos distribuciones de umbrales
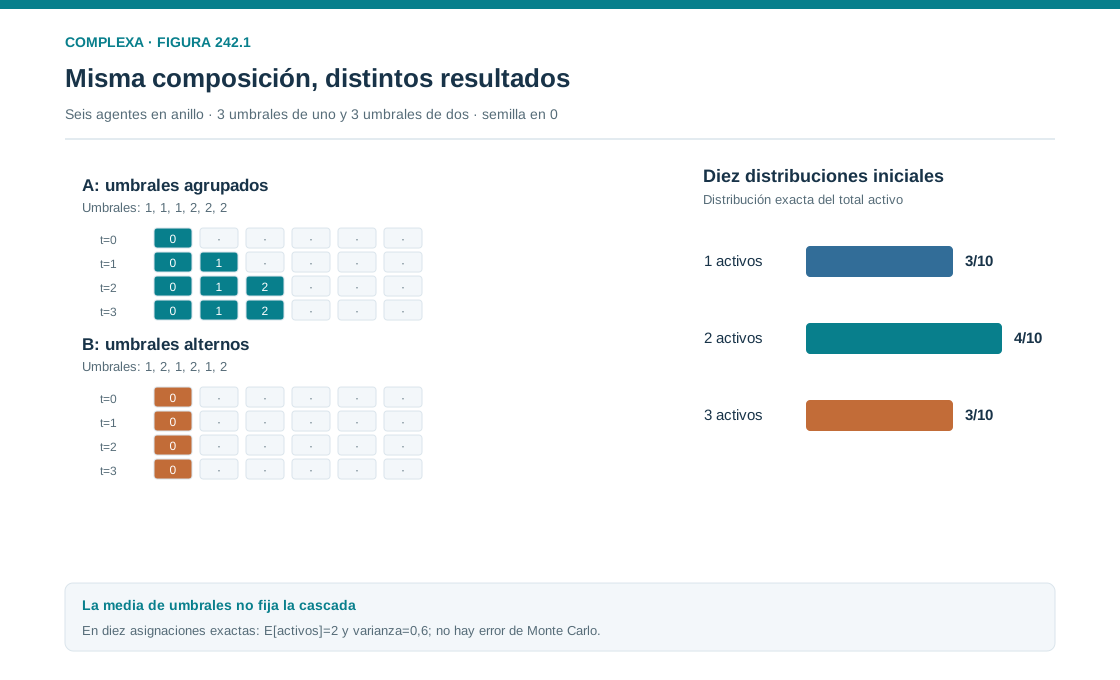
Numeremos seis posiciones desde cero hasta cinco y conectémoslas en un anillo. Cada agente tiene dos vecinos, el anterior y el siguiente, con cierre entre las posiciones cinco y cero. Su estado puede ser inactivo o activo. Al inicio solo está activo el agente cero. Quien se activa permanece activo durante todo el experimento.
Cada agente tiene un umbral fijo de uno o dos vecinos activos. Todas las decisiones se actualizan simultáneamente con la configuración anterior. Si llamamos a al estado y k al umbral, la regla se escribe
Los índices se interpretan módulo seis y el símbolo de disyunción expresa que basta con haber estado activo o cumplir ahora el umbral. Esta forma garantiza la irreversibilidad. No hay recuperación, cansancio ni abandono. Agregar cualquiera de esos procesos produciría otra dinámica y requeriría una nueva especificación.
Comparemos dos distribuciones. En la distribución A, los umbrales son uno, uno, uno, dos, dos y dos. En la distribución B, son uno, dos, uno, dos, uno y dos. Ambas contienen tres agentes de cada tipo, tienen umbral medio uno y medio y mantienen el mismo anillo. En ambas, el agente inicialmente activo tiene umbral uno.
Con la distribución A, la configuración 100000 pasa a 110000 en el primer paso, a 111000 en el segundo y ya no cambia en el tercero. Con la distribución B, la configuración 100000 se repite en los tres pasos.
En A, el agente uno observa al agente cero activo y satisface su umbral en el primer paso. El agente dos todavía no observa ningún vecino activo en la configuración inicial, por lo que debe esperar. En el segundo paso observa al agente uno y se activa. Los agentes tres y cinco solo tienen un vecino activo y requieren dos; el agente cuatro no encuentra vecinos activos.
En B, los dos vecinos de la semilla tienen umbral dos. Cada uno observa solo un vecino activo, de modo que ninguno cambia. La configuración inicial ya es un punto fijo. Los agentes con umbral uno situados más lejos no reciben activación porque las posiciones intermedias no la transmiten.
La diferencia final es de tres agentes activos frente a uno y se deriva directamente de las reglas, sin intervención del azar ni de ajustes numéricos. El ejemplo establece una dependencia concreta de la distribución espacial bajo este proceso y esta inicialización. Extenderla a cualquier red, como si agrupar tipos facilitara siempre la difusión, requeriría otro argumento.
El cálculo local permite entender el bloqueo. Una frontera formada por agentes que exigen dos vecinos activos puede detener un frente que llega desde un solo lado. Para superarla haría falta otra exposición, otra semilla o una regla distinta. La descripción causal del modelo debe mencionar esa condición, además de constatar que apareció un grupo activo.
242.5. Enumerar la incertidumbre de la distribución inicial
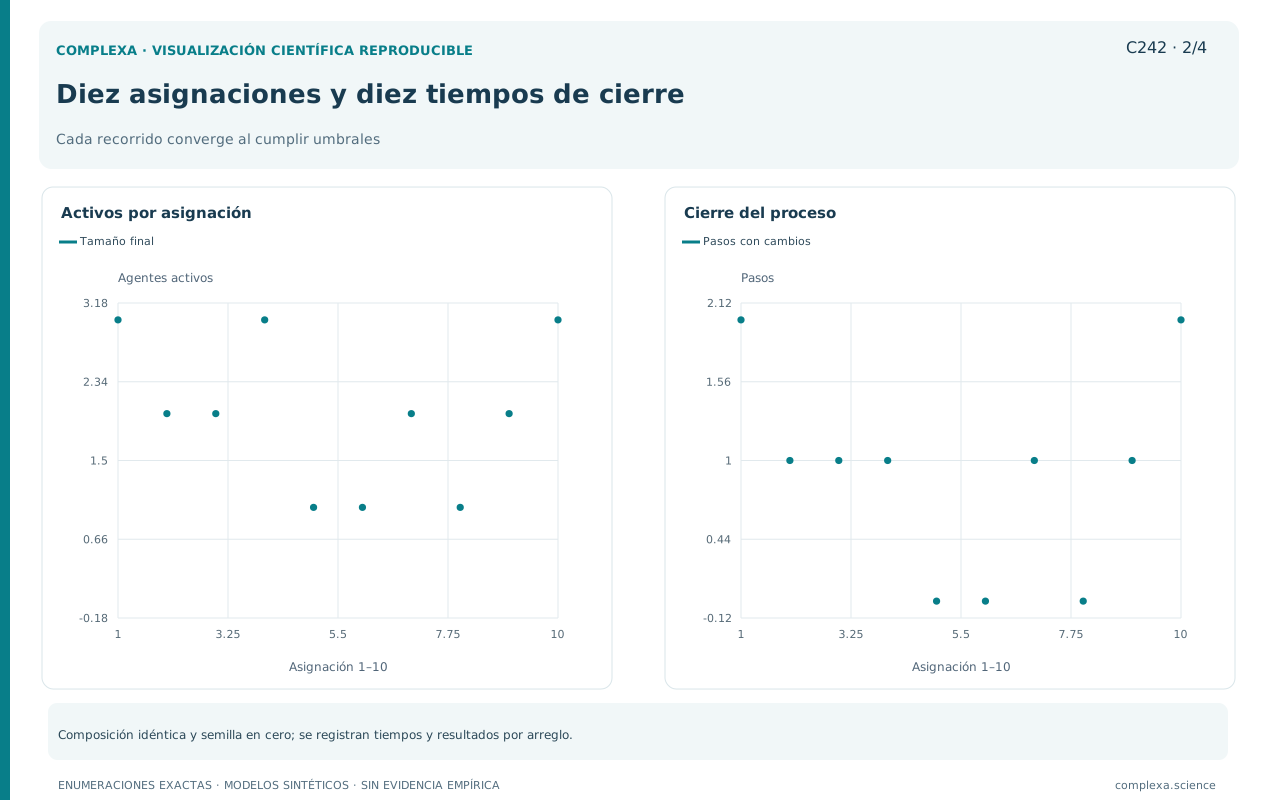
Ahora conservemos al agente cero como semilla de umbral uno y asignemos los otros dos umbrales de valor uno entre las cinco posiciones restantes. Hay diez maneras de elegir esas dos posiciones. Podemos estudiarlas todas sin recurrir a una muestra aleatoria. Las tres posiciones no elegidas reciben umbral dos y el estado inicial sigue siendo el mismo.
Supongamos, como parte del experimento, que las diez asignaciones son equiprobables. Esta distribución uniforme es una decisión matemática y no afirma que una población real organice sus atributos de esa manera. Permite definir una incertidumbre específica y calcular exactamente la distribución de una salida, el número final de agentes activos. Ese número es uno en tres asignaciones, dos en cuatro y tres en las tres restantes, con probabilidades 0,3; 0,4 y 0,3.
El número esperado de agentes activos es dos y su varianza es cero coma seis. La esperanza es un promedio entre configuraciones iniciales posibles. No describe una trayectoria adicional en la que haya dos agentes activos en cada realización. Tres de las asignaciones se detienen con uno y otras tres alcanzan tres.
Podemos comprobar estas frecuencias clasificando los pares de posiciones con umbral uno. Si ninguno de esos agentes permite iniciar una cadena desde la semilla, el proceso queda bloqueado. Si solo uno puede incorporarse sin abrir un paso adicional, el resultado es dos. Si los dos pueden alcanzarse, por el mismo lado o por lados distintos, el resultado es tres.
Esta enumeración elimina el error de Monte Carlo para el experimento definido. La incertidumbre sobre la red, los umbrales o la irreversibilidad permanece. Conocer exactamente una distribución simulada no significa conocer exactamente el proceso modelado.
Si en lugar de diez configuraciones hubiera millones, podríamos muestrear asignaciones y estimar las mismas cantidades. Entonces informaríamos cuántas realizaciones independientes usamos y cómo calculamos su incertidumbre. Repetir una trayectoria determinista con la misma inicialización no añadiría información sobre la variabilidad entre asignaciones.
El ejemplo también permite auditar una implementación grande. Antes de usarla en redes extensas, podemos exigir que reproduzca estos diez resultados pequeños. La prueba verifica una parte concreta del código (vecindad circular, umbrales, actualización simultánea y detención en puntos fijos) y deja sin validar los componentes que todavía no intervienen, como el movimiento o el aprendizaje.
Conviene conservar los resultados por configuración, además del histograma. Si dos implementaciones coinciden en la media pero asignan resultados diferentes a cada entrada, puede haber errores que se compensan. La comparación detallada es una verificación más fuerte que un único número agregado.
242.6. Generar un patrón no identifica su causa real
En la perspectiva generativa discutida por Epstein, un modelo puede mostrar cómo las interacciones entre unidades producen una organización colectiva [2]. Esa demostración establece una posibilidad explicativa; bajo determinadas condiciones, las reglas bastan para generar un resultado. Pasar de esa posibilidad a una explicación empírica requiere contrastar las condiciones y comparar mecanismos alternativos.
Nuestro anillo genera agrupaciones activas sin ninguna instrucción que ordene crear un grupo de tres. Sin embargo, la irreversibilidad, la red y los umbrales ya restringen mucho los resultados. La organización surge de una estructura especificada localmente. Reconocerlo evita presentar toda consecuencia no evidente como una sorpresa inexplicable.
Podemos preguntar qué papel tiene cada componente mediante intervenciones sobre el modelo. En la distribución A, eliminar la conexión entre cero y uno bloquea la activación inicial, porque el agente uno deja de observar a la semilla y el agente cinco todavía necesita dos vecinos activos. Esta comparación identifica una dependencia de la trayectoria respecto de esa conexión en el sistema construido.
La intervención no prueba que una conexión equivalente sea decisiva en una población real. Para trasladar la conclusión necesitamos justificar la correspondencia entre agentes, vínculos y exposiciones. También debemos comprobar que eliminar un vínculo no modifica simultáneamente otras condiciones relevantes, como acceso a información externa o redistribución de recursos.
Una prueba complementaria mantiene la red y modifica los umbrales; otra conserva los umbrales y cambia la semilla. Estas intervenciones responden a preguntas diferentes. Si hacemos todos los cambios al mismo tiempo, quizá obtengamos un contraste grande, pero no podremos atribuirlo a un componente particular o a una interacción entre componentes.
La palabra emergencia es útil cuando señala una propiedad colectiva que exige considerar la organización de muchas unidades. Se vuelve poco informativa si sustituye la descripción del mecanismo. En nuestro ejemplo podemos explicar qué agente cambia, qué información usa y por qué el proceso se detiene. Esa explicación local y temporal es más precisa que decir únicamente que apareció una estructura emergente.
También debemos distinguir patrones posibles, frecuentes y robustos. Que una configuración inicial produzca cierto resultado demuestra posibilidad. Que muchas configuraciones lo produzcan bajo una distribución definida indica frecuencia. Que el resultado persista al variar supuestos relevantes indica robustez dentro del conjunto examinado. Ninguna de las tres afirmaciones reemplaza a las otras.
La comparación con mecanismos rivales es especialmente necesaria cuando el observable es sencillo. Una media, una curva suave o una imagen agrupada pueden surgir de procesos muy diferentes. Cuanto más pobre sea la descripción del patrón, mayor será el conjunto de explicaciones compatibles. La tarea es encontrar observaciones que separen esas explicaciones.
242.7. Tiempo, información y fuentes de variación
En nuestro experimento, cada paso es una oportunidad simultánea de revisar a los vecinos. No equivale necesariamente a un minuto, un día o una conversación. Para asignarle una duración física necesitaríamos información sobre las oportunidades reales de interacción. Elegir una unidad temporal por conveniencia gráfica no establece esa correspondencia.
La actualización simultánea impide que una activación recorra varias conexiones dentro del mismo paso. El agente dos de la distribución A espera hasta el segundo paso porque no puede usar el estado nuevo del agente uno antes de que termine el primero. Un recorrido secuencial que modificara la lista sobre sí misma podría activar a ambos en una sola pasada.
En este proceso la activación es irreversible y la condición de activación es monótona (añadir agentes activos nunca impide que otro cumpla su umbral). Con oportunidades repetidas para todos los agentes, una actualización asincrónica justa alcanza el mismo cierre de activación que la actualización simultánea, aunque los tiempos registrados pueden diferir. Esta propiedad no se extiende automáticamente a reglas con abandono o competencia.
El argumento es constructivo. Toda activación simultánea acabará siendo posible bajo el calendario justo cuando sus apoyos ya estén activos. A la inversa, una activación asincrónica solo usa apoyos que también pertenecen al cierre generado por la regla. La irreversibilidad mantiene esos apoyos disponibles. Si alguna de estas condiciones falla, el razonamiento puede dejar de valer.
Un calendario es justo si ningún agente queda excluido indefinidamente de la posibilidad de actualizarse. No exige que todos actúen exactamente el mismo número de veces en cada intervalo. En una simulación finita debemos especificar además cuánto esperamos y cómo comprobamos que el estado ya no puede cambiar. La ausencia de cambios durante una selección parcial no garantiza un punto fijo.
Las fuentes de variación deben nombrarse por separado. Podemos tener incertidumbre en los atributos iniciales, azar en los encuentros, errores de observación o cambios exógenos del entorno. Un único número aleatorio en la regla no recoge a la vez todas esas fuentes. Cada una produce dependencias temporales y entre agentes que pueden afectar los resultados.
La aleatoriedad tampoco es un requisito de los modelos basados en agentes. Nuestro ejemplo es determinista una vez fijada la distribución de umbrales. La distribución de resultados aparece al variar esa entrada bajo una ley explícita. En otro modelo, incluso la misma entrada podría producir trayectorias distintas debido a encuentros aleatorios.
Para interpretar un promedio necesitamos saber sobre qué se promedia. Puede ser sobre agentes de una realización, sobre tiempos de una trayectoria o sobre realizaciones independientes. Esas operaciones no son intercambiables. Una población heterogénea observada una vez no equivale necesariamente a muchas poblaciones homogéneas generadas en ocasiones diferentes.
242.8. Calibrar requiere más de un resultado agregado
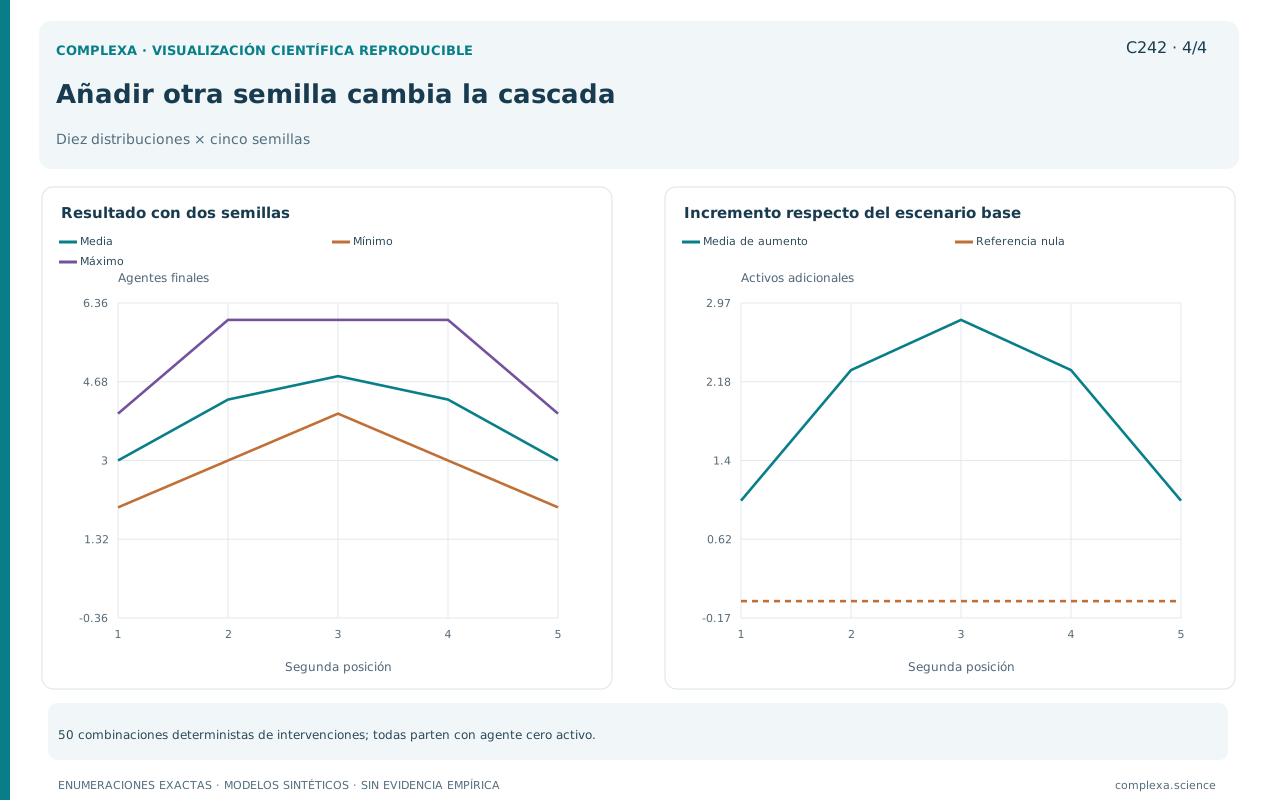
Imaginemos que solo observamos un promedio final de dos agentes activos. Nuestro modelo de umbrales lo reproduce bajo las diez asignaciones equiprobables. Lo mismo haría un procedimiento que activara siempre a la semilla y a exactamente otro agente, sin contagio ni interacción local. El promedio compartido no permite distinguir ambos mecanismos.
En la distribución sí hay una diferencia. El procedimiento alternativo tendría siempre dos activos y, por tanto, varianza nula. El modelo de umbrales produce uno, dos o tres. Observar variabilidad entre realizaciones comparables podría ayudar a separarlos, siempre que la medición y las fuentes de variación estén representadas de manera consistente.
Los tiempos son otra posible diferencia. En la distribución A, las activaciones ocurren en dos pasos sucesivos. Un modelo que asignara el estado final instantáneamente podría coincidir en el total y fallar en la trayectoria. Las conexiones entre agentes activos, la localización de las fronteras y la respuesta a una semilla adicional también pueden imponer restricciones.
La propuesta de modelización orientada a patrones de Grimm y colaboradores usa varios patrones para diseñar y contrastar modelos de agentes [3]. Su utilidad metodológica es exigir que una explicación responda a más de una característica del sistema. En nuestro ejemplo, combinar distribución final, tiempos y estructura local sería más informativo que ajustar únicamente la media.
Más patrones no garantizan identificación. Dos modelos pueden coincidir en todas las medidas disponibles, o los datos pueden ser demasiado ruidosos para separarlos. Medidas aparentemente diferentes pueden, además, contener información redundante. Debemos estudiar qué predicciones nuevas añade cada observable y qué mecanismos deja compatibles.
También hay riesgo de usar todos los datos para construir el modelo y después presentar su reproducción como una prueba independiente. Conviene distinguir la información usada para diseñar reglas, la usada para estimar parámetros y las observaciones reservadas para la evaluación. La separación puede ser temporal, espacial o experimental, según el problema.
Cuando no hay datos suficientes, el modelo puede conservar valor exploratorio. Podemos usarlo para localizar dependencias, construir escenarios o diseñar mediciones que discriminen hipótesis. Cambia entonces el alcance de la afirmación final, que se limita a describir consecuencias de supuestos y necesidades de información.
La calibración debe incluir el procedimiento de observación. Si una base de datos omite agentes aislados o registra activación con retraso, la comparación correcta no enfrenta directamente el estado interno completo de la simulación con el registro incompleto. Debemos representar, cuando sea relevante, cómo el sistema observado se transforma en datos.
242.9. Comprobar el modelo antes de ampliarlo
La primera comprobación es que los estados permanezcan dentro de su dominio. En nuestro caso, cada agente debe conservar un valor binario y cada umbral debe mantenerse fijo. La suma de estados no puede disminuir porque la regla es irreversible. Una caída en el número de activos indicaría un error de implementación o una regla distinta de la declarada.
La segunda comprobación afecta a las relaciones. Cada posición del anillo debe tener exactamente dos vecinos distintos. Los agentes cero y cinco deben estar conectados. Una frontera abierta introducida por error cambiaría algunas trayectorias sin que el programa fallara necesariamente de forma visible. Las estructuras pequeñas permiten inspeccionar estas condiciones directamente.
La tercera comprobación separa lectura y escritura de estados. Todas las decisiones de un paso simultáneo deben leer la misma configuración anterior. Podemos construir primero una lista nueva y después reemplazar la antigua. La organización interna del código puede variar, pero la semántica de la operación debe conservarse.
La cuarta comprobación usa casos extremos. Sin semilla activa no hay activaciones con estos umbrales positivos. Con todos los agentes activos, el estado permanece igual. Si todos tienen umbral uno, una semilla se propaga por el anillo. Si todos tienen umbral dos, una sola semilla no inicia cambios. Cada caso pone a prueba una consecuencia distinta.
La quinta comprobación recurre a la enumeración de diez asignaciones. Debemos recuperar las frecuencias tres, cuatro y tres para los totales uno, dos y tres. Conviene también comparar cada trayectoria con un cálculo independiente. Una prueba agregada puede pasar aunque dos errores intercambien resultados entre configuraciones.
El criterio de detención también merece atención. Como hay cinco agentes inicialmente inactivos y la activación es irreversible, solo pueden ocurrir cinco activaciones nuevas. En la actualización simultánea, cada paso que cambia algo incorpora al menos un agente. Si un paso completo no cambia ningún estado, hemos alcanzado un punto fijo y los pasos posteriores serán idénticos.
Cuando ampliemos el modelo, estas comprobaciones se convertirán en referencias locales. Añadir movimiento obligará a verificar ocupación y fronteras; añadir recursos requerirá balances; añadir nacimientos y salidas modificará las identidades persistentes. Si los nuevos mecanismos introducen cantidades y restricciones diferentes, harán falta pruebas nuevas además de las antiguas.
La documentación de resultados debe permitir reconstruir qué versión produjo cada salida. Incluye reglas, parámetros, inicialización, código y, si corresponde, semillas aleatorias. Esa trazabilidad es especialmente útil cuando una mejora corrige un error y cambia una conclusión. Podemos explicar entonces qué supuesto o implementación era responsable, sin reemplazar en silencio una figura.
242.10. Elegir el detalle que una pregunta necesita
Los modelos basados en agentes conectan de forma explícita diferencias individuales, relaciones locales y resultados colectivos. Su utilidad está en conservar información que puede perderse al agregar. El anillo mostró que una media y un histograma de tipos pueden ser insuficientes cuando importa su distribución entre conexiones.
La heterogeneidad relevante puede estar en atributos, capacidades, recursos, memoria o exposición, así como en las reglas que usan las distintas entidades. Cada dimensión añadida debe responder a una pregunta o a una restricción empírica. Un catálogo extenso de características sin consecuencias comprobables hace más difícil interpretar por qué el modelo produce sus resultados.
Nuestro ejemplo separó tres operaciones. Primero derivamos trayectorias bajo condiciones fijas, después enumeramos una distribución de inicializaciones y, finalmente, comparamos qué observaciones distinguirían mecanismos alternativos. Mantener esas operaciones separadas permite saber de qué tipo es una conclusión (matemática, estadística o empírica) y qué evidencia adicional requiere.
La distribución final de uno, dos o tres activos es exacta para las diez asignaciones definidas. La relevancia de esa distribución para un fenómeno real sigue abierta. Esa diferencia precisa el alcance del ejemplo y permite usarlo correctamente como prueba de implementación, ilustración de un mecanismo y punto de partida para preguntas más exigentes.
Una buena simplificación conserva aquello que la pregunta necesita y declara lo que descarta. Si solo interesa un promedio en un régimen concreto, quizá una descripción agregada sea suficiente. Si interesa intervenir sobre vínculos, identificar posiciones críticas o explicar diferencias entre trayectorias, conservar agentes y relaciones puede ser indispensable.
El siguiente capítulo estudiará el Juego de la Vida. Allí los estados locales y las reglas vuelven a ser muy simples, pero aparecen objetos persistentes y formas de transmitir información. Ese caso exigirá otro cuidado, porque reconocer patrones organizados y capacidad de cómputo requiere analizar construcciones y condiciones; una animación llamativa no permite inferir propiedades generales.
Referencias
- Bonabeau, E. (2002). Agent-based modeling: Methods and techniques for simulating human systems. Proceedings of the National Academy of Sciences, 99(Suppl. 3), 7280–7287. https://doi.org/10.1073/pnas.082080899
- Epstein, J. M. (1999). Agent-based computational models and generative social science. Complexity, 4(5), 41–60. Artículo original.
- Grimm, V., Revilla, E., Berger, U., Jeltsch, F., Mooij, W. M., Railsback, S. F., Thulke, H.-H., Weiner, J., Wiegand, T. y DeAngelis, D. L. (2005). Pattern-oriented modeling of agent-based complex systems: Lessons from ecology. Science, 310(5750), 987–991. https://doi.org/10.1126/science.1116681