Módulo 23. Complejidad algorítmica, computacional y estadística
229.1. Del proceso conocido al registro disponible
En los capítulos anteriores conocíamos las reglas que generaban las secuencias. Podíamos enumerar estados, calcular probabilidades estacionarias y demostrar qué historias tenían consecuencias predictivas distintas. El problema empírico empieza cuando solo disponemos de un registro (una serie de símbolos acompañada, idealmente, de tiempos, condiciones de adquisición y criterios de codificación). Ahora debemos distinguir la organización del proceso de las regularidades accidentales de una muestra. Una estructura inferida es una hipótesis estadística sometida a contraste, aunque su representación gráfica parezca completa.
Consideremos una secuencia binaria de actividad e inactividad. Podemos describirla mediante la frecuencia de cada símbolo, las probabilidades de transición entre símbolos o un modelo con estados internos. Cada descripción responde a una pregunta diferente. La primera estima con qué frecuencia ocurre cada observación; la segunda usa el último símbolo; la tercera permite conservar información relevante que no coincide necesariamente con una observación reciente. El objetivo es identificar distinciones del pasado que mejoren de manera estable las predicciones futuras. Añadir estados hasta reproducir cada dato no sirve a ese fin.
La palabra «inferir» exige especificar qué información estaba disponible cuando se produjo cada pronóstico. Si un estado se asigna usando observaciones posteriores al instante que pretende predecir, estamos reconstruyendo retrospectivamente. Eso puede ser útil, pero no equivale a pronosticar en tiempo real. El filtrado usa el pasado y la observación presente según la convención temporal; el suavizado usa también observaciones futuras. Una auditoría debe comprobar que estas operaciones no se intercambian inadvertidamente durante la evaluación.
También debemos fijar la unidad de observación. Un cero puede significar ausencia de un evento durante un segundo, una respuesta negativa en una entrevista o una señal por debajo de un umbral. Estos símbolos comparten un alfabeto, pero corresponden a procesos de medida distintos. Agregar intervalos, eliminar silencios o convertir duraciones en categorías modifica las dependencias que un algoritmo puede descubrir. Por ello, una máquina inferida caracteriza primero el proceso observado bajo ese protocolo y solo después admite interpretaciones sobre el sistema subyacente.
Trabajaremos con secuencias de un alfabeto finito y separaremos cuatro decisiones, que son la representación de los datos, la familia de modelos, el procedimiento de estimación y la evaluación predictiva. Esta separación permite localizar un fracaso. Un modelo puede estar correctamente ajustado dentro de una familia inadecuada; una familia adecuada puede ser imposible de identificar con el registro disponible. Aumentar la precisión decimal de las probabilidades estimadas no resuelve ninguna de estas situaciones.
229.2. Historias que parecen equivalentes
Llamamos historia finita a una palabra observada antes del símbolo que queremos predecir. Para cada historia podemos contar las continuaciones que aparecen en el registro; al dividir esos conteos por el número de apariciones obtenemos una distribución empírica del siguiente símbolo. Sin embargo, dos distribuciones empíricas distintas pueden proceder de una misma distribución poblacional. La variación de muestreo obliga a decidir qué discrepancias justifican mantener historias separadas y cuáles son compatibles con compartir una predicción.
Construyamos una tabla didáctica, que no procede de datos reales. Después de la historia cero observamos treinta ceros y treinta unos; después de cero uno, veinticinco unos y ningún cero; después de cero uno uno, veinte ceros y veinte unos. Las frecuencias sugieren agrupar la primera y la tercera historia, mientras que la segunda parece necesitar una predicción diferente. Esta observación orienta una propuesta de estados que aún no está demostrada.
Las historias de la tabla se solapan lógicamente, porque una aparición larga puede contribuir también a los conteos de sufijos más cortos, de modo que no debemos tratar automáticamente todas las filas como muestras independientes. También las ventanas sucesivas de una sola secuencia comparten símbolos. Un contraste diseñado para observaciones independientes puede quedar mal calibrado si ignora esa dependencia. La incertidumbre debe evaluarse dentro del modelo temporal o mediante procedimientos cuya validez responda a las propiedades del registro.
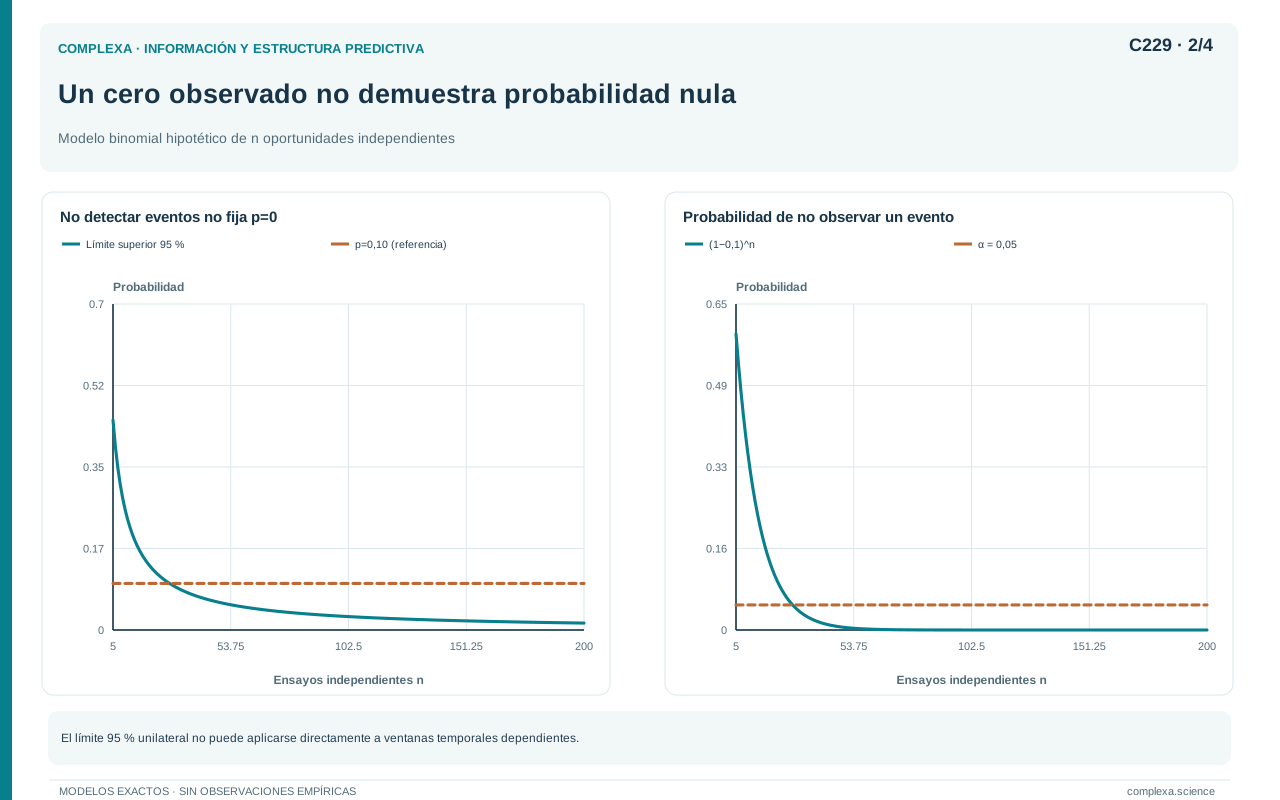
Veinticinco observaciones de cero uno sin ningún cero a continuación no prueban que la probabilidad de ese evento sea exactamente nula. Como cálculo ilustrativo, si las oportunidades fueran independientes y la probabilidad desconocida del evento fuera constante, la probabilidad de observar cero eventos sería la potencia veinticinco de uno menos esa probabilidad. Igualarla a cinco centésimas da un límite superior unilateral cercano a once centésimas. Este cálculo no vale directamente para conteos dependientes, pero muestra cuánto puede ocultar un cero empírico.
También hay que distinguir la igualdad del siguiente símbolo de la igualdad de todo el futuro. Dos historias pueden producir un cero y un uno con iguales probabilidades, pero diferir en las parejas que siguen. Por ejemplo, una puede permitir solo cero cero y uno uno, mientras la otra permite cero uno y uno cero; sus primeros símbolos tienen la misma distribución, pero sus futuros de longitud dos son incompatibles. Una reconstrucción predictiva debe conservar las distinciones necesarias para horizontes posteriores, aunque no mejoren una comparación aislada a un paso.
229.3. Reconstrucción por partición y actualización
Una estrategia es comenzar con una descripción muy simple y subdividirla cuando los datos dan evidencia de diferencias predictivas. CSSR, presentado por Shalizi y Shalizi, combina comparaciones de distribuciones del siguiente símbolo con una reconstrucción que exige actualización recursiva de los estados. Su resultado debe incluir, junto a los grupos de historias, la regla que indica cómo cambia el grupo tras observar un símbolo; esa regla conecta la predicción inmediata con la estructura temporal [1].
Podemos entender la recursividad con un razonamiento sencillo. Supongamos que todas las historias asignadas al estado A producen predicciones similares. Después de observar un uno, el analista debería saber qué estado usar a continuación a partir de A y de ese uno. Si unas historias conducen a B y otras a C, con futuros diferentes en B y en C, A ha mezclado información necesaria. El estado debe subdividirse o la representación debe reformularse para recuperar una actualización coherente.
En el ejemplo didáctico, las historias que terminan en cero y en cero uno uno sugieren un mismo estado. Observar cero desde ese estado permite permanecer en él; observar uno lleva a otro estado, desde el cual aparece necesariamente un uno en el modelo idealizado. Después de ese segundo uno se recupera el primer estado. Esta hipótesis reproduce la restricción de paridad del proceso par estudiado anteriormente. La tabla de conteos permite imaginarla, pero inferirla exige examinar más historias y comprobar todas las transiciones pertinentes.
El procedimiento introduce una longitud máxima de historia. Con un alfabeto binario hay hasta dos elevado a esa longitud palabras posibles. Muchas pueden ser imposibles bajo el proceso, pero el crecimiento potencial explica la escasez de observaciones por contexto. Aumentar la memoria examinada puede descubrir una dependencia antes invisible y, simultáneamente, volver inestables las probabilidades estimadas. El compromiso depende del número total de símbolos registrados y, sobre todo, de las frecuencias efectivas de cada contexto.
No implementaremos una versión simplificada para llamarla CSSR. Una tabla de frecuencias, un agrupamiento de vectores y un dibujo de flechas no reproducen necesariamente sus pruebas, reglas de asignación, tratamiento de transitorios y reconstrucción recursiva. Un análisis real exige identificar el algoritmo y su versión, conservar sus parámetros y verificar su comportamiento con procesos de estructura conocida. Aquí los ejemplos pequeños solo ilustran las decisiones que toda reconstrucción debe justificar.
229.4. Qué permiten afirmar las garantías
La convergencia de un algoritmo es una afirmación condicional. La presentación original de CSSR supone estacionariedad condicional, un número finito de estados causales y la existencia, para cada estado, de algún sufijo finito que permita identificarlo. La profundidad explorada debe ser suficiente para representar esos sufijos. Estas condiciones no equivalen a afirmar que cualquier ventana de una longitud fija identifique siempre el estado [1]. Confundir ambas propiedades excluiría precisamente algunos procesos de memoria observacional prolongada.
El proceso par ilustra la diferencia. Observar un cero permite localizar un estado; observar cero uno permite localizar el otro. Sin embargo, una ventana formada solo por unos no revela la paridad, porque el último cero queda fuera de ella. Puede existir una palabra corta que sincronice cada estado y, al mismo tiempo, haber ventanas arbitrariamente largas que mantengan la ambigüedad. La existencia de sufijos identificadores no fija un tiempo máximo universal de sincronización.
La estacionariedad condicional exige que la regla predictiva no cambie con el calendario una vez especificada la historia relevante. Si una intervención modifica las probabilidades a mitad del registro, mezclar ambas etapas puede crear estados que codifiquen indirectamente la etapa. El modelo describe entonces una combinación de regímenes. Antes de interpretar los nuevos estados como mayor organización interna, debemos comprobar cambios de instrumento, horarios, condiciones ambientales, composición de la muestra y decisiones de preprocesamiento.
El supuesto de finitud también tiene consecuencias. Un algoritmo que busca hasta cierto número de estados puede aproximar procesos cuya representación predictiva exacta requiere infinitos estados. Obtener una máquina pequeña no demuestra que el proceso tenga una máquina exacta pequeña; puede indicar que, dentro de la longitud y la resolución observadas, las diferencias restantes tienen un impacto predictivo difícil de detectar. La complejidad estimada queda condicionada por esa capacidad de resolución.
Finalmente, un resultado asintótico no especifica cuánto vale «suficiente» para una muestra concreta. Dos estados con probabilidades casi idénticas requieren más evidencia para distinguirse que dos estados con salidas incompatibles. Los estados raros añaden otra dificultad, porque un registro largo puede contener muy pocas visitas informativas. Por eso conviene informar la ocupación de cada estado, la cantidad de transiciones observadas y la estabilidad de la reconstrucción ante variaciones razonables del análisis. Estas comprobaciones convierten una promesa de convergencia en preguntas empíricas examinables.
229.5. Complejidad de búsqueda y decisiones estadísticas
Un umbral estadístico controla cada decisión de un procedimiento por separado y deja sin controlar la credibilidad global de un diagrama. Si examinamos muchas historias, aumentan las oportunidades de separar grupos debido al azar. En un ejemplo idealizado con cien contrastes independientes de tamaño cinco por ciento, la probabilidad de al menos un rechazo falso sería uno menos la potencia cien de noventa y cinco centésimas, aproximadamente noventa y nueve coma cuatro por ciento. Los contrastes reales suelen depender entre sí, pero el ejemplo muestra por qué debe evaluarse el procedimiento completo.
Reducir el umbral tampoco resuelve todos los problemas. Puede evitar divisiones espurias y, a la vez, fusionar estados diferentes cuando hay pocos datos. Este equilibrio entre errores tiene consecuencias predictivas, porque una máquina demasiado fragmentada estima mal sus probabilidades y una demasiado agregada pierde dependencias. La decisión debe considerar rendimiento fuera de muestra, estabilidad estructural y relevancia de las diferencias, más allá del número de estados.
La longitud máxima examinada es otro parámetro de selección. Si elegimos la longitud que funciona mejor sobre un conjunto de prueba y luego presentamos ese mismo rendimiento como evaluación final, hemos usado la prueba para ajustar el procedimiento y su resultado deja de ser independiente. Una división temporal en entrenamiento, validación y prueba permite asignar a cada tramo una tarea distinta, aunque reduce la cantidad de datos disponible en cada etapa.
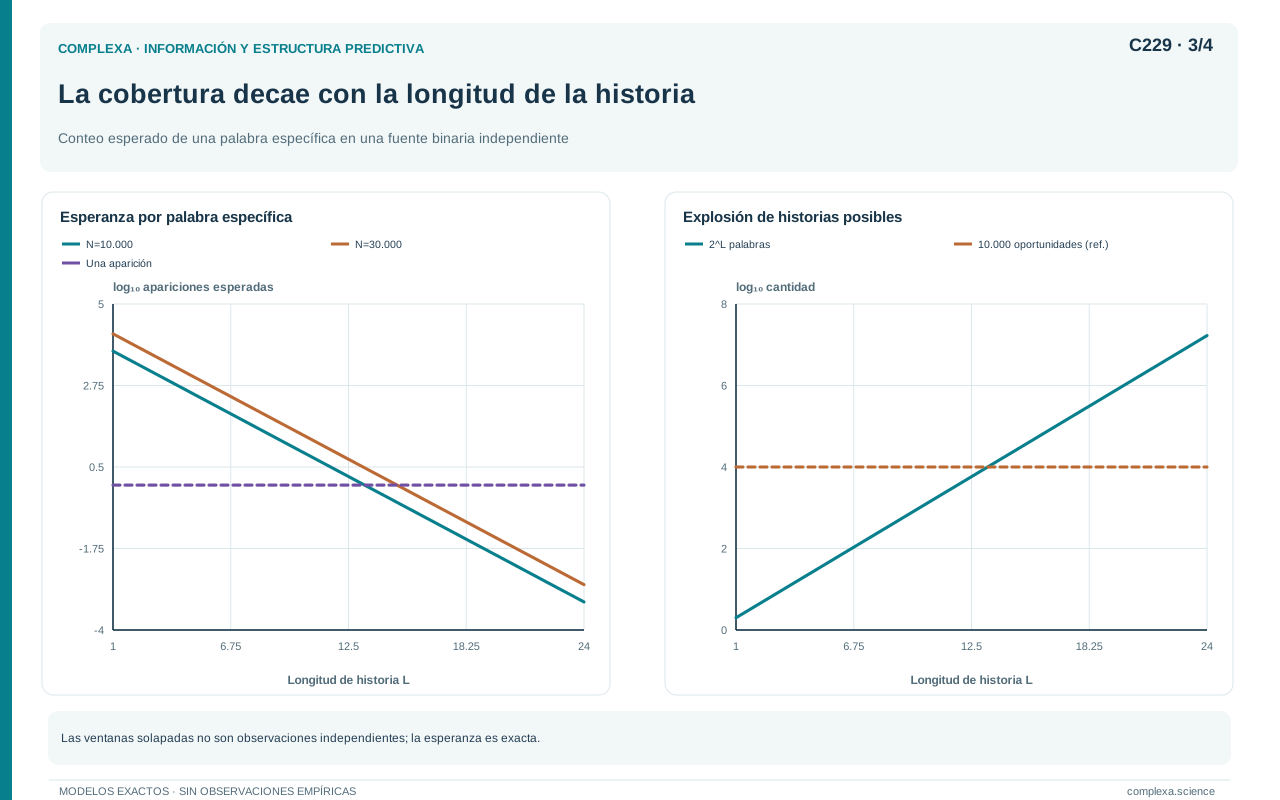
Para dimensionar el problema, una historia concreta de longitud diez tendría alrededor de diez apariciones en una secuencia independiente y equilibrada de diez mil símbolos; la expectativa exacta depende de cuántas posiciones completas puedan examinarse. Una historia de longitud veinte tendría una expectativa inferior a una centésima. Estos números no valen para todos los procesos binarios, porque una secuencia muy regular concentra su masa en pocas palabras. Muestran, sin embargo, que la precisión de cada distribución condicional depende menos de la longitud total del registro que de cuántas oportunidades informativas hay para cada distinción propuesta.
Para una secuencia de treinta mil observaciones podríamos reservar las primeras dieciocho mil para el ajuste, las siguientes seis mil para elegir configuraciones y las últimas seis mil para la evaluación final. Estas cifras son solo un ejemplo de diseño. Las ventanas que cruzan límites requieren una regla explícita. Usar el pasado anterior al tramo de prueba para inicializar un predictor puede ser legítimo en una evaluación prospectiva; usar símbolos futuros para estimar parámetros o seleccionar estados no lo es.
También importa cómo se comparan las configuraciones. Debemos fijar las profundidades que se examinarán, una regla de desempate y un criterio principal antes de inspeccionar los resultados finales. Si muchas estructuras predicen de manera equivalente, una presentación honesta puede conservar varias candidatas. Elegir la más pequeña puede facilitar la interpretación, pero no convierte automáticamente sus estados en los verdaderos estados del sistema. El objetivo operativo es una representación suficientemente informativa y reproducible, con una incertidumbre explícita sobre las distinciones que los datos permiten sostener.
229.6. Comparar estructuras mediante probabilidad
Otra estrategia parte de una colección explícita de modelos candidatos y calcula cuánto apoyo reciben de los datos. La inferencia estructural bayesiana de Strelioff y Crutchfield desarrolla esta idea para familias de modelos ocultos unifilares. Integra la incertidumbre sobre las probabilidades de transición y los estados iniciales para comparar las topologías mediante sus probabilidades posteriores [2]. Su valor conceptual es recordar que la estructura también puede ser incierta, igual que los parámetros de una estructura seleccionada.
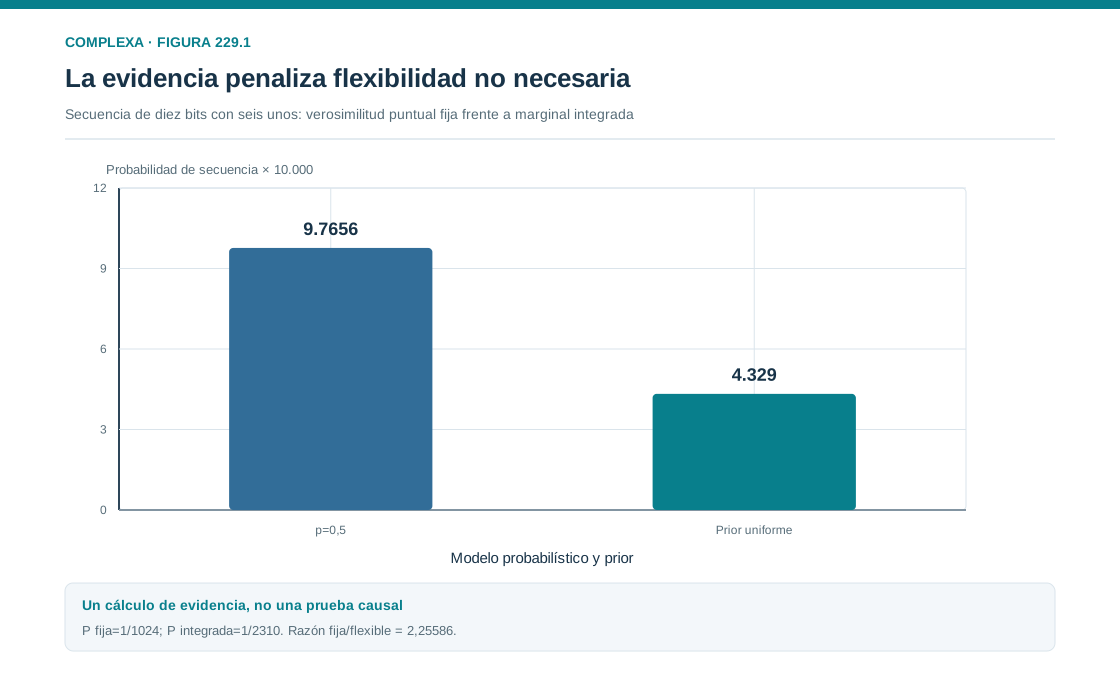
La probabilidad posterior de una topología es proporcional a su probabilidad previa multiplicada por la evidencia marginal de los datos. La evidencia marginal integra la verosimilitud respecto de la distribución previa de los parámetros. Esta operación difiere de escoger el mejor ajuste posible de cada modelo. Una topología flexible puede alcanzar un ajuste excelente en una región muy pequeña de sus parámetros y, aun así, no recibir la mayor evidencia integrada.
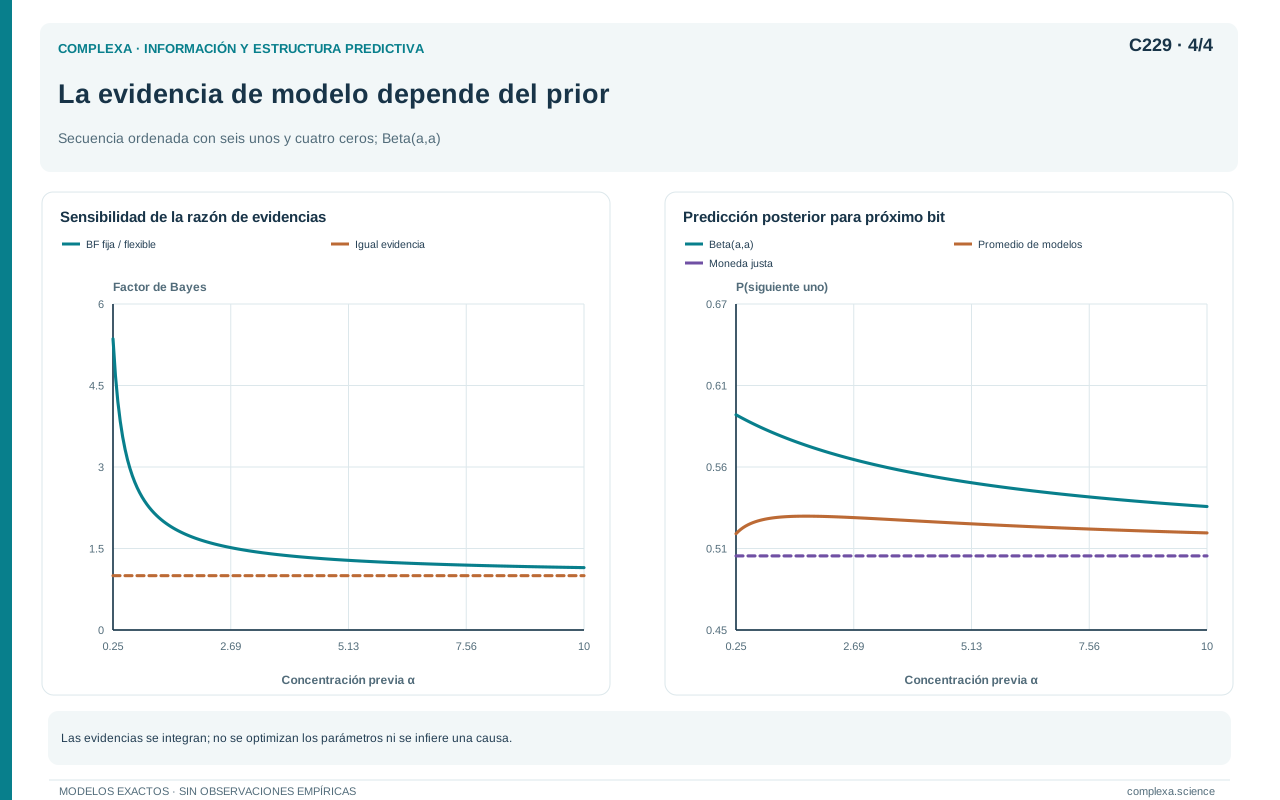
Un ejemplo elemental permite ver esa diferencia sin introducir modelos ocultos. Para una secuencia binaria ordenada con seis unos y cuatro ceros, el modelo de moneda equilibrada asigna una probabilidad de uno dividido por mil veinticuatro. Un modelo con probabilidad de uno desconocida y distribución previa uniforme integra las probabilidades de la misma secuencia; el resultado es uno dividido por dos mil trescientos diez. En estas condiciones, la razón de evidencias favorece al modelo fijo por un factor aproximado de dos coma veintiséis.
Este cálculo usa la probabilidad de una secuencia particular. Si la observación fuera solo el conteo de seis unos, habría que incluir el coeficiente combinatorio correspondiente en ambos modelos; la razón seguiría siendo la misma. Precisar el dato observado evita mezclar probabilidades de objetos diferentes y concluir que el modelo flexible «pierde» por no poder representar la proporción observada; puede representarla, pero su evidencia promedia sobre otras posibilidades admitidas inicialmente.
Las probabilidades posteriores son relativas al conjunto candidato y a sus supuestos. Si todas las topologías disponibles son inadecuadas, una de ellas puede obtener casi todo el peso. Por eso deben acompañarse de comprobaciones predictivas y de análisis de sensibilidad a las distribuciones previas. Promediar predicciones entre modelos puede reflejar incertidumbre estructural; promediar sin explicar qué modelos entraron en la comparación puede ocultarla. La inferencia es interpretable cuando el lector conoce tanto las alternativas consideradas como las excluidas.
229.7. Evaluar predicciones y examinar errores
Una evaluación útil compara el modelo reconstruido con referencias simples. Para símbolos binarios, una referencia estima una probabilidad constante de uno; otra usa solo el último símbolo. Si una máquina con numerosos estados apenas mejora esas referencias fuera de muestra, su diagrama necesita una justificación adicional. La comparación, que no excluye que exista estructura, mide cuánto aporta la estructura inferida a la tarea predictiva y al horizonte elegidos.
La pérdida logarítmica asigna a cada observación el negativo del logaritmo de la probabilidad que el modelo le había otorgado. Con logaritmos en base dos se expresa en bits. Promediarla sobre una secuencia de prueba permite comparar pronósticos probabilísticos. Para un proceso de distribución verdadera conocida, la pérdida esperada se descompone en la incertidumbre irreducible más una divergencia debida a las probabilidades usadas. Esta identidad explica por qué importa calibrar las probabilidades, más allá de acertar el símbolo más frecuente.
Si un modelo asigna probabilidad cero a una observación que ocurre, su pérdida es infinita. Reemplazar el cero por una cantidad pequeña puede ser una decisión práctica razonable, pero cambia el modelo evaluado. Debemos declarar la regla de suavizado y aplicarla de manera comparable. Si una topología prohíbe una palabra y esa palabra aparece con frecuencia, introducir una tolerancia minúscula no resuelve la discrepancia estructural y solo permite calcular una cifra finita.
También debemos evaluar horizontes distintos. Un predictor puede dar buenas probabilidades inmediatas y fallar al generar distribuciones de bloques, duraciones de rachas o tiempos de retorno. Las simulaciones predictivas permiten comparar esas propiedades con el registro observado. Elegir solo la estadística que mejor coincide después de inspeccionar muchas produce una imagen parcial; conviene fijar propiedades pertinentes para la pregunta científica y mostrar las discrepancias relevantes, aunque la pérdida media sea competitiva.
La incertidumbre de las diferencias entre modelos debe respetar el orden temporal. Restar sus pérdidas observación por observación produce una serie posiblemente dependiente. Un intervalo que trate cada instante como una réplica independiente puede ser demasiado estrecho. Según el diseño, pueden usarse registros independientes, bloques adecuados o una estimación explícita de la dependencia. Estos recursos indican si una mejora predictiva pequeña es reproducible y cuánto vale; sin otra evidencia, no la convierten en una explicación mecanística.
Conviene distinguir además dos protocolos de prueba. En uno, los parámetros quedan congelados durante todo el tramo final. En otro, el predictor puede actualizarse después de cada observación, según una regla fijada previamente. Ambos son legítimos si corresponden al uso previsto. El segundo evalúa un sistema de aprendizaje continuo, por lo que la actualización y su costo forman parte del método. Comparar un modelo congelado con otro actualizado sin declarar esa diferencia atribuiría a la estructura una ventaja procedente, al menos en parte, del acceso a información nueva.
229.8. Estado inferido, mecanismo y medida
Un estado predictivo agrupa pasados con consecuencias observacionales equivalentes dentro del modelo. No tiene por qué corresponder a un compartimento físico, una intención, una región cerebral o una categoría clínica. Puede resumir la combinación de varias variables ocultas y del instrumento que las observa. Nombrarlo «activación» o «vulnerabilidad» añade una interpretación que requiere evidencia externa. Sin ella, nombres neutrales como A y B mantienen clara la diferencia entre representación estadística y explicación sustantiva.
Supongamos que una persona alterna períodos de respuesta y de silencio. Un modelo identifica dos estados, uno con alta probabilidad de responder y otro con alta probabilidad de seguir en silencio. La estructura podría reflejar un cambio interno, pero también horarios de disponibilidad, interrupciones de conexión o una regla del dispositivo que agrupa mensajes. Para discriminar estas explicaciones necesitamos variables adicionales, diseños comparativos o intervenciones pertinentes. Es posible que la secuencia simbólica, sin otros datos, no identifique el mecanismo.
El ruido de observación también altera la estructura. Si un proceso ideal prohíbe dos ceros consecutivos, los errores de clasificación pueden producirlos en el registro. Un algoritmo que no contempla errores puede añadir estados para acomodar esas apariciones; otro puede estimar una máquina más simple con transiciones raras. Ambos describen posibles regularidades observadas, pero ninguno ha separado automáticamente la dinámica latente del canal de medida. Esa separación requiere un modelo de observación identificable y evidencia suficiente.
La agregación temporal merece un análisis propio. Registrar cada evento y registrar el estado dominante durante una hora producen alfabetos y dependencias diferentes. Incluso cuando ambas series proceden del mismo sistema, sus complejidades estadísticas pueden ser distintas. Compararlas exige especificar la resolución y preguntar si cambia la información predictiva disponible, la incertidumbre por símbolo o simplemente la cantidad de símbolos por unidad de tiempo. Los bits por observación y los bits por hora son unidades distintas.
La robustez debe evaluarse frente a decisiones plausibles que conserven el problema original. Podemos variar modestamente los umbrales de simbolización, excluir segmentos con fallos documentados o repetir el análisis en registros independientes. Si los estados cambian pero las predicciones permanecen estables, quizá los datos sostengan una función predictiva con varias representaciones aproximadas. Si cambian también las conclusiones sustantivas, el resultado debe presentarse como sensible al protocolo.
229.9. Un protocolo de inferencia reproducible
Podemos organizar un estudio alrededor de una pregunta concreta. ¿Contiene la secuencia información predictiva adicional a la frecuencia de símbolos y a una dependencia de primer orden? Esta formulación da referencias claras y evita que «encontrar complejidad» se convierta en una meta sin criterio de fracaso. Antes del ajuste debemos definir el horizonte de predicción, la unidad temporal, el tratamiento de los datos ausentes y qué magnitud de mejora tendría relevancia para la aplicación.
La preparación conserva una copia de los datos originales y produce una representación simbólica mediante reglas documentadas. Si los intervalos ausentes se eliminan, dos observaciones distantes pueden convertirse artificialmente en vecinas. Si se codifican como un símbolo adicional, el modelo puede aprender sobre el proceso de ausencia. Si se dividen los registros en segmentos, deben reiniciarse adecuadamente las historias. Cada opción modifica la pregunta y tiene consecuencias verificables sobre los conteos.
A continuación se construyen referencias simples y se ajustan modelos candidatos solo con la información autorizada para entrenamiento. La validación selecciona profundidad, regularización o conjunto de topologías. Deben registrarse las configuraciones examinadas, incluidas las que fallaron o produjeron estructuras inestables. Conservar solo el modelo ganador impide evaluar cuánto dependió el resultado de la búsqueda. Una tabla compacta de configuraciones y pérdidas puede ser más informativa que varios diagramas sin comparadores.
La prueba final evalúa predicciones fijadas por ese proceso. Además de la pérdida principal, conviene mostrar la ocupación de los estados, las transiciones escasamente observadas y las discrepancias en propiedades temporales pertinentes. Para interpretar la complejidad estadística estimada se calcula la distribución estacionaria del modelo cuando corresponde y se reconoce la incertidumbre de sus probabilidades y de su topología. La entropía de los estados ajustados es solo una estimación de la complejidad del proceso real.
El informe debe permitir reconstruir el recorrido desde el registro hasta la conclusión. Incluye versiones, semillas cuando interviene aleatoriedad, reglas de segmentación, criterios de selección y resultados de comparación. También establece qué observaciones futuras cuestionarían la propuesta, como la aparición repetida de palabras prohibidas, una degradación predictiva en otro período o cambios estructurales ante pequeñas modificaciones de la medida. Una inferencia gana contenido científico cuando, además de explicar la muestra usada, formula condiciones de revisión.
229.10. Qué significa haber encontrado estructura
Encontrar estructura predictiva significa haber identificado distinciones del pasado que ayudan a anticipar observaciones bajo condiciones definidas. No significa haber agotado la organización del sistema ni haber descubierto su única representación posible. El alcance depende de las variables observadas, la escala temporal, la familia de modelos y la cantidad de información disponible. Expresar ese alcance con precisión permite comparar resultados entre estudios sin convertir diferencias metodológicas en aparentes diferencias ontológicas.
Una máquina de dos estados puede ser suficiente para una tarea y demasiado limitada para otra. Si solo queremos predecir el próximo símbolo, ciertas diferencias entre futuros largos pueden tener poca relevancia operacional. Si queremos anticipar rachas prolongadas o eventos infrecuentes, esas diferencias pueden ser centrales. La elección del horizonte es previa al análisis, porque determina qué información vale la pena conservar y cómo deben evaluarse los errores de simplificación.
Un resultado negativo también puede ser informativo. Si una reconstrucción compleja no supera referencias sencillas, quizá la secuencia sea poco informativa a esa resolución, el registro sea insuficiente o el procedimiento no capture la dependencia existente. Diferenciar estas explicaciones requiere simulaciones de control y análisis de sensibilidad. El fracaso de un algoritmo no demuestra ausencia de estructura; el éxito sobre datos sintéticos sencillos tampoco garantiza su recuperación en registros con ruido, cambios de régimen y observación parcial.
Los ejemplos del capítulo permiten reconocer cuatro errores recurrentes, que son interpretar un cero empírico como imposibilidad, fusionar historias por su semejanza inmediata sin comprobar la actualización, tratar una estructura seleccionada como si no hubiera incertidumbre y atribuir significado causal a estados puramente predictivos. Sus correcciones concretas son, en el mismo orden, cuantificar la información disponible, examinar la consistencia temporal, comparar alternativas y buscar evidencia externa para la interpretación mecanística.
El capítulo siguiente integra estas distinciones con las medidas de compresibilidad y complejidad estudiadas en el módulo. Compararemos procesos cuya entropía, memoria predictiva y restricciones temporales no se ordenan de la misma manera. El propósito será mostrar qué pregunta responde cada medida y cómo un experimento reproducible puede revelar sus límites. Inferir estructura con rigor exige dejar de esperar que una sola cifra o un único diagrama resuelva todas esas preguntas.
Referencias
- Shalizi, C. R., y Shalizi, K. L. (2004). Blind construction of optimal nonlinear recursive predictors for discrete sequences. En Proceedings of the Twentieth Conference on Uncertainty in Artificial Intelligence, 504–511. Manuscrito original.
- Strelioff, C. C., y Crutchfield, J. P. (2014). Bayesian structural inference for hidden processes. Physical Review E, 89, 042119. DOI: 10.1103/PhysRevE.89.042119.
- Shalizi, C. R., y Crutchfield, J. P. (2001). Computational mechanics: Pattern and prediction, structure and simplicity. Journal of Statistical Physics, 104, 817–879. DOI: 10.1023/A:1010388907793.
Nota metodológica. Las tablas verbales, los cálculos elementales y el protocolo de evaluación son desarrollos didácticos propios. No representan una ejecución de CSSR ni resultados de un estudio empírico.