Módulo 23. Complejidad algorítmica, computacional y estadística
228.1. Un modelo de cómo cambia la memoria
Los estados predictivos agrupan historias que producen la misma distribución de futuros. Para convertir esa clasificación en un modelo dinámico necesitamos describir cómo cambia el estado cuando aparece un nuevo símbolo.
Una máquina épsilon reúne esos estados (los estados causales) y sus transiciones etiquetadas por observaciones. Permite representar tanto la memoria relevante como la generación de incertidumbre.
Pese a su nombre, una máquina épsilon es una representación matemática de un proceso estocástico, construida a partir de su equivalencia predictiva.
La letra épsilon designa la aplicación que transforma historias en estados. No alude a un pequeño error tolerado; la definición ideal usa la equivalencia exacta de distribuciones futuras.
En una representación finita podemos usar un grafo. Los nodos corresponden a estados y cada conexión indica qué símbolo se emite, con qué probabilidad y a qué estado conduce.
Una tabla de transiciones contiene la misma información y facilita comprobar que las probabilidades de cada estado suman uno. La forma visual no reemplaza esa normalización.
La mecánica computacional estudia estas representaciones y las relaciones entre memoria, azar y estructura de las secuencias. El adjetivo «computacional» alude al procesamiento de información que hace el propio proceso, se simule o no en un computador.
Un modelo puede predecir sin identificar directamente estados físicos. Sus estados son clases de historias observadas, aunque en algunos casos coincidan con variables internas conocidas.
Al interpretar una reconstrucción, llamar a un estado «reposo» o «activación» no demuestra que corresponda a un mecanismo fisiológico con ese nombre.
En este capítulo construiremos dos máquinas pequeñas que comparten probabilidades estacionarias y medidas globales, pero generan restricciones temporales diferentes. La comparación mostrará por qué una cifra de complejidad no sustituye la estructura del modelo. Dos procesos pueden almacenar la misma cantidad promedio de información y usarla de maneras distintas.
También examinaremos la sincronización, es decir, cómo un observador que desconoce el estado inicial aprende a localizarse en la máquina mediante los símbolos recibidos.
El objetivo es poder pasar de una tabla de transiciones a probabilidades de palabras, tasas de entropía y condiciones de memoria, con cálculos que puedan verificarse directamente.
228.2. Unifilaridad y transición determinada por estado y símbolo
Una propiedad central de las máquinas épsilon es la unifilaridad. Si conocemos el estado actual y el símbolo emitido, el siguiente estado queda determinado.
Para cada estado y cada símbolo de probabilidad positiva existe como máximo un destino. Esa condición puede expresarse mediante una entropía condicional nula
La propiedad se sigue de la equivalencia predictiva. Historias del mismo estado tienen distribuciones futuras iguales. Tras observar el mismo símbolo posible, sus historias extendidas deben inducir también la misma distribución del futuro restante.
Si produjeran distribuciones distintas, ya antes de observar el símbolo diferiría alguna probabilidad de bloques futuros, en contradicción con la equivalencia inicial.
Unifilaridad no significa que el proceso sea determinista. Un estado puede emitir cero o uno aleatoriamente y conducir a destinos diferentes según el resultado.
Tampoco significa que el observador conozca el estado actual. Si comenzó a registrar a mitad del proceso, puede mantener incertidumbre entre varias posibilidades.
La propiedad garantiza que, una vez sincronizado y mientras observe correctamente todos los símbolos, podrá actualizar el estado sin volver a perderlo dentro del modelo.
Un modelo oculto de Markov general puede carecer de esta propiedad. Desde un mismo estado puede emitir el mismo símbolo y dirigirse a dos destinos distintos con probabilidades positivas.
En ese caso, observar la salida no resuelve toda la incertidumbre de transición. Para representar las creencias del observador puede no bastar una sola etiqueta.
Además de la unifilaridad, una máquina épsilon requiere estados predictivamente distintos y la estructura adecuada del proceso considerado. Un grafo unifilar con estados redundantes no es automáticamente una representación mínima.
Podemos construir dos estados que alternen entre sí mientras emiten monedas independientes equilibradas. Si ambos producen exactamente la misma distribución de cualquier futuro, la fase oculta es irrelevante para predecir las observaciones.
Ese generador tiene dos etiquetas internas, pero el proceso observado tiene una máquina épsilon de un solo estado. Contar etiquetas del generador sin minimizar equivalencias sobreestimaría la memoria predictiva.
Al interpretar modelos aprendidos de datos habrá que distinguir con cuidado entre generador y predictor.
228.3. Matrices etiquetadas y probabilidades de palabras
Para trabajar algebraicamente definimos una matriz por símbolo. El elemento situado en la fila s y la columna s prima indica la probabilidad conjunta de emitir ese símbolo y pasar al estado de destino, dado el estado inicial.
Escribimos
La suma de todas las matrices etiquetadas es la matriz de transición entre estados sin distinguir emisiones. Cada una de sus filas debe sumar uno.
Las filas de una matriz individual no necesitan sumar uno. Cada suma de fila es la probabilidad de emitir el símbolo correspondiente desde ese estado.
Si usamos vectores fila para distribuciones, una distribución estacionaria pi satisface pi multiplicada por T igual a pi, con componentes no negativas que sumen uno.
En una cadena finita irreducible, la distribución estacionaria es única. La aperiodicidad interviene en otras propiedades de convergencia, pero no es necesaria para esa unicidad.
Si existen varias clases cerradas, necesitamos especificar cómo se distribuye la probabilidad entre ellas. Resolver una ecuación sin reconocer esa estructura puede ocultar una elección de proceso.
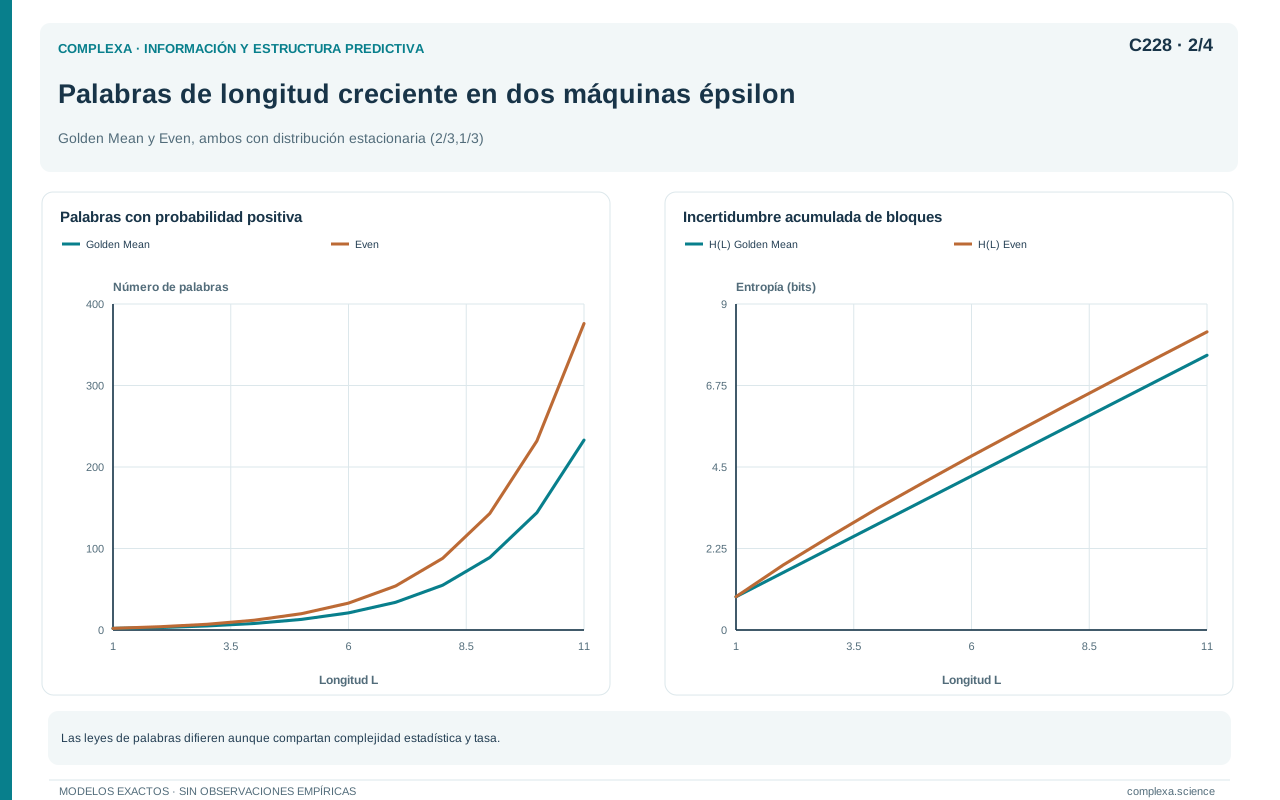
La probabilidad de una palabra finita se obtiene multiplicando las matrices de sus símbolos en orden
El vector final de unos suma las probabilidades sobre todos los estados de llegada. Si conocemos un estado inicial específico, reemplazamos pi por la distribución concentrada en él.
La fórmula suma automáticamente los caminos compatibles con la palabra. En una máquina unifilar existe como máximo un camino por estado inicial y palabra, aunque varios estados iniciales puedan ser compatibles.
El mismo producto informa también sobre el estado de llegada. Antes de multiplicar por el vector de unos, tenemos un vector cuyas componentes son probabilidades conjuntas de la palabra y cada destino. Al dividirlo por la probabilidad de la palabra obtenemos la distribución posterior de estados. Esta operación solo está definida si la palabra tiene probabilidad positiva. Si el modelo le asigna cero, no podemos continuar la actualización mediante una división arbitraria, porque la observación contradice el modelo tal como está formulado.
La normalización puede hacerse después de cada símbolo para evitar números excesivamente pequeños en secuencias largas. El producto de los factores de normalización recupera la probabilidad total, o su suma recupera el logaritmo correspondiente.
Una palabra imposible tiene probabilidad cero. Esa imposibilidad puede provenir de una transición local prohibida o de una restricción que depende de una historia más larga.
Para comprobar una implementación podemos enumerar todas las palabras cortas y verificar que sus probabilidades sumen uno en cada longitud.
También podemos comprobar la consistencia, que exige que la probabilidad de una palabra coincida con la suma de probabilidades de todas sus extensiones por un símbolo.
Estos controles conectan la estructura del modelo con una distribución verificable de observaciones. Si la multiplicación usa índices o convenciones temporales incorrectos, una tabla bien formada da resultados erróneos.
228.4. Una máquina que prohíbe ceros consecutivos
Construyamos un proceso binario con dos estados, A y B. Desde A emitimos uno con probabilidad un medio y permanecemos en A; emitimos cero con probabilidad un medio y pasamos a B.
Desde B emitimos uno con certeza y regresamos a A. Ninguna transición emite cero desde B.
| Estado actual | Símbolo | Probabilidad | Estado siguiente |
|---|---|---|---|
| A | 1 | 1/2 | A |
| A | 0 | 1/2 | B |
| B | 1 | 1 | A |
Después de un cero, el estado es B y el próximo símbolo debe ser uno, así que la secuencia nunca contiene dos ceros consecutivos.
Este ejemplo se conoce habitualmente como proceso de la media áurea, o Golden Mean Process. El nombre no significa que todas sus probabilidades deban contener la razón áurea; aquí hemos fijado probabilidades concretas.
El estado A corresponde a haber observado un uno; B, a haber observado un cero. Para predecir basta el último símbolo, de modo que el proceso observado es de Markov de primer orden.
Podemos variar la probabilidad de emitir cero desde A y llamarla p, manteniendo la transición obligatoria desde B. Para valores estrictamente entre cero y uno, el equilibrio da a A una probabilidad igual a uno dividido por uno más p; la de B es p dividido por uno más p. La tasa de entropía es la entropía binaria de p multiplicada por la probabilidad de A. Así, conservar la misma restricción de palabras no fija las frecuencias ni las medidas informacionales. La estructura de posibilidades y la distribución probabilística deben especificarse conjuntamente.
Las distribuciones futuras de A y B difieren ya en el próximo símbolo, pues desde A puede aparecer cero y desde B no. Por eso los estados no pueden fusionarse sin perder la predicción exacta.
La matriz de transición total tiene como primera fila (un medio, un medio) y como segunda fila (uno, cero). El equilibrio estacionario exige que la probabilidad de B sea la mitad de la de A.
Al normalizar obtenemos dos tercios para A y un tercio para B. La probabilidad marginal de cero es un tercio y la de uno, dos tercios.
La complejidad estadística es la entropía de esas probabilidades, aproximadamente 0,918296 bits. La tasa de entropía es dos tercios de bit por símbolo, porque solo A produce una elección aleatoria y se visita dos tercios del tiempo.
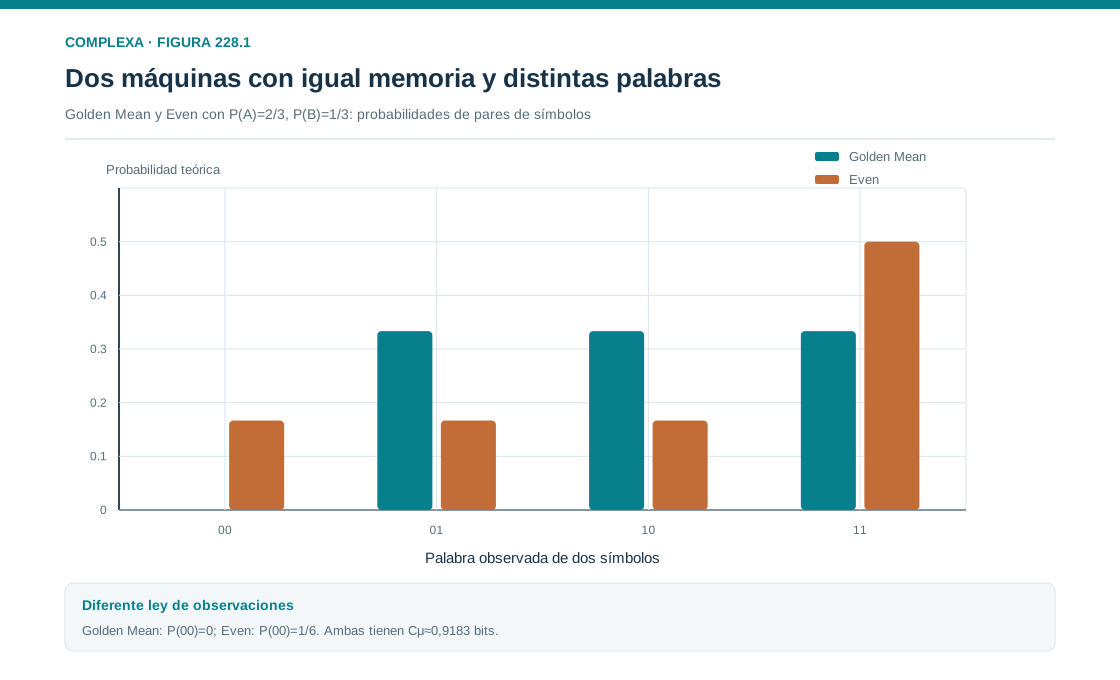
Podemos verificar palabras cortas. La probabilidad de 00 es cero. Las palabras 01, 10 y 11 tienen cada una probabilidad un tercio.
La palabra 010 requiere empezar en A, emitir cero hacia B, emitir uno hacia A y emitir cero nuevamente. Su probabilidad es dos tercios multiplicado por un medio, por uno y por un medio, es decir, un sexto.
Con una sola observación ya conocemos el estado posterior. Cero indica B y uno indica A. Esta sincronización rápida simplifica la predicción desde un registro iniciado en un momento desconocido.
228.5. Una máquina que recuerda paridad
Ahora conservemos dos estados y las mismas probabilidades de transición entre ellos, pero cambiemos qué símbolo acompaña una conexión.
Desde A emitimos cero con probabilidad un medio y permanecemos en A. Con la otra mitad emitimos uno y pasamos a B. Desde B emitimos uno con certeza y volvemos a A.
| Estado actual | Símbolo | Probabilidad | Estado siguiente |
|---|---|---|---|
| A | 0 | 1/2 | A |
| A | 1 | 1/2 | B |
| B | 1 | 1 | A |
Entre dos ceros aparece siempre un número par de unos, porque cada uno alterna el estado y solo A puede emitir cero. Este proceso se conoce como proceso par, o Even Process.
Después de un cero estamos en A. Un uno conduce a B y otro devuelve a A. La máquina conserva la paridad del número de unos desde el último cero.
Pueden aparecer ceros consecutivos porque cero unos es una cantidad par. En cambio, 010 es imposible, ya que contiene un único uno entre ceros.
La palabra 0110 es posible. Empezando en A, las probabilidades sucesivas son un medio, un medio, uno y un medio. Con la distribución inicial estacionaria, su probabilidad es un doceavo.
La matriz total de transición entre estados es la misma del ejemplo anterior. Por tanto, las probabilidades estacionarias vuelven a ser dos tercios y un tercio.
La complejidad estadística sigue siendo aproximadamente 0,918296 bits y la tasa de entropía, dos tercios de bit por símbolo.
También coinciden las probabilidades marginales de símbolos (cero aparece un tercio del tiempo). Sin embargo, las probabilidades de pares cambian.
Ahora 00, 01 y 10 tienen probabilidad un sexto cada una; 11 tiene probabilidad un medio. La distribución suma uno y difiere de forma observable de la del proceso anterior.
Compartir memoria promedio, tasa de entropía y frecuencias marginales no implica compartir estructura. Las etiquetas de las transiciones determinan restricciones distintas sobre las secuencias.
Si elimináramos las etiquetas y conserváramos únicamente la matriz de estados, estos dos ejemplos resultarían indistinguibles. Una red de transiciones sin emisiones no caracteriza un proceso simbólico; necesitamos saber qué se observa al recorrer cada conexión. Tampoco basta asignar nombres diferentes a los nodos, porque la diferencia relevante está en las distribuciones de palabras que la máquina genera.
El estado A no equivale simplemente a «último símbolo cero». Puede alcanzarse después de cero o después de un número par de unos. B corresponde a una paridad impar desde el último cero.
La memoria relevante es una función de la historia que no tiene por qué reducirse a una ventana de longitud fija.
228.6. Memoria finita sin orden de Markov finito
El proceso par tiene dos estados, pero no puede representarse exactamente como un proceso de Markov de orden finito sobre sus símbolos observados.
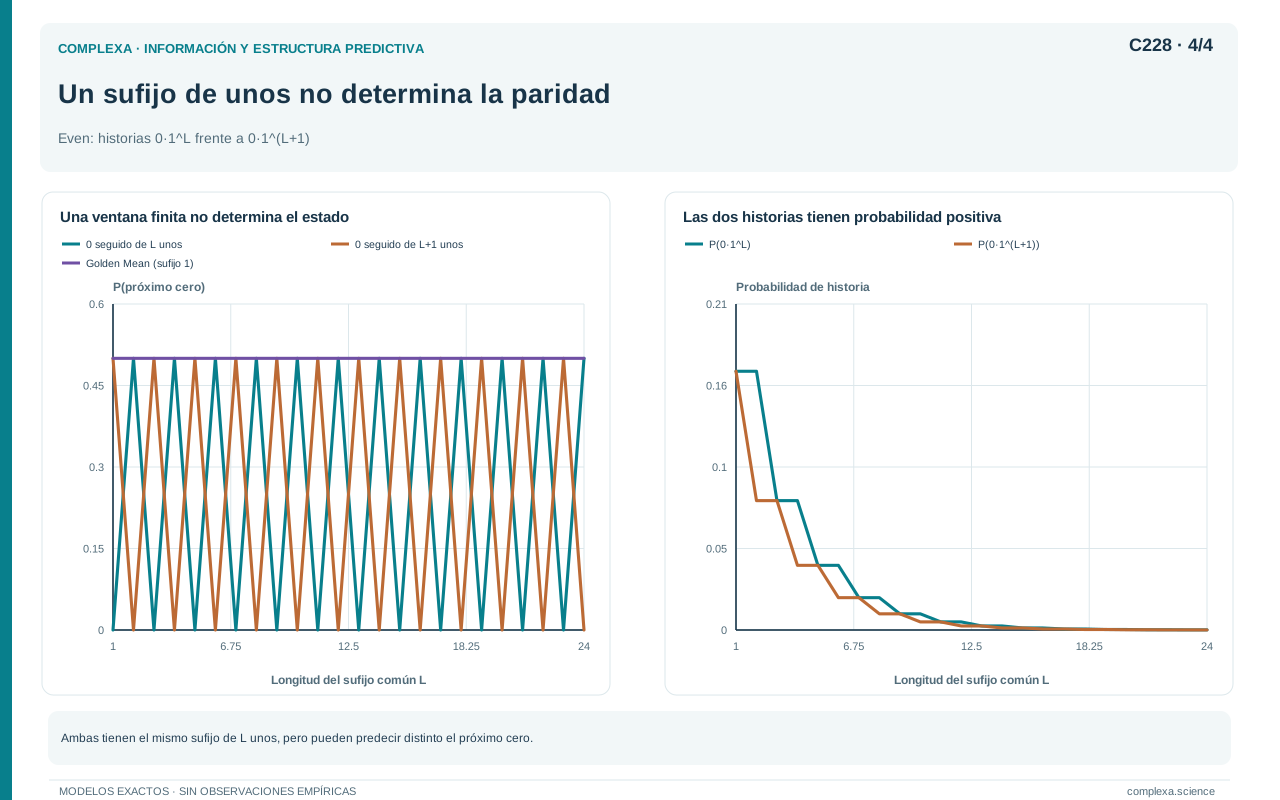
Para cualquier longitud L que fijemos, existen historias que terminan con L unos consecutivos y cuyo último cero se encuentra más atrás. La paridad total desde ese cero puede ser distinta.
Esas historias comparten el mismo sufijo de longitud L, pero una permite emitir cero en el siguiente paso y la otra lo prohíbe. Por tanto, la predicción exacta requiere más información que el sufijo.
Podemos hacer L tan grande como queramos y el argumento persiste, porque el proceso permite rachas arbitrariamente largas de unos con probabilidad positiva.
Sin embargo, una vez identificada la paridad, basta conservar una de dos etiquetas y alternarla con cada uno. La cantidad de memoria de estado es finita.
Esta diferencia separa el orden de Markov del tamaño de la representación predictiva. El primero pregunta cuántos símbolos recientes deben conservarse literalmente; el segundo permite resumir la historia mediante una función.
Guardar una ventana cada vez más larga puede ser una estrategia ineficiente para una regularidad que solo necesita un contador de paridad.
La idea se extiende a otras restricciones. Un proceso puede necesitar recordar el resto de un conteo, una fase o una categoría de eventos, sin conservar la secuencia completa que produjo ese estado.
No debemos concluir que toda memoria larga admite un resumen finito. Algunos procesos requieren infinitos estados o una distribución de creencias con estructura más complicada.
El ejemplo muestra una posibilidad concreta, suficiente para refutar la equivalencia entre dependencia a largo alcance y gran número de estados.
También ayuda a interpretar inferencias con ventanas limitadas. Un modelo de orden fijo puede aproximar el proceso par y acertar muchas predicciones, pero fallará en ciertas historias más largas que su ventana.
La frecuencia de esos fallos puede ser pequeña si las rachas largas son raras. Una evaluación promedio puede ocultarlos si no examina las restricciones estructurales pertinentes.
Si la tarea exige reproducir exactamente las palabras permitidas, necesitamos representar la paridad. Si tolera una aproximación bajo una distribución concreta, una ventana limitada podría ser suficiente.
No debemos atribuir exactitud estructural a un modelo solo porque su error promedio sea bajo.
228.7. Sincronizarse con una fuente oculta
Un observador puede conocer la máquina y desconocer el estado inicial. Antes de recibir símbolos mantiene una distribución de probabilidades sobre los estados, que puede ser la estacionaria.
Después de observar una palabra, actualiza esa distribución mediante la regla de Bayes. En notación matricial, multiplica la distribución inicial por las matrices de la palabra y divide por la probabilidad total de observarla.
Si la distribución posterior se concentra en un estado, el observador se ha sincronizado. La unifilaridad permite mantener esa identificación con las observaciones posteriores.
En el proceso que prohíbe ceros consecutivos, cualquier símbolo identifica el estado de llegada.
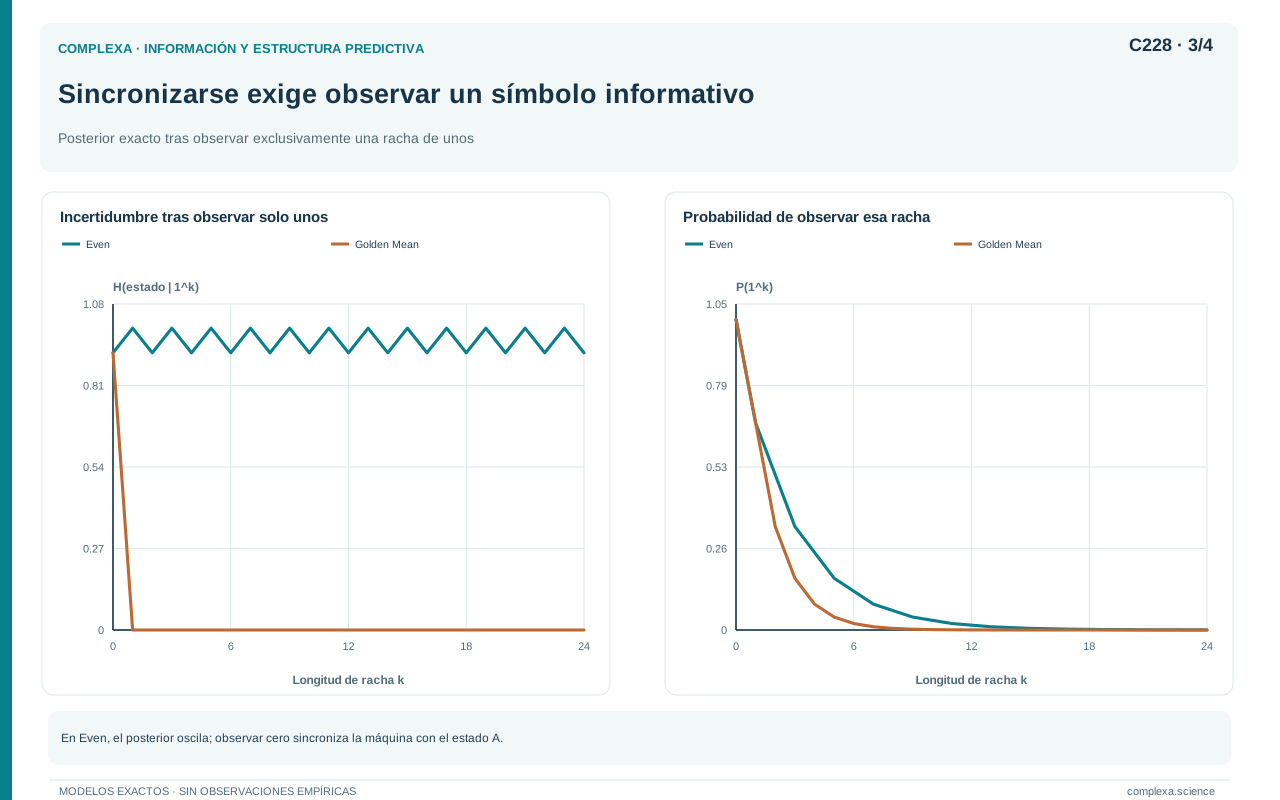
En el proceso par, observar un cero identifica A. Después, contar la paridad de los unos permite seguir la evolución.
Una secuencia formada únicamente por unos puede mantener ambigüedad. Partiendo de la distribución estacionaria, tras un uno las probabilidades posteriores de A y B son iguales.
La probabilidad de llegar a A emitiendo uno procede de B y vale un tercio. La de llegar a B procede de A y también vale un tercio. Al dividir por la probabilidad total de uno, dos tercios, obtenemos un medio para cada estado.
Tras otro uno, la distribución vuelve a dos tercios y un tercio. La incertidumbre no desaparece únicamente por alargar una racha sin ceros.
Sin embargo, la probabilidad de observar una racha así disminuye. Para una longitud par de dos m símbolos, la probabilidad de que todos sean unos es dos elevado a menos m.
Para una longitud impar de dos m más uno, es dos tercios multiplicado por dos elevado a menos m. Estas expresiones se obtienen alternando las transiciones de probabilidad un medio y uno y sumando sobre ambos estados iniciales.
La probabilidad de seguir sin sincronización tiende a cero. El proceso se sincroniza exactamente cuando aparece una palabra finita adecuada, aunque no exista una longitud fija que garantice que todos los registros ya se sincronizaron.
También podemos calcular el tiempo esperado hasta observar el primer cero en el proceso par. Desde A consumimos un paso y, con probabilidad un medio, pasamos a B sin haber visto cero. Desde B consumimos un paso y llegamos necesariamente a A. Si llamamos a esos tiempos medios a y b, la primera ecuación es a igual a uno más b dividido por dos y la segunda, b igual a uno más a. Su solución es a igual a tres y b igual a cuatro. Al comenzar en la distribución estacionaria, el promedio es diez tercios de observación. Un promedio finito no fija un máximo, porque algunas rachas de unos pueden ser arbitrariamente largas.
Travers y Crutchfield estudiaron formalmente la sincronización exacta y, en un trabajo complementario, la sincronización solo asintótica. No todas las fuentes permiten identificar el estado con una palabra finita.
La distinción entre conocer el modelo y conocer su estado actual debe mantenerse al evaluar la precisión de un predictor.
228.8. Misma memoria, diferente accesibilidad de la información
Los dos ejemplos tienen la misma complejidad estadística y la misma tasa de entropía. La entropía excedente permite distinguir cuánto de esa memoria se comparte entre pasado y futuro.
En el proceso que prohíbe ceros consecutivos, el último símbolo determina el estado. Al ser de primer orden, la entropía excedente es la entropía marginal menos la tasa de entropía.
La entropía marginal coincide aquí con 0,918296 bits y la tasa es dos tercios, de modo que E vale aproximadamente 0,251629 bits.
La diferencia entre memoria de estado e información compartida es dos tercios de bit. El futuro no permite recuperar siempre con certeza el último símbolo del pasado.
En el proceso par ocurre algo diferente. Observemos el futuro desde la frontera temporal hasta su primer cero. El número de unos anteriores a ese cero revela el estado en la frontera.
Si ese número es par, el estado inicial era A; si es impar, era B. La aparición eventual de un cero tiene probabilidad uno para las probabilidades elegidas.
Así, el futuro completo permite reconstruir el estado inicial casi seguramente. La entropía condicional del estado dado el futuro es cero y E coincide con C_mu.
Obtenemos aproximadamente 0,918296 bits de entropía excedente para el proceso par. La misma cantidad de memoria es más accesible a través de las observaciones futuras.
| Cantidad | Sin ceros consecutivos | Proceso par |
|---|---|---|
| Complejidad estadística | 0,918296 bits | 0,918296 bits |
| Tasa de entropía | 0,666667 bits/símbolo | 0,666667 bits/símbolo |
| Entropía excedente | 0,251629 bits | 0,918296 bits |
| Diferencia C_mu menos E | 0,666667 bits | 0 bits |
La tabla no sustituye la explicación estructural. La diferencia proviene de qué restricciones conectan el estado presente con las palabras futuras.
Ninguna de estas cantidades permite juzgar si uno de los procesos es mejor o más adaptativo, porque describen propiedades informacionales de dos mecanismos definidos.
Un estudio aplicado puede necesitar precisamente distinguir cuánta memoria requiere la predicción y cuánta puede identificarse a partir de las observaciones. Las máquinas permiten calcular y explicar ambas cantidades sin reducir toda organización a una sola cifra.
228.9. Construir y comprobar una representación
Cuando proponemos una máquina para un proceso conocido, debemos verificar primero sus transiciones y la distribución que genera. Las probabilidades salientes de cada estado deben ser compatibles con una ley normalizada.
Después comprobamos si los estados son predictivamente distintos. Dos estados con las mismas probabilidades del próximo símbolo podrían diferir en palabras más largas, por lo que no basta comparar una sola fila de emisiones.
La unifilaridad se comprueba por pares de estado y símbolo; ningún par puede tener dos destinos diferentes con probabilidad positiva.
Si existe un estado que nunca se visita bajo la distribución considerada, debemos distinguirlo de los estados recurrentes que contribuyen a las medidas estacionarias.
Un modelo puede incluir estados transitorios útiles para describir el inicio de un experimento. Su presencia no debe mezclarse automáticamente con la complejidad estadística del régimen estacionario.
Las probabilidades de palabras permiten contrastar el modelo con restricciones conocidas. Para el proceso par, cualquier palabra que contenga dos ceros separados por un número impar de unos debe tener probabilidad cero.
Para el otro ejemplo basta la restricción local de ausencia de 00. Ambas condiciones pueden verificarse sobre palabras generadas y mediante cálculo exacto de probabilidades.
Un simulador necesita además seleccionar el estado inicial. Empezar siempre en A produce un régimen inicial distinto del proceso estacionario, aunque las transiciones posteriores sean correctas.
Podemos iniciar con la distribución estacionaria o estudiar explícitamente el transitorio. Eliminar algunos pasos iniciales es una aproximación que exige evaluar cuánto tarda la distribución en acercarse al régimen de interés.
La inferencia desde datos añade incertidumbre sobre estructura y parámetros. Un grafo que reproduce una muestra puede contener estados inventados para absorber fluctuaciones o fusionar estados que los datos no permiten distinguir.
Por eso necesitamos validar probabilidades y predicciones fuera de la muestra usada para construirlo. Las restricciones estructurales también pueden examinarse, sin olvidar los errores de medición.
Si aparecen palabras que el modelo declara imposibles, debemos investigar si falla la estructura, si hay ruido o si cambió la representación del registro.
En sentido inverso, no observar una palabra en una muestra finita no demuestra que su probabilidad sea cero. Puede ser rara y requerir un registro mucho más largo para aparecer. Convertir todos los conteos nulos en prohibiciones estructurales puede producir una máquina artificialmente restrictiva. Una evaluación debe distinguir los ceros establecidos por el mecanismo de los ceros derivados únicamente del muestreo y examinar cómo esa elección afecta las predicciones posteriores.
Asignar pequeñas probabilidades a todo evita ceros numéricos, pero modifica la hipótesis. El suavizado debe acompañarse de una interpretación sobre qué incertidumbre o mecanismo adicional representa.
Una máquina útil combina una estructura comprensible con probabilidades contrastables. Su valor depende de esa correspondencia y es independiente de la complejidad visual del grafo.
228.10. De los estados a la organización de secuencias
Las máquinas épsilon convierten la equivalencia predictiva en una dinámica explícita. Indican qué memoria se conserva y cómo cada observación la actualiza.
La unifilaridad distingue incertidumbre sobre el símbolo de incertidumbre sobre el destino una vez conocido ese símbolo. La sincronización distingue conocer la ley de conocer el estado actual.
Los ejemplos muestran que dos estados pueden representar memoria de último símbolo o memoria de paridad. El mismo tamaño y la misma distribución estacionaria no determinan la estructura temporal.
También muestran que un proceso de estados finitos puede tener orden de Markov infinito en sus observaciones. Resumir una historia mediante una función puede ser mucho más eficiente que conservar una ventana literal.
Las matrices etiquetadas permiten calcular probabilidades de palabras y las distribuciones de estados permiten calcular memoria. Ambas partes deben mantenerse para comprender el proceso.
La tasa de entropía describe la novedad que permanece al conocer el estado. La entropía excedente describe información compartida a través de la frontera temporal. Sus diferencias se explican mediante la estructura de la máquina.
El alcance de estas cantidades es la organización predictiva de un proceso observado bajo una representación definida. Sin información adicional no identifican causalidad de intervención; tampoco equivalen a medidas universales de función biológica o social.
Cuando la ley es conocida, podemos verificar las afirmaciones algebraicamente. Cuando debemos aprenderla, necesitamos reconocer límites de muestra, errores de medición y decisiones de selección.
El siguiente capítulo abordará esa inferencia. Pasaremos de máquinas propuestas por construcción a procedimientos que buscan estados a partir de secuencias, con atención a qué condiciones permiten confiar en la reconstrucción.
En ese paso habrá que recordar que una definición exacta del objeto buscado no garantiza que una muestra finita permita identificarlo de manera única.
Referencias
- Shalizi, C. R., y Crutchfield, J. P. (2001). Computational Mechanics: Pattern and Prediction, Structure and Simplicity. Journal of Statistical Physics, 104, 817–879. DOI: 10.1023/A:1010388907793.
- Ellison, C. J., Mahoney, J. R., y Crutchfield, J. P. (2009). Prediction, Retrodiction, and the Amount of Information Stored in the Present. Journal of Statistical Physics, 136, 1005–1034. DOI: 10.1007/s10955-009-9808-z.
- Travers, N. F., y Crutchfield, J. P. (2011). Exact Synchronization for Finite-State Sources. Journal of Statistical Physics, 145, 1181–1201. DOI: 10.1007/s10955-011-0342-4.
- Travers, N. F., y Crutchfield, J. P. (2011). Asymptotic Synchronization for Finite-State Sources. Journal of Statistical Physics, 145, 1202–1223. DOI: 10.1007/s10955-011-0349-x.