COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 22. Información temporal, multivariada y entre escalas
212.1. Qué parte del pasado sigue siendo útil
La tasa de entropía describe la incertidumbre nueva por observación después de usar la historia disponible. Ahora preguntaremos cuánta información comparte esa historia con la continuación del proceso. El interés se extiende del siguiente símbolo a un bloque futuro o a todo el futuro.
Una señal independiente puede producir mucha incertidumbre nueva, pero su pasado no ayuda a predecir las observaciones siguientes. Una señal periódica puede producir poca incertidumbre nueva y, sin embargo, exigir que el observador identifique una fase para anticipar su continuación. Tasa y memoria predictiva describen aspectos diferentes.
Imaginemos que observamos un sistema durante un tiempo y después perdemos acceso al registro anterior. Si la historia contenía información útil para pronosticar, el olvido empeora nuestras probabilidades sobre lo que viene. La información mutua entre pasado y futuro cuantifica esa diferencia promedio bajo un modelo especificado.
No mide necesariamente cuántos bytes guardaba el observador; un archivo puede contener detalles del pasado que no dicen nada sobre el futuro. Tampoco fija la cantidad de parámetros del programa usado para predecir, porque programas diferentes pueden representar la misma relación predictiva con costos distintos.
El término información predictiva requiere especificar ventanas. Puede referirse a un pasado y un futuro finitos, a una ventana finita comparada con un futuro ilimitado o al límite de ambas mitades temporales. Esas cantidades están relacionadas, pero no son iguales para todos los tamaños.
En procesos estacionarios discretos, el exceso de entropía conecta esa relación entre mitades temporales con la convergencia de la entropía de bloques. Crutchfield y Feldman estudian esa conexión; Bialek, Nemenman y Tishby relacionan información predictiva y aprendizaje de modelos. Aquí distinguiremos cuidadosamente las definiciones antes de interpretar ejemplos.
Usaremos procesos de alfabeto finito, con entropías de bloques finitas, aunque algunos límites podrán divergir. Que cada observación tenga pocos valores posibles no obliga a que toda la información compartida entre dos historias infinitas sea finita.
Sin pretender una clasificación universal de complejidad, el objetivo será identificar qué recuerda estadísticamente una historia sobre su continuación, cuánto contexto necesita una medida para detectarlo y qué mecanismos diferentes pueden producir esa memoria.
212.2. Cortar una secuencia en dos ventanas
Fijemos un corte temporal. El pasado contiene las observaciones anteriores al corte y el futuro comienza inmediatamente después. Si sus longitudes son dos enteros positivos, definimos
Esta cantidad mide la reducción promedio de incertidumbre sobre el bloque futuro al conocer el bloque pasado. Por simetría de la información mutua, también puede interpretarse como reducción de incertidumbre sobre el pasado al conocer ese futuro, aunque la simetría matemática no invierte la disponibilidad temporal de datos para un predictor.
Para un proceso estacionario, las entropías de bloques dependen de su longitud; si la indicamos con un subíndice, obtenemos
Como la pareja formada por ambos bloques es un bloque contiguo más largo, su entropía conjunta aparece en el último término. Si dejamos un intervalo sin observar entre pasado y futuro, la expresión requiere otra distribución.
Con ventanas iguales queda
La fórmula es cómoda para cálculos, pero exige que las entropías provengan del mismo proceso. Combinar una entropía pasada de una población con una futura de otra puede producir una cantidad que ya no sea una información mutua.
Aumentar una ventana manteniendo fija la otra no puede disminuir la información mutua verdadera. Las observaciones adicionales pueden ser inútiles, pero siempre podríamos ignorarlas. Esta monotonía se deriva de la regla de la cadena y de la no negatividad de la información condicional.
La propiedad vale para cantidades poblacionales. Estimadores calculados con diferentes muestras, regularizaciones o modelos pueden no respetarla exactamente. Una caída empírica al aumentar la ventana requiere revisar tanto el proceso como el procedimiento de estimación.
Para interpretar un resultado necesitamos conocer ambas longitudes. Una dependencia que requiere varias observaciones futuras puede no aparecer al estudiar únicamente la siguiente; del mismo modo, una historia demasiado corta puede dejar sin identificar un estado predictivo importante.
La expresión también tiene una interpretación de codificación ideal. Conocer el pasado permite reducir la longitud esperada necesaria para describir el bloque futuro, si el código usa las probabilidades condicionales correctas. La reducción teórica es la información mutua; en un archivo implementado, los costos de aprender y describir el modelo deben considerarse aparte.
212.3. Del crecimiento de bloques al exceso de entropía
Recordemos que los incrementos de entropía de un proceso estacionario finito descienden hacia su tasa. La diferencia entre cada incremento y la tasa es la incertidumbre adicional debida a disponer de un contexto todavía limitado.
Sumando esas diferencias definimos
La suma puede ser finita o infinita. Como sus términos son no negativos bajo las condiciones indicadas, no hay cancelaciones arbitrarias. Si la convergencia de los incrementos es lenta, muchas pequeñas diferencias pueden acumular una cantidad grande.
La suma parcial puede escribirse de forma equivalente como
Cuando el límite es finito, la entropía de un bloque largo se comporta como una contribución proporcional a su longitud, cuya pendiente asintótica es la tasa, más un término que tiende al exceso de entropía y no crece proporcionalmente al tamaño.
Podemos demostrar la interpretación predictiva manteniendo primero fijo el pasado. En la identidad de las dos ventanas, la diferencia entre la entropía del bloque largo y la del futuro es solo la suma de un número fijo de incrementos, situados cada vez más lejos en la secuencia de longitudes.
Al hacer crecer el futuro, cada uno de esos incrementos tiende a la tasa, de modo que
Si después hacemos crecer también el pasado, obtenemos el exceso de entropía como información mutua entre las dos mitades temporales infinitas, interpretada mediante esas aproximaciones finitas.
Para un pasado finito, su información sobre todo el futuro es igual a la entropía del bloque menos su longitud por la tasa, mientras que su información sobre un futuro igualmente corto puede ser menor. No debemos intercambiar ambas cantidades solo porque sus límites finales coincidan.
También existen convenciones distintas para cantidades finitas llamadas exceso de entropía. Crutchfield y Feldman usan una aproximación que resta la longitud multiplicada por el incremento de entropía a esa misma longitud. Aquí restamos la tasa límite verdadera y llamamos F al resultado. Las dos expresiones difieren antes de alcanzar el régimen asintótico; al comparar fórmulas debe comprobarse qué pendiente se usa.
Si el exceso es infinito, no podemos describir la entropía de bloques como una recta más una constante finita. Puede existir una contribución que crece sin límite, aunque más despacio que la longitud. La tasa seguirá capturando el término dominante y dejará fuera ese crecimiento adicional.
Esta observación reaparecerá al estudiar el aprendizaje de parámetros. Un proceso puede generar incertidumbre nueva a una tasa estable y, al mismo tiempo, permitir que historias cada vez más largas compartan más información sobre una característica persistente.
212.4. Tres ejemplos que separan tasa y memoria
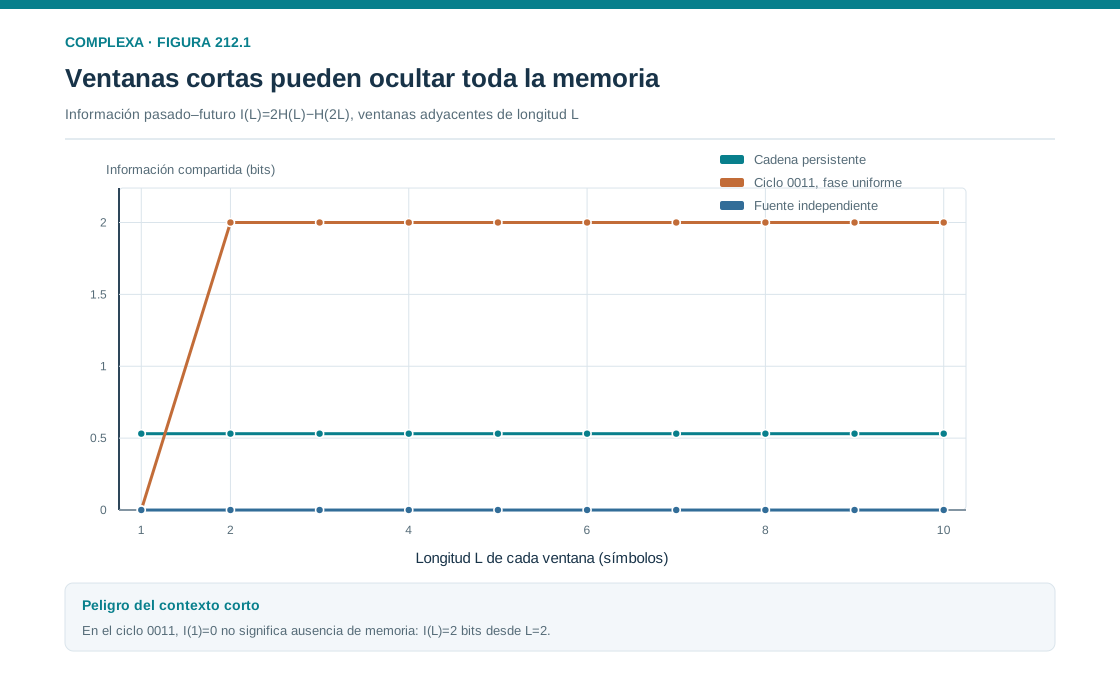
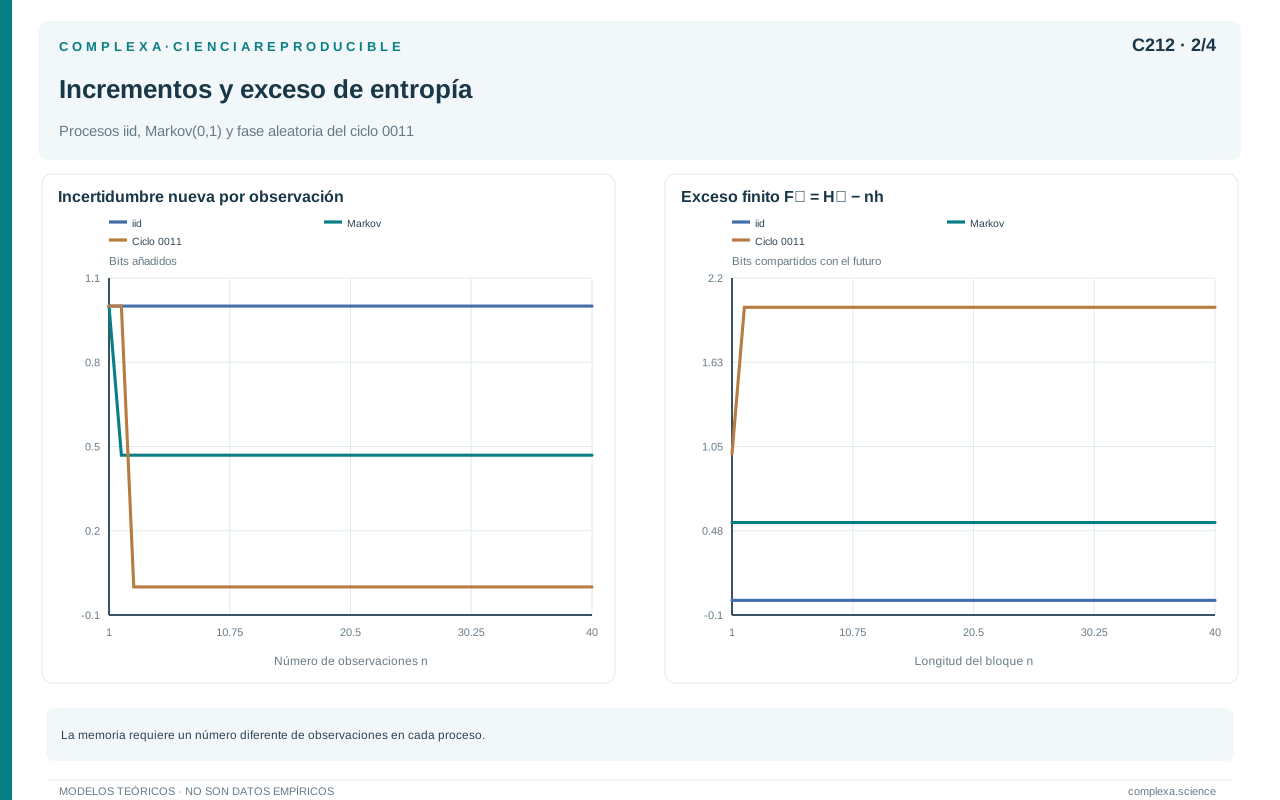
En una fuente independiente e idénticamente distribuida, la entropía del bloque es su longitud por la entropía de una observación. Al sustituirla en la expresión de dos ventanas, todos los términos se cancelan y la información predictiva es cero para cualquier par de ventanas separadas por el corte.
Esto vale tanto para una moneda equilibrada como para una muy sesgada. Sus tasas son distintas, pero en ninguna el pasado modifica las probabilidades futuras cuando el parámetro de la fuente ya está especificado. Una frecuencia desigual no implica memoria temporal.
Consideremos ahora la cadena binaria estacionaria que cambia con probabilidad una décima. Su entropía de bloque es un bit inicial más la entropía de las transiciones restantes. Al sustituirla se obtiene
Aquí, cualquier pasado y futuro contiguos de longitud al menos uno comparten esa misma información. El último estado pasado y el primer estado futuro contienen toda la conexión entre las ventanas; las observaciones más alejadas no añaden otra conexión una vez conocidos esos estados.
La cadena con probabilidad de cambio de nueve décimas tiene el mismo exceso. Persistencia y alternancia pueden diferir en su forma temporal y coincidir en estas cantidades escalares. Ni la tasa ni el exceso bastan para identificar la regla completa de transición.
Volvamos al proceso periódico cero-cero-uno-uno con fase uniforme. Su tasa es cero. La entropía de una observación es un bit y la de cualquier bloque de longitud al menos dos es dos bits. El exceso de entropía es, entonces, dos bits; la fase determina tanto el pasado como el futuro.
Sin embargo, con un símbolo a cada lado del corte la información mutua es cero, porque las parejas vecinas son equiprobables. Dos símbolos a cada lado ya comparten los dos bits de fase. La memoria existe, pero una comparación demasiado corta no la detecta.
La información de un único símbolo pasado sobre todo el futuro es un bit. Esto difiere tanto del cero obtenido con un único símbolo futuro como de los dos bits obtenidos con un pasado suficientemente largo. Las tres respuestas son correctas porque las preguntas usan ventanas distintas.
Para un proceso periódico de período mínimo finito, con fase uniforme y fases distinguibles al observar suficientes símbolos, el exceso es el logaritmo del período. Una periodicidad más larga puede requerir más información inicial sin producir una tasa positiva de incertidumbre nueva.
Estos casos muestran por qué describir una señal como más compleja exige especificar el criterio. La moneda independiente maximiza novedades impredecibles; el patrón periódico conserva fase; la cadena combina novedades y dependencia. Una sola ordenación no expresa todas esas diferencias.
212.5. Cuánto aporta ampliar el contexto
Los incrementos de entropía permiten localizar dónde aparece una ganancia predictiva. La diferencia entre dos incrementos consecutivos mide cuánto ayuda una observación pasada adicional cuando ya conocemos el contexto más reciente.
Para una formulación estacionaria apropiada, esa diferencia puede escribirse como la información mutua entre la observación que queremos predecir y un símbolo más lejano, condicionada al bloque intermedio. En general no equivale a la información mutua simple entre los extremos.
En el patrón periódico anterior, la observación inmediata pasada no reduce la incertidumbre sobre la siguiente, pero al añadir la observación situada dos pasos atrás la incertidumbre cae a cero. Esa información adicional se pierde si evaluamos únicamente vecinos.
Una señal con orden de Markov finito alcanza su tasa en cuanto el contexto incluye las observaciones necesarias. Si el orden es como máximo un entero determinado, los incrementos posteriores son constantes y el exceso puede calcularse mediante
para una longitud de contexto suficiente. La expresión exige que sea de Markov el propio proceso observado; no sirve que lo sea un estado oculto que no medimos.
En una señal con estados ocultos, la predicción puede mejorar gradualmente al ampliar la historia sin alcanzar una igualdad exacta en ninguna longitud finita. Esto no implica que el exceso sea infinito, porque una secuencia de mejoras cada vez menores puede tener suma finita.
Tampoco la existencia de memoria a retardos largos implica una gran cantidad de información compartida, ya que puede persistir una dependencia extremadamente pequeña. Para evaluar su importancia necesitamos considerar magnitud, incertidumbre de estimación y efecto sobre la pregunta predictiva.
Un procedimiento práctico puede comparar modelos de distintas memorias mediante su pérdida probabilística sobre datos nuevos. Esa evaluación, distinta del cálculo del límite informacional de un modelo conocido, pregunta si el contexto adicional se transforma en mejores predicciones realizables con la muestra disponible.
Si una memoria más larga empeora la predicción empírica, eso no refuta la monotonía de la información verdadera. El modelo puede haber sobreajustado, estimado mal contextos raros o añadido parámetros cuya incertidumbre supera la ganancia potencial.
Hay que distinguir entre información disponible y capacidad de usarla. Un pasado puede contener una regularidad que ningún algoritmo probado haya aprendido todavía. También puede ocurrir que un algoritmo parezca aprovecharla porque recibió información futura durante el entrenamiento. La evaluación debe separar ambas situaciones.
El exceso de entropía describe la dependencia global. La curva de convergencia lo complementa al mostrar cómo se distribuye esa dependencia entre escalas de contexto. Dos procesos pueden compartir el mismo exceso y necesitar longitudes muy diferentes para revelarlo.
212.6. Información compartida y memoria de un modelo
Supongamos que un estado interno separa estadísticamente pasado y futuro, de modo que, una vez conocido ese estado, la historia anterior no añade información sobre la continuación. Si el estado es discreto, la información compartida entre las dos mitades no puede superar su entropía.
La cota se sigue del procesamiento de datos, ya que el estado es un intermediario suficiente para la dependencia entre pasado y futuro. Que exista ese intermediario, sin embargo, no significa que toda la información de su representación pueda recuperarse observando el futuro.
En la cadena binaria persistente, el último símbolo pasado es un estado de ese tipo. Su entropía es un bit, mientras que el exceso es aproximadamente 0,531 bits. La diferencia aparece porque la transición siguiente es ruidosa y parte de la incertidumbre sobre aquel estado no queda identificada por la continuación.
Por la propiedad de Markov, si conocemos el primer estado futuro, los estados posteriores no añaden información sobre el último estado pasado. Observar un futuro interminable no permite deshacer automáticamente una transición aleatoria ocurrida en el corte.
Podemos aumentar artificialmente la memoria del modelo adjuntando un bit independiente que no influye en ninguna predicción. La entropía del estado representado aumenta, pero el exceso del proceso observado permanece igual. Por eso el tamaño de una implementación no es una medida intrínseca de información predictiva.
También puede haber representaciones redundantes que usan varios estados internos para la misma distribución de futuros. Una descripción predictiva más económica agruparía historias que generan idénticas probabilidades de continuación. Esos estados se estudiarán sistemáticamente en la mecánica computacional, en capítulos posteriores.
En un modelo oculto con un número finito de estados, si el estado en el corte hace condicionalmente independientes pasado y futuro, el exceso queda acotado por el logaritmo del número de estados. Sin embargo, el proceso observado puede requerir historias de longitud arbitraria para aproximar su predicción óptima.
Así, orden de memoria infinito y cantidad infinita de información predictiva no son equivalentes. El observador puede necesitar acumular evidencia durante mucho tiempo para estimar un estado que contiene poca información discreta. La dificultad de sincronización y la cantidad de dependencia son propiedades distintas.
No toda variable denominada estado cumple la separación requerida. Un resumen elegido por comodidad puede omitir aspectos de la historia que todavía afectan al futuro. Antes de usar la cota, debemos comprobar la independencia condicional o justificarla mediante el mecanismo generador.
Comparar la información compartida con la memoria interna evita dos errores opuestos, el de suponer que toda memoria almacenada es predictivamente útil y el de suponer que toda información predictiva puede conservarse con el mismo número de bits en cualquier implementación práctica.
212.7. Una característica persistente puede crear memoria
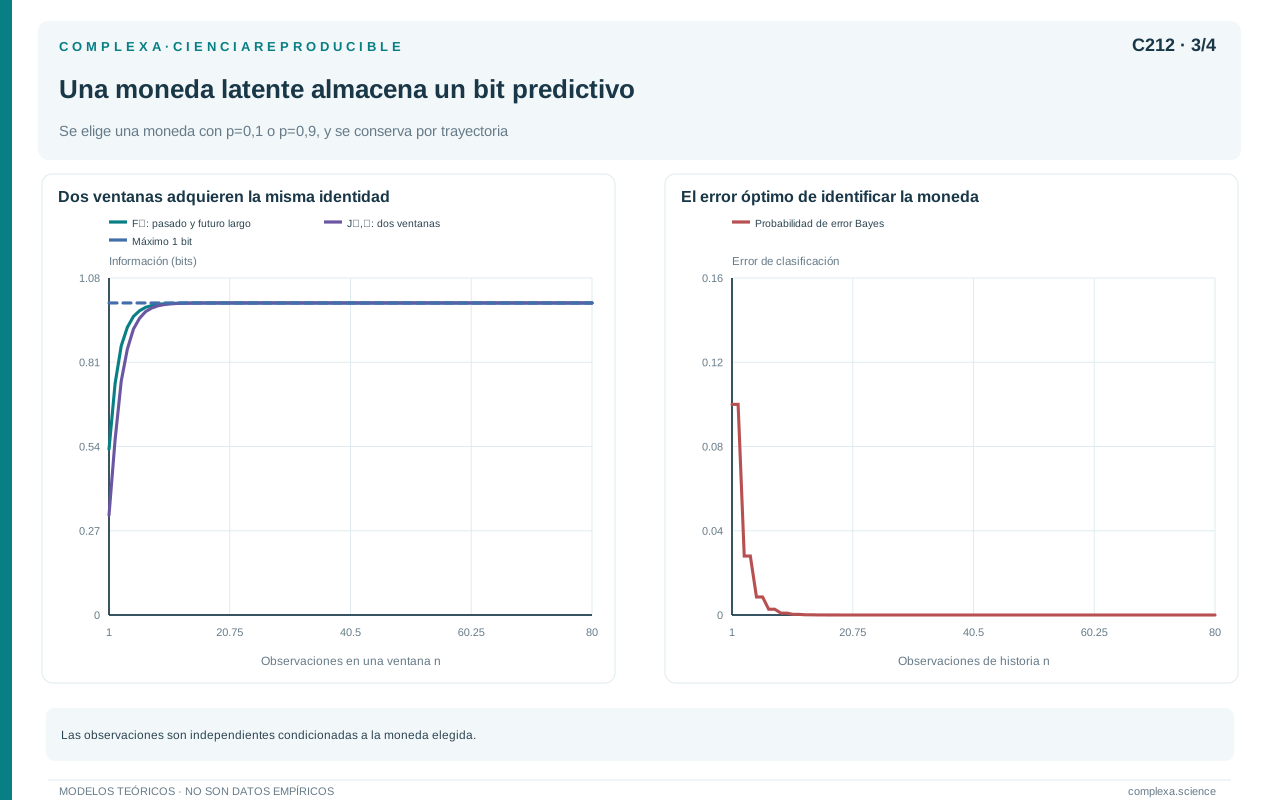
La dependencia entre pasado y futuro no necesita surgir de interacciones directas entre observaciones sucesivas. Puede aparecer porque ambas mitades informan sobre una característica común que permanece fija durante la realización.
Tomemos una variable que selecciona una de dos monedas, una que produce unos con probabilidad una décima y otra que los produce con probabilidad nueve décimas. La selección es equiprobable y después los lanzamientos son independientes si conocemos la moneda elegida.
Como pasado y futuro son condicionalmente independientes dada esa selección, su información mutua no puede superar un bit, la entropía de la variable que identifica la moneda. Historias suficientemente largas en ambas direcciones permiten identificarla con probabilidad de error cada vez menor.
En el límite, el exceso de entropía es un bit, mientras que la tasa permanece en la entropía binaria de una décima. Aquí la memoria predictiva es conocimiento compartido sobre el tipo de fuente; ningún lanzamiento influye en el siguiente.
Si comunicamos previamente al observador qué moneda se usa, desaparece esa información compartida adicional, porque dentro de cada componente las dos mitades son independientes. La descripción conjunta de la mezcla y la descripción condicionada a la identidad responden a preguntas distintas.
El ejemplo se aplica a registros de varias unidades. Si cada unidad tiene un parámetro estable distinto, las observaciones previas ayudan a inferirlo y, con ello, a anticipar observaciones futuras. La memoria aparente puede reflejar heterogeneidad entre unidades.
Combinar registros sin conservar su identidad puede añadir o alterar dependencias. Separarlos no siempre es la solución completa, porque la identidad también puede ser información legítimamente disponible para el predictor. Debemos decidir a qué escenario de predicción corresponde el análisis.
Una permutación temporal dentro de cada unidad conserva la dependencia debida a su parámetro persistente, aunque elimine otras formas de organización del orden. Una permutación que mezcla unidades modifica además la estructura de heterogeneidad, de modo que no es el mismo control.
Un exceso positivo tampoco implica que exista una memoria física localizada en un componente observable. En este modelo, la variable latente organiza toda la distribución. Para atribuirle un mecanismo material necesitaríamos información adicional sobre cómo se genera y mantiene.
Una información predictiva positiva demuestra dependencia entre las variables temporales definidas bajo una distribución, pero su origen puede ser dinámico, estructural, de mezcla o de observación. La medida permite formular la pregunta, pero elegir una explicación causal requiere otra información.
212.8. Aprender un parámetro continuo
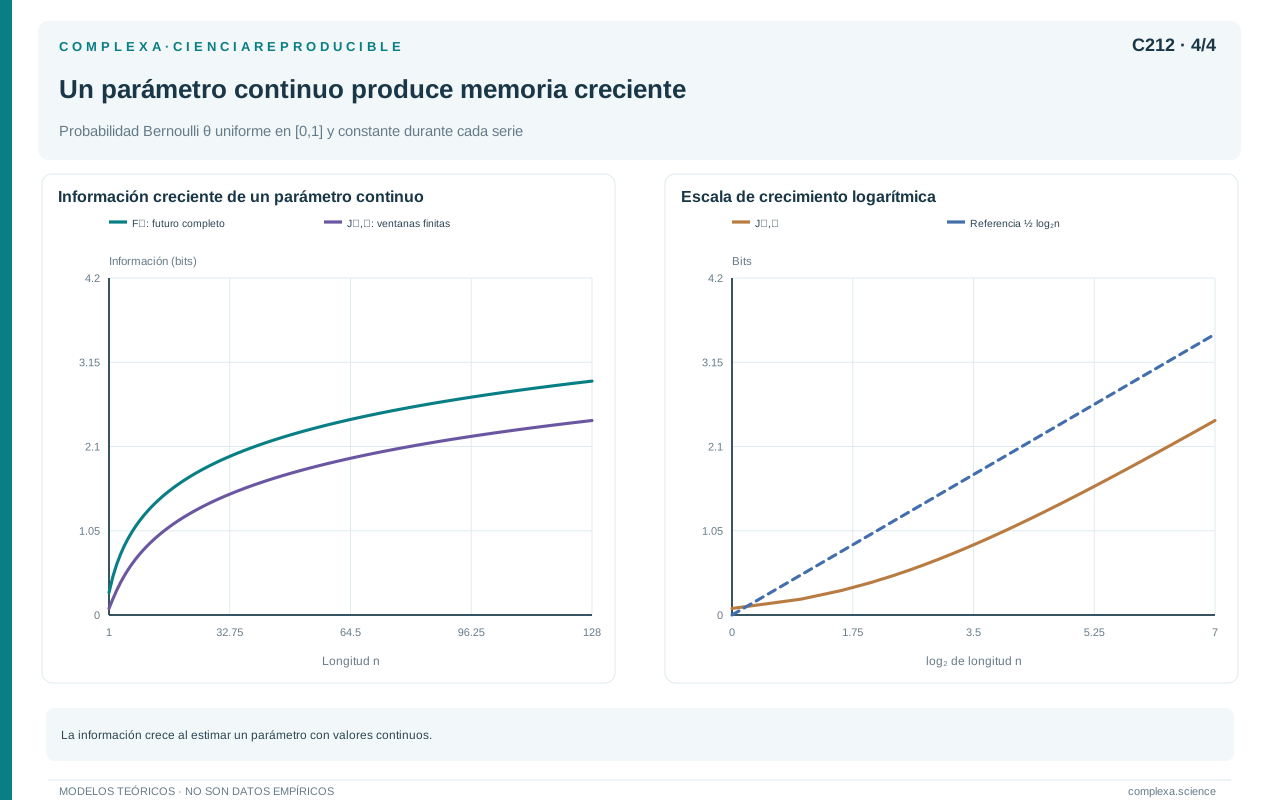
Podemos ampliar el ejemplo a una familia continua de monedas eligiendo una probabilidad de uno de manera uniforme entre cero y uno al comienzo de cada realización. Después generamos lanzamientos independientes condicionados a ese parámetro.
La probabilidad de cualquier secuencia concreta depende únicamente de su número de unos. Al integrar sobre el parámetro uniforme se obtiene
cuando la secuencia contiene exactamente un número de unos indicado por el índice del coeficiente binomial. El conteo total de unos es uniforme entre cero y la longitud del bloque y, dentro de cada conteo, todas las secuencias son equiprobables.
Esta estructura permite calcular exactamente la entropía de bloques, que es
La tasa es el promedio de las entropías binarias de las monedas posibles; la integral correspondiente vale aproximadamente 0,721348 bits por lanzamiento. Una historia larga permite conocer el parámetro con precisión creciente, pero los lanzamientos mantienen aleatoriedad condicionada a él.
Calculemos dos cantidades. La primera compara un pasado de longitud dada con todo el futuro; la segunda compara dos ventanas de esa misma longitud.
| Longitud | Información con todo el futuro | Información entre ventanas iguales |
|---|---|---|
| 1 | 0,278652 bits | 0,081704 bits |
| 4 | 0,753531 bits | 0,401394 bits |
| 16 | 1,514554 bits | 1,067728 bits |
| 64 | 2,431418 bits | 1,947933 bits |
| 256 | 3,405928 bits | 2,910760 bits |
La diferencia entre columnas es la información que un futuro más largo todavía puede aportar. Ambas crecen porque cada mitad ayuda a precisar el parámetro compartido. No hay interacción causal entre lanzamientos una vez conocido ese parámetro.
En este modelo regular de un parámetro, el crecimiento dominante de la información predictiva es la mitad del logaritmo de la longitud, más términos menores respecto de ese crecimiento. No debemos trasladar ese coeficiente a cualquier modelo, porque redundancias paramétricas, singularidades, cambios de distribución y restricciones pueden modificar las condiciones.
Los análisis de Bialek y colaboradores relacionan este tipo de crecimiento con aprendizaje en familias de modelos y estudian otros regímenes. Para nuestro propósito basta saber que una información predictiva sin cota finita puede surgir al aprender con precisión creciente una característica continua persistente.
No hay contradicción con el alfabeto binario de las observaciones. Cada símbolo contiene como máximo un bit, pero una historia ilimitada puede acumular evidencia sobre un parámetro con infinitos valores posibles. Tampoco podemos acotar esa información por la entropía diferencial de una uniforme, que vale cero en esta coordenada; la cota mediante entropía del estado discreto no se traslada así a variables continuas.
El crecimiento no prueba una dinámica caótica ni una jerarquía ilimitada de interacciones temporales. En este ejemplo procede de incertidumbre sobre un único parámetro común. Interpretar una divergencia exige identificar el mecanismo que puede generarla.
212.9. Dificultades al estimar información predictiva
Las expresiones de este capítulo se calcularon para procesos definidos. En datos finitos, estimar distribuciones de bloques largos es difícil porque el número de categorías posibles aumenta rápidamente. Una comparación entre dos ventanas de longitud determinada puede requerir estimar bloques del doble de longitud.
Al restar entropías estimadas, sus sesgos no se cancelan necesariamente; pueden diferir entre longitudes y producir una información predictiva aparente. Si los cálculos usan conjuntos de datos distintos, tampoco queda garantizada la coherencia de marginales y distribuciones conjuntas.
En la expresión basada en la tasa hay otra dificultad, porque un pequeño error en la tasa se multiplica por la longitud del bloque. Si subestimamos la tasa, podemos producir un crecimiento aparente de la diferencia entre entropía y término lineal, incluso cuando el exceso verdadero es finito.
Por ejemplo, un error constante de una centésima de bit por observación añade artificialmente un bit a esa diferencia en una ventana de cien observaciones y diez bits en una de mil. Una curva creciente puede deberse a ese error acumulado, sin que exista memoria de largo alcance.
Para evaluar saturación o divergencia necesitamos comprobar estabilidad respecto de métodos, tamaños y supuestos. Un rango corto puede ser compatible con varias formas funcionales. Una recta ajustada en escala logarítmica es, a lo sumo, un indicio de una ley asintótica.
La no estacionariedad puede introducir dependencias adicionales. Si el proceso cambia lentamente de régimen, ventanas cercanas comparten información sobre el momento o la condición. Esa información puede ser relevante para predecir, pero no corresponde necesariamente a la memoria de un proceso estacionario único.
Los controles por reordenamiento deben conservar las propiedades que no queremos alterar. Mezclar todos los símbolos destruye las dependencias temporales, pero también puede modificar la relación con segmentos, unidades o condiciones. Por eso, un resultado distinto después de mezclar no identifica qué estructura era responsable.
La evaluación predictiva fuera de muestra es una comprobación complementaria, que pregunta si una representación del pasado mejora la distribución asignada a bloques futuros nuevos. Esa ganancia operacional puede ser más estable que una estimación directa de una cantidad límite, aunque responde a un modelo y una ventana concretos.
También hay que distinguir promedio y valor local. Algunas historias particulares pueden reducir poco la incertidumbre y otras pueden volver más incierto un futuro específico. La información mutua es una ganancia promedio no negativa; no garantiza una mejora de todas las decisiones en cada realización.
Un informe debería presentar ventanas, unidades, población, representación, estimador y controles de incertidumbre. Si el exceso se estima como finito, conviene indicar qué evidencia apoya la saturación. Si parece crecer, conviene mostrar qué errores y mecanismos alternativos se han examinado antes de atribuirle un significado amplio.
212.10. Una descripción conjunta de novedad y persistencia
La tasa de entropía y el exceso de entropía permiten separar dos preguntas. La tasa describe la incertidumbre nueva por observación en el límite de contexto amplio; el exceso, la información compartida entre pasado y futuro.
Una fuente independiente puede tener tasa alta y exceso cero; un proceso periódico, tasa cero y exceso positivo. Una cadena ruidosa puede combinar ambos. Una mezcla con parámetro continuo puede tener tasa positiva y exceso divergente sin interacción directa entre observaciones condicionadas al parámetro.
Estas diferencias muestran la utilidad de emplear varias cantidades con interpretaciones claras. También muestran sus límites, porque dos procesos distintos pueden coincidir en tasa y exceso. Ninguna pareja de números sustituye la distribución completa de trayectorias ni una explicación de su mecanismo.
La longitud de memoria necesaria para aproximar una predicción no equivale a la cantidad total de información predictiva. Un estado oculto finito puede producir dependencias observadas de alcance arbitrario. Un parámetro continuo puede producir crecimiento informacional aunque la dinámica condicionada sea independiente.
El significado práctico depende de la tarea. Una historia puede mejorar probabilidades sin cambiar la acción más conveniente bajo una pérdida particular. Otra puede contener poca información promedio, pero resultar decisiva para un evento infrecuente y costoso. La información predictiva debe conectarse con el problema de decisión sin ocupar su lugar.
Cuando se usa como indicador de organización, conviene declarar la representación que hace visible esa organización. El muestreo, la discretización y la elección de variables pueden conservar o descartar dependencias. Una comparación entre sistemas requiere condiciones de observación suficientemente compatibles.
También debemos mantener separadas predicción y causalidad. El pasado ocurre antes que el futuro, pero su relación estadística puede estar mediada por variables comunes o por el instrumento. La dirección temporal orienta el problema predictivo; la explicación causal requiere, además, otra información.
El siguiente capítulo añadirá una segunda serie temporal y preguntará si su pasado contiene información sobre el futuro de una serie objetivo después de considerar la historia de esa misma serie. Esa pregunta conduce a la transferencia de entropía y exige conservar las distinciones que acabamos de establecer entre dependencia, contexto y mecanismo.
Referencias
- Crutchfield, J. P., y Feldman, D. P. (2003). Regularities unseen, randomness observed: Levels of entropy convergence. Chaos, 13(1), 25–54. https://doi.org/10.1063/1.1530990.
- Bialek, W., Nemenman, I., y Tishby, N. (2001). Predictability, Complexity, and Learning. Neural Computation, 13(11), 2409–2463. https://doi.org/10.1162/089976601753195969.
- Shannon, C. E. (1948). A Mathematical Theory of Communication. The Bell System Technical Journal, 27(3), 379–423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x.