COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 22. Información temporal, multivariada y entre escalas
213.1. Añadir una segunda historia
Hasta ahora hemos preguntado cuánto permite el pasado de una serie anticipar su propio futuro. Introduzcamos una segunda serie. La pregunta será si su historia mejora la predicción de la primera una vez considerado lo que ya sabíamos por la historia del objetivo.
Dos señales pueden compartir información porque ambas reflejan una misma evolución, porque una es una copia retrasada de la otra o porque reciben una entrada común. Una asociación entre la primera señal y el futuro de la segunda puede darse, entonces, sin ninguna aportación adicional.
La transferencia de entropía, introducida por Schreiber, usa probabilidades condicionales para formular esa aportación. Compara la distribución del próximo valor del objetivo dada solo su historia con la que se obtiene al añadir la historia de una fuente.
El nombre puede sugerir un flujo material de información. Sin embargo, la transferencia de entropía es una cantidad estadística definida como información mutua condicional entre variables temporales especificadas. Su interpretación causal requiere supuestos adicionales sobre variables observadas, resolución temporal y mecanismo generador.
La dirección procede de la pregunta, en la que elegimos una fuente, un objetivo y un instante futuro del objetivo. Si intercambiamos los papeles, cambiamos las variables y el condicionamiento. Por eso las dos transferencias pueden ser diferentes aunque la información mutua ordinaria sea simétrica.
La cantidad puede detectar aportaciones predictivas que una correlación lineal no muestra, aunque no elimina las dificultades de estimación ni garantiza descubrir cualquier relación con cualquier muestra.
Trabajaremos primero con ejemplos binarios de mecanismo completamente definido, para separar las propiedades de la medida de las afirmaciones sobre datos reales. Después veremos la relación con modelos gaussianos y las condiciones que deben declararse antes de interpretar una dirección.
Durante el capítulo distinguiremos entre cuánto mejora la predicción, qué observaciones producen esa mejora y qué mecanismo explica la dependencia. La transferencia de entropía responde directamente a la primera pregunta en un contexto determinado; las otras requieren analizar cómo se construyó el sistema observado.
213.2. Definición y significado del condicionamiento
Llamemos historia del objetivo a sus últimas observaciones hasta el tiempo actual; la historia de la fuente se define de manera semejante. Para una predicción de un paso definimos
Las longitudes forman parte de la medida. Una transferencia con una observación pasada no es necesariamente la misma cantidad que otra calculada con diez. Tampoco deben omitirse los retardos si la historia de la fuente termina antes del tiempo actual.
En variables discretas, la definición equivale a una diferencia de entropías condicionales
La primera es la incertidumbre que queda al usar la memoria propia elegida y la segunda, la que queda después de añadir la fuente. La diferencia promedia la ganancia bajo la distribución conjunta de todas esas variables.
También puede escribirse como un promedio de logaritmos de razones de probabilidades
La transferencia es no negativa en su definición poblacional y se anula exactamente cuando el futuro del objetivo y la historia de la fuente son condicionalmente independientes dada la historia del objetivo, con las precisiones habituales sobre eventos de probabilidad nula.
No obstante, esa independencia es relativa a las historias elegidas. Si el objetivo necesita más memoria de la que incluimos, la fuente podría aportar una copia de información propia omitida. La ganancia sería real para el predictor restringido, pero su interpretación como influencia entre sistemas requeriría revisión.
La cantidad se expresa en bits por predicción cuando usamos logaritmos de base dos. Convertirla en una tasa por segundo exige definir el intervalo temporal y el procedimiento. La predicción de un bloque futuro es también otra cantidad, aunque pueda construirse con las mismas herramientas.
Si añadimos otras variables al condicionamiento, obtenemos una transferencia condicionada. Esto puede ayudar a examinar explicaciones alternativas, aunque no siempre mejora la interpretación; según la estructura del problema, condicionar puede eliminar dependencias, revelar sinergias o introducir asociaciones por selección.
213.3. Una copia retrasada con ruido
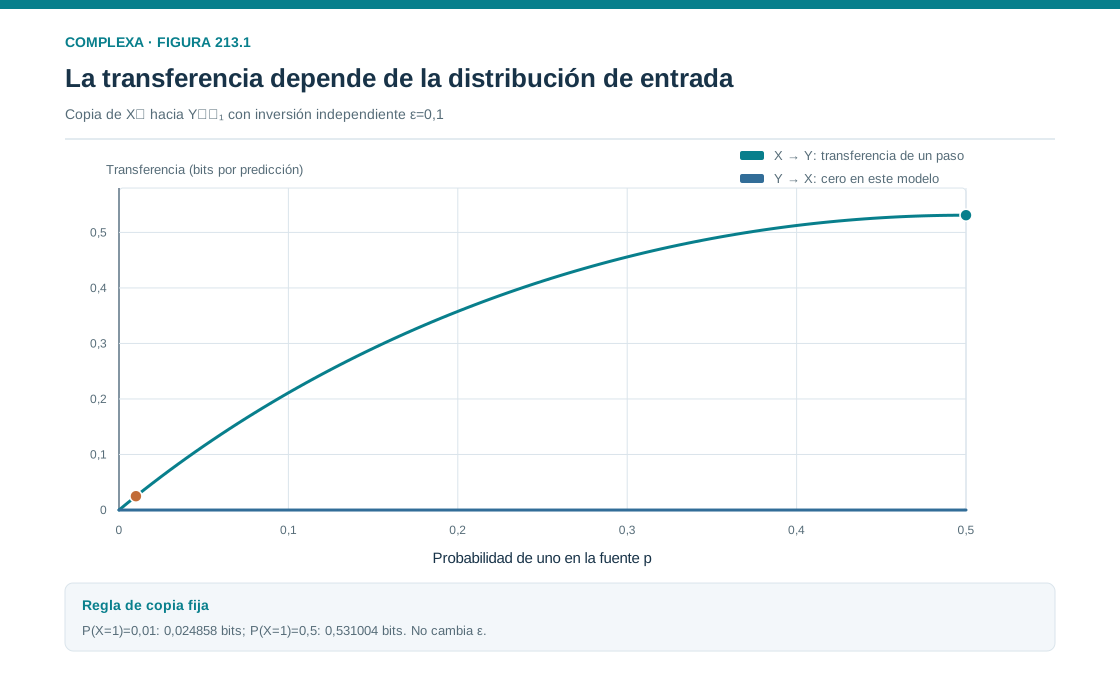
Construyamos una fuente binaria independiente y equiprobable. El objetivo del instante siguiente es una copia del valor actual de la fuente, invertida con probabilidad una décima. Los errores son independientes entre tiempos y de toda la fuente.
El pasado del objetivo informa sobre valores antiguos de la fuente, pero no sobre su valor actual, porque la fuente es independiente entre instantes. Por ello, antes de observar la fuente actual, el siguiente valor del objetivo es equiprobable.
Cuando conocemos la fuente actual, la incertidumbre restante es la del error binario y la transferencia de un paso es
En la dirección inversa, el siguiente valor de la fuente es independiente de todas las historias disponibles. Añadir el pasado del objetivo no modifica su distribución, de modo que la transferencia inversa es cero.
La asimetría coincide aquí con la estructura causal porque hemos definido explícitamente un mecanismo unidireccional y errores independientes. Esa correspondencia no debe generalizarse a un par de señales observadas sin conocer su generación.
Una comparación contemporánea entre fuente y objetivo daría información mutua cero, porque el objetivo actual depende de la fuente del instante anterior, que es independiente de la fuente actual. Si ignoramos el retardo, podríamos pasar por alto la relación.
En cambio, en este ejemplo la información mutua entre la fuente actual y el objetivo siguiente coincide con la transferencia. Coinciden porque la historia del objetivo no aporta información relevante adicional; la igualdad no es una identidad general.
Podemos cambiar la distribución de la fuente manteniendo la misma regla de copia y el mismo ruido. Si la probabilidad de que la fuente valga uno es una centésima, la del objetivo es 0,108 y la transferencia pasa a ser aproximadamente 0,024858 bits.
El mecanismo de inversión es el mismo; lo que varió es cuánta incertidumbre tenía la fuente para aportar. Por tanto, una transferencia menor no implica necesariamente un acoplamiento físico más débil. Puede reflejar una entrada menos variable o una distribución de condiciones diferente.
Tampoco debemos confundir la transferencia observada con la capacidad de un canal. La capacidad es un máximo sobre las distribuciones de entrada admisibles, mientras que aquí evaluamos la distribución concreta que usa el proceso. Un sistema puede operar muy por debajo de su capacidad informacional sin que el mecanismo haya cambiado.
En el ejemplo, el orden temporal, la distribución de entrada y el ruido determinan conjuntamente el valor y su interpretación; ninguno puede sustituirse por una etiqueta general de fuerza de conexión.
213.4. Descontar lo que ya sabe el objetivo
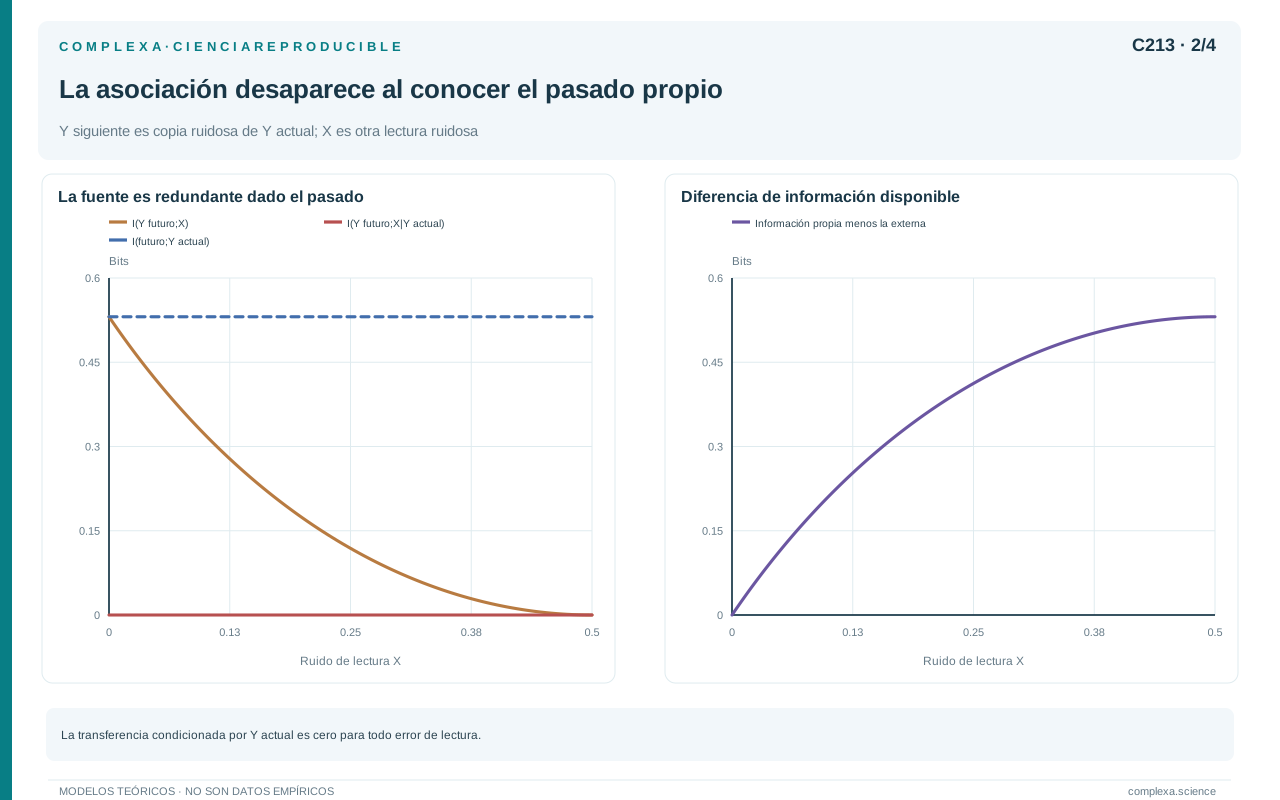
Consideremos una serie objetivo que sigue una cadena binaria persistente (conserva su valor con probabilidad nueve décimas). Definimos ahora la fuente observada como una copia exacta del estado actual del objetivo.
La fuente actual tiene información sobre el futuro del objetivo, porque reproduce su estado presente; la información mutua retrasada es aproximadamente 0,531004 bits. Sin embargo, si el predictor ya recibe el estado actual del objetivo, la copia no añade nada nuevo.
La transferencia calculada con una observación propia es cero, porque su numerador y su denominador asignan las mismas probabilidades al siguiente estado.
Este caso muestra por qué una relación retrasada positiva puede ser insuficiente. El futuro depende del estado presente del objetivo y la fuente refleja ese estado, pero observar ambos no demuestra que modificar la fuente como variable separada altere la transición del objetivo.
Imaginemos ahora que usamos una historia demasiado corta del objetivo en un proceso con memoria de orden dos. Una segunda señal que copie una observación propia más antigua podría mejorar la predicción. La transferencia calculada sería positiva respecto del contexto elegido, aunque la señal no introdujera una nueva causa.
Podemos calcularlo para el patrón periódico cero-cero-uno-uno con fase uniforme. Sea la señal X una copia del objetivo retrasada un paso. Conocer únicamente el objetivo actual deja un bit de incertidumbre sobre su siguiente valor. Añadir X revela el objetivo anterior; con las dos observaciones, la continuación queda determinada.
La transferencia calculada con una sola observación propia es entonces un bit. Si ampliamos la historia del objetivo a dos observaciones, la transferencia se vuelve cero, porque X ya está incluida en el contexto. Solo ha cambiado la información de referencia frente a la que medimos la contribución de X.
La conclusión precisa del primer cálculo es que esa señal ayuda a un predictor al que solo permitimos recordar un paso. De ahí no se sigue que exista una nueva interacción física desde X. El ejemplo explica también por qué estudios con longitudes de historia distintas pueden obtener valores discrepantes sin ningún error aritmético.
Restar automáticamente todas las correlaciones no resuelve el problema. Hay que declarar qué información propia tiene disponible el predictor y justificar si basta para la interpretación buscada. Un contexto finito puede ser una restricción práctica legítima, pero debemos nombrarla.
Tampoco conviene condicionar sin límite en una muestra pequeña, porque aumentar el número de variables genera contextos poco observados y estimaciones inestables. La selección de memoria debe equilibrar conocimiento del mecanismo, cantidad de datos y evaluación predictiva.
En sistemas con observación ruidosa, otra señal puede ayudar a reconstruir el estado real del objetivo. Esa aportación es predictivamente útil aunque no sea un impulso causal desde la señal al sistema.
Como la transferencia compara conjuntos de observaciones, si cambiamos la calidad de los sensores, el filtrado o el contexto disponible, podemos cambiar el resultado sin modificar las interacciones físicas. Un informe debe registrar esas condiciones para no interpretar una mejora instrumental como un cambio de mecanismo.
Al comparar grupos o situaciones experimentales hace falta todavía más cuidado, porque una transferencia más alta puede proceder de distinta variabilidad, distinta memoria propia o distinto ruido de medida. La comparación causal necesita examinar esas alternativas además de calcular el indicador.
213.5. Una influencia que aparece al combinar fuentes de contexto
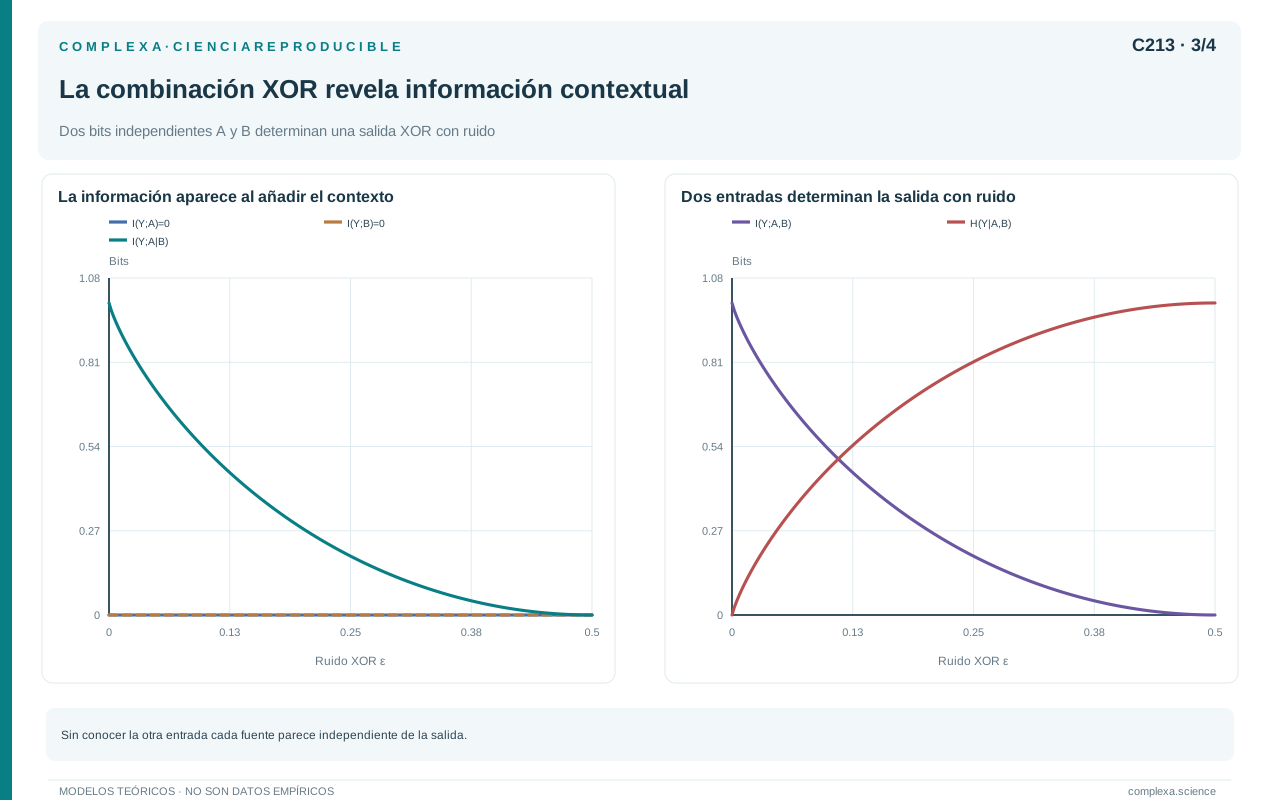
Construyamos una regla binaria diferente, en la que el siguiente estado del objetivo es el XOR de su estado actual y la fuente actual. La fuente produce bits independientes y equiprobables. El estado inicial del objetivo también es equiprobable e independiente.
Si conocemos solo la fuente actual, el siguiente objetivo sigue siendo equiprobable, porque desconocemos el estado previo con el que se combina. Por tanto, la información mutua entre fuente actual y objetivo siguiente es cero.
Si conocemos solo el objetivo actual, tampoco podemos anticipar la siguiente salida, porque falta el bit independiente de la fuente. En cambio, al conocer ambos valores, el siguiente objetivo queda determinado exactamente.
La transferencia vale entonces
Que la información mutua no condicionada sea nula no contradice este resultado, porque la información relevante está en la combinación de las dos entradas.
La regla puede verse como un control de cambio, en el que el objetivo permanece si la fuente vale cero y se invierte si vale uno. Sin conocer el estado previo, saber si hubo inversión no identifica la salida; conocerlo convierte ese mismo bit en información suficiente para predecir.
Añadamos ahora un error independiente que invierta la salida calculada con probabilidad una décima. La incertidumbre con ambas entradas pasa a ser la entropía del error, mientras que la incertidumbre con solo la historia propia sigue siendo de un bit. La transferencia vuelve a ser aproximadamente 0,531004 bits.
El valor coincide con el de la copia retrasada ruidosa, aunque los mecanismos son diferentes. En un caso, la fuente identifica directamente el valor probable de la salida; en el otro, indica cómo transformar el estado previo. Un mismo valor de la cantidad no identifica una única regla generadora.
Este ejemplo prepara el análisis de sinergia entre fuentes. La información condicional atribuida a una fuente puede depender de que otra variable esté presente, de modo que no siempre puede interpretarse como una porción que la fuente poseía de manera aislada.
La transferencia tampoco obedece una ley general de conservación como la de una sustancia. Sumar valores obtenidos para diferentes fuentes puede contar información redundante o tratar de forma distinta información que solo aparece conjuntamente. Para separar esas posibilidades necesitaremos un análisis multivariado explícito.
Una transferencia positiva establece una aportación predictiva adicional bajo el contexto indicado. El ejemplo muestra que esa aportación puede consistir en completar una regla conjunta, sin que la fuente, observada por separado, transporte un contenido identificable.
213.6. Transferencia local y observaciones engañosas
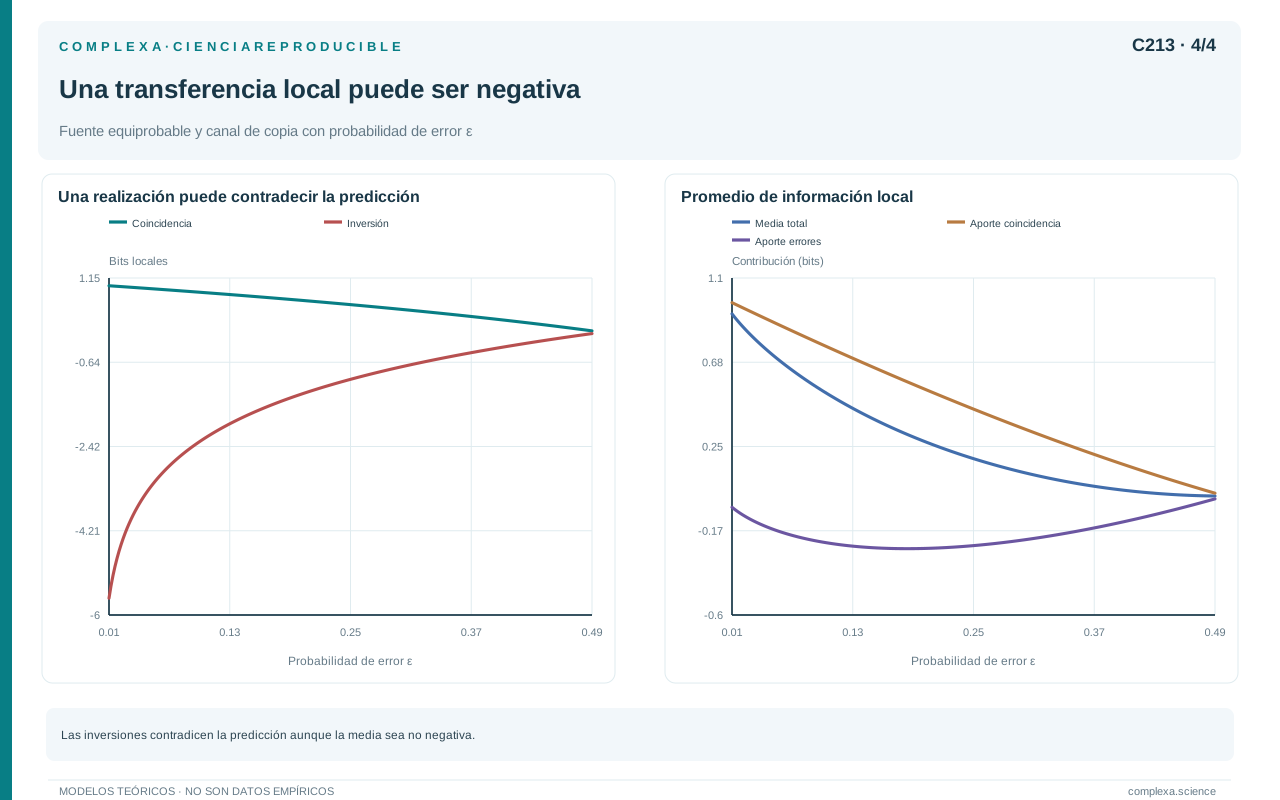
La transferencia promedio puede descomponerse en valores que corresponden a observaciones particulares. El valor local es el logaritmo de la razón entre la probabilidad condicional con fuente y la probabilidad condicional sin ella, evaluadas en la realización observada.
Un valor positivo indica que el predictor con la fuente asignaba más probabilidad al resultado que ocurrió. Uno negativo indica que, en esa realización, la fuente favorecía menos el resultado observado que el predictor basado únicamente en la historia propia.
Volvamos a la copia retrasada con error de una décima y fuente equilibrada. Sin la fuente, cada salida tiene probabilidad una mitad; con ella, la salida que coincide con la copia tiene probabilidad nueve décimas y la que la contradice, una décima.
Cuando la copia acierta, el valor local es
Cuando ocurre una inversión, el valor local es
El promedio ponderado por nueve décimas y una décima da aproximadamente 0,531004 bits. Los episodios negativos no contradicen la no negatividad del promedio; reflejan que una observación informativa puede ser engañosa en algunas realizaciones.
Un valor local negativo tampoco significa necesariamente que la fuente ejerza una acción física inhibitoria. El signo del logaritmo expresa una comparación de probabilidades predictivas. Una influencia causal que reduce una magnitud puede producir valores locales positivos si ayuda a anticipar correctamente esa reducción.
Lizier, Prokopenko y Zomaya desarrollaron el uso de cantidades locales para examinar patrones temporales y espaciales. Esa perspectiva permite localizar contribuciones que un promedio global oculta, aunque su interpretación depende de estimar correctamente las distribuciones de referencia.
Si las probabilidades se ajustan con la misma observación que evaluamos, podemos exagerar la aparente utilidad local. Si asignamos probabilidad cero a un resultado por falta de datos, aparecen divergencias que quizá reflejan el estimador. Los mapas locales requieren los mismos cuidados que la cantidad promedio.
Un promedio estimado negativo tampoco es una transferencia poblacional negativa; algunas correcciones de sesgo o diferencias entre estimadores pueden producirlo sin alterar la no negatividad de la información mutua condicional.
El análisis local es útil cuando se combina con el promedio, las condiciones de estimación y la definición del evento. De un mapa de regiones positivas y negativas no pueden leerse directamente rutas físicas ni mecanismos causales.
213.7. El caso gaussiano y la predicción lineal
En variables conjuntamente gaussianas, las entropías condicionales se expresan mediante varianzas o matrices de covarianza residuales. Para un objetivo escalar, la transferencia puede escribirse como
El predictor restringido usa la historia propia acordada y los demás controles que hayamos fijado; el completo añade la historia de la fuente. Ambos deben referirse al mismo horizonte, la misma población y el mismo conjunto común de condicionamiento.
Barnett, Barrett y Seth demostraron la equivalencia entre transferencia de entropía y una medida de causalidad de Granger para variables gaussianas, con el factor que corresponda a las convenciones. Sin otros supuestos, esa equivalencia no convierte una dependencia predictiva en una intervención causal identificada.
Consideremos el ejemplo explícito
La fuente es ruido gaussiano independiente en el tiempo, de varianza conocida. El error también es gaussiano e independiente y no comparte variación con la fuente ni con el pasado. Tomamos el valor absoluto del coeficiente de persistencia menor que uno para que exista el régimen estacionario.
Conocer el pasado del objetivo permite descontar su término de persistencia. Sin la fuente actual, la varianza residual es la suma de la varianza de su contribución y la del error. Al añadir la fuente, permanece únicamente la varianza del error, de modo que
Si ambas varianzas son uno y el coeficiente de la fuente vale dos, la transferencia es aproximadamente 1,160964 bits por predicción. Una variable continua no está limitada al máximo de un bit propio de una salida binaria.
Cambiar las unidades de la fuente no altera esta cantidad si transformamos coherentemente el modelo. Al multiplicar sus valores por diez, su varianza se multiplica por cien y el coeficiente que mantiene la misma contribución física se divide por diez. El producto del coeficiente al cuadrado por la varianza permanece igual. Comparar únicamente coeficientes sin considerar unidades puede sugerir cambios inexistentes de influencia.
Si hacemos tender a cero la varianza del error con una fuente continua no degenerada y coeficiente no nulo, la expresión crece sin límite. Ese límite supone una observación de precisión ilimitada. Un registro digital con cuantización finita plantea otro problema y no justifica trasladar directamente esa divergencia a una cantidad de bits observada.
La medida de Granger escrita como logaritmo natural de la razón de varianzas es el doble de la transferencia expresada en nats. Si la transferencia está en bits, el factor es dos veces el logaritmo natural de dos. Omitir esa conversión produce comparaciones numéricas equivocadas.
En este ejemplo, modificar la persistencia propia manteniendo las otras condiciones no cambia la transferencia, porque el predictor descuenta correctamente ese término. Si omitiéramos parte de la memoria propia o usáramos un modelo incorrecto, la comparación de residuos podría responder otra pregunta.
La fórmula gaussiana supone gaussianidad conjunta y el condicionamiento pertinente. Un ajuste lineal puede ser útil en datos no gaussianos, pero su razón de varianzas no coincide necesariamente con toda la transferencia de entropía del proceso, ya que las dependencias no lineales pueden modificar la distribución sin reflejarse plenamente en ese resumen.
213.8. Retardos, horizontes y variables comunes
Elegir un retardo significa decidir qué información de la fuente estaba disponible antes del resultado. Si la influencia física tarda varios pasos, una historia mal alineada puede perderla. Con todo, el retardo que maximiza una transferencia estimada no coincide necesariamente con el tiempo de propagación del mecanismo.
La autocorrelación de la fuente puede extender la información a varios retardos y la memoria del objetivo puede absorber parte de ella; el filtrado y el muestreo, a su vez, pueden desplazar o ensanchar las relaciones observadas. El perfil temporal de la medida debe interpretarse junto con esas propiedades.
También debemos declarar el horizonte del objetivo. Predecir el siguiente valor y predecir un valor diez pasos después son problemas diferentes. En el segundo, la información puede haber pasado por estados intermedios que no se incluyen explícitamente.
Si exploramos muchos retardos y presentamos únicamente el mayor, la selección forma parte del procedimiento. La incertidumbre y la comparación con una hipótesis nula deben tener en cuenta esa búsqueda. Un máximo entre muchas fluctuaciones puede parecer convincente sin corresponder a una relación reproducible.
Una variable común omitida puede producir exactamente la misma transferencia que una influencia directa. Supongamos que una variable latente genera un bit equiprobable en cada instante. La señal X lo copia y el objetivo siguiente también lo copia, quizá con ruido independiente.
La señal X predice el futuro del objetivo sin intervenir en su generación; ambos dependen de la variable común. El valor informacional puede ser idéntico al de nuestro modelo de copia directa y, con datos bivariados únicamente, esas estructuras son indistinguibles.
Si observamos la variable común con precisión suficiente y la incluimos en el condicionamiento, la señal X puede dejar de aportar información. Esa reducción es compatible con la explicación por causa común, pero hay que examinar si el control mide realmente lo necesario y si su tiempo está bien elegido.
Añadir variables tampoco garantiza que la transferencia disminuya. El ejemplo XOR mostró cómo un contexto puede revelar información antes invisible; condicionar en ciertos efectos comunes también puede introducir asociaciones. Elegir los controles exige una hipótesis causal; incluir todo lo disponible no la sustituye.
El siguiente capítulo desarrollará estas dificultades con variables omitidas y rutas indirectas. Aquí basta fijar que una dirección estadística condicionada a observaciones no es, solo en virtud de su definición, una medida del efecto de intervenir en la fuente.
Sin esa interpretación fuerte, la transferencia puede ser útil para orientar sensores, comparar modelos predictivos o localizar relaciones que merecen nuevos experimentos. Su utilidad mejora cuando el lenguaje del resultado se ajusta a la evidencia disponible.
213.9. Evaluar una estimación y comparar situaciones
Una estimación debe comenzar por especificar variables, historias, retardo y horizonte. También debe indicar si trata símbolos discretos, valores continuos o discretizaciones de mediciones. Modificar esos elementos puede cambiar el valor incluso con los mismos datos originales.
El número de contextos crece con las dimensiones y las longitudes. En datos escasos, una tabla conjunta puede contener muchas combinaciones vacías. Que falten en la muestra no significa que sean imposibles en la población. Una estimación aparentemente alta puede reflejar diferencias de sesgo entre modelos.
La evaluación fuera de muestra permite preguntar si añadir la fuente mejora las probabilidades de resultados nuevos. Cuando usamos pérdida logarítmica y modelos coherentes, la comparación tiene una conexión directa con la definición informacional. Aun así, lo que mide es la ganancia alcanzada por los modelos ajustados, que puede diferir del límite poblacional exacto.
Los controles por sustitución o reordenamiento deben corresponder a una hipótesis nula explícita. Desplazar circularmente una fuente puede conservar parte de su autocorrelación, pero su validez requiere condiciones sobre estacionariedad, independencia bajo la hipótesis nula y tratamiento de los extremos.
La incertidumbre debe tener en cuenta la dependencia temporal. Tratar todas las parejas de ventanas solapadas como observaciones independientes puede producir intervalos demasiado estrechos. El número de filas no resume cuántas realizaciones distintas de los contextos hemos observado.
Para comparar situaciones, conviene revisar también la incertidumbre inicial del objetivo. Una transferencia de medio bit no significa lo mismo en un objetivo binario casi impredecible que en uno cuya historia ya resuelve casi toda su variación. La cantidad absoluta y la incertidumbre residual de referencia responden a preguntas complementarias.
Podemos dividir la transferencia por la entropía condicional del objetivo sin fuente, cuando esta es positiva y ambas cantidades son discretas y finitas. El cociente queda entre cero y uno, aunque la normalización no elimina diferencias de población, resolución o estimación.
Si la entropía residual es cero, el cociente no está definido y no corresponde reemplazarlo por una interpretación de transferencia total. El objetivo ya era perfectamente predecible en ese contexto y no hay ganancia adicional.
También es posible comparar las dos direcciones. Su diferencia puede resumir una asimetría predictiva, pero no es un flujo neto universal ni una prueba de quién controla físicamente a quién; ambas direcciones pueden ser positivas por realimentación, por variables ocultas o por observación incompleta.
Un resultado convincente informa magnitud, incertidumbre, contexto y sensibilidad a decisiones razonables. La significación estadística no implica utilidad práctica. Una ganancia muy pequeña puede detectarse con muchos datos y no cambiar una decisión, mientras que una ganancia difícil de estimar puede merecer atención por su posible consecuencia.
213.10. Qué permite afirmar una transferencia
La transferencia de entropía cuantifica información adicional de una historia fuente sobre un futuro objetivo, una vez considerado un contexto declarado. Su dirección corresponde a esa organización temporal y condicional de la pregunta.
Los ejemplos separaron varios casos. Una copia retrasada muestra una asimetría clara, mientras que una copia del presente del objetivo añade asociación retrasada sin transferencia adicional. La regla XOR tiene transferencia positiva aunque la información mutua no condicionada sea cero; una variable común, por su parte, puede reproducir el valor de una conexión directa.
La cantidad local permite identificar observaciones que aumentan o disminuyen la probabilidad asignada al resultado ocurrido. Sus valores negativos no contradicen el promedio no negativo y no deben confundirse con signos de efectos físicos.
En el caso gaussiano, la razón de varianzas predictivas conecta transferencia y causalidad de Granger, con factores de unidad explícitos. Fuera de ese caso, un ajuste lineal puede omitir aspectos de la dependencia. En ambos, la inferencia causal necesita condiciones adicionales.
Una transferencia no puede interpretarse sin saber qué información propia se descontó. Memoria insuficiente, mediciones ruidosas, retardos incorrectos y variables omitidas pueden cambiar lo que significa una ganancia predictiva. La selección del contexto forma parte del resultado.
La transferencia tampoco mide una propiedad completamente independiente de la distribución de entrada; el mismo mecanismo de copia produjo valores muy diferentes al cambiar la frecuencia de la fuente. Comparar magnitudes exige revisar qué condiciones del sistema se mantuvieron constantes.
La formulación más defendible de un resultado especifica que cierta historia mejora la predicción de cierto objetivo, con determinadas variables y tiempos. A partir de ahí podemos formular hipótesis sobre mecanismos y diseñar observaciones o intervenciones que las distingan.
El próximo capítulo se centrará en esa distinción. Examinaremos cómo una dirección informacional puede aparecer por rutas indirectas o causas comunes y qué trabajo adicional se necesita para separar una relación predictiva de una explicación causal del sistema.
Referencias
- Schreiber, T. (2000). Measuring Information Transfer. Physical Review Letters, 85(2), 461–464. https://doi.org/10.1103/PhysRevLett.85.461.
- Lizier, J. T., Prokopenko, M., y Zomaya, A. Y. (2008). Local information transfer as a spatiotemporal filter for complex systems. Physical Review E, 77(2), 026110. https://doi.org/10.1103/PhysRevE.77.026110.
- Barnett, L., Barrett, A. B., y Seth, A. K. (2009). Granger Causality and Transfer Entropy Are Equivalent for Gaussian Variables. Physical Review Letters, 103(23), 238701. https://doi.org/10.1103/PhysRevLett.103.238701.