COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 22. Información temporal, multivariada y entre escalas
211.1. Un instante no describe una historia
Dos señales binarias pueden mostrar ceros y unos con la misma frecuencia y comportarse de maneras muy diferentes. Una puede cambiar al azar en cada observación; otra puede repetir durante todo el registro un único valor elegido al comienzo. Si examinamos una observación aislada de cada experimento, ambas pueden parecer equiprobables. Si observamos dos instantes consecutivos, la diferencia resulta evidente.
La entropía marginal mide la incertidumbre sobre una observación sin usar su historia. Para estudiar una serie temporal necesitamos preguntar cuánta incertidumbre permanece cuando conocemos observaciones anteriores. Una parte de lo que parece sorpresa en un instante puede ser repetición de información que ya estaba disponible.
Consideremos una fuente que elige un bit equiprobable y después lo repite indefinidamente. Identificar el primer bit requiere un bit de información; después no aparece incertidumbre nueva, siempre que conozcamos la regla. La entropía de cualquier bloque no vacío es un bit, aunque cada posición, considerada por separado antes de observar la fuente, tenga entropía de un bit.
En una secuencia de bits independientes y equiprobables, la entropía de un bloque coincide con su longitud. Cada nueva posición aporta otro bit de incertidumbre incluso después de observar todas las anteriores. La igualdad marginal oculta la diferencia entre una incertidumbre inicial y una renovación continua de incertidumbre.
La tasa de entropía cuantifica esa renovación por observación en un régimen bien definido. No mide cuánta estructura necesita un modelo, cuánto tarda un observador en aprenderla ni cuánto conocimiento del pasado resulta útil para todo el futuro; esas preguntas requieren cantidades adicionales.
Crutchfield y Feldman estudiaron sistemáticamente la relación entre el crecimiento de la entropía y la memoria. Su análisis ayuda a distinguir regularidades no detectadas de aleatoriedad residual bajo una representación. Usaremos esa distinción para construir ejemplos sencillos cuyos cálculos puedan seguirse directamente.
Debemos mantener visible qué señal observamos. Una variable física continua, una etiqueta obtenida por umbral y una versión filtrada de esa etiqueta pueden tener propiedades temporales distintas. La tasa corresponde al proceso representado y a su intervalo de muestreo, de modo que depende de cómo lo medimos.
El objetivo será pasar de contar símbolos a estudiar bloques y probabilidades condicionales. Esa transición permite describir persistencia, alternancia y dependencias que no aparecen al mirar una pareja aislada de instantes.
211.2. Entropía de bloques e información adicional
Sea una secuencia de variables aleatorias discretas. Llamaremos entropía de bloque a la incertidumbre conjunta de un tramo de longitud determinada,
Para calcularla hacen falta las probabilidades conjuntas de todos los bloques posibles. En una señal binaria, el número máximo de bloques distintos crece como dos elevado a la longitud. Aunque muchos sean improbables o imposibles, esa expansión anticipa dificultades de estimación.
La regla de la cadena descompone la entropía del bloque como
donde el primer término se interpreta como entropía sin condicionamiento. Cada contribución mide lo que la nueva observación añade después de conocer el prefijo correspondiente.
Definimos el incremento
Para alfabetos finitos, este incremento es no negativo, porque añadir una variable no puede reducir la incertidumbre conjunta de las que ya estaban incluidas. Sin embargo, la incertidumbre adicional puede ser cero si el nuevo símbolo queda determinado por el prefijo.
Conviene distinguir crecimiento total y crecimiento incremental. Una curva de entropía de bloques puede aumentar siempre mientras sus incrementos disminuyen. El sistema sigue admitiendo más bloques posibles al ampliar la observación, pero cada posición nueva puede sorprender menos porque disponemos de más contexto.
En una fuente independiente con la misma distribución en todos los instantes, los incrementos son constantes. En la fuente del bit elegido una vez y repetido, el primer incremento es un bit y todos los demás son cero. Ambos ejemplos se obtienen de la misma identidad, sin cambiar el significado de entropía.
Si el contexto que usamos es demasiado corto, podemos atribuir al azar lo que un contexto más largo permitiría anticipar. Tampoco debemos suponer que alargar el contexto mejore siempre un predictor estimado con pocos datos. La identidad vale para las distribuciones verdaderas; aprenderlas introduce errores adicionales.
Una observación individual puede ser muy sorprendente aunque el incremento promedio sea pequeño. Si una transición rara tiene poca probabilidad bajo el pasado observado, su logaritmo negativo puede ser grande. La tasa promedia esas sorpresas con las probabilidades del proceso; no garantiza que cada paso sea fácil de anticipar.
Para hablar de memoria tampoco necesitamos que la historia determine exactamente el futuro; basta con que modifique su distribución. Una serie puede conservar dependencia temporal y seguir generando incertidumbre nueva en cada instante.
211.3. Estacionariedad y existencia de una tasa
Un proceso es estrictamente estacionario cuando sus distribuciones conjuntas no cambian al desplazar todos los tiempos en la misma cantidad. La condición exige más que una media constante, porque afecta a las distribuciones de cualquier conjunto finito de observaciones.
La estacionariedad permite comparar incrementos calculados en distintas posiciones como versiones de la misma pregunta. Para un proceso estacionario de alfabeto finito, los incrementos de entropía no aumentan con la longitud del contexto,
La demostración combina dos hechos. Primero, por estacionariedad, podemos desplazar la ventana de modo que ambas entropías condicionales correspondan al mismo instante final. Segundo, condicionar a una observación adicional no aumenta la entropía promedio. No estamos comparando poblaciones distintas ni cambiando el objetivo entre pasos.
Como los incrementos son no negativos y decrecientes, tienen un límite, que coincide con el crecimiento promedio de la entropía del bloque,
La segunda igualdad vale porque el cociente es el promedio de los primeros incrementos. Si una secuencia converge, el promedio de sus primeros términos converge al mismo valor. Las contribuciones iniciales pierden peso al dividir por bloques cada vez más largos.
La tasa queda entre cero y la entropía marginal, que a su vez no supera el logaritmo del tamaño del alfabeto. Esas cotas permiten un control básico; una tasa negativa en este contexto señalaría un problema de cálculo o de estimación.
Bajo las condiciones indicadas, la existencia de la tasa no requiere ergodicidad. La ergodicidad será importante cuando queramos reemplazar promedios sobre el conjunto de realizaciones por promedios de una trayectoria larga. Confundir ambos papeles puede llevar a justificar una estimación con un teorema que solo establece una propiedad de la distribución.
Sin estacionariedad, los incrementos pueden subir o bajar por cambios del proceso. Una fuente que modifica su probabilidad de activación a mitad de un registro no tiene necesariamente una única tasa estable que se interprete del mismo modo. Puede ser útil analizar segmentos o modelar explícitamente la variación temporal.
En alfabetos infinitos se necesitan además condiciones de finitud, porque las expresiones anteriores no autorizan restas de entropías infinitas. Nos limitaremos a ejemplos finitos, en los que la dificultad principal es temporal y la existencia de las cantidades está asegurada.
211.4. Una cadena con persistencia
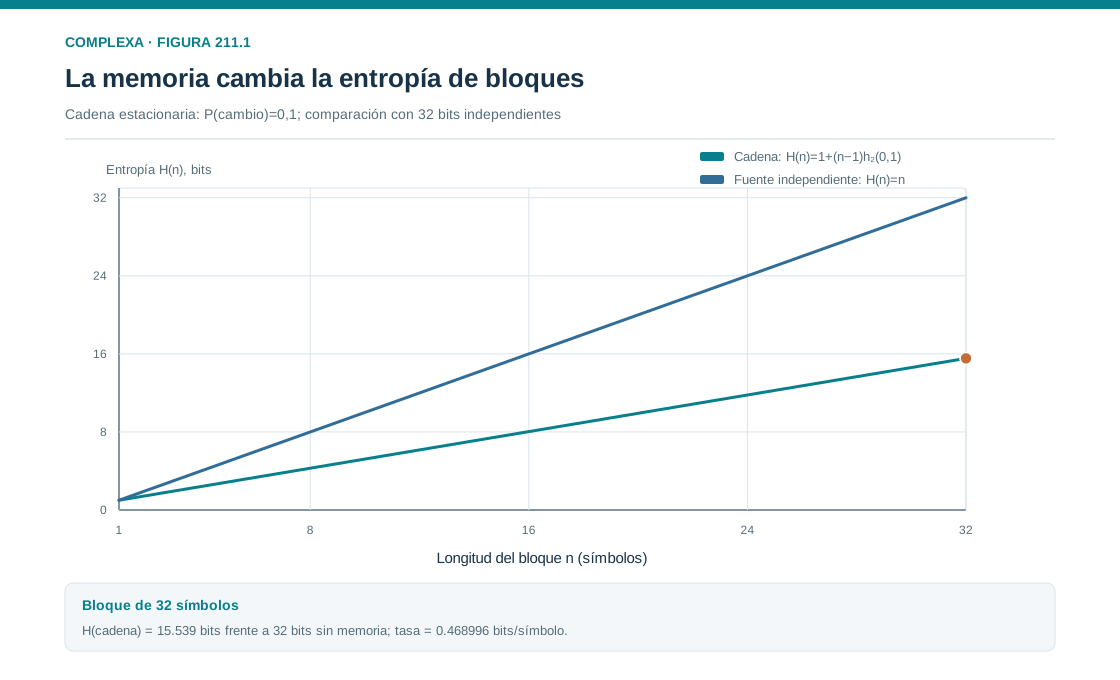
Consideremos una cadena binaria estacionaria. El primer estado es equiprobable. En cada paso, el sistema cambia de valor con probabilidad una décima y lo conserva con probabilidad nueve décimas. En este modelo, las decisiones de cambio son independientes entre pasos.
Cada estado individual sigue siendo equiprobable, por lo que la entropía marginal es un bit. Sin embargo, conocer el estado anterior permite asignar probabilidades de nueve décimas y una décima a las dos posibilidades siguientes. La entropía condicional es aproximadamente 0,468996 bits.
La propiedad de Markov de primer orden significa que, conocido el último estado, las observaciones más antiguas no añaden información sobre el siguiente. Por tanto, todos los incrementos a partir del segundo son iguales y
Para treinta y dos observaciones, la entropía de bloque es aproximadamente 15,539 bits. Un modelo que ignorara la dependencia y asignara un bit independiente a cada posición calcularía treinta y dos bits. La diferencia es información temporal que el modelo independiente no usa.
La cifra de entropía es un promedio bajo la distribución definida; la longitud de un archivo particular puede apartarse de ella. Un código realizable requiere además palabras enteras, convenciones y, posiblemente, bloques largos; la tasa fija solo el límite informacional.
Una representación intuitiva consiste en guardar el primer estado y después los indicadores de cambio. La transformación es invertible. Los indicadores son independientes y valen uno con probabilidad una décima. Así, la dependencia de los estados se convierte en una distribución desigual de innovaciones binarias.
Esta representación muestra por qué una señal puede parecer equilibrada y aun así ser compresible. Los estados tienen frecuencias iguales, pero la mayoría de los indicadores de cambio son cero. La regularidad está en la relación entre observaciones y aparece al elegir una representación temporal apropiada.
Fijemos ahora la probabilidad de cambio en nueve décimas. La cadena tiende a alternar. Su entropía marginal sigue siendo un bit y su tasa es la misma, porque la entropía binaria es simétrica respecto de un medio.
Los dos procesos requieren estrategias predictivas diferentes. En el primero, la predicción más probable es repetir el estado; en el segundo, invertirlo. Ambos permiten una exactitud óptima de nueve décimas, pero aplicar la estrategia de persistencia a la cadena alternante produciría solo una décima de aciertos.
La tasa de entropía describe la incertidumbre residual bajo el modelo correcto. No asegura que un predictor concreto haya aprendido las dependencias ni que use la regla adecuada. La estructura necesaria para alcanzar esa predicción es otra pregunta.
211.5. Una memoria que no aparece entre vecinos
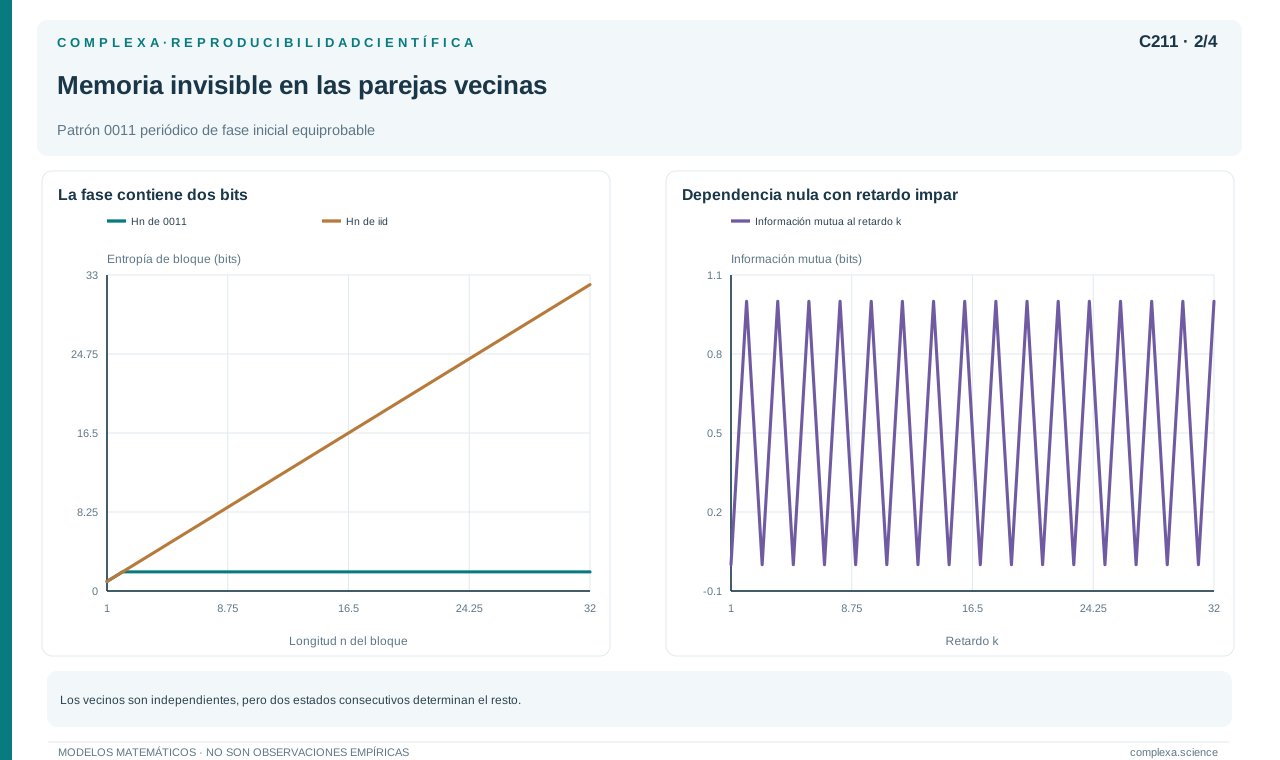
Construyamos una señal periódica repitiendo el patrón cero-cero-uno-uno. Antes de observarla elegimos su fase inicial uniformemente entre las cuatro posibilidades. Esta elección hace estacionario el proceso, porque desplazarlo un instante permuta las fases sin cambiar su distribución.
Cada observación es un bit equiprobable. Las parejas consecutivas posibles son cero-cero, cero-uno, uno-uno y uno-cero, todas con probabilidad una cuarta parte, de modo que dos observaciones vecinas son estadísticamente independientes.
Si estimamos únicamente una tabla de transición de primer orden, obtendremos probabilidades de una mitad para repetir o cambiar. Ese modelo atribuiría un bit de incertidumbre nueva a cada paso. Sin embargo, el proceso verdadero es periódico y su tasa de entropía es cero.
La situación cambia al observar dos símbolos consecutivos. Cada pareja identifica exactamente la fase y determina la continuación. Después de cero-cero viene uno; después de cero-uno viene uno; después de uno-uno viene cero; después de uno-cero viene cero.
La regla equivale a que cada símbolo sea el complemento del situado dos pasos antes. Por eso una historia de longitud dos basta para predecir, aunque una historia de longitud uno no reduzca la incertidumbre.
La entropía del primer símbolo es un bit y la de una pareja, dos bits. Para cualquier bloque de longitud al menos dos, la entropía permanece en dos bits, porque solo hay cuatro continuaciones posibles, una por fase.
Los incrementos son, por tanto, un bit, un bit y después ceros. La tasa es cero, pero el observador necesita resolver inicialmente una incertidumbre de fase. Una estimación que no explore suficiente contexto convertiría esa estructura en aleatoriedad aparente.
Dos observaciones separadas por dos pasos son complementarias y comparten un bit de información; las separadas por cuatro pasos son idénticas. La ausencia de dependencia entre vecinos no implica ausencia de organización temporal.
Este ejemplo aconseja no generalizar a partir de una correlación o una información mutua de un solo retardo. Esas medidas corresponden a las parejas examinadas; una dependencia puede aparecer a otra distancia o requerir combinar varias observaciones.
La fase aleatoria es parte de la definición del proceso. Si fijáramos de antemano la fase y la comunicáramos al observador, no quedaría esa incertidumbre inicial. Si reuniéramos muestras sin respetar el orden, perderíamos la posibilidad de detectarla. Medida, proceso y conocimiento disponible deben definirse juntos.
La periodicidad del ejemplo no implica que toda señal real de baja tasa sea periódica, porque existen otras formas de dependencia y restricciones. El ejemplo demuestra una posibilidad lógica concreta, la de que una tasa nula coexista con marginales y parejas de apariencia muy variable.
211.6. Cambiar la escala de muestreo
La tasa se expresa por observación. Para convertirla en bits por unidad de tiempo necesitamos conocer el intervalo entre muestras. Una señal con medio bit por muestra registrada mil veces por segundo no tiene la misma tasa temporal que una registrada una vez por minuto.
Cambiar la frecuencia de muestreo también puede cambiar la tasa por observación, así que la conversión no se reduce a multiplicar una cantidad fija. Al omitir observaciones, el contexto entre muestras retenidas abarca un intervalo físico mayor y puede dejar más incertidumbre.
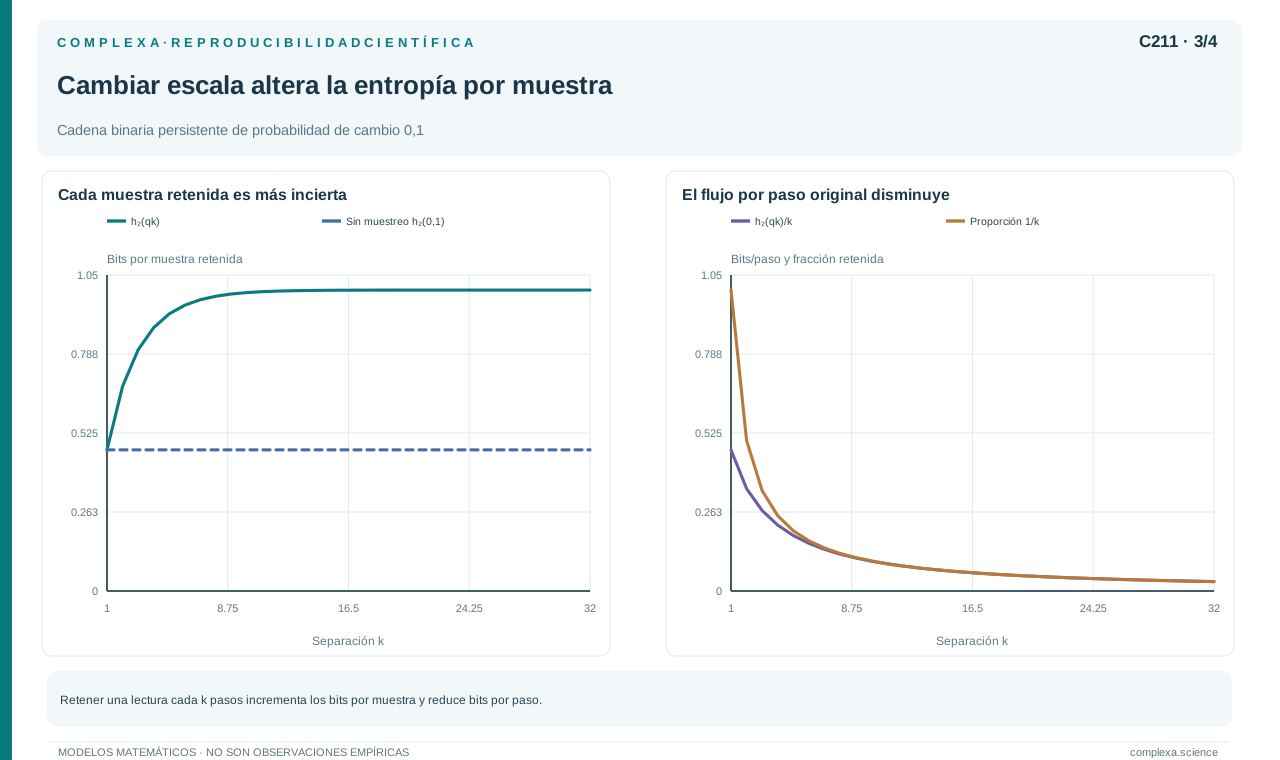
Volvamos a la cadena binaria con probabilidad de cambio de una décima por paso. Si retenemos solo una observación cada cierto número de pasos, dos estados retenidos consecutivos difieren exactamente cuando ha ocurrido un número impar de cambios intermedios.
Para una separación de cinco pasos, la probabilidad de que difieran es
La fórmula puede derivarse considerando el signo asociado al estado binario. Cada paso multiplica la correlación por uno menos dos veces la probabilidad de cambio; después de cinco pasos aparece la quinta potencia.
La tasa de la cadena retenida es aproximadamente 0,921097 bits por observación retenida, mayor que los 0,468996 bits por observación original. Como cada muestra retenida abarca cinco pasos, la tasa por paso original es aproximadamente 0,184219 bits.
Muestrear menos no crea información temporal. La observación retenida resulta más impredecible respecto de la anterior retenida porque hay un intervalo mayor entre ambas, pero al mismo tiempo registramos menos observaciones. Comparar solamente bits por muestra daría una impresión equivocada sobre el flujo total.
En general, la subsecuencia pierde distinciones sobre la trayectoria y no permite recuperar los estados omitidos. Que ambos extremos de un intervalo coincidan no significa que no hubiera cambios, porque podrían haber ocurrido dos o cuatro.
Promediar ventanas exige el mismo cuidado. A diferencia de una muestra más espaciada, un promedio combina varios valores y puede introducir dependencias entre ventanas si estas se solapan. Su tasa debe estudiarse como la del proceso transformado.
La resolución de amplitud añade otra escala. Una etiqueta binaria derivada de una medición continua puede ocultar fluctuaciones dentro de cada categoría. Cambiar el umbral o aumentar el número de intervalos modifica las posibilidades distinguidas y, con ellas, las entropías.
Para comparar dos registros necesitamos especificar unidad de tiempo, intervalo, resolución y transformaciones. Sin esas condiciones, no sabremos si una tasa mayor indica una organización intrínsecamente más compleja o solo una observación más fina, menos contexto relativo o más ruido.
211.7. Ruido de observación y estados ocultos
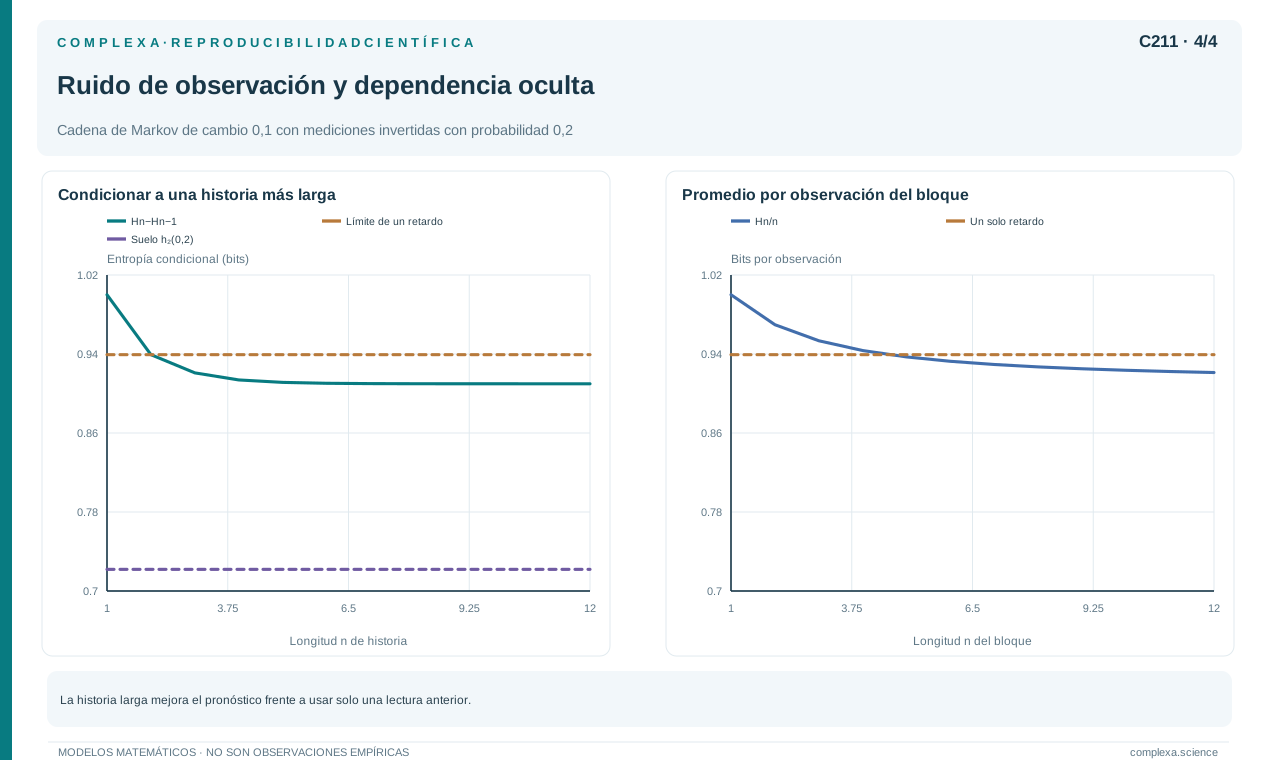
Una dependencia corta en el sistema puede convertirse en una dependencia más larga en las observaciones. Supongamos que el estado oculto sigue la cadena persistente anterior, pero el instrumento invierte cada lectura con probabilidad una quinta parte, independientemente de los estados y de otros errores.
La observación más reciente ya no identifica con certeza el estado oculto. Varias lecturas anteriores pueden ayudar a estimarlo. Por ello, aunque el estado físico sea Markov de primer orden, la señal observada no tiene por qué serlo.
El predictor debe mantener una distribución sobre el estado oculto. Una lectura aislada modifica esa distribución; una sucesión coherente puede modificarla más. La información relevante del pasado puede resumirse mediante una creencia actualizada, pero esa creencia depende de cómo se acumuló la evidencia.
La probabilidad de que dos errores de observación consecutivos sean diferentes es 0,32. Al combinarla con la probabilidad de cambio oculto de 0,1, la probabilidad de que dos lecturas consecutivas difieran resulta 0,356.
Como las observaciones siguen siendo marginalmente equiprobables, la entropía condicionada únicamente a la lectura anterior es la entropía binaria de 0,356, que ronda 0,939313 bits por muestra. Esa cantidad es una cota superior de la tasa verdadera del proceso observado, porque un contexto más largo puede aportar información adicional.
Para mejorar esa cota necesitaríamos calcular probabilidades condicionadas a historias más largas o resolver el filtro del estado oculto. Tratarla como una igualdad equivaldría a imponer memoria de primer orden a las lecturas, una propiedad que no se deduce de la memoria del estado.
También obtenemos una cota inferior. Aunque conociéramos todos los estados ocultos, seguiría faltando la realización de los errores independientes del instrumento, cuya entropía por muestra es la entropía binaria de una quinta parte, aproximadamente 0,721928 bits.
La tasa observada no puede ser menor que esa contribución condicional del ruido; puede ser mayor porque el estado oculto tampoco se conoce perfectamente. Este intervalo, entre el ruido inevitable y la predicción con contexto insuficiente, se obtiene sin resolver exactamente todo el modelo.
La tasa de la señal observada puede superar la del estado oculto. Esto no contradice la desigualdad de procesamiento de datos, porque añadir ruido puede aumentar la entropía mientras reduce la información sobre el estado. La entropía de una salida y su información mutua con el objetivo son cantidades distintas.
Un filtro puede producir una señal más suave y una tasa aparente menor. Esa reducción no prueba que haya recuperado el estado real, porque podría haber eliminado variación relevante junto con el ruido. La evaluación necesita una pregunta y, cuando sea posible, una referencia independiente.
También debemos distinguir ruido de modelo y ruido de observación. Una transición inesperada podría proceder del sistema, del instrumento o de una regla predictiva incompleta. La tasa calculada sobre el registro no indica cuál de esas fuentes explica la sorpresa.
211.8. Estacionariedad no equivale a una sola población
Al comienzo de cada realización elegimos, con igual probabilidad, una moneda cuya probabilidad de uno es una décima o una cuya probabilidad de uno es nueve décimas. Después lanzamos siempre la moneda elegida, de manera independiente entre lanzamientos.
El proceso conjunto es estacionario, porque sus distribuciones no dependen de la posición temporal. La probabilidad marginal de uno, al promediar sobre realizaciones, es una mitad. Sin embargo, una trayectoria muy larga mostrará aproximadamente una décima o nueve décimas de unos, según la moneda seleccionada.
El proceso no es ergódico respecto de esa mezcla. Una sola trayectoria no recorre las dos poblaciones de realizaciones y su frecuencia temporal no converge a la frecuencia marginal de una mitad. Así, un único registro puede dar una estimación equivocada de las propiedades del conjunto.
La historia sí tiene valor predictivo. Al observar suficientes lanzamientos podemos inferir qué moneda fue elegida. Una vez resuelta esa incertidumbre, la incertidumbre nueva por lanzamiento es la entropía binaria de una décima, la misma para ambas monedas.
La entropía del bloque puede escribirse con la variable que identifica la moneda como
La incertidumbre sobre la moneda está entre cero y un bit. Al dividir por la longitud y hacer crecer el bloque, ese término no afecta a la tasa. La tasa del proceso observado es, por tanto, aproximadamente 0,468996 bits por lanzamiento.
Con una sola observación previa todavía no conocemos la moneda. La probabilidad de que dos resultados consecutivos difieran es 0,18 y la entropía del segundo condicionada al primero ronda 0,680077 bits, por encima de la tasa límite. Un pasado más largo ayuda a identificar la moneda.
Este tipo de dependencia puede aparecer por heterogeneidad estable entre unidades. Si mezclamos registros de sistemas con parámetros diferentes, el pasado informa sobre el parámetro de la unidad, aunque sus observaciones sean independientes una vez conocido ese parámetro.
Por eso no debemos interpretar toda memoria observada como interacción dinámica entre instantes; puede deberse a una variable persistente no observada. La distinción requiere modelos y diseños que separen los cambios dentro de una unidad de las diferencias entre unidades.
La fuente del bit fijo del comienzo es un caso extremo, en el que el componente elegido determina todas las observaciones y la tasa es cero. En la mezcla de monedas queda aleatoriedad dentro de cada componente. Ambos ejemplos muestran que la incertidumbre sobre una población y la generación de novedades temporales son aspectos diferentes.
211.9. Estimar una tasa con datos finitos
Calcular una tasa a partir de una distribución conocida es distinto de estimarla a partir de un registro. Si usamos contextos de longitud creciente, el número de patrones posibles aumenta rápidamente. Muchos contextos aparecerán pocas veces y otros no aparecerán.
Una tabla empírica puede asignar probabilidad uno al único sucesor observado de un contexto raro, con lo que su entropía condicional estimada será cero. Eso no demuestra determinismo, porque quizá solo hemos visto ese contexto una vez. Aumentar la memoria aparente puede reducir artificialmente la entropía dentro de la muestra.
Un predictor que identifica cada contexto largo con una posición concreta puede acertar todos los sucesores usados para ajustarlo; ese éxito no garantiza que prediga una nueva realización del mismo proceso.
Por ello conviene evaluar predicciones probabilísticas sobre datos que no se hayan usado para ajustar el modelo. La pérdida logarítmica promedio se compara de forma natural con la entropía condicional, siempre que las predicciones asignen probabilidades válidas y que el diseño de evaluación respete la dependencia temporal.
Dividir observaciones al azar puede introducir información del futuro en el entrenamiento o colocar ventanas casi idénticas a ambos lados de la división. Un procedimiento temporal debe justificar qué datos estarían disponibles al formular cada predicción y reproducir esa disponibilidad en la evaluación.
El suavizado de probabilidades evita que un evento no observado reciba necesariamente probabilidad cero. Puede mejorar la estabilidad, pero introduce supuestos y modifica el sesgo. No existe una corrección universal que permita usar cualquier longitud de contexto con cualquier tamaño de muestra.
Las identidades de entropía permiten comprobaciones internas. Si las distribuciones de bloques y sus marginales se derivan de un mismo modelo coherente, deben respetar las relaciones correspondientes. Estimar cada longitud con muestras o correcciones diferentes puede producir violaciones aparentes debidas al procedimiento.
También debemos analizar la estabilidad del proceso. Una caída de la entropía estimada durante un intervalo puede reflejar un cambio real, una ventana más pequeña, una categoría dominante o una modificación del instrumento. La serie de valores de una medida necesita su propia explicación.
La cantidad de datos útil no coincide siempre con el número de filas. La dependencia fuerte, la repetición de sujetos o los segmentos muy parecidos reducen la diversidad de contextos observados. La incertidumbre del estimador debe considerar esa estructura.
Un informe responsable presenta el alfabeto, la construcción de contextos, el tamaño efectivo de los conjuntos evaluados y el criterio de comparación. Una cifra de tasa con muchos decimales no compensa la omisión de esas decisiones. Los capítulos posteriores tratarán la estimación y la comparación de medidas.
211.10. Qué conserva la tasa y qué deja abierto
La tasa de entropía responde a cuánta incertidumbre nueva aparece por observación después de usar un pasado suficientemente amplio, bajo el proceso y las condiciones definidos. Esa pregunta es más específica que la de cuán compleja es una señal.
Una secuencia independiente equiprobable tiene tasa máxima y carece de memoria predictiva. Una secuencia periódica puede tener tasa cero y requerir identificar una fase. Dos cadenas con persistencia y alternancia pueden tener la misma tasa y reglas predictivas opuestas.
Una tasa baja tampoco garantiza que aprender el modelo sea sencillo, porque puede haber regularidades largas, estados ocultos o parámetros desconocidos. El límite describe qué incertidumbre permanece si disponemos de la distribución adecuada; el trabajo de descubrirla a partir de datos queda fuera de lo que mide.
La expresión «memoria predictiva» puede designar la longitud de contexto necesaria, la cantidad de información del pasado útil para el futuro o los recursos de un estado interno que permite predecir. Estas propiedades están relacionadas, pero no son equivalentes. Conviene nombrar la que realmente calculamos.
La diferencia entre entropía marginal y tasa indica la ganancia de usar el pasado para anticipar la próxima observación. Sin embargo, el futuro contiene muchas observaciones y puede depender de aspectos del pasado que apenas cambian la predicción inmediata. Examinar bloques futuros amplía la pregunta.
La predictibilidad tampoco establece causalidad. Una variable persistente puede organizar toda la secuencia (como en la mezcla de monedas) y un instrumento puede introducir dependencia por filtrado. La información temporal revela relaciones estadísticas que después deben interpretarse mediante un modelo del sistema y de su observación.
Para comparar tasas necesitamos mantener las unidades y el contexto. Cambiar muestreo, resolución o población puede alterar la cantidad aun sin cambiar el mecanismo físico. La comparación solo es clara cuando sabemos qué distinciones se conservaron y qué conocimientos se permitieron al predictor.
El próximo capítulo estudiará la información compartida entre pasado y futuro. Allí veremos cómo medir una parte de la estructura temporal que la tasa deja fuera, la que una historia permite conservar para anticipar continuaciones. Combinar ambas perspectivas permite distinguir la producción de incertidumbre de la persistencia de información útil.
Referencias
- Shannon, C. E. (1948). A Mathematical Theory of Communication. The Bell System Technical Journal, 27(3), 379–423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x.
- Crutchfield, J. P., y Feldman, D. P. (2003). Regularities unseen, randomness observed: Levels of entropy convergence. Chaos, 13(1), 25–54. https://doi.org/10.1063/1.1530990.
- Bialek, W., Nemenman, I., y Tishby, N. (2001). Predictability, Complexity, and Learning. Neural Computation, 13(11), 2409–2463. https://doi.org/10.1162/089976601753195969.