COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 21. Teoría de la información: incertidumbre, dependencia y representación
201.1. Una medida para distinguir posibilidades
Recibimos un mensaje que indica cuál de varios resultados ocurrió. Si casi todos los resultados posibles estaban descartados de antemano, el mensaje resuelve poca incertidumbre. Si muchas alternativas seguían siendo plausibles, puede resolver más. La teoría de la información de Shannon convierte esta intuición en una relación entre probabilidades, observaciones y recursos de representación.
La palabra «información» tiene aquí un significado técnico. No mide directamente la verdad de una afirmación, su importancia humana, su utilidad para una decisión ni la profundidad de una explicación. Una secuencia aleatoria puede tener mucha incertidumbre estadística y carecer de interés para la tarea que nos ocupa.
Esta delimitación permite formular preguntas precisas, como cuánta incertidumbre tiene una variable, cuánto se reduce al observar otra, qué parte puede conservarse durante una transformación y cuántos recursos requiere transmitirla bajo ciertas condiciones.
Necesitamos comenzar con una variable aleatoria y una distribución. La variable define qué resultados distinguimos; la distribución expresa las probabilidades que les asignamos en el modelo. Cambiar cualquiera de esos elementos puede cambiar la cantidad de información calculada.
Por ejemplo, registrar si una unidad está activa da dos categorías, mientras que registrar además intensidad, duración y posición conserva otras distinciones. Cada entropía describe la incertidumbre de una representación especificada; ninguna caracteriza toda la complejidad de la unidad con independencia de la observación.
En el capítulo anterior, una fracción final resumía miles de posibles trayectorias de activación. Ese resumen podía ser suficiente para una pregunta e insuficiente para otra. La teoría de la información ayudará a expresar esas diferencias, sin tratar de antemano toda reducción de datos como una pérdida relevante.
Shannon desarrolló su teoría en el contexto de la comunicación. Sus cantidades permiten estudiar límites de codificación y transmisión. Extenderla a otros campos exige trasladar, junto con el nombre de cada medida, el significado de sus variables, probabilidades y procedimientos de observación.
Nuestro primer objetivo será distinguir la sorpresa de un resultado de la incertidumbre promedio de una fuente. Después veremos por qué ambas dependen del modelo y cómo pueden calcularse, compararse y malinterpretarse.
201.2. La sorpresa de un resultado
Sea una variable discreta y sea la probabilidad de un resultado. Definimos su autoinformación, o sorpresa, mediante
Un resultado seguro tiene sorpresa cero. Un resultado con probabilidad de un medio tiene una unidad; uno con probabilidad de un cuarto tiene dos; uno con probabilidad de un octavo tiene tres. La disminución multiplicativa de probabilidad se traduce en un aumento aditivo de sorpresa.
La elección del logaritmo responde a esa aditividad. Si dos resultados son independientes, la probabilidad conjunta es el producto de sus probabilidades. El logaritmo convierte ese producto en una suma, de modo que la sorpresa conjunta coincide con la suma de las sorpresas individuales.
Esta propiedad no se aplica de la misma manera a resultados dependientes. Si conocer el primero modifica la probabilidad del segundo, debemos usar la probabilidad condicional correspondiente.
La sorpresa no es una reacción emocional ni una valoración de importancia. Una combinación específica de muchas cifras aleatorias puede tener probabilidad diminuta sin ser extraordinaria respecto del mecanismo que la genera. Siempre debe ocurrir alguna combinación, aunque cada una sea individualmente improbable.
La interpretación depende también de cómo se definió el evento antes de observarlo. La probabilidad de una secuencia exacta puede ser pequeña, mientras que la probabilidad de encontrar alguna secuencia perteneciente a una clase amplia sea grande. Definir la clase después de ver el resultado modifica la interpretación de su rareza.
Si asignamos probabilidad cero a un evento y después ocurre, la sorpresa bajo ese modelo es infinita. Ese valor infinito indica que el modelo descartó por completo un resultado que debía poder representar; carece de interpretación como cantidad física.
Por eso conviene distinguir una probabilidad teórica nula de una frecuencia observada nula en una muestra pequeña. Que no hayamos visto un evento no demuestra que sea imposible. Al evaluar predicciones, una exclusión absoluta puede tener consecuencias muy diferentes de una probabilidad pequeña.
La autoinformación es relativa a una distribución. Dos modelos que asignan probabilidades distintas al mismo resultado calculan sorpresas diferentes. Esta dependencia reaparecerá al comparar modelos mediante divergencias y reglas de puntuación.
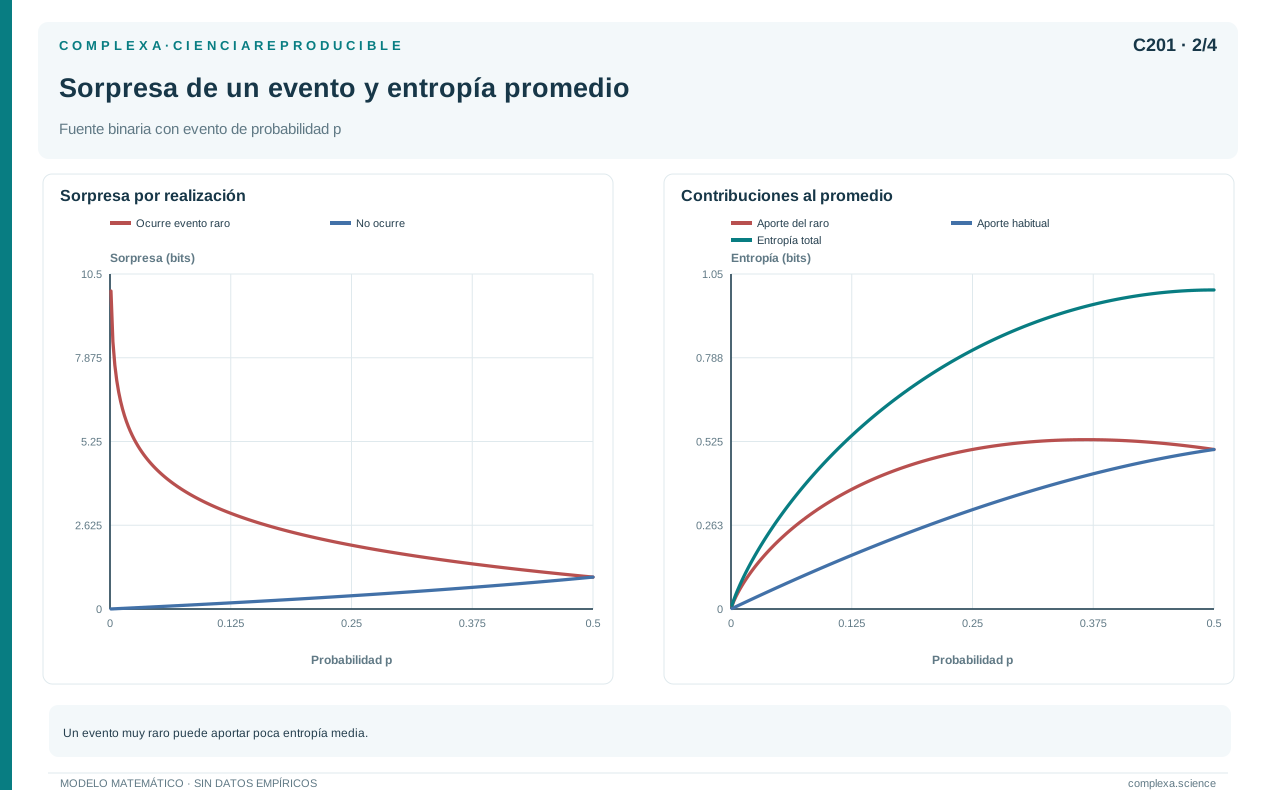
La diferencia entre un evento raro y una fuente incierta puede cuantificarse con una alarma que aparece con probabilidad de una milésima. Bajo ese modelo, su aparición tiene una sorpresa de unos diez bits. Sin embargo, la entropía binaria de cada observación es de apenas bits.
No hay contradicción. Casi todas las observaciones informan de la ausencia esperada de alarma y su sorpresa es muy pequeña. Por ello la medida promedio es pequeña, aunque un resultado particular sea infrecuente. Si la alarma tiene consecuencias importantes, esa importancia debe incorporarse mediante una función de costos o una pregunta de decisión, porque la entropía no mide consecuencias.
El ejemplo también impide interpretar una entropía baja como garantía de seguridad. Una distribución muy concentrada puede contener eventos raros de consecuencias grandes. La incertidumbre promedio y el costo esperado son cantidades distintas que necesitan definiciones diferentes.
201.3. Bits, unidades y preguntas binarias
Con logaritmos en base dos, la unidad es el bit. Un bit de incertidumbre corresponde, por ejemplo, a una elección entre dos alternativas equiprobables. No debe confundirse con una casilla física de memoria, aunque la codificación relaciona ambas nociones.
Si usamos logaritmos naturales, la unidad habitual es el nat. Cambiar de base multiplica todos los valores por una constante. Una cantidad de un nat equivale a bits. El contenido matemático no cambia si mantenemos coherencia en las unidades.
Ocho resultados equiprobables tienen tres bits de incertidumbre. Podemos identificarlos mediante tres respuestas binarias bien elegidas, cada una de las cuales divide las posibilidades restantes en dos grupos iguales.
Si los resultados no son equiprobables, una secuencia de preguntas puede reservar trayectorias cortas para resultados frecuentes y largas para resultados raros. El número de preguntas varía entre realizaciones. La cantidad relevante puede ser entonces el promedio esperado.
No todas las preguntas disponibles dividen las probabilidades de forma conveniente. Restricciones físicas, semánticas o de acceso pueden impedir una estrategia ideal. La entropía fija un límite bajo ciertas condiciones de representación, pero un sistema concreto puede no alcanzarlo con sus operaciones permitidas.
Un resultado con probabilidad de tres cuartos tiene sorpresa aproximada de bits. Eso no exige una fracción literal de una respuesta binaria aislada. Las cantidades no enteras adquieren significado operacional mediante promedios, bloques de mensajes y códigos adecuados.
La resolución temporal también cambia las unidades de una tasa. Bits por símbolo, bits por observación y bits por segundo son cantidades relacionadas, pero diferentes. Una fuente que produce pocos bits por símbolo puede generar muchos por segundo si emite con mucha frecuencia.
Antes de comparar dos mediciones debemos comprobar la base del logaritmo, la definición del símbolo y la frecuencia de observación. Una diferencia de escala puede proceder solo de esas convenciones, sin reflejar ninguna propiedad nueva del sistema.
Los nombres de las categorías no intervienen en el cálculo, que depende solo de las distinciones conservadas. Renombrar cuatro estados sin fusionarlos ni dividirlos deja intactas sus probabilidades y su entropía.
201.4. La entropía como sorpresa promedio
Definimos la entropía de una variable discreta como la esperanza de su sorpresa,
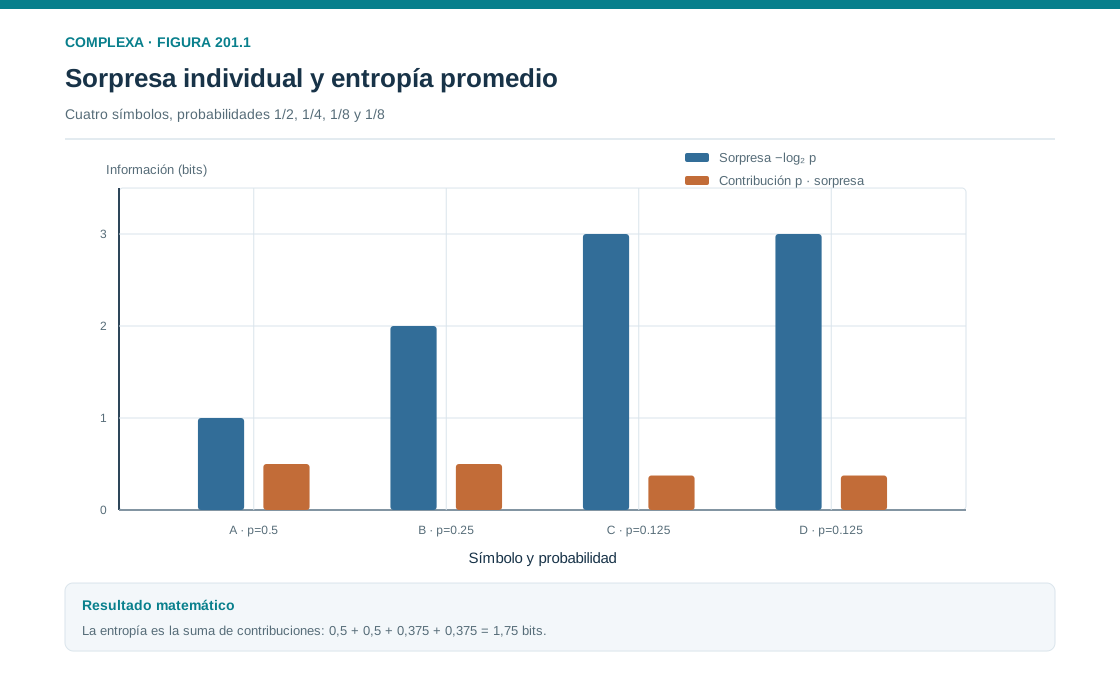
Cada resultado contribuye con su sorpresa, ponderada por la probabilidad de observarlo. Los resultados raros pueden ser muy sorprendentes, pero aparecen con poca frecuencia. La entropía combina ambos efectos en un promedio.
Adoptamos la convención , entendida como un límite. Un resultado imposible bajo la distribución no contribuye a la esperanza, aunque la sorpresa formal de observarlo fuera infinita. Ese producto límite no es una multiplicación ordinaria de cero por una cantidad indefinida.
Consideremos cuatro símbolos con probabilidades , , y . Sus sorpresas son uno, dos, tres y tres bits. El promedio es
La fuente tiene una entropía de bits por símbolo. Si las cuatro probabilidades fueran iguales, la entropía sería dos bits. La desigualdad de frecuencias introduce predictibilidad que puede aprovecharse al representar secuencias.
Para una variable binaria con probabilidad de uno, escribimos
Con probabilidades iguales, la entropía es un bit. Con probabilidad de uno, es aproximadamente bits. La mayor parte de las veces ocurre el resultado frecuente, aunque el raro sorprende más cuando aparece.
Podemos calcular ambas contribuciones. El resultado frecuente tiene sorpresa aproximada de bits; el raro, de . Multiplicarlas por nueve décimas y una décima, respectivamente, produce el promedio anterior.
La entropía es una propiedad de una distribución sobre resultados, cuya estimación exige datos o supuestos. No coincide con la sorpresa del resultado más probable ni con la del más raro, ni con el logaritmo del número de observaciones recogidas.
Dos variables pueden tener la misma entropía y distribuciones diferentes. Si necesitamos probabilidades de eventos específicos, debemos conservar más que un único número.
201.5. Por qué la distribución uniforme maximiza la incertidumbre
Para una variable con un máximo de categorías, la entropía satisface
El límite inferior se alcanza cuando una categoría tiene probabilidad uno. El superior se alcanza cuando las categorías tienen probabilidades iguales. Ambas afirmaciones son relativas al conjunto de categorías permitido.
Podemos entender el máximo mediante simetría y concavidad. La función es cóncava para probabilidades positivas. Promediar una distribución con versiones que permutan sus categorías produce la distribución uniforme. La concavidad implica que ese promedio no disminuye la entropía.
La igualdad en el máximo requiere uniformidad sobre las categorías consideradas, salvo las precisiones pertinentes sobre categorías imposibles. Si decimos que existen ocho categorías pero cuatro están excluidas por definición, el soporte efectivo contiene cuatro y el máximo relevante cambia.
Para una variable binaria, la derivada de la entropía es . Se anula en un medio. La segunda derivada es negativa en el interior del intervalo, por lo que ese punto es el máximo.
La forma de la curva muestra que aumentar la probabilidad de un evento no siempre aumenta la entropía. Si estaba por debajo de un medio, acercarlo al equilibrio aumenta la incertidumbre; si ya era el evento dominante, hacerlo todavía más probable la reduce.
Un aumento de frecuencia no implica, por tanto, un aumento de información, porque el efecto depende de la distribución completa.
El máximo bajo restricciones puede ser diferente de la distribución uniforme. Si conocemos una media, una energía o un costo esperado, no todas las distribuciones son admisibles. El principio de máxima entropía, que estudiaremos después, debe incluir esas restricciones y un espacio de referencia.
Tampoco debemos interpretar una entropía alta como ausencia de toda estructura. Una variable puede ser uniforme en un instante y tener dependencias temporales o relaciones fuertes con otras variables. El máximo marginal solo expresa incertidumbre cuando no usamos esa información adicional.
La desigualdad requiere un alfabeto finito. En alfabetos numerables infinitos no existe un máximo finito determinado solamente por el número de categorías. Algunas distribuciones tienen entropía finita y otras infinita; asegurar que sea finita exige condiciones adicionales.
Un ejemplo de alfabeto infinito aclara el alcance de la cota. Para enteros a partir de dos, podemos asignar probabilidades proporcionales a . La suma converge, de modo que existe una constante que normaliza la distribución.
Sin embargo, al multiplicar por la sorpresa aparece en la cola un término del orden de , cuya suma diverge. La distribución está bien definida y su entropía es infinita. No toda distribución con infinitas categorías tiene esa propiedad; la distribución geométrica, por ejemplo, tiene entropía finita.
El ejemplo tiene consecuencias para los límites de codificación. Antes de usar una entropía finita como tasa de referencia debemos comprobar que la distribución y el régimen considerados permiten ese valor; la analogía con alfabetos pequeños no lo garantiza.
201.6. Agrupar y distinguir cambia la pregunta
Supongamos tres resultados con probabilidades de un medio, un cuarto y un cuarto. Su entropía es uno coma cinco bits. Podemos identificar primero si ocurrió el primer resultado o alguno de los otros dos; esa primera distinción tiene un bit.
Si ocurrió el grupo de dos resultados, todavía necesitamos distinguir cuál de ellos fue. Dentro de ese grupo son equiprobables y añaden un bit, pero el grupo aparece solo la mitad de las veces. El promedio total es un bit más medio bit, igual que en el cálculo directo.
Esta propiedad de agrupación descompone la incertidumbre total en incertidumbre entre grupos e incertidumbre dentro de ellos. El próximo capítulo la desarrollará como regla de la cadena. Aquí permite entender por qué fusionar categorías elimina determinadas distinciones.
Si un sensor solo informa si ocurrió el primer resultado o alguno de los otros dos, conserva la distinción entre grupos y pierde la distinción interna. La entropía del registro reducido es un bit. Lo que cambió es la observación; la diferencia no muestra que el sistema físico se haya vuelto menos variable.
Dividir una categoría puede aumentar la entropía si la nueva variable distingue resultados que antes se trataban como equivalentes. Si añadimos etiquetas arbitrarias generadas por ruido, también podemos aumentar la entropía del archivo sin mejorar la descripción de la propiedad que interesa.
Por ejemplo, una categoría fija puede acompañarse de un bit aleatorio independiente. El registro ampliado tiene un bit de incertidumbre, aunque la categoría original siga siendo completamente predecible. La cantidad de variación registrada y la información relevante para una tarea no coinciden necesariamente.
Comparar entropías exige, por ello, mantener los mismos criterios de discretización. Diez intervalos estrechos suelen distinguir más resultados que dos intervalos amplios. La diferencia puede deberse al diseño del registro aunque el proceso no haya cambiado.
Una normalización por el máximo posible puede ayudar a comparar ciertas distribuciones, pero tampoco elimina todas las diferencias. Dos discretizaciones pueden agrupar de manera distinta precisamente los estados que importan. Dividir por el logaritmo del número de categorías no recupera la información descartada.
La selección de variables es una decisión científica que debe responder a la pregunta y al modelo de medición. Calcular una entropía con gran precisión después de una selección inadecuada no resuelve ese problema inicial.
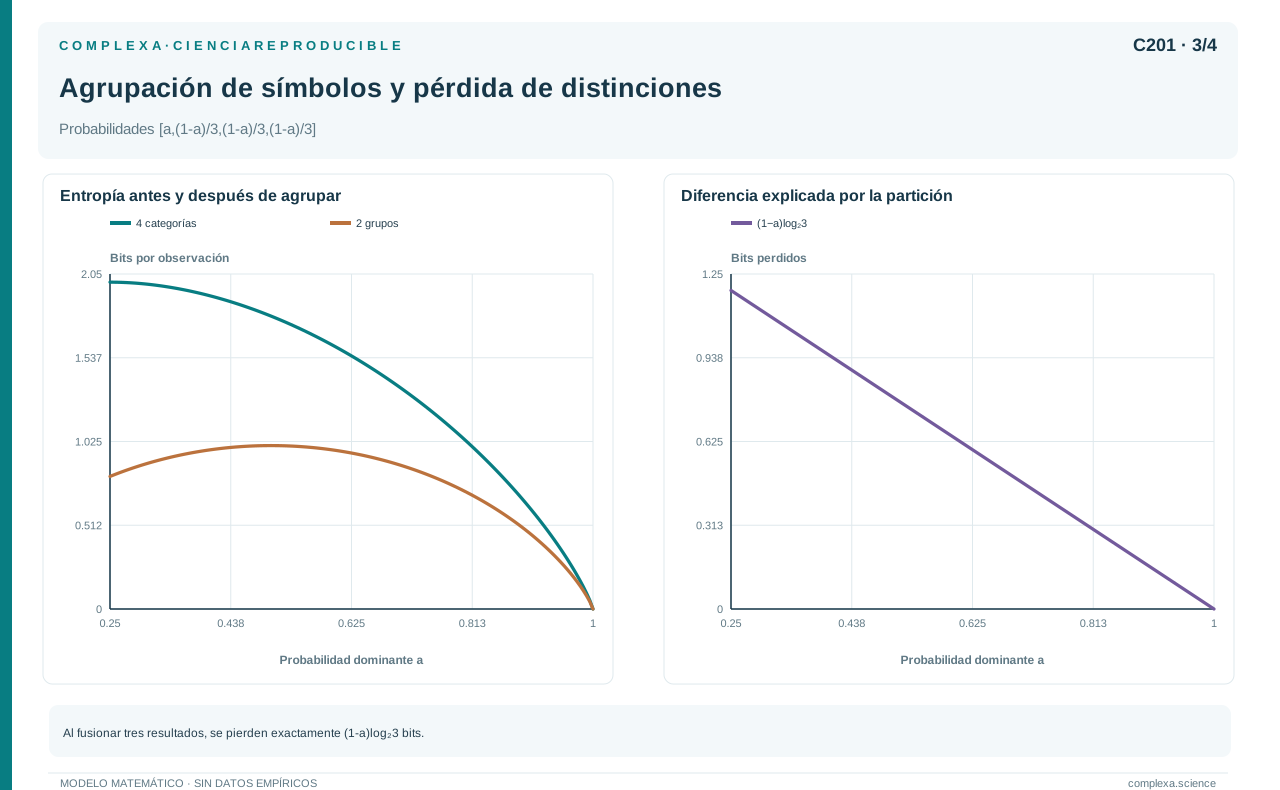
Podemos repetir el cálculo de agrupación con probabilidades desiguales. Supongamos un resultado dominante de probabilidad y otros tres de probabilidad cada uno. La primera pregunta distingue el dominante del grupo restante y tiene entropía .
Dentro del grupo restante hay tres posibilidades equiprobables. Su incertidumbre adicional es el logaritmo de tres, ponderado por la probabilidad de entrar en ese grupo. El total es aproximadamente bits, frente a unos bits si solo conservamos la distinción inicial.
La diferencia, aproximadamente bits, identifica exactamente qué se pierde al fusionar las tres categorías minoritarias. No hace falta atribuir el cambio a una noción vaga de orden, porque corresponde a una pregunta concreta que el nuevo registro ya no puede responder.
201.7. Incertidumbre, tiempo y conocimiento disponible
Consideremos dos fuentes binarias. La primera produce una secuencia de resultados independientes y equiprobables. La segunda elige una sola vez un bit equiprobable y lo repite indefinidamente. En cualquier instante aislado, ambas tienen una distribución uniforme y una entropía de un bit.
Sin embargo, sus secuencias son muy diferentes. Para la primera fuente, un bloque de longitud tiene bits de entropía. Para la segunda, el bloque solo puede ser una cadena de ceros o una cadena de unos, por lo que tiene un bit en total.
Después de observar el primer símbolo de la fuente repetitiva, conocemos todos los siguientes dentro de ese modelo. La entropía marginal de cada posición, considerada sin esa observación, no ha cambiado. Lo que cambia es la incertidumbre condicionada al pasado.
La diferencia muestra por qué una medida de un solo instante no caracteriza la complejidad temporal. Debemos estudiar bloques, condiciones y tasas. Estos conceptos se desarrollarán en el módulo siguiente, donde la memoria predictiva ocupará un lugar central.
También podemos comparar observadores con conocimientos distintos. Quien conoce el bit elegido por la segunda fuente no tiene incertidumbre sobre ningún símbolo. Quien lo desconoce tiene inicialmente un bit. La situación física puede ser la misma y la distribución pertinente diferente.
Esta dependencia no convierte todos los cálculos en opiniones arbitrarias. Un modelo probabilístico puede evaluarse mediante sus predicciones y la información que realmente estaba disponible. Lo necesario es declarar el contexto que justifica esas probabilidades.
Una dinámica determinista puede generar registros difíciles de predecir cuando desconocemos con suficiente precisión su estado inicial. A la inversa, una variable observable puede ser predecible aunque el sistema contenga otros componentes aleatorios. Decidir si la dinámica subyacente es determinista exige más información que la entropía de un registro.
La información de Shannon tampoco equivale a complejidad algorítmica. Una fuente puede asignar la misma probabilidad a muchas secuencias, mientras algunas tienen descripciones cortas por sus regularidades particulares. Las relaciones y diferencias entre descripción, cálculo y estadística requieren otros conceptos.
El análisis gana precisión cuando preguntamos qué incertidumbre permanece para qué observador, sobre qué variable y después de qué datos. Esa formulación evita atribuir a un número aislado una interpretación que depende de condiciones no especificadas.
201.8. De la entropía a la representación
Volvamos a los cuatro símbolos con probabilidades un medio, un cuarto, un octavo y un octavo. Podemos asignarles, respectivamente, las palabras binarias 0, 10, 110 y 111. Ninguna palabra completa es el comienzo de otra, de modo que una secuencia concatenada puede decodificarse sin separadores entre palabras.
Sus longitudes son uno, dos, tres y tres bits. La longitud promedio es uno coma setenta y cinco bits por símbolo, igual a la entropía de esa distribución. En este caso particular las probabilidades permiten longitudes enteras exactamente iguales a las sorpresas.
La coincidencia no ocurre para cualquier distribución mediante un código símbolo a símbolo. Los códigos deben satisfacer restricciones que permitan distinguir mensajes. Los resultados de codificación relacionan la entropía con longitudes promedio y con límites alcanzables bajo condiciones apropiadas.
No afirman que cada mensaje individual pueda representarse con un número de bits igual a su entropía. Algunos mensajes requieren más y otros menos. Tampoco eliminan el costo de comunicar el código, la longitud del mensaje o la estructura necesaria para interpretar el archivo.
Si emisor y receptor ya comparten el código, ese costo puede amortizarse sobre muchos símbolos. Si cada archivo pequeño necesita incluir una descripción nueva del código, la cabecera puede dominar el tamaño total. Un límite asintótico y un archivo concreto responden a escalas distintas.
La dependencia temporal puede permitir otros ahorros. Una secuencia repetitiva puede describirse mediante un símbolo y una longitud, mientras una representación independiente de cada posición desperdicia esa estructura. Para cuantificar el límite relevante necesitamos, además de la marginal, la distribución de bloques.
En el ejemplo de cuatro símbolos, diez mil emisiones requieren en promedio diecisiete mil quinientos bits con el código indicado, frente a veinte mil con dos bits fijos por símbolo. El ahorro esperado es de doce coma cinco por ciento, antes de cabeceras y otros costos. Una secuencia particular tendrá una longitud diferente si sus frecuencias se apartan de las probabilidades. Para verificar una implementación conviene comparar el tamaño real con sus conteos efectivos; para evaluar el rendimiento de la fuente, interesa además el promedio entre realizaciones.
La redundancia estadística tampoco coincide siempre con datos prescindibles para una tarea. Una repetición puede ser útil para detectar errores, sincronizar un protocolo o asegurar comprensión. La teoría de canales estudia cómo añadir redundancia deliberadamente para transmitir de manera fiable.
Así aparecen dos problemas complementarios. La compresión busca evitar distinciones de representación innecesarias; la comunicación fiable puede añadir estructura para resistir perturbaciones. Ambos usan información probabilística, pero optimizan objetivos diferentes.
201.9. Estimar una entropía a partir de datos
Si conocemos la distribución, el cálculo es directo. Si solo tenemos datos, una estrategia elemental estima probabilidades mediante frecuencias relativas y las sustituye en la fórmula. Esa estimación puede ser útil, pero tiene sesgos y depende de la cobertura y del tamaño muestral.
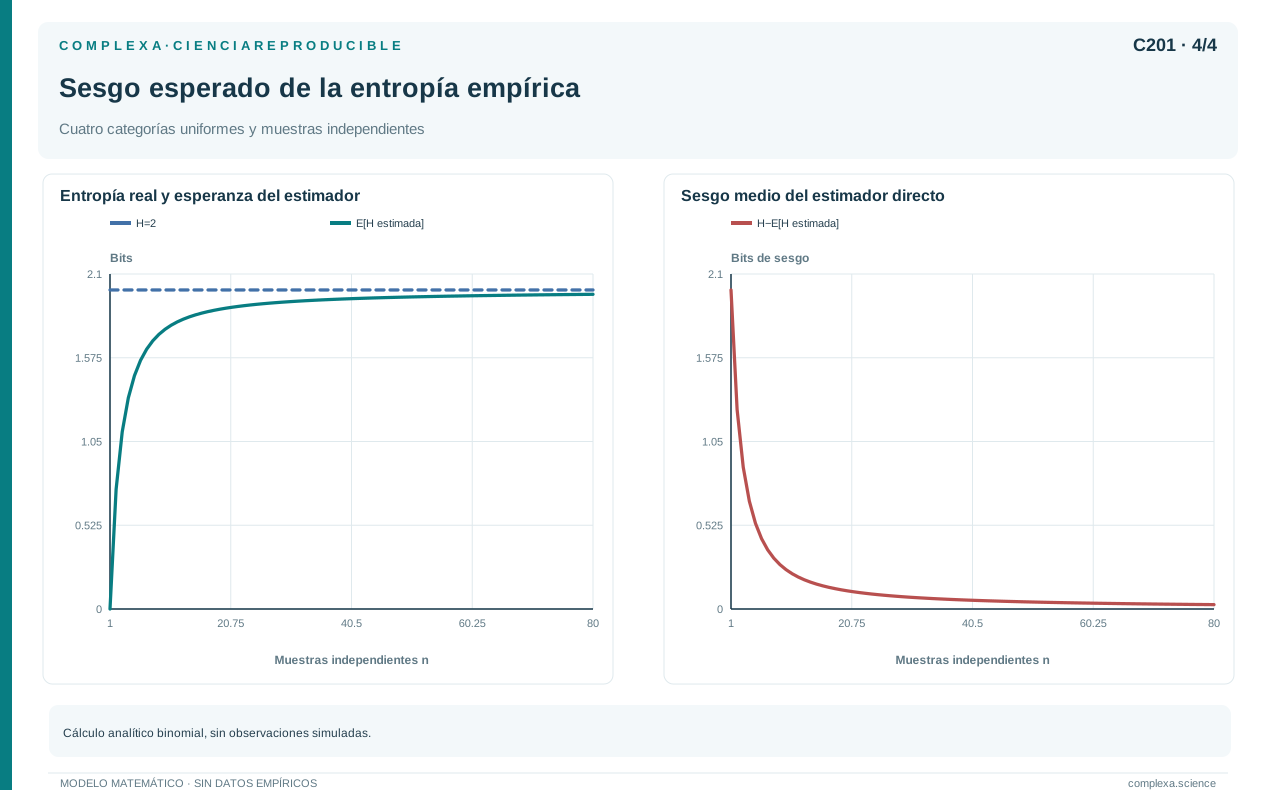
Un ejemplo exacto muestra el problema. Supongamos una fuente uniforme de cuatro categorías, cuya entropía verdadera es dos bits. Observamos únicamente dos resultados independientes. Si ambos coinciden, la distribución empírica asigna probabilidad uno a una categoría y su entropía es cero.
Si los dos resultados difieren, la distribución empírica asigna un medio a cada categoría observada y su entropía es un bit. La probabilidad de coincidencia es un cuarto; la de diferencia, tres cuartos. La entropía empírica esperada es, por tanto, tres cuartos de bit.
El estimador subestima mucho la entropía verdadera en esta muestra diminuta. El cálculo no necesita simulación; basta enumerar las dieciséis parejas equiprobables, de las cuales cuatro son coincidencias y doce contienen resultados distintos.
En problemas de gran alfabeto, muchas categorías pueden quedar sin observar incluso con muestras aparentemente grandes. Declararlas imposibles reduce artificialmente la incertidumbre. Las correcciones y modelos de estimación deben responder a la relación entre cobertura, restricciones y cantidad de datos.
La dependencia temporal añade otra dificultad. Dos mil registros muy próximos pueden contener mucha menos información para estimar una distribución que dos mil observaciones independientes. El tratamiento de incertidumbre debe respetar cómo se recogieron los datos.
También hay que considerar cambios de distribución durante el registro. Mezclar períodos con comportamientos distintos puede aumentar la entropía marginal aunque cada período sea relativamente predecible. Esa mezcla puede ser pertinente para una pregunta y engañosa para otra.
Una presentación responsable declara categorías, ventana temporal, tratamiento de valores ausentes y procedimiento de estimación. Si compara grupos o condiciones, debe comprobar que sus diferencias no procedan únicamente de tamaños muestrales o resoluciones distintos.
Los métodos específicos se desarrollarán más adelante. Por ahora basta distinguir la cantidad poblacional que define la fórmula del valor calculado desde una muestra, que añade un problema de inferencia.
El sesgo del estimador por sustitución tiene una explicación general para un alfabeto finito. Las frecuencias empíricas son estimadores insesgados de cada probabilidad bajo muestreo independiente de la misma distribución. La entropía, en cambio, es una función no lineal y cóncava de ese vector de frecuencias.
La desigualdad de Jensen implica que la entropía esperada del vector empírico no supera la entropía de su esperanza. Como esa esperanza es la distribución verdadera, aparece el sesgo descendente. La demostración explica una dirección promedio; no afirma que todas las muestras particulares produzcan un valor inferior.
Una muestra concreta puede parecer más equilibrada que la población y arrojar una entropía superior a la verdadera. Los intervalos y correcciones deben reconocer la variación entre muestras, además del sesgo.
201.10. Qué cambia cuando la variable es continua
Con una variable continua no podemos asignar a cada valor exacto una probabilidad ordinaria positiva ni aplicar directamente la fórmula discreta como una suma infinita. Las densidades y las probabilidades de intervalos cumplen papeles diferentes.
Hay una entropía diferencial, definida mediante una integral de la densidad por su logaritmo. A diferencia de la entropía discreta, puede ser negativa y cambia al reescalar la coordenada. Por ello no debe leerse como el número de bits necesarios para registrar un valor real exacto.
Una distribución uniforme entre cero y uno tiene entropía diferencial cero en esa coordenada. Si expresamos la misma magnitud en una unidad cien veces menor, su intervalo numérico pasa de cero a cien y la entropía diferencial aumenta en el logaritmo de cien. La situación física no se volvió más incierta por cambiar de unidad.
En una medición real hay una resolución. Al discretizar una densidad suficientemente regular en intervalos pequeños, la entropía discreta incluye un término que depende del tamaño de esos intervalos, además de la entropía diferencial. La resolución debe formar parte de la comparación.
La relación con la entropía de la física también exige condiciones. Una expresión estadística sobre microestados puede convertirse en una entropía con unidades físicas mediante una constante apropiada y un modelo de estados. No toda entropía de etiquetas observadas obedece por ello una ley termodinámica.
El trabajo de Jaynes sobre información y mecánica estadística conecta inferencia y restricciones físicas. Esa conexión no autoriza a tratar la incertidumbre de un clasificador o de una señal digital como calor, desorden material o irreversibilidad sin una derivación adicional.
La información de Shannon es una herramienta precisa cuando mantenemos visibles sus objetos (variable, distribución, conocimiento disponible y unidad). A partir de esta base podemos estudiar cómo se reparte la incertidumbre entre varias variables y qué cambia cuando observamos una parte del sistema.
Referencias
- Shannon, C. E. (1948). A mathematical theory of communication. The Bell System Technical Journal, 27(3), 379–423. DOI.
- Shannon, C. E. (1948). A mathematical theory of communication, continuación. The Bell System Technical Journal, 27(4), 623–656. DOI.
- Jaynes, E. T. (1957). Information theory and statistical mechanics. Physical Review, 106, 620–630. DOI.