82.1. Una distribución cambia cuando conocemos algo
C81 introdujo distribuciones conjuntas, marginalización e independencia. Una distribución conjunta describe cómo se reparte probabilidad entre configuraciones posibles antes de saber cuál de ellas ocurrió. El siguiente paso es preguntar qué ocurre cuando obtenemos información parcial.
Supongamos que conocemos la distribución conjunta de dos variables e , pero observamos que
Las configuraciones incompatibles con esa observación dejan de ser posibles para la pregunta actual. Las probabilidades restantes deben renormalizarse para volver a sumar uno. Esa es la idea central del condicionamiento.
La probabilidad condicional cambia la distribución relevante una vez conocido un evento, sin que ello introduzca necesariamente una nueva dinámica ni una nueva causalidad. Puede representar una actualización temporal, pero también una selección, una restricción lógica o simplemente una pregunta diferente sobre la misma distribución conjunta.
C82 desarrollará cuatro piezas conectadas, a saber, la probabilidad condicional, la ley de probabilidad total, el teorema de Bayes y la verosimilitud. El objetivo es mantenerlas separadas. La notación es compacta, mientras que los objetos matemáticos no son intercambiables.
82.2. Definición de probabilidad condicional
Sean y eventos con
La probabilidad de condicionada a se define por
El numerador contiene los resultados que satisfacen simultáneamente ambos eventos. El denominador restringe el universo de referencia a aquellos resultados donde ocurre.
La definición puede reorganizarse como
Intercambiando y ,
Estas dos factorizaciones de la misma probabilidad conjunta producirán el teorema de Bayes.
La división cumple una función precisa, pues normaliza la masa que permanece después de restringirnos a .
82.3. Retomar la tabla de C81
C81 estudió dos componentes binarios con
y una distribución dependiente donde
La tabla conjunta era
Si observamos , solo importa la segunda columna. Su masa total es
Por tanto,
Análogamente,
Ambas cantidades suman uno.
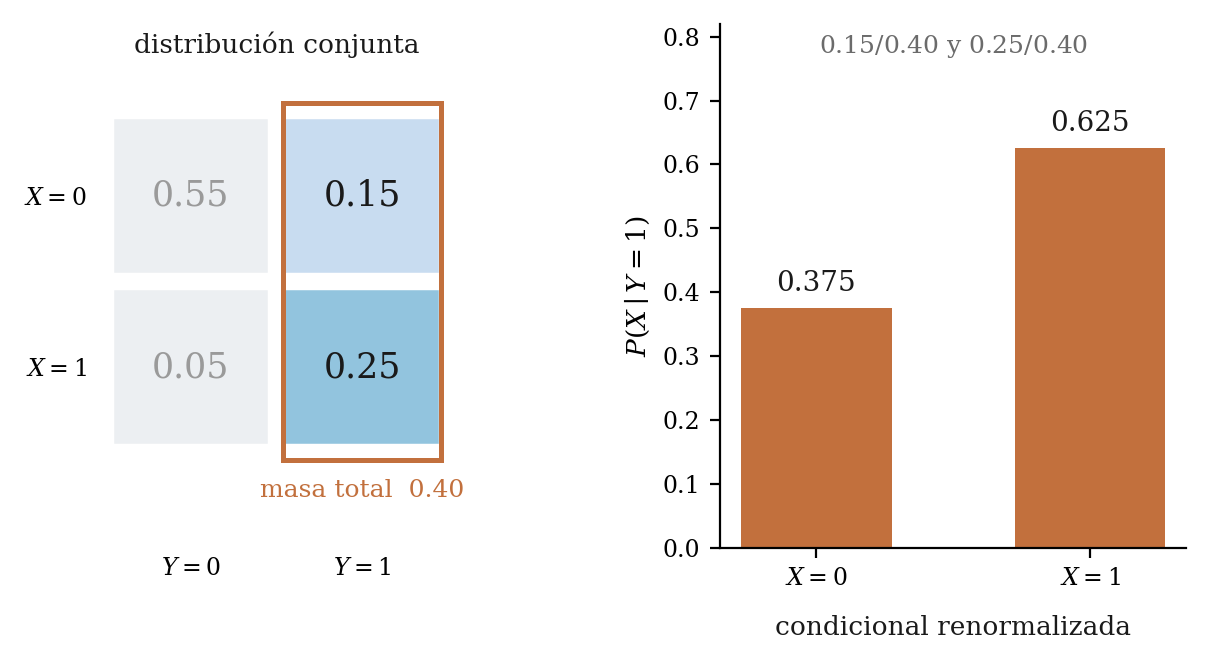
El condicionamiento construye una nueva distribución sobre dentro del subconjunto de realizaciones compatibles con , sin alterar la tabla original.
82.4. El orden de la barra importa
En general,
En el ejemplo,
mientras
La intersección es la misma. Lo que cambia es el conjunto utilizado para normalizar.
Esta diferencia es responsable de numerosos errores de interpretación. Saber que un estado produce con frecuencia cierta señal no equivale a saber con qué frecuencia ese estado está presente entre quienes muestran la señal. Bayes es la identidad que conecta ambas direcciones.
82.5. Independencia como invariancia frente al condicionamiento
Si y son independientes,
Cuando ,
Por tanto, una forma equivalente de expresar independencia es
Conocer no modifica la probabilidad de .
En términos de variables, si e son independientes, la distribución de condicionada a conocer coincide con su distribución marginal. Si cambia, existe dependencia probabilística.
Esta formulación también aclara que independencia y ausencia de información están relacionadas respecto de la distribución considerada, no respecto de cualquier descripción posible del sistema.
82.6. Condicionar puede crear dependencia
C81 terminó con un ejemplo que permite mostrar una sutileza adicional.
Sean y bits independientes y equiprobables. Definamos
Marginalmente, y son independientes.
Ahora condicionemos en
Los únicos estados compatibles son y cada uno con probabilidad condicional .
Así,
pero
Si fueran independientes después de condicionar, esperaríamos
La igualdad no se cumple.
La independencia marginal puede desaparecer al restringir el espacio de resultados. El condicionamiento modifica la estructura de dependencia, además de reducir el conjunto de realizaciones consideradas.
82.7. Probabilidad condicional en variables continuas
La definición
requiere .
Si es una variable absolutamente continua,
para cualquier valor individual. Por tanto, no podemos definir ingenuamente
dividiendo por .
Cuando existe una densidad conjunta, utilizamos la densidad condicional
para valores donde
La teoría general utiliza distribuciones condicionales regulares. Para este nivel basta con retener que condicionar en un valor continuo exacto difiere de condicionar en un evento discreto de probabilidad positiva.
82.8. Particiones y ley de probabilidad total
Supongamos que
forman una partición del espacio muestral:
y
Para cualquier evento ,
Las intersecciones son disjuntas, de modo que
Usando
obtenemos
Esta es la ley de probabilidad total, que permite calcular la probabilidad marginal de una observación combinando sus probabilidades bajo distintos estados posibles.
82.9. Un régimen oculto y un sensor imperfecto
Consideremos un sistema que puede encontrarse en un régimen oculto con probabilidad previa
El régimen complementario es , con probabilidad .
Disponemos de un sensor binario que emite una señal positiva . Si el sistema está en ,
Si no está en ,
Por tanto,
Antes de invertir la inferencia necesitamos la probabilidad marginal de una señal positiva. Por probabilidad total,
Sustituyendo,
La mayoría de las oportunidades de producir falsos positivos procede del estado frecuente . Ese dato pesará al interpretar la señal.
82.10. Derivación elemental del teorema de Bayes
Partimos de
También,
Igualando,
Si ,
Sustituyendo la probabilidad total en el denominador,
En nuestro ejemplo,
Una señal positiva aumenta la probabilidad de desde 0.02 hasta aproximadamente 0.162, lejos del 0.95 que caracteriza al sensor.
82.11. La misma cuenta mediante frecuencias naturales
La aritmética puede visualizarse sin porcentajes abstractos.
Imaginemos 10.000 realizaciones. Aproximadamente están en , y en .
Entre las 200 realizaciones en , el sensor produce aproximadamente positivos.
Entre las 9800 realizaciones en , produce falsos positivos.
Por tanto, existen aproximadamente señales positivas. De ellas, solo 190 corresponden a .
Así,
Este razonamiento es Bayes expresado mediante conteos esperados, con la ventaja de dejar visible el efecto de la tasa previa.
82.12. La tasa previa forma parte del resultado
El número
describe el comportamiento del sensor bajo un estado conocido, cantidad distinta de la probabilidad posterior del estado después de observar la señal.
La figura siguiente mantiene fija la sensibilidad en 0.95 y la tasa de falsos positivos en 0.10, pero varía
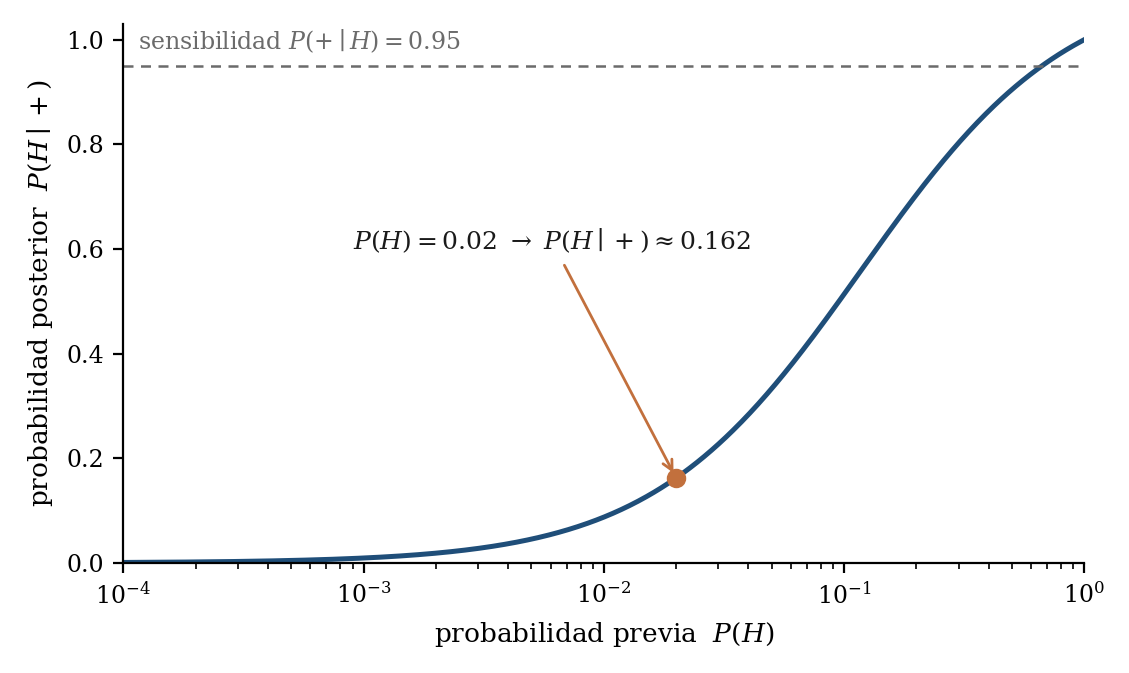
Con el mismo sensor, una señal positiva tiene implicaciones distintas si era extremadamente raro o relativamente frecuente.
Ignorar la tasa previa equivale a descartar parte de la distribución necesaria para invertir la condición.
82.13. Una señal negativa
La misma estructura funciona para una señal negativa.
Tenemos
La probabilidad total es
Por Bayes,
Una señal negativa reduce la probabilidad del régimen oculto.
Bayes es una transformación coherente de una distribución previa en una posterior según qué observación ocurrió, con independencia de que el resultado suba o baje la confianza en la hipótesis.
82.14. Forma de odds y razón de verosimilitudes
Para dos hipótesis complementarias podemos trabajar con odds.
Las odds previas de son
Después de observar ,
Aplicando Bayes,
El factor
es una razón de verosimilitudes entre las dos hipótesis simples.
Para una señal positiva,
Las odds previas son
Multiplicarlas por 9.5 produce las odds posteriores. Convertidas de nuevo a probabilidad recuperan exactamente .
82.15. Qué es una verosimilitud
La palabra verosimilitud cambia cuál variable consideramos fija.
Supongamos una familia de modelos parametrizados por , con distribución
Antes de observar los datos, para un fijo,
es una distribución de probabilidad sobre resultados posibles.
Después de observar
definimos la función de verosimilitud
Ahora los datos permanecen fijos y variamos .
La expresión algebraica puede ser la misma, mientras el objeto matemático cambia. Por sí sola, la verosimilitud carece de la normalización que exigiría una distribución de probabilidad sobre .
82.16. Siete éxitos en diez ensayos de Bernoulli
Supongamos diez ensayos de Bernoulli independientes con probabilidad de éxito y observamos éxitos.
La probabilidad de observar exactamente siete éxitos, para un fijado, es
Una vez observado , la verosimilitud es
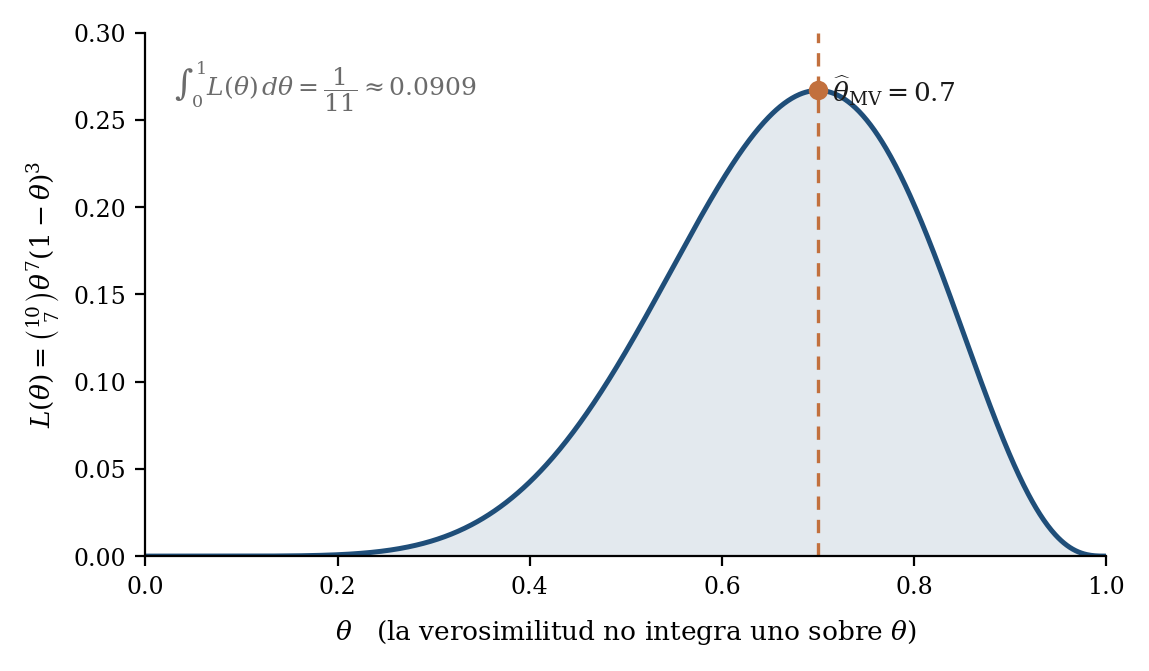
La función alcanza su máximo en
Esto no significa
Ni siquiera hemos especificado una distribución de probabilidad para .
82.17. La verosimilitud no necesita integrar uno
Una densidad de probabilidad sobre tendría que integrar uno.
La verosimilitud anterior satisface
Ese valor no plantea ninguna dificultad, porque la verosimilitud no está obligada a normalizar respecto de .
Si multiplicamos por una constante positiva que no depende de ,
las comparaciones relativas entre valores de no cambian.
Por eso a menudo se grafica
La escala vertical absoluta no debe interpretarse como una probabilidad del parámetro.
82.18. Verosimilitud, prior y posterior
Para convertir información sobre los datos en una distribución posterior sobre necesitamos una distribución previa
La forma continua de Bayes puede escribirse
El numerador es
El denominador normaliza el producto para que la posterior integre uno. También es la probabilidad marginal o densidad predictiva de los datos bajo el modelo previo completo.
Si elegimos una prior uniforme en para el ejemplo binomial, la posterior es proporcional a
Ahora sí, después de normalizar, obtenemos una distribución de probabilidad sobre .
La distinción debe conservarse:
Bayes conecta ambos objetos sin identificarlos. Mantener esta separación evita leer una curva de verosimilitud como si ya expresara grados posteriores de creencia o frecuencias poblacionales de los parámetros.
82.19. La evidencia en el denominador
En la forma discreta,
El denominador
recibe a menudo el nombre de evidencia o probabilidad marginal de los datos.
Su función inmediata es normalizar las probabilidades posteriores:
El denominador tiene además significado probabilístico propio. Responde a cuán probable era observar bajo la mezcla completa de hipótesis, antes de saber cuál de ellas produjo los datos.
En el ejemplo del sensor,
Ese valor depende tanto de las características del sensor como de la distribución previa de los estados, de modo que cambia con el contexto.
82.20. Actualización secuencial
Bayes puede aplicarse más de una vez.
Supongamos que recibimos dos señales positivas
Si asumimos que son condicionalmente independientes dado y dado ,
mientras
Entonces
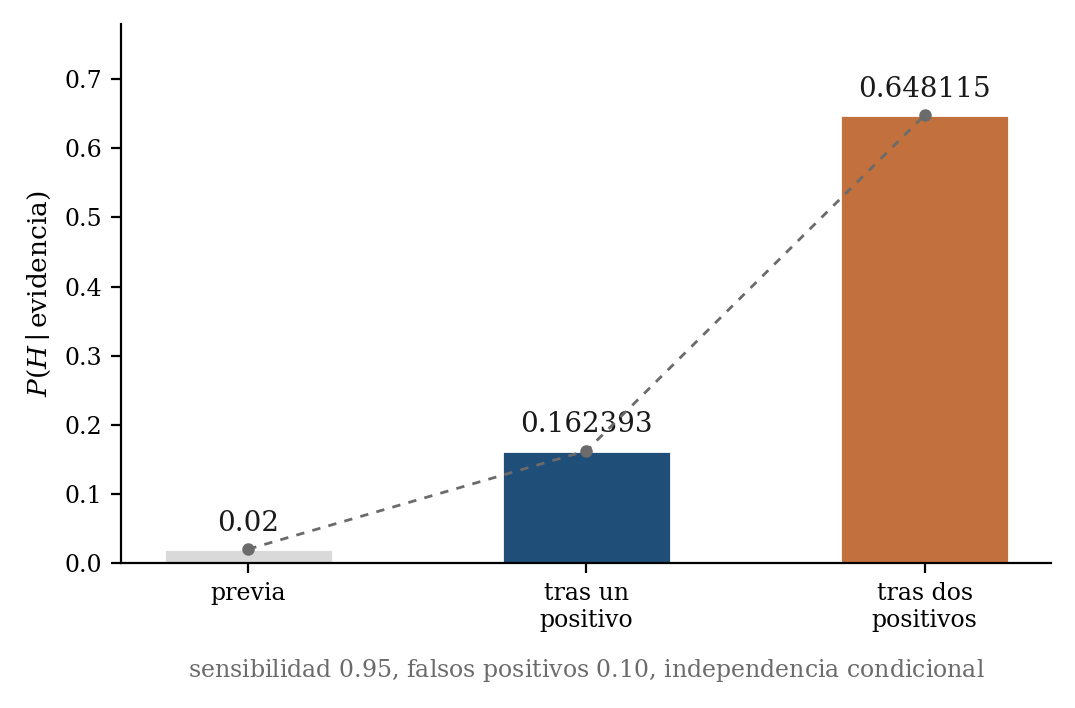
El segundo positivo aporta información adicional porque hemos supuesto que, una vez fijado el estado oculto, las dos mediciones aportan evidencia independiente.
82.21. Repetir evidencia no siempre multiplica información
La independencia condicional del ejemplo anterior es un supuesto.
Si dos sensores comparten la misma fuente de error, o si la segunda lectura reutiliza datos de la primera, entonces
en general.
Multiplicar dos razones de verosimilitud como si provinieran de observaciones independientes puede contar dos veces la misma información.
Esta es una conexión directa con C81. La dependencia importa para describir el sistema y también para saber cuánto aprendizaje aporta una colección de observaciones.
Una secuencia de cien mediciones casi idénticas y fuertemente correlacionadas no equivale automáticamente a cien piezas independientes de evidencia.
82.22. Independencia condicional no es independencia marginal
También puede ocurrir lo contrario del ejemplo XOR.
Supongamos un estado oculto que modifica simultáneamente dos sensores y . Dentro de cada estado, los errores de ambos sensores pueden ser independientes:
y
Sin embargo, al ignorar , y pueden aparecer dependientes porque comparten una causa estadística común dentro del modelo.
Condicionar puede entonces eliminar dependencia o crearla, según la arquitectura de la distribución conjunta.
No existe una regla general según la cual «condicionar siempre reduce incertidumbre entre variables» o «si dos variables son independientes lo seguirán siendo bajo cualquier condición».
82.23. Condicional no significa causal
La expresión
no afirma que cause .
Puede describir una relación temporal, una asociación simultánea, una selección o una restricción puramente matemática.
En XOR, condicionar en crea dependencia entre y , aunque fue definido a partir de ambos.
La probabilidad condicional pertenece al lenguaje de distribuciones. La causalidad requiere estructura adicional sobre qué variables pueden intervenirse, qué relaciones se mantienen bajo intervención y qué supuestos conectan observación con mecanismo.
Esta separación reaparecerá cuando el currículo llegue a inferencia causal. En C82 basta con no introducir causalidad mediante la barra vertical.
82.24. La inversión accidental de la condición
Supongamos que un patrón aparece frecuentemente cuando un sistema está en régimen :
No podemos concluir
Para calcular la segunda cantidad necesitamos al menos y la frecuencia de cuando no está presente.
El error surge porque ambas expresiones comparten los mismos símbolos, pero normalizan sobre conjuntos diferentes.
Una forma práctica de detectarlo es traducir la notación:
significa «probabilidad de la evidencia si fuera el estado».
En cambio,
significa «probabilidad del estado dentro de los casos compatibles con la evidencia».
La traducción verbal no sustituye la matemática, pero hace visible una inversión accidental.
82.25. Bayes no elimina la dependencia del modelo
El teorema de Bayes es una identidad matemática. La calidad de una aplicación depende de las probabilidades que introducimos.
Si la sensibilidad del sensor está mal estimada, si la tasa previa corresponde a otra población o si asumimos independencia condicional donde no existe, la posterior puede estar mal calibrada aunque la aritmética sea impecable.
Bayes organiza coherentemente supuestos y datos, sin garantizar que esos supuestos representen bien el sistema.
La transparencia del cálculo es una ventaja porque permite localizar dónde entra cada supuesto:
Cada término puede discutirse por separado.
82.26. Qué significa una prior
Una distribución previa no tiene una única interpretación obligatoria.
Puede representar información acumulada antes de la observación actual, describir una frecuencia poblacional o servir para regularizar parámetros. En otros contextos formaliza incertidumbre epistemológica sobre valores desconocidos.
Lo relevante es que su papel matemático sea explícito.
En el ejemplo del sensor, es una probabilidad previa de estados. Si esa tasa cambia entre contextos, la posterior cambia aunque el mecanismo de medición permanezca igual.
En problemas con parámetros continuos, elegir una prior exige más decisiones sobre soporte, escala, concentración y sensibilidad de la posterior frente a elecciones alternativas. Este capítulo no desarrollará aún inferencia bayesiana completa. El objetivo es entender la arquitectura elemental de la actualización.
82.27. Bayes con más de dos estados posibles
La forma binaria frente a es útil para derivar el teorema, pero muchos sistemas admiten varios estados mutuamente excluyentes.
Supongamos una partición
con probabilidades previas
Después observamos un evento . Para cada estado conocemos o postulamos la probabilidad
La probabilidad total de la evidencia es
Bayes produce entonces
Esta expresión puede interpretarse como dos operaciones. Primero asignamos a cada estado un peso no normalizado
Después normalizamos:
La evidencia redistribuye masa entre las posibilidades según dos factores, el peso que tenían antes y la compatibilidad de la observación con cada una, sin que ninguna quede seleccionada automáticamente.
Esto importa cuando varias explicaciones producen la misma señal con probabilidades parecidas. Una observación puede aumentar el peso de una familia de hipótesis sin concentrar la posterior en una sola.
También muestra por qué una hipótesis con verosimilitud máxima no tiene necesariamente la probabilidad posterior máxima. Si dos hipótesis y tienen
pero tenía una probabilidad previa mucho menor, puede ocurrir
La inferencia por máxima verosimilitud y la actualización bayesiana responden, por tanto, a preguntas relacionadas pero distintas.
82.28. Ceros, soporte y actualización
Bayes también obliga a prestar atención a los ceros.
Si
entonces, siempre que la formulación ordinaria sea aplicable,
Ninguna verosimilitud finita puede recuperar masa posterior desde una hipótesis a la que el modelo asignó probabilidad previa exactamente nula.
Un cero previo es, por tanto, una afirmación estructural fuerte que excluye esa posibilidad del soporte del modelo, aunque de ello no se sigue que toda prior deba asignar probabilidad positiva a cualquier posibilidad imaginable.
Existe un segundo tipo de cero. Si
la observación descarta dentro del modelo, porque esa hipótesis declaraba imposible la evidencia observada.
Un tercer caso es más problemático. Si
la expresión elemental
no está definida. En modelos continuos, como vimos al condicionar en , este problema requiere trabajar con densidades o distribuciones condicionales regulares en lugar de dividir probabilidades puntuales.
Los ceros exactos deben distinguirse de números muy pequeños. Una verosimilitud de no declara imposible un resultado. Puede volverse relevante si otras hipótesis asignan probabilidades aún menores.
En implementación numérica, esta diferencia también importa. Redondear a cero probabilidades extremadamente pequeñas puede convertir una afirmación de «muy improbable» en «imposible» y alterar actualizaciones posteriores de forma irreversible.
82.29. Verosimilitud relativa y log-verosimilitud
La verosimilitud se interpreta principalmente mediante comparaciones.
Para dos valores de parámetro y ,
indica cuánto más compatibles son los datos observados con uno que con otro dentro de la familia especificada.
Si multiplicamos toda la función por una constante independiente de ,
Por eso los factores que no dependen del parámetro pueden omitirse al buscar el máximo de verosimilitud.
En muestras con muchas observaciones independientes, la verosimilitud suele ser un producto:
Los productos de muchos números menores que uno pueden volverse extremadamente pequeños en aritmética de precisión finita. Se utiliza entonces la log-verosimilitud
Como el logaritmo es estrictamente creciente,
El máximo no cambia, pero el cálculo se vuelve más estable y los productos se transforman en sumas.
Esta operación tampoco convierte la verosimilitud en probabilidad. La log-verosimilitud puede ser negativa, positiva o desplazarse por una constante según la representación utilizada. Su función es comparar parámetros respecto de los mismos datos.
82.30. Protocolo elemental para una actualización bayesiana
Un cálculo de Bayes puede ser aritméticamente corto y conceptualmente incompleto. Antes de utilizar una posterior conviene explicitar la arquitectura del problema.
Primero se define el conjunto de hipótesis o estados. En el ejemplo fueron y . Esa elección determina qué alternativas pueden recibir probabilidad. Si falta una explicación relevante, ninguna actualización dentro del conjunto cerrado puede descubrirla por sí sola.
Después se especifica la distribución previa. Debe quedar claro qué población, estado inicial o información previa representa. Una tasa previa transportada desde otro contexto puede ser matemáticamente válida y empíricamente inadecuada.
El tercer componente es el modelo de observación:
Aquí se concentran supuestos sobre sensibilidad, errores, dependencia entre mediciones y estabilidad del instrumento. Si estas probabilidades cambian con el contexto, el modelo debe representarlo.
El cuarto paso es calcular la evidencia
y después la posterior.
Finalmente debe examinarse sensibilidad. Si pequeñas modificaciones plausibles de la prior o del modelo de observación producen cambios grandes en la posterior, esa fragilidad forma parte de la conclusión.
Este protocolo evita presentar Bayes como una calculadora que recibe dos porcentajes y entrega una verdad actualizada. El teorema garantiza coherencia entre probabilidades dentro del modelo. La adecuación del modelo sigue siendo una cuestión científica.
82.31. Una posterior alta no demuestra que el conjunto de modelos sea adecuado
Existe una limitación que conviene introducir desde el comienzo. Bayes redistribuye probabilidad dentro del conjunto de hipótesis que el modelo contiene.
Supongamos tres hipótesis . Después de observar , obtenemos
Esto significa que concentra el 90 % de la masa posterior entre esas tres alternativas, dadas las probabilidades especificadas. No implica que reproduzca bien todos los rasgos de los datos ni que no exista una cuarta explicación ausente del modelo.
Puede ocurrir que la evidencia observada sea muy improbable bajo todas las hipótesis:
puede dominar la posterior relativa porque explica mejor que sus competidoras, aunque siga siendo extraordinariamente inesperado bajo . La inferencia relativa y la adecuación absoluta son preguntas diferentes.
Este punto importa en sistemas complejos, donde el conjunto de modelos suele ser una simplificación deliberada. Una posterior concentrada puede justificar preferir provisionalmente una explicación dentro de la familia estudiada, pero no certifica que esa familia abarque el mecanismo real.
Por ello, además de actualizar probabilidades, conviene preguntar si el modelo genera observaciones comparables con las que realmente aparecen. Más adelante el currículo estudiará comprobaciones predictivas y comparación formal de modelos. Aquí basta conservar la advertencia conceptual:
no equivale necesariamente a
Bayes resuelve cómo actualizar dentro de una arquitectura probabilística especificada. La suficiencia de esa arquitectura queda fuera de su alcance.
82.32. Verificación computacional
El paquete reproducible ejecuta controles analíticos y numéricos.
Primero reconstruye la tabla conjunta dependiente de C81 y verifica
y
Después comprueba la ley de probabilidad total para el sensor, obteniendo y calcula las posteriores para señales positiva y negativa. La forma en odds reproduce exactamente los mismos resultados.
El código verifica además que dos señales positivas elevan la posterior a aproximadamente
Esa comprobación utiliza explícitamente la hipótesis de independencia condicional.
Para la verosimilitud binomial con siete éxitos en diez ensayos, localiza el máximo cerca de
compara la verosimilitud con y comprueba que
mostrando que la verosimilitud no está normalizada como densidad sobre . Al multiplicarla por una prior uniforme y normalizar, la posterior sí integra aproximadamente uno.
Finalmente se reutiliza XOR para verificar que y , independientes marginalmente, dejan de ser independientes al condicionar en .
Se ejecutaron 29 comprobaciones automáticas y las 29 resultaron satisfactorias.
82.33. Qué queda establecido
La probabilidad condicional restringe una distribución a un subconjunto de resultados compatible con información conocida y renormaliza la masa restante.
La ley de probabilidad total reconstruye una probabilidad marginal a partir de una partición. Bayes invierte el orden de una condición utilizando esa marginal como normalización.
La verosimilitud responde a otra operación. Fija los datos observados y compara cómo distintos parámetros o hipótesis los harían probables, sin ser por sí sola una probabilidad del parámetro.
Estas distinciones permiten modelar sistemas parcialmente observados sin convertir toda incertidumbre en una sola cantidad. El estado oculto, la observación, la tasa previa y el mecanismo de medición ocupan lugares diferentes en la distribución.
El próximo capítulo, C83, introducirá la esperanza, la varianza y la covarianza. Allí pasaremos de describir distribuciones completas a construir resúmenes cuantitativos de localización, dispersión y dependencia lineal, con una cautela ya establecida. Resumir una distribución no equivale a conservar toda su estructura.
Referencias
- Bayes, T. (1763). An essay towards solving a problem in the doctrine of chances. Philosophical Transactions of the Royal Society of London, 53, 370–418. https://doi.org/10.1098/rstl.1763.0053
- Berger, J. O. (1985). Statistical Decision Theory and Bayesian Analysis (2nd ed.). Springer. https://doi.org/10.1007/978-1-4757-4286-2
- Bernardo, J. M., & Smith, A. F. M. (1994). Bayesian Theory. Wiley. https://doi.org/10.1002/9780470316870
- Billingsley, P. (1995). Probability and Measure (3rd ed.). Wiley.
- Casella, G., & Berger, R. L. (2002). Statistical Inference (2nd ed.). Duxbury.
- Kallenberg, O. (2021). Foundations of Modern Probability (3rd ed.). Springer. https://doi.org/10.1007/978-3-030-61871-1
Recursos reproducibles
Descargar recursos del capítulo (ZIP, 270 kB).
4 archivos CSV · 4 figuras · 1 programa Python.
El programa se ha ejecutado en una carpeta vacía y genera los archivos de datos y figuras incluidos en el paquete.