83.1. De una distribución completa a unos pocos números
C81 introdujo distribuciones como objetos que asignan probabilidad a resultados posibles. C82 mostró cómo esas distribuciones cambian al condicionar y cómo Bayes reorganiza masa probabilística entre hipótesis o estados. Una distribución completa puede contener mucha información. Sin embargo, en numerosos problemas necesitamos resumir algunos de sus rasgos mediante cantidades más compactas.
Tres de las más utilizadas son:
y
La esperanza resume una localización promedio ponderada por probabilidad. La varianza cuantifica dispersión cuadrática alrededor de esa esperanza. La covarianza describe cómo dos variables se apartan conjuntamente de sus medias.
Estas cantidades resultan muy útiles porque obedecen identidades algebraicas simples y se propagan con facilidad a través de sumas y transformaciones lineales. Esa misma comodidad favorece que se sobreinterpreten. Dos distribuciones muy distintas pueden compartir media y varianza. Dos variables pueden tener covarianza cero mientras dependen entre sí de forma exacta. Una matriz de covarianza resume la geometría lineal de la distribución conjunta y deja fuera el resto de su estructura.
El objetivo de C83 será aprender qué dicen estos momentos, cómo se derivan y dónde dejan de ser suficientes.
83.2. Esperanza de una variable discreta
Sea una variable aleatoria discreta que toma valores
con probabilidades
Cuando la suma correspondiente es integrable, definimos
La esperanza es un promedio ponderado por probabilidad, distinto del valor que observaremos en una realización concreta.
Consideremos
con
Entonces
El valor ni siquiera pertenece al soporte de , lo que muestra que la esperanza puede quedar fuera de los resultados posibles.
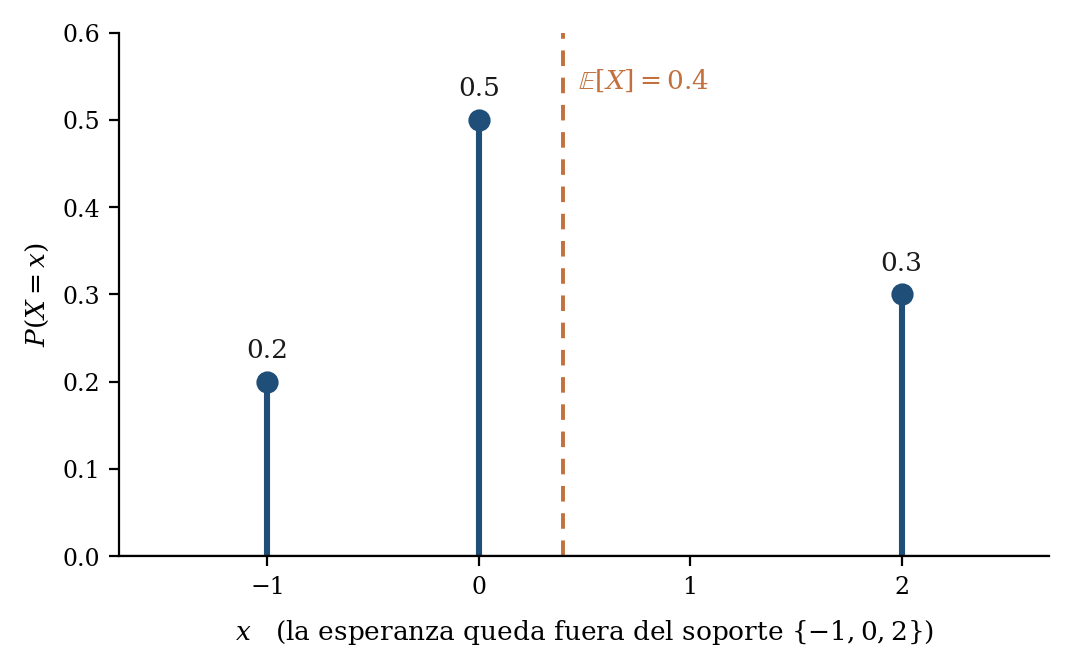
La interpretación correcta es geométrica y probabilística. Si repetimos el experimento bajo condiciones compatibles con la misma distribución, las contribuciones de los diferentes valores se ponderan según sus probabilidades.
83.3. Esperanza de una variable continua
Si tiene densidad y el momento es integrable,
Más generalmente, para una función ,
cuando la integral existe.
En la formulación de teoría de la medida, la definición más general es
Las fórmulas discretas y continuas son representaciones particulares de este mismo operador integral.
Bajo el cambio de notación permanece la misma idea. Una expectativa combina valores con la medida de probabilidad que los pondera.
83.4. Existencia de la esperanza
No toda variable aleatoria tiene una esperanza finita.
Una condición suficiente y, para variables reales, la condición estándar de integrabilidad es
Esto evita expresiones ambiguas del tipo
Considérese una variable discreta positiva con
La normalización funciona porque
Sin embargo,
y la serie armónica diverge. Por tanto,
El paquete reproducible conserva las sumas parciales. A , la masa acumulada ya es aproximadamente , pero la media parcial supera 7 y continúa creciendo lentamente. Una distribución puede estar bien normalizada y, aun así, carecer de media finita.
83.5. Linealidad de la esperanza
Entre las propiedades de la esperanza, la linealidad es la de mayor alcance.
Si e son integrables y son constantes,
La identidad no requiere independencia.
En particular,
Para una transformación afín
tenemos
En el ejemplo discreto anterior, con
El código verifica directamente este resultado sumando sobre la distribución transformada.
La linealidad hace que la esperanza de una suma pueda calcularse incluso cuando la estructura de dependencia es complicada. La varianza carecerá de esa simplicidad.
83.6. Esperanza de una transformación no lineal
En general,
El caso más importante para este capítulo es
Para la variable discreta del ejemplo,
En cambio,
La diferencia entre ambas cantidades es la varianza.
Esta separación aparece en muchos modelos no lineales. Conocer la media de una entrada no basta para predecir la media de una salida no lineal. Si el sistema aplica , la forma completa de la distribución puede influir en
83.7. Definición de varianza
Si tiene segundo momento finito, definimos
La varianza mide la distancia cuadrática promedio respecto de la media.
Como el integrando es no negativo,
Además,
si y solo si
casi seguramente.
La varianza mide dispersión respecto de una localización específica, la esperanza, con una penalización cuadrática. La descripción vaga «qué tan lejos están los valores» omite ambos elementos.
La desviación estándar se define como
A diferencia de la varianza, tiene las mismas unidades físicas que .
83.8. La identidad
Partimos de
donde
Expandiendo,
Aplicando linealidad,
Como
obtenemos
Por tanto,
siempre que los momentos requeridos existan.
Para nuestro ejemplo,
83.9. Traslación y cambio de escala
Sea
Su media es
Restando esa media,
Al elevar al cuadrado,
Por tanto,
La constante aditiva desaparece porque una traslación no modifica la dispersión.
El factor aparece al cuadrado. Si una longitud se expresa en centímetros en vez de metros, la varianza cambia por el cuadrado del factor de conversión. La desviación estándar cambia linealmente.
Esto explica las unidades:
83.10. Varianza de una suma
Para dos variables e ,
Definamos
Entonces
Expandiendo,
Los dos primeros términos son las varianzas. El tercero conduce a la covarianza.
83.11. Definición de covarianza
La covarianza entre e se define por
si el producto es integrable.
También puede escribirse
La derivación es inmediata al expandir el producto centrado.
La covarianza puede ser positiva, negativa o cero.
Si los valores altos de tienden a coincidir con valores altos de y los bajos con bajos, la covarianza suele ser positiva. Si desviaciones en sentidos opuestos tienden a coincidir, puede ser negativa.
Sin embargo, esta descripción es solo orientativa. La covarianza resume asociación lineal centrada y deja fuera otras formas de dependencia.
83.12. Varianza de la suma con covarianza
La identidad anterior se convierte en
sin necesidad de independencia.
Más generalmente,
Ahora aparece con claridad qué información faltaba al conocer solo las varianzas marginales. Para determinar la dispersión del agregado necesitamos también cómo fluctúan conjuntamente las variables.
83.13. Retomar el sistema binario de C81
En C81 fijamos
Como es Bernoulli,
Análogamente,
En el modelo independiente,
Por tanto,
En el modelo dependiente,
y entonces
Las marginales son exactamente las mismas. La covarianza detecta una diferencia que las varianzas individuales no contienen.
83.14. La dependencia cambia la varianza del agregado
Definamos nuevamente
Bajo independencia,
En el modelo dependiente,
El paquete calcula también la distribución completa de y obtiene la misma varianza directamente.
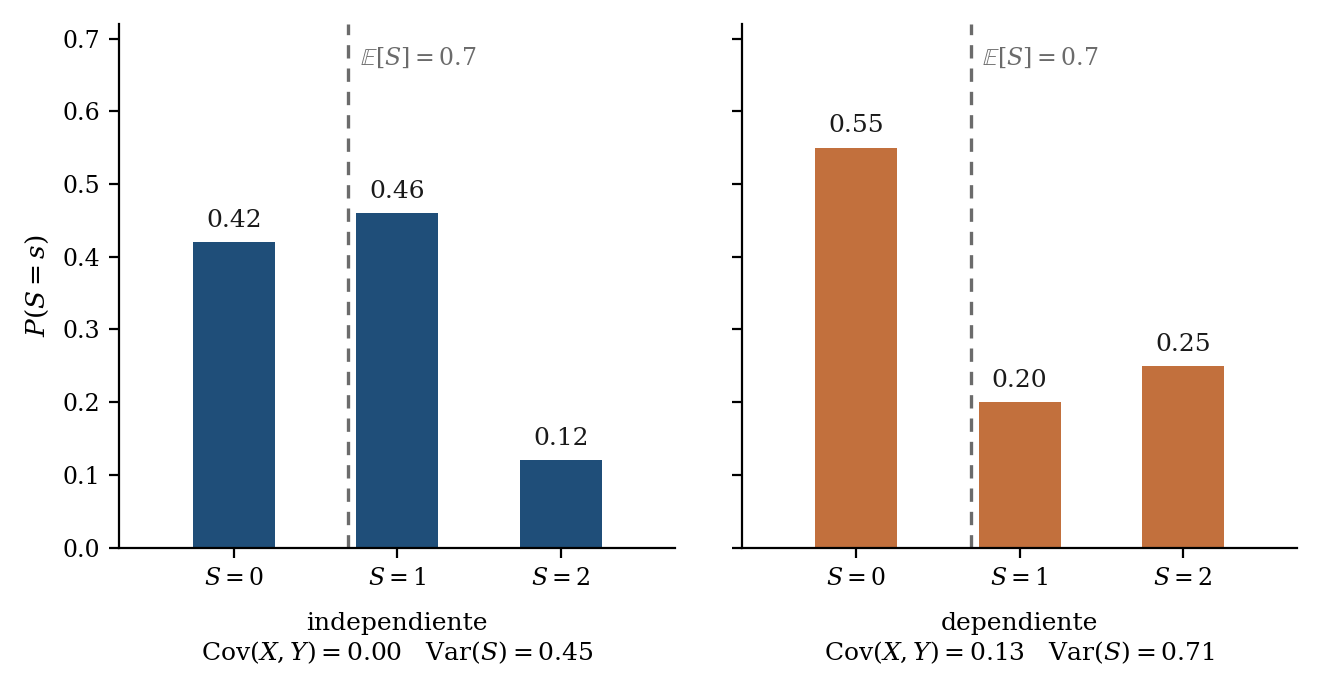
La media de es
en ambos modelos. Cambiar la dependencia no modificó la media del agregado, pero sí su variabilidad.
Este ejemplo resume una diferencia de fondo:
no necesita independencia, mientras la varianza de una suma sí depende de la estructura conjunta mediante las covarianzas.
83.15. Covarianza bajo cambios de escala
Si
entonces
Las constantes y desaparecen por centrado.
La covarianza tiene unidades
Por ello su magnitud depende de las unidades en que se midan ambas variables. Multiplicar por mil multiplica la covarianza por mil.
Esta dependencia de escala motiva una versión estandarizada.
83.16. Correlación
Cuando ambas varianzas son positivas, definimos la correlación de Pearson
Es adimensional y satisface
En el ejemplo binario dependiente,
La correlación elimina las unidades y normaliza la covarianza por las escalas marginales.
Su carácter lineal, en cambio, permanece. Una relación no lineal fuerte puede tener correlación cero.
83.17. Independencia implica covarianza cero
Si e son independientes y tienen momentos suficientes,
Por tanto,
Así,
La implicación inversa es falsa. Conviene mostrarlo con un ejemplo exacto.
83.18. Covarianza cero sin independencia
Sea
y definamos
La dependencia es determinista. Conocer determina exactamente .
Por simetría,
Además,
El producto es
Como es impar y la distribución es simétrica,
Por tanto,
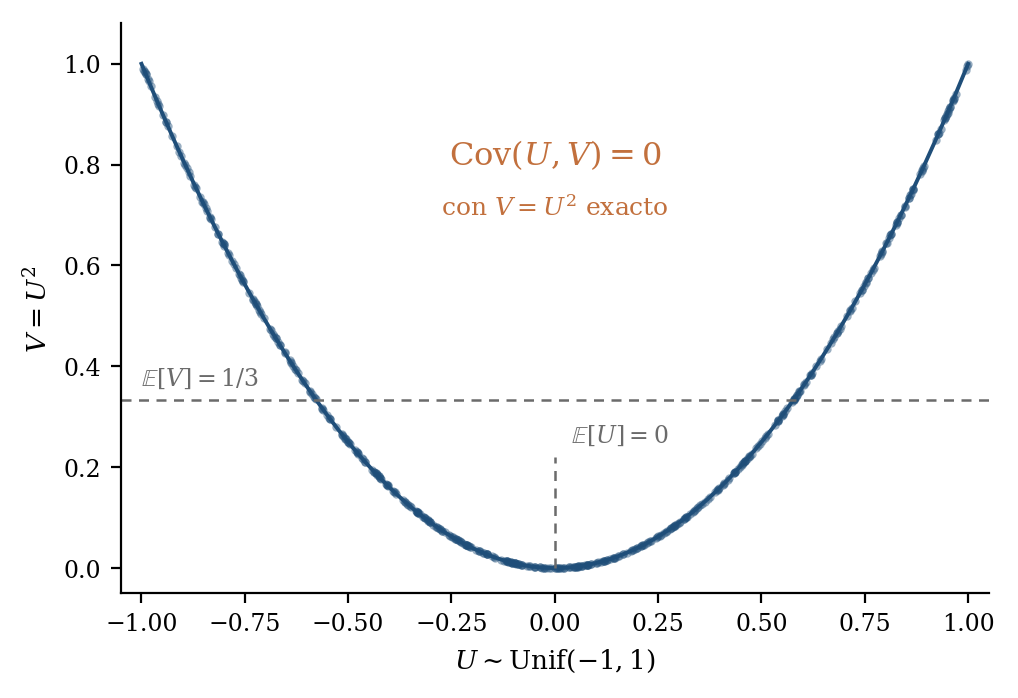
La nube sigue una parábola exacta, de modo que las dos variables están lejos de ser independientes.
La lección es que la covarianza responde a una pregunta específica sobre asociación lineal centrada.
83.19. Matriz de covarianza
Para un vector aleatorio
con media
la matriz de covarianza se define como
Sus elementos son
La diagonal contiene varianzas:
La matriz es simétrica porque
En dos dimensiones puede escribirse
83.20. Semidefinición positiva
La matriz de covarianza tiene una propiedad estructural que conviene establecer.
Para cualquier vector ,
Moviendo los escalares al interior,
El lado derecho es una varianza:
Por tanto, toda matriz de covarianza es semidefinida positiva.
Esto implica que sus valores propios son no negativos.
El paquete utiliza
y verifica numéricamente esta propiedad.
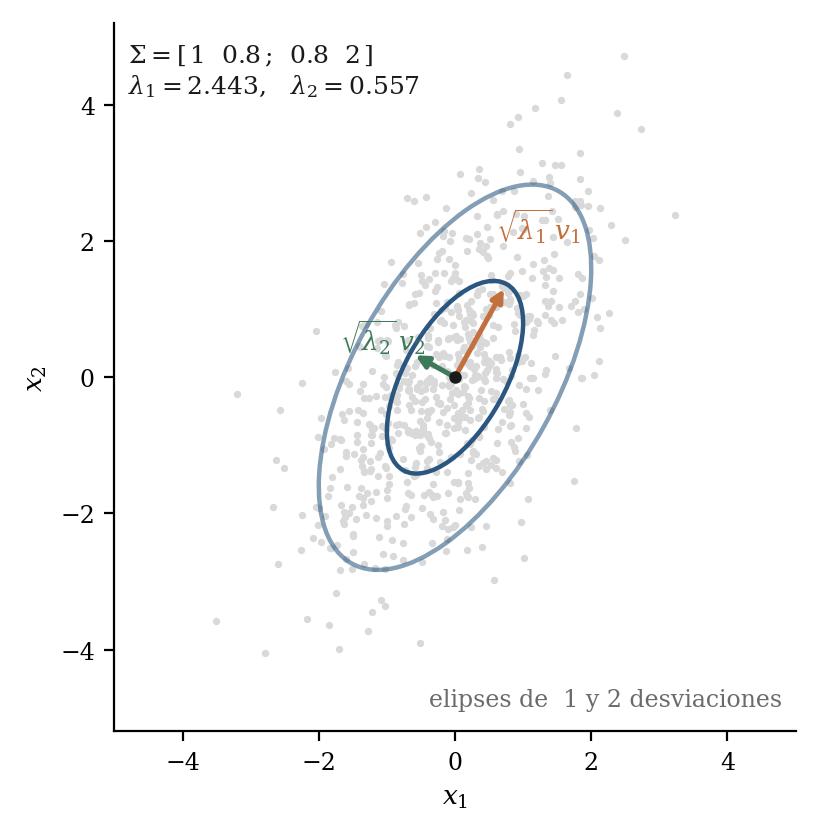
Los vectores propios marcan direcciones principales de variación lineal. Esta interpretación conectará más adelante con herramientas espectrales y reducción dimensional.
83.21. Matrices singulares y relaciones exactas
Una matriz de covarianza puede ser singular.
En el ejemplo binario dependiente definimos
Consideremos el vector
Sus tres componentes no son linealmente independientes porque exactamente.
Entonces existe un vector no nulo
tal que
para todas las realizaciones.
Por tanto,
y
La matriz tiene al menos un valor propio nulo.
El código reproduce esta singularidad con error numérico cercano a precisión de máquina.
83.22. Esperanza condicional
C82 introdujo distribuciones condicionales. Podemos aplicar ahora la esperanza dentro de ellas.
La esperanza condicional
es una variable aleatoria que depende de . Para cada valor de , resume la distribución de compatible con esa información.
En un caso discreto,
En el ejemplo binario dependiente de C82,
Como toma valores 0 y 1,
Si ,
por lo que
La esperanza condicional cambia con la información observada.
83.23. Ley de la esperanza total
Una propiedad central es
En el ejemplo,
Sustituyendo,
Entonces
Recuperamos la marginal de C81.
La ley de la esperanza total muestra que podemos calcular un promedio global promediando primero dentro de estratos o estados condicionales y después ponderando esos promedios por la distribución del condicionante.
83.24. Ley de la varianza total
Existe una descomposición análoga para la varianza:
El primer término mide la variabilidad promedio dentro de los niveles de . El segundo mide cuánto cambian las medias condicionales entre esos niveles.
Esta identidad importa en sistemas heterogéneos. Una varianza global grande puede provenir de dispersión interna en cada estado, de diferencias entre estados o de ambas.
La descomposición describe cómo se reparte la variabilidad respecto de la variable utilizada para condicionar, sin identificar por sí sola una causa.
En capítulos posteriores aparecerán modelos jerárquicos donde esta separación volverá a utilizarse.
83.25. La media y la varianza no determinan una distribución
Dos distribuciones pueden compartir
y
y diferir en casi todo lo demás.
Una distribución puede ser simétrica y unimodal, mientras otra es bimodal. Una tercera concentra casi toda la masa cerca de la media y reserva poca probabilidad para valores extremos. Las tres pueden ajustarse para tener la misma media y varianza.
Por ello, no es una codificación completa de una distribución.
En algunos modelos específicos, como una distribución normal, esos dos parámetros determinan toda la ley. Esa suficiencia pertenece a la familia elegida y no se extiende a media y varianza en general.
C84 estudiará las distribuciones discretas y continuas como supuestos de modelamiento, con las restricciones que cada elección impone.
83.26. Segundo momento finito y límites de la varianza
Para que la varianza sea finita necesitamos
Esto implica
pero no al revés en general.
La distribución de cola
utilizada antes ni siquiera tiene media finita. Su segundo momento parcial crece mucho más rápido:
Cuando ,
Por tanto no existe una varianza finita.
Un algoritmo puede calcular una varianza muestral para cualquier muestra finita, pero eso no implica que la distribución generadora tenga segundo momento finito. La estadística finita y la propiedad del modelo deben distinguirse.
83.27. Covarianza y causalidad
Una covarianza positiva no identifica el mecanismo que la produce.
Puede aparecer porque influye sobre , porque influye sobre , porque ambas variables responden a un tercer proceso o porque la selección de observaciones induce asociación.
C82 ya estableció la misma cautela para probabilidades condicionales. La covarianza no añade causalidad a esa relación.
Tampoco covarianza cero certifica ausencia de interacción. El ejemplo contiene una relación funcional exacta y covarianza nula.
La covarianza es un descriptor de segundo orden de la distribución conjunta.
83.28. Estandarización
Cuando
podemos definir
donde
Por linealidad,
Por la regla de escala de la varianza,
La estandarización elimina una localización y una escala específicas, sin igualar dos distribuciones que tenían formas diferentes.
Para la variable discreta inicial, con
el paquete transforma los tres valores y verifica exactamente media cero y varianza uno.
La operación es útil cuando queremos comparar variables expresadas en unidades diferentes. Sin embargo, una diferencia de una desviación estándar no tiene necesariamente el mismo significado sustantivo en dos sistemas distintos. La estandarización iguala los dos primeros momentos y deja intactas colas, asimetría y estructura multimodal.
83.29. La cota de Cauchy–Schwarz y por qué
La cota de la correlación no es una convención.
Definamos las variables centradas
La desigualdad de Cauchy–Schwarz para variables cuadrado-integrables establece
El lado izquierdo es
El derecho es
Por tanto,
Si ambas desviaciones estándar son positivas, dividimos por su producto:
La igualdad requiere, bajo las condiciones habituales, una relación lineal casi segura entre las variables centradas. Una dependencia no lineal perfecta como puede tener
El intervalo acota la asociación lineal normalizada, sin ordenar toda forma de dependencia desde «ninguna» hasta «máxima».
83.30. Varianza de una combinación lineal de muchas variables
Sea
con matriz de covarianza . Consideremos un agregado
Ya demostramos que
Expandiendo el producto matricial,
Esta fórmula muestra por qué la variabilidad de un sistema agregado no se obtiene sumando mecánicamente las variabilidades de sus componentes.
Los términos diagonales describen dispersión individual. Los términos cruzados describen coordinación entre fluctuaciones.
Si muchas covarianzas son positivas, las variaciones pueden reforzarse. Si varias son negativas, pueden compensarse.
En un sistema con cientos de componentes, ignorar la dependencia equivale a eliminar todos los términos fuera de la diagonal de . Esa simplificación puede ser apropiada como modelo de referencia, pero debe reconocerse como un supuesto.
83.31. Compensación exacta mediante covarianza negativa
La covarianza puede reducir la variabilidad de una suma.
Sea
y definamos
Entonces en todas las realizaciones.
Por tanto,
Como
la identidad general exige
Luego
Para ,
de modo que
Aquí la dependencia es perfectamente compensatoria. Cada aumento de viene acompañado por una disminución de .
Este ejemplo y el caso positivo de C81 muestran que la misma variabilidad marginal puede producir agregados mucho más variables, igual de variables o incluso completamente constantes, según la estructura conjunta.
83.32. Resolver la ley de la varianza total en el ejemplo binario
Volvamos al modelo dependiente con
Ya obtuvimos
Cuando ,
Como una Bernoulli con parámetro tiene varianza la varianza condicional para es
Para ,
Promediando dentro de los dos estratos,
Las medias condicionales son
y
Su varianza respecto de la media global es aproximadamente
Sumando,
El paquete verifica esta igualdad con precisión numérica.
La descomposición permite distinguir variación residual dentro de los estados de de variación atribuible a que las medias de esos estados son distintas.
83.33. Momentos de una distribución y estadísticas de una muestra
Hasta ahora
han sido propiedades de una distribución.
En datos finitos calculamos cantidades empíricas, por ejemplo
La media muestral es una variable aleatoria antes de observar la muestra. Después de observarla se convierte en un número.
No debemos escribir automáticamente
En una muestra finita normalmente difieren.
Lo mismo ocurre con la varianza. Podemos calcular
como segundo momento empírico centrado, o utilizar
cuando buscamos el estimador insesgado usual de una varianza poblacional bajo muestreo independiente con segundo momento finito.
El factor pertenece a un problema de estimación y deja intacta la definición matemática
C86 estudiará por qué ciertos promedios muestrales convergen a cantidades poblacionales. Por ahora basta mantener separados parámetro de distribución y estadístico observado.
83.34. Sensibilidad de la varianza a valores extremos
El cuadrado hace a la varianza muy sensible a observaciones alejadas de la media.
Si una desviación pasa de a su contribución cuadrática pasa de a
Esta propiedad es una consecuencia deliberada de medir dispersión mediante energía cuadrática.
Tiene ventajas claras. La expansión algebraica es simple, la varianza interactúa bien con productos internos y conduce a matrices semidefinidas positivas, mínimos cuadrados y geometría euclídea.
Sin embargo, en distribuciones de cola amplia puede hacer que la varianza sea muy grande o infinita. Una muestra pequeña puede entonces producir estimaciones muy inestables.
Existen otras medidas de dispersión, como desviación absoluta respecto de una localización o rangos basados en cuantiles. No son equivalentes a la varianza y responden de forma diferente a las colas.
El descriptor adecuado depende de qué propiedad del sistema queremos resumir. Esta elección debe declararse porque distintos descriptores pueden ordenar de manera diferente dos sistemas con colas o asimetrías distintas.
83.35. Qué información conservan los momentos de segundo orden
El conjunto
y
describe por completo la localización y la geometría lineal de segundo orden.
Eso puede ser suficiente para algunas preguntas. Por ejemplo, la varianza de cualquier combinación lineal
queda completamente determinada por .
En cambio, y no determinan probabilidades de eventos generales. Tampoco especifican colas, multimodalidad ni dependencias no lineales.
Dos vectores aleatorios pueden compartir la misma media y matriz de covarianza y presentar distribuciones conjuntas muy distintas.
Existe una excepción. Dentro de la familia normal multivariada, media y covarianza sí determinan toda la distribución. Esa suficiencia proviene del supuesto de normalidad más que de los primeros dos momentos en sí.
Esta es la transición conceptual hacia C84. Elegir una familia probabilística convierte ciertos resúmenes en parámetros suficientes para describir esa familia, pero también introduce compromisos sobre la forma de la distribución.
83.36. Dependencia de orden superior invisible para la covarianza por pares
El ejemplo XOR de C81 permite llevar la limitación un paso más lejos.
Sean y bits independientes y equiprobables, y
Cada variable tiene distribución Bernoulli con parámetro . Además, los tres pares
son independientes.
Por tanto,
La matriz de covarianza de es diagonal:
Si solo observáramos media y matriz de covarianza, el sistema sería indistinguible, en esos momentos de segundo orden, de tres bits mutuamente independientes. Las tres variables, sin embargo, distan de serlo.
Existe la restricción exacta
Conocer dos variables determina la tercera. Por ejemplo,
Además, el estado
tiene probabilidad cero, mientras que tres Bernoulli independientes asignarían
La dependencia vive en la distribución conjunta de tercer orden y no aparece en ninguna covarianza por pares.
Este ejemplo importa en ciencias de la complejidad. Un sistema puede carecer de asociaciones lineales bivariadas y, sin embargo, estar fuertemente organizado por restricciones colectivas.
Las matrices de covarianza siguen siendo objetos centrales cuando la pregunta depende de combinaciones lineales o de estructura de segundo orden. Lo que el ejemplo acota es su alcance, porque una matriz de covarianza no representa por completo la organización multivariada.
Este límite también afecta cualquier procedimiento que reconstruya un sistema utilizando únicamente correlaciones. Si dos conjuntos de datos tienen la misma matriz de covarianza, un método basado exclusivamente en esa matriz producirá la misma entrada matemática para ambos, aunque uno contenga una restricción XOR y el otro sea completamente independiente. La pérdida de información no aparece durante el cálculo; ocurrió antes, cuando resumimos la distribución conjunta mediante segundos momentos. Esta observación ayuda a separar dos preguntas distintas, la de si un método está correctamente implementado respecto de su entrada y la de si esa entrada conserva la estructura necesaria para la pregunta científica. Un cálculo impecable sobre una representación insuficiente puede ser incapaz de detectar el fenómeno relevante.
Más adelante, la teoría de la información permitirá describir dependencias que no se reducen a segundos momentos y distinguir redundancia de estructura que solo aparece al combinar varias variables.
83.37. Verificación computacional
El paquete reproducible ejecuta controles analíticos y numéricos.
Para la variable discreta
verifica
y
También comprueba
y
En el ejemplo binario calcula exactamente las dos covarianzas, las varianzas de , y . Confirma además que la fórmula con el término coincide con la varianza obtenida directamente desde la distribución de .
Para el contraejemplo
la integración numérica recupera
La covarianza teórica es cero, mientras la simulación conserva la relación determinista parabólica.
Finalmente, el código comprueba que las matrices de covarianza son simétricas y semidefinidas positivas. Para el vector , con , detecta un valor propio nulo compatible con dependencia lineal exacta.
La distribución pesada truncada se utiliza únicamente como aproximación numérica a las sumas parciales del ejemplo analítico de momento divergente.
Se ejecutaron 43 comprobaciones automáticas y las 43 resultaron satisfactorias.
83.38. Qué queda establecido
La esperanza es un operador lineal que resume una distribución mediante un promedio ponderado. Puede existir fuera del soporte y no se conserva a través de transformaciones no lineales.
La varianza mide dispersión cuadrática alrededor de la esperanza. Cambia con el cuadrado de la escala y exige un segundo momento finito.
La covarianza es el término que conecta las fluctuaciones de dos variables y determina cómo cambia la varianza de una suma. Su versión estandarizada, la correlación, elimina unidades pero no deja de describir asociación lineal.
La matriz de covarianza generaliza estas ideas a muchas variables y es necesariamente semidefinida positiva porque toda combinación lineal tiene varianza no negativa.
Ninguno de estos resúmenes reemplaza a la distribución completa. Covarianza cero no implica independencia. Media más varianza no determinan una ley salvo en familias particulares.
El próximo capítulo, C84, estudiará las distribuciones discretas y continuas como supuestos de modelamiento. Allí la pregunta cambiará de «qué momentos tiene una distribución» a «qué familia probabilística estamos suponiendo y qué compromisos introduce esa elección».
Referencias
- Grimmett, G. R., & Stirzaker, D. R. (2001). Probability and Random Processes (3rd ed.). Oxford University Press. https://doi.org/10.1093/oso/9780198572237.001.0001
- Gut, A. (2013). Probability: A Graduate Course (2nd ed.). Springer. https://doi.org/10.1007/978-1-4614-4708-5
- Kallenberg, O. (2021). Foundations of Modern Probability (3rd ed.). Springer. https://doi.org/10.1007/978-3-030-61871-1
- Pitman, J. (1993). Probability. Springer. https://doi.org/10.1007/978-1-4612-4374-8
Recursos reproducibles
Descargar recursos del capítulo (ZIP, 1,6 MB).
7 archivos CSV · 4 figuras · 1 programa Python.
El programa se ha ejecutado en una carpeta vacía y genera los archivos de datos y figuras incluidos en el paquete.