84.1. Elegir una distribución es elegir restricciones
C81 introdujo distribuciones como medidas de probabilidad. C82 mostró cómo condicionarlas y actualizarlas. C83 estudió esperanza, varianza y covarianza como resúmenes de primer y segundo orden. Ahora aparece una decisión que en aplicaciones suele tomarse demasiado rápido, la de qué familia de distribuciones utilizar.
Escribir
o
va más allá de escoger una fórmula conveniente. Cada expresión fija un soporte, relaciones entre momentos, forma de las colas y, en ciertos casos, propiedades más exigentes sobre el mecanismo que podría generar los datos.
Una distribución es por ello un supuesto de modelamiento.
Dos familias pueden tener la misma media y varianza y, aun así, asignar probabilidades muy distintas a eventos relevantes. Una distribución puede ajustarse visualmente al centro de los datos y ser incompatible con valores imposibles por razones físicas. Otra puede tener el soporte correcto, pero imponer una estructura temporal ajena al proceso.
El objetivo de C84 no será memorizar un catálogo. Compararemos unas pocas distribuciones canónicas y preguntaremos en cada caso:
- ¿qué valores permite?;
- ¿qué mecanismo representa de manera natural?;
- ¿qué propiedades adicionales impone?;
- ¿qué observaciones podrían contradecirla?
84.2. Lo primero es el soporte
Antes de mirar la forma de una curva conviene preguntar dónde puede vivir la variable.
Una variable de Bernoulli tiene soporte
Una binomial con ensayos tiene soporte
Una Poisson tiene soporte
Una exponencial tiene soporte
Una normal tiene soporte
Una uniforme en tiene soporte acotado.
Estas diferencias tienen consecuencias. Si una magnitud es físicamente no negativa, una normal asignará alguna probabilidad a valores negativos, salvo casos degenerados o cuando esa masa sea numéricamente despreciable para la pregunta planteada. La aceptabilidad de esa aproximación depende del caso.
El soporte debería examinarse antes del ajuste fino de parámetros.
84.3. Discreto y continuo no significa pequeño y grande
Una variable es discreta cuando su soporte es finito o numerable. Es continua, en el sentido habitual de este capítulo, cuando se modela mediante una densidad respecto de la longitud de Lebesgue.
La distinción no depende de cuán pequeña sea la unidad de medida.
El número de eventos en una hora puede ser discreto aunque alcance millones. Una longitud registrada con tres decimales puede almacenarse como un número de un conjunto finito de valores, aunque el modelo físico subyacente se trate como continuo.
El modelo debe distinguir entre la resolución de registro y el tipo de variable idealizada.
Una densidad continua tampoco asigna probabilidad a un valor exacto:
La probabilidad vive en intervalos. En cambio, una masa discreta puede satisfacer
Esta diferencia reaparece en la verosimilitud, el muestreo y los algoritmos de simulación.
84.4. La Bernoulli como modelo binario elemental
Sea
Decimos que
si
Su función de masa puede escribirse como
La esperanza es
porque
Como ,
Por tanto,
Bernoulli es natural cuando una realización se resume legítimamente mediante dos estados, sin que el fenómeno subyacente tenga que ser ontológicamente binario. Puede recoger una decisión de codificación, como detectado frente a no detectado o activado frente a no activado. Esa reducción debe ser defendible para la pregunta.
84.5. La binomial cuenta éxitos bajo una estructura específica
Supongamos
variables Bernoulli independientes con el mismo parámetro .
Definimos
Entonces
La probabilidad de observar exactamente éxitos es
La fórmula contiene tres piezas.
El factor
es la probabilidad de una secuencia concreta con éxitos y fracasos. El coeficiente
cuenta cuántas secuencias distintas contienen exactamente éxitos.
La independencia permite multiplicar probabilidades de los ensayos. La igualdad del parámetro hace intercambiables sus posiciones.
84.6. La binomial contiene más supuestos que «datos de conteo»
Para utilizar una binomial no basta con que la variable sea un número entero.
El modelo estándar supone:
- un número fijo de ensayos;
- dos resultados por ensayo bajo la codificación elegida;
- la misma probabilidad ;
- independencia entre ensayos, condicional a los parámetros del modelo.
Si los ensayos tienen probabilidades diferentes,
la suma ya no tiene en general una distribución binomial, sino una Poisson-binomial.
Si existe dependencia entre resultados, la fórmula
tampoco se obtiene.
Por eso «ajustar una binomial» significa asumir una arquitectura generativa concreta, algo más exigente que elegir una curva discreta de aspecto razonable.
84.7. Media y varianza binomiales
Por linealidad de la esperanza,
Como los son independientes,
para . Entonces
Con
obtenemos
El paquete reproducible simula realizaciones y recupera ambos valores dentro de tolerancia numérica.
84.8. La Poisson y los conteos sin máximo fijo
Una variable Poisson con parámetro
tiene función de masa
Su soporte carece de máximo finito.
La media y la varianza son
Esta igualdad es una propiedad rígida de la familia.
Un conteo con varianza empírica mucho mayor que su media no queda automáticamente invalidado como Poisson, porque la muestra introduce variabilidad. Sin embargo, una discrepancia sistemática y reproducible entre media y varianza es una señal de que el modelo puede omitir estructura.
C85 estudiará cómo heterogeneidad y mezclas pueden modificar distribuciones. Aquí basta reconocer que la relación es una predicción del modelo Poisson antes que una propiedad general de los conteos.
84.9. La aproximación de Poisson a una binomial rara
La distribución de Poisson puede aparecer como límite de una binomial.
Tomemos
Entonces
para todo .
Para un fijo,
Reordenamos:
Cuando
para fijo,
y
Por tanto,
Recuperamos la masa Poisson.
84.10. Una aproximación no vuelve idénticos los modelos
La convergencia anterior tiene hipótesis.
Para cualquier finito, una binomial satisface
Una Poisson asigna probabilidad positiva, aunque quizá minúscula, a
Además, en la binomial el número de oportunidades está explícitamente fijado. En un modelo Poisson de conteo, esa estructura no aparece de la misma forma.
El paquete mantiene
y compara
La distancia de variación total entre ambas distribuciones cae aproximadamente de a
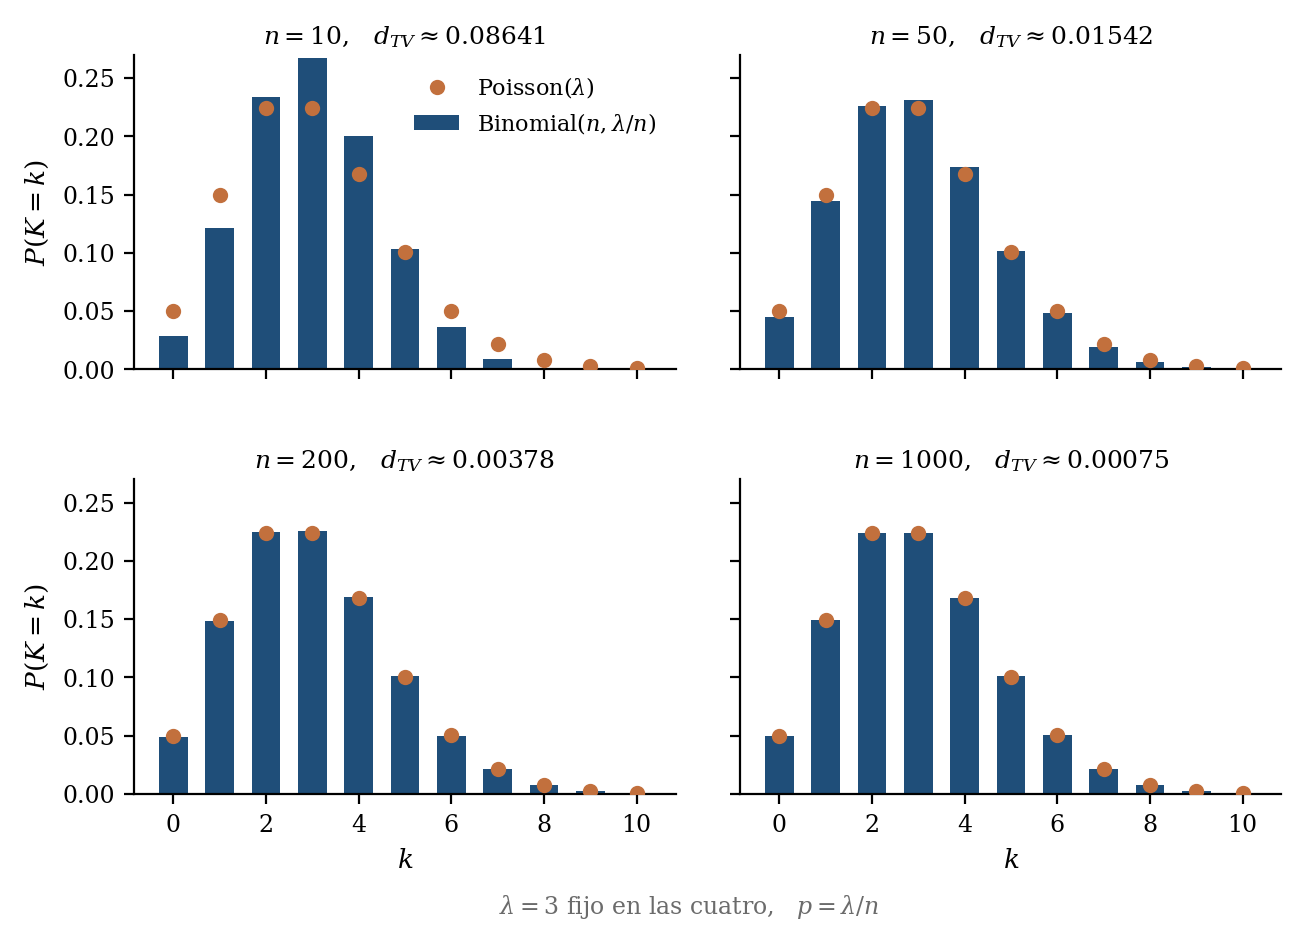
La aproximación mejora, pero el mecanismo conceptual de cada modelo sigue siendo distinto.
84.11. La uniforme y la igualdad de densidad dentro de límites
Una distribución uniforme continua en tiene densidad
y cero fuera del intervalo.
Su media es
y su varianza
La uniformidad es apropiada cuando el modelo declara que, dentro de ciertos límites, intervalos de igual longitud deben recibir igual probabilidad.
Interpretarla automáticamente como «no sabemos nada» es un error. Elegir una uniforme implica conocer o fijar límites y , asignar probabilidad exactamente cero fuera de ellos y tratar todas las posiciones interiores con la misma densidad. El supuesto es muy concreto.
84.12. La exponencial y los tiempos de espera con tasa constante
Sea
Su densidad es
Su función de supervivencia es
La media es
y la varianza
Para
obtenemos
Estos valores describen la familia, pero la propiedad más característica de la exponencial es otra.
84.13. Propiedad sin memoria
Para ,
Usando la supervivencia exponencial,
Además,
Por tanto,
La distribución no «recuerda» cuánto tiempo ya ha transcurrido.
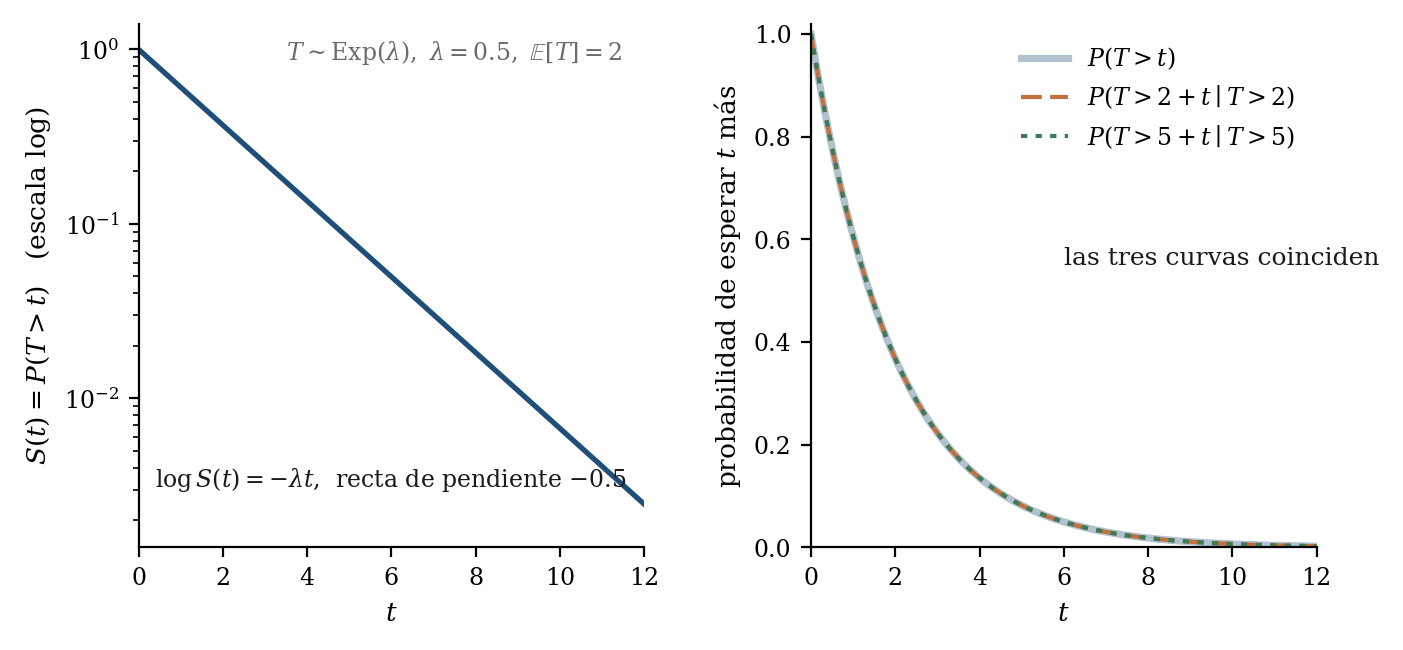
Esta propiedad es una restricción fuerte. Si la probabilidad de que ocurra un evento durante el próximo intervalo depende sistemáticamente de la edad actual del proceso, una exponencial de tasa constante puede ser una representación inadecuada.
84.14. Tasa constante no significa trayectoria constante
La exponencial no afirma que todos los tiempos de espera sean parecidos.
De hecho, tiene una cola que permite tiempos arbitrariamente grandes:
para todo .
La tasa constante se refiere a la estructura de riesgo instantáneo condicionada a supervivencia, sin implicar que los intervalos observados tengan duración fija.
Una secuencia de esperas exponenciales puede mostrar variabilidad considerable.
El lenguaje de tasas y procesos de Poisson se desarrollará con mayor profundidad en C125. Aquí interesa únicamente la conexión entre forma de distribución y supuesto de memoria.
84.15. La normal como familia sobre toda la recta real
La distribución normal con media y varianza tiene densidad
Es simétrica respecto de .
Su soporte es
La familia queda completamente determinada por y
Esto contrasta con la afirmación general de C83, según la cual media y varianza no determinan una distribución arbitraria. Dentro de la familia normal sí la determinan, porque la forma funcional ya fue fijada.
La normal es central en probabilidad y estadística, pero no es una distribución universal por defecto.
84.16. El soporte normal puede ser físicamente incorrecto
Supongamos una variable necesariamente positiva con
Si elegimos
el modelo asigna
La probabilidad es pequeña, pero no cero.
Si la variable representa una cantidad para la cual valores negativos son literalmente imposibles, debemos decidir si esa masa es tolerable como aproximación o si necesitamos otra familia.
No existe una regla universal. Si la inferencia depende precisamente de eventos extremos o cercanos al límite físico, una masa aparentemente pequeña puede importar.
84.17. Misma media y varianza, distribuciones diferentes
Construyamos una uniforme con la misma media y varianza que
Para
queremos
y
Entonces
La semiamplitud es
Por tanto,
Ambas distribuciones tienen exactamente
Sin embargo, la uniforme asigna probabilidad cero fuera de . La normal asigna aproximadamente un de masa fuera de ese mismo intervalo.
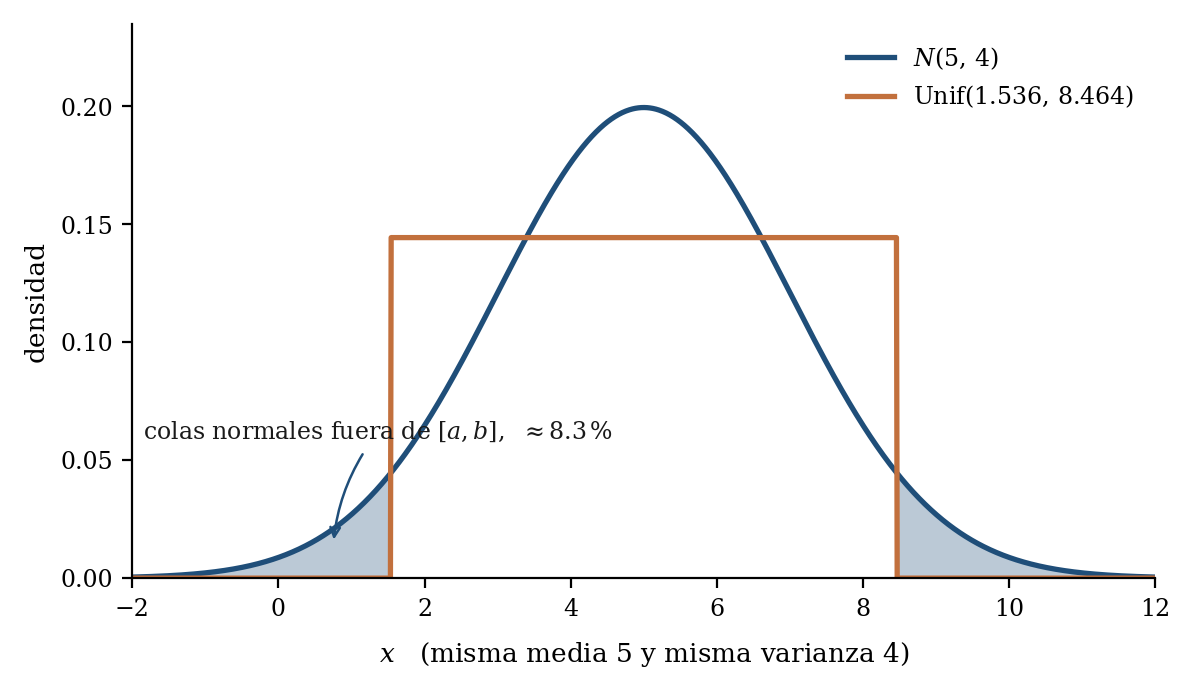
Los primeros dos momentos, por tanto, no eligen la distribución.
84.18. Una familia probabilística produce predicciones comprobables
Una elección de distribución debería traducirse en consecuencias observables.
La binomial predice soporte máximo , media y varianza .
La Poisson predice soporte entero no negativo y
La uniforme predice límites abruptos y densidad constante en el interior. La exponencial predice la propiedad sin memoria. La normal predice simetría, soporte no acotado y una forma específica de colas.
Estas propiedades pueden contrastarse con datos o con conocimiento mecanístico independiente.
Modelar exige preguntar tanto «¿qué distribución parece ajustarse?» como «¿qué afirmaciones adicionales estoy aceptando al usarla?».
84.19. Ajuste visual no identifica una distribución
En muestras pequeñas, distintas distribuciones pueden producir histogramas parecidos.
Un histograma depende del tamaño muestral, del ancho de los intervalos y de la aleatoriedad de la muestra. La ausencia de una discrepancia visual evidente no prueba que la familia sea correcta.
Por ejemplo, una uniforme suavizada por ruido de medición puede parecer aproximadamente acampanada. Una normal observada dentro de una ventana estrecha puede parecer casi plana. Una binomial con grande puede parecer continua a la resolución de una figura.
La visualización es útil para detectar incompatibilidades gruesas, sin reemplazar el examen de las consecuencias matemáticas del modelo.
84.20. No inferir mecanismo únicamente desde una distribución
Incluso si una familia describe bien la distribución observada, el mecanismo que la produjo puede no ser único.
Una distribución normal puede emerger de mecanismos diferentes. Un conteo aproximadamente Poisson puede aparecer como límite de muchos ensayos raros, como mostró la derivación anterior, pero una coincidencia con la masa Poisson no demuestra que ese sea el mecanismo real.
La dirección lógica debe preservarse:
no implica automáticamente
La distribución restringe las explicaciones candidatas y rara vez las identifica por sí sola.
84.21. Simulación como consecuencia del supuesto
Una vez especificada una distribución, podemos generar realizaciones.
Si
podemos simular valores enteros entre 0 y 10.
Si
obtenemos esperas positivas con media dos.
La simulación muestra las consecuencias del modelo y permite verificar que el algoritmo reproduce la distribución especificada, sin validar la elección misma.
El paquete genera realizaciones binomiales y exponenciales. Las medias y varianzas empíricas se aproximan a los valores analíticos. El control alcanza a la implementación y deja fuera la adecuación al mundo.
84.22. Aproximaciones y dominio de validez
Una distribución puede utilizarse como aproximación aunque sus supuestos exactos no se cumplan literalmente.
La aproximación binomial-Poisson es un ejemplo. Cuando aumenta y
disminuye, la distribución binomial converge hacia Poisson para fijo.
El paquete cuantifica esta aproximación mediante distancia de variación total.
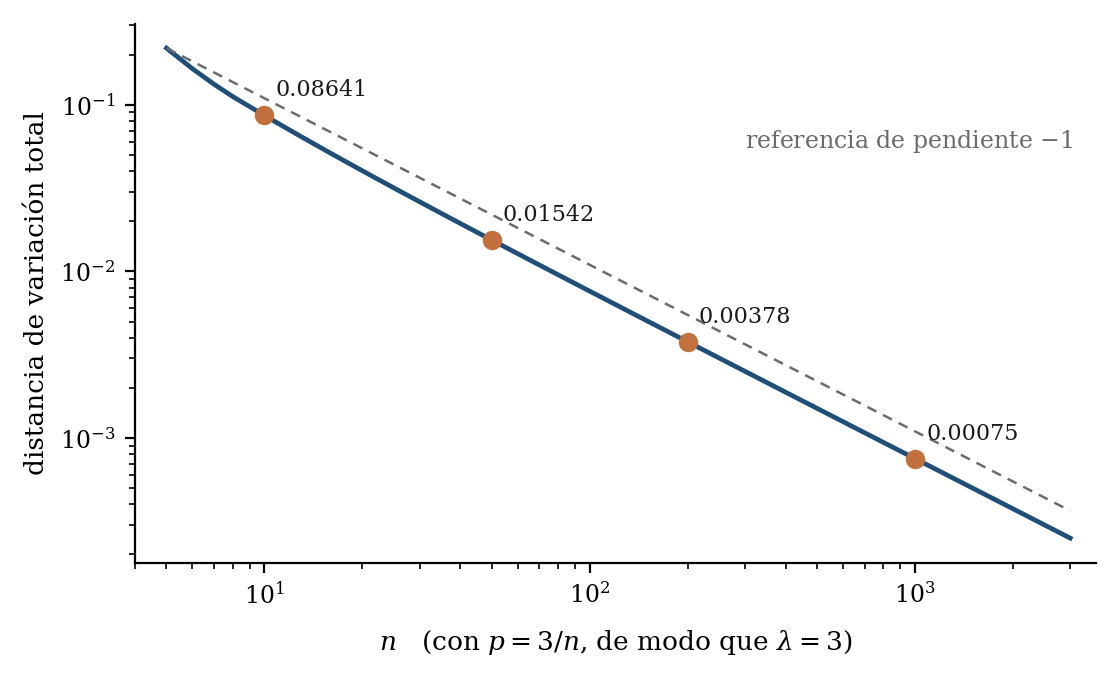
Con la distancia cae al aumentar .
La pregunta práctica es si la discrepancia restante afecta aquello para lo cual usamos la aproximación, más que si los dos modelos son matemáticamente idénticos.
Una buena aproximación depende del observable y de la precisión necesaria.
84.23. Cuando el soporte domina la decisión
Supongamos que queremos estimar la probabilidad de que una variable con media cinco y varianza cuatro supere diez.
Bajo la uniforme construida antes, porque
Bajo la normal,
Para predecir valores centrales, ambas distribuciones pueden producir resúmenes parecidos. Para un evento de cola, la elección cambia de cero a una probabilidad positiva.
El ejemplo muestra por qué una distribución debe evaluarse respecto de la pregunta final. Dos modelos con iguales primeros momentos pueden ser casi intercambiables para una tarea y completamente distintos para otra.
84.24. Discretización de una variable continua
Un instrumento puede redondear una magnitud continua.
Supongamos una variable física continua, pero el dispositivo registra
Entonces es discreta.
La distribución de se obtiene integrando la densidad de sobre intervalos:
El hecho de que la base de datos contenga enteros no demuestra que el mecanismo subyacente sea discreto.
De forma inversa, un conteo discreto grande puede representarse gráficamente mediante una curva suave para conveniencia, pero eso no vuelve continua su ley.
El nivel de medición y el nivel del modelo deben distinguirse.
84.25. Dimensiones físicas y parámetros
Los parámetros de una distribución pueden tener unidades.
Si se mide en segundos y
entonces tiene unidades
Su media tiene unidades de segundos.
En una normal, tiene las mismas unidades que , mientras tiene unidades cuadradas.
Un parámetro de Poisson , cuando representa el número esperado de eventos dentro de un intervalo ya fijado, es adimensional como conteo esperado. Si se habla de una tasa por unidad de tiempo, la tasa sí tiene unidades inversas de tiempo.
Controlar unidades ayuda a evitar parámetros interpretados fuera del contexto que los define.
84.26. Un protocolo mínimo para elegir una familia
Una elección de distribución puede organizarse en una secuencia simple.
Primero se define la variable y su soporte físico o lógico.
Después se pregunta qué proceso de generación sugiere la estructura del modelo, sea ensayos binarios, conteos, esperas, cantidades acotadas o desviaciones aproximadamente simétricas alrededor de una localización.
Luego se identifican las propiedades adicionales de la familia, entre ellas relaciones entre momentos, memoria, límites, simetría y comportamiento de colas.
Solo entonces se estiman parámetros y se compara el modelo con observaciones.
Finalmente se examinan las consecuencias que importan para la pregunta científica. Un modelo puede describir bien la zona central y fallar en los extremos que determinan una decisión. La familiaridad del nombre no es un criterio de elección.
84.27. Qué no cubre todavía este capítulo
Los sistemas reales pueden presentar heterogeneidad que una sola familia simple no representa.
Una población puede contener subgrupos. Un parámetro puede variar entre realizaciones. Una distribución observada puede resultar de combinar mecanismos diferentes.
No desarrollaremos esas posibilidades aquí porque son el foco de C85, sobre transformaciones, mezclas y heterogeneidad.
Tampoco estudiaremos todavía por qué sumas o promedios de muchas variables pueden aproximarse a ciertas formas universales. Eso corresponde a C86, sobre leyes de grandes números y teorema central del límite.
C84 se limita a la pregunta previa de qué significa asumir una familia distributiva concreta.
84.28. Probabilidad cero como afirmación estructural
El soporte de una distribución contiene afirmaciones más fuertes que una media o una varianza.
Si
entonces
El modelo afirma que esos valores están excluidos, algo más fuerte que declararlos raros.
Lo mismo ocurre con una binomial:
Una Poisson, en cambio, asigna probabilidad positiva a todo entero no negativo. La masa puede ser extremadamente pequeña, pero nunca desaparece para un valor finito.
Esta diferencia importa cuando el modelo se utiliza fuera de la región central. Un valor observado fuera del soporte contradice la distribución tal como fue especificada y no se reduce a una observación de cola, salvo que exista error de medición o que la variable observada no corresponda exactamente a la variable modelada.
En la práctica, un soporte incorrecto puede pasar inadvertido cuando todos los datos de entrenamiento quedan lejos de sus fronteras. El problema aparece al extrapolar, simular escenarios extremos o calcular probabilidades de violaciones de restricciones.
Por ello conviene preguntar explícitamente:
La respuesta puede ser científicamente más importante que la forma exacta de la densidad cerca de su máximo.
84.29. La tasa de riesgo hace visible el supuesto exponencial
La propiedad sin memoria puede expresarse mediante la tasa de riesgo o hazard.
Para una variable continua no negativa con densidad y supervivencia
definimos
cuando .
Para una exponencial, y
Entonces
La tasa instantánea condicionada a que el evento aún no haya ocurrido es constante.
Comparemos esto con una espera uniforme
Para ,
y
Por tanto,
El riesgo aumenta a medida que nos acercamos al límite . Ambas distribuciones pueden modelar tiempos positivos, pero hacen afirmaciones dinámicas diferentes sobre el efecto del tiempo ya transcurrido.
Este ejemplo muestra por qué clasificar una variable simplemente como «tiempo continuo» no determina una familia adecuada.
84.30. La escala de la pregunta determina qué diferencias importan
Dos modelos pueden ser distinguibles matemáticamente y prácticamente equivalentes para una pregunta concreta.
La binomial y su aproximación Poisson nunca son exactamente iguales para finito. Sin embargo, con
el paquete obtiene una distancia de variación total cercana a
Si el objetivo es calcular probabilidades en la región central con precisión porcentual, esa discrepancia puede ser irrelevante. Si el objetivo depende de un evento imposible para la binomial pero permitido por la Poisson, el soporte vuelve a importar.
De manera análoga, una normal puede ser una aproximación útil para una magnitud positiva cuando
y la masa negativa es despreciable para la tarea. No por ello la variable se vuelve realmente normal ni desaparece la frontera física.
Un modelo debe juzgarse respecto de la resolución y del observable relevantes.
La exigencia correcta consiste en preguntar si las simplificaciones alteran las conclusiones que queremos extraer. Usar siempre la distribución exacta resulta imposible, porque muchos mecanismos reales solo admiten aproximaciones. Usar la más simple sin evaluar consecuencias tampoco sirve.
84.31. Un modelo distributivo debe poder fallar
Una familia es científicamente informativa cuando impone restricciones que los datos podrían contradecir.
Si una Poisson permitiera cualquier relación entre media y varianza, perdería parte de su contenido. Una exponencial que admitiera cualquier dependencia con la edad del proceso dejaría de describir una tasa constante. Una uniforme sin límites ni densidad constante conservaría poco más que el nombre.
Los supuestos útiles generan riesgo de error.
Esto permite distinguir modelamiento de descripción puramente flexible. Una familia sencilla comprime muchos resultados posibles en pocos parámetros y, a cambio, excluye otras formas de comportamiento.
La exclusión es lo que vuelve comprobable al modelo, de modo que evitarla por principio sería contraproducente.
La disciplina consiste en no ocultar qué se excluyó. Cuando una predicción importante depende de una propiedad rígida, como soporte acotado o memoria nula, esa propiedad debería aparecer explícitamente en la justificación del modelo.
En este sentido, elegir una distribución es similar a elegir una ecuación dinámica. Ambas decisiones convierten conocimiento y simplificaciones en restricciones matemáticas. La calidad del modelo depende de que esas restricciones sean suficientemente fieles para la pregunta y suficientemente explícitas para poder ser examinadas.
Un último cuidado es separar la estandarización de la normalidad. C83 mostró que cualquier variable con media finita y varianza positiva puede transformarse mediante
para obtener media cero y varianza uno. Esa operación no convierte su distribución en
Una uniforme estandarizada sigue siendo uniforme, una variable bimodal conserva dos modos y una distribución asimétrica continúa siendo asimétrica. El símbolo se utiliza a menudo para valores estandarizados y puede inducir la impresión errónea de que toda puntuación estandarizada debe interpretarse con la tabla normal. Para calcular probabilidades normales necesitamos además el supuesto de normalidad o una aproximación justificada por otro resultado. La media y la desviación estándar fijan localización y escala, mientras la forma completa de la ley queda sin determinar. Esta separación será importante cuando C86 introduzca el teorema central del límite, que explica normalidad aproximada en contextos específicos y bajo hipótesis concretas, no como consecuencia automática de estandarizar datos.
84.32. Verificación computacional
El paquete reproducible ejecuta controles analíticos y numéricos sobre los ejemplos centrales.
Para
verifica que la masa total sea uno y que
Las simulaciones recuperan ambos valores dentro de tolerancias prefijadas.
Para la aproximación Poisson mantiene
y calcula la distancia de variación total entre
y
La distancia decrece de aproximadamente para a para . También se comprueba convergencia puntual de las masas para .
Para
verifica
y la identidad sin memoria
La simulación reproduce esa igualdad dentro del error finito esperado.
Finalmente construye una normal y una uniforme con
Confirma que ambas comparten esos momentos, mientras la normal asigna probabilidad positiva a valores negativos y a valores mayores que diez. La uniforme asigna probabilidad cero a ambos eventos.
Se ejecutaron 37 comprobaciones automáticas y las 37 resultaron satisfactorias.
84.33. Qué queda establecido
Una familia probabilística determina qué resultados son posibles y cómo se reparte la probabilidad entre ellos, muy lejos de ser una decoración añadida después de calcular media y varianza.
Bernoulli describe una realización binaria. La binomial cuenta éxitos bajo número fijo de ensayos, probabilidad común e independencia. Poisson modela conteos sin máximo fijo y contiene la restricción media-varianza característica. La exponencial representa esperas positivas con propiedad sin memoria. La uniforme impone límites duros y densidad constante. La normal impone simetría, soporte sobre toda la recta y una forma específica determinada por media y varianza.
El mismo par puede corresponder a distribuciones con predicciones incompatibles sobre colas y soporte.
Por eso la elección debe justificarse mediante la variable, el mecanismo plausible y las consecuencias relevantes para la pregunta.
El capítulo siguiente, C85, estudiará las transformaciones, las mezclas y la heterogeneidad. Allí veremos qué ocurre cuando una distribución simple es transformada o cuando las realizaciones no comparten una única estructura homogénea.
Referencias
- Feller, W. (1968). An Introduction to Probability Theory and Its Applications, Volume I (3rd ed.). Wiley.
- Grimmett, G. R., & Stirzaker, D. R. (2001). Probability and Random Processes (3rd ed.). Oxford University Press. https://doi.org/10.1093/oso/9780198572237.001.0001
- Kallenberg, O. (2021). Foundations of Modern Probability (3rd ed.). Springer. https://doi.org/10.1007/978-3-030-61871-1
- Pitman, J. (1993). Probability. Springer. https://doi.org/10.1007/978-1-4612-4374-8
Recursos reproducibles
Descargar recursos del capítulo (ZIP, 345 kB).
4 archivos CSV · 4 figuras · 1 programa Python.
El programa se ha ejecutado en una carpeta vacía y genera los archivos de datos y figuras incluidos en el paquete.