86.1. Dos resultados distintos sobre promedios
Los capítulos anteriores introdujeron distribuciones, condicionamiento, momentos, familias probabilísticas y heterogeneidad. Ahora aparece una pregunta inevitable. Si repetimos un experimento o acumulamos muchas realizaciones, ¿qué ocurre con los promedios?
Dos resultados dominan esta parte de la teoría:
y
Se parecen porque ambos estudian sumas o medias, aunque responden a preguntas diferentes.
Una ley de grandes números explica por qué
se aproxima a una cantidad estable, habitualmente
El teorema central del límite estudia la forma de las fluctuaciones restantes alrededor de esa media cuando las reescalamos apropiadamente:
La primera pregunta es de convergencia hacia una constante. La segunda es de distribución asintótica de los errores.
Confundirlas conduce a dos errores frecuentes, el de creer que la ley de grandes números implica normalidad y el de creer que el teorema central del límite es lo que hace converger la media.
86.2. El promedio muestral es una variable aleatoria
Sean
variables aleatorias.
Antes de observarlas,
también es una variable aleatoria.
Si las son idénticamente distribuidas con media
entonces, por linealidad,
Esta igualdad no requiere independencia. El supuesto aparece cuando queremos controlar la variabilidad de la media.
Si además
y las variables son independientes,
Por tanto,
El promedio conserva la media y reduce su dispersión.
86.3. Una primera ley débil mediante Chebyshev
La desigualdad de Chebyshev establece que, para una variable con varianza finita,
Apliquémosla a
Bajo variables independientes e idénticamente distribuidas con media y varianza finita ,
Para cualquier
el lado derecho tiende a cero cuando
Entonces
Esta es una forma de la ley débil de los grandes números.
La notación
significa convergencia en probabilidad.
86.4. Qué significa convergencia en probabilidad
Decir
significa que, para todo
En el caso del promedio,
No significa que exista un finito después del cual toda media sea exactamente .
Tampoco significa que una secuencia concreta de medias deba acercarse monótonamente. Puede oscilar, alejarse temporalmente y volver a aproximarse.
La afirmación es probabilística. Para grande, la masa de la distribución de se concentra en cualquier vecindad fija de .
86.5. Bernoulli como ejemplo exacto
Tomemos
independientes.
Entonces
La media
es la proporción de éxitos en ensayos.
Su varianza es
Con
Chebyshev produce
Para , esta cota supera uno y solo resulta útil después de truncarla en uno. Para valores mayores disminuye como .
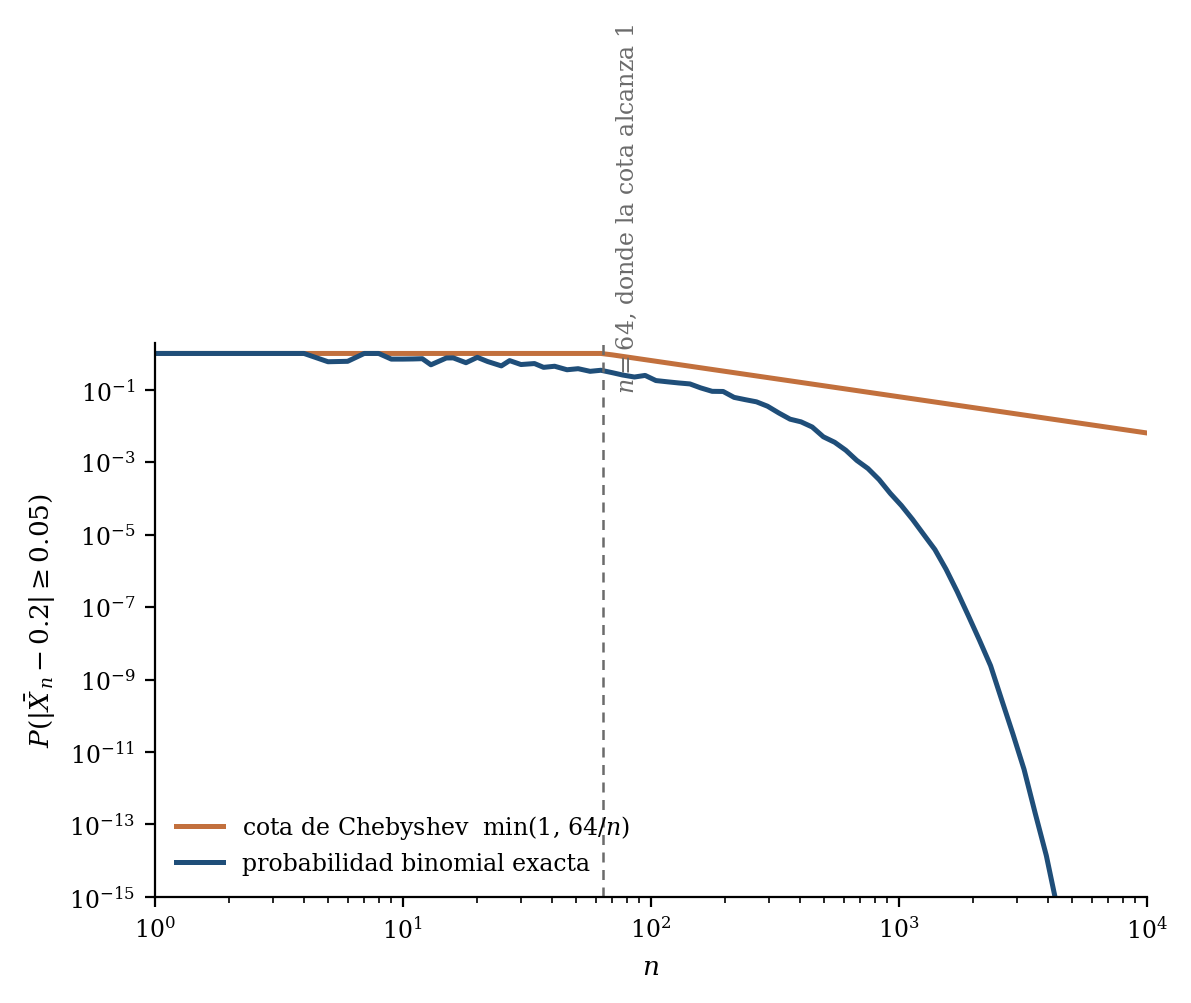
La probabilidad exacta binomial cae mucho más rápido que la cota. Chebyshev es una desigualdad general y no busca ajustarse a este caso particular.
86.6. Una sola trayectoria también puede estabilizarse
El paquete reproduce cuatro secuencias Bernoulli de longitud 5000 y calcula
a lo largo de cada trayectoria.
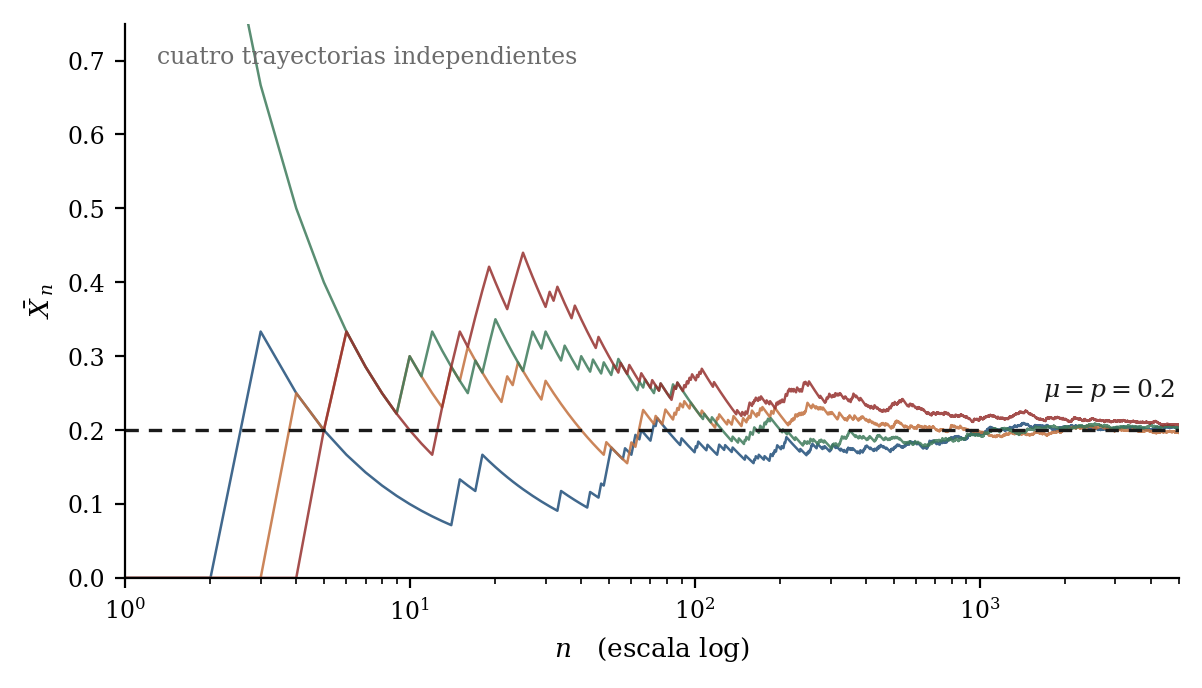
Al principio, cada nueva observación puede modificar mucho el promedio. Cuando crece, su peso individual es
La figura ilustra estabilización alrededor de , pero una figura no demuestra el teorema.
También conviene notar que la media acumulada no se vuelve inmóvil. Continúa fluctuando a escalas cada vez menores.
86.7. Ley fuerte de los grandes números
Existe una noción de convergencia más fuerte.
Decimos
si
La abreviatura a.s. significa almost surely, es decir, casi seguramente.
Para variables independientes e idénticamente distribuidas con
la ley fuerte establece
donde
La hipótesis de varianza finita utilizada en la demostración elemental con Chebyshev no es necesaria para esta versión i.i.d. de la ley fuerte. La integrabilidad de basta.
86.8. Convergencia casi segura frente a convergencia en probabilidad
La convergencia casi segura es más fuerte:
La implicación inversa no vale en general. La diferencia puede entenderse preguntando qué conjunto de realizaciones consideramos.
La convergencia en probabilidad permite que, para cada , exista un conjunto de trayectorias problemáticas cuya probabilidad se hace pequeña, aunque esos conjuntos puedan cambiar con .
La convergencia casi segura afirma que existe un conjunto fijo de probabilidad uno dentro del cual la trayectoria completa termina convergiendo.
El conjunto de excepciones matemáticas tiene probabilidad cero, de modo que la afirmación no las descarta una por una.
86.9. La independencia no es una decoración
Hasta ahora la independencia ha permitido reducir la varianza del promedio:
Sin independencia,
Los términos de covarianza pueden impedir que la varianza disminuya como .
La dependencia no destruye automáticamente toda ley de grandes números. Existen teoremas para numerosas formas de dependencia débil, procesos estacionarios y estructuras ergódicas.
Ahora bien, no podemos eliminar el supuesto sin reemplazarlo por condiciones alternativas.
86.10. Un contraejemplo de dependencia perfecta
Sea una única variable
y definamos para todo .
Cada tiene la misma distribución Bernoulli que antes.
Sin embargo,
Por tanto,
para todo .
Aumentar el tamaño muestral equivale aquí a copiar repetidamente la misma realización, sin añadir información independiente. La media permanece exactamente en 0 o en 1 según el valor de , sin converger a .
Este ejemplo muestra que «muchos datos» no equivale a «muchas realizaciones informativas».
86.11. Qué pregunta queda después de la ley de grandes números
La ley de grandes números explica que
bajo las hipótesis correspondientes.
Ese resultado, sin embargo, elimina la estructura que queremos estudiar si preguntamos por el error, de modo que necesitamos amplificar la diferencia.
Como
su escala típica es
Esto sugiere estudiar
El teorema central del límite describe el comportamiento de esta variable estandarizada.
86.12. Teorema central del límite i.i.d.
Sean
independientes e idénticamente distribuidas, con
y
Entonces
La notación
significa convergencia en distribución.
Equivalentemente,
El resultado afirma que la suma centrada y estandarizada adquiere una distribución aproximadamente normal cuando crece bajo las hipótesis del teorema, sin decir nada sobre la normalidad de los .
86.13. El TCL no dice que los datos se vuelvan normales
Supongamos otra vez
Cada solo puede tomar 0 o 1, sin importar cuán grande sea .
La distribución que se aproxima a una normal es la de
no la distribución de cada observación individual.
Esta distinción parece obvia algebraicamente y, sin embargo, es una fuente frecuente de confusión aplicada.
El tamaño muestral puede normalizar aproximadamente ciertas sumas y medias estandarizadas, sin transformar en normal una variable Bernoulli, exponencial o lognormal.
86.14. Bernoulli y convergencia hacia la normal
Para la Bernoulli con el paquete calcula exactamente la distribución binomial de la suma y la compara con la CDF normal estándar después de estandarizar.
La distancia de Kolmogorov disminuye aproximadamente desde para hasta para
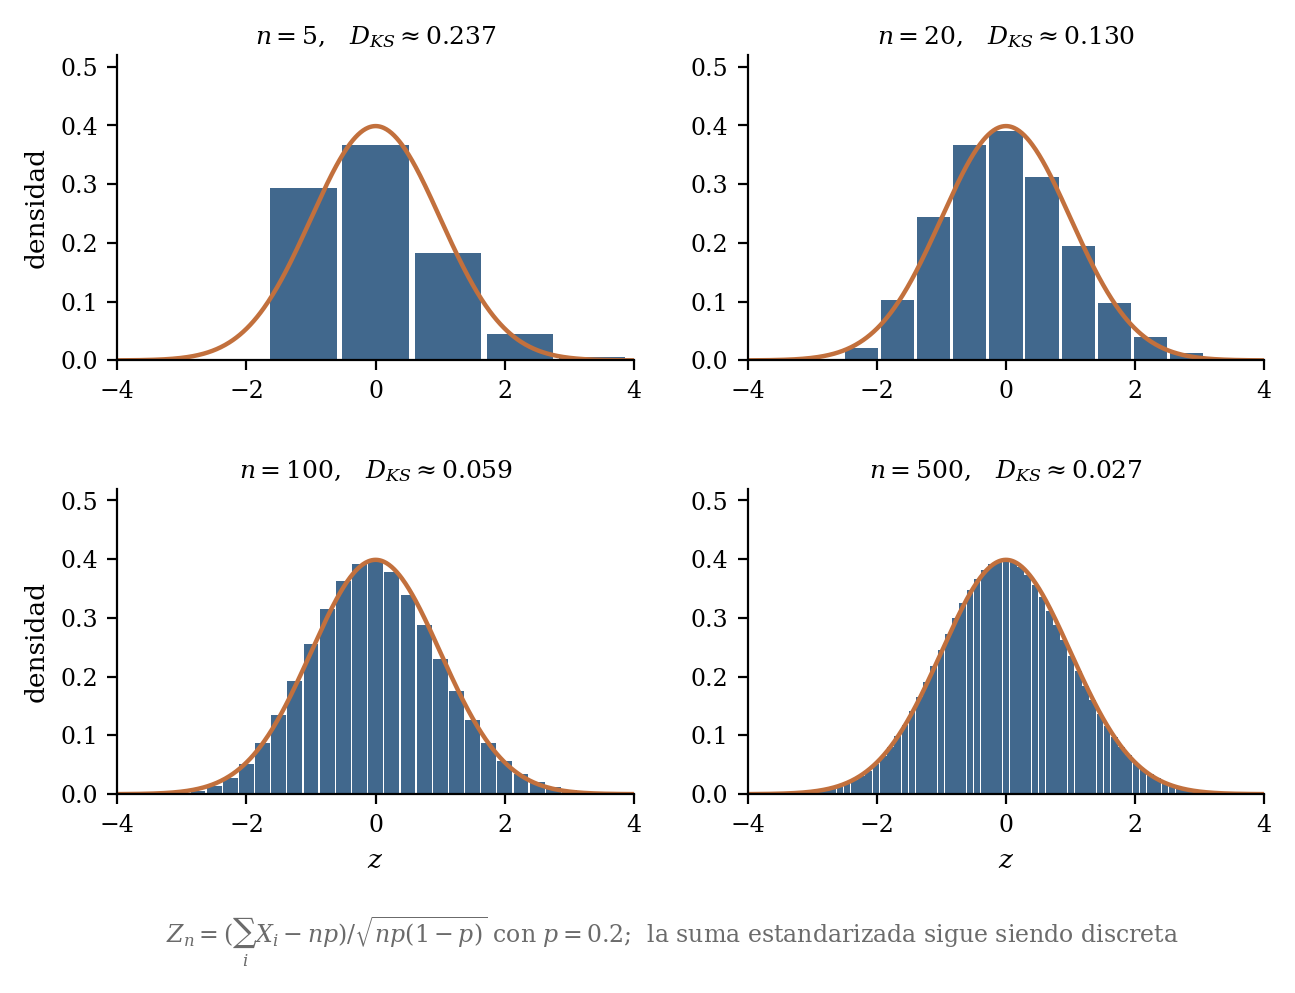
La aproximación no es exacta. La distribución binomial sigue siendo discreta y la normal continua.
En tamaños pequeños, la granularidad y la asimetría son visibles. A medida que aumenta , la distribución estandarizada se aproxima a la forma gaussiana.
86.15. Por qué aparece
La escala
obedece a una razón precisa.
Tenemos
Multiplicando por ,
Después de dividir por ,
Sin reescalamiento, la distribución de
colapsaría hacia cero por la ley de grandes números.
El TCL encuentra la escala precisa donde las fluctuaciones permanecen de orden uno y adquieren un límite no degenerado.
86.16. Una aproximación de error estándar
El resultado
precede al TCL y es exacto bajo independencia y varianza común.
El TCL añade que, para suficientemente grande bajo sus hipótesis,
puede aproximarse por
Esto permite aproximar probabilidades de error.
Por ejemplo,
se aproxima a en el límite normal.
La precisión para un concreto depende de la distribución original.
86.17. El tamaño muestral necesario no es universal
No existe un número mágico como que garantice una aproximación normal suficientemente buena en cualquier problema.
La velocidad depende de la distribución.
Una variable casi simétrica y de colas ligeras puede aproximarse con tamaños relativamente modestos. Una distribución muy asimétrica o con colas importantes puede requerir muestras mucho mayores.
La variable de interés también importa. Aproximar la región central puede ser mucho más fácil que aproximar probabilidades extremas de cola.
Por eso «el TCL aplica» y «la aproximación normal es suficientemente precisa para esta decisión» son afirmaciones distintas.
86.18. El teorema de Berry–Esseen y la velocidad de convergencia
Bajo hipótesis adicionales puede cuantificarse la velocidad de convergencia.
Para variables i.i.d. con
y tercer momento absoluto centrado finito
el teorema de Berry–Esseen proporciona una cota de la forma
donde es una constante universal.
El mensaje principal es la escala
La constante y el cociente influyen en cuán útil es la cota para un problema concreto.
El TCL es asintótico. Berry–Esseen añade una forma de controlar error finito bajo condiciones más fuertes.
86.19. Ley de grandes números sin TCL clásico
Ahora consideremos una distribución Pareto con escala mínima uno y exponente
Su cola satisface
Como
la media existe:
Como, en cambio,
el segundo momento diverge:
Por tanto, la varianza es infinita.
La ley fuerte i.i.d. puede seguir aplicándose porque
Así,
Sin embargo, el TCL clásico de varianza finita no puede utilizarse.
86.20. Convergencia más lenta bajo cola pesada
La figura reproducible compara el error mediano de la media en dos modelos.
El primero es la Pareto con
El segundo es una exponencial con media uno y varianza finita.
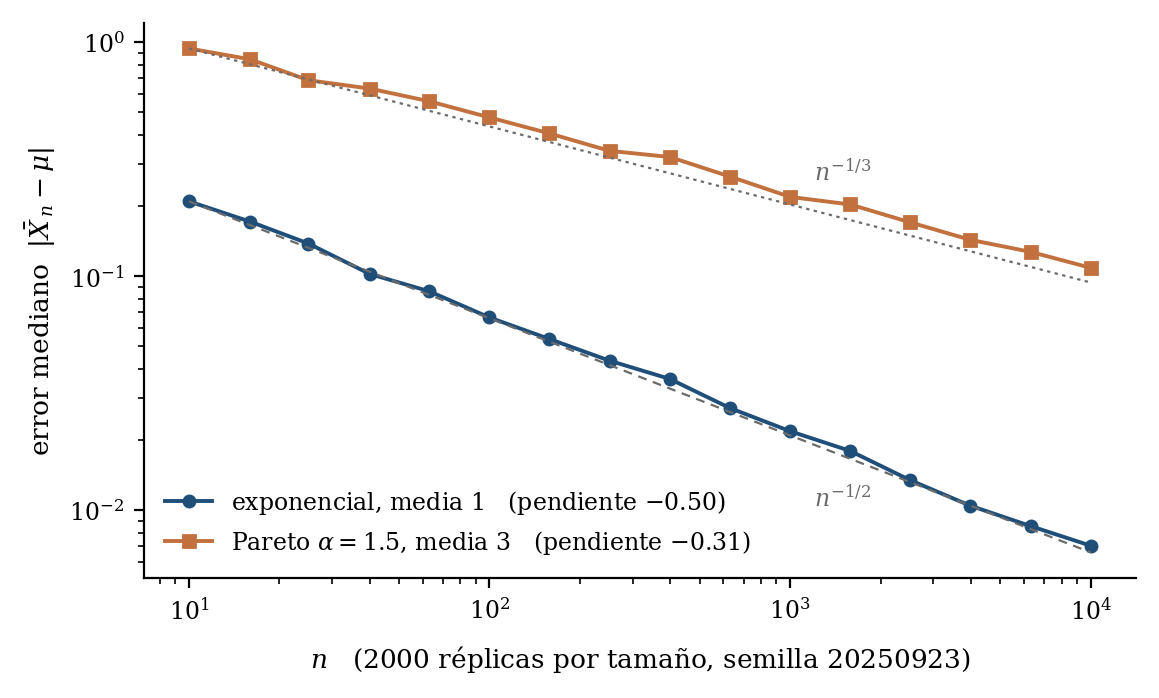
Para la exponencial, el error mediano de la media decrece aproximadamente con pendiente log-log compatible con la escala
Para la Pareto, la pendiente simulada es aproximadamente cercana a la escala esperable en este régimen estable de cola.
La media converge, pero sus fluctuaciones no siguen la escala gaussiana clásica.
86.21. La presencia de valores extremos no contradice la ley fuerte
En la Pareto, incluso para grande pueden aparecer observaciones enormes.
Una sola observación de magnitud comparable con puede modificar apreciablemente el promedio.
La ley fuerte afirma que, después de normalizar por , la suma total termina comportándose de manera compatible con la media finita casi seguramente, sin excluir la aparición de extremos.
La convergencia puede ser lenta e irregular.
El punto cuenta porque una trayectoria visualmente inestable no contradice automáticamente una ley asintótica. La escala del error puede disminuir mucho más lentamente que en distribuciones de varianza finita.
86.22. Varianza infinita no significa que toda muestra tenga varianza infinita
Cualquier muestra finita produce números finitos con probabilidad uno en la distribución Pareto considerada.
Podemos calcular una varianza muestral ordinaria sin que de ello se siga la existencia de una varianza poblacional finita.
La propiedad
se refiere a la integral o suma teórica del segundo momento bajo la distribución generadora.
Una estadística calculada en datos finitos puede existir incluso cuando el parámetro poblacional que intenta aproximar no existe como número finito.
Esta separación continúa el principio de C83 entre estadístico y propiedad distributiva.
86.23. El TCL también tiene versiones más generales
El teorema i.i.d. de varianza finita no es el único teorema central del límite.
Existen extensiones para variables independientes no idénticamente distribuidas bajo condiciones como las de Lindeberg o Lyapunov. Existen también TCL para diversas secuencias dependientes, martingalas, procesos de Markov y otros sistemas.
No desarrollaremos esas teorías aquí. El propósito de C86 es dominar la forma canónica y entender qué función cumplen las hipótesis.
La existencia de generalizaciones obliga a buscar el teorema apropiado cuando la estructura se aparta del caso i.i.d., sin autorizar la aplicación del TCL sin verificar condiciones.
86.24. Dependencia débil puede conservar una escala gaussiana
La dependencia perfecta de C86.10 destruyó la reducción de varianza, sin que toda dependencia tenga ese efecto.
Si una secuencia estacionaria tiene covarianzas
que decaen suficientemente rápido, la varianza de la suma puede crecer todavía de forma aproximadamente lineal en .
En ese caso, la varianza asintótica de la media puede involucrar
en vez de solo
La idea anticipa un tema posterior, porque con datos correlacionados observaciones no equivalen necesariamente a observaciones independientes.
La velocidad de acumulación de información depende de la dependencia temporal.
86.25. La normalidad de una suma no prueba independencia
El TCL tiene una dirección lógica específica.
Bajo ciertas condiciones sobre las variables componentes, una suma estandarizada se aproxima a una normal.
Observar una distribución aproximadamente normal para una suma no permite invertir el razonamiento y concluir que los sumandos eran independientes o idénticamente distribuidos.
Muchos mecanismos pueden producir formas aproximadamente gaussianas.
Incluso una variable individual puede ser normal por construcción, sin ser suma de nada en el modelo utilizado.
La normalidad es una propiedad distributiva. El TCL es uno de los mecanismos matemáticos capaces de producirla asintóticamente.
86.26. El promedio de una mezcla y la unidad de muestreo
C85 estudió heterogeneidad entre componentes.
Supongamos que cada observación selecciona de nuevo una componente de una mezcla de manera independiente. Entonces los pueden ser i.i.d. respecto de la distribución marginal de mezcla y una ley de grandes números puede estabilizar el promedio marginal.
Si cada grupo, en cambio, selecciona una componente una sola vez y después produce muchas observaciones condicionadas al mismo estado latente, aparece dependencia dentro de grupo.
Promediar 100 observaciones de una sola unidad heterogénea no equivale a promediar una observación de 100 unidades independientes.
La pregunta «¿cuál es ?» requiere especificar cuál es la unidad independiente de muestreo.
Este problema reaparecerá en modelos jerárquicos y datos agrupados.
86.27. Error estándar no es desviación estándar de los datos
La desviación estándar poblacional es
La desviación estándar de la media bajo muestreo i.i.d. es
Esta segunda cantidad suele llamarse error estándar de la media.
Describe cuánto varía el estimador
entre muestras repetidas de tamaño , más que cuánto varían las observaciones individuales.
Aumentar reduce el error estándar sin reducir necesariamente la heterogeneidad individual .
Confundir ambas escalas puede hacer parecer que una población se vuelve menos variable simplemente porque estimamos su media con mayor precisión.
86.28. Cuatro tipos de afirmación que deben mantenerse separados
Los resultados de este capítulo pueden organizarse en cuatro niveles.
Primero, una propiedad de la distribución individual:
Segundo, una propiedad exacta de la media finita bajo independencia:
Tercero, una afirmación asintótica de concentración:
Cuarto, una afirmación asintótica sobre la forma de las fluctuaciones:
Ningún nivel debe sustituirse silenciosamente por otro.
86.29. Normalidad exacta y normalidad asintótica
Existe un caso donde no necesitamos esperar al límite.
Si
son independientes, entonces cualquier combinación lineal es normal. En particular,
exactamente para todo .
Aquí la normalidad de la media proviene del cierre algebraico de la familia normal bajo sumas independientes, sin intervención de ninguna aproximación central.
El TCL se vuelve importante cuando la distribución original no es normal.
Para Bernoulli, exponencial o muchas otras distribuciones con varianza finita, la normalidad de la media es asintótica:
Distinguir ambos casos evita expresiones vagas como «la media es normal por el TCL». Si los datos originales son gaussianos, la distribución de la media ya es normal exactamente. Si no lo son, necesitamos un argumento asintótico y debemos evaluar si es suficiente para la precisión requerida.
También existen distribuciones para las que la suma permanece dentro de otra familia estable. La Cauchy es un ejemplo conocido, porque el promedio de variables Cauchy i.i.d. tiene la misma distribución Cauchy y no se concentra alrededor de una media finita, porque esa media no existe. C88 retomará el papel de las colas amplias; aquí basta notar que la suma no tiene por qué dirigirse hacia el régimen gaussiano cuando fallan las hipótesis relevantes.
86.30. Discreción y corrección de continuidad
En el ejemplo Bernoulli, la suma
es discreta, mientras la aproximación normal es continua.
Si queremos aproximar una probabilidad como
una aproximación simple sería
Sin embargo, el evento discreto incluye toda la masa del punto . Una aproximación clásica mejora a menudo al extender el límite hasta la mitad del siguiente intervalo:
El término es una corrección de continuidad. Se trata de una mejora finita para el caso en que usamos una distribución continua para aproximar una variable que vive sobre una retícula entera, sin que el TCL quede modificado.
Su utilidad disminuye a medida que los saltos individuales representan una fracción menor de la escala total. En tamaños pequeños o probabilidades muy cercanas a cero o uno, la aproximación puede seguir siendo pobre aun con corrección.
Este ejemplo recuerda una regla general. Un teorema asintótico especifica un límite, mientras convertirlo en una aproximación numérica para finito puede requerir correcciones adicionales y evaluación de error.
86.31. Un TCL no es una licencia para ignorar colas
El teorema central del límite controla la distribución de una suma estandarizada en el límite bajo sus hipótesis. No afirma que las colas de la distribución original se vuelvan irrelevantes en cualquier tamaño finito.
Supongamos que tiene varianza finita pero una cola derecha muy asimétrica. En muestras moderadas, unas pocas observaciones grandes pueden dominar el promedio. La región central de la distribución de
puede parecer aproximadamente normal antes de que sus colas estén bien aproximadas.
Esto importa si la pregunta científica es
para un umbral extremo.
Una aproximación suficientemente buena cerca de la mediana no garantiza precisión en una probabilidad de .
Berry–Esseen controla una distancia uniforme bajo tercer momento absoluto finito, pero su cota puede ser conservadora y no resuelve todos los problemas de cola. Existen teorías específicas de desviaciones moderadas y grandes desviaciones para preguntas más extremas.
No las desarrollaremos aquí. La idea necesaria es más sencilla. La adecuación del TCL debe juzgarse respecto del evento que queremos aproximar, más que por el aspecto central de un histograma.
86.32. Auditoría mínima antes de invocar una ley límite
Antes de aplicar una ley de grandes números o un TCL conviene identificar cinco elementos.
El primero es la unidad de repetición. Conviene precisar qué cuenta como un , porque repetir mediciones de una misma unidad puede introducir dependencia que no existe entre unidades.
El segundo es la cantidad objetivo. Para una ley de grandes números necesitamos saber qué esperanza se pretende aproximar y si esa esperanza existe.
El tercero es la dependencia. El caso i.i.d. es un punto de partida antes que una descripción automática de todos los datos. Si existe agrupamiento, series temporales o estados latentes compartidos, deben evaluarse teoremas compatibles con esa estructura.
El cuarto son los momentos. El TCL clásico utilizado aquí requiere
de modo que una media finita no basta.
El quinto es el tamaño y la región de interés. Un límite asintótico puede ser correcto y una aproximación finita, insuficiente. La distribución original, su asimetría y sus colas influyen en la velocidad.
Esta auditoría separa tres afirmaciones:
y
Las tres necesitan argumentos distintos.
86.33. La precisión mejora con rendimientos decrecientes
La escala
tiene una consecuencia práctica inmediata.
Si queremos reducir el error estándar por un factor dos, necesitamos multiplicar por cuatro:
Para reducirlo por un factor diez, necesitamos aproximadamente cien veces más observaciones independientes. La precisión, por tanto, no mejora linealmente con el tamaño muestral.
Este resultado ayuda a distinguir cantidad de datos y cantidad de información. Si las observaciones son independientes y el modelo de varianza finita es adecuado, aumentar produce beneficios previsibles pero decrecientes. Si existe dependencia positiva, la ganancia puede ser menor porque el tamaño muestral nominal sobrestima el número de realizaciones efectivamente distintas.
También explica por qué muestras gigantes no corrigen automáticamente un sesgo sistemático. La ley de grandes números concentra el promedio alrededor de su esperanza bajo el modelo generador. Si la variable observada está desplazada por un error de medición o el mecanismo de selección cambia la distribución, más observaciones pueden estimar con enorme precisión la cantidad equivocada.
Las leyes límite controlan la variación aleatoria, sin reparar por sí solas una representación sesgada del problema. Esta diferencia debe conservarse siempre que se interprete precisión estadística como calidad de conocimiento sobre el sistema.
86.34. Verificación computacional
El paquete reproducible ejecuta controles sobre los tres escenarios centrales.
Para Bernoulli con
verifica
y la identidad
Calcula exactamente
mediante la distribución binomial y confirma que nunca supera la cota de Chebyshev. Las simulaciones coinciden con las probabilidades exactas dentro de tolerancias prefijadas.
Para el TCL, el código calcula la distancia de Kolmogorov entre la distribución estandarizada binomial y la normal estándar. La distancia disminuye monótonamente en los tamaños estudiados y alcanza aproximadamente en .
El contraejemplo dependiente define para una única Bernoulli y comprueba que la varianza de la media permanece cerca de para .
Finalmente simula la Pareto con y un control exponencial de varianza finita. El error mediano del promedio decrece en ambos, pero la escala estimada para Pareto es aproximadamente , frente a en el control.
Se ejecutaron 29 comprobaciones automáticas y las 29 resultaron satisfactorias.
86.35. Qué queda establecido
La ley de grandes números y el teorema central del límite estudian promedios desde perspectivas distintas.
La ley de grandes números explica concentración:
El TCL clásico explica la forma de las fluctuaciones reescaladas:
se vuelve aproximadamente gaussiana después de normalizar por .
La independencia y los momentos determinan cómo disminuye la variabilidad y qué teoremas pueden utilizarse, lejos de ser detalles técnicos sin significado.
La dependencia perfecta muestra que repetir la misma información no produce estabilización. La Pareto con muestra que una media finita puede ser suficiente para una ley fuerte y, al mismo tiempo, insuficiente para el TCL clásico de varianza finita.
Los límites asintóticos tampoco garantizan precisión a cualquier tamaño muestral. La pregunta práctica siempre requiere saber qué distribución, qué dependencia, qué escala de error y qué observable se están considerando.
C87 continuará con Monte Carlo y el aprendizaje mediante realizaciones repetidas. Allí las leyes de grandes números dejarán de ser solo resultados teóricos y se convertirán en la base explícita de un método computacional para aproximar cantidades que no podemos o no queremos calcular analíticamente.
Referencias
- Berry, A. C. (1941). The accuracy of the Gaussian approximation to the sum of independent variates. Transactions of the American Mathematical Society, 49(1), 122–136. https://doi.org/10.1090/S0002-9947-1941-0003498-3
- Durrett, R. (2019). Probability: Theory and Examples (5th ed.). Cambridge University Press. https://doi.org/10.1017/9781108591034
- Gut, A. (2013). Probability: A Graduate Course (2nd ed.). Springer. https://doi.org/10.1007/978-1-4614-4708-5
- Kallenberg, O. (2021). Foundations of Modern Probability (3rd ed.). Springer. https://doi.org/10.1007/978-3-030-61871-1
Recursos reproducibles
Descargar recursos del capítulo (ZIP, 508 kB).
5 archivos CSV · 4 figuras · 1 programa Python.
El programa se ha ejecutado en una carpeta vacía y genera los archivos de datos y figuras incluidos en el paquete.