87.1. Convertir una cantidad en una esperanza
C86 terminó con una idea que ahora se vuelve método computacional. Si podemos escribir una cantidad como
y podemos generar realizaciones
de la distribución de , entonces podemos aproximar mediante
Esta es la estructura elemental de Monte Carlo.
La ley de grandes números da la justificación básica:
bajo condiciones apropiadas.
El teorema central del límite añade una descripción aproximada del error cuando la varianza es finita:
donde
Monte Carlo transforma un problema determinista o probabilístico difícil en un problema de promediar realizaciones.
La potencia del método proviene de que ciertas cantidades pueden representarse como expectativas y de que sabemos cómo se comportan los promedios, sin que el azar «encuentre» nada por sí mismo.
87.2. El estimador Monte Carlo elemental
Sea
con
Generamos realizaciones independientes e idénticamente distribuidas
El estimador es
Si
entonces
El estimador es insesgado.
Si además
Por tanto, su error estándar teórico es
Esta tasa es el sello del Monte Carlo ordinario independiente.
87.3. Duplicar precisión es caro
La tasa
implica rendimientos decrecientes.
Para dividir el error estándar por dos necesitamos aproximadamente realizaciones.
Para dividirlo por diez necesitamos aproximadamente
Monte Carlo es robusto, pero no converge rápido.
Esto explica el papel de los métodos de reducción de varianza en problemas costosos. No los desarrollaremos aquí. Aparecerán más adelante en el currículo, cuando el objetivo sea mejorar la eficiencia sin alterar la cantidad que se estima.
C87 se concentrará en el Monte Carlo directo y en cómo auditarlo correctamente.
87.4. Integración como esperanza
Consideremos la integral
Si
su densidad es uno sobre el intervalo. Entonces
Definamos
Podemos aproximar la integral generando
uniformes independientes y calculando
El problema de integración se ha convertido en un promedio.
87.5. Valor exacto para poder auditar el método
Esta integral tiene una expresión conocida:
El paquete reproducible usa este valor como referencia y lo contrasta además con cuadratura numérica de alta precisión.
La concordancia entre ambas es mejor que
Elegir un ejemplo con solución conocida permite separar dos preguntas, la de si el algoritmo Monte Carlo está implementado correctamente y la de qué comportamiento finito exhibe el estimador. Así evitamos confiar en el propio Monte Carlo para decidir si el Monte Carlo funciona.
87.6. Varianza exacta del integrando
El segundo momento es
Utilizando la función error,
Por tanto,
La desviación estándar es aproximadamente
Así, antes de simular sabemos que
La simulación tiene una predicción cuantitativa contra la cual compararse.
87.7. Una trayectoria Monte Carlo no es la convergencia teórica
La primera figura muestra la estimación acumulada
para una única secuencia pseudoaleatoria.
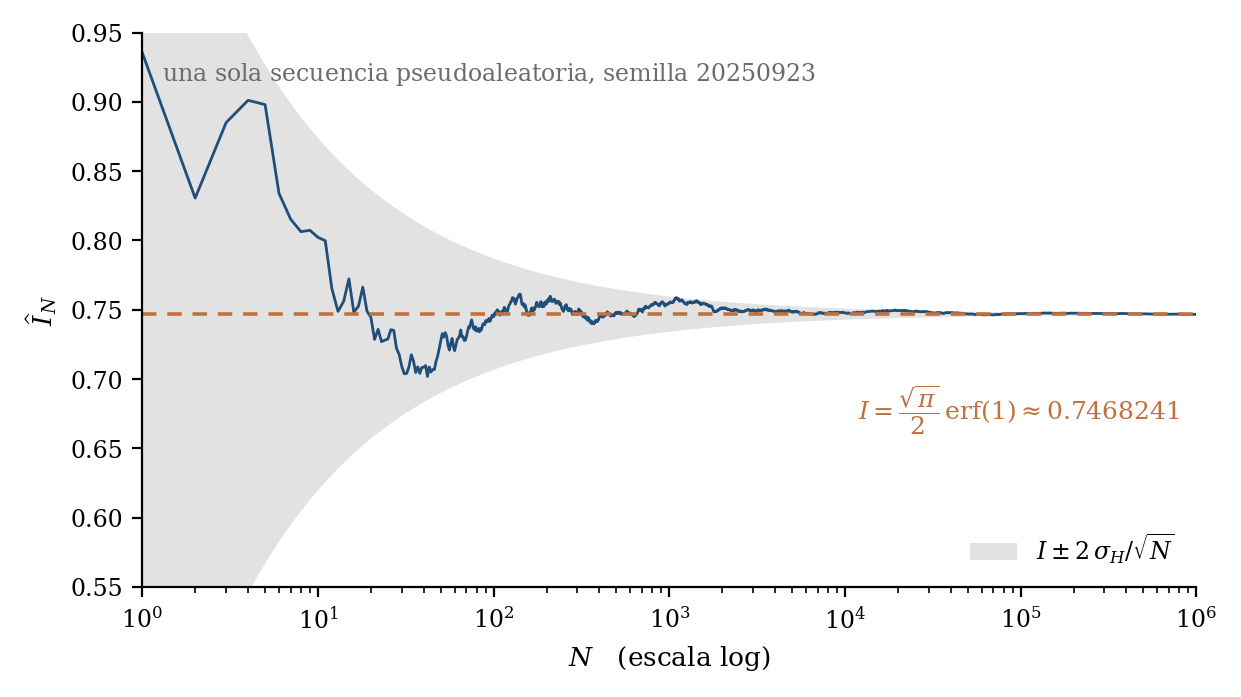
La curva oscila alrededor del valor exacto y se estabiliza progresivamente.
Con
la ejecución reproducible obtiene aproximadamente
El error de esta realización concreta es cercano a
Ese error es el resultado aleatorio de una ejecución. Leerlo como «el error del método para un millón de muestras» sería incorrecto.
Para estudiar la distribución del error necesitamos replicaciones independientes del experimento completo.
87.8. Repetir el propio Monte Carlo
El paquete ejecuta 2500 estimaciones independientes para cada uno de varios tamaños:
Para cada calcula la media de los estimadores, el sesgo empírico, la desviación estándar entre replicaciones, el RMSE, el error estándar teórico y la cobertura de un intervalo normal aproximado.
El estimador es insesgado en teoría. Los sesgos empíricos observados fluctúan alrededor de cero y disminuyen en importancia respecto de su desviación.
La desviación estándar entre replicaciones coincide estrechamente con
Así se verifica operacionalmente la teoría de C86.
87.9. RMSE y tasa de convergencia
Para un estimador
el error cuadrático medio es
Se descompone como
El RMSE es
Como el Monte Carlo elemental del ejemplo es insesgado,
La regresión log-log de los RMSE empíricos produce una pendiente aproximada de
muy próxima al valor teórico
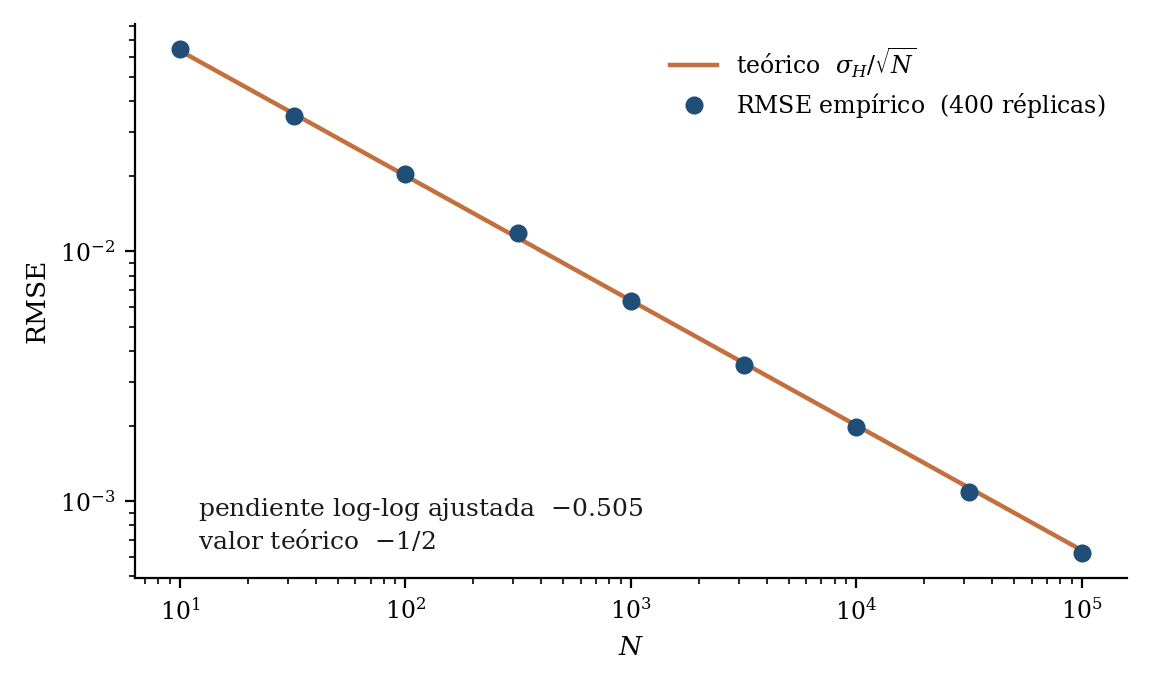
La simulación verifica que este experimento reproduce la consecuencia esperada de la ley general, sin demostrarla.
87.10. Estimar el error desde la propia muestra
En un problema real no conoceremos
Podemos estimarla mediante la desviación estándar muestral
Entonces utilizamos
Bajo las hipótesis del TCL, un intervalo aproximado del 95 % es
En las replicaciones del ejemplo, la cobertura observada queda aproximadamente entre y
Eso es compatible con la aproximación nominal del 95 %.
87.11. Qué significa esa cobertura
Un intervalo Monte Carlo no expresa incertidumbre sobre todo el modelo.
Si repitiéramos el procedimiento de simulación muchas veces bajo la misma distribución y el mismo , aproximadamente el 95 % de esos intervalos contendría el valor objetivo en el régimen donde la aproximación normal funciona adecuadamente.
Quedan fuera de ese cálculo el error en el modelo probabilístico, la incertidumbre sobre parámetros externos, el sesgo de discretización, el error de un solucionador determinista interno y los errores de programación.
El error Monte Carlo es solo una capa de la incertidumbre total. Una simulación puede tener un error estándar minúsculo y representar con enorme precisión un modelo equivocado.
87.12. Error de modelo frente a error Monte Carlo
Supongamos que realmente queremos
pero simulamos desde una distribución incorrecta .
Al aumentar ,
El error Monte Carlo respecto de la expectativa bajo puede tender a cero mientras persiste
Más simulaciones no corrigen ese sesgo estructural, que pertenece a la especificación y no al muestreo. Esta distinción es análoga a la de C80 entre precisión de una pendiente y validez del régimen de escala elegido.
87.13. Una semilla no genera aleatoriedad física
Los computadores ordinarios utilizan generadores pseudoaleatorios, algoritmos deterministas que producen secuencias diseñadas para comportarse estadísticamente como realizaciones de ciertas distribuciones.
Una semilla fija produce una secuencia reproducible dentro de la implementación especificada.
El paquete demuestra que dos generadores inicializados con la misma semilla producen los mismos primeros valores, mientras una semilla diferente produce otra secuencia.
La reproducibilidad es una ventaja científica.
Esa ventaja, sin embargo, exige conservar información suficiente sobre el algoritmo o biblioteca utilizados, su versión, la semilla o estado inicial y los parámetros de simulación.
La palabra «aleatorio» no debe utilizarse como excusa para resultados irreproducibles.
87.14. El error de reiniciar la misma semilla
Supongamos que queremos 100 replicaciones independientes.
Si dentro de cada repetición ejecutamos
antes de generar datos, produciremos la misma realización 100 veces.
El promedio entre «replicaciones» duplica exactamente la misma información y no estima la variabilidad entre ejecuciones.
Una estrategia correcta consiste en mantener un flujo generador bien definido o crear subflujos independientes mediante mecanismos apropiados del generador.
El principio es el mismo que en C86, porque repetir datos idénticos no aumenta el tamaño efectivo de muestra.
87.15. Monte Carlo para probabilidades
Una probabilidad puede escribirse como esperanza de una variable indicadora.
Si
es un evento,
Por tanto, el estimador Monte Carlo es
Es simplemente la fracción de realizaciones donde ocurre el evento.
Su varianza es
El error estándar es
Esto funciona bien para probabilidades moderadas. Los eventos raros muestran una limitación seria.
87.16. El caso
Sea
Queremos estimar
El valor exacto es aproximadamente
El Monte Carlo ingenuo genera normales estándar y cuenta cuántas superan tres.
Con
esperamos solo aciertos.
En la ejecución reproducible aparecen ocho.
La estimación es muy distinta en términos relativos del valor verdadero, aunque el algoritmo esté funcionando correctamente.
87.17. El error relativo de un evento raro
El error estándar relativo es
Puede escribirse como
Cuando
La cantidad importante es el número esperado de eventos
Si queremos un error estándar relativo del 10 %, necesitamos aproximadamente
Para 3 %,
Para 1 %,
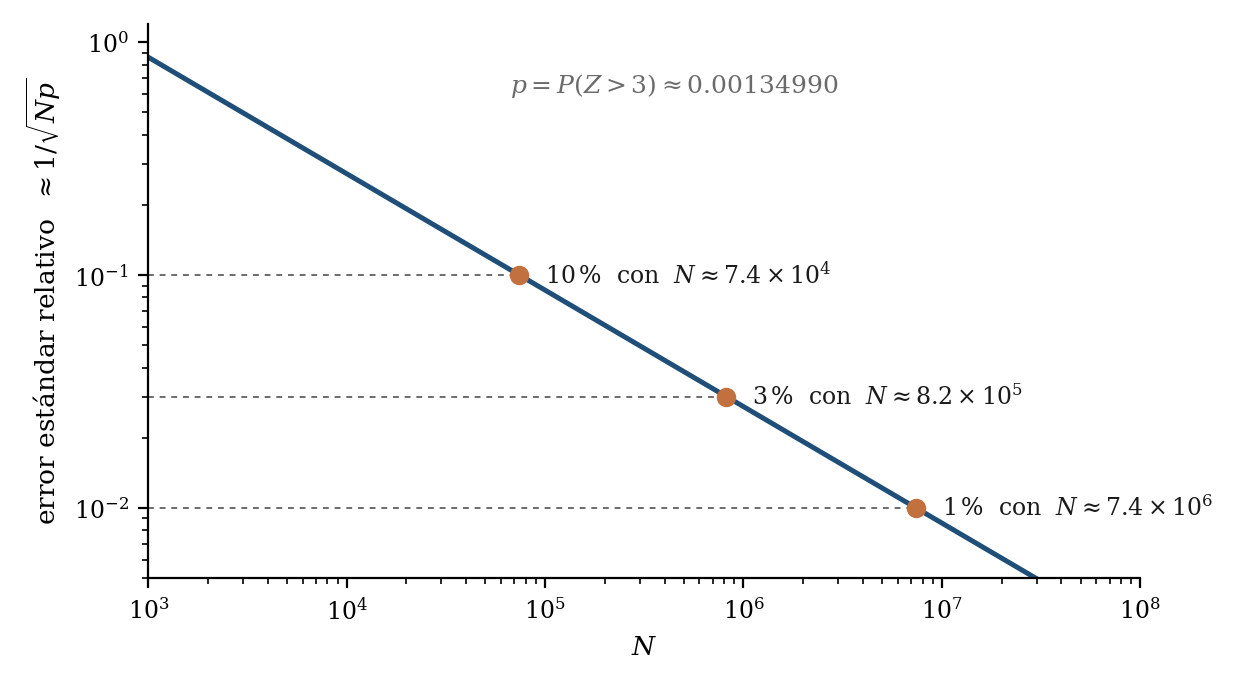
El método funciona correctamente. Lo desfavorable es la varianza relativa de la cantidad que intentamos estimar.
87.18. Cero observaciones no significa probabilidad cero
Para eventos aún más raros puede ocurrir que ninguna de simulaciones alcance el evento.
Entonces
Eso solo indica que la muestra no observó éxitos, sin demostrar
La probabilidad de cero aciertos es
Para pequeño,
Si
observar cero es lo habitual incluso cuando el evento tiene probabilidad positiva.
Este punto será central en C88, donde estudiaremos colas y riesgo de extrapolación.
87.19. Monte Carlo multidimensional
Consideremos
La integral es separable:
Por tanto,
El valor exacto permite auditar Monte Carlo en varias dimensiones.
Si
definimos
Entonces
El mismo estimador medio funciona para cualquier .
87.20. La tasa formal no depende de la dimensión
Para Monte Carlo independiente,
El exponente de sigue siendo
independientemente de .
Esta propiedad hace atractivo a Monte Carlo en problemas de alta dimensión.
Una regla de cuadratura construida como una malla con puntos por eje requiere evaluaciones.
Con cinco puntos por eje y ya obtenemos puntos.
Con diez puntos por eje,
El crecimiento tensorial puede ser prohibitivo.
87.21. Dimensión independiente no significa costo independiente
La frase «la tasa Monte Carlo no depende de la dimensión» debe interpretarse con precisión.
El factor no cambia.
La varianza
sí puede depender de , en cambio. También puede aumentar el costo de evaluar una sola realización.
En el ejemplo reproducible, con el error estándar relativo crece desde aproximadamente en una dimensión hasta en veinte dimensiones.
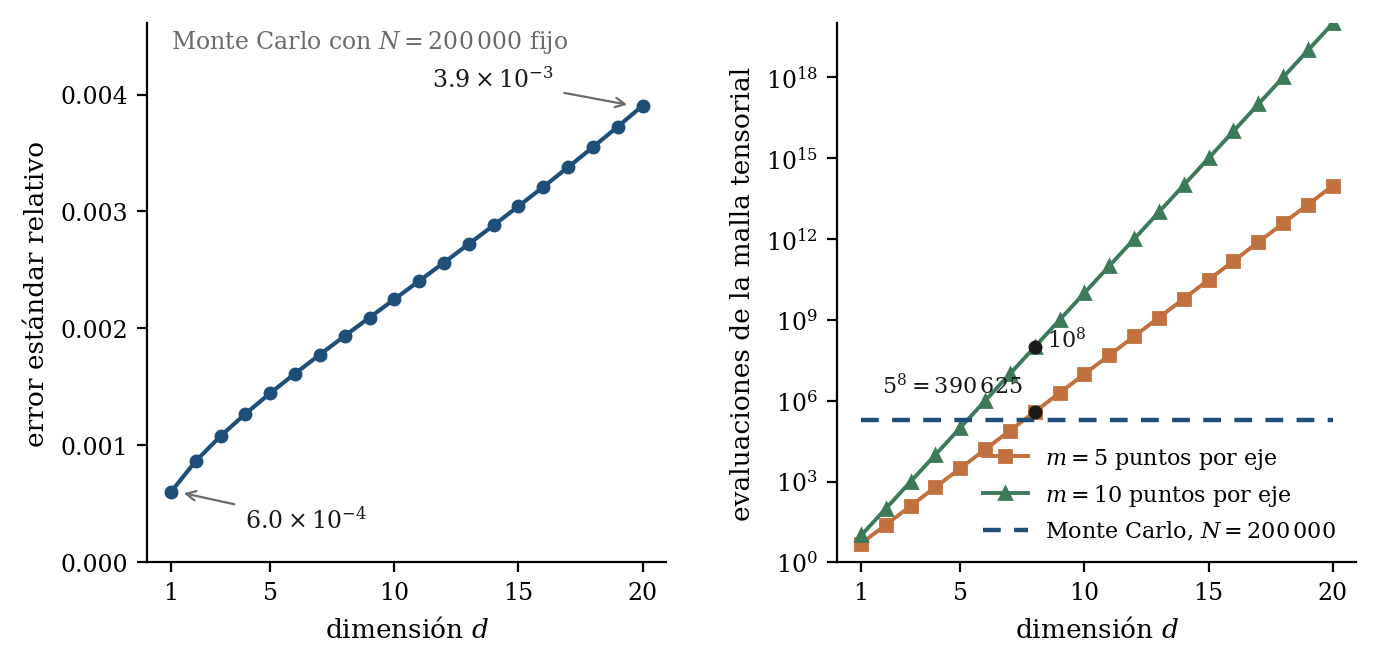
Lo que Monte Carlo evita es la explosión combinatoria directa de una malla tensorial, sin conceder inmunidad universal frente a la dimensionalidad.
87.22. Este ejemplo multidimensional es deliberadamente fácil
La integral anterior es separable.
Eso significa que el mejor método no sería Monte Carlo ni una malla de cien millones de puntos. Podemos calcularla mediante una integral unidimensional y elevar el resultado a la potencia .
El ejemplo aísla dos propiedades, sin pretender que Monte Carlo sea superior. Una malla tensorial ingenua crece como , mientras Monte Carlo conserva su tasa aunque su constante de error pueda cambiar.
La estructura del problema debe explotarse siempre que exista. Utilizar Monte Carlo donde una derivación exacta resuelve el problema sería desperdiciar información.
87.23. Monte Carlo frente a cuadratura determinista
En una dimensión, para una función suave como los métodos deterministas de cuadratura pueden converger muchísimo más rápido que Monte Carlo.
La cuadratura utilizada como control en este capítulo reproduce el valor de referencia prácticamente a precisión de máquina con un costo minúsculo frente a un millón de muestras.
Ambos hechos son compatibles. Monte Carlo resulta atractivo cuando la dimensión es alta, cuando el dominio es complicado, cuando la expectativa proviene de un simulador, cuando la distribución permite muestrear pero no integrar con facilidad o cuando el integrando no se presta a cuadratura estructurada. No existe un ganador universal entre integración determinista y estocástica.
87.24. Una simulación puede ser más costosa que el muestreo
Hasta ahora evaluar ha sido casi gratuito.
En aplicaciones reales una realización puede requerir resolver un sistema de ecuaciones diferenciales, ejecutar un modelo basado en agentes o simular una red grande.
Entonces el costo total es aproximadamente
Reducir el error por un factor dos exige cuatro veces más muestras y, en primera aproximación, cuatro veces más tiempo computacional.
Esta relación convierte la varianza en una cantidad operacional. Menor varianza del estimador significa menos simulaciones para una precisión dada.
87.25. Error de discretización dentro de Monte Carlo
Supongamos que cada realización necesita resolver numéricamente una ecuación diferencial con paso
Entonces podemos estar estimando
no exactamente
El error total puede descomponerse conceptualmente en
Aumentar reduce solo el primer término.
Disminuir puede reducir el segundo, pero encarece cada realización.
Una simulación reproducible debe distinguir ambas fuentes de error.
87.26. Detener la simulación según un criterio de precisión
Un procedimiento razonable puede definir de antemano una tolerancia Monte Carlo.
Por ejemplo, queremos
Como
podemos aumentar hasta alcanzar la tolerancia.
Sin embargo, el criterio se vuelve aleatorio porque también se estima.
En problemas ordinarios esto puede ser suficiente como regla operacional. En problemas más delicados se requieren procedimientos secuenciales con garantías explícitas.
La idea general es que el número de simulaciones debería fijarse a partir de la precisión requerida, antes que como una cifra redonda sin diagnóstico de error.
87.27. No reutilizar el mismo error estándar para todas las cantidades
Una simulación puede estimar varias salidas:
Cada una puede tener varianza diferente.
Una cantidad central puede estimarse con gran precisión mientras una probabilidad de cola permanece extremadamente ruidosa.
El hecho de haber ejecutado realizaciones no define por sí solo la calidad de todas las estimaciones producidas.
Debe calcularse el error Monte Carlo de cada cantidad relevante.
Para probabilidades raras, cuantiles extremos o razones de cantidades pequeñas, el comportamiento puede ser mucho peor que para una media central.
87.28. Reproducibilidad y separación entre experimento y análisis
Una implementación robusta debería separar:
- generación de realizaciones;
- cálculo de la cantidad ;
- agregación del estimador;
- diagnóstico de incertidumbre;
- producción de figuras y tablas.
Esta separación facilita verificar cada etapa.
El paquete reproducible del capítulo conserva datos fuente resumidos, semilla, resultados de replicaciones, cálculos de error y verificaciones analíticas.
La reproducibilidad exige que sea posible reconstruir qué se estimó, con qué distribución y con qué tolerancia, más allá de que el código «corra».
87.29. Pseudorandomness no sustituye validación estadística
Una secuencia pseudoaleatoria puede ser perfectamente reproducible y aun así utilizarse mal.
Entre los errores frecuentes están correlacionar involuntariamente flujos que deberían ser independientes, reiniciar semillas, transformar mal uniformes a otra distribución, reutilizar realizaciones sin reconocer dependencia y descartar valores extremos porque parecen errores.
La calidad del generador no corrige un algoritmo probabilístico equivocado.
Del mismo modo, obtener cifras distintas al cambiar de semilla solo muestra que existe variabilidad entre ejecuciones, sin acreditar que el simulador sea «realista».
87.30. Qué significa aprender mediante realizaciones repetidas
Monte Carlo puede interpretarse como aprendizaje computacional sobre una distribución especificada.
Cada realización aporta información sobre
La media acumulada reduce el ruido de muestreo.
El método, sin embargo, aprende dentro del modelo. No descubre por sí solo qué distribución debería usarse, qué variables se omitieron o si el simulador representa el fenómeno real.
La cadena lógica es
La validez del primer eslabón sigue requiriendo argumentos externos a la simulación.
87.31. La distribución de muestreo forma parte del estimador
La integral unidimensional utilizó una uniforme porque el dominio era :
Si el dominio tiene volumen finito y
entonces
El factor no puede omitirse salvo que el volumen sea uno.
Más generalmente, si queremos calcular
donde es una densidad normalizada, podemos escribir
El subíndice recuerda respecto de qué distribución se toma la esperanza.
La elección de la distribución de muestreo y la definición de la función promediada forman una pareja. Cambiar una sin modificar la otra cambia la cantidad estimada.
Existe una identidad más general. Si generamos desde otra densidad , positiva donde es relevante,
Esta expresión es la base del muestreo de importancia. No desarrollaremos aquí cómo elegir ni sus diagnósticos, porque el currículo lo retomará en C235. El punto de C87 es conceptual. Monte Carlo consiste en construir una expectativa bajo una distribución de muestreo conocida y promediar el integrando correcto, lo que rara vez equivale a «muestrear uniformemente».
Una implementación puede generar millones de puntos sin estimar la cantidad deseada si los pesos, el volumen del dominio o la distribución de referencia están mal especificados.
87.32. Insesgado no se conserva bajo cualquier posprocesamiento
El estimador de la integral satisface
Eso no significa que cualquier función posterior del estimador siga siendo insesgada.
Supongamos que queremos informar
pero calculamos
En general,
Por ejemplo, si
entonces
Por tanto,
si la varianza es positiva.
El sesgo es exactamente
Desaparece cuando , pero existe para tamaño finito.
Esta observación cuenta en simulaciones donde la cantidad final es una razón, un logaritmo, un máximo o alguna transformación no lineal de varias expectativas estimadas.
La ley de grandes números puede garantizar consistencia mediante continuidad de , pero consistencia e insesgamiento finito no son sinónimos.
También recuerda una idea de C85:
Monte Carlo aproxima expectativas. Aplicar después una transformación cambia el objeto algebraico y puede introducir otro componente del error.
87.33. Planificar el tamaño Monte Carlo
Si conocemos aproximadamente la desviación estándar
y queremos que un semiancho normal aproximado sea como máximo ,
Despejando,
Para un intervalo aproximado del 95 %,
Si es desconocida, puede estimarse mediante una ejecución piloto.
Esta planificación contiene incertidumbre porque el propio es aleatorio. Aun así, es preferible a elegir solo porque una potencia de diez resulta cómoda.
También hace visible el costo cuadrático de la precisión. Si reducimos a la mitad, se multiplica aproximadamente por cuatro.
Para eventos raros conviene utilizar precisión relativa. Como
resolver
produce
El cálculo del capítulo para proviene exactamente de esta identidad.
87.34. Replicaciones, lotes y diagnóstico de estabilidad
Una única media acumulada puede ocultar problemas.
Dividir las realizaciones en lotes independientes permite observar si las estimaciones parciales son compatibles con el error esperado. Si cuatro lotes enormes producen resultados separados por muchas desviaciones estándar, puede existir dependencia inadvertida, un cambio de régimen, un error de implementación o una subestimación de la varianza.
En el Monte Carlo i.i.d. elemental, si cada lote contiene realizaciones,
deberían comportarse como estimadores aproximadamente independientes con varianza
La variabilidad entre lotes aporta una comprobación externa al cálculo de dentro de una única secuencia.
No deben confundirse lotes con repetir la misma secuencia debido a una semilla reiniciada. Los lotes necesitan información pseudoaleatoria distinta.
El diseño por lotes gana peso cuando las muestras no son independientes, como ocurrirá posteriormente con MCMC. Allí las observaciones consecutivas pueden estar autocorrelacionadas y la fórmula
subestimaría la incertidumbre si se aplica ingenuamente.
C87 no desarrolla ese caso, pero fija un principio que sobrevivirá. El tamaño nominal de una simulación no determina el tamaño informativo sin conocer la dependencia entre realizaciones.
87.35. Verificar un simulador con problemas que sí sabemos resolver
Monte Carlo suele utilizarse cuando la respuesta exacta es desconocida. Eso no elimina la posibilidad de verificar partes del procedimiento.
Una estrategia robusta consiste en construir primero casos de referencia donde la respuesta sí sea conocida. El ejemplo de la integral
cumple esa función. También lo hace la integral multidimensional separable.
Si el código falla en esos problemas, no existe fundamento para confiar en una aplicación más compleja donde el valor verdadero está oculto.
La verificación puede realizarse por capas. El generador se contrasta mediante distribuciones conocidas. Las transformaciones se comprueban contra identidades analíticas. El estimador se audita usando medias o probabilidades exactas. La tasa de convergencia se compara con
Cuando el simulador interno incluye dinámica, pueden utilizarse invariantes, soluciones especiales o límites simplificados, siguiendo el método de C29.
Esto separa verificación de validación.
Verificar pregunta si resolvemos correctamente el modelo que escribimos. Validar pregunta si ese modelo representa suficientemente el fenómeno de interés.
Monte Carlo puede aprobar todas las pruebas de verificación y seguir siendo científicamente inadecuado porque las distribuciones, parámetros o mecanismos elegidos no corresponden al sistema real. Por eso conviene conservar, junto con el resultado final, una jerarquía explícita de controles que cubra la exactitud del generador, la corrección de las transformaciones, la consistencia del estimador, la estabilidad frente a semillas y el acuerdo con casos límite. Cuanto más opaco sea el simulador, más importante resulta disponer de problemas reducidos donde una parte de la respuesta pueda calcularse por otra vía independiente.
Esta distinción pesa más cuando la simulación produce imágenes o distribuciones visualmente convincentes. La apariencia de variabilidad realista no sustituye una prueba de que cada capa del algoritmo implementa la estructura declarada. En simulación científica, la trazabilidad de esas capas es parte del resultado y no una tarea administrativa posterior.
87.36. Verificación computacional
El paquete reproducible ejecuta controles en cuatro niveles.
Para la integral
comprueba que la expresión con coincide con cuadratura de alta precisión. Deriva el segundo momento y la varianza del integrando. La estimación con un millón de muestras permanece dentro de cinco errores estándar teóricos.
Después ejecuta 2500 replicaciones para seis tamaños muestrales. La desviación estándar empírica de los estimadores coincide con
la cobertura de intervalos normales aproximados permanece cerca de 95 % y la pendiente log-log del RMSE es compatible con la tasa teórica .
Para el evento verifica la fórmula del error estándar relativo y el crecimiento cuadrático del tamaño requerido al exigir mayor precisión relativa. Con un millón de realizaciones aparecen 1370 aciertos y la estimación queda dentro de cuatro errores estándar del valor exacto.
En el ejemplo multidimensional se calculan integrales exactas para dimensiones entre 1 y 20 y se verifica que todas las estimaciones queden dentro de cinco errores estándar. También se documenta el crecimiento de una malla tensorial.
Finalmente, dos generadores inicializados con la misma semilla reproducen exactamente la misma secuencia, mientras una semilla distinta produce otra.
Se ejecutaron 25 comprobaciones automáticas y las 25 resultaron satisfactorias.
87.37. Qué queda establecido
Monte Carlo convierte expectativas en promedios de realizaciones.
La ley de grandes números justifica convergencia. El TCL clásico explica la escala aproximada del error cuando la varianza es finita.
El estimador elemental tiene error estándar
por lo que mejorar precisión es costoso.
El método puede ser competitivo en dimensiones altas porque el exponente de convergencia respecto de no depende directamente de la dimensión, pero la constante de error y el costo por realización sí pueden hacerlo.
Los eventos raros revelan otra limitación, porque si solo una fracción de las simulaciones aporta un acierto la precisión relativa depende aproximadamente de .
Finalmente, el error Monte Carlo debe separarse de error del modelo, discretización y programación.
El siguiente capítulo, C88, estudiará las colas amplias, los cuantiles y el riesgo de extrapolación. Allí veremos por qué las regiones menos visitadas por Monte Carlo ordinario pueden ser las decisivas para ciertas preguntas y por qué resumir incertidumbre mediante media y varianza puede resultar insuficiente.
Referencias
- Caflisch, R. E. (1998). Monte Carlo and quasi-Monte Carlo methods. Acta Numerica, 7, 1–49. https://doi.org/10.1017/S0962492900002804
- Metropolis, N., & Ulam, S. (1949). The Monte Carlo method. Journal of the American Statistical Association, 44(247), 335–341. https://doi.org/10.1080/01621459.1949.10483310
- Niederreiter, H. (1992). Random Number Generation and Quasi-Monte Carlo Methods. SIAM. https://doi.org/10.1137/1.9781611970081
- Robert, C. P., & Casella, G. (2004). Monte Carlo Statistical Methods (2nd ed.). Springer. https://doi.org/10.1007/978-1-4757-4145-2
Recursos reproducibles
Descargar recursos del capítulo (ZIP, 287 kB).
6 archivos CSV · 4 figuras · 1 programa Python.
El programa se ha ejecutado en una carpeta vacía y genera los archivos de datos y figuras incluidos en el paquete.