88.1. La parte menos observada puede dominar la pregunta
C87 mostró una dificultad básica del Monte Carlo para eventos raros. Si un evento tiene probabilidad
una simulación de tamaño produce aproximadamente ocurrencias. Cuando es pequeño, la estimación relativa es inestable incluso si el generador es correcto.
Ahora la pregunta cambia. Más allá de estimar una probabilidad rara bajo una distribución conocida, queremos entender cómo la forma de la cola determina esas probabilidades y qué ocurre cuando extrapolamos más allá de la región donde tenemos datos.
La cola de una distribución puede afectar las probabilidades de eventos extremos, los cuantiles altos, los máximos observados, la existencia de media o varianza, la velocidad de convergencia de los promedios y la estabilidad de los estimadores.
Dos distribuciones pueden parecer semejantes en su región central y producir predicciones muy diferentes para eventos raros.
Por eso la cola no es un detalle que se añade al final del análisis. Si la pregunta científica depende de extremos, la especificación de la cola forma parte del modelo principal.
88.2. Función de supervivencia
Para una variable real con función de distribución
definimos la función de supervivencia
La supervivencia responde directamente a preguntas de cola.
Si queremos saber la probabilidad de superar un umbral , necesitamos
En escalas ordinarias, las probabilidades pequeñas pueden resultar difíciles de comparar. Por eso suelen representarse mediante ejes logarítmicos.
Para una exponencial con tasa ,
En un gráfico semilogarítmico,
que es una recta.
Para una Pareto con escala mínima y exponente ,
En ejes log-log,
La pendiente es
Las dos colas decaen de manera cualitativamente distinta.
88.3. Cola ligera, cola pesada y ley de potencia no son sinónimos
La terminología requiere cuidado.
Una exponencial tiene una cola que decae exponencialmente. Se considera típicamente una distribución de cola ligera.
Una Pareto tiene una cola de potencia:
Es un ejemplo canónico de cola pesada y, más específicamente, de cola regularmente variante.
Ahora bien, «cola pesada» es una categoría más amplia que «Pareto». Una lognormal, por ejemplo, decae más lentamente que cualquier exponencial lineal en , pero su cola no es una ley de potencia regularmente variante.
Existen varias definiciones técnicas de heavy-tailed según el contexto. Una definición común exige que la función generadora de momentos positiva diverja:
No toda distribución pesada comparte las mismas propiedades asintóticas.
Por ello, observar valores extremos frecuentes no justifica afirmar automáticamente «ley de potencia».
88.4. Un contraste controlado con la misma mediana
Compararemos una exponencial y una Pareto fijando en ambas
Para la exponencial,
Elegimos entonces
Para una Pareto,
Tomamos y elegimos
Así,
en ambas familias.
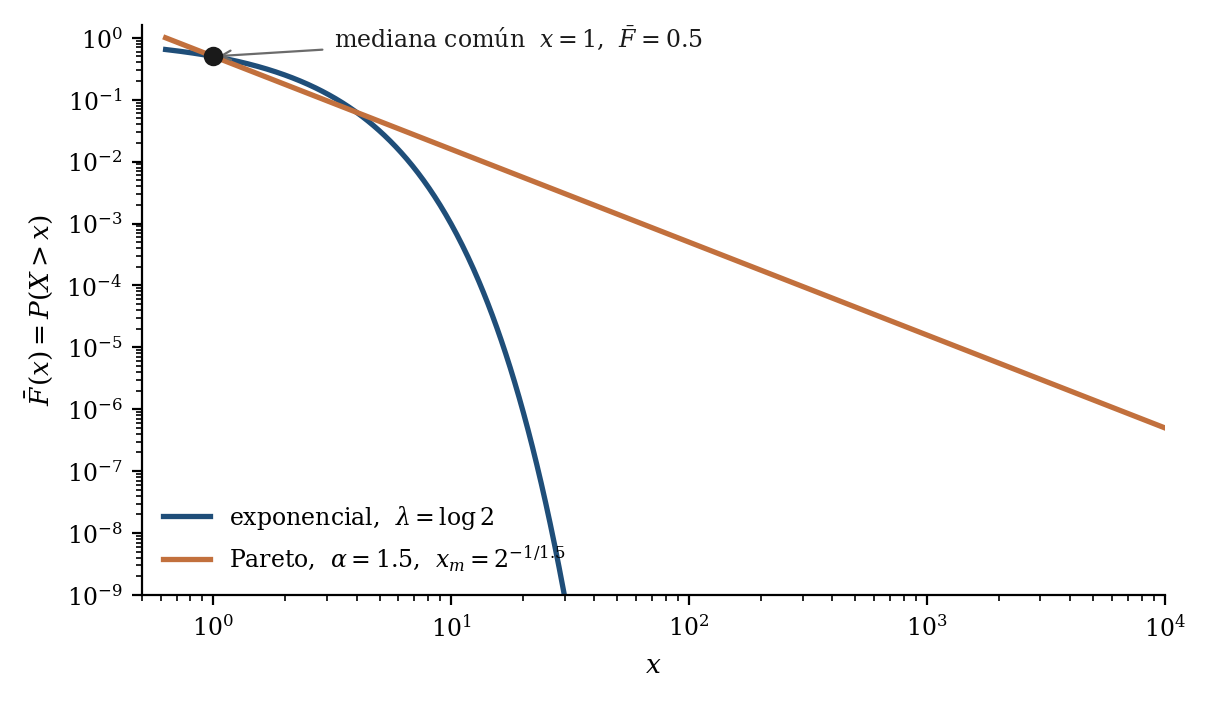
Compartir un cuantil central, como muestra la figura, no hace comparables sus extremos.
88.5. Cuantiles
Para
definimos un cuantil mediante
En una distribución continua estrictamente creciente,
Es frecuente trabajar con probabilidad de cola
Entonces
Para la exponencial,
de donde
Para Pareto,
por lo que
La diferencia entre logaritmo y potencia dominará la extrapolación extrema.
88.6. Cuantiles extremos con el mismo centro
Con las parametrizaciones anteriores, para la exponencial produce un cuantil cercano a mientras la Pareto produce aproximadamente
Para la exponencial entrega mientras la Pareto alcanza aproximadamente
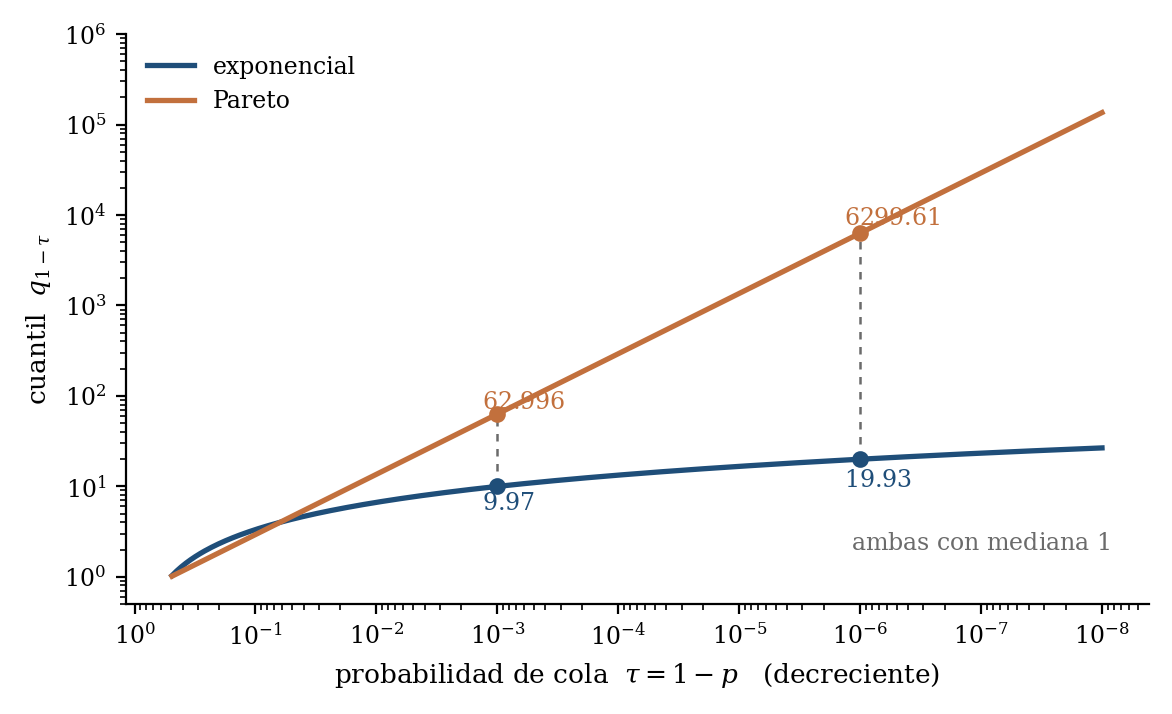
Ambas distribuciones tenían mediana uno.
La forma funcional de la cola cambia la predicción en varios órdenes de magnitud, muy por encima de lo que sería una pequeña corrección.
88.7. Los cuantiles no requieren media ni varianza
Una ventaja conceptual de los cuantiles es que pueden estar bien definidos aun cuando ciertos momentos no existan.
Para una Pareto con parámetro ,
si
En particular, la media es finita solo si
La varianza es finita solo si
Nuestro ejemplo utiliza
Entonces
es finita, pero
Aun así, la mediana, el cuantil 0.99 o cualquier otro cuantil con son finitos.
Esto vuelve a los cuantiles útiles cuando los momentos altos son inestables o inexistentes.
88.8. Por qué diverge el segundo momento de Pareto
La densidad Pareto es
El momento de orden contiene
La integral converge solo si es decir,
Para
la integral diverge.
El paquete calcula momentos truncados
El primer momento converge hacia la media finita cuando aumenta. El segundo continúa creciendo sin estabilizarse.
La divergencia significa que la contribución esperada de valores cada vez mayores impide que el segundo momento poblacional converja, sin que ninguna muestra finita contenga infinitos.
88.9. Cuantiles empíricos
Dada una muestra ordenada
los cuantiles empíricos se construyen a partir de estadísticos de orden cercanos a la posición
Existen varias convenciones de interpolación finita. Todas coinciden asintóticamente bajo condiciones regulares, pero pueden diferir cuando es pequeño o está muy cerca de uno.
El punto principal es simple.
Para estimar aproximadamente el 10 % de la muestra queda por encima del cuantil.
Para solo el 0.1 % queda por encima.
Con esperamos apenas observación por encima del cuantil 0.999.
La información empírica directa en esa región es mínima.
88.10. Error de un cuantil y densidad local
Bajo condiciones regulares, un cuantil empírico satisface una aproximación asintótica de la forma
Por tanto,
La densidad en el propio cuantil aparece en el denominador.
Si la densidad es muy pequeña en la cola, una pequeña variación de probabilidad puede traducirse en una gran variación de posición.
Los cuantiles extremos son difíciles por la escasez de observaciones y también por su sensibilidad a la pendiente local de la distribución.
88.11. El caso Pareto hace visible
Para Pareto,
Sustituyendo en la varianza asintótica,
Aparece de nuevo la cantidad
Es el número esperado de observaciones por encima del cuantil.
La misma estructura que C87 encontró para probabilidades raras reaparece ahora en la estimación de cuantiles extremos.
Cuando es pequeño, la precisión relativa se deteriora.
88.12. Simulación de cuantiles Pareto
El paquete simula muestras Pareto para
y estima los cuantiles
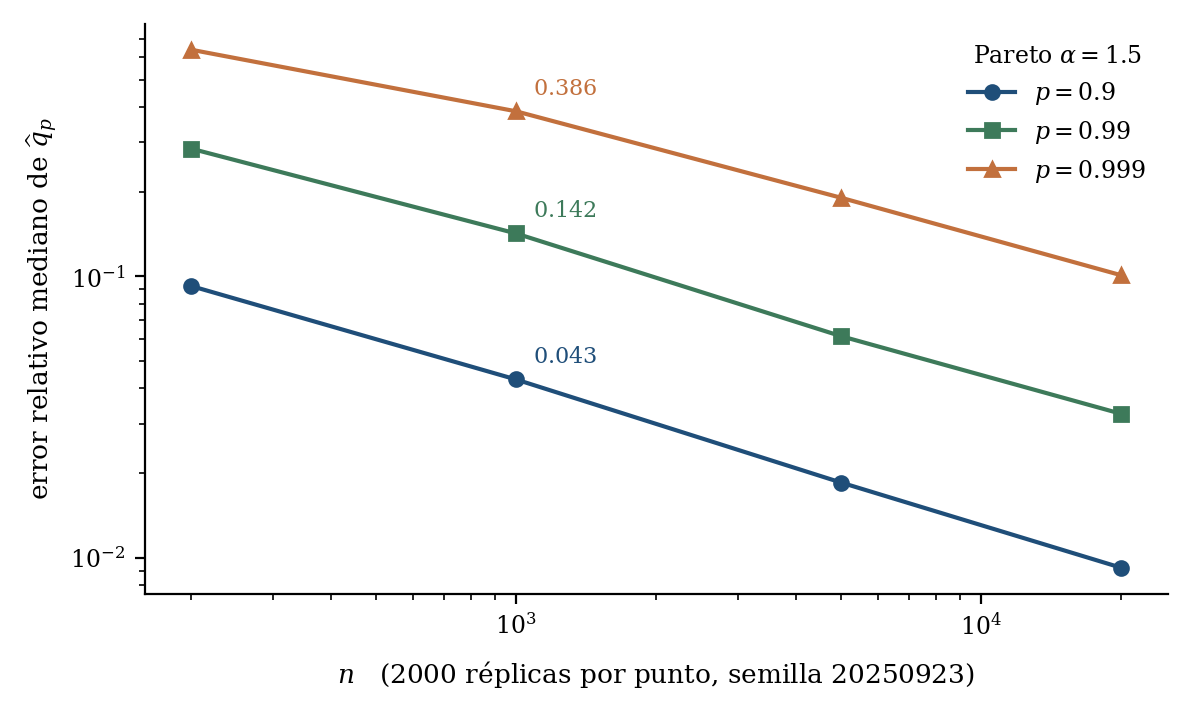
En todos los niveles, el error mediano disminuye al aumentar .
Para un mismo tamaño de muestra, sin embargo, el cuantil 0.999 es mucho menos estable que el 0.90.
Con , la mediana del error relativo del cuantil 0.999 supera ampliamente la del cuantil 0.90.
La simulación reproduce la estructura prevista por la teoría de estadísticos de orden.
88.13. La muestra tiene una frontera observacional
Sea
Si las observaciones son i.i.d. con CDF ,
La mediana del máximo satisface
Entonces la probabilidad de cola correspondiente es
Para grande,
Por tanto, el máximo típico de una muestra vive aproximadamente en una región con probabilidad de cola de orden
Esta relación da una escala natural para distinguir observación de extrapolación.
88.14. Máximos exponenciales y Pareto
Para la exponencial,
Asintóticamente crece de forma logarítmica con .
Para Pareto,
Asintóticamente crece como
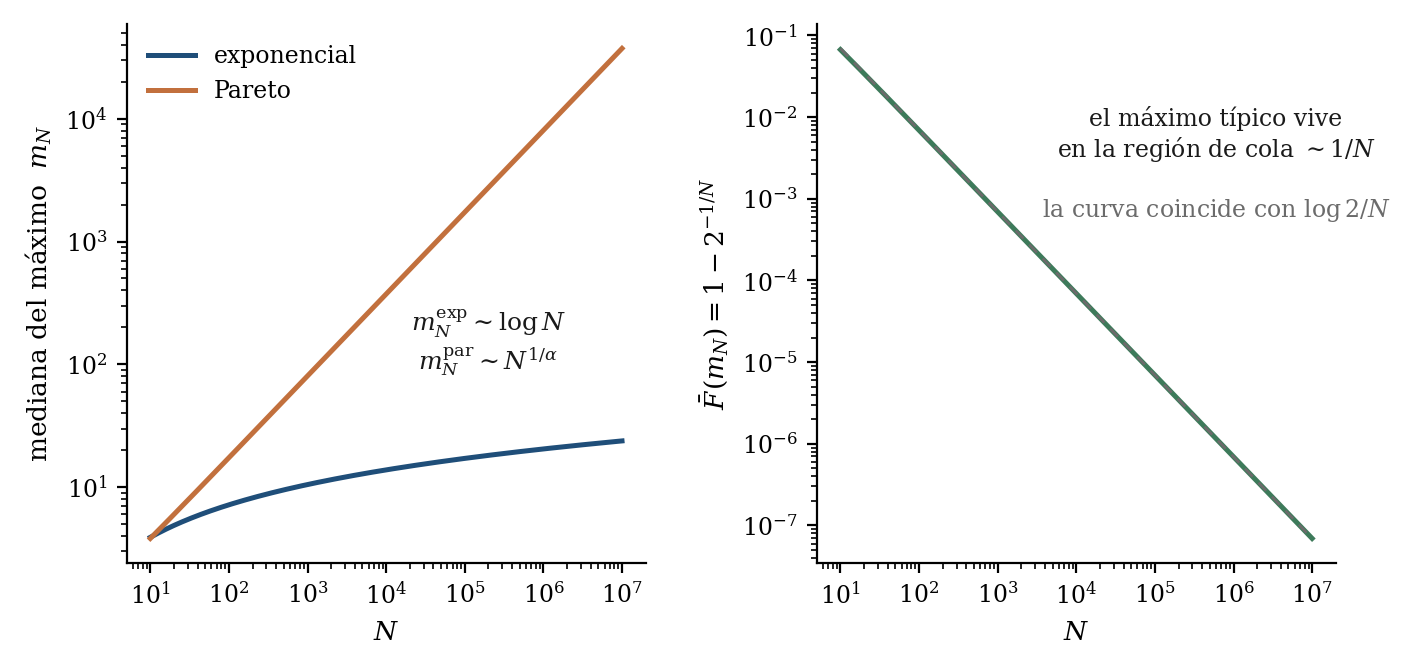
El tamaño del máximo observado depende del tamaño muestral y no es una propiedad fija de la distribución.
Comparar máximos de estudios con muy diferentes sin ajustar por exposición puede inducir conclusiones erróneas sobre la cola.
88.15. Extrapolar significa ir donde casi no hubo observaciones
Supongamos una muestra de tamaño y queremos estimar el cuantil asociado a
El número esperado de observaciones más allá de ese cuantil es
En otras palabras, una muestra típica contiene cero observaciones directas en esa región.
Cualquier estimación de ese cuantil depende entonces de la forma paramétrica o semiparamétrica que extrapolamos desde regiones menos extremas. La cifra resultante queda lejos de ser una interpolación entre puntos observados.
88.16. Incluso bajo el modelo correcto existe incertidumbre de extrapolación
El paquete genera muestras desde una Pareto verdadera con y conocido.
Para una muestra de tamaño
el estimador de máxima verosimilitud es
Como tiene un pequeño sesgo finito, el experimento utiliza también
cuya media coincide con en este caso ideal.
Después se extrapola
El cuantil verdadero es aproximadamente
Aun con el modelo correcto, conocido y mil observaciones, el intervalo central del 90 % de las extrapolaciones simuladas va aproximadamente desde hasta
No existe error de especificación en este experimento. La amplitud proviene solo de incertidumbre en el parámetro de cola.
88.17. La extrapolación amplifica pequeños errores del exponente
Para Pareto,
Tomando logaritmos,
Derivando respecto de ,
Como
la magnitud de la sensibilidad crece cuando disminuye.
Para
Una pequeña incertidumbre en puede convertirse en una incertidumbre relativa mucho mayor en el cuantil extrapolado.
Cuanto más lejos extrapolamos, más domina el supuesto de cola.
88.18. El máximo observado no es un límite físico
Si en una muestra el mayor valor es no podemos concluir
Bajo una distribución no acotada, la probabilidad de superar sigue siendo positiva.
El propio hecho de que sea el máximo observado implica solamente que, en esas realizaciones, ningún valor mayor apareció.
La distribución uniforme de C84 era diferente, porque allí el límite superior pertenecía al soporte especificado por el modelo.
Confundir máximo muestral con límite del soporte transforma una ausencia finita de observaciones en una afirmación estructural injustificada.
88.19. La ausencia de extremos también tiene probabilidad
Si un evento tiene probabilidad de cola la probabilidad de no observarlo en realizaciones independientes es
Para
Por tanto, no ver un evento muy raro es exactamente lo esperado.
Esta es la razón probabilística por la que una muestra finita no puede validar de manera directa extrapolaciones muy profundas en la cola.
Podemos evaluar consistencia con regiones observadas y comparar modelos, pero las probabilidades mucho menores que dependen necesariamente de estructura adicional.
88.20. Cuantiles y riesgo no son lo mismo que probabilidad de excedencia
La probabilidad de exceder un umbral fijo es
El cuantil invierte la pregunta:
Ambas representaciones contienen la misma información si es conocida y estrictamente creciente.
En aplicaciones, sin embargo, la incertidumbre estadística puede comportarse de manera diferente porque un problema fija y el otro debe inferir la posición correspondiente a una probabilidad.
Cuando los extremos importan conviene expresar los resultados en ambos lenguajes, como probabilidad de excedencia de umbrales físicamente relevantes y como niveles alcanzados por cuantiles de interés.
Esto evita que una única métrica oculte qué aspecto de la cola se está interpretando.
88.21. Cuantiles son invariantes ante transformaciones monótonas
Si y es estrictamente creciente,
Esto hace a los cuantiles naturales para variables positivas transformadas.
Por ejemplo, si como en C85,
No ocurre lo mismo con la media:
Los cuantiles respetan transformaciones monótonas porque preservan el orden de las realizaciones.
Esta propiedad facilita comunicar posiciones relativas en escalas transformadas, aunque no resuelve por sí sola el problema de estimar cuantiles extremos.
88.22. Robustez central no equivale a precisión extrema
La mediana tiene una conocida resistencia frente a valores muy extremos, porque alterar una pequeña fracción de observaciones enormes no necesariamente cambia mucho la posición central.
Un cuantil alto, en cambio, está diseñado para responder a la región superior.
El cuantil 0.99 depende de las mayores observaciones; el 0.999 depende todavía más.
Por tanto, decir que «los cuantiles son robustos» requiere especificar cuáles.
Los cuantiles centrales pueden ser mucho más estables que la media bajo colas pesadas. Los cuantiles extremos son sensibles porque están estimando directamente la parte menos poblada de la distribución.
Robustez ante magnitud extrema y cantidad de información disponible son propiedades distintas.
88.23. Una recta log-log no basta para declarar Pareto
C79 mostró que una relación curva puede parecer lineal en un intervalo finito.
La misma cautela se aplica a colas.
Una cola Pareto exacta produce
Observar una región aproximadamente recta en un gráfico log-log, sin embargo, no demuestra que la ley continúe indefinidamente.
Distribuciones lognormales, Weibull con ciertos parámetros y mezclas pueden imitar una pendiente casi lineal dentro de rangos limitados.
La evaluación debería incluir el umbral utilizado, sensibilidad de la pendiente, alternativas plausibles y rango dinámico disponible.
Extrapolar una recta más allá de la mayor observación multiplica las consecuencias de cualquier curvatura no detectada.
88.24. El umbral crea un compromiso
En análisis de extremos suele elegirse un umbral y modelarse el exceso condicionado a
Un umbral alto concentra el análisis en la cola relevante, pero deja pocas observaciones.
Un umbral más bajo aporta más datos, aunque aumenta el riesgo de incluir una región que aún no sigue el régimen asintótico de cola.
Existe por tanto un compromiso entre:
y
Este problema es análogo al rango de escala de C79. Seleccionar retrospectivamente el umbral que produce la cola más convincente puede introducir el mismo tipo de razonamiento circular.
88.25. Aproximación de Pareto generalizada en excesos
Un resultado central de teoría de valores extremos, asociado a Balkema–de Haan y Pickands, establece que para una clase amplia de distribuciones la distribución de excesos por encima de un umbral suficientemente alto puede aproximarse mediante una Pareto generalizada.
Su función de supervivencia puede escribirse como
en el soporte donde
El caso límite
produce una cola exponencial.
Si
aparece una cola de potencia.
Si
la distribución tiene un extremo superior finito.
Esta familia da un lenguaje unificado para diferentes regímenes de cola, pero no elimina el problema de seleccionar el umbral ni de estimar parámetros con pocos extremos.
88.26. Teoría de extremos no crea información inexistente
La teoría de valores extremos aporta límites y modelos especializados para colas, aunque no puede convertir diez observaciones extremas en miles.
Una extrapolación a una probabilidad desde una muestra de mil observaciones puede estar matemáticamente definida, pero la información empírica directa en esa región es prácticamente nula.
Su credibilidad depende de la validez del régimen de cola, de la estabilidad del parámetro respecto del umbral, de la independencia o dependencia de los extremos, de la calidad de medición de los valores mayores y de la plausibilidad de extrapolar la familia elegida. Un número calculable puede quedar mal identificado por los datos.
88.27. Dependencia entre extremos
Hasta ahora los argumentos de máximos utilizaron observaciones independientes.
En series temporales, eventos extremos pueden agruparse.
Si una tormenta, crisis o episodio dinámico produce varios valores consecutivos grandes, contar cada punto como un extremo independiente sobrestima la cantidad de información sobre la cola.
El tamaño nominal de la muestra ya no coincide con el número efectivo de oportunidades independientes para extremos.
Este problema es análogo a la dependencia en C86 y C87. La cola no elimina la necesidad de modelar estructura temporal.
La teoría de extremos dependientes introduce conceptos específicos, como agrupamiento y extremal index, que quedan fuera de este capítulo.
88.28. Extrapolación y cambio de régimen
Una dificultad mayor es que la distribución futura puede no conservar la misma cola.
Si el mecanismo generador cambia para valores muy grandes, extrapolar desde la región moderada puede fallar aunque la estimación estadística dentro de esa región sea impecable.
Puede intervenir una saturación física, la ruptura de un material, un cambio de política, un límite de capacidad, un mecanismo protector o una transición dinámica.
En esos casos, la cola estadística observada antes del cambio no contiene por sí sola la nueva dinámica.
El problema pasa a ser de incertidumbre estructural sobre si la misma ley continúa siendo aplicable, más allá de la incertidumbre paramétrica.
88.29. Un cuantil no describe qué ocurre después de cruzarlo
El cuantil localiza un umbral. No informa cuánto pueden superar ese umbral las observaciones que quedan en la cola.
Dos distribuciones pueden tener el mismo y distribuciones de excedencias muy diferentes.
Una cantidad complementaria es la media condicional por encima del cuantil:
cuando existe.
En aplicaciones de riesgo suele relacionarse con el concepto de expected shortfall o media de cola. Su utilidad conceptual aquí es mostrar que la frecuencia de excedencia y la severidad del excedente son dimensiones distintas.
Para una exponencial, por falta de memoria,
El exceso medio sobre es constante:
Para una Pareto con ,
Por tanto,
El exceso medio crece linealmente con el umbral.
La diferencia es de fondo. En la exponencial, alcanzar un nivel más alto no cambia la escala esperada del exceso restante. En Pareto, cuanto mayor es el umbral ya superado, mayor es también el exceso medio esperado. Una sola cifra de cuantil no contiene esa estructura.
88.30. La función de exceso medio como diagnóstico de cola
Definamos la función de exceso medio
Para la exponencial,
Es horizontal.
Para Pareto,
Es creciente y lineal.
Esta propiedad da otra forma de observar la diferencia entre colas.
En datos empíricos podemos calcular
si existen observaciones por encima de .
La estimación, en cambio, se vuelve progresivamente más inestable al elevar el umbral, porque el denominador contiene cada vez menos observaciones.
Un gráfico de exceso medio puede sugerir estructura de cola, pero no prueba por sí solo que la distribución sea Pareto o exponencial. Los mismos problemas de selección de umbral y rango finito de C79 reaparecen aquí.
La cola admite múltiples diagnósticos, todos dependientes de cuántos datos sobreviven al corte.
88.31. Los periodos de retorno como traducción con supuestos fuertes
Una probabilidad de excedencia
se traduce a veces en un periodo de retorno
Si cada periodo es una oportunidad independiente con la misma probabilidad, un evento con tiene un tiempo de espera geométrico medio de periodos.
Esta frase suele malinterpretarse.
«Periodo de retorno de 100 años» no significa que el evento ocurra exactamente una vez cada 100 años ni que, después de observarlo hoy, exista una protección de 99 años.
Bajo independencia y estacionariedad,
Si
y es pequeño,
Por tanto, durante una ventana igual al periodo de retorno medio existe alrededor de un 63 % de probabilidad de observar al menos una excedencia, lejos del 100 %.
Si hay dependencia temporal o no estacionariedad, incluso esta interpretación necesita modificación.
88.32. Transformar la escala puede revelar o esconder la cola
C85 mostró que las transformaciones cambian distribuciones.
Para una Pareto,
Definamos
Entonces, para ,
Sustituyendo la cola Pareto,
Por tanto,
Una cola de potencia en escala original se convierte en una cola exponencial en escala logarítmica.
Lo que cambia es la variable que estamos modelando, sin que la cola pesada del fenómeno original desaparezca.
La observación es útil por dos razones. Primero, explica por qué ciertos estimadores de cola Pareto utilizan logaritmos de razones. Segundo, muestra que palabras como «exponencial» o «potencia» deben vincularse siempre con la escala de la variable.
Una transformación no lineal puede convertir una cola aparentemente extrema en una distribución mucho más regular, o viceversa.
88.33. Una disciplina práctica para extrapolar
Una extrapolación de cola debería declarar al menos cinco elementos.
El primero es el umbral o rango desde el cual se ajustó la cola. El segundo es el número de observaciones efectivamente utilizadas en esa región. El tercero es la familia de cola asumida, junto con las alternativas razonables.
El cuarto es cuánto más allá del máximo observado se encuentra la cantidad solicitada. Una probabilidad de cola estimada desde implica una extrapolación a una región con apenas excedencias esperadas en la muestra original.
El quinto es la sensibilidad a los parámetros y a las decisiones de umbral.
Una estrategia útil es presentar una escalera de extrapolación, donde junto al cuantil más remoto se muestran resultados para
Si las distintas familias candidatas producen resultados similares cerca de la región observada y divergen progresivamente fuera de ella, el lector puede ver dónde comienza a dominar el supuesto de modelo.
Esta presentación separa dos fuentes de incertidumbre que suelen mezclarse:
y
La primera puede disminuir con más datos bajo el mismo régimen. La segunda requiere evidencia sobre si la forma de cola continúa siendo válida.
88.34. Verificación computacional
El paquete reproducible utiliza exponencial y Pareto con mediana exactamente uno.
Comprueba las fórmulas de cuantiles y muestra que, para probabilidad de cola el cuantil exponencial es aproximadamente y el Pareto aproximadamente .
Para la Pareto con verifica que el primer momento truncado converge hacia la media finita mientras el segundo momento crece al aumentar el corte superior.
Las simulaciones de cuantiles empíricos confirman que el error disminuye con el tamaño muestral y aumenta al avanzar desde hacia .
El código deriva la mediana del máximo mediante y verifica por simulación los resultados para .
Finalmente, genera 4000 muestras Pareto de tamaño , estima y extrapola el cuantil de cola . Aunque el modelo está correctamente especificado, el rango central del 90 % de las estimaciones se extiende aproximadamente de a , alrededor de un valor verdadero cercano a .
Se ejecutaron 30 comprobaciones automáticas y las 30 resultaron satisfactorias.
88.35. Qué queda establecido
Las colas determinan qué tan plausibles son las observaciones extremas y cómo crecen los cuantiles cuando exigimos probabilidades cada vez menores.
Una exponencial y una Pareto pueden compartir un cuantil central y diferir por órdenes de magnitud en la cola.
Los cuantiles siguen existiendo en situaciones donde ciertos momentos divergen, pero los cuantiles extremos disponen de poca información porque solo una fracción de la muestra cae por encima de ellos.
El máximo observado en una muestra de tamaño explora de manera típica probabilidades de cola del orden de
Ir mucho más allá requiere extrapolar una estructura de cola.
Incluso bajo un modelo Pareto verdadero, pequeños errores en el exponente producen grandes diferencias en cuantiles extremadamente altos. Bajo especificación incierta, el riesgo es mayor.
La teoría de valores extremos aporta modelos adecuados para estudiar excesos, pero no elimina la necesidad de justificar umbrales, dependencia y estabilidad del régimen.
C89 continuará con el bootstrap y la variabilidad de una estimación. Allí dejaremos de asumir que podemos calcular analíticamente la distribución de un estimador y estudiaremos qué información puede recuperarse re-muestreando los datos observados, junto con los casos en que esa estrategia falla.
Referencias
- Balkema, A. A., & de Haan, L. (1974). Residual life time at great age. The Annals of Probability, 2(5), 792–804. https://doi.org/10.1214/aop/1176996548
- Clauset, A., Shalizi, C. R., & Newman, M. E. J. (2009). Power-law distributions in empirical data. SIAM Review, 51(4), 661–703. https://doi.org/10.1137/070710111
- Coles, S. (2001). An Introduction to Statistical Modeling of Extreme Values. Springer. https://doi.org/10.1007/978-1-4471-3675-0
- Embrechts, P., Klüppelberg, C., & Mikosch, T. (1997). Modelling Extremal Events for Insurance and Finance. Springer. https://doi.org/10.1007/978-3-642-33483-2
- Pickands, J. III. (1975). Statistical inference using extreme order statistics. The Annals of Statistics, 3(1), 119–131. https://doi.org/10.1214/aos/1176343003
- Resnick, S. I. (2007). Heavy-Tail Phenomena: Probabilistic and Statistical Modeling. Springer. https://doi.org/10.1007/978-0-387-45024-7
Recursos reproducibles
Descargar recursos del capítulo (ZIP, 388 kB).
6 archivos CSV · 4 figuras · 1 programa Python.
El programa se ha ejecutado en una carpeta vacía y genera los archivos de datos y figuras incluidos en el paquete.