98.1. Una distribución amplia no basta
C92 mostró que una red puede presentar gran heterogeneidad de grados. C96 enseñó que esa heterogeneidad debe compararse con una referencia. Ahora aparece una afirmación más específica:
Una red cuyo grado sigue una ley de potencia suele denominarse libre de escala.
La expresión tiene fuerza y también se utiliza con demasiada facilidad. No toda distribución amplia es una ley de potencia, no toda recta aparente en ejes log-log basta como evidencia y no toda ley de potencia implica el mismo mecanismo generador.
C98 separará tres preguntas. Qué significa matemáticamente una cola de potencia, qué mecanismo puede producirla y qué evidencia permite sostenerla en una red finita.
98.2. Cola de potencia
Consideremos una variable de grado .
Una cola de potencia discreta ideal puede escribirse como
donde
es la función zeta de Hurwitz utilizada como constante de normalización.
El exponente debe satisfacer para que la distribución sea normalizable.
La ley se aplica únicamente por encima de un umbral
No exige que toda la distribución de grados, desde , siga la misma forma.
98.3. Qué significa «libre de escala»
La motivación del término proviene de una propiedad de escalamiento.
Si
entonces
Cambiar la escala de por un factor multiplica la densidad por otro factor, pero no introduce una escala característica nueva en la forma funcional ideal.
En una red finita, sin embargo, el grado satisface
Por tanto, ninguna red finita es literalmente invariante a todas las escalas.
La expresión «libre de escala» debe entenderse como una afirmación sobre un régimen de cola o un límite asintótico, no como ausencia absoluta de escalas físicas o finitas.
98.4. Distribución y función de supervivencia
Para una ley continua ideal
la función de supervivencia cumple aproximadamente
Por eso, si representamos la CCDF en ejes log-log, la pendiente esperada es no
Esta diferencia se olvida con frecuencia al leer gráficos.
En el caso discreto aparecen correcciones de suma, especialmente cerca de
La forma asintótica se vuelve más precisa a grados grandes.
98.5. Momentos y exponente
Las leyes de potencia tienen relaciones directas entre exponente y existencia de momentos.
En la versión continua ideal:
es finita si
mientras
es finita si
Para la media existe pero la varianza asintótica diverge.
En una red finita, la varianza muestral siempre será un número finito porque existe un grado máximo.
La cuestión es si ese valor se estabiliza al aumentar el tamaño de la red o continúa creciendo debido a la cola.
98.6. La referencia Erdős–Rényi
Construiremos dos redes con
y grado medio cercano a seis.
La primera será Barabási–Albert con nuevas aristas por nodo incorporado.
La segunda será Erdős–Rényi con probabilidad elegida para igualar aproximadamente el mismo grado medio.
En la red BA reproducible:
En la red ER:
Los promedios son casi iguales.
Las colas no.
98.7. Misma media, heterogeneidad radicalmente distinta
La varianza del grado BA es aproximadamente
En la red ER es aproximadamente
El grado máximo BA alcanza
El máximo ER es solo
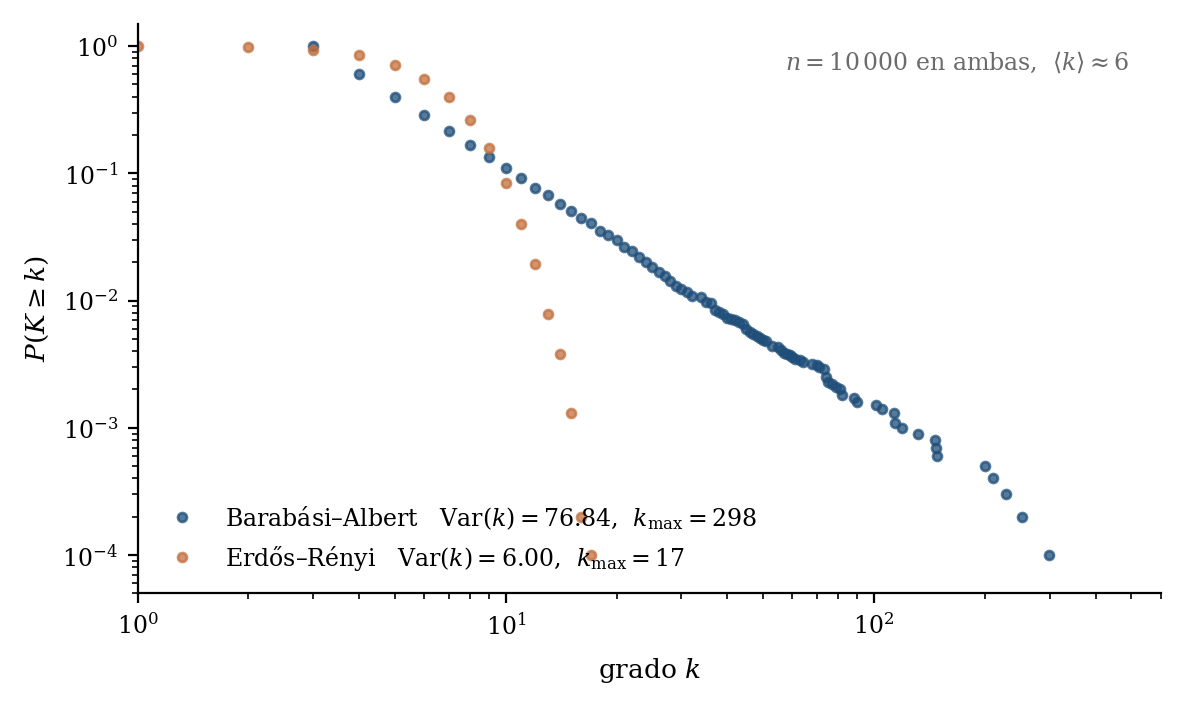
La comparación muestra por qué un único grado medio es insuficiente.
Eso todavía no demuestra que la red BA siga una Pareto exacta.
98.8. El mecanismo de enlace preferencial
El modelo de Barabási–Albert combina dos ingredientes.
El primero es el crecimiento, ya que nuevos nodos se incorporan progresivamente. El segundo es el enlace preferencial, donde la probabilidad de conectarse a un nodo existente resulta proporcional a su grado:
Los nodos que ya tienen más conexiones reciben, en promedio, más enlaces nuevos.
Este mecanismo produce una retroalimentación de ventaja acumulativa.
No significa que el nodo de mayor grado reciba siempre la siguiente arista.
La regla es probabilística.
98.9. Conservación del grado total
Si cada nuevo nodo añade aristas, cada arista incrementa el grado total en dos.
Tras muchas incorporaciones,
ignorando una constante asociada a la condición inicial.
Entonces la tasa esperada de crecimiento de un nodo puede aproximarse por
El parámetro desaparece de la ecuación diferencial de crecimiento relativo.
98.10. Crecimiento del grado de un nodo
Resolviendo
obtenemos
Integrando desde el tiempo de llegada :
Como un nodo entra aproximadamente con
resulta
Los nodos antiguos disponen de más tiempo para acumular conexiones.
98.11. De tiempos de llegada a distribución de grados
La desigualdad
equivale aproximadamente a
Si los tiempos de llegada están aproximadamente distribuidos de manera uniforme entre los nodos, la fracción con grado al menos satisface
Por tanto,
La densidad correspondiente tiene exponente
Esta es la derivación de continuo clásica del resultado BA.
98.12. La distribución BA exacta se aparta de una Pareto pura
Para el modelo BA estándar, la distribución estacionaria discreta puede escribirse asintóticamente en tamaño como
Para grados grandes,
y entonces
La distinción es crucial.
El modelo tiene una cola asintótica de potencia con exponente tres, pero su distribución finita sobre grados bajos no es exactamente
98.13. Por qué una realización finita no tiene que devolver
En la simulación de 10.000 nodos, un ajuste Pareto discreto que permite elegir
por distancia KS selecciona
y estima
Eso no refuta la derivación asintótica.
El ajuste está intentando representar mediante una Pareto pura todo el soporte desde el grado mínimo BA.
Precisamente allí las correcciones respecto de son más importantes.
98.14. El exponente se aproxima a tres al elevar
El paquete calcula el ajuste para varios umbrales.
Algunos resultados son:
El exponente se aproxima al valor asintótico esperado.
El número de observaciones en la cola, en cambio, disminuye.
En
hay 10.000 nodos.
En
quedan 789.
Aparece el mismo compromiso de C88 entre aproximación asintótica y cantidad de datos.
98.15. Elegir
Un umbral demasiado bajo incluye una región que puede no seguir la ley de potencia asintótica.
Uno demasiado alto deja pocos datos y aumenta la incertidumbre.
Una estrategia común selecciona
minimizando una discrepancia, por ejemplo la distancia de Kolmogórov–Smirnov entre distribución empírica y modelo ajustado.
Eso no elimina la necesidad de evaluar el ajuste.
La selección del umbral utiliza los mismos datos y forma parte del procedimiento inferencial.
No debe ocultarse.
98.16. Máxima verosimilitud discreta
Para datos
con
la log-verosimilitud de la Pareto discreta es
El estimador de máxima verosimilitud es el valor de que maximiza esta expresión.
A diferencia de una regresión lineal sobre un histograma, la verosimilitud trabaja directamente con las observaciones discretas y con la normalización correcta del modelo.
98.17. Por qué no usar una regresión log-log como prueba
Un procedimiento antiguo consiste en construir un histograma, tomar logaritmos de ambos ejes, ajustar una recta por mínimos cuadrados y reportar el .
Este método tiene varios problemas. Los bins del histograma tienen varianzas muy diferentes, los puntos no son observaciones independientes con error homocedástico y los bins vacíos desaparecen bajo el logaritmo. La elección del rango, además, puede decidir la pendiente.
Un alto demuestra linealidad aproximada en el gráfico utilizado, sin acreditar que los datos hayan sido generados por una ley de potencia.
98.18. Preferir CCDF para inspección visual
La función de supervivencia empírica evita escoger bins arbitrarios.
También conserva información en la cola de forma más estable que un histograma con pocos conteos.
Por eso las figuras reproducibles utilizan CCDF.
Sin embargo, la CCDF tampoco convierte una inspección visual en prueba estadística. Es una herramienta de diagnóstico. La inferencia necesita un modelo explícito, estimación y comparación.
98.19. Ajuste de la cola BA
La figura superpone la CCDF BA y la Pareto discreta ajustada a partir del seleccionado.
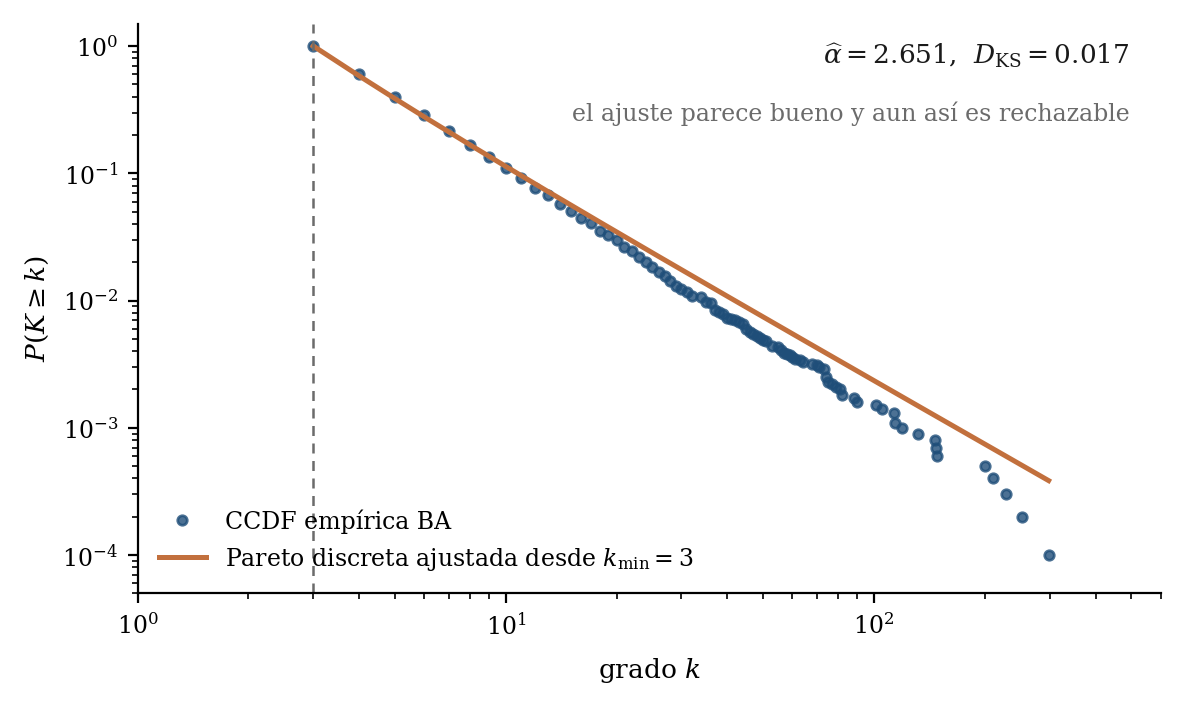
La distancia KS es pequeña:
Visualmente, el ajuste parece muy bueno.
Sin embargo, con 10.000 observaciones incluso discrepancias pequeñas pueden ser sistemáticas.
La pregunta correcta es si la magnitud de la discrepancia resulta compatible con muestras generadas realmente desde el modelo ajustado, más que si la curva «se ve recta».
98.20. Bootstrap de bondad de ajuste
El paquete realiza un control condicional sencillo.
Fija el elegido, genera muestras sintéticas desde la Pareto discreta ajustada, reestima y recalcula la distancia KS.
La probabilidad empírica de obtener una discrepancia igual o mayor que la observada es aproximadamente
Bajo este procedimiento, la Pareto discreta exacta es una descripción insuficiente de toda la cola desde
Este resultado es compatible con conocer de antemano que el BA finito sigue una forma discreta más específica y solo es asintóticamente .
98.21. El mecanismo puede ser correcto y el modelo estadístico simplificado, incorrecto
Este punto merece quedar explícito.
Sabemos cómo fue generada la red:
También sabemos que la teoría predice una cola asintótica de potencia.
Aun así, una prueba de una Pareto pura exacta puede rechazar. No hay contradicción, porque las afirmaciones son distintas:
no equivale a
La inferencia estadística debe corresponder a la precisión de la afirmación teórica.
98.22. Comparar con una cola exponencial
Una buena práctica pregunta si la ley de potencia ajusta y además la compara con explicaciones rivales.
El paquete ajusta, sobre el mismo rango de cola, una distribución exponencial discreta de la forma geométrica desplazada:
Después compara log-verosimilitudes punto por punto.
En BA, la diferencia total favorece ampliamente la ley de potencia:
La cola exponencial es claramente demasiado ligera.
98.23. Una conclusión más precisa para BA
Los resultados conjuntos permiten una formulación informativa. La cola BA es mucho más amplia que una exponencial y una ley de potencia describe bien su forma general, con un exponente que se aproxima a tres al elevar el umbral. Una Pareto discreta exacta desde el grado mínimo resulta, en cambio, estadísticamente imperfecta. El grado máximo queda limitado por el tamaño finito.
Esto es más preciso que clasificar la red mediante una etiqueta binaria.
La teoría del mecanismo y el diagnóstico finito se complementan.
98.24. La red Erdős–Rényi como contraste
La red ER tiene prácticamente el mismo grado medio.
Su grado máximo es
La varianza es aproximadamente
Si intentamos forzar una cola de potencia, el algoritmo selecciona
y lleva el exponente al límite superior de búsqueda, cercano a
Además, la comparación de verosimilitud favorece la cola exponencial:
La diferencia entre BA y ER no depende únicamente de que uno tenga un nodo de grado alto.
Toda la estructura de la cola es distinta.
98.25. Distribución amplia y ley de potencia son afirmaciones diferentes
Podemos construir distribuciones muy heterogéneas que no sean Pareto.
Una lognormal puede producir valores que abarcan varios órdenes de magnitud.
Una Weibull estirada puede generar colas amplias.
Mezclas de subpoblaciones pueden producir curvaturas lentas.
Incluso una distribución con corte exponencial puede parecer recta antes de que el corte sea visible.
Por eso:
es una descripción cualitativa,
mientras
es una afirmación funcional específica.
98.26. El ejemplo lognormal
El paquete genera aproximadamente 30.000 observaciones discretizadas desde una lognormal.
En la ventana la CCDF en ejes log-log admite una recta con
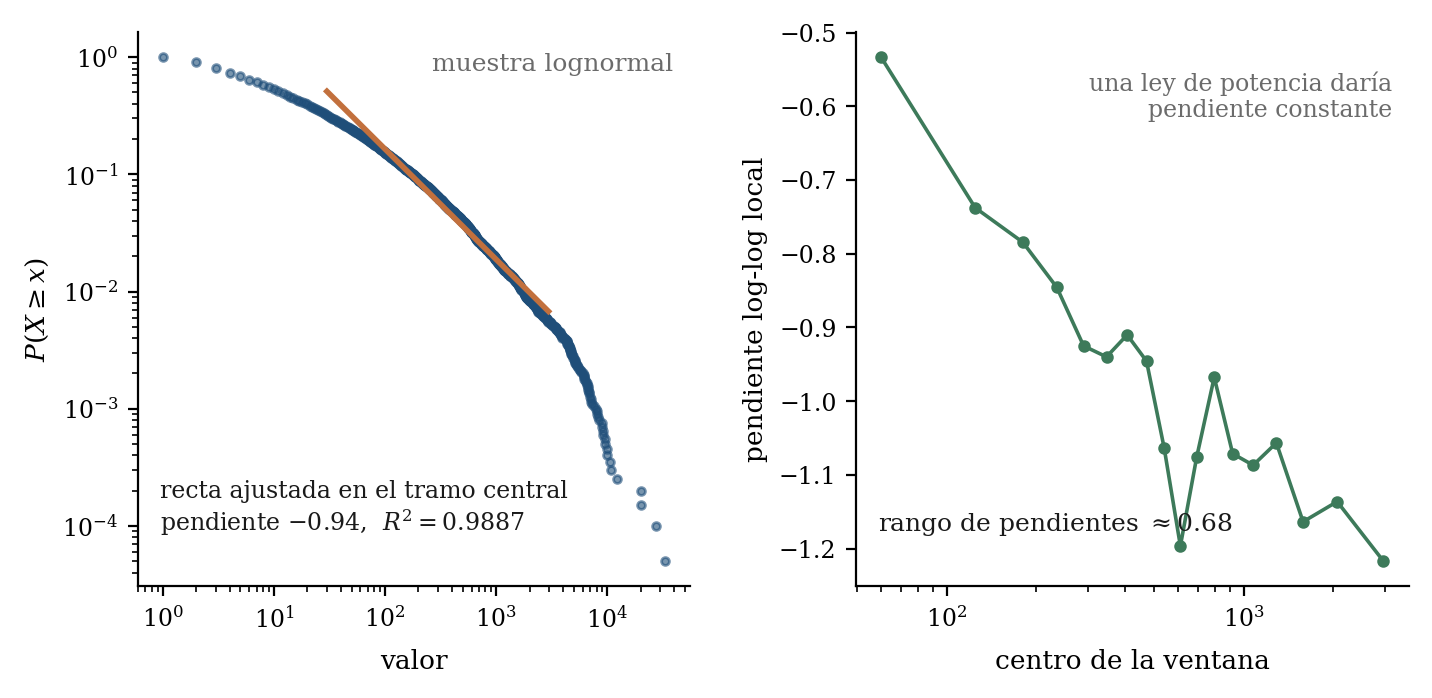
Si seleccionáramos retrospectivamente solo esa región, sería fácil describirla como «casi perfectamente lineal».
Sabemos, sin embargo, que por construcción los datos son lognormales.
El no identifica la familia generadora.
98.27. La pendiente local revela curvatura
Una ley de potencia pura produce una pendiente log-log aproximadamente constante dentro de su régimen.
En la muestra lognormal, calculamos pendientes locales sobre ventanas móviles.
El rango entre ellas es aproximadamente
La pendiente cambia sistemáticamente a medida que avanzamos por la cola.
Esa curvatura puede quedar oculta si se resume todo el intervalo con una sola recta.
Este control es análogo al análisis de pendientes locales utilizado en C79 para leyes de escala fractales.
98.28. El ajuste frente a una alternativa es condición insuficiente
Que una ley de potencia supere a una exponencial no demuestra que sea la mejor descripción posible.
Podría perder frente a una lognormal, una Weibull estirada, una Pareto con corte exponencial u otra distribución pesada.
Una metodología rigurosa separa dos preguntas. Si la ley de potencia es compatible con los datos. Después, cuál de los modelos plausibles recibe mayor apoyo relativo. Aceptar una y omitir la otra puede producir conclusiones exageradas.
98.29. Corte por tamaño finito
En una red de nodos,
Por tanto, toda distribución de grado empírica tiene un corte absoluto.
Además, incluso antes de ese máximo físico, la muestra finita limita cuántos nodos pueden ocupar la cola.
En una ley de potencia con exponente , una estimación heurística del máximo típico se obtiene imponiendo aproximadamente
Como
resulta
98.30. El caso BA predice raíz cuadrada
Para
la expresión anterior da
El paquete genera redes BA para tamaños desde
hasta
Ajustando la mediana del grado máximo contra en log-log obtenemos una pendiente aproximada de
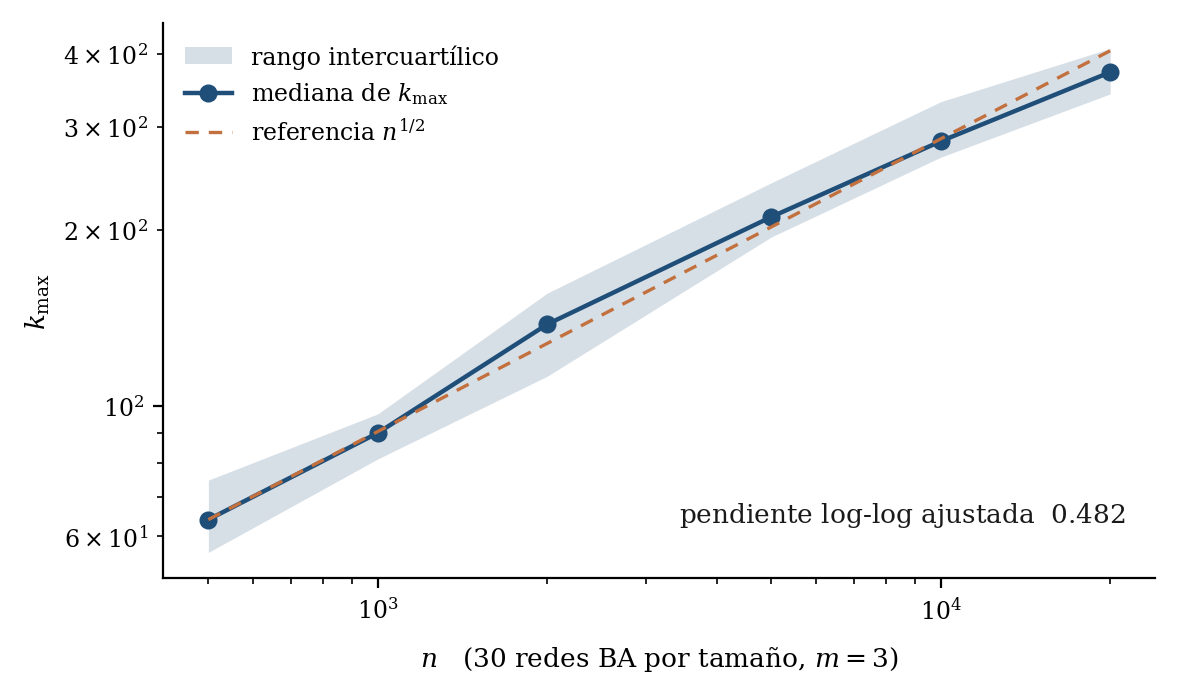
El resultado reproduce la escala teórica esperada.
98.31. El máximo depende del tamaño de la red
En las redes simuladas, el grado máximo mediano aumenta aproximadamente desde
para
hasta
para
Comparar entre redes de tamaños distintos sin normalización puede ser engañoso.
Una red mayor dispone de más oportunidades para producir nodos extremos.
La misma cautela apareció en C88 con máximos muestrales de distribuciones de cola amplia.
La teoría de extremos y la teoría de redes comparten aquí una estructura común.
98.32. Otras vías hacia colas de potencia
Observar una cola compatible con una ley de potencia no identifica automáticamente enlace preferencial.
Otros mecanismos pueden producir distribuciones similares, entre ellos la optimización bajo restricciones, los procesos multiplicativos, la mezcla de tasas, la duplicación con divergencia o la competencia y el crecimiento con aptitudes heterogéneas.
Incluso dentro de la familia de enlace preferencial, cambiar la regla modifica el exponente o introduce cortes.
Por tanto:
La inferencia de mecanismo necesita predicciones adicionales.
98.33. Enlace preferencial lineal es una hipótesis específica
El BA estándar utiliza
Podríamos generalizar a
El caso es lineal.
Si la ventaja acumulativa es sublineal y la distribución resultante cambia.
Si puede aparecer condensación, donde unos pocos nodos capturan una fracción macroscópica de enlaces.
Así, «preferencia por nodos conectados» tampoco especifica un modelo completo.
La función de preferencia debe cuantificarse.
98.34. Atractividad inicial
Otra extensión reemplaza por con una atractividad basal .
Entonces incluso nodos de grado pequeño pueden recibir enlaces con una tasa adicional.
Esta modificación cambia el exponente de la distribución resultante.
Por tanto, medir una cola no solo debería preguntar si existe enlace preferencial, sino qué regla de adquisición de enlaces es compatible con los datos longitudinales.
La estructura final no identifica unívocamente la dinámica de crecimiento.
98.35. Aptitud heterogénea
Podemos asignar a cada nodo una aptitud
y utilizar
Entonces dos nodos con el mismo grado pueden tener probabilidades diferentes de recibir el siguiente enlace.
La heterogeneidad de grado resultante combina historia acumulada y diferencias intrínsecas.
En redes reales, popularidad, visibilidad, localización o recursos pueden introducir esa clase de heterogeneidad.
Un modelo BA puro atribuye toda la ventaja a , lo que constituye una hipótesis fuerte.
98.36. Envejecimiento y costos pueden truncar la cola
Si la capacidad de recibir nuevos enlaces disminuye con la edad del nodo o si mantener muchos vínculos tiene un costo, la ventaja acumulativa puede frenarse.
La distribución resultante puede parecer Pareto durante un rango y después mostrar un corte.
En una red finita, distinguir corte estructural de corte por tamaño requiere suficiente rango dinámico.
La ausencia de grados enormes no refuta automáticamente una tendencia de potencia.
Tampoco debería ignorarse, sin embargo, ajustando una recta únicamente donde la cola parece conveniente.
98.37. Muestreo de nodos
Supongamos que la red real contiene hubs.
Si nuestro procedimiento de observación omite nodos con baja actividad, la distribución observada cambia.
Si, por el contrario, reclutamos unidades siguiendo enlaces, los nodos de grado alto quedan sobrerrepresentados, como mostró C92.
El mecanismo de muestreo puede fabricar o distorsionar una cola.
La distribución de grado observada no debe tratarse automáticamente como una muestra i.i.d. de una distribución poblacional abstracta.
Los grados están además estructuralmente vinculados por el propio grafo.
98.38. Muestreo de aristas
Eliminar aleatoriamente aristas reduce grados.
Si la probabilidad de observar una arista depende del grado, del peso o del tipo de nodo, la distorsión puede ser aún mayor.
Un hub con muchas conexiones débiles podría perder proporcionalmente más vínculos que uno con menos conexiones fuertes bajo un umbral de detección.
Por eso comparar exponentes entre estudios exige revisar cómo se construyó cada red.
Una diferencia de puede reflejar medición y no un mecanismo distinto.
98.39. Binarización de pesos
C91 mostró que convertir pesos en aristas mediante un umbral modifica la topología.
En una red ponderada, distintos umbrales producen distintas distribuciones de grado.
Una afirmación de «red libre de escala» sobre la versión binaria debería declarar el umbral.
Idealmente, debería evaluar sensibilidad a alternativas razonables.
Si el supuesto régimen de potencia aparece únicamente para un umbral retrospectivamente elegido, la evidencia es débil.
La construcción de la red precede a la inferencia sobre su cola.
98.40. Independencia estadística y grados de una red
Las fórmulas de máxima verosimilitud tratan los grados como observaciones de una distribución.
En un grafo, en cambio, los grados no son estrictamente independientes.
La suma debe satisfacer
y la estructura de aristas induce otras dependencias.
Los procedimientos clásicos de ajuste de distribuciones de grado suelen utilizar una aproximación marginal.
En análisis exigentes conviene reconocer esta limitación y, cuando sea necesario, utilizar modelos generativos de red completos en vez de una distribución marginal aislada.
98.41. Qué debería significar una afirmación empírica fuerte
Una afirmación razonable va mucho más allá de sostener que la red es libre de escala porque el gráfico log-log es recto.
Debería especificar:
- qué variable de grado se analizó;
- si la red es dirigida y qué grado se usa;
- ;
- número de nodos en la cola;
- estimador de ;
- bondad de ajuste;
- alternativas comparadas;
- sensibilidad a umbral y muestreo;
- límites por tamaño finito.
La conclusión debe corresponder a la fuerza de la evidencia.
También conviene reportar cuántos grados distintos existen dentro de la cola y cuántos órdenes de magnitud cubre el rango útil. Un ajuste con cientos de nodos concentrados entre y no proporciona la misma información sobre escalamiento que otro que mantiene apoyo desde hasta . El tamaño de muestra y el rango dinámico son dimensiones diferentes de evidencia. Muchos datos dentro de un intervalo estrecho pueden estimar con precisión una forma local sin demostrar que esa forma persista a escalas más amplias. La afirmación «libre de escala» necesita, por tanto, tanto cantidad de observaciones como extensión suficiente del régimen de cola.
98.42. Una clasificación más informativa que sí/no
En redes empíricas puede ser útil distinguir varios niveles de afirmación, ordenados de menor a mayor exigencia.
El primero es la cola amplia, donde la heterogeneidad excede claramente las referencias ligeras. El segundo es la compatibilidad con una ley de potencia en un rango, cuando el modelo no resulta rechazado y dispone de suficiente extensión. El tercero es la ley de potencia favorecida frente a alternativas concretas, sostenido por la comparación relativa. El cuarto es la evidencia de un mecanismo de enlace preferencial, que exige además datos o predicciones sobre la formación de aristas.
Estas afirmaciones no son intercambiables y cada una necesita evidencia adicional.
98.43. Debate empírico sobre cuántas redes son realmente libres de escala
La literatura reciente ha mostrado que la clasificación de redes reales depende fuertemente de los criterios utilizados.
Broido y Clauset concluyeron, bajo criterios estadísticos estrictos, que las redes claramente compatibles con estructuras libres de escala eran menos frecuentes de lo que sugería la literatura anterior.
Voitalov y colaboradores argumentaron que definiciones demasiado rígidas pueden excluir distribuciones regularmente variantes que deberían considerarse libres de escala en un sentido matemático más amplio.
La controversia no se resuelve mirando un único gráfico. Muestra, más bien, que la definición operacional de «scale-free» forma parte del problema científico.
98.44. Verificación computacional
El paquete genera una red BA y una ER de 10.000 nodos con grado medio prácticamente idéntico.
La BA presenta:
La ER presenta:
El ajuste Pareto discreto BA selecciona
con
La ley de potencia supera ampliamente a la exponencial en log-verosimilitud, pero el bootstrap condicional produce rechazando una Pareto pura exacta sobre todo ese rango.
Al elevar , el exponente se aproxima a tres.
La red ER, en cambio, favorece la cola exponencial.
El ejemplo lognormal alcanza en una ventana log-log seleccionada, pese a no haber sido generado por una ley de potencia.
Finalmente, el crecimiento del grado máximo BA presenta una pendiente de aproximadamente frente a , coherente con la escala
Se ejecutaron 27 comprobaciones automáticas y las 27 resultaron satisfactorias.
98.45. Qué queda establecido
Una red libre de escala se asocia con una distribución de grado cuya cola presenta escalamiento de potencia.
La afirmación es más específica que decir que la red tiene grados heterogéneos.
El modelo de Barabási–Albert proporciona un mecanismo explícito de crecimiento con enlace preferencial lineal que conduce asintóticamente a
La realización finita no es una Pareto exacta en todo su soporte. La distribución BA tiene correcciones discretas y un corte asociado al tamaño.
La evidencia empírica de ley de potencia requiere más que una recta log-log. Conviene utilizar máxima verosimilitud, declarar , evaluar bondad de ajuste y comparar alternativas.
Una ley de potencia compatible tampoco identifica por sí sola enlace preferencial.
La inferencia debe separar:
y
C99 estudiará las comunidades, la modularidad y la organización intermedia. Allí cambiaremos nuevamente de escala: dejaremos la cola de grados individuales para preguntar si la red contiene grupos de nodos con más conexiones internas de las esperadas respecto de una referencia.
Referencias
- Barabási, A.-L., & Albert, R. (1999). Emergence of scaling in random networks. Science, 286(5439), 509–512. https://doi.org/10.1126/science.286.5439.509
- Broido, A. D., & Clauset, A. (2019). Scale-free networks are rare. Nature Communications, 10, 1017. https://doi.org/10.1038/s41467-019-08746-5
- Clauset, A., Shalizi, C. R., & Newman, M. E. J. (2009). Power-law distributions in empirical data. SIAM Review, 51(4), 661–703. https://doi.org/10.1137/070710111
- Newman, M. E. J. (2005). Power laws, Pareto distributions and Zipf's law. Contemporary Physics, 46(5), 323–351. https://doi.org/10.1080/00107510500052444
- Voitalov, I., van der Hoorn, P., van der Hofstad, R., & Krioukov, D. (2019). Scale-free networks well done. Physical Review Research, 1, 033034. https://doi.org/10.1103/PhysRevResearch.1.033034
Recursos reproducibles
Descargar recursos del capítulo (ZIP, 265 kB).
9 archivos CSV · 4 figuras · 1 programa Python.
El programa se ha ejecutado en una carpeta vacía y genera los archivos de datos y figuras incluidos en el paquete.