92.1. Una vez definida la red, podemos contar conexiones
C91 estableció una regla metodológica. Antes de calcular cualquier métrica debemos saber qué representan los nodos, qué constituye una arista, si existe dirección, qué significa el peso y cómo se trataron ausencias, lazos, multiplicidad y tiempo.
Solo después tiene sentido preguntar cuántas conexiones tiene cada nodo.
En un grafo simple no dirigido, esa pregunta conduce al grado.
En una red dirigida debemos distinguir conexiones entrantes y salientes.
En una red ponderada aparece una segunda cantidad, la fuerza, que suma pesos y no simplemente aristas.
Estas cantidades son locales. Describen cómo se conecta un nodo de manera inmediata.
No responden todavía a preguntas sobre caminos, accesibilidad o centralidad global. Esos temas corresponden a capítulos posteriores.
C92 se concentra en la cuestión previa de cómo resumir la distribución de conexiones y qué significa que una red sea homogénea o heterogénea en este nivel.
92.2. Grado en un grafo simple no dirigido
Sea un grafo simple no dirigido.
El grado de un nodo , denotado es el número de aristas incidentes en él.
En el grafo de C91, con nodos
las aristas son
Por tanto,
El vector de grados es
El grado es una propiedad del nodo respecto del grafo especificado.
Si cambiamos la regla de arista, cambia el grado.
92.3. Grado desde la matriz de adyacencia
Para un grafo simple no dirigido con matriz de adyacencia ,
En notación vectorial,
donde
es un vector columna de unos.
Esta identidad conecta la representación matricial de C91 con una primera estadística de red.
En el ejemplo,
El grado es una suma de filas y no requiere ningún algoritmo complejo.
La dificultad aparece en su interpretación y comparación.
92.4. El lema del apretón de manos
En un grafo no dirigido sin lazos, cada arista contribuye una unidad de grado a cada uno de sus dos extremos.
Por tanto,
donde
Esta identidad suele denominarse lema del apretón de manos.
En nuestro grafo,
Como existen siete aristas,
La igualdad da una comprobación elemental de consistencia entre lista de aristas y vector de grados.
92.5. Grado medio
El grado medio es
Usando el lema anterior,
para un grafo simple no dirigido.
En el ejemplo,
Esta cantidad describe cuántas conexiones tiene un nodo promedio, sin decir cómo se distribuyen entre ellos. Esa será la cuestión central de la heterogeneidad.
92.6. Densidad y grado medio
Para un grafo simple no dirigido con nodos, el número máximo de aristas es
La densidad se define como
Sustituyendo
obtenemos
En el grafo base,
Esta identidad ayuda a interpretar comparaciones entre redes de diferente tamaño.
Un mismo grado medio puede corresponder a densidades muy distintas cuando cambia .
92.7. Grado normalizado
Una normalización sencilla es
porque en un grafo simple no dirigido cada nodo puede conectarse como máximo con nodos distintos.
Entonces
La media de los grados normalizados coincide con la densidad:
Esta normalización facilita algunas comparaciones entre tamaños.
No resuelve todos los problemas de comparabilidad. Dos redes pueden tener igual densidad y mecanismos de formación completamente diferentes.
Normalizar cambia la escala numérica y deja intacta la semántica del vínculo.
92.8. Distribución empírica de grado
En lugar de resumir todos los nodos mediante
podemos estudiar cuántos nodos tienen cada grado.
Definimos
En nuestro grafo de seis nodos:
La distribución no toma otros valores y conserva más información que el promedio.
En redes grandes puede presentar una forma estrecha, amplia, multimodal o altamente asimétrica.
C92 no intentará clasificar todavía esas formas mediante modelos generativos específicos. Primero necesitamos aprender a medir la heterogeneidad sin convertir una figura en una etiqueta.
92.9. Misma media, redes muy diferentes
Construyamos dos redes con y
La primera es un ciclo:
Cada nodo tiene exactamente dos vecinos:
para todos los nodos.
La segunda contiene un nodo conectado con los otros siete y una arista adicional entre dos nodos periféricos.
Su secuencia de grados es
En ambas redes,
Sin embargo, su estructura local es muy distinta.
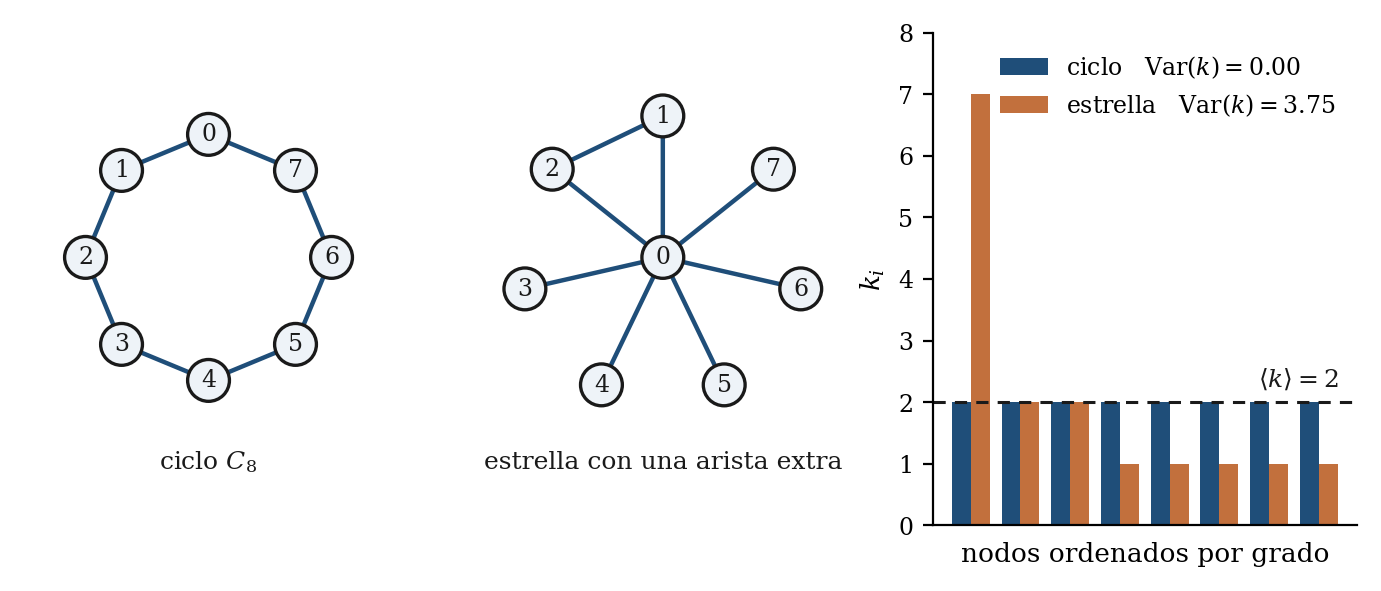
La figura muestra que el promedio deja fuera la concentración de conexiones.
92.10. Varianza del grado
Una medida elemental de heterogeneidad es
En el ciclo,
para todo , de modo que
En la red heterogénea,
y
Las dos redes tienen el mismo , el mismo y el mismo grado medio.
La varianza revela una diferencia que esos tres números no contienen.
92.11. Coeficiente de variación
Cuando el grado medio es positivo, podemos estandarizar la dispersión mediante
En la red regular,
En la red heterogénea,
El coeficiente de variación es adimensional.
Puede facilitar comparaciones entre redes con escalas medias diferentes, pero sigue dependiendo del rango posible de grados y del tipo de red.
No existe un umbral universal de que transforme una red en «heterogénea».
92.12. Segundo momento del grado
Otra cantidad útil es
Como
el segundo momento crece cuando aumenta la dispersión para media fija.
En el ciclo,
En la red heterogénea,
La razón
también es mayor en la red heterogénea.
Más adelante esta combinación aparecerá naturalmente en modelos de redes aleatorias y procesos sobre redes.
Por ahora su función es mostrar que los momentos superiores del grado distinguen arquitecturas con el mismo promedio.
92.13. Heterogeneidad no significa automáticamente ley de potencia
Una distribución de grado amplia no demuestra que siga
Una mezcla de poblaciones, restricciones de tamaño, mecanismos de crecimiento o decisiones de muestreo pueden producir distribuciones heterogéneas sin una ley de potencia.
Además, en una red finita
Toda afirmación asintótica exige mucho más que observar unos pocos nodos con grado alto.
C98 estudiará específicamente las redes libres de escala y las exigencias de evidencia.
En C92 utilizaremos «heterogeneidad» en un sentido descriptivo, el de desigualdad en la distribución de conexiones.
92.14. Un nodo aislado
Un nodo con es un nodo aislado.
Puede ser estructuralmente real o producto de observación incompleta.
Su presencia afecta la distribución de grado y el grado medio.
Eliminar nodos aislados antes del análisis aumenta artificialmente el grado medio de la red restante.
A veces la eliminación está justificada porque esos nodos no pertenecen al universo relevante. Otras veces elimina justamente la información de que algunas unidades no establecieron vínculos.
La decisión debe registrarse.
92.15. Lazos y multiaristas cambian la convención de grado
C91 distinguió grafos simples, lazos y multigrafos.
En un multigrafo, las aristas paralelas pueden contar separadamente en el grado.
En un grafo no dirigido, un lazo suele contribuir dos unidades al grado porque tiene dos extremos incidentes en el mismo nodo.
Por tanto, la identidad
continúa siendo compatible con esa convención.
Si una aplicación decide contar «número de vecinos distintos», en cambio, un lazo o varias aristas al mismo vecino requieren otra definición.
Antes de comparar grados necesitamos saber qué está contando exactamente .
92.16. Grado en redes dirigidas
Con la convención de C91,
si existe una arista
El grado de salida es
El grado de entrada es
En notación vectorial,
Un nodo puede tener muchos vínculos salientes y pocos entrantes, o al revés.
Reducir ambos a un único grado borra esa asimetría.
92.17. Identidades para grados dirigidos
Cada arista dirigida contribuye exactamente una unidad a algún grado de salida y una unidad a algún grado de entrada.
Por tanto,
y
Entonces
Las medias globales coinciden necesariamente.
Eso no implica que para cada nodo
La igualdad vale en el agregado, no nodo por nodo.
92.18. El ejemplo dirigido
El paquete incluye una red dirigida donde el nodo tiene dos aristas salientes:
Por tanto,
Solo recibe una:
Entonces
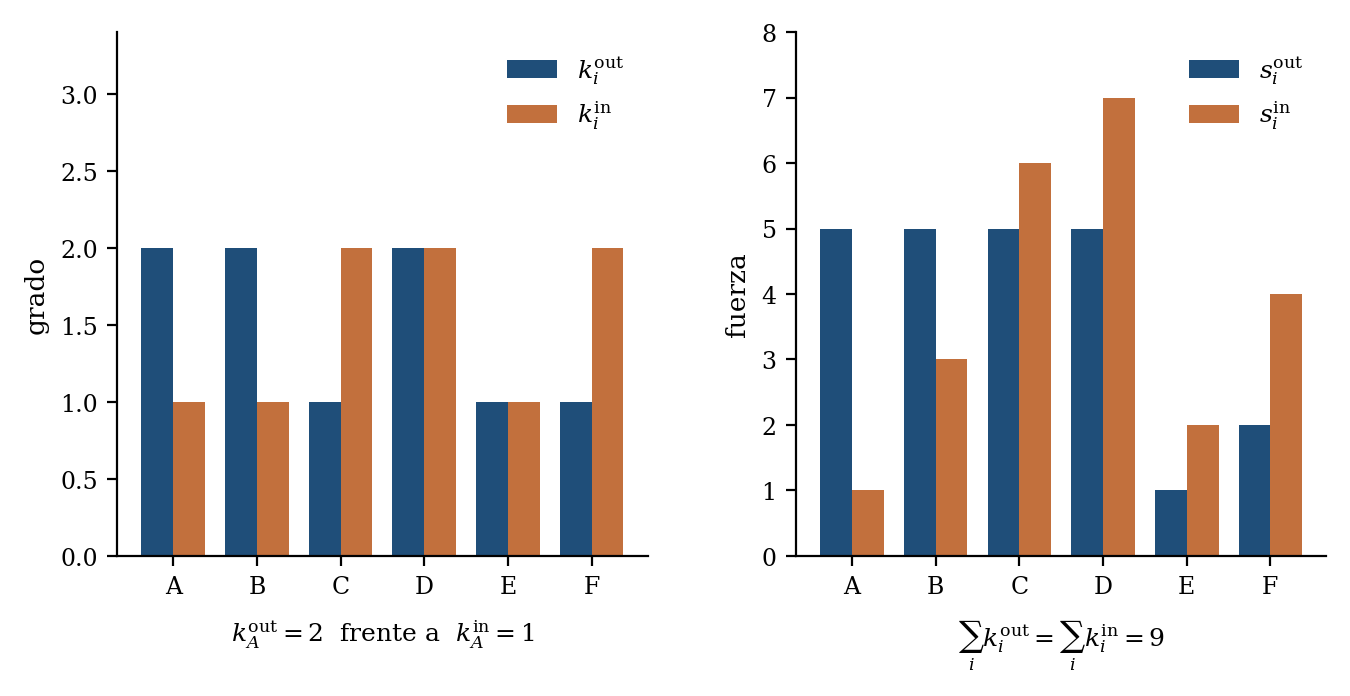
La diferencia entre entrada y salida ya contiene información relacional que desaparecería al simetrizar la red.
92.19. El grado y la fuerza miden cosas distintas
Supongamos ahora una red ponderada no dirigida con matriz .
El grado del nodo cuenta cuántos vínculos tienen peso distinto de cero:
La fuerza suma los pesos:
Dos nodos pueden tener el mismo grado y fuerzas muy diferentes.
El grado responde a con cuántos nodos está conectado un vértice. La fuerza responde a cuánto peso total acumulan esas conexiones. Son preguntas distintas.
92.20. Ejemplo de fuerza
En la red ponderada reproducible, el soporte binario es exactamente el grafo simple de C91.
Por tanto,
Los pesos, en cambio, son heterogéneos.
Para el nodo , existen dos conexiones:
con peso 1 y con peso 9.
Entonces mientras
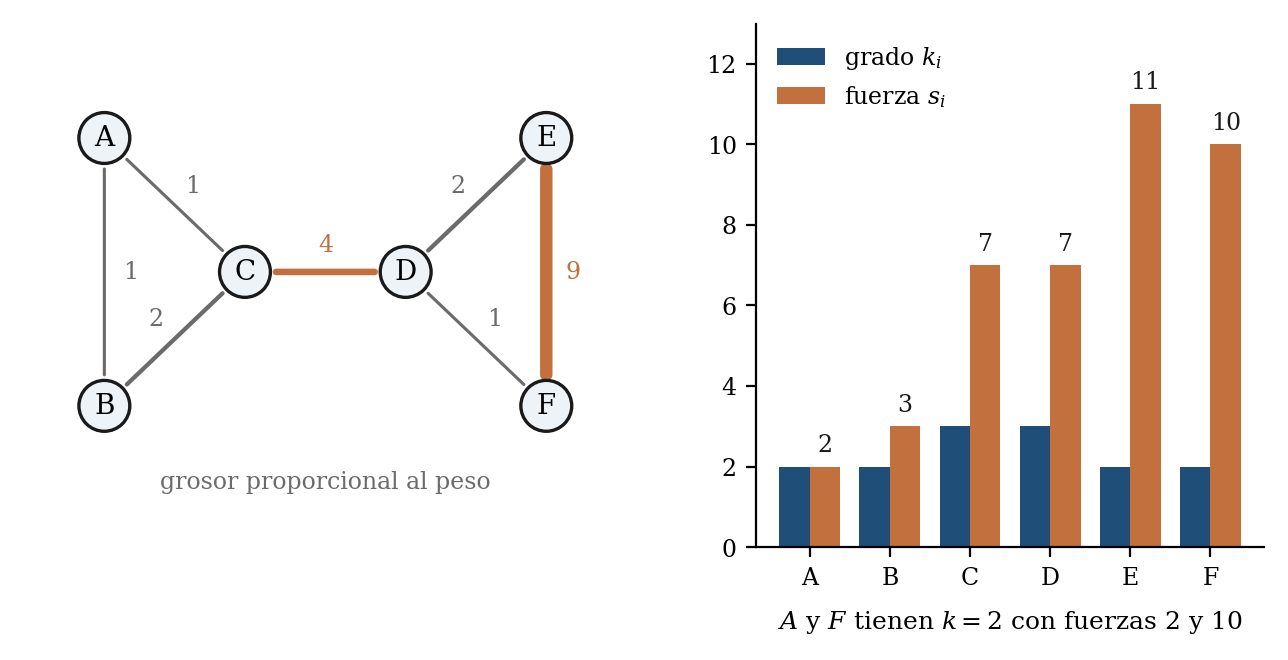
Un segundo nodo de grado dos puede tener una fuerza mucho menor.
El número de vínculos y su intensidad no deben mezclarse.
92.21. Fuerza total en una red no dirigida
Si
y la diagonal es cero,
Al sumar sobre todos los nodos,
Cada arista ponderada aparece dos veces, una por cada orientación matricial.
Por tanto,
Esta identidad es la versión ponderada del lema del apretón de manos.
El paquete la verifica exactamente.
92.22. Fuerza de entrada y salida
En una red dirigida ponderada con convención
definimos
y
Como cada peso sale de algún nodo y entra a otro,
De nuevo, la igualdad global no implica igualdad nodo por nodo.
Una entidad puede enviar mucho peso y recibir poco.
92.23. Grado alto no significa necesariamente fuerza alta
Si los pesos son muy variables, la relación entre y puede ser débil.
Un nodo puede tener muchas aristas pequeñas y otro pocas aristas muy intensas.
Por eso no deberíamos sustituir automáticamente grado por fuerza al pasar a una red ponderada.
La fuerza incorpora intensidad, pero pierde otra distinción, porque dos nodos con igual fuerza pueden repartirla de forma muy diferente entre sus vecinos.
C92 no intentará resumir toda esa distribución local. Basta reconocer que grado y fuerza son capas distintas de información.
92.24. Fuerza media
Para una red no dirigida ponderada,
donde
Así como
depende del número de aristas, la fuerza media depende del peso total.
Dos redes con igual fuerza media, sin embargo, pueden distribuir el peso de maneras muy diferentes, de modo que la lógica de la heterogeneidad se repite.
92.25. Heterogeneidad de fuerza
Podemos calcular
o
Estas cantidades describen la desigualdad del peso acumulado entre nodos y no equivalen a la heterogeneidad de grado. Una red puede ser casi regular en número de conexiones y muy heterogénea en intensidad, o al revés.
Si la pregunta depende de exposición acumulada, flujo o capacidad, la fuerza puede ser más relevante que el grado binario.
92.26. Comparar redes de diferente tamaño
Un grado de 20 puede ser enorme en una red de 25 nodos y pequeño en una de 10.000.
La normalización ayuda en grafos simples, pero tampoco elimina todas las diferencias.
En redes grandes y dispersas, la densidad puede tender a cero aunque el grado medio crezca lentamente.
En redes dirigidas, el máximo de entrada y salida también depende del número de nodos y de si se permiten lazos.
Comparar heterogeneidad exige mirar simultáneamente tamaño, densidad, soporte posible y definición de arista.
92.27. Muestreo incompleto distorsiona el grado
Si una fracción de aristas no se observa, el grado medido puede ser menor que el grado latente.
El problema puede afectar nodos de manera desigual.
Por ejemplo, si ciertos tipos de vínculo tienen mayor probabilidad de quedar registrados, algunos nodos parecerán más conectados por la cobertura del sistema de observación además de por su estructura real.
Eliminar nodos con información incompleta tampoco resuelve necesariamente el sesgo.
Las métricas locales heredan la incertidumbre de medición señalada en C91.
92.28. Umbral y distribución de grado
C91 mostró una matriz ponderada de contactos y la convirtió en grafos binarios mediante
Al aumentar , disminuye el número de aristas.
Por tanto,
también disminuye.
La heterogeneidad, en cambio, no tiene por qué cambiar de manera monotónica simple. Algunos nodos pueden perder rápidamente conexiones débiles mientras otros conservan vínculos fuertes, de modo que la distribución de grado puede reordenarse.
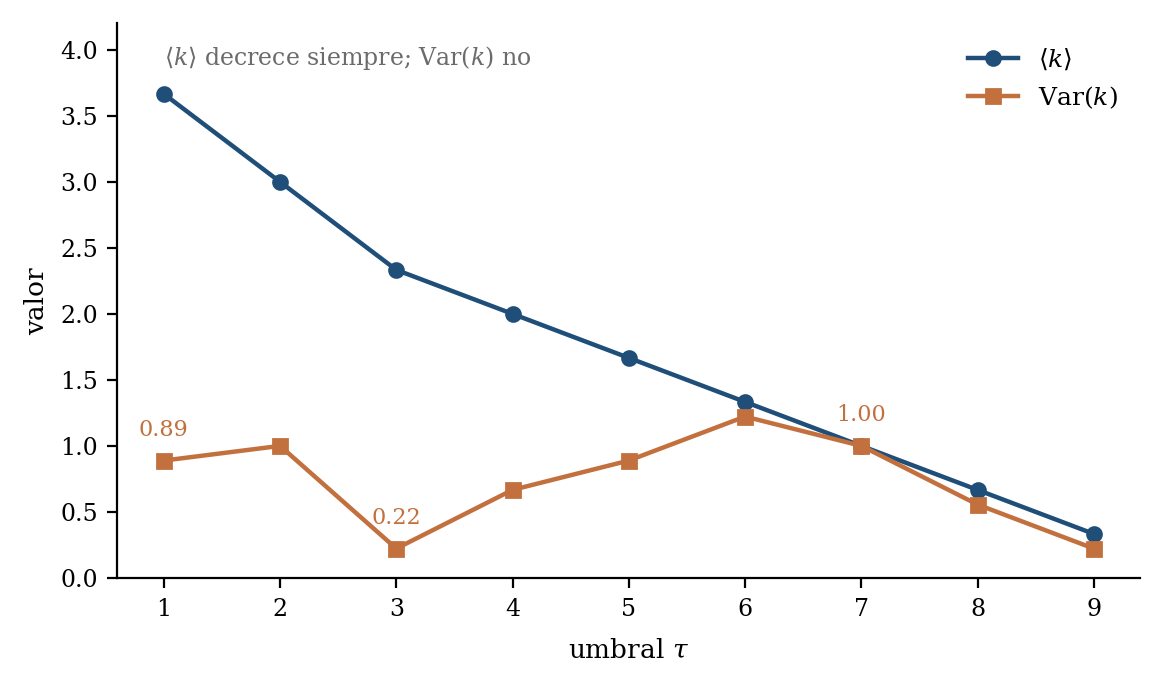
92.29. El ejemplo de sensibilidad al umbral
En la matriz de C91, el número de aristas pasa de 11 con a una sola con
El grado medio disminuye necesariamente porque
El coeficiente de variación del grado, en cambio, cambia de forma no trivial.
En algunos umbrales la reducción de aristas concentra los vínculos restantes en pocos nodos y aumenta la heterogeneidad relativa.
Por tanto, una afirmación como «la red presenta hubs locales» puede depender de la regla usada para convertir pesos en enlaces.
Antes de interpretar la heterogeneidad conviene estudiar sensibilidad a decisiones de construcción.
92.30. Heterogeneidad observada no identifica un mecanismo
Supongamos que observamos una distribución de grados muy amplia.
Eso puede surgir de diferencias persistentes entre nodos, de mecanismos de crecimiento, de restricciones espaciales, de una mezcla de subpoblaciones, de ventanas de observación distintas, de umbrales de detección o de muestreo incompleto. La estadística descriptiva no decide entre esas explicaciones.
C96 introducirá redes aleatorias como modelos de referencia.
C98 estudiará mecanismos y evidencia para distribuciones de grado amplias de tipo escala libre.
C92 solo establece qué debe medirse antes de comparar explicaciones.
92.31. El alcance local del grado frente a la centralidad global
Un nodo con grado alto tiene muchos vínculos inmediatos.
Eso no garantiza que ocupe una posición estratégica respecto del resto de la red.
Un nodo con pocos vecinos puede conectar regiones separadas. Otro con muchos vecinos puede estar encerrado dentro de un grupo local.
Las métricas de centralidad formalizarán varias de estas preguntas en C95.
Por tanto, no usaremos «central» como sinónimo automático de «grado alto». El grado es una medida local de conectividad inmediata.
92.32. El grado deja abierta la accesibilidad
Tampoco debemos confundir con cuántos nodos pueden alcanzarse desde .
Un nodo de grado uno puede pertenecer a una gran componente conectada y alcanzar indirectamente muchos nodos.
Un nodo de grado cinco podría pertenecer a una pequeña componente aislada de seis nodos.
C93 estudiará caminos, distancias y accesibilidad.
La secuencia curricular importa porque una red no puede reducirse a cuántas aristas tocan cada nodo.
92.33. Distribuciones y momentos deben acompañarse
En una red grande conviene reportar más de un resumen.
Como mínimo, según la pregunta, pueden ser útiles:
y la distribución empírica de grado.
En redes ponderadas añadimos
y la distribución de fuerza.
En redes dirigidas conviene separar entrada y salida.
Un único promedio puede ocultar la heterogeneidad misma que queremos estudiar.
92.34. Visualizar la distribución sin inventar una ley
Para redes grandes se utilizan histogramas, funciones acumuladas o funciones de supervivencia del grado.
La escala logarítmica puede ser útil cuando el rango es amplio.
C79 y C88, sin embargo, ya establecieron una cautela general:
no implica automáticamente
En redes, la tentación es fuerte porque unas pocas observaciones de alto grado llaman mucho la atención visual.
La forma distributiva debe evaluarse con modelos y alternativas, más allá del dibujo.
92.35. La secuencia de grados no determina el grafo
Supongamos seis nodos con para todos ellos.
Una posibilidad es un ciclo de seis nodos:
Otra posibilidad consiste en dos triángulos separados.
En ambos casos,
y la secuencia de grados es exactamente
Sin embargo, las redes no son equivalentes.
En el ciclo todos los nodos pertenecen a una sola componente. En los dos triángulos existen dos componentes desconectadas.
Por tanto, incluso toda la distribución de grado puede ser insuficiente para determinar propiedades globales.
Esta observación prepara C93. El grado registra vecindad inmediata, pero no conserva cómo esas vecindades se ensamblan en caminos largos.
Dos redes pueden ser indistinguibles para C92 y muy diferentes respecto de accesibilidad.
92.36. Muestrear aristas sobrerrepresenta nodos de grado alto
La heterogeneidad de grado también modifica qué nodos encontramos según el procedimiento de muestreo.
Si elegimos un nodo uniformemente al azar,
Si elegimos una arista al azar y luego uno de sus extremos, en cambio, la probabilidad de llegar al nodo es proporcional a su grado:
Los nodos con muchas conexiones aparecen más veces como extremos de aristas.
El grado esperado del nodo alcanzado es entonces
Por tanto,
En la red regular de ocho nodos,
En la red heterogénea,
Aunque el grado medio de un nodo elegido uniformemente es dos en ambas redes, un extremo de arista típico pertenece a un nodo de grado promedio 3.875 en la red heterogénea.
La diferencia surge exclusivamente de la ponderación por .
92.37. El llamado «paradigma de los amigos» es una consecuencia de la heterogeneidad
La identidad anterior puede compararse con
Como
tenemos
Si
entonces
En lenguaje de redes sociales, esto se relaciona con el conocido «friendship paradox», según el cual los vecinos de una persona, promediados de la manera apropiada, tienden a tener más conexiones que una persona elegida uniformemente.
El resultado nada tiene de paradójico en sentido lógico. Los nodos de grado alto quedan sobrerrepresentados porque aparecen como vecinos de muchas personas.
La magnitud del efecto aumenta con la heterogeneidad del grado.
Este resultado muestra que la distribución de conexiones describe nodos y además cambia la distribución observada cuando el muestreo ocurre a través de vínculos.
92.38. Fuerza por vínculo
Si un nodo tiene
y fuerza
podemos calcular su peso medio por arista:
Esta cantidad distingue dos formas de acumular fuerza.
Un nodo puede alcanzar un grande porque tiene muchas conexiones de intensidad moderada.
Otro puede alcanzar la misma fuerza mediante pocas conexiones muy intensas.
Por tanto, conocer sin todavía deja ambigua la arquitectura local.
De manera equivalente,
Esta factorización separa aritméticamente dos componentes, sin suponer independencia entre número e intensidad de vínculos.
En datos empíricos puede ser útil preguntar si la fuerza crece aproximadamente en proporción al grado o si los nodos con más conexiones presentan también pesos medios diferentes.
Ese patrón requiere análisis propio y no debe deducirse a partir del grado solamente.
92.39. La ventana de observación cambia el grado acumulado
Supongamos una red construida con todas las interacciones registradas durante un intervalo de longitud .
Si definimos una arista por «haber interactuado al menos una vez», aumentar solo puede conservar o añadir aristas mientras las demás reglas permanezcan iguales.
Entonces el grado acumulado es no decreciente con .
Una red observada durante una semana y otra durante un año no son directamente comparables si el vínculo significa «alguna interacción durante la ventana».
La red anual dispone simplemente de más oportunidades para descubrir conexiones.
Esto puede aumentar:
y modificar también la heterogeneidad.
Comparar distribuciones de grado exige por ello ventanas temporales compatibles o una definición del vínculo que controle explícitamente exposición.
La heterogeneidad observada puede reflejar heterogeneidad estructural, heterogeneidad de actividad o diferencias en duración de observación.
92.40. Heterogeneidad es una propiedad distributiva, no un juicio sobre nodos
Cuando una red presenta gran dispersión de grados, resulta tentador concentrarse únicamente en los nodos de valores máximos.
Sin embargo, la heterogeneidad es una propiedad de la distribución completa.
Dos redes pueden compartir el mismo grado máximo y diferir ampliamente en cómo se reparte el resto de las conexiones.
Por ejemplo, un único nodo de grado muy alto acompañado por una población casi regular no es equivalente a una red donde muchos nodos ocupan gradualmente todo el rango de grados.
La misma cautela se aplica a la fuerza.
Por eso conviene separar:
y
El grado máximo
describe un extremo.
La varianza o el coeficiente de variación describen dispersión.
La distribución empírica conserva información sobre cómo se asigna masa a cada grado.
Ninguna de estas cantidades sustituye completamente a las demás.
Además, un nodo de grado máximo no debe recibir automáticamente una interpretación funcional especial. Puede ser relevante por razones locales, pero atribuirle control, influencia o vulnerabilidad del sistema exige analizar la estructura que rodea esas conexiones y, en algunos casos, la dinámica que circula sobre la red.
C92 termina, por tanto, antes de convertir desigualdad de conexiones en una teoría de importancia. Esa separación será útil en los capítulos siguientes. Primero estudiaremos cómo las conexiones inmediatas se encadenan en caminos. Después veremos cómo distintas definiciones de centralidad responden a preguntas diferentes. Mantener el grado en su nivel local evita atribuirle propiedades que todavía no han sido demostradas. También obliga a conservar visibles las decisiones de medición que determinaron cuántas conexiones podía llegar a tener cada nodo.
92.41. Verificación computacional
El paquete reproducible comienza con el grafo simple de C91.
Confirma
y
La densidad es
y se verifica
Después compara dos redes de ocho nodos y ocho aristas.
La red regular tiene para todos los nodos y varianza cero.
La red heterogénea tiene grado medio dos y varianza
En la red ponderada, el soporte binario conserva exactamente el vector de grados de C91, pero las fuerzas difieren. El nodo tiene grado dos y fuerza diez.
En la red dirigida se comprueba que las sumas globales de grados de entrada y salida coinciden con el número de aristas, mientras los valores nodo por nodo son distintos.
Finalmente, el análisis de umbral confirma que aristas, grado medio, densidad y heterogeneidad cambian al modificar la regla de binarización.
Se ejecutaron 36 comprobaciones automáticas y las 36 resultaron satisfactorias.
92.42. Qué queda establecido
El grado cuenta conexiones inmediatas.
En un grafo no dirigido simple,
y
El grado medio no determina la distribución de grado. Redes con igual tamaño, igual número de aristas e igual promedio pueden diferir por completo en heterogeneidad.
La varianza, el coeficiente de variación y otros momentos describen aspectos adicionales de esa dispersión, pero no identifican el mecanismo que la produjo.
En redes dirigidas deben separarse grados de entrada y salida.
En redes ponderadas debe distinguirse grado de fuerza.
Las métricas dependen de cómo se construyó la red. Cambiar umbrales, cobertura o reglas de agregación puede cambiar la heterogeneidad antes de que comience cualquier interpretación estructural.
C93 estudiará los caminos, las distancias y la accesibilidad. Allí pasaremos de conexiones inmediatas a secuencias de aristas, hasta que la red comience a mostrar estructura que ningún grado individual puede describir por sí solo.
Referencias
- Barabási, A.-L. (2016). Network Science. Cambridge University Press.
- Barrat, A., Barthélemy, M., Pastor-Satorras, R., & Vespignani, A. (2004). The architecture of complex weighted networks. Proceedings of the National Academy of Sciences, 101(11), 3747–3752.
- Bollobás, B. (1998). Modern Graph Theory. Springer.
- Newman, M. E. J. (2010). Networks: An Introduction. Oxford University Press.
- Opsahl, T., Agneessens, F., & Skvoretz, J. (2010). Node centrality in weighted networks: Generalizing degree and shortest paths. Social Networks, 32(3), 245–251.
Recursos reproducibles
Descargar recursos del capítulo (ZIP, 176 kB).
6 archivos CSV · 4 figuras · 1 programa Python.
El programa se ha ejecutado en una carpeta vacía y genera los archivos de datos y figuras incluidos en el paquete.