96.1. Una propiedad observada necesita una comparación
Los capítulos anteriores calcularon propiedades de una red concreta:
Obtener un valor, sin embargo, no responde todavía una segunda pregunta. ¿Es ese valor extraordinario dadas ciertas propiedades básicas de la red?
Un agrupamiento de puede ser alto respecto de una familia de redes y ordinario respecto de otra.
La comparación requiere especificar qué características consideramos dadas y cuáles permitimos variar.
Eso es un modelo de referencia.
Una red aleatoria es una variable aleatoria cuyo espacio de resultados está formado por grafos y cuya distribución de probabilidad debe definirse explícitamente, bastante más que una red «desordenada».
96.2. Un modelo aleatorio es una distribución sobre grafos
Sea
un conjunto de grafos posibles.
Un modelo aleatorio asigna probabilidades
a los elementos
Una realización concreta es solo una muestra de esa distribución.
Esto es exactamente análogo a C84:
no es lo mismo que una observación particular .
De igual forma,
no es lo mismo que un grafo aleatorio concreto generado desde .
Para evaluar una métrica , necesitamos su distribución bajo el modelo:
96.3. Modelo generativo y modelo de referencia
La misma familia matemática puede cumplir funciones distintas.
Como modelo generativo, puede proponerse que el mecanismo real que formó la red se parece al proceso aleatorio especificado.
Como modelo de referencia, puede usarse solo para preguntar qué ocurriría si ciertas características fueran aleatorias mientras otras se mantienen fijas.
Estas afirmaciones no son equivalentes. Usar como referencia no significa afirmar que la red empírica fue producida realmente por conexiones independientes con probabilidad constante.
Puede significar únicamente que comparamos la red observada con una familia que conserva y la densidad esperada, pero elimina otras estructuras.
96.4. El espacio de aristas posibles
Para un grafo simple no dirigido con nodos existen
aristas posibles.
Nuestro ejemplo utilizará
Entonces
La red observada contiene aristas.
Su densidad es
Este valor permitirá construir referencias con la misma densidad esperada o con el mismo número exacto de aristas.
96.5. La red observada
Construimos un anillo regular donde cada nodo se conecta con sus dos vecinos más próximos a cada lado.
Por tanto, para los 40 nodos.
La secuencia de grados es exactamente constante y
El número de aristas es
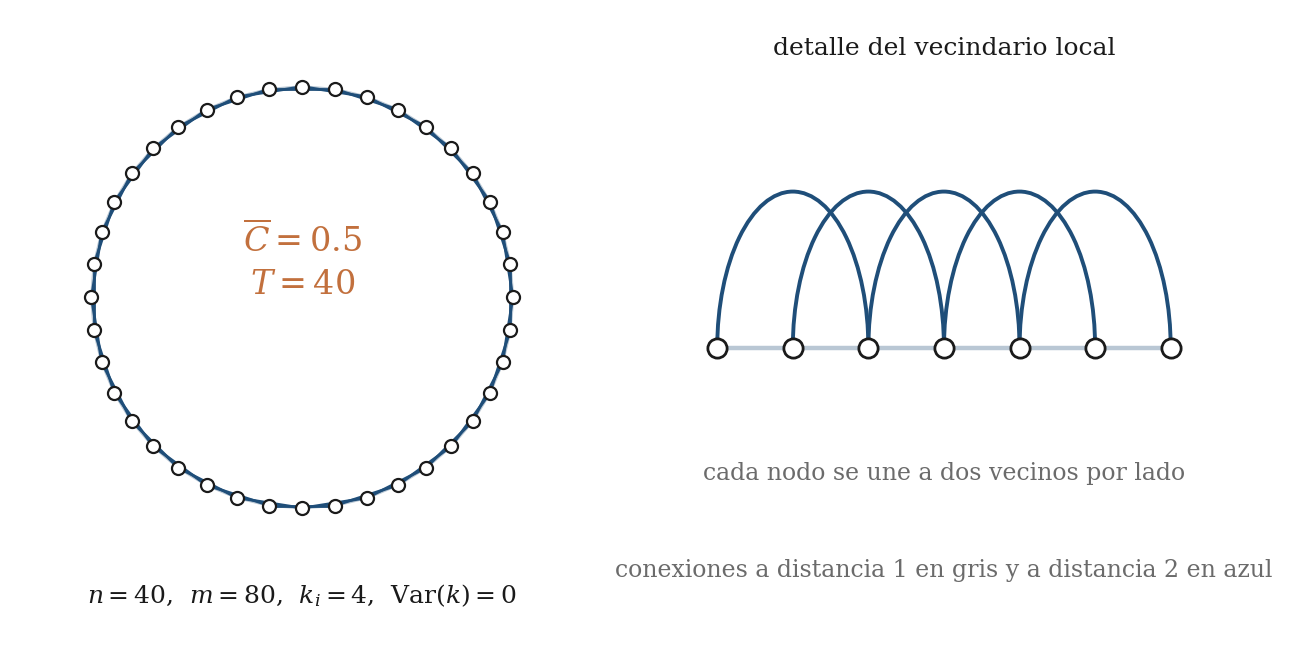
Esta red tiene estructura espacial local muy fuerte. Utilizaremos modelos aleatorios para preguntar qué aspectos de sus métricas podrían explicarse únicamente por restricciones más débiles.
96.6. El primer modelo
En el modelo cada una de las aristas posibles se incluye independientemente con probabilidad
Elegimos
Así, el número esperado de aristas coincide con la red observada.
Históricamente, este modelo se asocia con Gilbert, aunque en la literatura moderna suele incluirse junto con bajo la denominación amplia de modelos Erdős–Rényi.
Lo que importa es la distribución exacta que usamos, antes que el nombre.
96.7. Probabilidad de un grafo en
Sea un grafo concreto con aristas.
Como las aristas se generan independientemente,
Todos los grafos con el mismo número de aristas tienen la misma probabilidad.
Los grafos con distinto , en cambio, no son equiprobables salvo cuando
Por tanto, decir «todos los grafos son aleatorios por igual» sería incorrecto para un general.
96.8. Número de aristas en
Cada arista posible corresponde a una Bernoulli.
Entonces
Por tanto,
y
Con nuestros parámetros,
La desviación estándar teórica es aproximadamente
Una referencia con densidad esperada igual a la observada no fija el número de aristas.
96.9. La simulación muestra esa fluctuación
En 1500 realizaciones , el número de aristas fluctúa alrededor de 80.
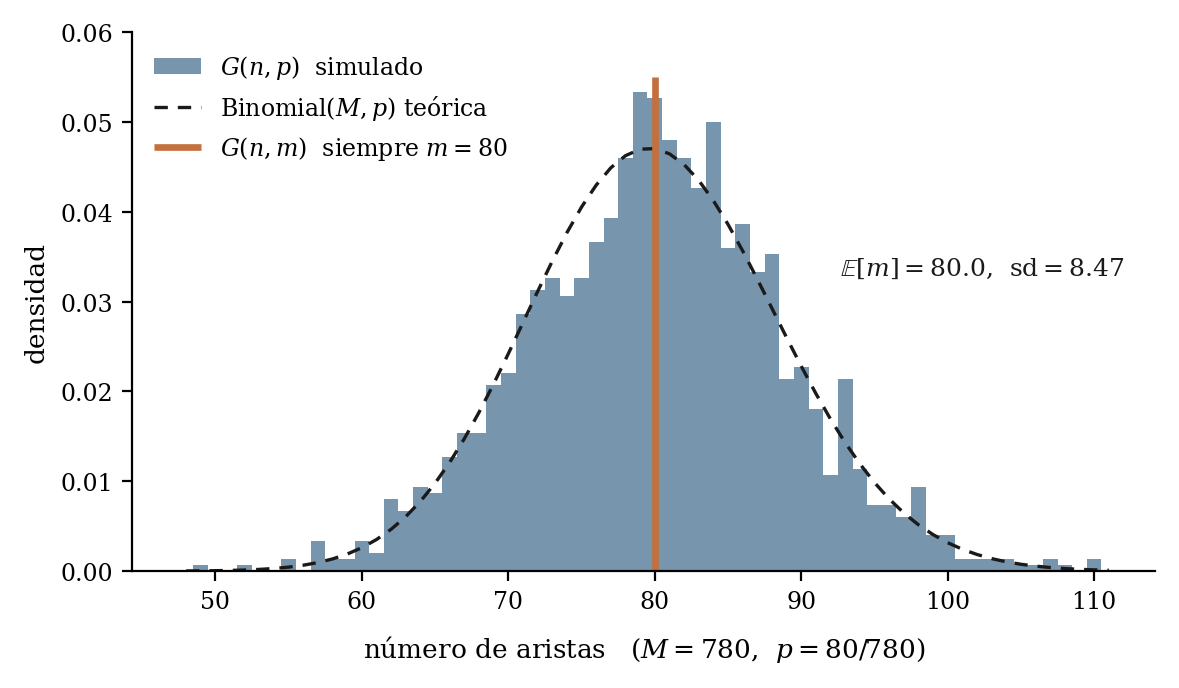
La simulación reproduce tanto la media teórica como su desviación estándar.
Esta es una diferencia de fondo frente a un modelo que condicione exactamente en
Si la métrica estudiada depende fuertemente del número de aristas, la variabilidad adicional de puede formar parte de la referencia aunque la red observada tenga un fijo.
96.10. Distribución del grado en
Para un nodo existen aristas posibles incidentes.
Cada una aparece independientemente con probabilidad .
Entonces
Por tanto,
Con nuestro ,
La varianza teórica es aproximadamente
La red observada también tiene grado medio cuatro, pero varianza cero.
Igualar el promedio no iguala la heterogeneidad.
96.11. Triángulos esperados en
Cualquier conjunto de tres nodos forma un triángulo si aparecen sus tres aristas.
Por independencia,
Existen
ternas posibles.
Entonces
En nuestro ejemplo,
La red observada contiene triángulos.
La discrepancia ya sugiere que tamaño y densidad esperada no bastan para explicar su cierre local.
96.12. Agrupamiento esperado bajo independencia de aristas
Condicionemos en que un nodo tenga al menos dos vecinos.
En , dos vecinos concretos están conectados entre sí con probabilidad independientemente de las aristas que los conectan al nodo central.
Por eso la probabilidad de cierre de una oportunidad local es
En redes suficientemente grandes, el agrupamiento típico de se encuentra alrededor de .
En nuestras simulaciones, el agrupamiento local medio es aproximadamente cercano a
No es exactamente en cada realización finita.
96.13. El segundo modelo
En fijamos exactamente: y
Entre las
formas de elegir aristas entre las posibles, cada grafo simple tiene la misma probabilidad:
si tiene exactamente aristas.
Nuestro ensamble conserva siempre:
La densidad queda fija en cada realización, más allá del promedio.
96.14. y no son el mismo experimento
Ambos modelos pueden tener la misma densidad nominal:
El modelo , en cambio, permite fluctuaciones en el número total de aristas.
condiciona exactamente en ese número.
La diferencia es análoga a comparar un experimento Bernoulli con una distribución condicionada en el número total de éxitos.
Para muchas propiedades y redes grandes las diferencias pueden ser pequeñas.
Para otras preguntas, sobre todo cuando participa directamente en la métrica, la distinción importa.
96.15. Las aristas de no son independientes
En , una arista concreta aparece con probabilidad
Una vez incluida, sin embargo, queda una arista menos por seleccionar.
Dos indicadores de aristas distintas presentan una covarianza negativa.
Para ,
Por tanto,
La restricción global sobre introduce dependencia entre aristas.
96.16. Distribución del grado en
Para un nodo concreto hay aristas incidentes dentro de un universo de aristas posibles.
Seleccionamos exactamente aristas.
Entonces el grado sigue una distribución hipergeométrica:
Su esperanza es
En nuestro caso vuelve a ser cuatro, aunque la secuencia completa de grados no queda fijada.
96.17. Misma y , grados diferentes
Las simulaciones contienen siempre 80 aristas.
Aun así, la varianza media del grado es aproximadamente
La red observada tiene
Por tanto, conservar el número total de aristas no conserva cómo esas aristas se distribuyen entre nodos.
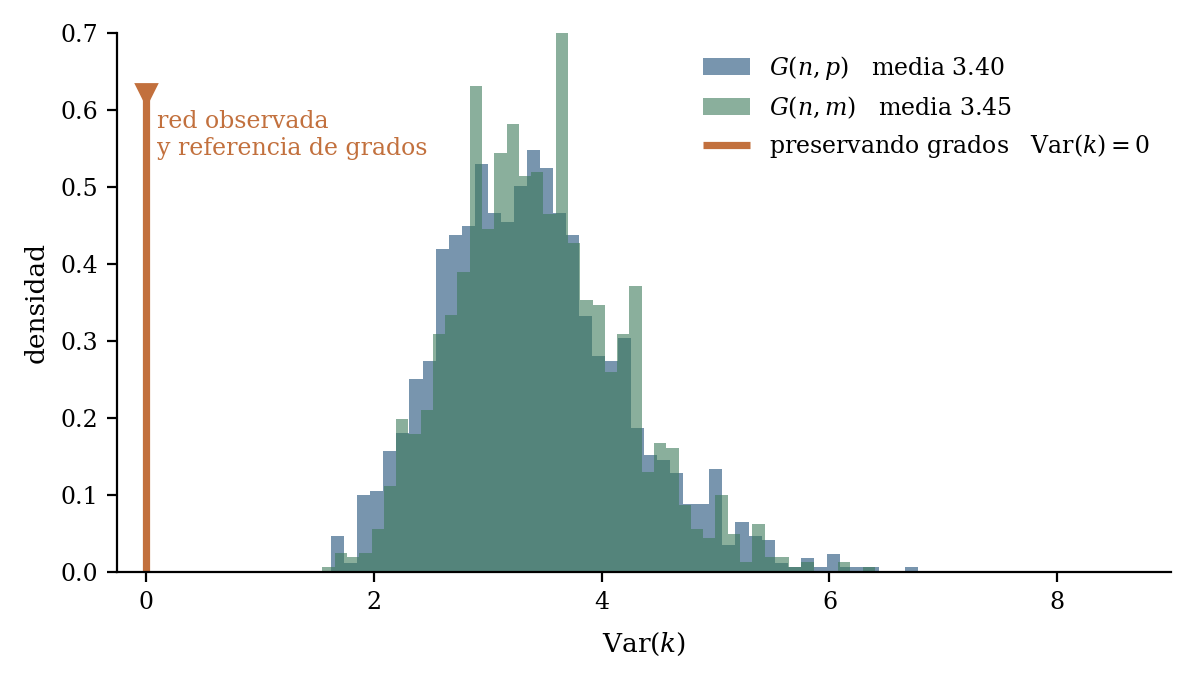
Si queremos preguntar por propiedades «más allá de la secuencia de grados», necesitamos una referencia más restrictiva.
96.18. Preservar la secuencia de grados
Supongamos que consideramos la secuencia observada
como una restricción que debe mantenerse.
Una forma de aleatorizar la red utiliza un intercambio doble de aristas.
Elegimos dos aristas:
y proponemos reemplazarlas por, por ejemplo,
si eso no crea lazos ni aristas duplicadas.
Cada uno de los cuatro nodos pierde una arista y gana otra.
Por tanto, todos sus grados permanecen iguales.
96.19. Qué conserva un intercambio doble
Una secuencia larga de intercambios preserva exactamente:
y
Puede cambiar, en cambio, los triángulos, el agrupamiento, las distancias, la intermediación y muchas otras propiedades.
Eso lo convierte en una referencia útil cuando la pregunta es qué estructura queda después de explicar el patrón solo por los grados observados.
96.20. El ensamble preservador de grados del ejemplo
La red observada tiene para todos los nodos.
En cada réplica, el script ejecuta numerosos intercambios dobles.
Todas las redes resultantes mantienen:
y
Sin embargo, el agrupamiento y el número de triángulos varían.
La media de clustering cae a aproximadamente
El número medio de triángulos es aproximadamente
La secuencia de grados no explica los 40 triángulos observados.
96.21. Preservar más estructura cambia la referencia
Tenemos ahora tres preguntas distintas.
Con preguntamos si la propiedad resulta inusual fijando solo y la densidad esperada. Con , si lo es fijando exactamente y . Con intercambios de aristas, si lo sigue siendo fijando además toda la secuencia de grados.
Las tres referencias son legítimas para preguntas diferentes. Ninguna es automáticamente «el» modelo nulo correcto.
96.22. Comparación del agrupamiento
La red observada tiene
Las medias simuladas son aproximadamente:
para ,
para ,
y para la aleatorización que conserva grados.
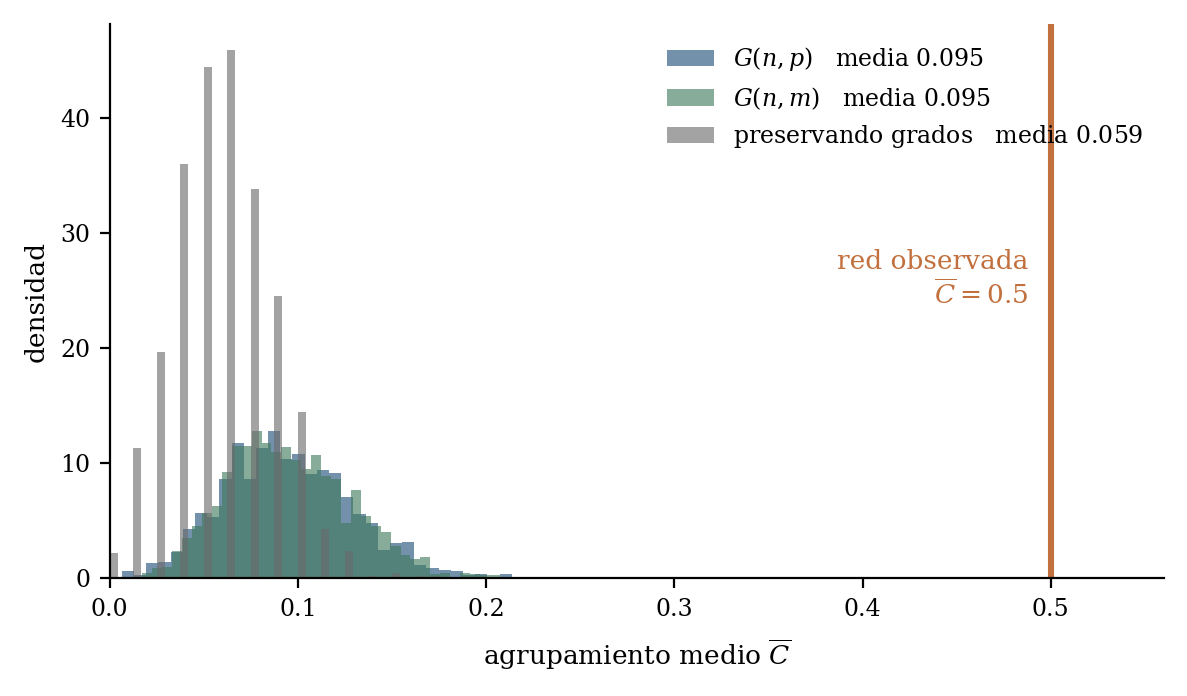
El mismo valor observado adquiere tres comparaciones distintas.
En todas resulta alto, pero la magnitud de la discrepancia depende del conjunto de restricciones.
96.23. Comparación del número de triángulos
La red observada contiene
El promedio del ensamble es cercano a
En es aproximadamente
En la referencia preservadora de grado es cercano a
Preservar grados reduce la cantidad típica de triángulos en este ejemplo porque elimina la heterogeneidad de grado de las referencias anteriores.
La conclusión no es que preservar grados «siempre» reduzca triángulos.
Es una propiedad de esta red y de estos ensambles.
96.24. Estadística de referencia
Sea
una métrica de la red observada.
Generamos
desde el modelo de referencia y calculamos
Podemos estimar:
y
Entonces una estandarización posible es
96.25. Un z-score no convierte el modelo nulo en verdad
Un valor grande de indica que la métrica observada está lejos de la distribución simulada en unidades de su desviación estándar.
Ese valor no acredita cuál fue el mecanismo generador real. Puede significar que la red tiene una estructura no preservada por el modelo, que el modelo de referencia omite una restricción relevante, que la estadística sigue una distribución poco gaussiana o que la red observada pertenece a otra clase estructural.
El z-score resume la discrepancia respecto de una referencia, sin identificar causalmente su origen.
96.26. Probabilidad empírica Monte Carlo
Para una prueba unilateral superior podemos contar cuántas réplicas satisfacen
Si ese número es , una estimación conservadora habitual es
en vez de utilizar simplemente .
La corrección evita declarar probabilidad exactamente cero cuando ninguna de las simulaciones superó el valor observado.
Con
la menor probabilidad empírica posible mediante esta fórmula es
La resolución inferencial está limitada por el número de simulaciones.
96.27. El número de réplicas es otra capa Monte Carlo
C87 mostró que la precisión Monte Carlo mejora como una potencia de .
Lo mismo ocurre aquí.
La distribución del modelo de referencia puede estar matemáticamente bien definida y aun así ser aproximada con ruido si generamos pocas redes.
Aumentar reduce ese ruido computacional y deja intacta una mala elección del modelo de referencia. Esta es la misma separación que apareció en el bootstrap de C89:
96.28. Una referencia puede fijar una propiedad que queremos estudiar
Supongamos que queremos saber si la varianza de grado observada es inusual.
Si utilizamos un ensamble que preserva exactamente todos los grados, entonces
es idéntica en todas las réplicas.
La distribución de referencia degenera en un único valor.
Ese modelo no puede evaluar si la secuencia de grados es sorprendente porque la ha incorporado como restricción.
Eso no constituye un fallo del modelo. Simplemente responde a una pregunta posterior, la de qué otras propiedades resultan inusuales dado el grado.
96.29. La restricción adecuada depende de la hipótesis
Supongamos que una red tiene alto clustering.
Si comparamos con , parte de la diferencia podría deberse a una secuencia de grados muy heterogénea.
Si preservamos los grados y la diferencia persiste, hemos eliminado esa explicación concreta.
Podemos interpretar el proceso como una escalera de referencias:
Cada modelo condiciona en más información.
La discrepancia restante se atribuye a estructura no capturada por esas restricciones, no automáticamente a un mecanismo específico.
96.30. Modelo de configuración
Otra familia fundamental preserva una secuencia de grados mediante «semienlaces» o stubs.
Cada nodo recibe stubs y estos se emparejan aleatoriamente.
El procedimiento básico puede generar:
y
Por tanto, produce naturalmente un multigrafo.
Si la red empírica es simple, eliminar lazos o fusionar multiaristas puede alterar la secuencia de grados.
Condicionar en simplicidad o utilizar algoritmos especializados exige cuidado.
96.31. Preservar grados no especifica automáticamente una distribución uniforme
Decir «aleatorizamos conservando los grados» todavía no describe completamente el ensamble.
Un algoritmo de intercambios puede visitar grafos con probabilidades distintas si no satisface las condiciones necesarias de muestreo y mezcla.
Además, una cadena de intercambios demasiado corta puede conservar memoria excesiva de la red inicial.
En el paquete reproducible utilizamos intercambios dobles como referencia práctica didáctica.
No afirmamos que las 1000 réplicas sean una muestra exacta e independiente de la distribución uniforme sobre todos los grafos simples 4-regulares.
En análisis formal, la calidad del muestreador debe auditarse.
96.32. Mezcla del algoritmo de intercambios
Una referencia basada en Markov chain edge switching necesita tiempo para explorar su espacio de estados.
Si realizamos solo uno o dos intercambios, la red resultante será casi idéntica a la observada.
Aumentar el número de swaps reduce esa dependencia inicial, pero no existe una regla universal de «30 swaps por arista» que demuestre mezcla para cualquier secuencia.
La convergencia debe estudiarse respecto de la aplicación y del algoritmo concreto.
Esta cautela es análoga a la de C69, porque una salida numérica puede parecer aleatoria sin haber explorado correctamente el objeto matemático deseado.
96.33. Conectividad como posible restricción
Una red observada puede ser conectada.
¿Debe la referencia conservar conectividad? La respuesta depende del caso.
Si preguntamos si la conectividad misma es sorprendente, no debemos imponerla.
Si calculamos una estadística definida solo en grafos conectados y queremos comparar condicionando en que la red sea conectada, puede ser razonable conservarla o condicionar en ella.
Estas dos preguntas son distintas:
frente a
El modelo de referencia debe declarar cuál utiliza.
96.34. Distancias en referencias desconectadas
Con grado medio cercano a cuatro y solo 40 nodos, algunas realizaciones o pueden ser desconectadas.
Entonces la distancia media clásica sobre todos los pares no está definida como número finito.
El paquete registra por separado la fracción de redes conectadas y calcula distancia media solo cuando la realización es conectada.
Además utiliza eficiencia global, que asigna contribución cero a pares no alcanzables mediante
No debemos comparar una distancia condicionada silenciosamente con una métrica calculada sobre todas las realizaciones.
96.35. Una referencia aleatoria también tiene estructura
Un contiene fluctuaciones de grado, triángulos, componentes y caminos.
Un también.
Una red aleatoria tiene propiedades típicas derivadas de sus restricciones y de la aleatoriedad, lejos de ser una estructura sin estructura.
La función del modelo de referencia es generar el tipo de estructura que consideramos explicable por esas reglas básicas.
La red observada se compara con esa distribución típica.
96.36. Hasta dónde conviene restringir un modelo
Podríamos seguir preservando los grados, el número de triángulos, las componentes, la distribución de pesos, los atributos de nodo o las distancias espaciales.
Si preservamos la propia estadística que queremos explicar, sin embargo, la comparación deja de ser informativa para esa pregunta.
Además, cada restricción reduce el espacio de grafos posibles.
Un buen modelo de referencia conserva las características consideradas irrelevantes para la hipótesis y permite variar la estructura que queremos evaluar.
El objetivo es preservar lo correcto para la pregunta, no todo lo que podría preservarse.
96.37. Múltiples métricas y selección retrospectiva
Supongamos que calculamos cien propiedades de una red y luego destacamos solo la que produjo el z-score más extremo.
Aunque cada comparación use un modelo de referencia correcto, la selección retrospectiva introduce un problema de multiplicidad.
Lo mismo ocurrió con motivos en C94.
Una estrategia exploratoria puede identificar candidatos.
Una afirmación confirmatoria debería declarar qué métricas se evaluaron y, cuando corresponda, ajustar la inferencia a esa búsqueda.
El modelo nulo no elimina el problema de selección de hipótesis.
96.38. El valor de una discrepancia estructural
Si el agrupamiento observado es mucho mayor que en un ensamble que preserva grados, podemos afirmar de forma descriptiva que el cierre triangular excede lo esperado bajo esa referencia condicionada en la secuencia de grados. Esa es una afirmación precisa.
Reemplazarla por la existencia de cierre triádico como mecanismo generador sería otra cosa. La primera es una comparación estructural y la segunda una hipótesis causal o temporal sobre la formación de aristas.
C94 ya mostró que varias dinámicas pueden producir clustering alto.
96.39. Comparar referencias como análisis de sensibilidad
No tenemos que elegir siempre un solo modelo nulo.
Puede ser más informativo calcular la misma métrica bajo varias referencias justificadas.
En nuestro ejemplo:
y
forman una secuencia útil.
Si una conclusión desaparece al preservar grados, la heterogeneidad de conexiones explicaba una parte esencial de la discrepancia.
Si persiste, debemos buscar estructura de orden superior.
Comparar referencias revela qué restricción absorbe el resultado.
96.40. Una referencia es una pregunta condicional
Puede ser útil escribir explícitamente qué estamos condicionando.
En , la comparación tiene la forma conceptual
En una referencia que preserva grados,
La segunda distribución condiciona en más información que la primera.
Por eso sus probabilidades son respuestas a preguntas diferentes, antes que dos estimaciones rivales de una única cantidad verdadera.
Este lenguaje ayuda a evitar una frase ambigua como «la probabilidad de observar esta red por azar».
Una red completa puede tener probabilidad minúscula bajo casi cualquier modelo cuando el espacio de grafos es enorme. La pregunta útil suele referirse a una estadística:
condicionada en restricciones estructurales concretas.
También evita tratar «azar» como una explicación sustantiva. Lo aleatorio está definido por el modelo y por aquello que decidimos mantener fijo.
96.41. Auditar que el generador preserve lo que promete
Antes de interpretar un ensamble de referencia debemos verificar su implementación.
Si utilizamos , toda réplica debe satisfacer exactamente
Si utilizamos intercambios que preservan grados, cada réplica debe reproducir exactamente
No basta con que el promedio de los grados sea parecido. El paquete comprueba estas restricciones en todas las realizaciones.
También verifica que las propiedades que deberían variar realmente varíen. En la referencia preservadora de grado, clustering y triángulos presentan dispersión positiva.
Si una estadística que esperábamos aleatorizar permanece constante, quizá la hayamos preservado involuntariamente mediante las restricciones.
La verificación del ensamble es análoga a la validación de un simulador en C87, porque antes de interpretar una distribución Monte Carlo debemos comprobar qué distribución estamos generando.
96.42. Incertidumbre de la red observada y aleatoriedad del modelo nulo son distintas
Hasta ahora tratamos
como un grafo conocido exactamente.
En aplicaciones reales, las aristas pueden tener falsos negativos, falsos positivos, umbrales de detección o incertidumbre temporal.
El ensamble nulo responde a la variabilidad de grafos bajo una hipótesis de referencia.
No incorpora automáticamente incertidumbre sobre si el propio grafo observado fue reconstruido correctamente.
Podemos tener dos capas:
y después
La primera flecha pertenece al proceso de medición.
La segunda pertenece al modelo de referencia.
Si la incertidumbre de medición es grande, un z-score extremadamente preciso condicionado en puede dar una falsa impresión de certeza sobre la estructura latente.
Una estrategia más completa puede repetir el análisis bajo redes observadas plausibles o incorporar un modelo probabilístico de detección de aristas.
96.43. Qué debería acompañar una comparación con redes aleatorias
Un resultado reproducible debería declarar, como mínimo:
- qué objetos son los nodos;
- qué regla define las aristas;
- qué estadística observada se evalúa;
- cuál es el modelo de referencia;
- qué propiedades fija exactamente;
- qué propiedades fija solo en esperanza;
- cuántas realizaciones se generaron;
- cómo se manejaron redes desconectadas;
- qué algoritmo se utilizó para muestrear el ensamble;
- qué diagnóstico de mezcla se aplicó si hubo una cadena de intercambios;
- si la prueba fue unilateral o bilateral;
- cómo se estimó la probabilidad Monte Carlo.
También conviene reportar la distribución de referencia, no solo un valor .
La media y desviación estándar permiten evaluar magnitud de la discrepancia. Los cuantiles muestran asimetría o colas. La visualización puede revelar si el valor observado está lejos de una distribución unimodal o si la referencia misma tiene una estructura compleja.
Un único número final puede ocultar información importante sobre el ensamble que le da significado.
96.44. Verificación computacional
El paquete construye una red observada con
Confirma:
y varianza de grado cero.
Para , verifica analíticamente:
y
Las simulaciones reproducen la media y desviación estándar teóricas del número de aristas y la varianza binomial de grado.
En , las 1500 realizaciones tienen exactamente 80 aristas. El grado medio sigue siendo cuatro, pero la varianza de grado permanece positiva y coincide con la predicción hipergeométrica.
En las 1000 aleatorizaciones preservadoras de grado, toda réplica mantiene exactamente la secuencia , mientras clustering y triángulos siguen variando.
El clustering observado supera ampliamente las tres distribuciones de referencia y la probabilidad empírica unilateral es inferior a 0.01 en cada una con la resolución Monte Carlo disponible.
Se ejecutaron 33 comprobaciones automáticas y las 33 resultaron satisfactorias.
96.45. Qué queda establecido
Una red aleatoria es una distribución de probabilidad sobre grafos.
El modelo fija y una probabilidad independiente por arista; el número total de aristas fluctúa.
El modelo fija exactamente y , introduciendo dependencia entre indicadores de aristas.
Una referencia que preserve la secuencia de grados condiciona en todavía más estructura y permite preguntar qué propiedades exceden lo explicable por esa secuencia.
No existe un modelo nulo universal. La referencia correcta depende de qué consideramos dado y qué propiedad queremos evaluar.
Los z-scores y probabilidades empíricas cuantifican discrepancia respecto del modelo elegido. No demuestran por sí solos el mecanismo real que generó la red.
C97 estudiará las redes de mundo pequeño, con su agrupamiento y sus distancias cortas. Allí utilizaremos modelos de referencia para separar dos propiedades que pueden coexistir de manera no trivial, el fuerte agrupamiento local y los recorridos globales cortos.
Referencias
- Erdős, P., & Rényi, A. (1959). On random graphs I. Publicationes Mathematicae Debrecen, 6, 290–297.
- Fosdick, B. K., Larremore, D. B., Nishimura, J., & Ugander, J. (2018). Configuring random graph models with fixed degree sequences. SIAM Review, 60(2), 315–355. https://doi.org/10.1137/16M1087175
- Gilbert, E. N. (1959). Random graphs. Annals of Mathematical Statistics, 30(4), 1141–1144. https://doi.org/10.1214/aoms/1177706098
- Newman, M. E. J. (2010). Networks: An Introduction. Oxford University Press.
- Newman, M. E. J., Strogatz, S. H., & Watts, D. J. (2001). Random graphs with arbitrary degree distributions and their applications. Physical Review E, 64, 026118. https://doi.org/10.1103/PhysRevE.64.026118
Recursos reproducibles
Descargar recursos del capítulo (ZIP, 332 kB).
6 archivos CSV · 4 figuras · 1 programa Python.
El programa se ha ejecutado en una carpeta vacía y genera los archivos de datos y figuras incluidos en el paquete.