81.1. De una trayectoria a un conjunto de posibilidades
Durante los primeros ochenta capítulos hemos trabajado principalmente con sistemas en los que, una vez fijados el estado inicial y los parámetros, las reglas determinan la evolución. Incluso cuando aparecía caos, la incertidumbre sobre una trayectoria no significaba necesariamente que la dinámica fuese aleatoria. C57 y C68 mostraron que un sistema determinista puede amplificar perturbaciones. C69 añadió que una simulación numérica tiene sus propias limitaciones. C80 cerró el módulo distinguiendo el objeto matemático, la muestra y el procedimiento de estimación.
El Módulo 9 introduce un lenguaje diferente. A la pregunta por el estado que sigue a otro se suma ahora la pregunta por el conjunto de resultados que consideramos posibles y por la manera en que distribuimos probabilidad sobre ellos.
La probabilidad puede entrar en un modelo por razones distintas. Un mecanismo puede contener fluctuaciones que decidimos representar estocásticamente. En otros casos ignoramos las variables microscópicas y modelamos solo su efecto agregado, o seleccionamos al azar una unidad de una población. También cabe usar una distribución para representar incertidumbre sobre un estado que existe pero no conocemos exactamente.
Estas situaciones no son ontológicamente idénticas. El formalismo probabilístico, sin embargo, permite tratarlas mediante una estructura común. Lo importante es declarar qué representa la distribución en cada modelo.
C81 desarrollará esa estructura desde sus fundamentos. El capítulo se ocupa de qué objeto matemático es una distribución, de cómo se construye una distribución conjunta y de por qué conocer las distribuciones de las partes no determina necesariamente la distribución del sistema completo. La nomenclatura de familias concretas queda para más adelante.
81.2. El espacio probabilístico
La formulación moderna parte de una terna
El conjunto es el espacio muestral. Sus elementos representan resultados elementales posibles del experimento o modelo.
La colección es una -álgebra de subconjuntos de . Sus elementos son los eventos a los que el modelo asigna probabilidad.
La función
es una medida de probabilidad.
Debe satisfacer tres condiciones.
y, si son eventos mutuamente disjuntos,
La tercera propiedad es la aditividad numerable. De estas condiciones se derivan muchas reglas familiares. Por ejemplo,
y, para el complemento ,
Si ,
Todas estas relaciones son propiedades del objeto matemático una vez adoptados los axiomas, con independencia de que la probabilidad se interprete como frecuencia, propensión o grado de incertidumbre.
81.3. Operaciones con eventos
Antes de introducir variables aleatorias conviene fijar cómo se combinan los eventos. Si y pertenecen a , también pertenecen su unión, su intersección y sus complementos.
La unión
representa que ocurra al menos uno de los dos eventos. La intersección
representa que ocurran ambos.
Si los eventos no son disjuntos, sumar y cuenta dos veces la región compartida. Por eso
Esta identidad es la primera forma del principio de inclusión-exclusión.
Tomemos dos componentes binarios y definamos
Si
entonces
No sería correcto obtener , porque las realizaciones en que ambos componentes están activos pertenecen simultáneamente a y .
También resulta útil la diferencia de eventos:
En el ejemplo,
Estas operaciones parecen elementales, pero adquieren importancia cuando un «evento del sistema» se construye a partir de muchas condiciones parciales. Un fallo global puede definirse como unión de varios fallos locales, mientras que una configuración específica requiere una intersección. Un criterio de exclusión se expresa mediante complementos.
La probabilidad asignada al evento compuesto depende de su estructura lógica. No basta conocer una lista de probabilidades marginales si no sabemos cómo se superponen los eventos. Esta observación anticipa el papel de la dependencia sin necesitar todavía probabilidad condicional.
81.4. Por qué no basta con usar todos los subconjuntos
En un espacio muestral finito podemos tomar sin dificultad
es decir, todos los subconjuntos.
En espacios continuos la situación es más delicada. Existen subconjuntos de para los que no puede definirse una medida de longitud compatible con todas las propiedades que querríamos conservar. Por eso la teoría no exige asignar probabilidad a absolutamente cualquier subconjunto imaginable.
La -álgebra garantiza, entre otras cosas, que si un evento es medible, también lo son su complemento y las uniones numerables de eventos medibles. En se utiliza habitualmente la -álgebra de Borel, generada por los intervalos abiertos. En teoría de probabilidad suele trabajarse con su completación respecto de la medida correspondiente.
En aplicaciones ordinarias rara vez construiremos una -álgebra explícitamente. Sin embargo, entender su función evita tratar la probabilidad como una operación informal que puede aplicarse sin restricciones a cualquier colección de resultados.
81.5. La variable aleatoria como función sobre el espacio muestral
Una variable aleatoria es una función medible
o, más generalmente, hacia otro espacio de estados.
El resultado elemental es . La variable aleatoria extrae de ese resultado una cantidad que queremos analizar:
Consideremos dos componentes binarios de un sistema. El resultado elemental puede codificar el estado de ambos:
Definimos
Aquí e son funciones definidas sobre el espacio muestral. Identificarlas con el espacio mismo es una confusión frecuente.
También podemos definir una variable agregada que toma valores . La misma realización puede alimentar muchas variables aleatorias distintas. Elegir una variable equivale a decidir qué aspecto del resultado queremos representar.
Esta distinción reaparecerá más adelante. Una distribución sobre estados observados puede perder información sobre el espacio de resultados que la produjo.
81.6. La distribución o ley de una variable
Una variable aleatoria induce una medida de probabilidad sobre sus valores. Su distribución se define mediante
para conjuntos medibles .
Esta operación puede entenderse como transportar la probabilidad desde hacia el espacio donde vive . En lenguaje de teoría de la medida, es la medida imagen o pushforward de por .
Dos modelos con espacios muestrales internos muy diferentes pueden inducir exactamente la misma distribución para una variable observada. Si solo vemos , esos mecanismos pueden ser indistinguibles respecto de esa observación.
Una distribución es, por tanto, una medida de probabilidad sobre el espacio de valores de la variable. Describirla como una lista de frecuencias omite esa estructura.
81.7. Igualdad de variables e igualdad en distribución
C76 ya utilizó el símbolo
para expresar autosimilitud estadística. Ahora podemos precisar qué significa.
Decir
significa que e inducen la misma distribución:
para todo conjunto medible apropiado.
Esto es mucho más débil que afirmar como funciones sobre el espacio muestral.
Consideremos
y definamos, sobre la misma realización,
Entonces también es uniforme en . En efecto, para ,
Por tanto,
Sin embargo, y no son la misma variable. Salvo en el punto ,
Más aún, están ligadas por una relación determinista exacta. Conocer determina .
Este ejemplo contiene dos advertencias. La primera es que una distribución no identifica la realización ni el mecanismo que la produce. La segunda es que dos variables con la misma distribución pueden mantener una dependencia muy fuerte entre sí.
Existe una noción intermedia que aparecerá repetidamente en probabilidad:
Significa
Puede ocurrir que las funciones difieran sobre un conjunto de probabilidad cero y, aun así, sean iguales casi seguramente. Esta igualdad es más fuerte que igualdad en distribución, porque
La implicación inversa es falsa, como muestra frente a .
Separar estas relaciones evita trasladar propiedades de una distribución a una realización concreta sin justificación.
81.8. Variables discretas y función de masa
Una variable discreta toma valores en un conjunto finito o numerable. Su ley puede describirse mediante la función de masa
Debe satisfacer
y
Si una variable puede tomar los valores con probabilidades
entonces
La distribución no tiene por qué asignar probabilidades iguales a los resultados posibles. Tampoco debemos confundir «posible» con «probable». Un estado puede pertenecer al soporte y tener probabilidad muy pequeña.
En un modelo de sistemas, una función de masa puede representar estados categóricos, número de eventos, número de componentes activos o cualquier otra cantidad discretizada.
81.9. Distribución continua y densidad
Una variable continua puede admitir una densidad tal que
La densidad debe satisfacer
y
Hay aquí una fuente habitual de error. La cantidad no es la probabilidad de observar exactamente . Para una distribución absolutamente continua, para todo punto individual.
La densidad incluso puede superar uno. Si
entonces
dentro de ese intervalo. No hay contradicción, porque la probabilidad total es área:
La altura de la densidad depende de las unidades del eje. La probabilidad de un intervalo es adimensional.
81.10. La función de distribución acumulada
Toda variable aleatoria real, sea discreta, continua o mixta, tiene una función de distribución acumulada, o CDF,
La CDF es no decreciente, satisface
y es continua por la derecha.
En una variable discreta aparecen saltos. El tamaño del salto en es
Si la distribución es absolutamente continua,
y donde la derivada existe,
Para una normal estándar,
la probabilidad del intervalo es
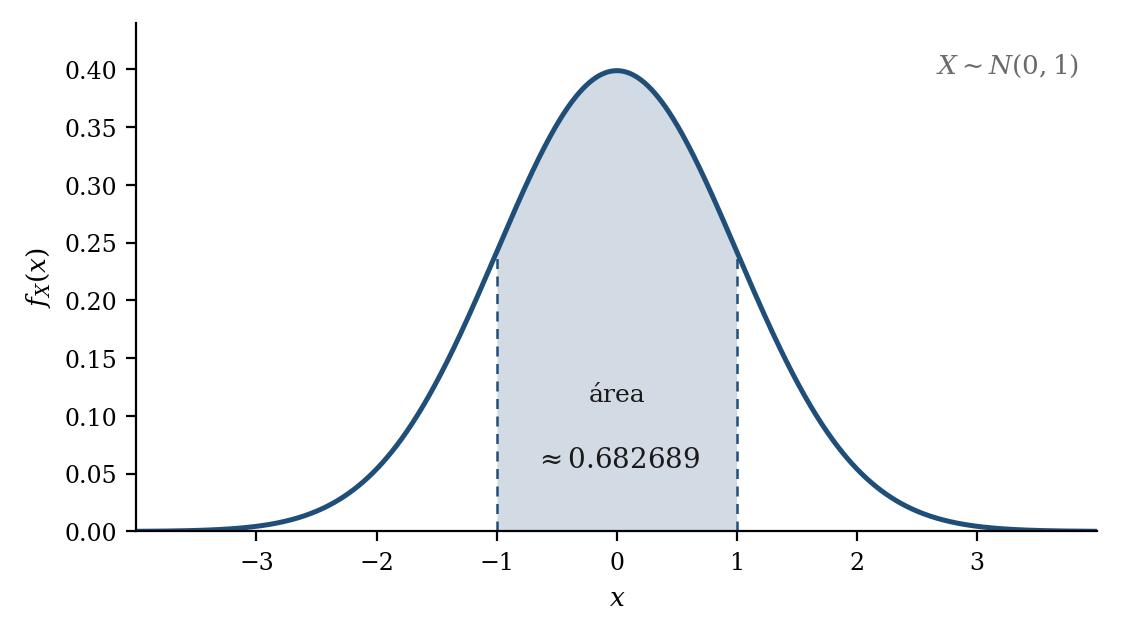
La figura distingue visualmente densidad de probabilidad. La probabilidad corresponde al área bajo la curva.
81.11. Probabilidad cero no significa conjunto vacío
Las distribuciones continuas introducen una distinción que suele resultar extraña al principio.
Si
entonces
Sin embargo, pertenece al soporte de la distribución y es un valor perfectamente compatible con el modelo.
El evento
no es vacío. Simplemente tiene medida de probabilidad cero.
Esto obliga a distinguir
de
El evento imposible es . Un evento nulo puede contener puntos, incluso infinitos puntos, siempre que su medida sea cero.
Por ejemplo, si es uniforme en , el conjunto de números racionales del intervalo es numerable. Como cada punto tiene probabilidad cero y una unión numerable de eventos nulos sigue teniendo probabilidad cero,
Por tanto, con probabilidad uno el valor obtenido es irracional, aunque los racionales sean densos y cualquier intervalo no vacío contenga alguno.
La expresión casi seguramente formaliza esta idea. Una propiedad ocurre casi seguramente si
Esto no exige que incluya literalmente todos los resultados elementales. Su complemento puede ser un conjunto no vacío de probabilidad cero.
La diferencia resulta importante en resultados matemáticos sobre procesos aleatorios. Cuando más adelante digamos que una propiedad se cumple «casi seguramente», no estaremos afirmando que no existe excepción matemática alguna. Afirmaremos que el conjunto de excepciones tiene probabilidad cero bajo la medida del modelo.
Tampoco debe confundirse un evento muy improbable con uno de probabilidad cero. Una probabilidad de es pequeña pero positiva; en repeticiones suficientes puede generar observaciones. Probabilidad cero tiene un significado matemático diferente.
81.12. No toda distribución es puramente discreta o continua
La clasificación discreta/continua es útil, pero no exhaustiva.
Podemos construir una variable que tome exactamente el valor cero con probabilidad y, con probabilidad , se distribuya uniformemente en . Su ley combina una masa puntual y una parte continua.
No existe entonces una única densidad ordinaria respecto de la longitud de Lebesgue que describa toda la distribución. La medida contiene componentes de naturaleza distinta.
Este ejemplo previene una identificación frecuente:
La distribución es el objeto general. Función de masa y densidad son representaciones apropiadas para clases particulares de distribuciones.
81.13. De una variable a un vector aleatorio
En sistemas complejos rara vez basta una sola variable. Consideremos
Su distribución conjunta asigna probabilidad a regiones del espacio de pares:
Si ambas variables son binarias, la distribución conjunta puede representarse mediante una tabla de cuatro probabilidades
con
La distribución conjunta contiene información que las distribuciones individuales no conservan, a saber, cómo aparecen juntos los estados de diferentes componentes. Ese es el punto matemático central del capítulo.
81.14. Marginalizar significa olvidar parte del sistema
A partir de la distribución conjunta obtenemos la distribución marginal de sumando sobre los valores de :
Análogamente,
En una distribución continua conjunta con densidad ,
Marginalizar elimina una coordenada. La operación no es neutra desde el punto de vista informacional, porque distribuciones conjuntas diferentes pueden tener exactamente las mismas marginales. Por eso describir cada componente por separado no reconstruye necesariamente el sistema.
81.15. Independencia
Dos eventos y son independientes si
Dos variables aleatorias e son independientes si, para todos los conjuntos medibles apropiados y ,
En el caso discreto, esto equivale a para todos los pares posibles.
Si existen densidades, casi en todas partes.
La independencia es una propiedad fuerte de factorización de la distribución conjunta. La impresión de que dos variables «parecen poco relacionadas» no equivale a ella.
81.16. Mismas marginales, distinta dependencia
Supongamos
Definamos
La tabla conjunta queda completamente determinada:
Para que todas las probabilidades sean no negativas,
y
Por tanto,
Con nuestros valores,
Las marginales permanecen fijas para cualquier dentro de ese intervalo.
Si e son independientes,
La distribución conjunta es
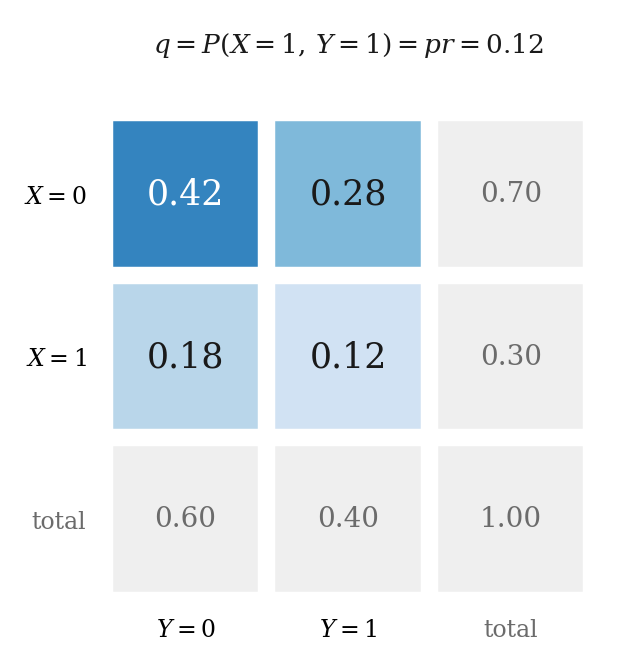
Ahora tomemos
Obtenemos
Las marginales siguen siendo exactamente
Sin embargo, los estados activos aparecen juntos con mucha mayor frecuencia.
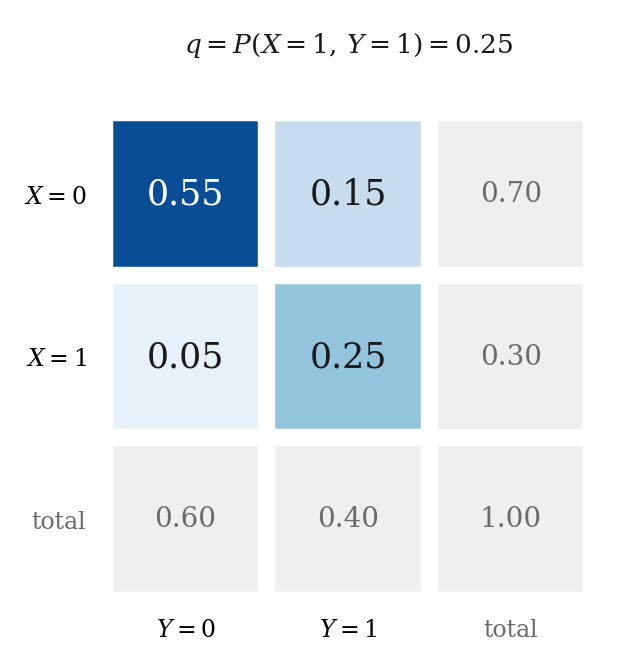
La distribución de cada componente por separado no detecta esta diferencia.
81.17. La dependencia cambia propiedades del sistema agregado
Definamos
La variable cuenta cuántos componentes están activos.
En términos de ,
Bajo independencia, con ,
Con la distribución dependiente ,
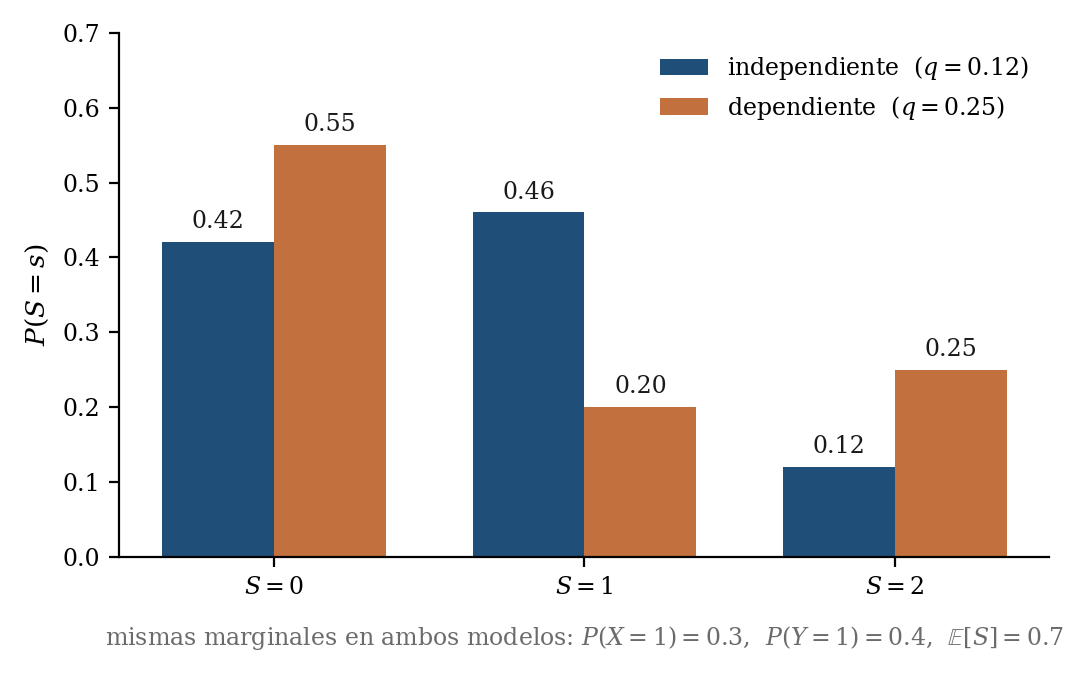
En ambos modelos, un observador que examine solo verá un componente activo el 30 % de las veces. Quien examine solo verá 40 %. Aun así, la probabilidad de que ambos estén activos pasa de 0.12 a 0.25.
La dependencia puede cambiar de forma sustancial el comportamiento colectivo, de modo que tratarla como un detalle añadido a las marginales conduce a error.
81.18. Los límites de Fréchet en el caso binario
El intervalo permitido para ,
muestra que las marginales restringen la dependencia, pero no la fijan.
Para y , no podemos elegir porque entonces lo que sería imposible.
Tampoco podemos elegir .
Los extremos reciben una interpretación útil. El valor máximo concentra tanto como permiten las marginales la ocurrencia conjunta de y . El mínimo reduce esa coincidencia todo lo posible.
En dimensiones y variables más generales, la construcción de distribuciones conjuntas con marginales prefijadas conduce al lenguaje de las cópulas. No desarrollaremos esa teoría aquí. El resultado binario basta para establecer que marginales y dependencia son componentes diferentes de un modelo multivariado.
81.19. Independencia por pares no implica independencia mutua
Con tres variables aparece una sutileza adicional.
Sean y bits independientes y equiprobables:
Definimos
donde es XOR, de modo que si exactamente uno de los dos bits vale uno.
Los cuatro estados posibles son
cada uno con probabilidad .
Tenemos
Además,
y lo mismo ocurre para los pares y .
Las variables son independientes por pares.
Sin embargo,
mientras que la independencia mutua exigiría
Por tanto, no son mutuamente independientes.
El ejemplo es importante porque un sistema puede carecer de dependencias detectables en cada par y, aun así, obedecer una restricción conjunta exacta de orden superior.
81.20. Dependencia estadística no equivale a interacción causal
Si e son dependientes, la distribución conjunta no factoriza. Esa afirmación es probabilística y no dice por sí sola por qué ocurre la dependencia.
La dependencia puede aparecer porque influye sobre , porque influye sobre , porque ambas responden a una tercera variable, porque existe selección de observaciones o porque el propio diseño del muestreo induce asociación.
Tampoco la independencia observada en un modelo reducido demuestra ausencia de mecanismos comunes. Un sistema puede contener interacciones que se cancelen en una distribución particular o en una escala determinada.
La teoría causal necesitará información adicional sobre intervenciones, estructura temporal y supuestos de identificación. Ese problema llegará mucho más adelante. En C81 basta con preservar la frontera conceptual:
81.21. Distribución del modelo y muestra observada
Una distribución es un objeto matemático. Una muestra es una realización finita producida bajo ese modelo.
Si simulamos pares desde la distribución independiente, las frecuencias empíricas se acercan a
pero no tienen por qué coincidir exactamente.
El paquete reproducible realiza esa simulación y conserva las frecuencias observadas. El error máximo absoluto respecto de las probabilidades teóricas resulta inferior a 0.004 tanto en el modelo independiente como en el dependiente.
No utilizamos esta concordancia como demostración de la distribución teórica. La distribución fue especificada antes de simular. La muestra sirve para comprobar que el algoritmo de generación implementa correctamente esa ley dentro de la variabilidad finita.
La dirección lógica importa:
Cuando trabajemos con datos reales tendremos el problema inverso:
Ese segundo problema requiere herramientas adicionales.
81.22. Probabilidad como capa de modelamiento
Un sistema determinista puede estudiarse probabilísticamente si desconocemos su estado inicial y representamos ese desconocimiento mediante una distribución. Un sistema estocástico puede tener, además, reglas cuya propia evolución incluya variables aleatorias. Los dos casos pueden producir ecuaciones probabilísticas parecidas, pero la interpretación del azar es diferente.
También es posible que la distribución describa una población antes que una evolución temporal. Si elegimos una persona al azar de una población, la variable aleatoria puede representar una característica de esa unidad. No existe ninguna obligación de imaginar que la persona «fluctúa» entre valores.
Esta flexibilidad amplía el alcance del formalismo y, al mismo tiempo, lo vuelve riesgoso cuando se omite qué aleatorización se está representando.
Antes de escribir
conviene poder responder:
- ¿qué representa una realización?;
- ¿qué permanece fijo entre realizaciones?;
- ¿qué mecanismo o procedimiento genera la variabilidad?;
- ¿qué variables se modelan conjuntamente?;
- ¿qué dependencias se están asumiendo?
La notación compacta no sustituye estas decisiones.
81.23. Regla determinista con entrada aleatoria
La introducción de probabilidad no obliga a abandonar las funciones deterministas estudiadas en módulos anteriores.
Supongamos que una variable aleatoria tiene distribución y que aplicamos una regla determinista
Una vez conocido , el valor de está completamente determinado. La incertidumbre sobre proviene de la distribución de entrada y de cómo reorganiza sus valores.
La distribución de salida satisface
Esta es nuevamente una medida imagen.
Tomemos un ejemplo simple:
La transformación elimina el signo. Para ,
Como es uniforme en un intervalo de longitud dos,
Derivando para ,
La densidad de salida no es uniforme. Una función determinista puede concentrar probabilidad porque intervalos distintos del espacio de entrada se proyectan sobre regiones de tamaño diferente en la salida.
Este cálculo conecta probabilidad con el lenguaje de mapas. En C51 estudiamos iteraciones
Si ahora el estado inicial se modela como variable aleatoria, entonces también es una variable aleatoria. La función puede seguir siendo completamente determinista, mientras la distribución de estados evoluciona.
Después de iteraciones,
Podemos preguntar tanto por una trayectoria concreta, condicionada a , como por la distribución de cuando varía según una ley.
Esta separación evita una confusión frecuente. Observar una distribución de resultados no demuestra que la regla dinámica sea estocástica, porque esa distribución puede provenir de incertidumbre inicial propagada por una transformación determinista.
En sistemas caóticos esa distinción adquiere especial importancia. Una pequeña distribución inicial puede estirarse y plegarse bajo la dinámica. Seguir la distribución y seguir una trayectoria responden a preguntas distintas, aunque ambas utilicen el mismo mapa subyacente.
Más adelante aparecerán procesos cuya propia regla de transición será probabilística. C81 solo necesita establecer el caso más elemental, en el que el azar en la entrada y el determinismo en la regla resultan compatibles dentro de un mismo modelo.
81.24. Verificación computacional
El paquete reproducible ejecuta controles analíticos y numéricos.
Primero comprueba las cotas del parámetro la no negatividad de las cuatro probabilidades y la normalización de las dos distribuciones conjuntas. Verifica que ambos modelos tienen exactamente las mismas marginales y que solo el primero satisface
Después calcula la distribución de y confirma que la dependencia modifica las probabilidades del agregado aunque las marginales permanezcan invariantes.
La simulación genera realizaciones de cada distribución conjunta y contrasta las frecuencias empíricas con las probabilidades teóricas.
Para el ejemplo continuo, el código compara la integral numérica de la densidad normal en con la diferencia de la función acumulada y recupera
También verifica que una uniforme sobre puede tener densidad manteniendo integral total uno.
Finalmente enumera los cuatro estados del ejemplo XOR y demuestra computacionalmente las tres independencias por pares, junto con el fracaso de la independencia mutua.
Se ejecutaron 34 comprobaciones automáticas y las 34 resultaron satisfactorias.
81.25. Qué queda establecido
Una distribución de probabilidad es una medida sobre resultados o sobre los valores de variables aleatorias. La función de masa y la densidad son representaciones particulares, mientras la función acumulada existe para toda variable real.
En sistemas multivariados, la distribución conjunta contiene información que desaparece al marginalizar. Dos modelos pueden compartir todas las distribuciones individuales y diferir radicalmente en cómo aparecen juntos los estados.
La independencia es una condición de factorización, distinta tanto de una impresión visual como de una afirmación causal. Independencia por pares y dependencia conjunta de orden superior pueden además coexistir.
Una consecuencia metodológica merece quedar explícita. Cuando un modelo probabilístico forma parte de una explicación de sistemas complejos, especificar solo las distribuciones marginales equivale a describir las piezas sin decir cómo se organizan conjuntamente. Esa omisión puede ser irrelevante para algunas preguntas y decisiva para otras. La elección correcta depende del observable. Si solo interesa una variable aislada, la marginal puede bastar; si interesan concurrencia, agregación, extremos conjuntos o coordinación, la estructura de dependencia pasa a formar parte del modelo mínimo necesario.
Estas ideas serán la base del resto del módulo. C82 introducirá la probabilidad condicional, la verosimilitud y el teorema de Bayes en su forma elemental. Allí una distribución conjunta dejará de ser solamente una descripción simultánea. Aprenderemos cómo restringirla cuando se conoce información sobre una parte del sistema y cómo invertir, bajo supuestos explícitos, la relación entre hipótesis y datos.
Referencias
- Billingsley, P. (1995). Probability and Measure (3rd ed.). Wiley.
- Grimmett, G. R., & Stirzaker, D. R. (2001). Probability and Random Processes (3rd ed.). Oxford University Press. https://doi.org/10.1093/oso/9780198572237.001.0001
- Kallenberg, O. (2021). Foundations of Modern Probability (3rd ed.). Springer. https://doi.org/10.1007/978-3-030-61871-1
- Kolmogorov, A. N. (1956). Foundations of the Theory of Probability (2nd English ed., N. Morrison, Trans.). Chelsea Publishing.
- Nelsen, R. B. (2006). An Introduction to Copulas (2nd ed.). Springer. https://doi.org/10.1007/0-387-28678-0
- Pitman, J. (1993). Probability. Springer. https://doi.org/10.1007/978-1-4612-4374-8
Recursos reproducibles
Descargar recursos del capítulo (ZIP, 209 kB).
5 archivos CSV · 4 figuras · 1 programa Python.
El programa se ha ejecutado en una carpeta vacía y genera los archivos de datos y figuras incluidos en el paquete.