90.1. La pregunta
El Módulo 9 ha construido una secuencia completa que va de las distribuciones y la dependencia al condicionamiento, Bayes, los momentos, las familias probabilísticas, la heterogeneidad, las leyes límite, Monte Carlo, las colas y el bootstrap. El cierre debe reunir esas piezas en un solo problema.
Construiremos un sistema sintético con tres variables binarias:
La variable define dos estratos.
Dentro de cada estrato haremos que
Por tanto, dentro de y dentro de , e serán exactamente independientes.
Después eliminaremos de la descripción y analizaremos solo la tabla marginal de e .
El resultado será una asociación fuerte, surgida porque la mezcla de estratos será diferente entre y , sin que intervenga ningún error de cálculo ni ruido de muestreo.
El objetivo es comprender, paso por paso, cómo puede ocurrir eso.
90.2. Construcción del sistema
Tomemos
Dentro de , fijamos
y
Además imponemos independencia condicional:
Dentro de , fijamos
y otra vez
El estrato tiene tasas altas tanto de como de , mientras el estrato las tiene bajas.
La relación entre e dentro de cada estrato es nula.
90.3. Una población sintética exacta de 10.000 unidades
Para evitar que el fenómeno dependa de azar muestral, construiremos exactamente
observaciones compatibles con esas probabilidades.
Cada estrato contiene 5000 unidades.
En , donde las probabilidades de y son 0.2, la tabla es:
| Total | |||
|---|---|---|---|
| 3200 | 800 | 4000 | |
| 800 | 200 | 1000 | |
| Total | 4000 | 1000 | 5000 |
En :
| Total | |||
|---|---|---|---|
| 200 | 800 | 1000 | |
| 800 | 3200 | 4000 | |
| Total | 1000 | 4000 | 5000 |
Las frecuencias son exactas y no provienen de una simulación.
90.4. Verificar independencia en
En el primer estrato,
También,
La diferencia de riesgos es
El odds ratio es
La correlación binaria también es cero.
No existe asociación entre e dentro de .
90.5. Verificar independencia en
En el segundo estrato,
Para ,
Por tanto,
y la correlación condicional también es cero.
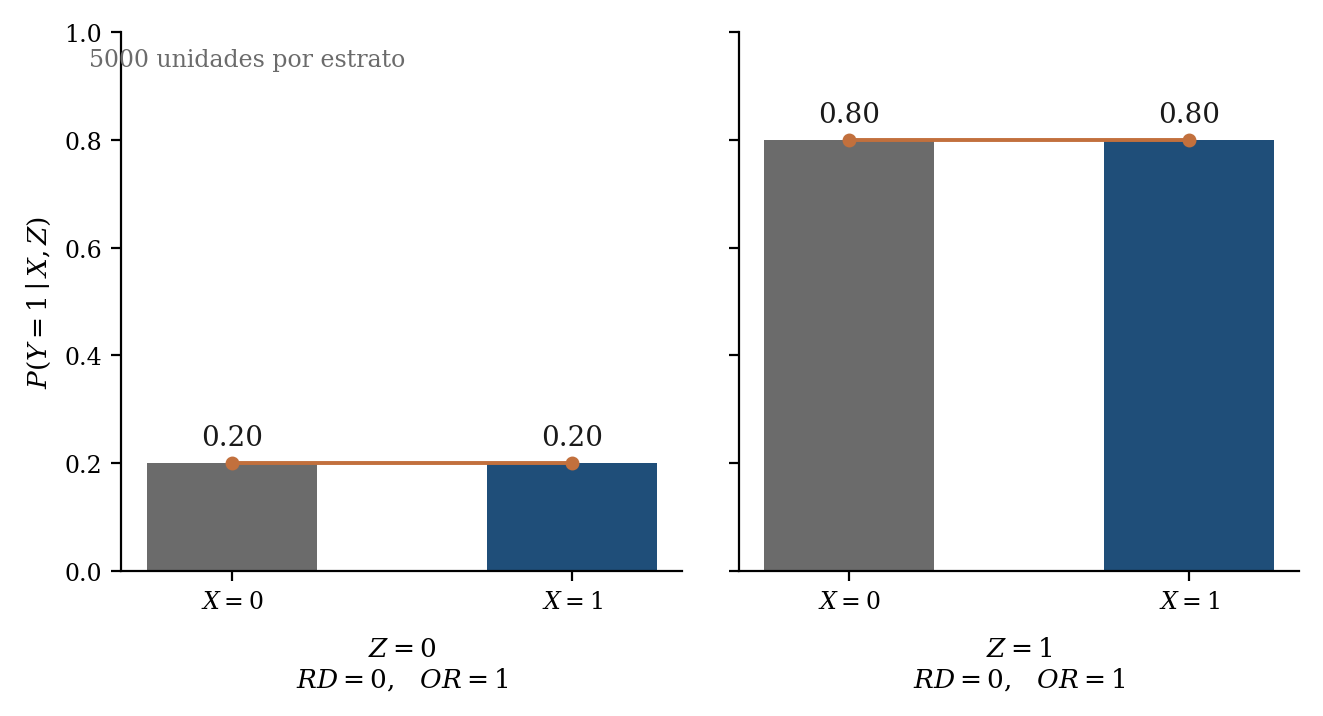
Los dos estratos son internamente coherentes, porque dentro de cada uno depende del estrato y deja de depender de .
90.6. Eliminar
Ahora sumemos las dos tablas.
Obtenemos:
| Agregado | Total | ||
|---|---|---|---|
| 3400 | 1600 | 5000 | |
| 1600 | 3400 | 5000 | |
| Total | 5000 | 5000 | 10000 |
La tabla marginal parece describir una relación fuerte.
Entre quienes tienen ,
Entre quienes tienen ,
Entonces
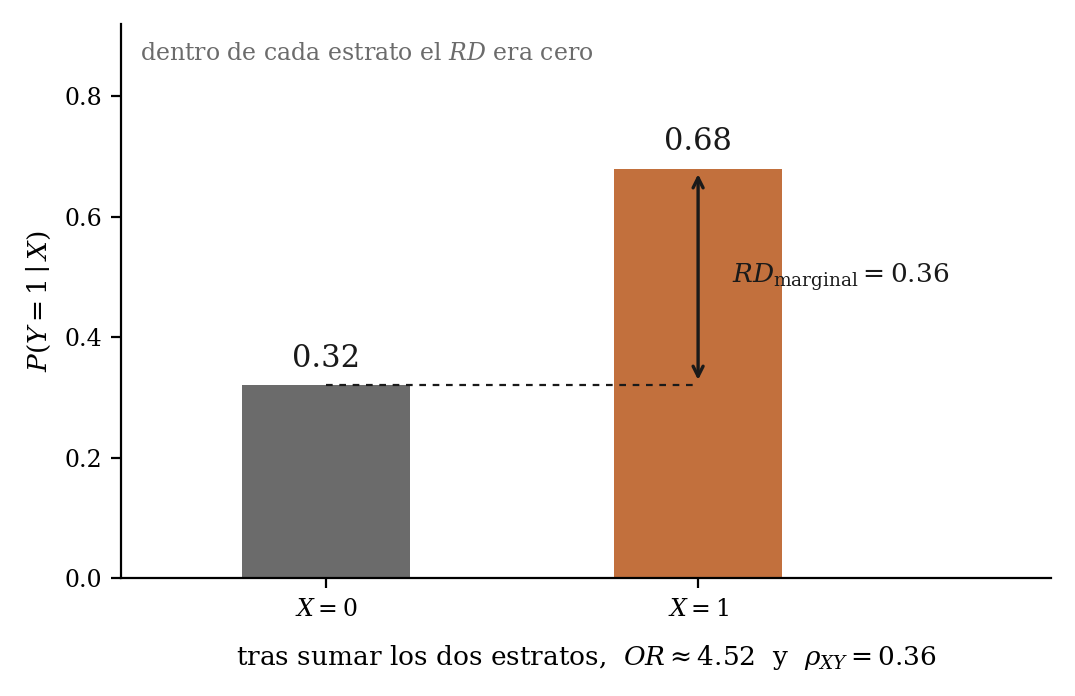
Dentro de cada estrato la diferencia era cero. Después de agregar, es 0.36.
90.7. La misma discrepancia con odds ratio
La tabla agregada produce
Por tanto,
Dentro de cada estrato,
El cambio va mucho más allá de una corrección de escala. La asociación marginal es fuerte según varias medidas:
y la correlación de Pearson para las variables binarias es
Las tres medidas coinciden, de modo que el fenómeno no depende de la métrica elegida.
90.8. ¿De dónde salió?
La clave está en la composición de .
Entre las unidades con ,
Entre las unidades con ,
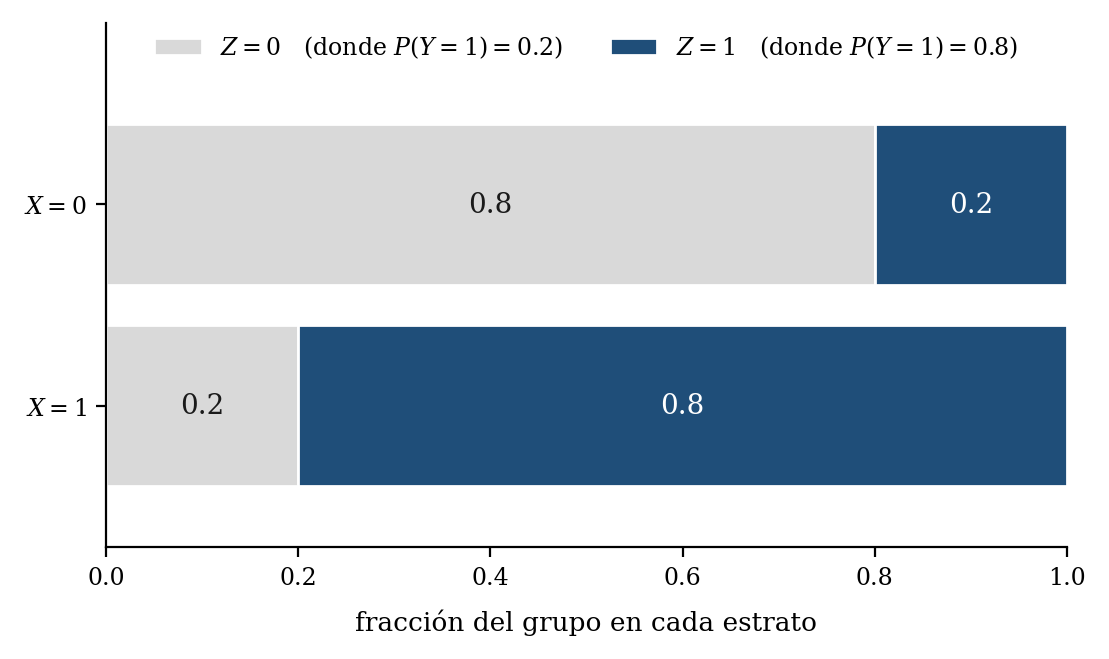
Por tanto, los dos grupos definidos por contienen mezclas muy distintas.
El grupo está compuesto principalmente por el estrato donde es frecuente.
El grupo está compuesto principalmente por el estrato donde es infrecuente.
La tasa marginal de hereda esa diferencia de composición.
90.9. Derivación mediante probabilidad total
Como
tenemos
Para ,
Sustituyendo,
Así,
Para ,
La asociación marginal aparece porque los pesos de mezcla son distintos.
90.10. Una fórmula compacta para la diferencia de riesgos
Definamos
Bajo independencia condicional,
Entonces
satisface
En nuestro caso,
y
Por tanto,
La asociación marginal es literalmente el producto de dos diferencias entre estratos.
90.11. La ley de covarianza total
C83 introdujo
Existe una descomposición condicional:
El primer término resume asociación dentro de estratos.
El segundo resume asociación entre sus medias.
En nuestro caso,
y
Por tanto,
Toda la covarianza marginal debe proceder del segundo término.
90.12. Calcular la covarianza entre estratos
Tenemos
También,
Las medias marginales son
Entonces
es
Por tanto,
La covarianza marginal calculada directamente también es
La descomposición es exacta:
90.13. Fórmula general para dos estratos
Supongamos
Definamos
Si
entonces el término dentro de estratos es cero.
La covarianza marginal queda reducida a
Esta identidad resume el mecanismo.
Si e aumentan ambos al pasar de a , la covarianza marginal es positiva.
Si uno aumenta y el otro disminuye, será negativa.
Si cualquiera de las dos variables tiene la misma tasa en ambos estratos, el término de composición desaparece.
La asociación marginal puede surgir sin ninguna asociación condicional.
90.14. Estandarizar la mezcla
Podemos hacer una pregunta diferente.
¿Qué ocurriría si comparáramos y bajo la misma distribución de ?
Utilicemos como población estándar
Para ,
Para ,
Por tanto,
Al igualar la composición del estrato, desaparece la asociación.
90.15. Reponderar de forma continua
No necesitamos pasar bruscamente de la mezcla observada a una composición 50/50.
Definamos un parámetro
Cuando
conservamos las composiciones observadas:
Cuando forzamos ambos grupos a 0.5.
El paquete interpola linealmente esos pesos.
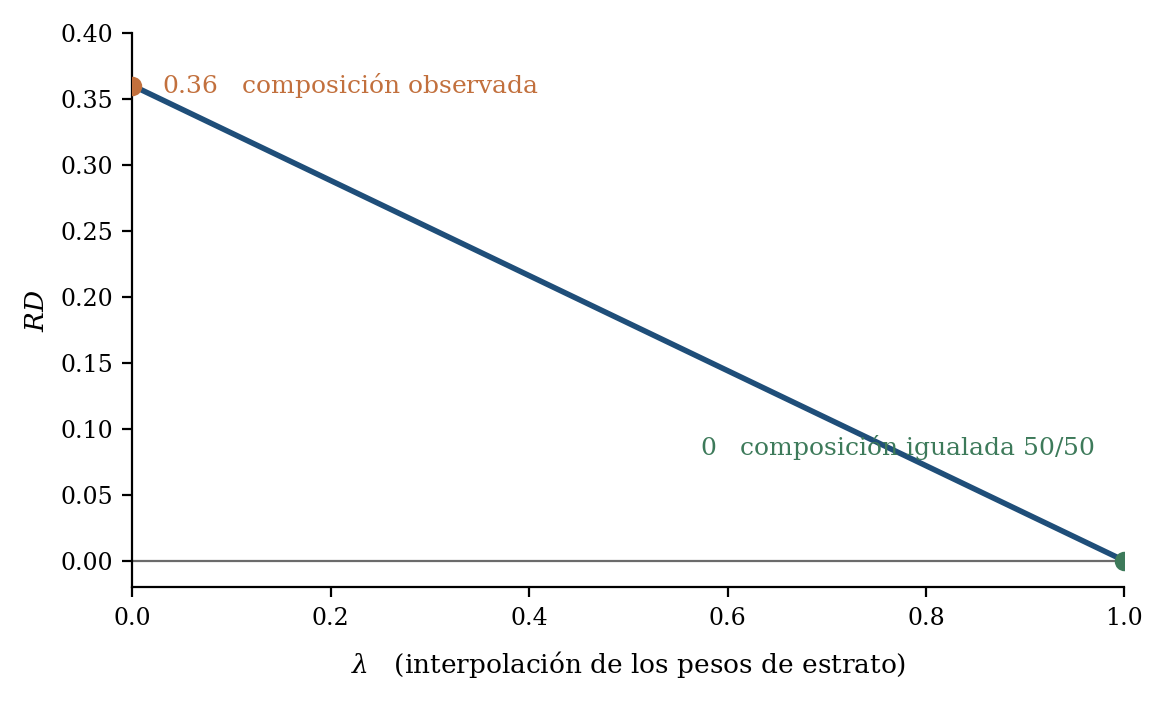
La diferencia de riesgos disminuye continuamente desde 0.36 hasta 0.
La asociación agregada puede verse como una función de cómo mezclamos los estratos.
90.16. El fenómeno no depende de una relación residual dentro de estratos
Podemos realizar una prueba adicional.
Dentro de cada estrato, permutamos aleatoriamente los valores de .
Esa operación destruye cualquier relación residual entre e que pudiera existir por el orden de las filas, pero conserva:
y el tamaño de cada estrato.
Repetimos la permutación 1500 veces.
La diferencia de riesgos marginal continúa centrada en
En todas las permutaciones permanece por encima de 0.30.
La composición basta por sí sola para producir la asociación agregada, sin necesidad de asociación dentro de los grupos.
90.17. ¿Es la asociación marginal «falsa»?
La respuesta es negativa. Matemáticamente,
y
son propiedades verdaderas de la distribución marginal construida, de modo que llamarlas falsas sería incorrecto.
La pregunta adecuada es qué relación queremos describir.
Si preguntamos por la asociación en la población agregada tal como está compuesta, la diferencia 0.36 es correcta.
Si preguntamos por la asociación entre e comparando unidades dentro del mismo estrato, la respuesta es cero.
Las dos afirmaciones pertenecen a distribuciones diferentes:
frente a
El problema aparece cuando se responde una pregunta y se interpreta como si fuera la otra.
90.18. Simpson y la agregación
Las discrepancias entre asociaciones marginales y condicionales se relacionan históricamente con el llamado paradigma o paradoja de Simpson.
El caso clásico suele destacar una reversión, en la que la dirección de una asociación cambia al estratificar.
Nuestro ejemplo es más simple. Dentro de cada estrato la asociación es exactamente nula y al agregar se vuelve positiva.
Pertenece a la misma familia de problemas de agregación, aunque el fenómeno pesa igual sin necesidad de una inversión de signo.
La enseñanza matemática es que
y
no son operaciones intercambiables.
90.19. No toda discrepancia marginal-condicional tiene la misma interpretación causal
Aquí debemos introducir una cautela.
Observar que una asociación cambia al condicionar en no nos dice, por sí solo, cuál de las dos debe interpretarse causalmente.
Si es una causa común de e , ignorarla puede generar confusión.
Si es consecuencia de ambas variables o funciona como colisionador, condicionar puede crear una asociación que antes no existía.
Si es un mediador entre e , ajustar por él cambia la pregunta causal.
Por tanto, la regla no es
La estadística muestra cómo cambian las distribuciones. La decisión sobre qué condicionamiento corresponde a una pregunta causal requiere información sobre la estructura del sistema.
Este es uno de los puntos enfatizados en tratamientos modernos del fenómeno de Simpson.
90.20. El bootstrap de la asociación marginal
C89 mostró que el bootstrap aproxima la variabilidad de un estimador bajo un esquema de remuestreo.
Tomemos ahora nuestras 10.000 filas y hagamos bootstrap individual, ignorando al calcular la estadística final.
En cada remuestra calculamos
Con réplicas, la distribución bootstrap se concentra alrededor de
El intervalo percentil del 95 % es aproximadamente
El cero queda muy lejos.
El bootstrap está funcionando correctamente para el estimando marginal.
90.21. El mismo bootstrap después de estandarizar
En cada remuestra podemos calcular también riesgos dentro de cada y luego estandarizar ambos valores de a una mezcla 50/50 de estratos.
Así obtenemos
La distribución bootstrap queda centrada prácticamente en cero.
El intervalo del 95 % es aproximadamente
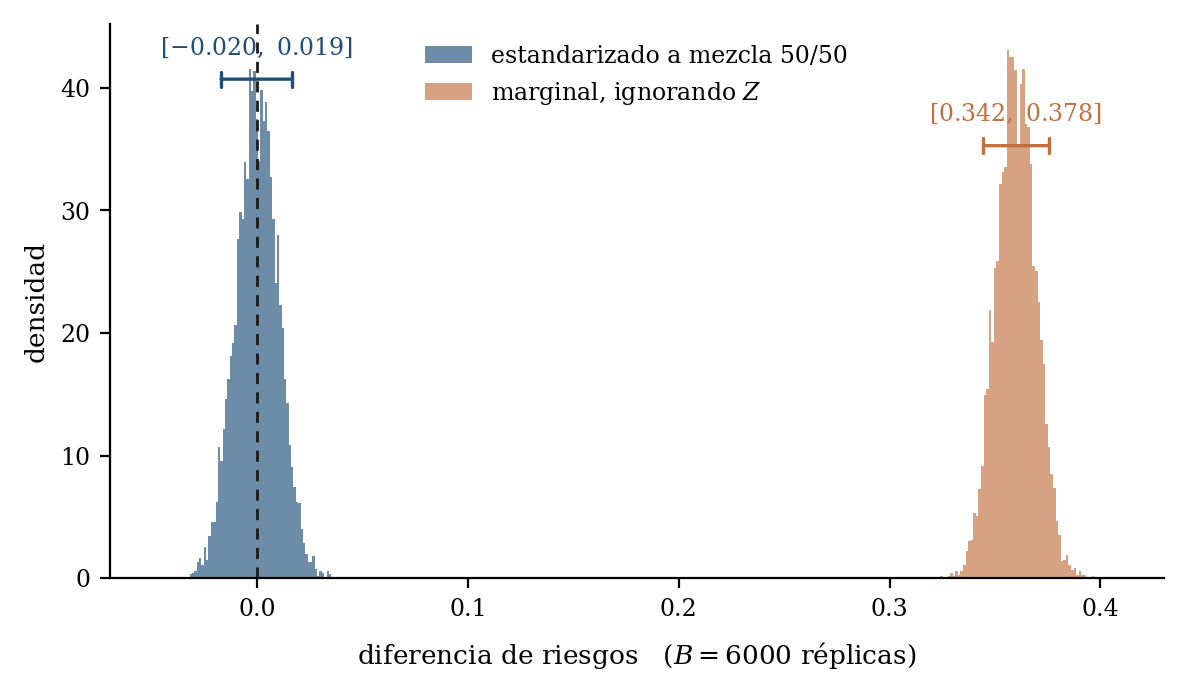
Los mismos datos y el mismo mecanismo de remuestreo producen respuestas distintas porque estamos estimando cantidades distintas.
90.22. El bootstrap no decide el estimando
Este ejemplo conecta directamente C89 con el problema de agregación.
El bootstrap puede responder cuánto variaría una estadística si repitiéramos el muestreo bajo una distribución cercana a la observada. Lo que no responde es si esa era la estadística que debíamos interpretar.
Si elegimos el riesgo marginal, el bootstrap cuantifica con precisión la asociación marginal.
Si elegimos la diferencia estandarizada, cuantifica con precisión otra cantidad.
El remuestreo no selecciona entre ellas, porque la definición del estimando precede al cálculo de su incertidumbre.
90.23. Más datos pueden hacer más precisa la respuesta equivocada
Supongamos que multiplicamos el tamaño de la muestra por cien manteniendo exactamente las mismas proporciones.
La diferencia marginal seguiría siendo
Su error estándar sería mucho menor.
El intervalo bootstrap podría volverse extremadamente estrecho.
Eso no resolvería la discrepancia con la asociación condicional.
Obtendríamos mayor precisión sobre
no una respuesta automática sobre
La precisión estadística deja intacta una definición inadecuada de la comparación.
90.24. Agregar es marginalizar
C85 presentó las mezclas como marginalización sobre estados latentes.
Eso es exactamente lo que hacemos aquí:
El paso de las tablas estratificadas a la tabla global es una transformación de la distribución mediante eliminación de , lejos de ser una operación inocente de presentación.
La marginalización puede borrar información, crear dependencia marginal o cambiar medidas de asociación. El resultado es una propiedad del operador de mezcla y no un error aritmético.
90.25. La heterogeneidad es la fuente del fenómeno
Para que aparezca la asociación de nuestro ejemplo necesitamos dos ingredientes.
Primero, debe estar asociado con :
Segundo, debe estar asociado con :
La fórmula
hace visibles ambas condiciones.
Si cualquiera de las dos diferencias fuera cero, la covarianza marginal creada por la mezcla desaparecería.
La heterogeneidad es aquí la estructura que genera la asociación agregada, muy lejos de ser ruido alrededor de un único mecanismo homogéneo.
90.26. El nivel de descripción forma parte de la pregunta
Una afirmación como
está incompleta si no sabemos respecto de qué distribución.
Podemos preguntar por la asociación entre individuos en la población agregada, por la asociación dentro de cada estrato, por la que resulta después de estandarizar a una población objetivo, por la asociación temporal dentro de cada unidad o por la asociación entre promedios de grupos. Estos niveles no son intercambiables.
En sistemas complejos, cambiar el nivel de agregación puede cambiar la estructura observada porque también cambia qué variables se mantienen visibles y cuáles se marginalizan.
90.27. Una asociación agregada puede ocultar ausencia, inversión o heterogeneidad
Nuestro ejemplo produce:
al agregar.
Otras configuraciones pueden producir:
o al revés.
También puede ocurrir que las asociaciones condicionales difieran entre estratos:
Entonces no existe una única asociación condicional común que resumir sin pérdida.
Antes de combinar grupos conviene examinar si sus distribuciones son suficientemente comparables para la pregunta que se desea responder.
90.28. No corregir automáticamente con una sola covariable
Descubrir en este caso resuelve la descomposición porque el sistema fue construido para ello.
En datos reales puede haber múltiples variables de estratificación, variables continuas y relaciones entre ellas.
Condicionar en muchas variables también puede producir celdas pequeñas, pérdida de precisión y problemas de soporte común.
Además, algunas variables no deben ajustarse para ciertas preguntas causales.
Por eso el aprendizaje correcto es una disciplina de modelamiento antes que una receta mecánica de estratificación. Consiste en definir primero el estimando, identificar después qué heterogeneidad importa, representar explícitamente la distribución conjunta, decidir qué variables deben condicionarse o marginalizarse y calcular la incertidumbre solo después de esas decisiones.
90.29. Un protocolo para auditar una asociación agregada
Cuando aparece una asociación global, una auditoría mínima puede seguir este orden.
Primero, comprobar la tabla o distribución marginal y calcular una medida interpretable.
Segundo, identificar variables de composición plausibles y examinar
Tercero, calcular las asociaciones condicionales
Cuarto, comparar las distribuciones de entre los grupos definidos por .
Quinto, utilizar una descomposición, como la ley de covarianza total o una estandarización, para cuantificar cuánto de la asociación marginal procede de diferencias entre estratos.
Sexto, separar la pregunta estadística de la causal. Que el ajuste cambie el resultado no establece por sí solo qué interpretación causal es correcta.
90.30. La colapsabilidad distingue el comportamiento de las medidas
El caso puede inducir una conclusión demasiado amplia, la de que toda medida que cambia al agregar revela confusión por composición. Esa lectura es incorrecta.
Las medidas de asociación tienen propiedades matemáticas diferentes respecto de la marginalización.
Una medida se denomina colapsable bajo ciertas condiciones cuando la medida marginal puede recuperarse adecuadamente de las medidas estratificadas al eliminar una variable que no introduce la clase relevante de heterogeneidad.
La diferencia de riesgos tiene propiedades de colapsabilidad relativamente transparentes. En nuestro ejemplo, la diferencia condicional es exactamente cero en ambos estratos, mientras la marginal es 0.36 porque los pesos
y
son distintos.
El odds ratio requiere más cuidado. Es una medida no colapsable en general. Puede cambiar entre análisis condicional y marginal incluso en situaciones donde la variable estratificadora no actúa como confusora causal en el sentido habitual.
Por ello, observar
no demuestra por sí solo que exista confusión.
En nuestro caso la interpretación es más simple porque la independencia condicional es exacta:
mientras la composición produce una asociación marginal fuerte. La lección general, sin embargo, debe formularse con la medida específica.
Esto explica por qué los trabajos modernos sobre Simpson distinguen al menos dos cuestiones, los cambios por confusión y los que dependen de propiedades matemáticas de la medida utilizada.
La auditoría correcta va más allá de «¿cambió el número al ajustar?» y pregunta
90.31. Asociación de grupos e inferencia sobre individuos
Existe otra forma de agregación que conviene separar.
Supongamos que no observamos individuos, sino únicamente porcentajes por región:
Podemos encontrar que regiones con valores altos de tienen también valores altos de .
Eso no implica que, dentro de cada región, los individuos con tengan mayor probabilidad de .
Nuestro caso muestra el mecanismo en miniatura. Los estratos con mayor frecuencia de tienen mayor frecuencia de , aunque dentro de cada estrato ambas variables sean independientes.
Si tratáramos cada estrato como una única observación, obtendríamos una asociación perfecta entre sus medias:
y
Esa relación entre grupos no contiene la relación individual dentro de grupos.
Este problema se conecta con la llamada falacia ecológica, que consiste en trasladar una asociación observada entre agregados a unidades individuales sin información suficiente.
La dirección contraria también puede fallar. Una asociación individual no determina necesariamente cómo se relacionarán los promedios de grupos, porque la composición y el tamaño de los grupos intervienen.
La unidad de análisis forma parte del estimando.
90.32. Predicción marginal sin información condicional adicional
El ejemplo también permite separar predicción y estructura condicional.
Si solo observamos , entonces es predictivo de :
Un predictor que utilice únicamente puede mejorar sobre una regla que ignore toda información.
Si también conocemos , en cambio,
Una vez fijado , no añade información probabilística sobre .
Por tanto, una variable puede ser predictiva marginalmente porque funciona como marcador de composición.
Eso no la convierte en mecanismo causal ni en predictor estable bajo cualquier población.
Si el vínculo entre y cambia, la capacidad predictiva marginal de también cambia aunque las probabilidades
permanezcan invariantes.
Esta distinción pesa en sistemas adaptativos. Una señal puede predecir bien porque rastrea indirectamente un estado latente. Si cambia la relación entre señal y estado, el predictor puede degradarse sin que haya cambiado el mecanismo del resultado.
90.33. Cambio de composición y transporte entre poblaciones
Supongamos ahora que llevamos el mismo mecanismo condicional a otra población.
Conservamos
y mantenemos
Ahora bien, hacemos que la composición de sea igual para ambos valores de :
Entonces
y
La asociación marginal desaparece.
Lo único que cambió es cómo se distribuyen los estratos entre los grupos definidos por , mientras la relación de con permanece igual.
La figura de reponderación del capítulo muestra una familia continua de poblaciones entre ambos extremos.
Esto introduce una idea que reaparecerá mucho más adelante, la de que una asociación marginal puede ser población-dependiente porque incorpora la distribución de covariables o estados.
Transportar una asociación desde una población a otra exige entonces preguntar qué componentes son estructurales y cuáles dependen de la mezcla poblacional.
Una medida estandarizada hace explícita una población objetivo:
Cambiar esa población estándar puede cambiar el resumen final si existen efectos condicionales heterogéneos.
En nuestro caso no hay heterogeneidad del efecto, porque ambos son cero. La estandarización a cualquier distribución común de produce diferencia cero, consecuencia especial de esta construcción antes que una propiedad universal.
90.34. No existe una única manera de «promediar» asociaciones
Una tentación ante los dos estratos es calcular sus medidas de asociación y promediarlas.
Aquí ambos estratos tienen y por lo que cualquier promedio razonable conservará esos valores. Sin embargo, en casos generales el problema es más delicado.
Las diferencias de riesgos viven en una escala aditiva. Los riesgos relativos viven en una escala multiplicativa. Los odds ratios utilizan odds y no probabilidades directas.
Promediar directamente y no produce en general una medida marginal con una interpretación simple. Tampoco un promedio de riesgos condicionales será correcto si utiliza pesos que no corresponden a la población objetivo.
La estandarización utilizada antes evita esta ambigüedad porque define primero una operación sobre probabilidades:
Solo después calculamos la diferencia entre los riesgos estandarizados.
El orden importa:
No es equivalente, en general, a
Esta regla conecta con una idea recurrente del proyecto. Un resumen de un resumen puede perder la estructura que hacía interpretable al primer nivel.
Cuando el objetivo es comparar poblaciones, conviene especificar la distribución estándar antes de producir el contraste final. Así los pesos dejan de ser una consecuencia accidental del tamaño de cada estrato observado y pasan a formar parte explícita del estimando.
Esto también permite documentar sensibilidad. Podemos repetir la estandarización con varias distribuciones objetivo razonables y observar cuánto cambia el contraste. Si el resultado depende fuertemente de si asignamos a un peso de 0.2, 0.5 o 0.8, esa dependencia no debería ocultarse dentro de un único número global. El contraste está describiendo una población específica. Cuando los efectos condicionales son heterogéneos, transportar el mismo modelo a otra mezcla puede cambiar incluso la dirección del promedio estandarizado. Por tanto, la elección de pesos forma parte de la definición matemática del resultado que queremos comunicar, antes que de la gestión posterior del análisis.
90.35. Qué comprueba el paquete reproducible
El script construye exactamente los 10.000 registros especificados.
Verifica para ambos estratos:
y correlación cero.
Después confirma en la tabla agregada:
y
También comprueba
La ley de covarianza total se verifica numéricamente como
La fórmula binaria general y la fórmula de la diferencia de riesgos por composición producen exactamente los valores observados.
90.36. Verificación por bootstrap y permutación
Las 6000 réplicas bootstrap producen un intervalo marginal de aproximadamente
para la diferencia de riesgos.
La versión estandarizada produce aproximadamente
Ambas distribuciones están calculadas desde las mismas filas.
La permutación de dentro de cada estrato conserva una diferencia marginal promedio cercana a 0.36.
Eso es una prueba computacional adicional de que la asociación agregada no necesita dependencia residual entre e dentro de .
Se ejecutaron 39 comprobaciones automáticas y las 39 resultaron satisfactorias.
90.37. Cierre del Módulo 9
El Módulo 9 comenzó introduciendo probabilidad como lenguaje para modelar incertidumbre y dependencia.
C81 separó marginales y distribuciones conjuntas. C82 mostró que condicionar cambia la distribución relevante. C83 introdujo esperanza, varianza y covarianza, mientras C84 trató las familias distributivas como supuestos de modelamiento. C85 mostró cómo transformación y heterogeneidad producen distribuciones marginales nuevas.
C86 explicó la estabilización de promedios y las fluctuaciones gaussianas bajo condiciones, hasta que C87 convirtió esos resultados en Monte Carlo. C88 mostró por qué las colas limitan las extrapolaciones. C89 introdujo el bootstrap como aproximación de la variabilidad muestral.
C90 reúne esas ideas en una advertencia final. Agregar es una operación probabilística que puede cambiar la asociación observada.
La tabla marginal no es una versión simplificada pero equivalente de las tablas condicionales. Es otra distribución. En consecuencia, toda reducción de dimensiones debería acompañarse de una pregunta explícita sobre qué estructura se pierde al marginalizar. En este caso se pierde exactamente la variable que organizaba simultáneamente la frecuencia de X y de Y.
La incertidumbre estadística tampoco decide qué distribución debemos interpretar. Podemos estimar con gran precisión la asociación marginal y seguir respondiendo una pregunta distinta de la que motivó el análisis.
Esta separación entre nivel, composición, dependencia y estimando será importante en los módulos posteriores. A partir de C91 comenzaremos el Módulo 10, sobre grafos y primeras redes complejas, donde la representación explícita de relaciones entre unidades se convertirá en el nuevo objeto central.
Referencias
- Hernán, M. A., Clayton, D., & Keiding, N. (2011). The Simpson's paradox unraveled. International Journal of Epidemiology, 40(3), 780–785. https://doi.org/10.1093/ije/dyr041
- Pearl, J. (2014). Comment: Understanding Simpson’s paradox. The American Statistician, 68(1), 8–13. https://doi.org/10.1080/00031305.2014.876829
- Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
Recursos reproducibles
Descargar recursos del capítulo (ZIP, 317 kB).
6 archivos CSV · 5 figuras · 1 programa Python.
El programa se ha ejecutado en una carpeta vacía y genera los archivos de datos y figuras incluidos en el paquete.