89.1. Conocemos una estimación pero no su distribución muestral
C83 distinguió parámetros de distribución y estadísticas muestrales. C86 mostró que un estimador como
tiene su propia distribución entre muestras repetidas. C87 utilizó esa idea para cuantificar error Monte Carlo cuando la distribución generadora era conocida. Ahora cambia la situación.
Tenemos una única muestra
procedente de una distribución desconocida , calculamos una estadística
y queremos conocer su variabilidad muestral.
Para algunos estimadores existen fórmulas analíticas. Para otros, la derivación es difícil o depende de aproximaciones poco transparentes.
El bootstrap propone una idea computacional, la de usar la distribución empírica de los datos como aproximación de la distribución desconocida y volver a muestrear desde ella.
El procedimiento intenta aproximar cómo variaría el estimador si pudiéramos repetir el proceso de muestreo bajo una distribución cercana a la que produjo los datos observados, sin generar información nueva.
89.2. La distribución empírica
Dada una muestra
la distribución empírica asigna probabilidad
a cada observación, contando multiplicidades.
Su función de distribución es
Esta es una distribución de probabilidad legítima.
Si la muestra contiene los valores
la distribución empírica asigna masas
El asterisco se utiliza habitualmente para señalar cantidades calculadas bajo el mundo bootstrap, condicionado a los datos observados.
La idea fundamental es sustituir
por
89.3. El principio plug-in
Supongamos que un parámetro puede escribirse como un funcional
La estimación plug-in es
Para la media,
y
El bootstrap lleva el principio un paso más lejos.
Si la distribución muestral de
depende de , la aproximamos reemplazando por y simulando nuevas muestras desde esa distribución empírica.
La aproximación alcanza al proceso de muestreo completo y no solo al parámetro.
89.4. Algoritmo bootstrap no paramétrico
Partimos de una muestra observada de tamaño .
Una réplica bootstrap consiste en generar
independientemente desde
Equivale a tomar observaciones con reemplazo desde la muestra original.
Calculamos entonces
Repetimos el procedimiento
veces:
La distribución empírica de estas estadísticas aproxima la distribución bootstrap de .
El tamaño de cada remuestra sigue siendo . El número controla la precisión computacional con la que aproximamos la distribución bootstrap.
89.5. Por qué el remuestreo es con reemplazo
Si tomáramos observaciones sin reemplazo desde una muestra de tamaño , cada remuestra contendría exactamente los mismos datos en otro orden.
Para estadísticas invariantes al orden,
en todas las réplicas, de modo que no habría variabilidad alguna.
El reemplazo permite que unas observaciones aparezcan varias veces y otras no aparezcan. Así imitamos el hecho de que otra muestra de la población desconocida contendría una composición diferente.
89.6. Un caso verificable con la media de una exponencial
Tomemos una muestra de tamaño desde una distribución exponencial con media
En una aplicación real fingiríamos no conocer esa distribución. Aquí sí la conocemos para poder auditar el bootstrap.
La muestra reproducible produce
La desviación estándar muestral es aproximadamente
La fórmula analítica habitual para el error estándar de la media es
Ejecutamos
réplicas bootstrap no paramétricas.
89.7. Distribución bootstrap de la media
En cada réplica calculamos
El error estándar bootstrap se estima mediante la desviación estándar de esas réplicas:
El resultado es aproximadamente
La fórmula analítica basada en la muestra entregaba
La concordancia es estrecha.
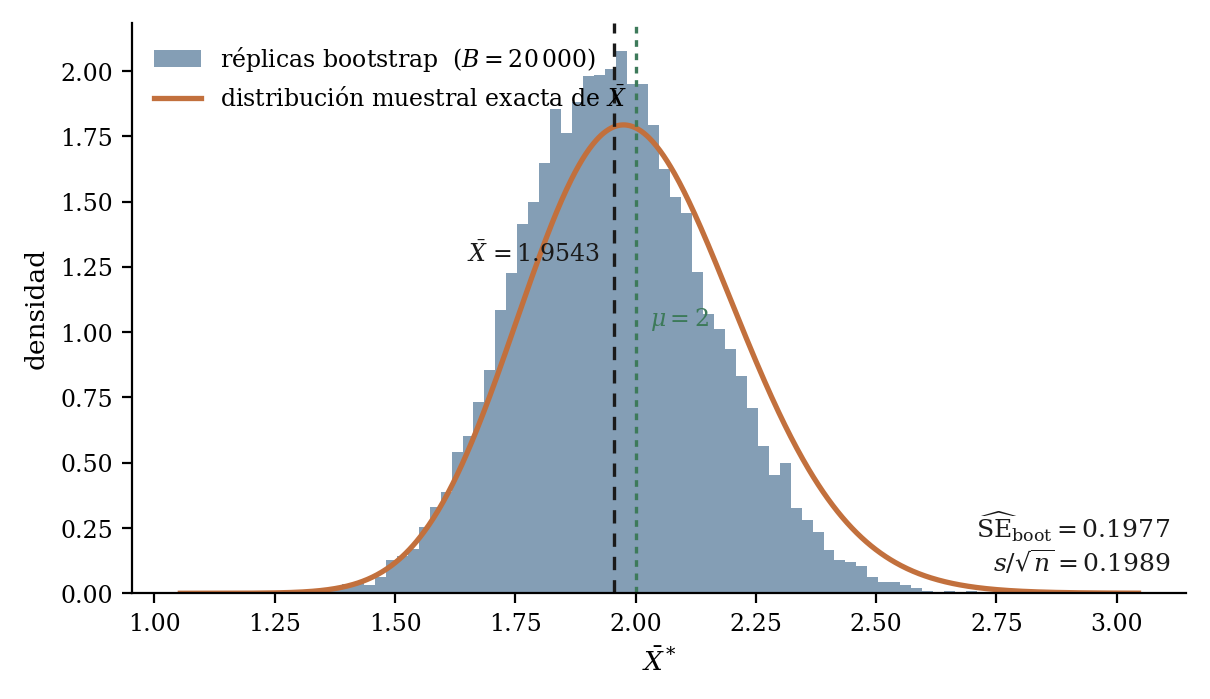
En este caso conocemos además la distribución muestral verdadera. Si
entonces
sigue una gamma, de modo que la distribución exacta de está disponible para comparación.
El bootstrap reproduce razonablemente su forma central después de recentrar ambas distribuciones.
89.8. El bootstrap es condicional a la muestra observada
La distribución bootstrap responde a
Una vez observados los datos, estos se mantienen fijos y la aleatoriedad procede del remuestreo.
La distribución muestral verdadera responde a otra pregunta:
cuando extraemos una nueva muestra desde .
El bootstrap intenta que la primera aproxime a la segunda, aunque por construcción no sean idénticas.
Si la muestra observada representa mal ciertas regiones de , la distribución empírica hereda esa limitación.
89.9. Error estándar bootstrap
El uso más directo del bootstrap es estimar variabilidad.
Si
son réplicas, definimos
y
Esta cantidad intenta aproximar
La ventaja es que no necesitamos derivar una fórmula analítica específica para cada estadística, siempre que el bootstrap sea válido para ese problema.
89.10. Sesgo bootstrap
También podemos estimar sesgo mediante
En práctica,
Para la media del ejemplo el sesgo bootstrap es muy pequeño, como esperamos.
Sin embargo, corregir automáticamente
no siempre mejora el error total.
Reducir sesgo puede aumentar varianza. La corrección debe evaluarse respecto de la cantidad final que queremos estimar.
89.11. Intervalo normal bootstrap
Una construcción sencilla es
Para 95 %,
En el ejemplo obtenemos aproximadamente
Esta forma supone que la distribución del estimador puede aproximarse razonablemente mediante una forma simétrica normal alrededor de .
El bootstrap aporta el error estándar, pero la forma del intervalo sigue incorporando una aproximación normal.
89.12. Intervalo percentil
Otra posibilidad utiliza directamente cuantiles bootstrap.
Si y son los cuantiles de las réplicas, es el intervalo percentil del 95 %.
En la muestra reproducible resulta aproximadamente
El intervalo no obliga a simetría alrededor de , lo que tampoco le garantiza mejor cobertura.
89.13. Intervalo básico
El intervalo bootstrap básico refleja la distribución del error
Si sus cuantiles son
un intervalo puede construirse como
Equivalentemente, usando cuantiles de ,
Percentil y básico son transformaciones diferentes de la misma distribución bootstrap, de modo que tratarlas como fórmulas intercambiables es un error.
89.14. La cobertura exige evaluar el intervalo repetidamente
La propiedad que define a un intervalo de confianza es de procedimiento, no el hecho de contener el parámetro en una única muestra.
El paquete simula muestras exponenciales independientes de tamaño 80. Para cada una calcula un bootstrap con y registra si el intervalo contiene la media verdadera.
La cobertura observada es aproximadamente:
para el intervalo percentil, para el intervalo normal con SE bootstrap, y para el intervalo normal usando .
Ninguno alcanza exactamente 0.95 en este experimento finito.
89.15. Bootstrap no significa cobertura exacta
La calidad del intervalo depende de la estadística, la distribución, el tamaño muestral y el tipo de intervalo.
El intervalo percentil es intuitivo, pero puede presentar errores de cobertura importantes si existe sesgo o asimetría.
Existen métodos más refinados, entre ellos intervalos studentized y BCa, que ajustan sesgo y aceleración bajo condiciones apropiadas. No desarrollaremos sus derivaciones en este capítulo.
La idea fundamental es que «usar bootstrap» no especifica por sí solo un método de intervalo. Debemos declarar qué construcción utilizamos.
89.16. y resuelven problemas diferentes
El tamaño original determina cuánta información contienen los datos sobre .
El número de réplicas determina con qué precisión Monte Carlo aproximamos la distribución bootstrap condicional a esos datos.
Aumentar no equivale, por tanto, a aumentar . Podemos ejecutar un millón de réplicas desde una muestra de diez observaciones y obtener una representación extremadamente precisa de
sin haber aprendido nada nuevo sobre regiones de ausentes de esas diez observaciones.
Esta distinción organiza buena parte del uso correcto del método.
89.17. Error Monte Carlo del propio bootstrap
Una estimación bootstrap calculada con finito también tiene ruido Monte Carlo.
El paquete toma la misma muestra exponencial y vuelve a estimar el SE bootstrap muchas veces para
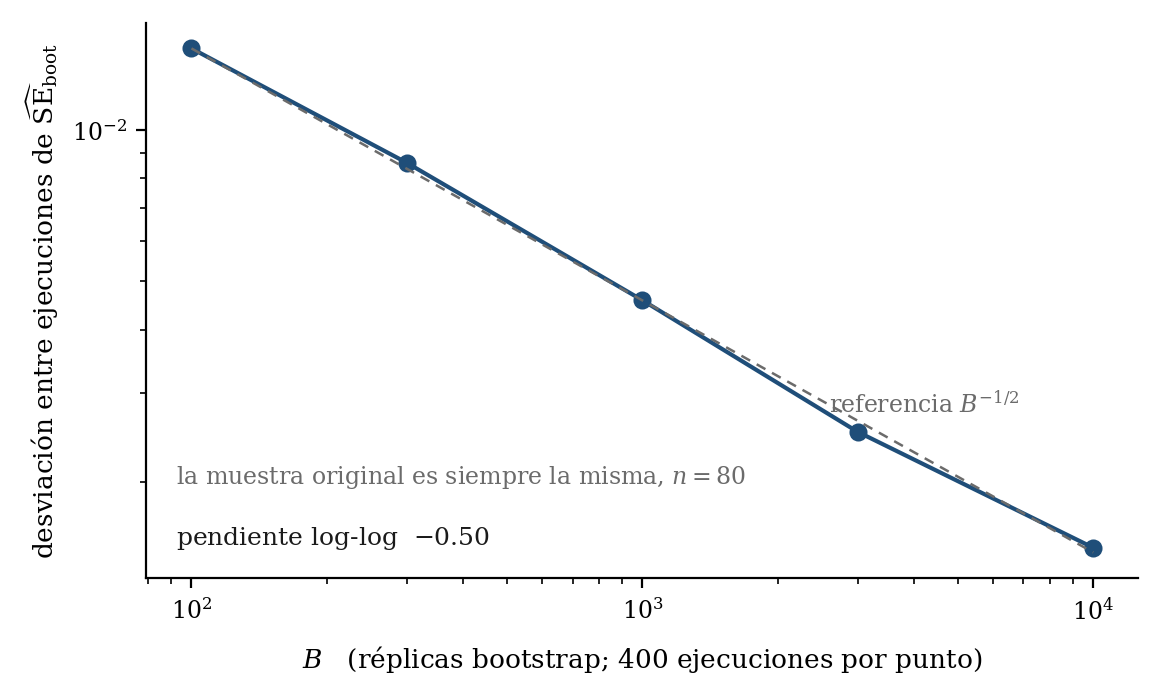
La desviación estándar entre ejecuciones disminuye aproximadamente como
La pendiente log-log observada es cercana a
El bootstrap utiliza Monte Carlo internamente, por lo que hereda el mismo costo cuadrático de precisión visto en C87.
89.18. Elegir
No existe un único adecuado para todo objetivo.
Estimar un error estándar central suele requerir menos replicaciones que estimar con estabilidad cuantiles muy extremos de la distribución bootstrap.
Si queremos el percentil 2.5 %, solo aproximadamente réplicas quedan por debajo de ese umbral.
Con eso corresponde a unas 25 réplicas.
Con
corresponde a unas 500.
Por tanto, el número de réplicas debería elegirse según la cantidad bootstrap que queremos estimar y el error Monte Carlo tolerable.
89.19. Primer límite del bootstrap, los valores fuera de la muestra
Consideremos una muestra
desde
y la estadística
Una remuestra no paramétrica solo contiene valores observados.
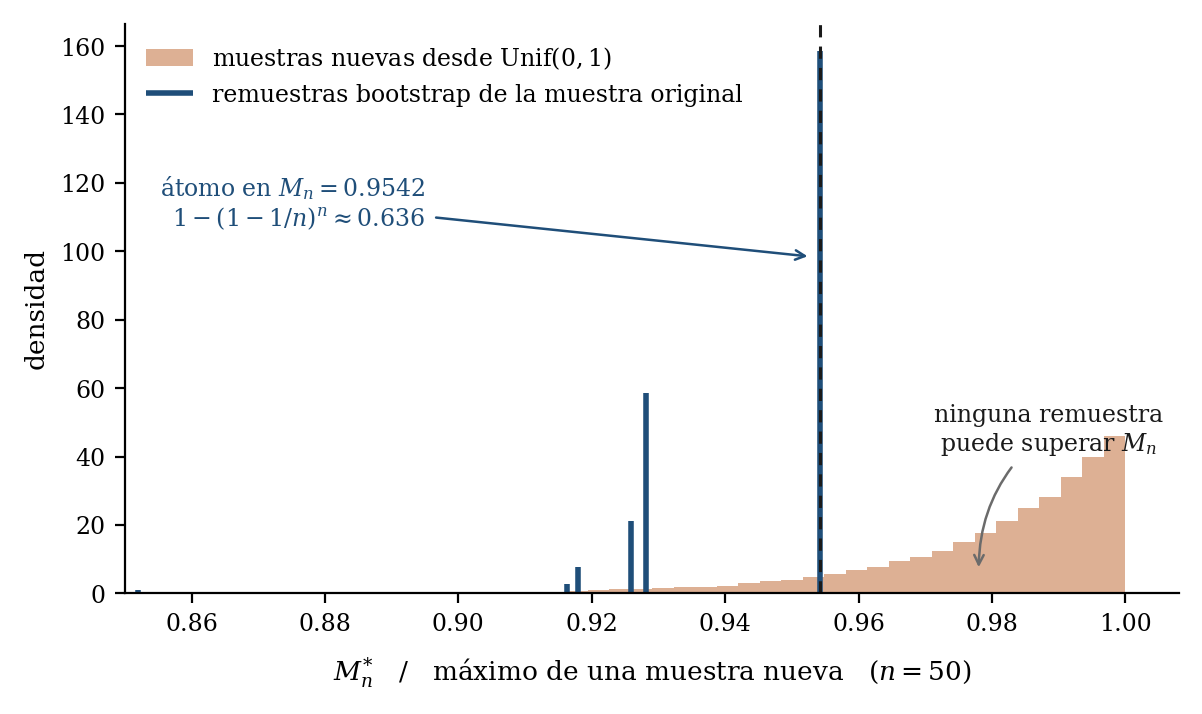
Por tanto, siempre.
El bootstrap no puede generar un máximo mayor que el máximo original, mientras una nueva muestra verdadera desde sí puede hacerlo.
89.20. Un átomo artificial en el máximo observado
En una remuestra de tamaño , la probabilidad de no seleccionar nunca la observación máxima es
Por tanto,
Cuando crece,
Entonces
La distribución bootstrap coloca una masa puntual cercana al 63 % en el máximo observado.
La distribución muestral verdadera del máximo uniforme es continua.
La discrepancia no desaparece de la manera necesaria para que el bootstrap ordinario sea válido para esta estadística extrema.
89.21. El problema del soporte vuelve a aparecer
C88 mostró que una muestra finita explora la cola solo hasta una escala limitada.
El bootstrap no paramétrico utiliza
cuyo soporte termina exactamente en el mayor valor observado.
Por ello no puede inferir una cola más allá de ese máximo.
Para estadísticas centrales, esta limitación puede ser irrelevante asintóticamente bajo condiciones regulares.
Para máximos, endpoints y extrapolaciones de cola, puede ser decisiva.
Remuestrear miles de veces los mismos extremos deja intacta la ignorancia sobre valores que nunca aparecieron.
89.22. Segundo límite del bootstrap, la dependencia
El bootstrap estándar supone que la estructura de muestreo puede aproximarse tomando observaciones independientemente desde
Supongamos una serie AR(1):
con
Las observaciones consecutivas están fuertemente correlacionadas.
Si tomamos puntos individuales con reemplazo, destruimos el orden temporal y eliminamos la autocorrelación.
La distribución bootstrap ya no reproduce el mecanismo que determina la variabilidad de la media.
89.23. Cuánto puede importar la dependencia
Para una AR(1) estacionaria con innovación de varianza uno,
es la varianza marginal.
La varianza exacta de la media finita es
Con
el SE verdadero es aproximadamente
La simulación repetida de series completas reproduce cerca de
El bootstrap ingenuo de observaciones individuales entrega solo
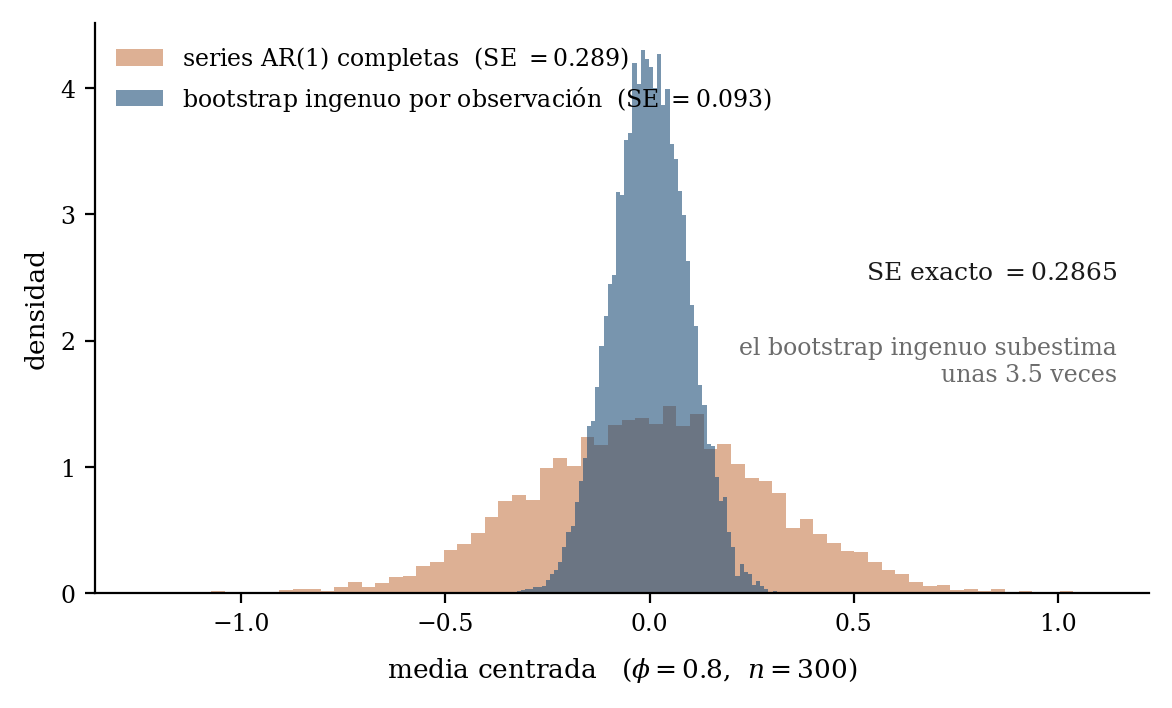
La subestimación es estructural y no se corrige aumentando .
89.24. La unidad de remuestreo debe preservar la estructura relevante
Para datos dependientes existen métodos bootstrap adaptados.
En series temporales, los block bootstraps remuestrean bloques de observaciones para conservar dependencia local.
En datos agrupados, puede ser necesario remuestrear unidades completas en vez de observaciones individuales.
En pares , si la pareja es la unidad muestral, deben remuestrearse pares y no columnas por separado.
El principio general es que la unidad de remuestreo debe corresponder a la unidad aleatoria que el diseño o el modelo considera intercambiable. Elegirla mal cambia la distribución muestral que intentamos aproximar.
89.25. Bootstrap paramétrico
El bootstrap no paramétrico no es la única opción.
Supongamos que adoptamos una familia
y estimamos
En un bootstrap paramétrico generamos
Después recalculamos la estadística en cada muestra.
Este procedimiento puede generar valores que no aparecían en la muestra original, porque simula desde una distribución continua o discreta parametrizada.
La ventaja es que puede representar mejor ciertas estructuras cuando el modelo paramétrico es adecuado.
La desventaja es que hereda explícitamente el riesgo de especificación del modelo.
89.26. No paramétrico frente a paramétrico
El bootstrap no paramétrico aproxima mediante
El paramétrico aproxima mediante
El primero utiliza menos estructura paramétrica y conserva literalmente el soporte observado.
El segundo utiliza más supuestos y puede extrapolar dentro de la familia elegida.
No existe una regla según la cual el no paramétrico sea siempre «más objetivo».
Si la estadística depende de regiones mal representadas por , una familia paramétrica bien justificada puede ser superior. Si la familia es incorrecta, puede producir inferencias precisas sobre la distribución equivocada.
89.27. Tercer límite del bootstrap, las colas muy pesadas
C88 utilizó una Pareto con
La media existe, pero la varianza es infinita.
En ese régimen, la distribución muestral de la media no sigue el TCL clásico de varianza finita.
El bootstrap ordinario de la media también puede fallar en el caso de varianza infinita. Athreya demostró resultados específicos sobre esta inconsistencia.
La razón conceptual es coherente con todo el módulo, porque la distribución empírica finita contiene una cola truncada en el máximo observado y no reproduce correctamente el mecanismo asintótico de extremos que gobierna las fluctuaciones de la media.
El bootstrap no elimina las condiciones necesarias de los teoremas límite.
89.28. Estadísticas suaves y estadísticas no regulares
El bootstrap funciona bien para una amplia clase de estadísticas suficientemente regulares, entre ellas las medias, muchos estimadores definidos por ecuaciones suaves y otros funcionales cuya respuesta a pequeñas perturbaciones de es controlable.
Puede fallar para estadísticas no regulares, parámetros en fronteras, máximos, algunos cuantiles extremos y problemas donde cambia la tasa de convergencia.
La distinción técnica completa requiere teoría asintótica más avanzada.
Para este nivel basta una pregunta operacional. ¿Reproduce la distribución empírica perturbada el mecanismo que controla la variabilidad de mi estadística?
Si la respuesta es no, aumentar solo aproxima con mayor precisión una distribución bootstrap inadecuada.
89.29. El bootstrap no es una prueba de que la muestra sea representativa
Toda remuestra procede de los datos observados.
Si el proceso de selección omitió sistemáticamente un grupo, el bootstrap tampoco lo recuperará.
Si existe error de medición común a todas las observaciones, el bootstrap lo conserva.
Si la muestra fue obtenida bajo sesgo de selección, las réplicas reproducen ese sesgo.
La incertidumbre bootstrap es condicional al mecanismo de datos que hemos representado mediante el remuestreo.
No debe confundirse con incertidumbre sobre todo aquello que pudo fallar antes de observar la muestra.
89.30. Bootstrap y transformación de una estadística
Supongamos que estimamos y después reportamos
Una ventaja del bootstrap es que podemos calcular directamente
en cada réplica.
Esto propaga automáticamente, dentro del modelo bootstrap, la no linealidad de .
Por ejemplo, para una razón, un logaritmo o una transformación exponencial, no necesitamos aplicar una aproximación lineal de primer orden si podemos recalcular la estadística completa.
Sin embargo, el resultado sigue siendo tan válido como lo sea el esquema de remuestreo y el comportamiento del funcional.
La facilidad computacional deja intactas las condiciones estadísticas.
89.31. Reproducibilidad
Un análisis bootstrap reproducible debe registrar al menos la muestra o el identificador de los datos utilizados, la estadística exacta, el esquema de remuestreo, el tamaño de cada remuestra, el número de réplicas, la semilla o estrategia de generación y el método de intervalo cuando corresponda.
Decir «se hizo bootstrap» es insuficiente.
Un bootstrap de observaciones individuales, de pares, de grupos o de bloques puede responder a distribuciones muestrales distintas.
La implementación forma parte de la definición del procedimiento.
89.32. Un flujo de trabajo mínimo
Un análisis bootstrap razonable puede seguir esta secuencia.
Primero se define el estimando y la estadística.
Después se identifica la unidad de muestreo independiente o la estructura de dependencia que debe conservarse.
Se decide si el bootstrap será no paramétrico, paramétrico o estructurado.
Se ejecuta un número suficiente para que el ruido Monte Carlo sea pequeño respecto de la incertidumbre estadística que queremos describir.
Se examina la distribución de réplicas y se calcula la cantidad necesaria, sea el error estándar, el sesgo o un intervalo.
Finalmente se realizan controles contra fórmulas analíticas, simulaciones bajo modelos conocidos o sensibilidades a decisiones del remuestreo cuando sea posible.
89.33. Cuántas observaciones distintas contiene una remuestra
Una remuestra bootstrap tiene tamaño , pero no suele contener observaciones distintas.
Tomemos una observación original concreta, . En cada extracción bootstrap, la probabilidad de no seleccionarla es
Como realizamos extracciones con reemplazo, la probabilidad de que no aparezca ninguna vez es
Por tanto, la probabilidad de que aparezca al menos una vez es
Si es el número de observaciones originales distintas presentes en una remuestra, por linealidad de la esperanza
Cuando ,
Así, una remuestra grande contiene en promedio alrededor del 63.2 % de los casos originales distintos; el resto de sus posiciones son repeticiones.
Esto no significa que el bootstrap «descarte» definitivamente el 36.8 % de los datos. Cada réplica omite un subconjunto diferente y repite otro. La distribución de réplicas se construye precisamente a partir de esa variación en las multiplicidades.
La misma constante explica por qué el máximo observado aparece en cerca del 63.2 % de las remuestras del ejemplo anterior.
También muestra que una remuestra bootstrap no debe imaginarse como una copia ligeramente perturbada de la muestra original. Puede repetir varias veces algunas observaciones y omitir otras por completo. Para estadísticas suaves, esa reponderación aleatoria aproxima adecuadamente la variabilidad inducida por volver a muestrear desde una distribución desconocida. Para estadísticas dominadas por uno o pocos puntos, las multiplicidades adquieren un papel mucho más abrupto. La validez depende de que la distribución de la estadística bootstrap reproduzca la distribución muestral relevante, más que del parecido visual entre cada remuestra y la original.
89.34. Datos pareados y el remuestreo de la unidad completa
Supongamos que cada individuo aporta un par
Queremos estimar, por ejemplo, una diferencia media
La unidad aleatoria es el individuo, no cada columna por separado.
El bootstrap apropiado remuestrea pares completos:
Si remuestreamos e independientemente, destruimos la dependencia intraindividual. La distribución resultante corresponde a otro experimento de muestreo.
El mismo principio se extiende a diseños pre-post, parejas emparejadas, múltiples mediciones por sujeto y observaciones agrupadas.
Antes de programar un bootstrap conviene poder responder qué objeto podría haber sido reemplazado por otro comparable en el diseño original. Ese objeto es un candidato natural para la unidad de remuestreo. El bootstrap no lo descubre por sí solo leyendo una tabla de datos.
89.35. Conglomerados y estructura jerárquica
C85 mostró que observaciones de una misma unidad pueden compartir heterogeneidad latente.
Supongamos pacientes agrupados en centros. Si existe un efecto de centro, dos pacientes del mismo centro no son completamente independientes.
Remuestrear pacientes individuales como si todos fueran intercambiables ignora parte de esa estructura.
Una alternativa conceptual es remuestrear centros completos y conservar dentro de cada centro las observaciones correspondientes. En otros diseños puede ser necesario un procedimiento multinivel que reproduzca más de una fuente de variación.
La elección depende de cuál sea la población de inferencia.
Si los centros observados son considerados una muestra de una población mayor de centros, su variabilidad debe formar parte del remuestreo. Si son los únicos centros de interés y se tratan como fijos, el objetivo puede ser distinto.
Remuestrear es una forma de codificar qué unidades podrían haber cambiado entre muestras repetidas, antes que un sustituto de la definición del estimando.
89.36. Qué hacer cuando el bootstrap ordinario falla
El fracaso del bootstrap no paramétrico estándar no implica que todo remuestreo sea imposible.
Existen modificaciones como el bootstrap por bloques para dependencia temporal, el bootstrap de conglomerados para datos agrupados, el bootstrap paramétrico cuando una familia generadora está bien especificada, los esquemas -out-of-, donde se remuestrean menos de observaciones, además del subsampling, que utiliza submuestras sin reemplazo bajo teorías específicas.
Ninguno de estos métodos es una corrección universal. Cada uno cambia la distribución de referencia y requiere sus propias condiciones de validez.
En particular, usar un método más sofisticado porque el bootstrap ordinario «se ve raro» no es suficiente. Hay que identificar por qué falla el esquema original, sea por dependencia, frontera del soporte, tasa de convergencia no estándar, cola extrema o estructura jerárquica.
La regla general del capítulo puede formularse así:
debe imitar
Cuando esa correspondencia falla, la computadora puede producir miles de réplicas muy estables de la distribución equivocada.
89.37. Verificación computacional
El paquete reproducible utiliza tres escenarios.
En la muestra exponencial de tamaño 80, calcula réplicas. El SE bootstrap de la media es aproximadamente frente a para .
Como la distribución generadora es conocida, la distribución bootstrap centrada también se compara con la distribución gamma exacta de la media muestral.
Después se repite el experimento completo 1200 veces. Las coberturas observadas de los intervalos percentil, normal bootstrap y normal analítico quedan próximas, aunque no idénticas, al 95 % nominal.
El control del número de replicaciones muestra que la variabilidad Monte Carlo del SE bootstrap decrece aproximadamente como
Para el máximo uniforme, el código confirma que ninguna réplica supera el máximo observado y que alrededor del 63 % de las remuestras contienen ese máximo.
Finalmente, para una AR(1) con la fórmula exacta y 5000 simulaciones de series completas producen un SE de la media cercano a , mientras el bootstrap ingenuo i.i.d. entrega cerca de .
Se ejecutaron 27 comprobaciones automáticas y las 27 resultaron satisfactorias.
89.38. Qué queda establecido
El bootstrap aproxima una distribución muestral reemplazando la distribución desconocida por una distribución estimada a partir de los datos.
En el bootstrap no paramétrico,
se sustituye por
y se generan remuestras con reemplazo.
El método puede estimar errores estándar, sesgos y distribuciones de estadísticas sin una derivación analítica específica para cada caso.
Ahora bien, y cumplen funciones distintas. Más réplicas reducen el ruido computacional sin añadir información sobre la población.
El bootstrap tampoco es universal. Puede fallar con máximos, colas de varianza infinita o esquemas de dependencia que el remuestreo destruye.
La pregunta correcta es si la distribución empírica y la unidad de remuestreo reproducen el mecanismo que determina la variabilidad del estimador, bastante más exigente que «¿puedo hacer bootstrap?».
C90 cerrará el módulo con un caso resuelto sobre una asociación creada por agregación. Allí integraremos dependencia, condicionamiento, heterogeneidad y muestreo para mostrar cómo una asociación global puede aparecer aunque la estructura dentro de los grupos sea diferente.
Referencias
- Athreya, K. B. (1987). Bootstrap of the mean in the infinite variance case. The Annals of Statistics, 15(2), 724–731. https://doi.org/10.1214/aos/1176350371
- Bickel, P. J., & Freedman, D. A. (1981). Some asymptotic theory for the bootstrap. The Annals of Statistics, 9(6), 1196–1217. https://doi.org/10.1214/aos/1176345637
- Davison, A. C., & Hinkley, D. V. (1997). Bootstrap Methods and Their Application. Cambridge University Press. https://doi.org/10.1017/CBO9780511802843
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
- Efron, B., & Tibshirani, R. J. (1993). An Introduction to the Bootstrap. Chapman & Hall. https://doi.org/10.1007/978-1-4899-4541-9
- Hall, P. (1992). The Bootstrap and Edgeworth Expansion. Springer. https://doi.org/10.1007/978-1-4612-4384-7
Recursos reproducibles
Descargar recursos del capítulo (ZIP, 518 kB).
7 archivos CSV · 4 figuras · 1 programa Python.
El programa se ha ejecutado en una carpeta vacía y genera los archivos de datos y figuras incluidos en el paquete.