85.1. Tres operaciones que producen distribuciones nuevas
C84 mostró que elegir una familia probabilística equivale a aceptar restricciones sobre soporte, momentos, memoria y colas. Esa decisión rara vez termina el modelamiento. Una distribución observada puede surgir porque transformamos una variable, porque combinamos subpoblaciones o porque algún parámetro varía entre realizaciones.
Estas posibilidades son matemáticamente distintas.
En una transformación partimos de una variable aleatoria y definimos
La misma realización cambia de representación mediante una regla determinista.
En una mezcla introducimos un estado latente . Primero se selecciona una componente y después se genera la observación desde la distribución correspondiente:
Al ignorar , observamos una distribución marginal que combina las componentes.
La heterogeneidad puede modelarse haciendo aleatorio un parámetro. Por ejemplo,
mientras la tasa varía entre unidades según otra distribución.
Las tres operaciones pueden producir asimetría, colas amplias o varianzas inesperadas. Identificar cuál se está utilizando evita confundir una forma observada con su mecanismo generador.
85.2. Una transformación es una medida imagen
C81 definió la distribución de una variable como la medida imagen del espacio probabilístico. La misma idea permite estudiar transformaciones.
Si entonces, para cualquier conjunto medible ,
Equivalentemente,
La distribución de se obtiene transportando la masa de probabilidad de a través de .
La operación difiere de una mezcla. Cada valor de produce un único valor , aunque distintos valores de puedan terminar en el mismo si no es inyectiva.
85.3. Cambio de variable en una transformación monótona
Supongamos que tiene densidad y que donde es estrictamente monótona y diferenciable, con inversa .
Para un intervalo infinitesimal, debe coincidir con la probabilidad de su preimagen en el espacio de .
El resultado es
El factor derivativo es el jacobiano unidimensional de la transformación inversa.
Su función es conservar probabilidad cuando una transformación comprime o expande distancias. Sustituir por en la densidad, sin más, da un resultado incorrecto.
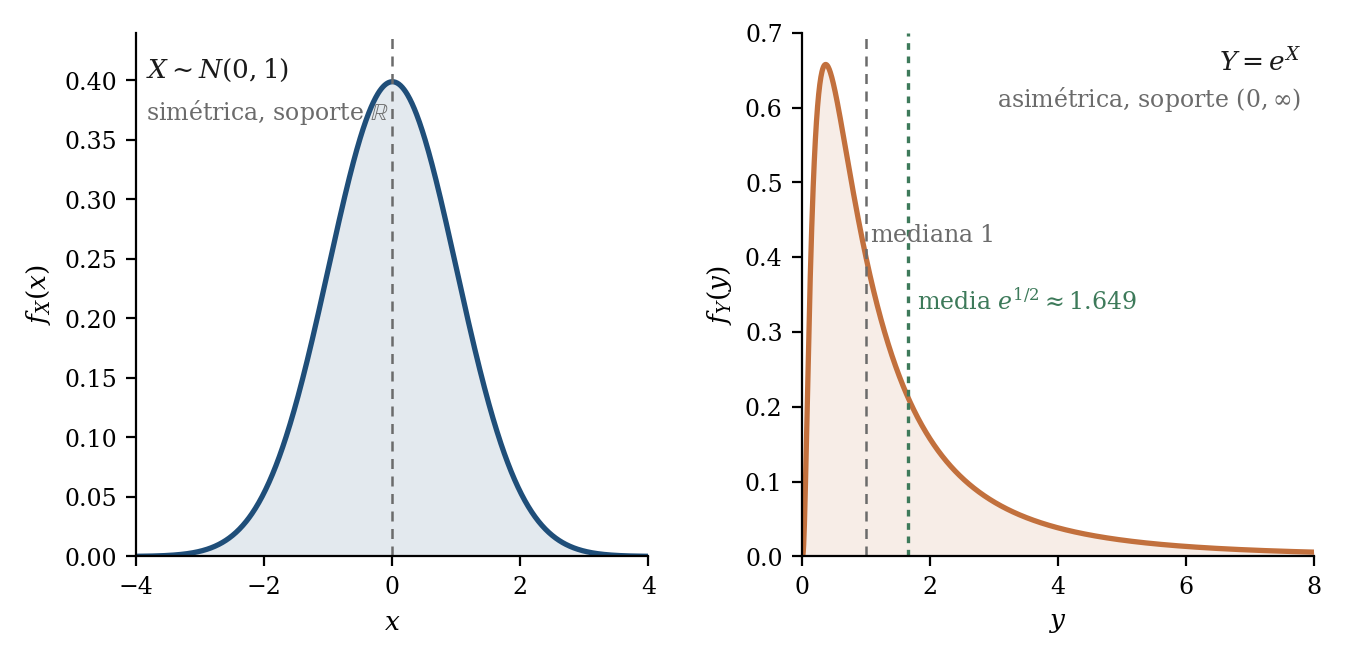
85.4. De normal a lognormal
Tomemos
y definamos
La transformación es estrictamente creciente y su inversa es
Además,
Como
obtenemos
Esta es una distribución lognormal.
La transformación exponencial ha cambiado el soporte:
y ha producido una distribución asimétrica con cola derecha.
85.5. Los momentos también cambian de forma no lineal
Para una normal general
si
entonces
En el caso estándar,
La mediana, en cambio, es
La media es mayor que la mediana por la asimetría de la cola derecha.
La varianza es
Para y ,
C83 ya había advertido que
en general. Aquí,
La distribución transformada depende de la dispersión de además de su media.
85.6. Transformaciones no inyectivas
La fórmula con una única inversa supone monotonicidad.
Si una transformación tiene varias preimágenes, debemos sumar sus contribuciones.
Por ejemplo, para
un valor puede provenir de
o
En términos generales, si las raíces
satisfacen
y son regulares,
Este resultado aclara por qué una transformación puede concentrar probabilidad, ya que diferentes regiones del espacio original pueden plegarse sobre el mismo valor de salida.
El paralelismo con la dinámica no lineal es útil. En mapas no invertibles, varios estados previos pueden compartir una misma imagen. En probabilidad, la densidad de la imagen debe sumar la masa transportada desde todas esas ramas.
85.7. Transformación no equivale a mezcla
Supongamos dos variables aleatorias y .
La combinación lineal es una transformación de un vector aleatorio.
Una mezcla
significa algo distinto. Con probabilidad generamos la observación desde y con probabilidad desde .
En la mezcla seleccionamos una componente latente, sin promediar dos realizaciones.
Esta diferencia cambia distribución, interpretación y varianza. El símbolo de suma puede ocultar mecanismos probabilísticos completamente distintos.
85.8. Definición de una mezcla finita
Sean densidades
y pesos
La densidad de mezcla es
Podemos introducir una variable latente con
y especificar
La densidad marginal de se obtiene mediante la ley de probabilidad total:
Una mezcla es, por tanto, una marginalización sobre un estado no observado.
85.9. Mezcla de dos normales
Consideremos
Condicionalmente,
La densidad marginal es
donde representa una densidad normal.
Cada componente es unimodal y simétrica. La mezcla puede mostrar dos regiones de alta densidad.
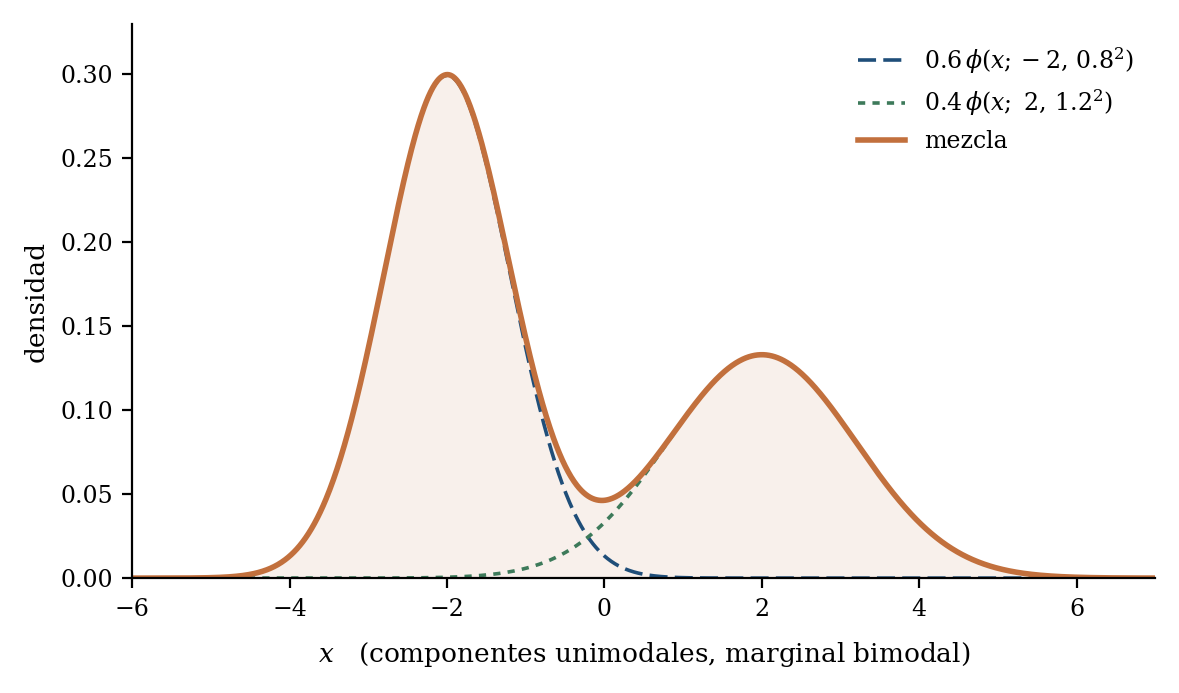
La multimodalidad apareció al combinar subpoblaciones simples con medias diferentes, sin que ninguna componente fuese complicada.
85.10. Media de una mezcla
Por la ley de la esperanza total,
Si la componente tiene media ,
En nuestro ejemplo,
La media de mezcla se encuentra entre las dos medias componentes.
Esto no implica que exista una componente con media , ni que la densidad alcance allí su máximo. La media marginal resume el conjunto combinado.
85.11. Varianza dentro y entre componentes
Aplicamos la ley de la varianza total:
El primer término es la varianza promedio dentro de componentes:
En nuestro ejemplo,
El segundo término es la varianza entre las medias componentes:
Aquí,
Por tanto,
La mayor parte de la dispersión marginal proviene de la heterogeneidad entre componentes antes que de la variación interna.
85.12. La misma varianza global puede ocultar arquitecturas diferentes
Construyamos una única normal
Tiene exactamente la misma media y varianza que la mezcla anterior.
Sin embargo, las densidades son muy diferentes.
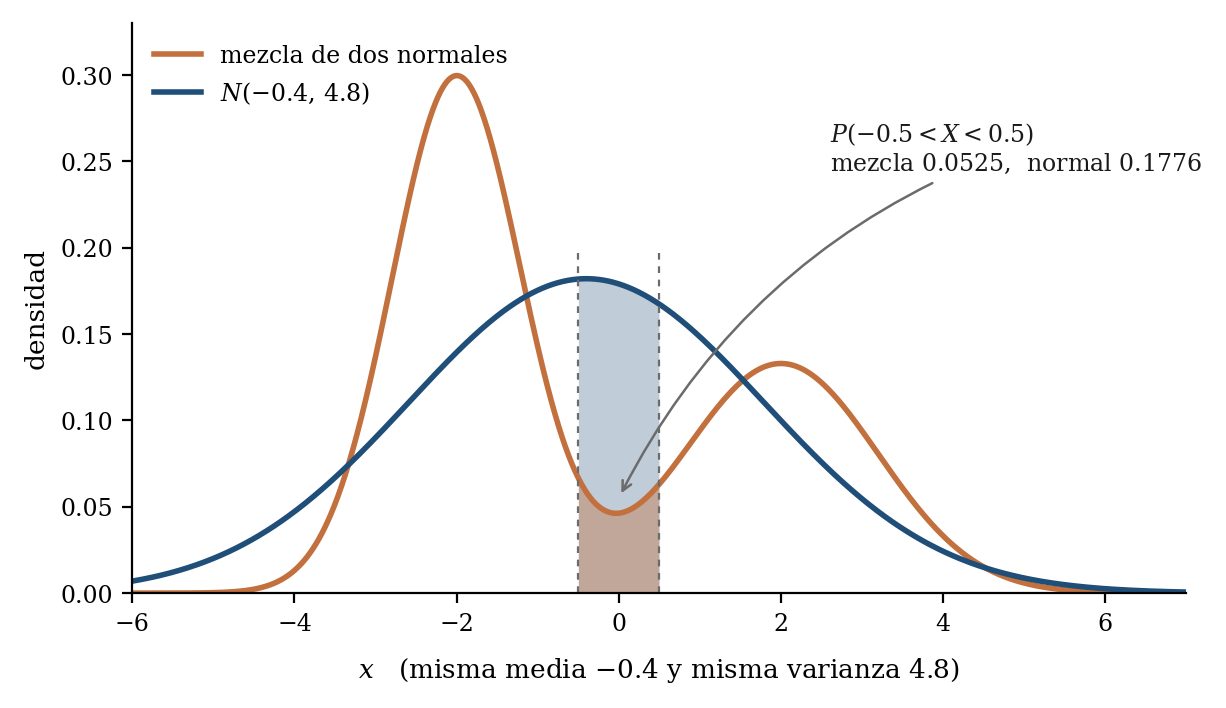
La probabilidad de caer cerca del centro también cambia. Para la mezcla asigna aproximadamente mientras la normal de mismos momentos asigna cerca de
Los primeros dos momentos no revelan si la variabilidad global proviene de una única población dispersa o de varias poblaciones más concentradas y separadas.
Este ejemplo extiende lo visto en C83, porque media y covarianza pueden ser correctas mientras la representación distributiva sigue omitiendo estructura.
85.13. La etiqueta latente puede inferirse probabilísticamente
Aunque no sea observado, una realización aporta información sobre qué componente pudo generarla.
Por Bayes,
Estas probabilidades reciben a menudo el nombre de responsabilidades en algoritmos de ajuste de mezclas. Salvo que las componentes no se solapen, no equivalen a etiquetas determinadas.
Un valor intermedio puede tener probabilidades apreciables bajo ambas normales. La clasificación dura
descarta incertidumbre que la distribución posterior sobre sí conserva.
Este es un ejemplo directo de cómo C82, sobre Bayes, entra en un modelo de heterogeneidad.
85.14. Componentes estadísticas no equivalen automáticamente a tipos naturales
Una mezcla con dos componentes puede describir adecuadamente una densidad bimodal, sin que eso demuestre que el fenómeno tenga dos clases ontológicas discretas.
Las componentes pueden ser aproximaciones matemáticas a una distribución continua de heterogeneidad. También pueden depender de qué familia paramétrica usamos. Una distribución asimétrica puede aproximarse mediante varias normales aunque no exista un mecanismo real que seleccione una de esas «subpoblaciones».
La interpretación científica de requiere evidencia adicional.
Los modelos de mezcla resultan útiles porque una combinación de componentes simples puede aproximar formas complejas. Esa flexibilidad vuelve peligroso interpretar cada componente como una entidad real sin justificación independiente.
85.15. Identificabilidad y permutación de etiquetas
Una mezcla presenta una simetría inmediata.
Si intercambiamos los nombres de las componentes,
por
la distribución marginal no cambia.
Este label switching significa que las etiquetas numéricas carecen de significado intrínseco.
Existen además problemas de identificabilidad más serios en algunas familias y configuraciones. Dos parametrizaciones diferentes pueden producir distribuciones muy semejantes o incluso equivalentes bajo condiciones particulares.
El hecho de que un algoritmo entregue parámetros no garantiza que los datos determinen esos parámetros con precisión.
La inferencia sobre mezclas debe separar ajuste distributivo de identificación de componentes.
85.16. De mezcla finita a parámetro aleatorio
Una mezcla no necesita tener un número finito de componentes.
Supongamos que un parámetro varía continuamente entre realizaciones.
Condicionalmente,
Si tiene densidad , la distribución marginal es
Esta es una mezcla continua.
La heterogeneidad no observada de parámetros puede modificar por completo la forma marginal incluso cuando la distribución condicional es simple.
85.17. Conteos Poisson con tasa heterogénea
C84 estudió una Poisson homogénea:
con
Ahora permitamos que la tasa cambie entre realizaciones:
Condicionalmente, cada unidad sigue siendo Poisson.
Marginalmente, en cambio, debemos integrar sobre la distribución de .
Por la ley de la esperanza total,
Para la varianza,
Como una Poisson satisface
obtenemos
La heterogeneidad en la tasa añade varianza.
85.18. Gamma como distribución de heterogeneidad
Tomemos
donde utilizamos parametrización por forma y tasa :
Sus momentos son
Elegimos
Entonces
Por tanto, los conteos marginales tendrán
y
Ya sabemos, sin calcular todavía la masa completa, que no pueden seguir una Poisson homogénea de media dos.
85.19. Derivación de la mezcla Poisson–gamma
La probabilidad marginal de observar es
Sustituimos
y la densidad gamma:
La integral es una integral gamma:
Con
obtenemos
Esta es una parametrización de la distribución binomial negativa.
85.20. Sobredispersión como consecuencia de heterogeneidad
Comparemos dos modelos con la misma media:
y generado por la mezcla Poisson–gamma anterior.
En ambos,
Pero
mientras
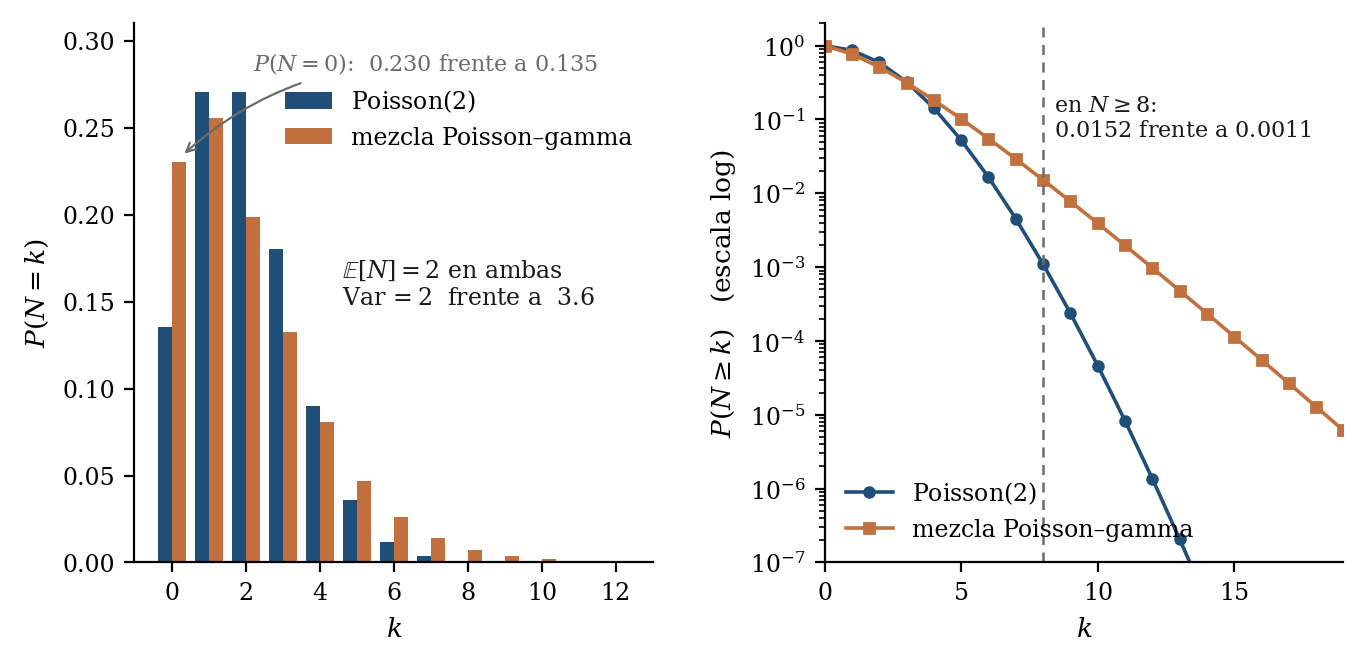
La mezcla tiene más masa en cero:
frente a
También tiene una cola mucho mayor. Para la mezcla asigna aproximadamente mientras la Poisson homogénea asigna cerca de
La heterogeneidad produce simultáneamente más observaciones pequeñas y más observaciones grandes.
85.21. Sobredispersión no identifica una causa única
Observar
puede ser incompatible con una Poisson homogénea simple, pero no identifica automáticamente una mezcla gamma.
La sobredispersión puede provenir de heterogeneidad de tasas, dependencia temporal, agrupamiento de eventos, inflación de ceros, errores de medición o mecanismos distintos.
La mezcla Poisson–gamma da una explicación generativa que produce binomial negativa, entre otras posibles para una varianza elevada. Esta es la misma regla epistemológica utilizada desde los módulos anteriores, según la cual reproducir una estadística restringe los mecanismos candidatos y rara vez identifica uno sin información adicional.
85.22. Heterogeneidad observada y no observada
Si la variable que explica la heterogeneidad está medida, podemos condicionar en ella.
Por ejemplo, si cada unidad pertenece a un grupo conocido,
puede analizarse por estratos.
Si no se observa, la distribución marginal mezcla las componentes y parte de la estructura queda oculta.
La diferencia alcanza a qué preguntas pueden responderse, más allá del aparato estadístico.
Una varianza marginal grande puede reducirse mucho al condicionar en un factor explicativo. En el ejemplo normal,
mientras la varianza total era
Conocer el grupo latente convertiría gran parte de la variación aparentemente individual en diferencia entre grupos.
85.23. Marginalizar puede crear una distribución que ninguna unidad sigue
Conviene detenerse aquí, porque el punto afecta a cómo se informan los resultados agregados.
En la mezcla de normales, ninguna unidad condicional sigue
La distribución global tampoco es normal.
Sin embargo, si resumiéramos únicamente media y varianza, podríamos describir el agregado mediante esos parámetros y olvidar que las realizaciones proceden de dos regímenes diferentes.
De forma análoga, en la mezcla Poisson–gamma cada unidad condicional satisface
pero la población marginal satisface
Una propiedad que vale dentro de cada unidad condicional puede dejar de valer después de marginalizar sobre heterogeneidad.
85.24. Mezcla no equivale a contaminación
La palabra mezcla puede sugerir que una distribución principal fue «ensuciada» por otra, lectura que el modelo no exige.
En un modelo de mezcla, todas las componentes forman parte de la distribución generadora.
La contaminación es un caso particular donde puede existir una distribución principal y una pequeña proporción de observaciones generadas por otro proceso, por ejemplo
Esta estructura es útil en estadística robusta, pero no agota el concepto de mezcla.
En una población genuinamente heterogénea, ninguna componente tiene por qué ser considerada error.
85.25. Una transformación puede crear apariencia de heterogeneidad
La asimetría o una cola larga no exige mezcla.
La transformación convierte una única normal unimodal en una lognormal muy asimétrica.
Si observáramos solo , podríamos sentir la tentación de explicar la cola mediante subpoblaciones. En este caso sería innecesario, porque una sola variable normal transformada produce la forma completa.
Por tanto,
no implica
Antes de introducir estados latentes conviene considerar si una transformación natural de escala explica la geometría distributiva.
85.26. Una mezcla puede parecer unimodal
El caso contrario también ocurre.
Si las medias componentes están suficientemente cerca o las varianzas son grandes, una mezcla de dos normales puede mostrar un único máximo visible.
La ausencia de bimodalidad no demuestra homogeneidad, porque dos subpoblaciones superpuestas pueden producir una densidad suave y aparentemente simple.
Esto limita el razonamiento basado únicamente en histogramas. La estructura latente puede existir sin producir valles evidentes entre componentes.
La posibilidad matemática tampoco demuestra que existan grupos ocultos. Solo elimina la inferencia ingenua
85.27. Transformar antes o después de mezclar puede dar resultados distintos
Supongamos una mezcla de y una transformación no lineal .
Si
entonces
produce, condicionalmente,
donde representa la medida imagen de la componente.
La distribución marginal de es la mezcla de las componentes transformadas:
Esto es distinto de aplicar a una cantidad resumen como la media de mezcla.
En general,
Los órdenes «promediar» y «transformar» no conmutan para funciones no lineales.
Esta observación reaparecerá en problemas multiescala, donde agregar primero y transformar después puede no equivaler a transformar localmente y luego agregar.
85.28. Mezcla, condicionamiento y Bayes forman una misma arquitectura
Los capítulos 82 y 85 pueden reunirse en un esquema.
Partimos de
El modelo de observación es
Marginalizando,
Después de observar , Bayes invierte la dirección:
Así, mezclar significa pasar del estado latente a la distribución observable, mientras inferir la componente significa condicionar en la observación y aplicar Bayes. Son dos direcciones dentro del mismo modelo conjunto.
85.29. Ajustar mezclas es más difícil que escribirlas
La ecuación
es sencilla.
Estimar sus parámetros desde datos puede ser difícil.
Las etiquetas son intercambiables, las componentes pueden solaparse y el número de componentes puede no estar determinado de forma clara. En algunas mezclas normales, además, la verosimilitud puede presentar degeneraciones si una componente colapsa sobre una observación con varianza tendiendo a cero, salvo que se impongan restricciones adecuadas.
El algoritmo EM de Dempster, Laird y Rubin proporciona una estrategia general para problemas con datos latentes o incompletos y se utiliza ampliamente en mezclas. No desarrollaremos su derivación aquí porque C85 se centra en la estructura probabilística antes que en los algoritmos de estimación.
El hecho de que exista un método computacional de ajuste no elimina los problemas de representación e identificabilidad.
85.30. Protocolo conceptual para modelar heterogeneidad
Antes de utilizar una mezcla conviene preguntar qué tipo de heterogeneidad queremos representar.
Primero debe definirse la unidad de observación. ¿Cada dato corresponde a una unidad distinta, a un momento temporal o a un evento?
Después se identifica qué parámetro podría variar. Puede cambiar la media, la varianza, una tasa de ocurrencia o incluso la familia completa.
A continuación se decide si la heterogeneidad es observada mediante covariables o si debe tratarse como latente.
Finalmente se pregunta qué predicciones adicionales produce la mezcla, entre ellas multimodalidad, sobredispersión, más ceros, colas distintas o dependencia entre observaciones de una misma unidad.
La heterogeneidad no debería introducirse únicamente porque un modelo homogéneo «ajusta mal». Debe especificarse qué estructura ausente se está añadiendo.
85.31. Heterogeneidad compartida crea dependencia marginal
La tasa latente puede afectar a más de una observación de la misma unidad.
Supongamos dos conteos
que, condicionados en , son independientes:
y
Dentro de una unidad con tasa conocida, conocer no añade información sobre más allá de .
Sin embargo, si no se observa, ambas mediciones comparten la misma fuente de heterogeneidad. Las unidades con tasa alta tienden a producir valores altos en ambos conteos; las de tasa baja, valores bajos.
La covarianza marginal puede derivarse mediante la ley de la covarianza total:
El primer término es cero por independencia condicional.
Además,
Por tanto,
En nuestro ejemplo,
Como cada conteo marginal tiene varianza ,
El paquete reproduce esta correlación mediante simulación jerárquica.
La dependencia marginal emerge al ocultar la tasa común, sin haber sido añadida directamente entre y .
85.32. Independencia condicional y dependencia marginal no se contradicen
La expresión
y el resultado
pueden parecer incompatibles solo si confundimos niveles de descripción.
Condicionar en compara realizaciones dentro de una tasa fija. Marginalizar mezcla unidades con tasas diferentes.
En la distribución condicional, una unidad con
se compara con otras realizaciones bajo la misma tasa. En la distribución marginal, esa unidad convive con otras que quizá tengan
La variación entre tasas genera una asociación común.
Este fenómeno es una aplicación probabilística del principio trabajado repetidamente en el proyecto, según el cual una propiedad puede depender del nivel al que se realiza la descripción.
La correlación marginal es una propiedad real de la distribución observable, de modo que llamarla «falsa» sería inexacto. Tampoco debemos concluir que exista una interacción directa entre los dos conteos.
La explicación del patrón está en la variable compartida.
Esto ofrece un criterio práctico. Si varias mediciones de una misma unidad son más parecidas entre sí que mediciones de unidades diferentes, una posible explicación es heterogeneidad persistente entre unidades. Esa posibilidad debe compararse con mecanismos alternativos, como interacción temporal directa.
85.33. Inflación de ceros es otra arquitectura de mezcla
La mezcla Poisson–gamma produce más ceros que una Poisson homogénea de igual media. Sin embargo, un exceso de ceros también puede construirse mediante un mecanismo distinto.
En un modelo Poisson cero-inflado, introducimos un estado latente .
Con probabilidad la observación es un cero estructural:
Con probabilidad
generamos
Entonces
Para ,
La media es
y la varianza
Con
el paquete obtiene
El modelo es sobredisperso, pero el mecanismo no es una tasa gamma continua. Existe una masa latente que produce ceros por una vía separada.
Así, observar muchos ceros y varianza elevada no permite distinguir por sí solo entre heterogeneidad continua, cero-inflación, dependencia u otras explicaciones.
85.34. La distinción científica es condicional frente a marginal
En un modelo heterogéneo conviene declarar siempre qué distribución se está describiendo.
La distribución
responde a una pregunta condicional, la de cómo varían las observaciones dentro de un estado especificado.
La distribución
responde a una pregunta marginal, la de qué observamos cuando el estado no se conoce o se ignora.
Ambas son correctas, pero pueden tener propiedades distintas.
Una distribución condicional puede ser normal mientras la marginal es multimodal, o un conteo condicional puede ser Poisson mientras el marginal es binomial negativo. Dos mediciones pueden además ser independientes condicionalmente y correlacionadas marginalmente.
Por eso no existe una única respuesta a «¿cuál es la distribución del sistema?» sin especificar qué variables se condicionan, cuáles se integran y cuál es la unidad sobre la que se formula la pregunta.
Esta distinción prepara varias ideas posteriores del currículo. Los modelos jerárquicos, los estados latentes y la agregación estadística dependerán de separar niveles de variación en vez de colapsarlos prematuramente en una sola distribución global.
85.35. Los pesos de mezcla son probabilidades, no cuotas exactas en cada muestra
Si
el modelo no afirma que toda muestra finita contenga exactamente un 60 % de observaciones de la primera componente.
Para realizaciones independientes, el número de observaciones con
es una variable binomial:
Su esperanza es
pero una muestra concreta fluctúa alrededor de ese valor.
Esto separa el parámetro de mezcla de la composición empírica observada. En muestras pequeñas, la proporción realizada puede alejarse apreciablemente de sin que el modelo haya cambiado.
La diferencia también afecta la interpretación de subgrupos raros. Un componente con peso puede no aparecer en una muestra pequeña. Su ausencia observada no demuestra peso poblacional cero.
De forma inversa, unas pocas observaciones extremas pueden hacer parecer mayor un componente pequeño de lo que realmente es.
Por tanto, los pesos pertenecen a la distribución generadora, mientras las frecuencias de etiquetas en una muestra son estadísticas aleatorias.
Esta separación es paralela a la que C83 estableció entre momentos poblacionales y momentos muestrales. También prepara C86, porque justificar que las frecuencias empíricas se estabilizan alrededor de sus probabilidades exigirá leyes de grandes números y no una igualdad exacta en cada conjunto de datos.
85.36. Verificación computacional
El paquete reproducible ejecuta controles analíticos y numéricos para las tres operaciones centrales.
Para
integra la densidad lognormal derivada mediante el jacobiano y comprueba que su masa total sea uno. Verifica por integración
y
Una simulación de realizaciones reproduce media, varianza y mediana dentro de tolerancias predefinidas.
En la mezcla normal confirma
y
La misma varianza se obtiene mediante el segundo momento marginal y mediante la ley de la varianza total. La simulación reproduce los valores analíticos.
En la mezcla Poisson–gamma verifica
y por tanto
La masa derivada analíticamente coincide con la implementación de binomial negativa de SciPy. La simulación jerárquica reproduce la media y la sobredispersión.
Se ejecutaron 41 comprobaciones automáticas y las 41 resultaron satisfactorias.
85.37. Qué queda establecido
Una transformación modifica una variable mediante una regla determinista y transporta su medida de probabilidad. El jacobiano describe cómo la transformación cambia densidad.
Una mezcla introduce una variable latente y marginaliza sobre componentes. Sus momentos contienen variación dentro y entre subpoblaciones.
La heterogeneidad de parámetros puede producir distribuciones marginales cualitativamente diferentes de las distribuciones condicionales. En particular, una tasa Poisson variable produce sobredispersión y una mezcla gamma genera una binomial negativa.
Ninguna forma distributiva identifica por sí sola cuál de estos mecanismos actúa. La asimetría puede provenir de una transformación y la multimodalidad de una mezcla. La sobredispersión puede provenir de heterogeneidad o de otras estructuras.
La tarea del modelamiento consiste en hacer explícita la arquitectura que genera la distribución.
C86 estudiará las leyes de grandes números y el teorema central del límite. Allí cambiaremos de pregunta. En vez de combinar poblaciones distintas, analizaremos qué ocurre cuando acumulamos muchas realizaciones y bajo qué condiciones aparecen estabilidad de promedios y aproximaciones gaussianas.
Referencias
- Dempster, A. P., Laird, N. M., & Rubin, D. B. (1977). Maximum likelihood from incomplete data via the EM algorithm. Journal of the Royal Statistical Society: Series B (Methodological), 39(1), 1–22. https://doi.org/10.1111/j.2517-6161.1977.tb01600.x
- Johnson, N. L., Kemp, A. W., & Kotz, S. (2005). Univariate Discrete Distributions (3rd ed.). Wiley. https://doi.org/10.1002/0471715816
- Johnson, N. L., Kotz, S., & Balakrishnan, N. (1994). Continuous Univariate Distributions, Volume 1 (2nd ed.). Wiley.
- Kallenberg, O. (2021). Foundations of Modern Probability (3rd ed.). Springer. https://doi.org/10.1007/978-3-030-61871-1
- McLachlan, G., & Peel, D. (2000). Finite Mixture Models. Wiley. https://doi.org/10.1002/0471721182
Recursos reproducibles
Descargar recursos del capítulo (ZIP, 1,1 MB).
4 archivos CSV · 4 figuras · 1 programa Python.
El programa se ha ejecutado en una carpeta vacía y genera los archivos de datos y figuras incluidos en el paquete.