76.1. Tres afirmaciones que no significan lo mismo
Los fractales clásicos de C71–C73 reproducen su geometría mediante copias reducidas. Esa propiedad puede formularse de varias maneras y no todas son equivalentes.
La autosimilitud significa, en su forma exacta, que las partes se obtienen del todo mediante similitudes, esto es, transformaciones que cambian todas las longitudes por el mismo factor, aunque puedan incluir rotaciones, reflexiones y traslaciones.
La autoafinidad permite factores de escala diferentes según la dirección. Un eje puede reducirse a la mitad mientras otro se reduce a un tercio. La forma no se conserva bajo una ampliación isotrópica, de modo que para recuperar la estructura hay que reescalar cada dirección de manera distinta.
El escalamiento estadístico es aún más débil. No exige que una realización concreta se transforme exactamente en sí misma. Exige que determinadas distribuciones o estadísticos se comporten de forma covariante al cambiar la escala.
Estas distinciones son necesarias porque en aplicaciones empíricas la palabra «autosimilar» suele usarse para cualquier objeto que parece parecido a sí mismo. Una costa, una serie temporal o una superficie pueden mostrar regularidades de escala sin contener copias geométricas exactas.
El objetivo de C76 es convertir esas diferencias en definiciones formales y ejemplos comprobables.
76.2. Las similitudes usan una sola escala para todas las direcciones
Una similitud en puede escribirse como
donde
es una transformación ortogonal y una traslación.
La propiedad esencial es
Todas las distancias cambian por el mismo factor .
Cantor utiliza similitudes con
Koch también utiliza cuatro similitudes con razón , aunque algunas ramas incluyen rotaciones.
Sierpiński utiliza tres similitudes con razón .
En estos ejemplos, la geometría reaparece mediante copias que pueden superponerse tras rotar y trasladar, sin que cambie su proporción interna.
76.3. Autosimilitud exacta
Un conjunto es exactamente autosimilar cuando existe una familia de similitudes contractivas
tal que
Esta definición enlaza directamente con los IFS de C73.
El conjunto completo es punto fijo del operador
La autosimilitud no significa que cualquier recorte arbitrario del objeto sea una copia exacta del todo. Significa que existen ramas específicas, determinadas por las transformaciones generadoras, que sí lo son.
Por ejemplo, en Cantor cada intervalo básico de nivel , una vez reescalado por , contiene una copia del conjunto completo.
El adjetivo exacta es importante. En datos naturales casi nunca puede sostenerse igualdad geométrica para un rango infinito de escalas.
76.4. Las afinidades y el escalamiento anisotrópico
Una transformación afín tiene la forma
Si no es un múltiplo escalar de una matriz ortogonal, diferentes direcciones pueden cambiar por factores distintos.
Por ejemplo,
Una separación horizontal se reduce por un factor , mientras una separación vertical se reduce por .
Los valores singulares de son
Como no coinciden, la transformación no es una similitud.
Sin embargo,
por lo que sigue siendo contractiva.
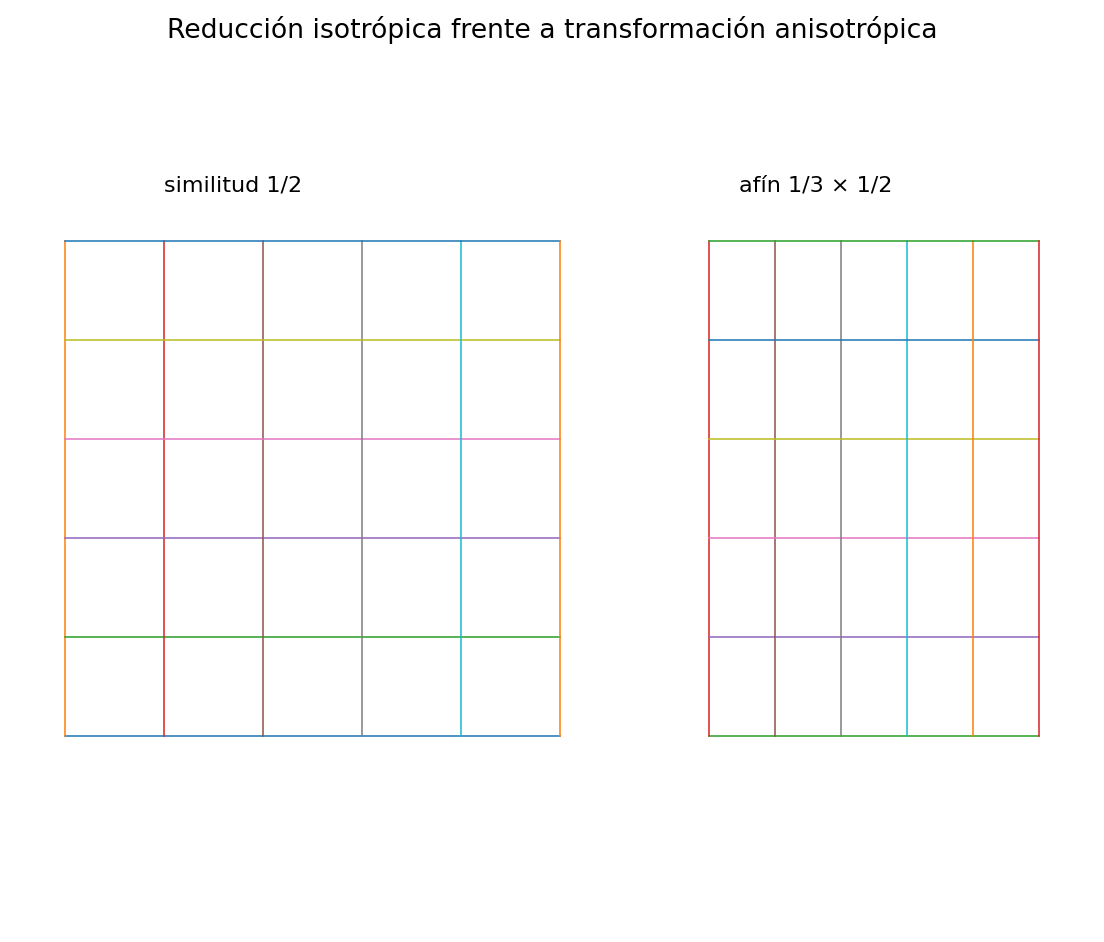
La figura 76.1 compara ambas operaciones. La reducción isotrópica conserva ángulos y proporciones; la transformación afín, en general, no.
Un IFS formado por transformaciones de este tipo puede poseer un atractor único por el mismo teorema de Hutchinson–Banach, aunque ese atractor es autoafín y no necesariamente autosimilar.
76.5. Un IFS autoafín
El paquete reproducible utiliza cuatro transformaciones con la misma parte lineal
y distintas traslaciones.
Cada rama produce una copia rectangularmente deformada del conjunto completo.
La ecuación invariante sigue siendo
aunque ninguna rama es una miniatura isotrópica de .
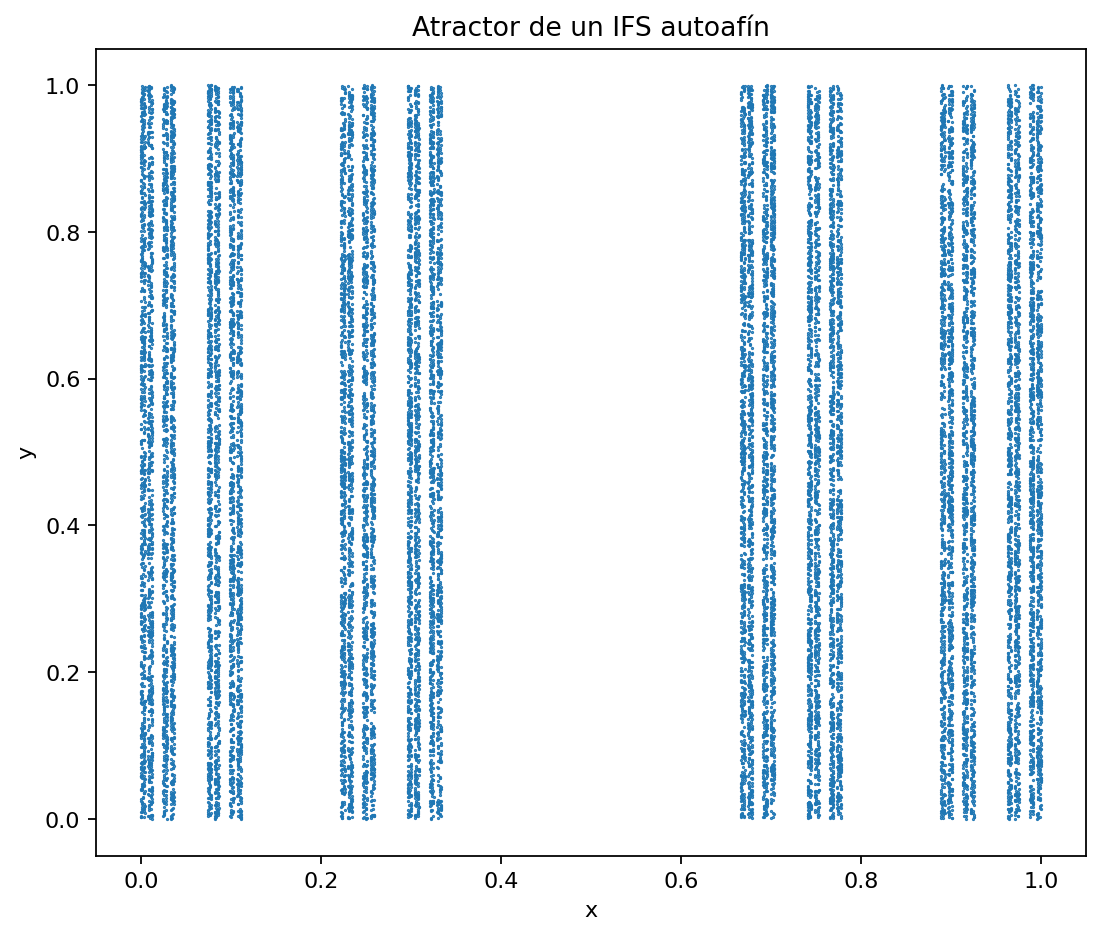
Autoafinidad significa que la estructura se recupera aplicando el reescalamiento anisotrópico adecuado.
76.6. Una autoafinidad exacta que no es fractal
La relación autoafín puede aparecer incluso en un objeto geométricamente simple.
Considérese la gráfica
con
Si reescalamos
entonces
Por tanto,
lleva la gráfica a sí misma.
La relación es exactamente autoafín.
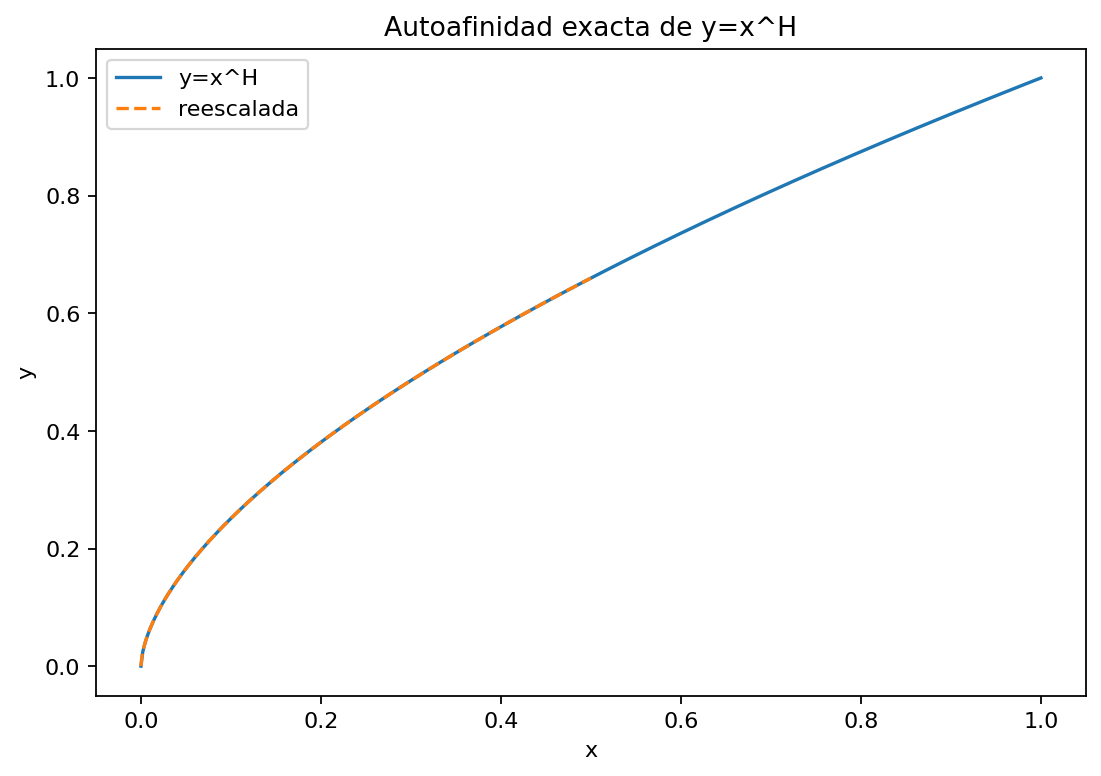
Sin embargo, para la curva restringida a sigue teniendo longitud finita. Su derivada es
Cerca de cero, el integrando de longitud se comporta como cuya integral converge porque
Por tanto, la gráfica es rectificable y su dimensión geométrica es uno.
Este ejemplo destruye una equivalencia muy útil de eliminar desde ahora,
El exponente de una ley anisotrópica no es automáticamente una dimensión.
76.7. El exponente de autoafinidad
Para una gráfica o perfil , una forma común de autoafinidad utiliza
El parámetro se denomina a menudo exponente de Hurst o exponente de rugosidad, según el contexto.
Si ambos ejes escalan igual y la transformación es isotrópica.
Si la coordenada vertical disminuye más lentamente que una potencia lineal de la horizontal al refinar la escala. En perfiles aleatorios esto suele asociarse a rugosidad persistente a pequeña escala.
La interpretación, sin embargo, depende del modelo.
En una función determinista como el exponente describe una ley exacta de homogeneidad.
En un proceso estocástico, puede describir igualdad de distribuciones tras reescalamiento.
En una superficie empírica, puede ser una pendiente estimada dentro de un rango finito.
El mismo símbolo no implica el mismo estatus epistemológico.
76.8. Escalamiento estadístico
Un proceso aleatorio
es -autosimilar en sentido estadístico si, para todo ,
El símbolo
indica igualdad de las distribuciones finito-dimensionales.
No significa para una misma realización.
La diferencia es fundamental.
Una trayectoria concreta puede verse completamente distinta después del reescalamiento. La afirmación es que si repetimos el experimento aleatorio muchas veces, el conjunto de distribuciones conjuntas es el mismo después de compensar la escala por .
Este es el sentido apropiado de «autosimilitud» para numerosos procesos aleatorios.
76.9. El movimiento browniano y el caso
Sea un movimiento browniano estándar.
Tiene media cero y covarianza
Consideremos
Su media sigue siendo cero. Su covarianza es
Como el movimiento browniano es gaussiano, media y covarianza determinan sus distribuciones finito-dimensionales.
Por tanto,
El exponente es
Una trayectoria browniana concreta no contiene copias exactas de sí misma. El escalamiento es estadístico.
76.10. Incrementos y estructura de escala
El movimiento browniano posee incrementos estacionarios, ya que tiene distribución
Por tanto,
donde
La varianza satisface
En coordenadas logarítmicas,
La pendiente es uno, que corresponde a
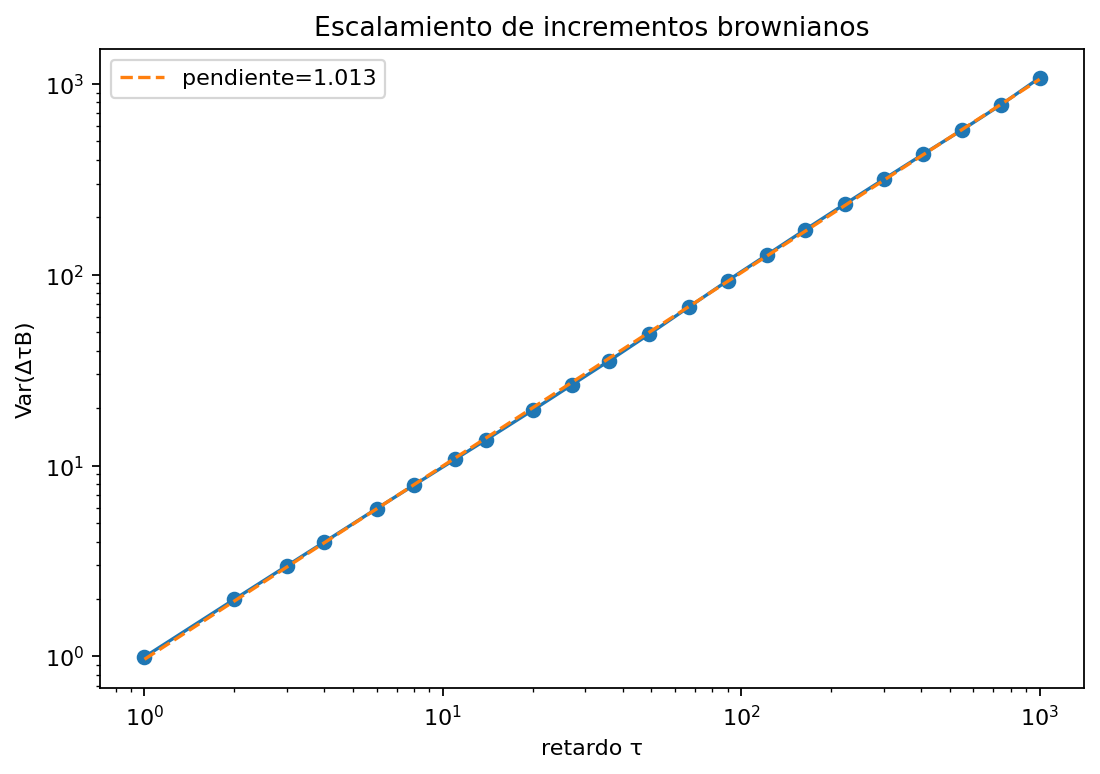
El paquete reproducible genera una trayectoria browniana y obtiene una pendiente aproximada de 0.985, es decir,
La concordancia es numérica y finita; el valor exacto proviene de la teoría.
76.11. Movimiento browniano fraccionario
Mandelbrot y Van Ness introdujeron el movimiento browniano fraccionario como una familia gaussiana
con covarianza, en una normalización estándar,
Este proceso satisface
y posee incrementos estacionarios.
El caso
recupera el movimiento browniano estándar.
Para
los incrementos muestran correlaciones positivas de largo alcance en el modelo ideal, de modo que los incrementos del mismo signo tienden a agruparse más de lo que ocurriría en Browniano.
Para
predominan correlaciones negativas, de manera que un incremento positivo tiende a compensarse con mayor frecuencia por uno negativo.
El exponente controla simultáneamente la autoafinidad estadística y la estructura de dependencia de los incrementos.
76.12. Funciones de estructura
Una herramienta general para estudiar escalamiento estadístico son las funciones de estructura.
Para un proceso , definimos
Si los incrementos satisfacen una ley autoafín con exponente ,
y existe el momento de orden , entonces
Por tanto,
con
La dependencia lineal de respecto de caracteriza un escalamiento monofractal ideal de este tipo.
El paquete verifica para Browniano que las pendientes estimadas para órdenes son próximas a
76.13. Cuando deja de ser lineal
No todos los procesos con escalamiento poseen una única que describa todos los momentos.
Puede ocurrir
con una función no lineal.
En ese caso se habla habitualmente de multiescalamiento o multifractalidad, según el marco teórico.
La curvatura de significa que distintos órdenes estadísticos responden de manera diferente al cambio de escala. Los momentos altos ponderan con mayor intensidad eventos extremos.
No desarrollaremos aquí el formalismo multifractal. Las dimensiones generalizadas y entropías de Rényi aparecerán más adelante en el currículo.
Por ahora basta distinguir
como escalamiento simple frente a
como señal de una estructura más rica que requiere análisis adicional.
76.14. Autoafinidad de una superficie
En una superficie topográfica
una ley autoafín típica puede escribirse de forma isotrópica en el plano horizontal,
mientras la altura escala como
Así, tiene, exacta o estadísticamente según el modelo, la escala
También pueden existir anisotropías horizontales,
Una única dimensión escalar puede ser entonces insuficiente para describir la geometría completa.
La autoafinidad obliga a preguntar qué coordenadas se están reescalando y con qué exponentes.
76.15. Exponente de Hurst y dimensión como relación bajo hipótesis
Para ciertas gráficas autoafines aleatorias existe una relación conocida entre el exponente de Hurst y la dimensión de la gráfica.
Para el movimiento browniano fraccionario unidimensional, bajo el modelo ideal,
casi seguramente.
En Browniano ordinario,
y la gráfica tiene dimensión de Hausdorff
casi seguramente.
Esta fórmula, sin embargo, no es una identidad universal de toda función autoafín.
La gráfica determinista satisface exactamente y, sin embargo, tiene longitud finita en para . Su dimensión es uno.
Por tanto, debe utilizarse solo cuando la clase de modelo que justifica esa relación está especificada.
76.16. Invariancia de escala discreta y continua
No todas las leyes de escala actúan sobre cualquier factor positivo.
En el conjunto de Cantor, la construcción natural reaparece exactamente cuando se cambia la escala por potencias de tres,
La estructura generadora selecciona una familia discreta de escalas privilegiadas.
Si observamos el conjunto con un factor arbitrario, por ejemplo no obtenemos necesariamente una copia exacta alineada con la construcción.
La situación de la función homogénea es distinta. Para todo se cumple
Aquí la ley es válida para una familia continua de factores de escala.
El movimiento browniano también posee autosimilitud estadística continua,
para cualquier
Esta distinción entre escalamiento discreto y continuo es importante porque una estructura puede mostrar repetición exacta solo en razones geométricas específicas y, sin embargo, producir un gráfico log-log aproximadamente lineal cuando se observan escalas intermedias.
En algunos sistemas con invariancia discreta aparecen oscilaciones periódicas en el logaritmo de la escala, conocidas como correcciones log-periódicas. No necesitamos desarrollar aquí esa teoría; basta reconocer que una ley de escala puede contener estructura más fina que una única pendiente.
Por tanto, al decir que un objeto es «invariante de escala» conviene preguntar
La respuesta puede ser «para todos», «para una secuencia discreta» o «aproximadamente dentro de cierto intervalo».
76.17. Los valores singulares cuantifican la anisotropía
En una transformación afín la matriz contiene la información local sobre cambios de escala y dirección.
Si con ortogonal, todos los valores singulares de son iguales a . La transformación es una similitud.
Si los valores singulares son distintos, el cambio de escala depende de la dirección. Esa es una forma precisa de detectar anisotropía lineal.
Para el ejemplo del capítulo,
los valores singulares son
Un círculo se transforma en una elipse. La razón entre sus semiejes queda modificada.
Esta descripción es más general que hablar solo de «escalar y de manera distinta». Si incluye rotaciones o cizallamientos, las direcciones principales de expansión pueden no coincidir con los ejes coordenados.
La descomposición en valores singulares permite escribir
donde selecciona direcciones de entrada, aplica factores de escala y orienta las direcciones resultantes.
Así, la autoafinidad puede estudiarse mediante la geometría lineal ya introducida en C15.
La conexión será importante cuando aparezcan atractores autoafines más complejos, donde una sola razón deja de ser suficiente y las tasas direccionales pasan a formar parte de la descripción.
76.18. El mismo no identifica un mismo proceso
El exponente resume una relación de escala, aunque no identifica de forma única la dinámica o la distribución subyacente.
Dos procesos pueden satisfacer
en un rango y, sin embargo, diferir en la distribución de incrementos, en la dependencia temporal de orden superior, en las colas, en la estacionariedad, en la asimetría, en la multifractalidad y en el mecanismo generador.
El movimiento browniano fraccionario es gaussiano. Esa hipótesis hace que media y covarianza determinen todas sus distribuciones finito-dimensionales.
Un proceso no gaussiano puede compartir el mismo valor de estimado desde el segundo momento sin compartir esa estructura probabilística.
Por ello, no significa automáticamente «movimiento browniano fraccionario con ».
Incluso la interpretación de persistencia requiere contexto. En fBm, está asociado a correlación positiva de los incrementos. Esa asociación es una propiedad de esa familia de procesos y no una definición universal de .
Este punto es metodológicamente importante en aplicaciones. Estimar una pendiente es mucho menos informativo que identificar un modelo probabilístico completo.
76.19. Momentos inexistentes y límites de las funciones de estructura
Las funciones de estructura utilizan momentos,
Ese momento, sin embargo, puede no existir.
En distribuciones de cola suficientemente pesada, los momentos de orden alto divergen. En ese caso, escribir
para un cuyo momento teórico es infinito carece de fundamento.
Una muestra finita siempre produce un número finito,
Ese hecho computacional no demuestra que
sea finita.
Los momentos altos son además muy sensibles a observaciones extremas. Dos muestras del mismo proceso pueden producir pendientes sustancialmente distintas si unos pocos eventos dominan la suma.
Por tanto, antes de interpretar la curvatura de
como multifractalidad, hay que comprobar que los momentos utilizados sean estadísticamente y teóricamente defendibles.
El escalamiento estadístico no puede separarse de las propiedades de la distribución que se está resumiendo.
76.20. Exactitud geométrica frente a igualdad en distribución
Podemos ordenar las tres nociones principales por la fuerza de la afirmación.
Autosimilitud exacta
con similitudes.
La igualdad ocurre entre conjuntos.
Autoafinidad exacta
con afinidades contractivas anisotrópicas. También puede aparecer como relación funcional exacta,
La igualdad sigue siendo geométrica o funcional, aunque utiliza escalas distintas por dirección.
Escalamiento estadístico
La igualdad es entre distribuciones.
Cada afirmación es diferente. Pasar de una a otra sin declararlo cambia el objeto matemático.
76.21. Escalamiento finito en datos
Los datos empíricos nunca contienen un rango infinito de escalas.
Una ley observada tiene, como máximo, un intervalo
Por debajo de pueden dominar resolución instrumental, ruido o granularidad física.
Por encima de pueden aparecer tamaño finito, fronteras o un mecanismo dinámico diferente.
Por tanto, una formulación empírica defendible dice que el observable es compatible con escalamiento de exponente en el rango especificado. La formulación indefendible afirma que el sistema es autoafín a todas las escalas, porque extrapola infinitamente más allá de los datos.
76.22. El crossover y la presencia de más de un régimen de escala
Un objeto puede mostrar pendientes diferentes en escalas diferentes.
Por ejemplo,
El valor es una escala de cruce.
Una regresión única sobre todo el rango puede producir una pendiente intermedia que no representa ninguno de los dos mecanismos.
La existencia de un crossover tampoco demuestra automáticamente dos procesos físicos distintos. Puede surgir de filtrado, ruido, resolución o tamaño finito. Obliga, eso sí, a abandonar una ley de escala única.
76.23. Tendencias y no estacionariedad
El escalamiento estadístico puede ser imitado por tendencias.
Supongamos una señal
donde es ruido estacionario.
Para retardos grandes, el incremento contiene y su segundo momento puede quedar dominado por
Un análisis ingenuo produciría una pendiente cercana a dos y sugeriría
Ese exponente proviene, sin embargo, de una tendencia determinista y no de una autoafinidad estocástica intrínseca.
La detrendización puede ser necesaria, aunque también puede eliminar estructura real si se aplica de forma arbitraria.
Por eso la estimación de escalamiento requiere un modelo de qué componentes se consideran tendencia, señal y fluctuación.
76.24. Efectos de muestreo y aliasing
Una serie temporal observada en pasos
no contiene información sobre escalas arbitrariamente menores que .
Además, procesos con dinámica rápida pueden aliasarse cuando la frecuencia de muestreo es insuficiente.
En el extremo opuesto, si la duración total es , estimar estadísticos para
utiliza muy pocos incrementos casi independientes.
El rango útil suele quedar entre ambos extremos,
Esta desigualdad es conceptual y no una receta fija. La cantidad de separación necesaria depende de correlaciones, ruido y objetivo.
Una pendiente estimada utilizando puntos cercanos a ambos límites puede ser numéricamente precisa y científicamente poco informativa.
76.25. El logaritmo no crea escalamiento
Las leyes de potencia se visualizan habitualmente en ejes logarítmicos.
Si
entonces
La pendiente aparece como una recta.
Tomar logaritmos, en cambio, no convierte cualquier relación en una ley de potencia.
Una función curva puede parecer casi lineal en un intervalo corto. Ruido heteroscedástico puede deformar el ajuste. Los errores de medición en ambos ejes violan el modelo de regresión lineal ordinaria.
El argumento de C74 reaparece aquí, ya que una recta log-log es evidencia descriptiva de un posible régimen de escala y no una demostración automática.
76.26. Anisotropía y elección de coordenadas
Una estructura puede parecer autoafín en un sistema de coordenadas y no en otro si se mezclan direcciones físicamente distintas.
Por ejemplo, en una superficie estratificada, una dirección paralela a las capas y otra perpendicular pueden poseer estadísticas diferentes.
Rotar la imagen antes de estimar un único puede mezclar ambos comportamientos.
La primera pregunta debería ser si existe simetría suficiente para justificar un mismo escalamiento horizontal.
En ausencia de isotropía, puede ser necesario estimar exponentes direccionales.
La autoafinidad es bastante más que «autosimilitud con otro nombre». Su contenido principal está en que las direcciones no son equivalentes bajo el cambio de escala.
76.27. Una ley de escala es una restricción, no un mecanismo generador
Supongamos que dos sistemas producen el mismo resultado empírico,
En ambos casos estimaríamos
si la relación apropiada fuera
Ese acuerdo no implica que ambos sistemas compartan mecanismo.
Una ley de escala restringe la forma en que un observable cambia con la resolución. No especifica por sí sola qué ecuaciones, interacciones o procesos microscópicos produjeron esa regularidad.
El mismo exponente puede aparecer en un proceso gaussiano con memoria, en una transformación determinista, en una mezcla de procesos dentro de un rango limitado o incluso como resultado aproximado de filtrado y tendencias.
Por tanto, el razonamiento correcto tiene dos etapas.
Primero se establece, con incertidumbre explícita, que existe un régimen compatible con
Después se compara qué mecanismos pueden generar ese exponente junto con las demás propiedades observadas. El exponente funciona como una restricción sobre modelos candidatos y no como identificación causal.
Esta distinción conecta la geometría fractal con un principio más general del proyecto. Reproducir una estadística no equivale a explicar su origen. Dos modelos dinámicos diferentes pueden compartir atractores con dimensiones próximas; dos procesos estocásticos distintos pueden compartir ; dos superficies generadas por mecanismos físicos diferentes pueden mostrar pendientes log-log similares.
Una afirmación empírica fuerte debería, por ello, separar la
de la
La primera puede obtenerse mediante análisis de escala. La segunda requiere predicciones adicionales, intervenciones, información independiente o comparación entre modelos rivales.
76.28. Unidades y constantes de proporcionalidad
Una ley de escala
no elimina las unidades físicas. Significa que, dentro del rango considerado,
para alguna constante compatible con las dimensiones del problema.
Si se mide en segundos o metros, cambiar la unidad modifica , aunque no el exponente . Por eso el exponente puede ser invariante frente a cambios de unidad mientras la ordenada al origen de un gráfico log-log no lo es.
En comparaciones entre sistemas conviene introducir escalas de referencia,
y expresar
La adimensionalización evita atribuir significado estructural a una constante que depende solo de centímetros frente a metros o segundos frente a horas. También obliga a declarar qué escala de referencia se utiliza.
Una ley de escala es una afirmación sobre cómo cambia una cantidad al modificar resolución o tamaño, no sobre la desaparición de las dimensiones físicas del problema.
76.29. Tres nociones y tres tipos de igualdad
Podemos resumir el capítulo con tres problemas.
El conjunto de Cantor
Para Cantor,
Las dos transformaciones reducen todas las distancias por
La igualdad es geométrica.
La gráfica
Para se cumple
La transformación apropiada del plano es
Si los ejes no escalan igual.
Sin embargo, la curva puede ser rectificable. El exponente no es por sí mismo una dimensión.
El movimiento browniano
Para Browniano,
Además,
La igualdad no se aplica a una trayectoria concreta, sino a distribuciones.
Las tres expresiones contienen una «repetición entre escalas», aunque pertenecen a categorías matemáticas distintas.
76.30. Verificación computacional
El paquete reproducible ejecuta cuatro grupos de controles.
Primero, verifica con precisión de máquina la identidad para la gráfica determinista .
También calcula aproximaciones crecientes a su longitud y confirma que convergen a un valor finito, mostrando que autoafinidad exacta no implica longitud infinita.
Segundo, verifica que la matriz
es contractiva y anisotrópica, de modo que genera un IFS autoafín.
Tercero, simula una trayectoria browniana y estima
El exponente estimado es
Cuarto, calcula funciones de estructura de órdenes y verifica pendientes próximas a
Se ejecutaron 22 comprobaciones automáticas y todas resultaron satisfactorias.
La simulación no demuestra la autosimilitud browniana. Esa propiedad se deriva de su estructura gaussiana y su covarianza. La simulación verifica que la implementación reproduce sus consecuencias estadísticas dentro del error finito esperado.
76.31. Qué debe informarse al estimar un exponente
Una estimación empírica debería especificar la definición exacta del estadístico utilizado, el rango de escalas, la frecuencia y duración de muestreo, el tratamiento de tendencias, la presencia de ruido instrumental, la incertidumbre de la pendiente, los posibles crossovers, la anisotropía y las hipótesis necesarias para relacionar con dimensión.
No todos los métodos estiman exactamente el mismo objeto.
Un exponente derivado de varianza de incrementos, uno obtenido por análisis espectral y otro producido por un método de rango reescalado pueden reaccionar de forma distinta a tendencias y dependencia temporal.
La convergencia de varios estimadores bajo supuestos compatibles aporta más evidencia que una única pendiente.
76.32. Qué aporta cada noción
La autosimilitud exacta describe una geometría compuesta por copias isotrópicas.
La autoafinidad describe geometrías o funciones que requieren reescalamiento anisotrópico.
El escalamiento estadístico describe invariancia de distribuciones o momentos bajo cambio de escala.
Pueden coexistir, aunque ninguna debe inferirse automáticamente de otra.
En particular,
Estas separaciones son más importantes que memorizar una colección de exponentes.
76.33. Hacia Julia y Mandelbrot
Hasta ahora los fractales del módulo han sido generados mediante reglas geométricas explícitas o procesos de escala definidos directamente.
El siguiente capítulo cambiará el mecanismo.
Los conjuntos de Julia y Mandelbrot emergen al iterar funciones complejas,
La geometría fractal aparecerá como frontera entre comportamientos dinámicos distintos y no como resultado de reemplazar segmentos o aplicar un IFS contractivo.
Ese cambio conectará el Módulo 8 con los mapas discretos y el caos estudiados antes, ya que la iteración volverá a ser protagonista, ahora en el plano complejo.
Referencias
Falconer, K. (2003). Fractal Geometry: Mathematical Foundations and Applications (2nd ed.). Wiley. https://doi.org/10.1002/0470013850
Mandelbrot, B. B. (1985). Self-affine fractals and fractal dimension. Physica Scripta, 32(4), 257–260. https://doi.org/10.1088/0031-8949/32/4/001
Mandelbrot, B. B., & Van Ness, J. W. (1968). Fractional Brownian motions, fractional noises and applications. SIAM Review, 10(4), 422–437. https://doi.org/10.1137/1010093
Malinverno, A. (1990). A simple method to estimate the fractal dimension of a self-affine series. Geophysical Research Letters, 17(11), 1953–1956. https://doi.org/10.1029/GL017i011p01953
Recursos reproducibles
Descargar recursos del capítulo (ZIP, 293 kB).
2 archivos CSV · 4 figuras · 1 programa Python.
El programa ilustra cálculos del capítulo. Las figuras y los CSV están incluidos, pero el script no vuelve a guardar todos esos archivos.