80.1. El problema
Los capítulos anteriores han separado varias preguntas que suelen comprimirse en una sola cifra. C74 mostró que la dimensión por conteo de cajas es un límite matemático y que una pendiente obtenida desde datos finitos es solo un estimador. C75 distinguió nociones de dimensión no equivalentes. C76 introdujo escalamiento finito y crossovers. C78 separó la dimensión del soporte de la distribución de visitas. C79 añadió la dificultad central para datos reales, dado que cualquier régimen empírico posee una escala inferior y una superior, mientras una recta log-log puede aparecer por razones que no implican una ley de escala genuina.
Este capítulo resuelve un caso completo. Recibimos una nube planar de 80.000 puntos. Se conoce, por calibración del procedimiento de observación, una incertidumbre de localización en cada coordenada. El diámetro lineal del conjunto observado es aproximadamente
No se nos dice al comienzo cómo se generó la nube. La pregunta es deliberadamente limitada. ¿Existe un intervalo de escalas en el que el conteo por cajas sea compatible con una dimensión aproximadamente constante? Y, en tal caso, ¿qué dimensión podemos defender sin seleccionar retrospectivamente la ventana que produzca la recta más atractiva?
No intentaremos demostrar autosimilitud infinita. Tampoco convertiremos el valor estimado en una explicación del mecanismo.
80.2. Qué se decidirá antes de mirar la pendiente
El procedimiento utiliza cajas cuadradas de lado . Para cada escala contamos las cajas ocupadas y trabajamos con
Si existe un régimen
entonces
La pendiente es el estimador de . El punto metodológico es que no elegiremos y maximizando .
Fijamos primero dos reglas operativas. La escala inferior será
El factor diez no es una constante matemática. Es una decisión conservadora destinada a mantener el ajuste suficientemente por encima de la incertidumbre de localización. Su arbitrariedad residual se examinará después utilizando factores 8, 10 y 12.
Para el extremo superior exigimos que el tamaño de caja sea como máximo una décima parte de la extensión lineal observada,
Tampoco es un teorema. Impide que unas pocas cajas macroscópicas dominen el ajuste. Más adelante cambiaremos el divisor entre 8 y 12.
Estas reglas producen un rango nominal de
décadas. La decisión queda fijada antes de examinar qué pendiente resulta.
80.3. La malla también forma parte del estimador
A escala finita, el conteo depende del origen de la cuadrícula. Una frontera que cae justo sobre una línea de la malla puede requerir un número de cajas distinto del obtenido después de trasladar la cuadrícula una fracción de .
Usaremos nueve orígenes. En cada eje desplazamos la malla por
lo que genera nueve combinaciones. Para el ajuste principal tomamos la mediana de los nueve conteos. Además conservamos mínimo, máximo y cada conteo individual.
La mediana no define una nueva dimensión matemática. Es una convención computacional destinada a reducir la dependencia de una alineación particular. Como se trata de una elección del algoritmo, su efecto debe quedar disponible para auditoría.
Las escalas evaluadas se distribuyen logarítmicamente entre y
El rango completo se conserva para visualizar los cortes, aunque solo las escalas prefijadas entran al ajuste principal.
80.4. La nube observada
La figura 80.1 muestra una octava parte de los puntos, únicamente para mantener legible la imagen.
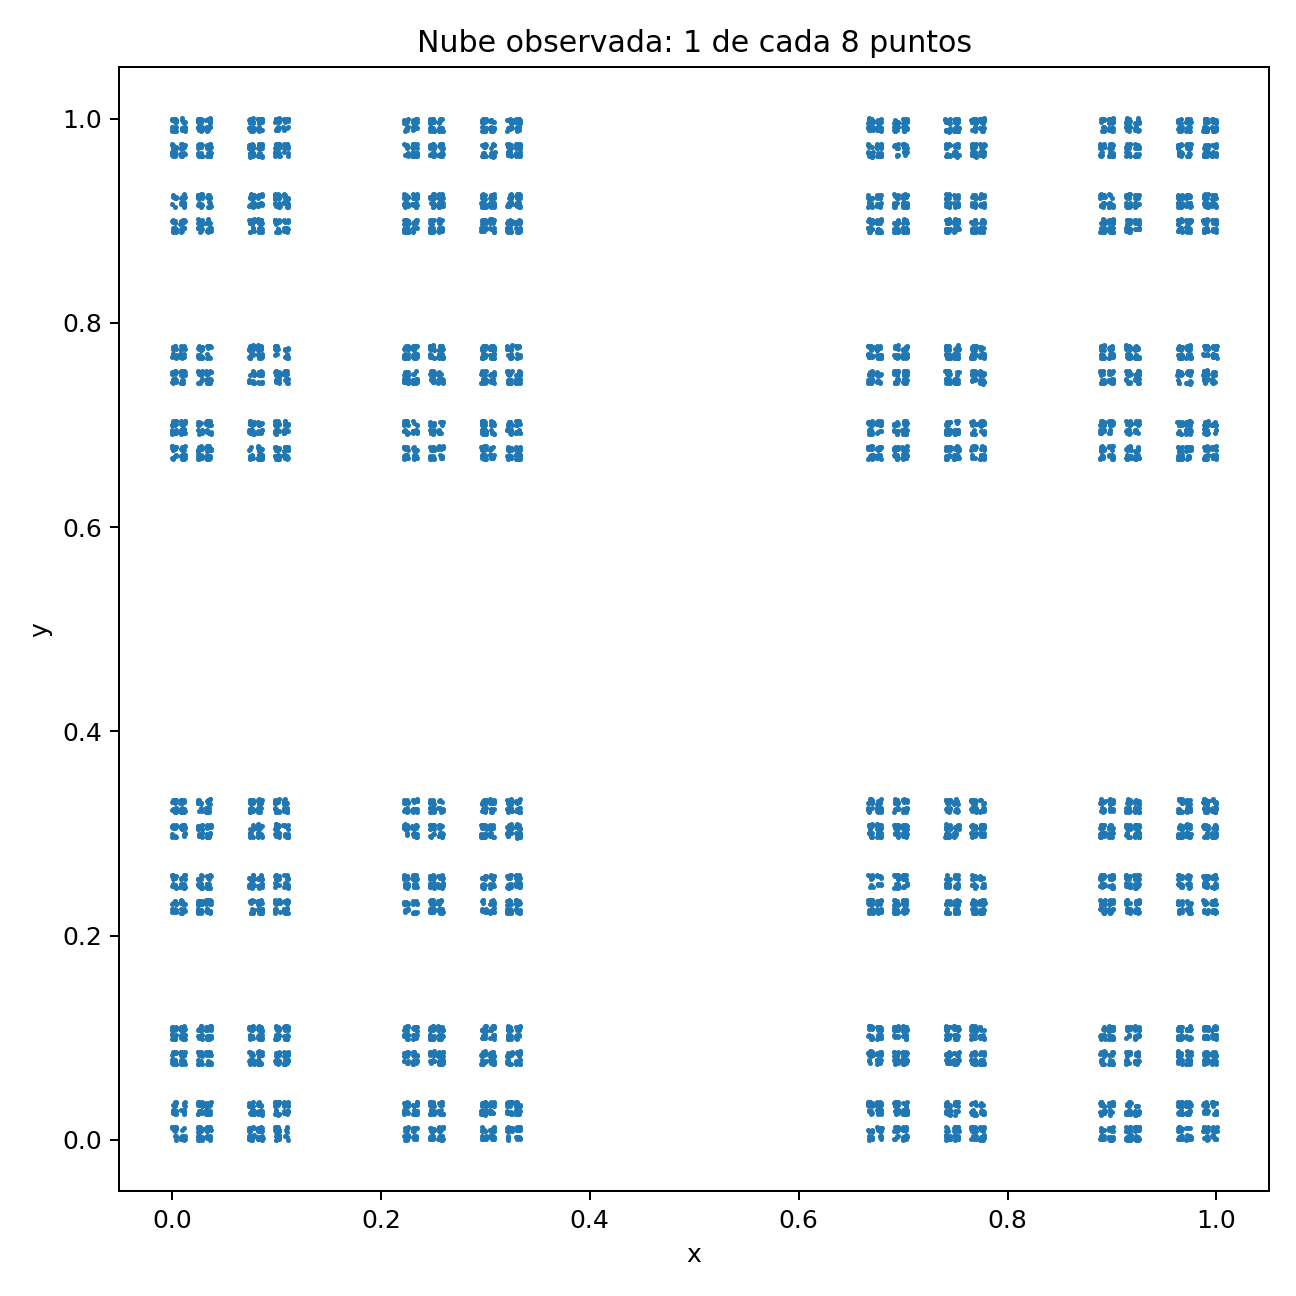
La estructura parece jerárquica. Esa impresión es útil para formular preguntas, sin decidir la dimensión. Una nube con huecos repetidos puede proceder de un fractal ideal, de un prefractal, de una regla de agrupamiento con pocas escalas o de una representación procesada.
Por eso no utilizaremos la apariencia visual para fijar los límites del ajuste.
80.5. Conteo por cajas
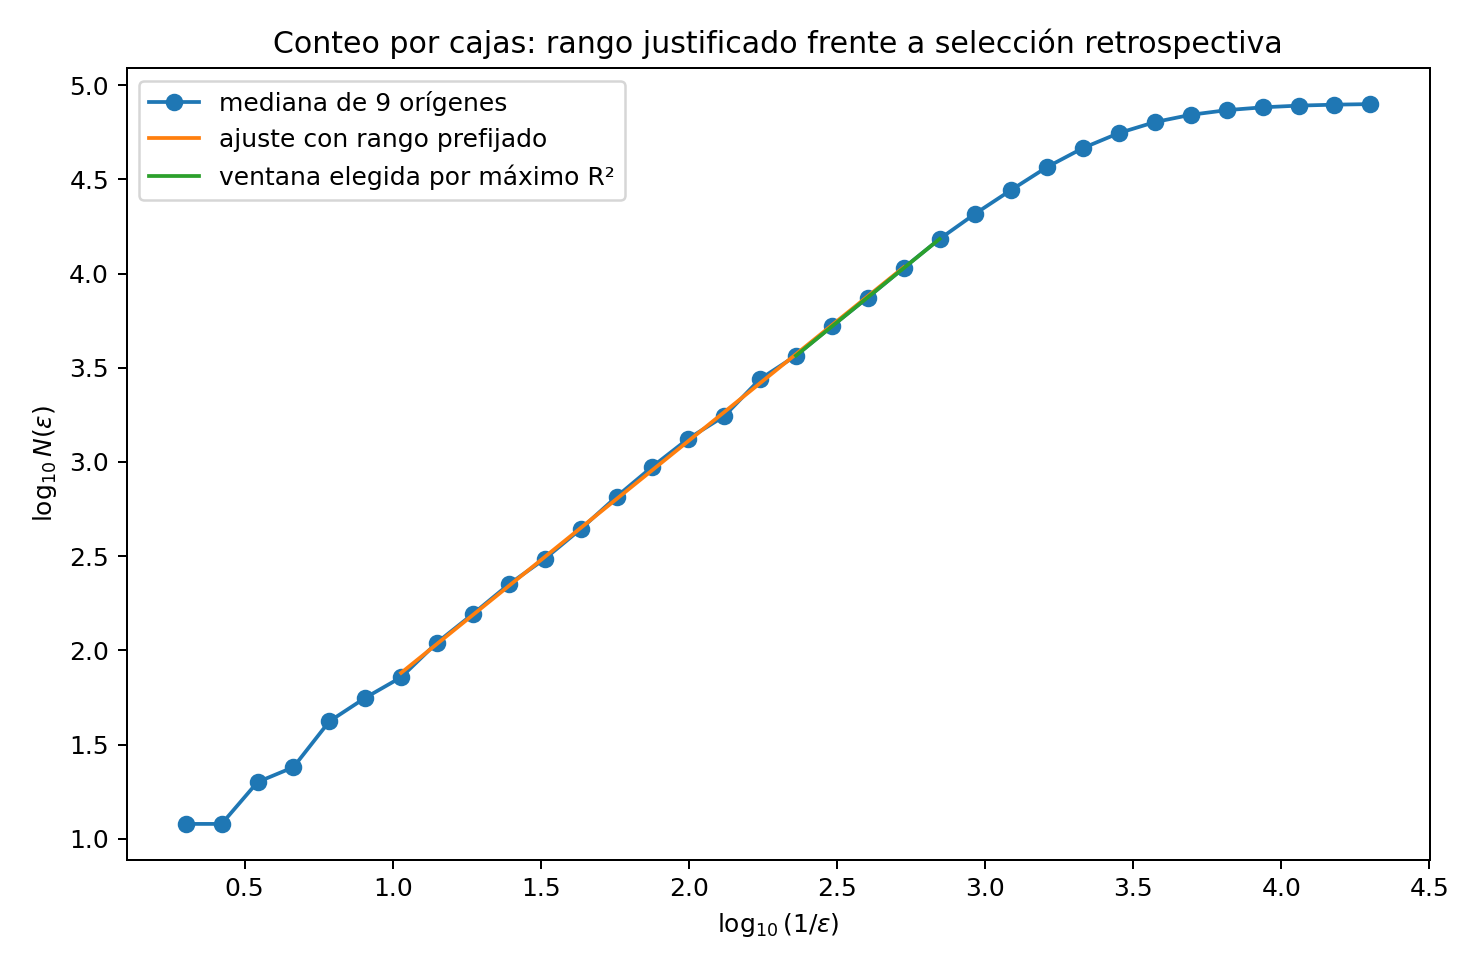
Para cada calculamos
correspondiente a cada origen de malla. Definimos entonces el resumen
En el rango prefijado ajustamos
donde es el residuo.
El resultado es
El coeficiente de determinación descriptivo es
Conviene detenerse en la palabra «descriptivo». Los conteos en escalas sucesivas no son observaciones independientes, porque cada refinamiento reutiliza la misma nube y está matemáticamente relacionado con los conteos anteriores. Por ello no trataremos los errores estándar ordinarios de una regresión lineal como si provinieran de muestras independientes. El ajuste proporciona una pendiente y residuos; la incertidumbre metodológica se evaluará mediante estabilidad frente a decisiones del procedimiento.
80.6. Una recta no basta
El valor alto de no constituye la conclusión. Debemos preguntar si la pendiente es aproximadamente estable a lo largo del intervalo.
Calculamos regresiones móviles de cinco escalas consecutivas. Su centro geométrico define la escala representativa de cada ventana. Dentro del rango prefijado, la media de estas pendientes es y su desviación estándar descriptiva es
No esperamos una línea perfectamente horizontal. El conteo por cajas de una muestra finita presenta oscilaciones por alineación, discreción y estructura jerárquica. Lo relevante es que no aparece una deriva sostenida comparable con el cambio de pendiente visible fuera de la región útil.
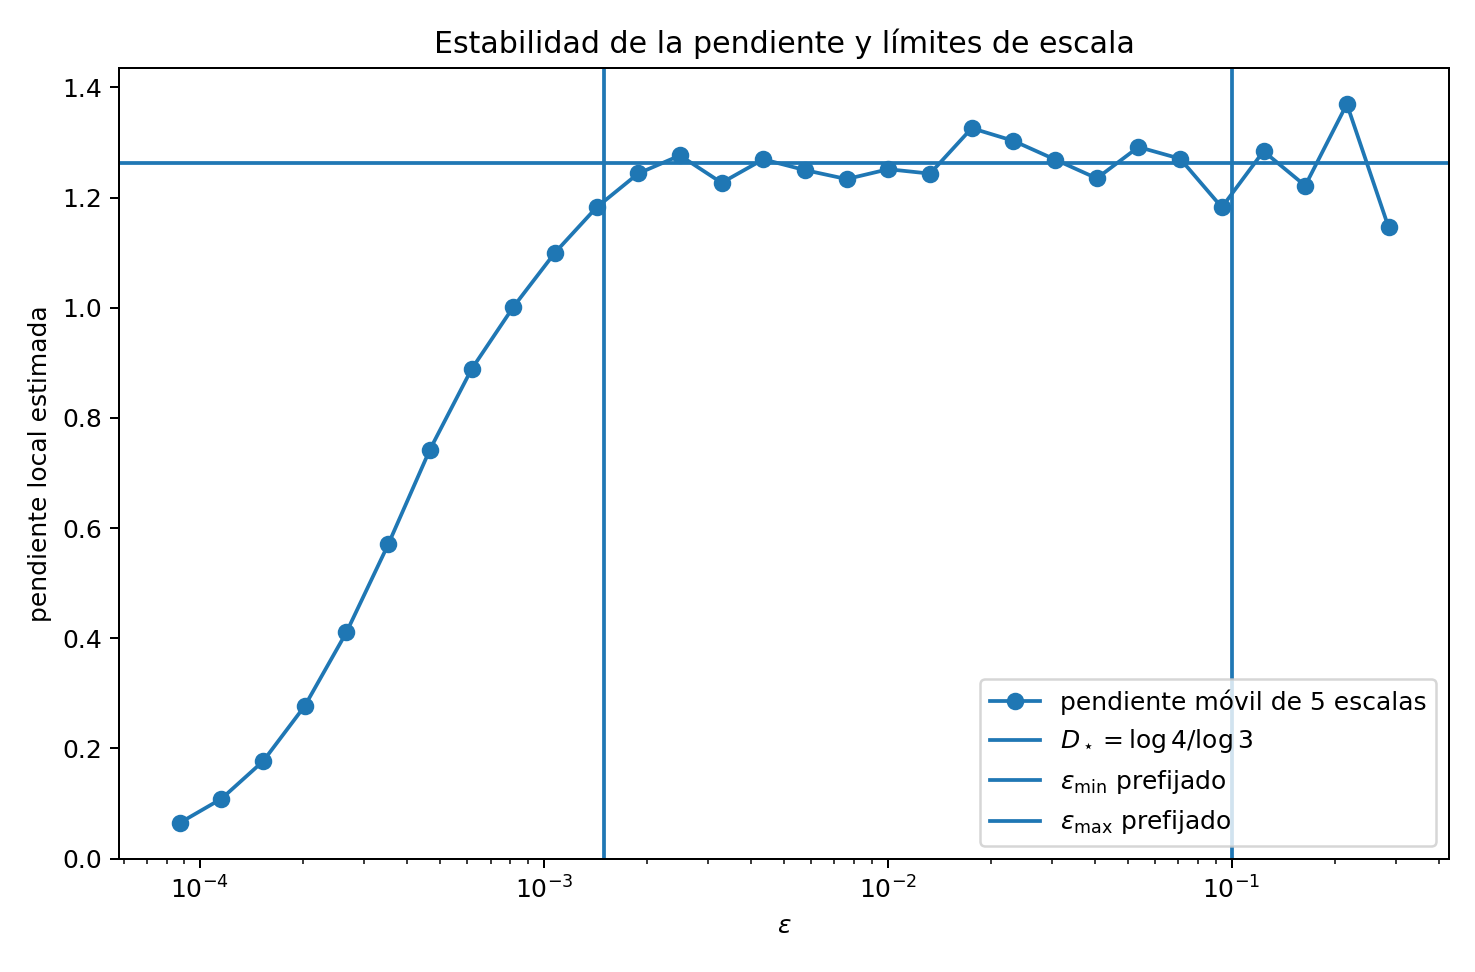
Por debajo de la escala inferior, la pendiente colapsa progresivamente. Esto no demuestra que el objeto subyacente pierda estructura. En esa región confluyen incertidumbre de localización, tamaño muestral y saturación del número de cajas ocupadas. El estimador deja de disponer de información suficiente para extrapolar hacia .
En el extremo grueso aparecen menos niveles de estructura y aumenta la influencia del tamaño global. La decisión de excluir esas escalas no se tomó porque «arruinaran» la recta, sino porque responden a una resolución distinta del objeto.
80.7. El error de ajustar todo lo disponible
Una estrategia aparentemente objetiva sería usar las 34 escalas sin excluir ninguna. El resultado es
con
La pendiente ya no representa el régimen intermedio. Mezcla la saturación fina, el tramo jerárquico y el comportamiento macroscópico.
Este ejemplo muestra que «usar todos los datos» no siempre es metodológicamente neutral. Si el modelo postula una ley válida solo dentro de un régimen, combinar escalas gobernadas por mecanismos distintos viola el propio modelo que se intenta estimar.
Excluir escalas puede ser correcto. Lo problemático es excluirlas después de observar cuál selección entrega la cifra deseada.
80.8. Qué ocurre si elegimos la ventana por el mejor
Ahora aplicamos deliberadamente un procedimiento defectuoso. Examinamos todas las ventanas de 5 a 10 escalas consecutivas y seleccionamos la que maximiza .
La ventana ganadora abarca
con solo
décadas. Produce
y
El ajuste es visualmente mejor que el principal. Sin embargo, cubre menos de un tercio de su rango dinámico. Haber probado muchas ventanas convierte ese extremo en parte de un procedimiento de selección.
El problema se hace más visible si no observamos solo la ganadora. Existen 26 ventanas con y sus pendientes van aproximadamente desde hasta
Por tanto, haber encontrado una recta con no identifica una dimensión única. La flexibilidad para elegir la ventana produce muchas rectas excelentes.
80.9. Por qué más puede significar menos evidencia
En un intervalo pequeño, cualquier curva suave puede aproximarse localmente por una recta. Esta es una consecuencia elemental de la expansión de Taylor y no una propiedad especial de los fractales.
Si
es dos veces diferenciable cerca de ,
Al reducir la amplitud de la ventana, el término cuadrático disminuye como el cuadrado de esa amplitud. El gráfico se vuelve inevitablemente más lineal aunque .
Por eso un procedimiento que recompensa exclusivamente tiene un incentivo incorporado para escoger intervalos cortos. En análisis de escalamiento, la calidad del ajuste y la amplitud del rango deben examinarse conjuntamente.
Malcai y colaboradores formalizaron la importancia de los cortes y del rango de escalamiento en fractales empíricos. El principio no consiste en exigir un número mágico de décadas, sino en declarar cuánto rango sostiene la inferencia.
80.10. Sensibilidad a los cortes prefijados
La elección de y contiene convenciones. Para comprobar si la estimación depende críticamente de ellas, repetimos el análisis con
y
Las nueve combinaciones producen estimaciones entre y
La amplitud es inferior a 0,01. Este resultado es más informativo que añadir decimales a la regresión principal, porque dentro de un conjunto razonable de decisiones sobre los límites la pendiente central permanece estable.
No se concluye que esos nueve pares agoten todas las decisiones plausibles. Se demuestra algo más acotado, a saber, que el resultado no depende de manera frágil del valor exacto 10 elegido inicialmente.
80.11. Sensibilidad al origen de la malla
Al ajustar cada uno de los nueve orígenes por separado, las pendientes van desde hasta
Esta variación es mayor que la producida por mover modestamente los cortes. Por tanto, el origen de malla es una fuente de incertidumbre computacional relevante en esta muestra.
No sería apropiado informar como si los seis decimales expresaran precisión empírica. Es más fiel decir que el estimador central está cerca de 1,27 y que las variantes de malla razonables producen aproximadamente 1,24–1,31.
La cifra con seis decimales se conserva en los recursos únicamente para reproducibilidad numérica.
80.12. Sensibilidad al tamaño muestral
El mismo procedimiento se repite después de conservar aleatoriamente la mitad y un cuarto de los puntos, con semilla fijada.
Con el 50 % de la muestra obtenemos
Con el 25 %,
La estimación disminuye al empobrecer el muestreo.
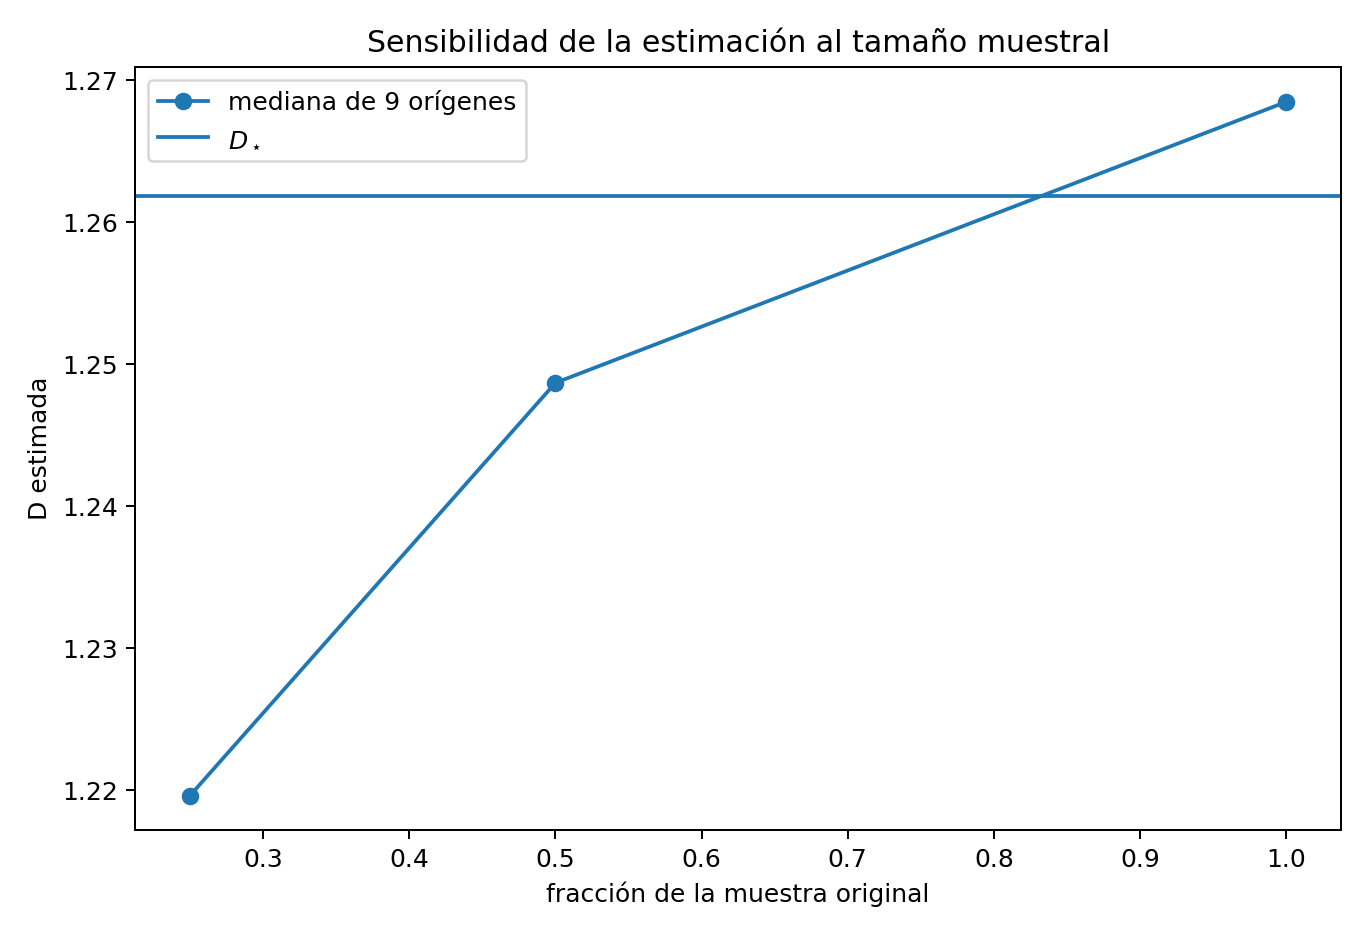
La interpretación no es que la dimensión física cambie al borrar puntos. Cambia el estimador porque las cajas finas dejan de ocuparse con suficiente densidad. Esta es la distinción de C74 entre una propiedad matemática y su estimación desde una nube finita.
Este control también muestra por qué aumentar el número de escalas calculadas no compensa automáticamente una muestra insuficiente. Podemos evaluar cien valores de , aunque si las escalas finas contienen muy pocos puntos, esos cien números no crean información geométrica nueva.
80.13. La recta debe fallar de forma no sistemática
Hasta ahora hemos resumido la calidad del régimen mediante la pendiente, el rango cubierto y las pendientes móviles. Falta mirar qué información queda en los residuos.
Si el modelo de escala es adecuado dentro del intervalo elegido,
con
no esperamos que sea exactamente cero. La nube es finita, la cuadrícula introduce oscilaciones y los conteos son discretos. Sí esperamos, en cambio, que los residuos no describan una curvatura sostenida que la recta esté intentando ocultar.
Imaginemos un patrón donde los residuos sean negativos en ambos extremos y positivos en el centro. Una regresión puede conservar un muy alto porque la mayor parte de la variación de se explica por el crecimiento global con . Aun así, la forma arqueada de los residuos indicaría que la pendiente efectiva está cambiando con la escala.
Esta es la razón por la que el análisis de C79 no puede reducirse a establecer un umbral como
Un modelo puede superar ese umbral y fallar de manera estructurada. El diagnóstico relevante es si existe información sistemática en aquello que la recta no explica.
En este caso, las pendientes móviles dentro del rango admisible fluctúan alrededor del valor central sin mostrar una transición monotónica desde una dimensión hacia otra. Las oscilaciones locales son visibles, aunque no organizan un arco persistente. Esta observación es compatible con un régimen aproximadamente constante.
La palabra «compatible» sigue siendo importante. El hecho de no detectar curvatura no demuestra que la curvatura sea exactamente cero. Con un rango mayor o con datos más precisos podrían aparecer desviaciones hoy invisibles.
También debemos evitar un error simétrico. Una pequeña oscilación periódica alrededor de la recta no obliga a rechazar el escalamiento. Los fractales con autosimilitud discreta pueden exhibir correcciones log-periódicas asociadas a la razón preferente de escala. En nuestro generador existen niveles triádicos, de modo que cierta estructura oscilatoria del conteo entre escalas no triádicas es esperable.
La pregunta práctica no es entonces si los puntos forman una recta perfecta, sino si una pendiente aproximadamente constante resume el intervalo mejor que la hipótesis de una transición sistemática dentro de ese mismo intervalo.
80.14. Cambio de unidades y cambio de geometría
El paquete reproduce el análisis después de expresar todas las longitudes en milímetros, es decir, mediante
Entonces
El cambio añade una constante al eje horizontal sin alterar sus diferencias. Por tanto, la pendiente satisface
La comprobación numérica confirma la igualdad con precisión de máquina.
Esto parece elemental, aunque ayuda a separar una propiedad de escala de una convención de unidades. Si una estimación cambia porque pasamos de metros a milímetros, el algoritmo está mal implementado.
No todos los cambios de coordenadas son tan inocuos. Una transformación lineal con factores distintos en cada eje puede convertir una estructura autosimilar en una representación anisotrópica. Una deformación suave bi-Lipschitz conserva la dimensión de cajas asintótica bajo las hipótesis habituales, aunque puede alterar de forma apreciable los conteos a escala finita. Una transformación no regular puede modificar incluso la dimensión.
Por eso, cuando el objeto empírico procede de una imagen, conviene saber si los píxeles representan la misma longitud física en ambos ejes. Si una dirección fue comprimida para ajustar la figura a una pantalla y después se ejecuta el conteo sobre esa imagen deformada, el procedimiento ya no analiza la geometría original.
En nuestro caso las coordenadas utilizan la misma unidad y la misma escala en e . El cambio de metros hipotéticos a milímetros solo desplaza el gráfico logarítmico. Esta verificación funciona como prueba de consistencia del código.
La distinción enlaza con C76. Un exponente de escala puede ser independiente de las unidades y, al mismo tiempo, depender de qué transformación geométrica se considere legítima para comparar dos representaciones.
80.15. Qué ocurre cuando la resolución instrumental no es conocida
El caso ha sido deliberadamente favorable en un aspecto, ya que conocemos mediante calibración independiente. Eso permite establecer una escala inferior antes de mirar la geometría.
En datos reales, esa información puede faltar. Una imagen histórica puede no conservar metadatos ópticos. Una base de coordenadas puede haber pasado por varios procesos de redondeo. Una serie digital puede registrar la frecuencia de muestreo sin documentar el filtrado aplicado por el dispositivo.
En esa situación no sería correcto estimar primero una dimensión y después declarar que el punto donde la pendiente comienza a desviarse «debe ser la resolución». El mismo gráfico se estaría utilizando para inferir simultáneamente la ley y el límite que permite verla. La circularidad no hace imposible el análisis, aunque debilita la fuerza de la conclusión.
Una estrategia es obtener información externa. Puede repetirse la medición con otro instrumento, estudiar patrones de calibración o comparar versiones con distinta resolución conocida. Si el corte inferior se desplaza cuando cambia la resolución instrumental mientras el régimen intermedio permanece, aumenta la evidencia de que el corte pertenece a la observación y no al objeto.
Otra posibilidad consiste en tratar explícitamente la escala inferior como parámetro de sensibilidad. En lugar de elegir una única frontera y ocultar la decisión, se calcula
sobre una región de valores plausibles. El resultado deja de ser un número y se convierte en una superficie de estabilidad. Eso es lo que la tabla sensibilidad_cortes.csv aproxima en este ejercicio mediante nueve combinaciones.
Si ninguna región amplia produce una pendiente estable, la conclusión correcta puede ser que los datos no permiten estimar una dimensión de escala con suficiente robustez. No existe obligación metodológica de terminar cada análisis con un .
Este punto es importante porque el sesgo más peligroso no consiste únicamente en obtener una cifra equivocada. También consiste en convertir una pregunta que los datos no resuelven en una estimación aparentemente precisa.
En el caso actual, la existencia de metadatos y la estabilidad ante factores 8, 10 y 12 permiten defender la ventana seleccionada. Sin esa información, el mismo gráfico sería evidencia más débil y la redacción final tendría que reflejarlo.
80.16. Revelación del generador
Solo después de completar el análisis revelamos cómo se construyeron los datos.
El cuadrado unidad se sometió a una regla de tipo polvo de Cantor. En cada nivel se conservaron cuatro cuadrados de esquina, cada uno con razón lineal
La construcción se detuvo después de diez niveles. Dentro de cada cuadrado terminal se distribuyeron puntos uniformemente. Después se añadió error gaussiano independiente con desviación estándar a cada coordenada.
La versión infinita ideal del polvo de Cantor tiene dimensión de similitud
Nuestra estimación principal fue
con una diferencia
El error relativo respecto del exponente jerárquico es aproximadamente
La proximidad es satisfactoria, aunque la interpretación correcta requiere una precisión conceptual adicional.
80.17. El objeto observado no posee como dimensión asintótica
La construcción se detuvo en el nivel 10. El objeto latente antes del muestreo es una unión finita de pequeños cuadrados con área positiva. Si pudiéramos refinar indefinidamente dentro de esos cuadrados, su dimensión por cajas sería 2, no .
La nube registrada contiene solo 80.000 puntos. Considerada literalmente como conjunto finito, su dimensión de Hausdorff y su dimensión de cajas asintótica son 0. Además, el error gaussiano describe un proceso de observación con soporte continuo.
Entonces, ¿qué recuperó el valor 1,268?
Recuperó el exponente del régimen jerárquico intermedio. Entre la escala macroscópica y la escala donde terminan la jerarquía, la resolución y el muestreo, el número de estructuras crece aproximadamente como
Esto demuestra por qué C79 insistió en no identificar fractalidad empírica con una dimensión asintótica. El estimador puede ser correcto respecto de la pregunta finita y falso respecto de una pregunta más fuerte que nunca fue observada.
80.18. Qué habría sido una conclusión incorrecta
A partir de los mismos datos podrían haberse escrito varias conclusiones demasiado fuertes.
La primera sería que el conjunto tiene dimensión fractal exacta 1,268. No sabemos eso y, en este caso sintético, sabemos que es falso si se interpreta asintóticamente.
La segunda sería que el alto demuestra una ley de potencia. El experimento de selección retrospectiva mostró que múltiples ventanas estrechas tienen y pendientes diferentes.
La tercera sería que el exponente identifica el mecanismo de generación. Tampoco. Incluso conocer no revela por sí solo que existan cuatro copias a escala 1/3. Otros mecanismos pueden producir exponentes próximos.
La cuarta sería que la incertidumbre es el error estándar de la regresión. Esa cifra ignoraría origen de malla, tamaño muestral y límites de escala.
La conclusión defendible es más específica. La nube observada presenta un régimen de conteo por cajas compatible con entre aproximadamente y unidades, estable frente a variaciones moderadas de los cortes y algo más sensible al origen de malla y al tamaño muestral.
80.19. Una nota sobre ajuste estadístico
La expresión
es una ley de potencia entre dos cantidades de escala. No debe confundirse automáticamente con una distribución de probabilidad de cola potencial
Clauset, Shalizi y Newman desarrollaron métodos de máxima verosimilitud, bondad de ajuste y comparación de modelos para el segundo problema. Sus advertencias sobre seleccionar rangos y confiar en regresiones log-log son metodológicamente pertinentes, aunque su estimador no se trasplanta sin más al conteo por cajas.
Aquí los valores son resúmenes anidados de la misma nube. No son una muestra independiente de una variable aleatoria con distribución de Pareto. Esta diferencia importa porque una técnica estadística válida para una ley de potencia distribucional puede ser inapropiada para una relación de escalamiento geométrico.
La forma algebraica parecida no vuelve equivalentes los problemas inferenciales.
80.20. Un protocolo reutilizable
Del caso puede extraerse una secuencia de trabajo.
Primero se define qué dimensión se pretende estimar y qué objeto entra al algoritmo. Después se documentan resolución, ruido y tamaño de muestra. Los límites de escala se justifican con esa información antes de optimizar una pendiente.
Luego se calculan los conteos conservando suficiente detalle para evaluar dependencia de malla. El gráfico log-log se inspecciona junto con pendientes locales o móviles. La regresión resume el régimen solo después de haber defendido el intervalo.
Finalmente se repite el cálculo bajo decisiones razonablemente próximas. Si pequeñas variaciones de escala, origen o muestreo cambian sustancialmente el exponente, la fragilidad forma parte del resultado.
Este protocolo no garantiza que la explicación fractal sea correcta. Reduce una fuente concreta de autoengaño, la de utilizar la flexibilidad analítica para descubrir a posteriori la ventana que confirma la hipótesis.
80.21. Verificación computacional
El script genera de nuevo la nube completa desde una semilla fija y conserva tanto las coordenadas latentes como las observadas. Calcula 34 escalas y nueve orígenes de malla. Produce el ajuste prefijado, las pendientes móviles y las tablas de sensibilidad.
También ejecuta la búsqueda retrospectiva de ventanas de 5 a 10 escalas. Esa búsqueda no se utiliza para estimar la dimensión principal. Se conserva como control adversarial para mostrar qué puede conseguirse si se permite elegir el intervalo después de observar los resultados.
Las verificaciones automáticas comprueban la dimensión jerárquica exacta, la amplitud del rango, la monotonicidad de los conteos, la cercanía de la pendiente central a , la estabilidad frente a cortes, la variación por origen de malla, la degradación por reducción de muestra y la invariancia de la pendiente ante un cambio de unidades.
Se ejecutaron 36 comprobaciones automáticas y todas resultaron satisfactorias.
Las comprobaciones validan la consistencia entre fórmulas, datos y código. No transforman el análisis finito en una demostración de fractalidad asintótica.
80.22. Cierre del Módulo 8
El recorrido desde C71 hasta C80 comenzó con fractales matemáticos exactos y terminó con una inferencia finita.
Cantor y Koch permitieron separar longitud, medida y dimensión. Los sistemas de funciones iteradas formalizaron la autosimilitud. El conteo por cajas mostró cómo una definición asintótica se convierte en un estimador. Hausdorff obligó a abandonar la idea de una dimensión fractal única. La autoafinidad y el escalamiento estadístico ampliaron el lenguaje. Julia y Mandelbrot conectaron fractalidad con iteración dinámica. C78 incorporó medidas y distribución de visitas. C79 introdujo los cortes y las explicaciones rivales.
C80 añade la regla operativa que faltaba, según la cual la ventana de escala no puede ser una consecuencia silenciosa del resultado que queremos obtener.
Una estimación útil no necesita fingir una precisión que los datos no poseen. En este caso, la información fuerte no es que aparezcan seis decimales en una pendiente. Es que un rango de casi dos décadas, fijado con criterios externos al ajuste, recupera el exponente jerárquico esperado y permanece razonablemente estable bajo controles explícitos.
El módulo siguiente introduce probabilidad, incertidumbre y muestreo de manera sistemática. Esa transición permitirá reemplazar varias de las evaluaciones descriptivas utilizadas aquí por herramientas probabilísticas más generales, sin alterar la separación fundamental entre una propiedad del modelo, un estimador y la evidencia disponible.
Referencias
Berntson, G. M., & Stoll, P. (1997). Correcting for finite spatial scales of self-similarity when calculating fractal dimensions of real-world structures. Proceedings of the Royal Society B: Biological Sciences, 264(1387), 1531–1537. https://doi.org/10.1098/rspb.1997.0212
Clauset, A., Shalizi, C. R., & Newman, M. E. J. (2009). Power-law distributions in empirical data. SIAM Review, 51(4), 661–703. https://doi.org/10.1137/070710111
Dubuc, B., Quiniou, J. F., Roques-Carmes, C., Tricot, C., & Zucker, S. W. (1989). Evaluating the fractal dimension of profiles. Physical Review A, 39(3), 1500–1512. https://doi.org/10.1103/PhysRevA.39.1500
Falconer, K. (2003). Fractal Geometry: Mathematical Foundations and Applications (2nd ed.). Wiley. https://doi.org/10.1002/0470013850
Malcai, O., Lidar, D. A., Biham, O., & Avnir, D. (1997). Scaling range and cutoffs in empirical fractals. Physical Review E, 56(3), 2817–2828. https://doi.org/10.1103/PhysRevE.56.2817
Recursos reproducibles
Descargar recursos del capítulo (ZIP, 3,1 MB).
7 archivos CSV · 4 figuras · 1 programa Python.
El programa se ha ejecutado en una carpeta vacía y genera los archivos de datos y figuras incluidos en el paquete.