99.1. Una escala entre el nodo y la red completa
Los capítulos C91–C98 recorrieron varias escalas de una red.
El grado describe nodos individuales. Los caminos y distancias conectan pares. Los triángulos describen cierre local. Las centralidades resumen distintas posiciones estructurales. Los modelos aleatorios permiten preguntar si una propiedad observada excede una referencia.
Ahora introducimos una escala intermedia:
que presentan más conexiones internas de las esperadas respecto de alguna referencia.
Estos grupos suelen llamarse comunidades.
La palabra puede sugerir entidades sociales bien delimitadas. Matemáticamente, sin embargo, una comunidad es una hipótesis sobre organización mesoscópica de la red.
No toda red tiene una partición única y evidente, ni todo algoritmo de detección recupera una «verdad oculta».
C99 estudiará una de las formulaciones más influyentes, la modularidad.
99.2. Partición de los nodos
Sea un grafo no dirigido.
Una partición divide el conjunto de nodos en grupos no solapados:
Debe cumplirse
para
y
Cada nodo pertenece exactamente a una comunidad.
Esta es una partición dura.
Más adelante veremos que algunas redes empíricas pueden requerir pertenencias solapadas o jerárquicas. La modularidad estándar que utilizaremos aquí trabaja con una partición.
99.3. Más aristas internas no basta
Supongamos que un grupo contiene cien nodos y otro solo cinco.
El grupo grande dispone de muchas más oportunidades para contener aristas internas.
También puede concentrar nodos de grado muy alto.
Por eso no basta contar:
Necesitamos compararlas con cuántas esperaríamos si las conexiones se reorganizaran bajo una referencia que preserve ciertas restricciones.
La modularidad incorpora una referencia basada en los grados.
La pregunta, por tanto, no es si hay muchas aristas internas, sino si hay más de las esperadas dado el volumen de conexiones de esos nodos.
99.4. Un ejemplo limpio con cuatro grupos densos
El paquete construye cuatro cliques de ocho nodos.
Cada clique contiene
aristas internas.
Los cuatro cliques se conectan formando un anillo mediante una arista entre cada par de grupos vecinos.
La red completa tiene nodos y aristas.
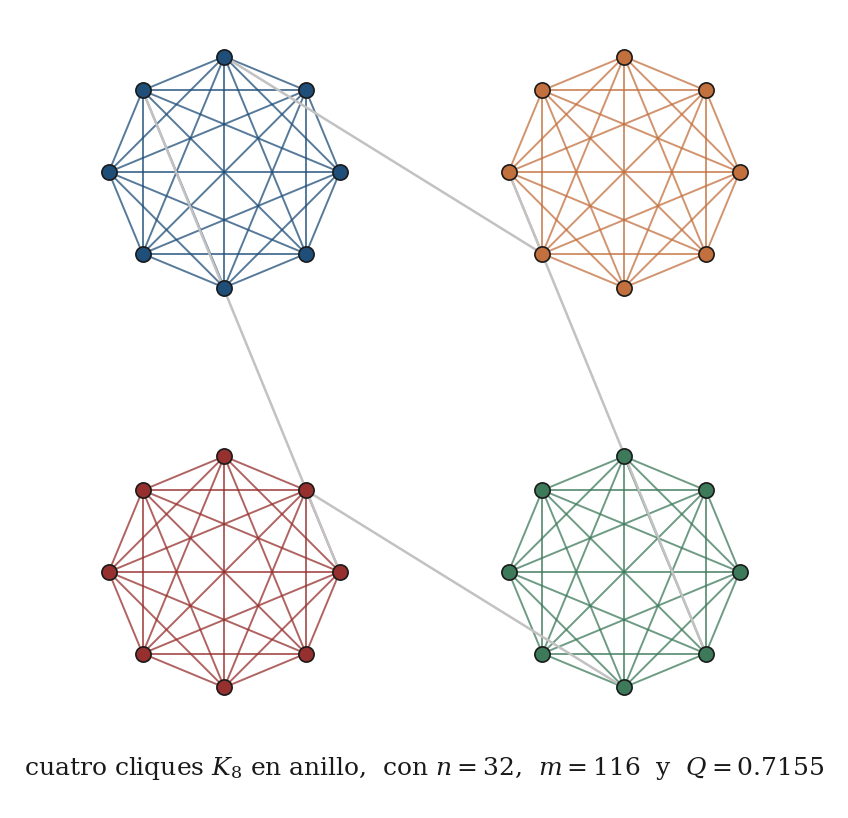
Visualmente, la partición en cuatro cliques parece natural.
Ahora formalizaremos esa intuición.
99.5. La referencia de grados
Sea la matriz de adyacencia.
Sea el grado del nodo .
En una referencia de tipo configuración, el número esperado de aristas entre y se aproxima por
La lógica es sencilla.
Un nodo con muchos stubs o extremos de aristas tiene más oportunidades de conectarse con cualquier otro nodo.
Por tanto, una arista entre dos hubs no debería sorprender tanto como una arista entre dos nodos de grado bajo si queremos evaluar concentración interna respecto del grado.
99.6. Matriz de modularidad
Definimos
La matriz compara conexión observada y conexión esperada.
Si la pareja está más conectada de lo esperado bajo la referencia marginal.
Si está menos conectada.
Además,
El paquete verifica esta identidad numéricamente.
No significa que cada fila tenga igual cantidad de valores positivos y negativos. Significa que el exceso total respecto de la referencia se equilibra.
99.7. Modularidad de una partición
Sea la comunidad asignada al nodo .
La modularidad estándar es
donde si ambos nodos pertenecen a la misma comunidad.
Solo se suman los excesos o déficits de conexión de pares colocados dentro del mismo grupo.
Una partición con muchas aristas internas puede tener modularidad baja si esas aristas eran esperables por los grados.
99.8. Forma por comunidades
La misma expresión puede escribirse de modo más interpretable.
Sea el número de aristas internas de la comunidad .
Sea
la suma de grados de sus nodos.
Entonces
El primer término es la fracción observada de aristas internas.
El segundo es la fracción esperada bajo la referencia de grados.
La modularidad suma esas diferencias en todas las comunidades.
99.9. Calcular en el ejemplo
Cada clique tiene aristas internas.
Además, cada comunidad participa en dos aristas externas del anillo.
Por tanto,
Como
la contribución de cada grupo es
Dado que
obtenemos una modularidad total
El script calcula el mismo valor mediante la fórmula matricial y mediante NetworkX.
99.10. Una sola comunidad produce
Supongamos ahora que colocamos todos los nodos en una única comunidad.
Entonces todas las aristas son internas:
Además,
Por tanto,
Este resultado es importante.
La modularidad no premia simplemente poner más aristas dentro de grupos. Si todo pertenece al mismo grupo, la estructura observada coincide trivialmente con su expectativa global.
99.11. Partición en nodos individuales
En el extremo opuesto, coloquemos cada nodo en su propia comunidad.
No existen aristas internas:
Cada nodo, en cambio, tiene grado positivo, por lo que el término esperado sigue siendo mayor que cero.
La modularidad resulta negativa.
En el ejemplo:
La modularidad puede ser negativa.
No está restringida al intervalo
99.12. Fusionar comunidades también puede reducir
Fusionemos los dos primeros cliques y los dos últimos.
Ahora tenemos dos comunidades de dieciséis nodos.
La modularidad cae a
Por tanto:
En este ejemplo limpio, la partición visualmente natural coincide con la mejor de estas alternativas sencillas.
99.13. Detectar comunidades como problema de optimización
Si no conocemos la partición, podemos buscar
El problema es combinatoriamente difícil.
El número de particiones de elementos crece mediante los números de Bell y se vuelve enorme incluso para redes moderadas.
La maximización exacta de modularidad es computacionalmente difícil en general.
Por ello se utilizan heurísticas.
No debemos confundir:
con
99.14. Algoritmo greedy en el ejemplo
El paquete utiliza una heurística greedy de modularidad.
En la red limpia recupera exactamente cuatro comunidades de tamaño ocho.
La modularidad obtenida es idéntica a la partición plantada.
El índice de Rand entre ambas particiones es
En una simulación donde conocemos cómo se construyó la red, podemos decir que el algoritmo recuperó la partición plantada.
En una red empírica no existe necesariamente una etiqueta externa equivalente a «verdad».
99.15. Modularidad positiva no basta
Podría parecer que demuestra comunidades.
Incluso una red aleatoria puede contener, por fluctuación, particiones con más aristas internas de las esperadas.
Además, si buscamos entre muchas particiones, elegiremos justamente una que explote esas fluctuaciones.
La optimización introduce selección.
Por eso no deberíamos comparar una modularidad maximizada solo con el valor teórico cero de una partición fija.
Debemos comparar procedimientos equivalentes.
99.16. Referencia preservadora de grados
C96 mostró cómo aleatorizar una red preservando su secuencia de grados mediante intercambios dobles de aristas.
El paquete genera 250 redes de referencia a partir del grafo de cuatro cliques.
En cada una calcula dos cantidades.
La primera es la modularidad de la partición original, mantenida fija. La segunda se obtiene volviendo a ejecutar el algoritmo greedy sobre la red aleatoria, de modo que registra una modularidad optimizada.
Estas dos distribuciones responden a preguntas distintas.
99.17. La partición fija se centra cerca de cero
En las redes aleatorizadas que preservan grados, la modularidad de los cuatro grupos originales tiene media aproximada y desviación estándar
Está cerca de cero, como cabe esperar cuando la relación entre aristas y etiquetas comunitarias originales ha sido destruida.
El pequeño desplazamiento finito no modifica la idea central.
La referencia de grados no favorece especialmente esa partición.
99.18. Optimizar una red aleatoria produce modularidad positiva
Ahora permitamos que el algoritmo busque la mejor partición disponible en cada red aleatorizada.
La modularidad media sube a aproximadamente
El máximo observado entre las 250 referencias es cercano a
La red empírica alcanza
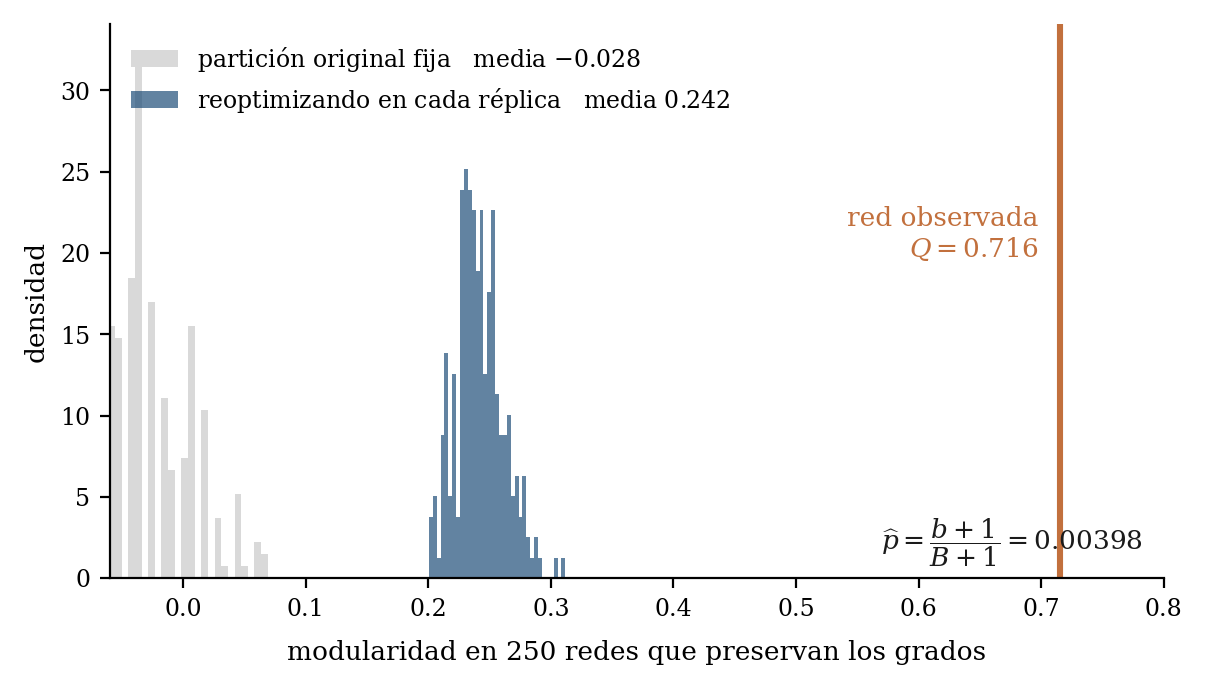
La diferencia demuestra por qué « positivo» es un criterio insuficiente.
La optimización encuentra estructura aparente incluso bajo el nulo.
99.19. Comparar optimizado con optimizado
La comparación metodológicamente coherente es:
frente a la distribución de
obtenida aplicando el mismo procedimiento a redes de referencia.
En el paquete, ninguna de las 250 redes nulas alcanza la modularidad observada.
Usando la corrección Monte Carlo
obtenemos
La resolución de esta probabilidad está limitada por el número de réplicas.
99.20. Alto tampoco identifica un mecanismo
Una modularidad alta respecto de un nulo preservador de grados permite afirmar que la concentración interna de aristas excede la explicable por esa referencia.
Eso no explica por sí solo por qué apareció. Podría deberse a homofilia, a geografía, a organización funcional, a la historia de crecimiento, a restricciones institucionales o a tipos de nodo no observados.
La modularidad describe organización mesoscópica, mientras el mecanismo generador requiere evidencia adicional.
99.21. Las comunidades rara vez son cliques
En el ejemplo utilizamos cliques para hacer transparente el cálculo.
Una comunidad real no necesita ser completamente conectada.
Puede contener:
sin contenerlas todas. Una comunidad tampoco necesita estar aislada.
De hecho, si no existieran aristas entre comunidades, la partición sería trivialmente visible mediante componentes conectadas.
El problema interesante aparece cuando los grupos están internamente densos pero siguen conectados entre sí.
99.22. Comunidad y componente conectada son conceptos distintos
Una componente conectada se define por alcanzabilidad.
Dos nodos están en la misma componente si existe algún camino entre ellos.
Una comunidad se define mediante una concentración relativa de conexiones.
En la red de cuatro cliques, todo el grafo es una única componente conectada.
Sin embargo, tiene una estructura comunitaria evidente.
Por tanto:
La primera es una propiedad binaria de accesibilidad global.
La segunda depende de densidades relativas y de una referencia.
99.23. Comunidad y clustering miden cosas distintas
Un grupo puede tener alto clustering porque contiene muchos triángulos.
La modularidad, en cambio, compara la densidad interna con una expectativa basada en grados.
Podemos construir comunidades con pocos triángulos, por ejemplo grupos bipartitos densos.
También podemos tener triángulos repartidos por toda la red sin una partición comunitaria clara.
C94 y C99 describen escalas relacionadas pero distintas.
99.24. La resolución de la modularidad
La modularidad estándar utiliza el tamaño total de la red a través de
Eso produce una consecuencia de fondo.
Un grupo pequeño puede ser internamente muy denso y, aun así, la modularidad global puede preferir fusionarlo con otro grupo.
Este fenómeno se denomina límite de resolución. Es una propiedad de la función objetivo, no un error de programación.
99.25. Anillo de cliques pequeños
Construyamos ahora cliques.
Cada uno contiene nodos.
Un clique de cinco nodos tiene
aristas internas.
Conectamos los cliques en un anillo mediante una arista entre vecinos.
El número total de aristas es
Visualmente, los treinta cliques son grupos elementales muy claros.
99.26. Modularidad si cada clique queda separado
Para esta partición, cada clique tiene diez aristas internas y dos extremos de aristas externas.
La modularidad puede simplificarse a
Con
obtenemos
Es un valor muy alto.
Sin embargo, no es el máximo entre particiones sencillas.
99.27. Fusionar cliques vecinos de a pares
Fusionemos cada par de cliques adyacentes.
Cada comunidad nueva contiene:
aristas internas, porque incorpora también la arista que conectaba ambos cliques.
La modularidad se simplifica a
Para nuestro caso:
Por tanto,
La modularidad prefiere quince grupos de diez nodos sobre treinta cliques de cinco.
99.28. Umbral analítico del límite de resolución
La diferencia es
Fusionar pares mejora la modularidad cuando
Para el umbral es
Con veinte cliques, mantenerlos separados es mejor.
Con veinticuatro, fusionarlos por pares ya aumenta .
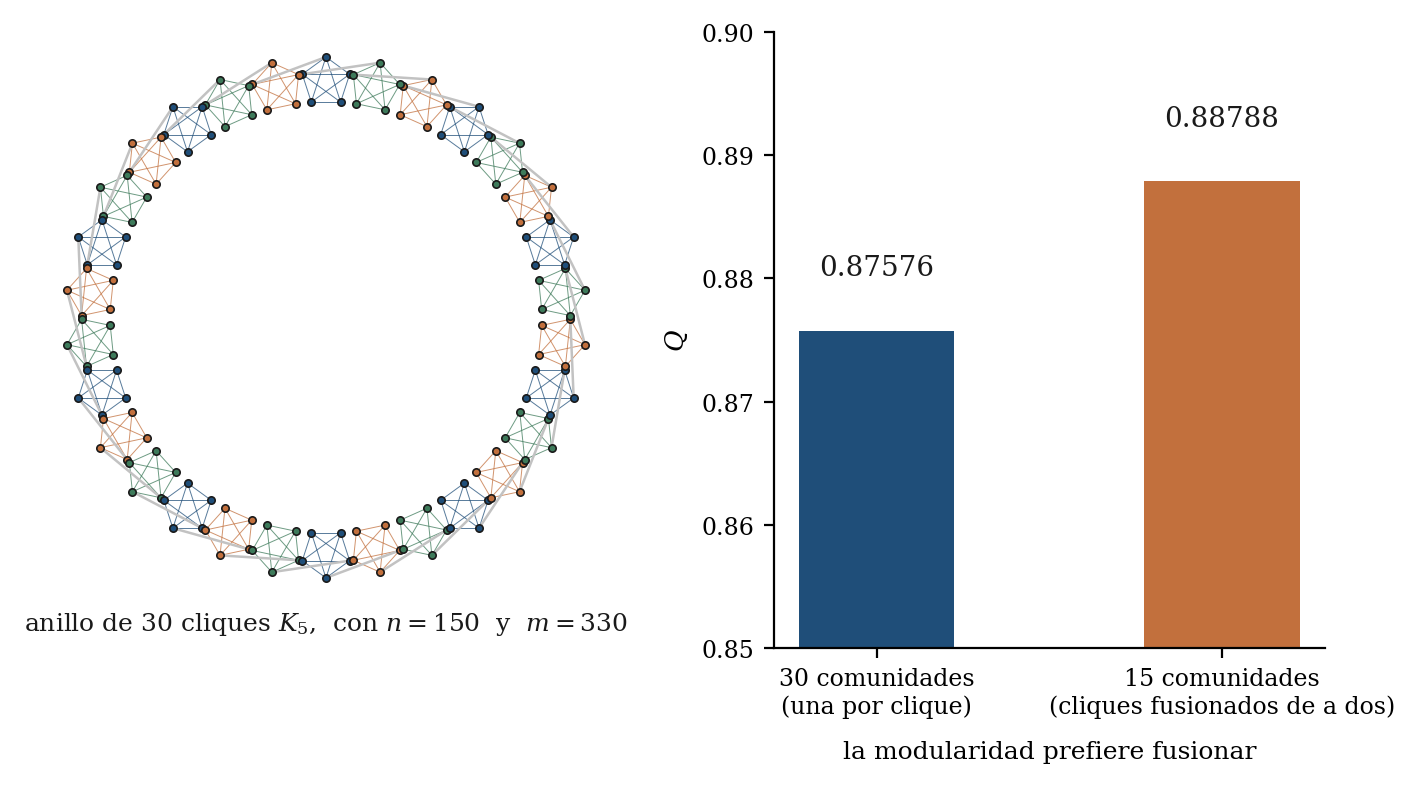
La escala óptima depende del tamaño global de la red.
99.29. El algoritmo reproduce la fusión
En el anillo de treinta cliques, la heurística greedy devuelve:
comunidades.
Cada una contiene diez nodos.
Su modularidad es exactamente la de la partición por pares.
El algoritmo no «falló» respecto de su objetivo.
Encontró una partición con modularidad mayor.
Lo que falla sería interpretar automáticamente:
como
99.30. El parámetro de resolución
Una generalización introduce
Cuando recuperamos la modularidad estándar.
Aumentar penaliza con mayor fuerza grupos grandes y suele favorecer particiones más finas.
Reducir suele favorecer grupos mayores.
Esto permite explorar escalas.
No elimina el problema de elegir qué escala corresponde a la pregunta.
99.31. No existe un universal
Podría parecer que basta buscar un valor de que recupere la partición deseada.
En una red empírica, en cambio, no conocemos necesariamente qué partición debería aparecer.
Elegir retrospectivamente para obtener grupos familiares puede introducir confirmación circular.
Una estrategia más informativa examina la estabilidad de estructuras a través de un rango de resoluciones y utiliza conocimiento externo solo de forma explícita.
El tratamiento avanzado de resolución y particiones alternativas quedará para C187.
Aquí basta reconocer que la escala comunitaria no está fijada universalmente por la topología.
99.32. Degeneración de soluciones
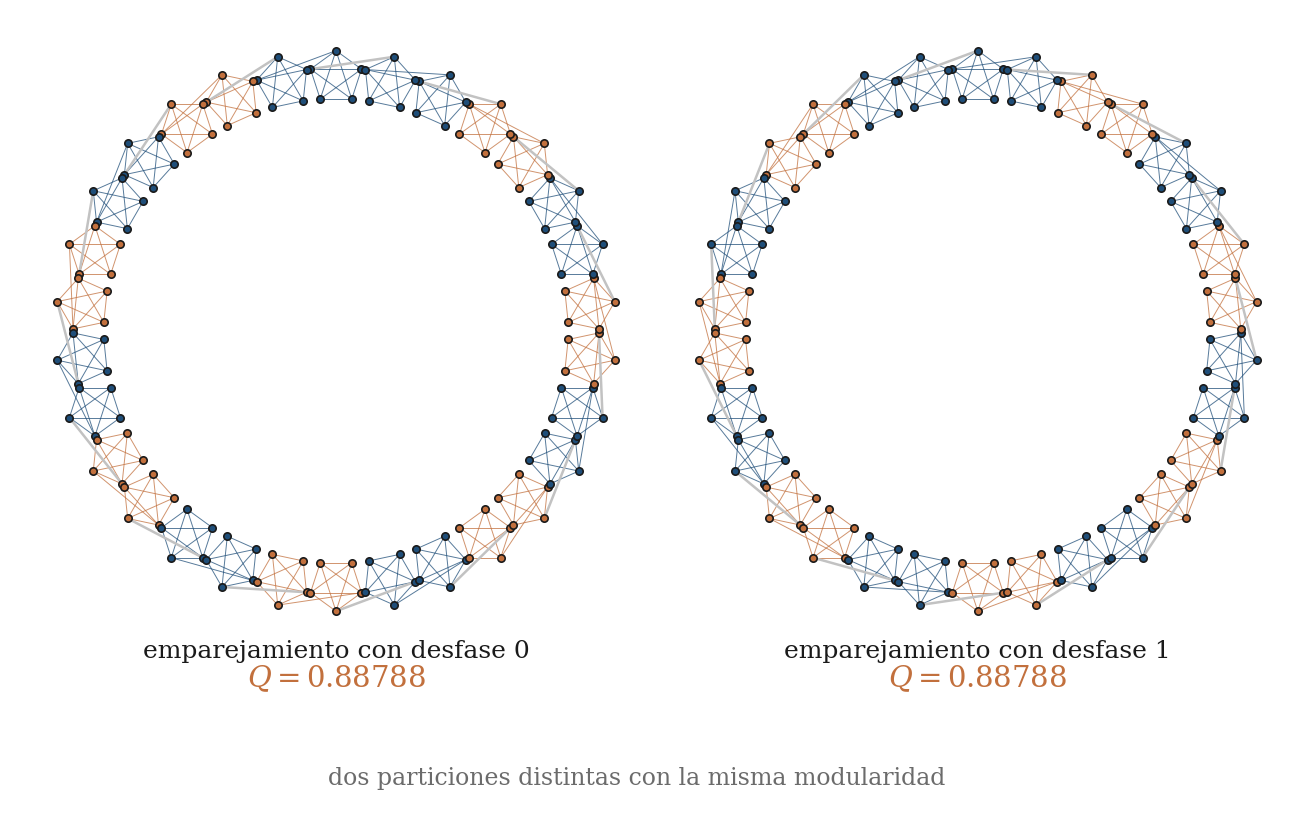
En el anillo de treinta cliques existen al menos dos maneras simétricas de fusionar grupos vecinos de a pares.
Podemos combinar:
o desplazar el inicio:
cerrando el anillo al final.
Ambas particiones tienen exactamente
La función objetivo tiene soluciones degeneradas.
Una implementación puede devolver una u otra según detalles del algoritmo o del orden de nodos.
99.33. Casi-degeneración
En redes más irregulares no necesitamos empates exactos.
Puede haber muchas particiones con valores de modularidad muy próximos al máximo.
Dos soluciones con y pueden asignar numerosos nodos de forma distinta.
Reportar solo «la partición óptima» oculta esa incertidumbre estructural.
La diferencia en función objetivo debería acompañarse, cuando sea relevante, de estabilidad entre soluciones.
99.34. Algoritmos distintos pueden producir particiones distintas
Existen numerosas estrategias para detectar comunidades.
El método de Girvan-Newman elimina aristas con alta intermediación y observa cómo se fragmenta la red.
La optimización greedy combina grupos buscando incrementos de modularidad.
Louvain alterna movimientos locales de nodos con agregación jerárquica.
Leiden modifica el proceso para mejorar propiedades de conectividad de las comunidades y la calidad de la optimización.
Los algoritmos incorporan decisiones de búsqueda y no son implementaciones equivalentes de una operación exacta.
99.35. Repetir algoritmos estocásticos
Algunos métodos dependen de semillas o del orden de actualización.
Conviene ejecutar varias veces el algoritmo y comparar la modularidad final, el número de comunidades, sus tamaños y la similitud entre particiones.
Si todas las ejecuciones convergen a una estructura similar, aumenta la evidencia de estabilidad algorítmica.
Si divergen, eso no demuestra ausencia de estructura. Puede indicar un paisaje de soluciones casi degeneradas.
La variabilidad del algoritmo es otra capa distinta de la incertidumbre de medición de la red.
99.36. Modularity maximization y referencia deben ser coherentes
C96 enseñó que un modelo nulo forma parte de la afirmación.
La modularidad estándar ya contiene una referencia interna basada en grados.
Para evaluar si el valor máximo de es extraordinario, en cambio, podemos necesitar un segundo nivel:
sobre las que repetimos la optimización completa.
El paquete muestra esa diferencia:
pero
Comparar el máximo observado con cero sería demasiado favorable.
99.37. Modularity y modelo de configuración
El término
proviene de una lógica de configuración.
Preserva el papel esperado de los grados y deja fuera la geografía, los tipos de nodo, la temporalidad, los pesos, la dirección y las restricciones institucionales.
Si esas características generan concentración de aristas, modularidad puede interpretarla como comunidad aunque el fenómeno tenga otra explicación.
Una referencia más adecuada podría necesitar conservar información adicional. No existe un nulo universal para comunidades.
99.38. Redes espaciales
Supongamos que los nodos cercanos geográficamente tienen mayor probabilidad de conectarse.
Entonces aparecerán grupos densos por proximidad.
La modularidad estándar puede detectarlos como comunidades.
Eso es descriptivamente correcto, porque existe concentración interna de aristas.
Si la pregunta es si hay organización comunitaria más allá de la geografía, en cambio, la referencia debe incorporar la distancia espacial.
La misma partición puede ser sorprendente respecto del modelo de configuración y ordinaria respecto de un modelo espacial.
99.39. Atributos de nodo
Una red social puede presentar grupos según profesión, idioma o edad.
Si esos atributos determinan oportunidades de conexión, una partición modular puede alinearse con ellos.
La coincidencia puede ser científicamente interesante, aunque no acredita que el atributo sea causal.
Tampoco toda etiqueta externa debería utilizarse como «ground truth» comunitario.
La comunidad estructural y la categoría observada son objetos diferentes que pueden coincidir parcialmente.
99.40. Comunidades solapadas
La partición estándar exige:
En muchos sistemas un nodo puede participar en varios grupos.
Una persona puede pertenecer simultáneamente a:
Una proteína puede participar en varios complejos funcionales.
Forzar una única asignación puede ser una simplificación fuerte.
Existen modelos y algoritmos de comunidades solapadas.
C99 no los desarrolla, pero la limitación debe quedar explícita.
99.41. Organización jerárquica
También puede existir estructura anidada.
Un conjunto de nodos puede dividirse en subgrupos, que a su vez forman una organización mayor.
La pregunta:
puede no tener una respuesta de una sola escala.
La modularidad con distintos valores de , métodos jerárquicos y modelos probabilísticos pueden explorar esa posibilidad.
La existencia de jerarquía vuelve todavía menos defendible interpretar una única partición como descripción completa.
99.42. Modelos de bloques estocásticos
Una alternativa conceptual importante es el modelo de bloques estocásticos.
En lugar de definir comunidad mediante una función de puntuación, propone un modelo generativo.
Cada nodo pertenece a un bloque.
La probabilidad de una arista depende del par de bloques:
Una comunidad assortativa corresponde a:
para conexiones internas frente a externas.
El modelo también puede describir estructuras no comunitarias, como redes bipartitas o núcleo-periferia.
La diferencia entre modularidad y bloques recuerda la separación entre descriptor y modelo generador.
99.43. Otras organizaciones mesoscópicas además de la densidad interna
Imaginemos dos conjuntos de nodos con muchas aristas entre grupos y pocas dentro.
Eso es una estructura aproximadamente bipartita.
Un algoritmo diseñado para comunidades assortativas podría describirla mal.
También existen arquitecturas de núcleo-periferia, de capas, de bloques dirigidos y de roles estructurales.
«Organización intermedia» es una categoría más amplia que «comunidades densas». C99 estudia la modularidad como puerta de entrada a esa categoría, sin pretender agotarla.
99.44. La comunidad estructural frente a la función
Una partición puede corresponder a regiones con alta densidad interna.
Eso no demuestra que cada comunidad sea una unidad funcional autónoma.
Un proceso dinámico puede atravesar con facilidad las fronteras topológicas.
Una arista intercomunitaria de gran peso puede ser más funcionalmente importante que muchas aristas internas débiles.
La función depende del proceso que opera sobre la red.
Como en C95:
99.45. Comunidades y dinámica
Aun así, la organización mesoscópica puede condicionar dinámicas.
Grupos densos pueden favorecer la sincronización local, la retención temporal de la difusión, la propagación rápida dentro de los módulos o las transiciones secuenciales entre regiones.
Estas consecuencias, sin embargo, no se deducen solo de . Hay que especificar ecuaciones, tasas o reglas de propagación. La topología impone restricciones y abre oportunidades, mientras la dinámica determina qué efectos se realizan.
99.46. Redes ponderadas y dirigidas
La modularidad puede generalizarse a redes ponderadas reemplazando grados por fuerzas y aristas por pesos.
En redes dirigidas deben distinguirse fuerza o grado de entrada y salida.
La referencia esperada cambia.
No debemos aplicar mecánicamente la fórmula no dirigida binaria a cualquier matriz.
Además, pesos negativos requieren definiciones adicionales porque «más peso interno» deja de tener una semántica única.
La representación de C91 sigue determinando la fórmula correcta.
99.47. Redes temporales
Una partición calculada sobre una red agregada puede mezclar comunidades que existen en momentos distintos.
Una comunidad puede formarse, dividirse o desaparecer.
Agregar todo un año puede producir grupos densos que nunca coexistieron simultáneamente.
El análisis temporal requiere equilibrio entre:
y
Eso queda fuera del alcance de este capítulo, pero impide interpretar toda comunidad como una entidad estática.
99.48. Comparar particiones
Cuando disponemos de dos particiones podemos comparar sus asignaciones mediante el índice de Rand, el índice de Rand ajustado, la información mutua normalizada o la variación de información. Cada una tiene convenciones y propiedades distintas.
En el ejemplo limpio, el índice de Rand entre partición plantada y greedy es uno porque coinciden exactamente.
En datos reales, una similitud parcial puede ser más informativa que obligar a decidir si dos algoritmos «coinciden» o «no coinciden».
99.49. Tamaño de las comunidades
Una partición debe reportar no solo:
También conviene informar:
el número de comunidades, junto con sus tamaños:
Dos particiones pueden tener modularidades cercanas y distribuciones de tamaños muy distintas.
Una solución con un gran grupo y muchos singletons no tiene la misma interpretación que otra con bloques equilibrados.
El valor escalar comprime mucha estructura.
99.50. Un flujo práctico de análisis
Un análisis comunitario razonable puede seguir esta secuencia.
Primero, definir con precisión la red.
Después, especificar qué concepto de comunidad se busca, sea densidad interna, bloques generativos, solapamiento o jerarquía.
Si se utiliza modularidad, declarar:
tipo de red y fórmula.
Ejecutar más de una inicialización o algoritmo cuando corresponda.
Examinar estabilidad de número y composición de comunidades.
Comparar el valor optimizado con redes de referencia usando el mismo procedimiento.
Finalmente, interpretar los grupos respecto de variables externas o mecanismos solo después de establecer su existencia estructural.
99.51. Verificación computacional
El paquete construye la red de cuatro cliques y verifica:
La modularidad de cuatro comunidades es
La partición en dos grupos produce
Una sola comunidad produce, salvo error de coma flotante,
La partición en singletons tiene modularidad negativa.
La heurística greedy recupera exactamente cuatro grupos de ocho nodos y coincide con la partición plantada.
En 250 redes aleatorizadas preservando grados, la modularidad de la partición fija se centra cerca de cero, mientras la modularidad optimizada alcanza una media cercana a 0.240.
Ninguna referencia optimizada alcanza el valor observado.
En el anillo de treinta cliques de cinco nodos:
pero
La heurística devuelve quince grupos de diez nodos.
Se ejecutaron 31 comprobaciones automáticas y las 31 resultaron satisfactorias.
99.52. Qué queda establecido
Las comunidades describen organización a una escala intermedia entre nodos individuales y red completa.
La modularidad evalúa una partición comparando las aristas internas observadas con una referencia basada en grados:
Un valor alto solo adquiere sentido respecto de una partición y una referencia.
Maximizar modularidad puede producir valores positivos incluso en redes aleatorias, por lo que una red observada debería compararse con referencias sometidas al mismo procedimiento de optimización.
La partición de máxima modularidad tampoco es necesariamente única ni coincide con la escala elemental visualmente más evidente. El límite de resolución puede favorecer fusiones de comunidades pequeñas. Distintas soluciones pueden tener valores de iguales o casi iguales.
Por ello, detectar comunidades no consiste en revelar automáticamente bloques «verdaderos». Consiste en formular, optimizar y contrastar una definición concreta de organización mesoscópica.
C100 cerrará el primer año con una síntesis sobre estados, trayectorias y redes de un mismo fenómeno. Allí integraremos los lenguajes construidos desde sistemas dinámicos y caos hasta fractales, probabilidad y redes, mostrando qué pregunta responde cada representación y qué errores aparecen al confundirlas.
Referencias
- Blondel, V. D., Guillaume, J.-L., Lambiotte, R., & Lefebvre, E. (2008). Fast unfolding of communities in large networks. Journal of Statistical Mechanics: Theory and Experiment, P10008. https://doi.org/10.1088/1742-5468/2008/10/P10008
- Fortunato, S., & Barthélemy, M. (2007). Resolution limit in community detection. Proceedings of the National Academy of Sciences, 104(1), 36–41. https://doi.org/10.1073/pnas.0605965104
- Fortunato, S., & Hric, D. (2016). Community detection in networks: A user guide. Physics Reports, 659, 1–44. https://doi.org/10.1016/j.physrep.2016.09.002
- Newman, M. E. J. (2006). Modularity and community structure in networks. Proceedings of the National Academy of Sciences, 103(23), 8577–8582. https://doi.org/10.1073/pnas.0601602103
- Newman, M. E. J., & Girvan, M. (2004). Finding and evaluating community structure in networks. Physical Review E, 69, 026113. https://doi.org/10.1103/PhysRevE.69.026113
- Traag, V. A., Waltman, L., & van Eck, N. J. (2019). From Louvain to Leiden: Guaranteeing well-connected communities. Scientific Reports, 9, 5233. https://doi.org/10.1038/s41598-019-41695-z
Recursos reproducibles
Descargar recursos del capítulo (ZIP, 345 kB).
6 archivos CSV · 4 figuras · 1 programa Python.
El programa se ha ejecutado en una carpeta vacía y genera los archivos de datos y figuras incluidos en el paquete.