COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 19. Arquitecturas de redes y modelos generativos
187.1. La comunidad depende de la pregunta
Al observar una red, es tentador colorear grupos de nodos y tratar los colores como partes naturales del sistema. La imagen suele ser convincente, con conjuntos compactos y unos pocos enlaces entre ellos. Sin embargo, la posición de los nodos en un dibujo depende del algoritmo de representación y la apariencia visual puede anticipar una respuesta que los datos todavía no justifican. Detectar comunidades requiere especificar qué propiedad distingue a un grupo.
Una definición frecuente busca conjuntos con más enlaces internos de los esperados bajo una referencia. Otra se interesa por regiones donde un proceso de circulación permanece durante mucho tiempo antes de salir. También puede interesar que los miembros tengan patrones de conexión semejantes, aunque apenas estén conectados entre sí; esta última idea se aproxima a la equivalencia de posiciones y a los modelos de bloques del capítulo anterior. Las tres preguntas pueden producir particiones distintas de la misma red.
Consideremos una red de derivaciones entre servicios. Dos centros pueden recibir pacientes de los mismos hospitales y enviarlos a instituciones semejantes. Comparten una posición funcional, aunque no intercambien pacientes directamente. Un algoritmo orientado a densidad interna podría separarlos y un modelo de roles podría agruparlos; una descripción basada en recorridos podría reunir cada centro con los establecimientos entre los que circulan más pacientes. La elección adecuada depende de qué se desea explicar o predecir.
Una partición asigna cada nodo a exactamente un grupo. Esa exigencia facilita muchos cálculos, pero puede ser restrictiva cuando una persona participa en varias comunidades o una proteína interviene en distintos procesos. Pertenecer de forma incierta a uno de varios grupos es diferente de pertenecer simultáneamente a varios. La incertidumbre describe nuestro conocimiento; el solapamiento es una propiedad postulada de la organización.
En este capítulo analizaremos la modularidad porque permite mostrar con claridad cómo una definición matemática introduce una escala y una referencia. Después examinaremos alternativas, discrepancias entre soluciones y criterios de evaluación. El objetivo es leer una partición como resultado de una pregunta, unos supuestos y un procedimiento, y decidir con evidencia cuánto confiar en ella.
187.2. Qué mide la modularidad
Sea un grafo no dirigido y simple, con enlaces, grados y matriz de adyacencia . Una partición asigna al nodo la etiqueta . La modularidad compara los enlaces internos observados con una expectativa que depende de los grados. En una formulación con parámetro de resolución , su expresión es
El indicador vale uno cuando los dos nodos están en el mismo grupo. La expresión suma tanto parejas ordenadas como términos diagonales; esa convención explica el factor . El término de referencia corresponde a conectar extremos de enlaces sin preferencia adicional por los grupos. Se inspira en los modelos de configuración, aunque la expresión no es la probabilidad exacta de enlace de todo ensamble simple con grados fijados.
Si cuenta los enlaces internos del grupo y suma los grados de sus nodos, la misma función se escribe de manera más transparente como
El primer término recompensa los enlaces internos. El segundo penaliza que un grupo acumule muchos extremos de enlaces, porque entonces una parte de esos enlaces internos ya sería esperable bajo la referencia. Por eso dos grupos con igual número de enlaces internos pueden contribuir de manera distinta, según el grado total de sus integrantes.
En la modularidad habitual, . Si todos los nodos se colocan en un solo grupo, los dos términos globales valen uno y el resultado es cero. Con otro valor de resolución, esa misma partición produce . No es válido comparar valores de modularidad obtenidos con distintas resoluciones como si compartieran automáticamente una escala de calidad.
Un valor positivo indica un exceso respecto de la referencia para esa partición, pero ese valor aislado no es una prueba estadística de estructura comunitaria. Al explorar muchas particiones, incluso redes aleatorias pueden alcanzar máximos positivos, porque la selección usa fluctuaciones del mismo registro sobre el que se evalúa el resultado. Para una comparación justa, el procedimiento de optimización debe aplicarse también a las redes de referencia.
Newman y Girvan (2004) presentaron la modularidad para evaluar divisiones comunitarias. Su popularidad se explica por la sencillez del cálculo y porque formaliza una intuición útil. La misma sencillez obliga a examinar qué aspectos de la red quedan fuera de la referencia (distancia, restricciones institucionales, tipos de nodos o mecanismos de observación), ya que pueden generar un exceso de enlaces internos sin que intervenga el mecanismo que interesa investigar.
187.3. Un ejemplo donde varias respuestas empatan
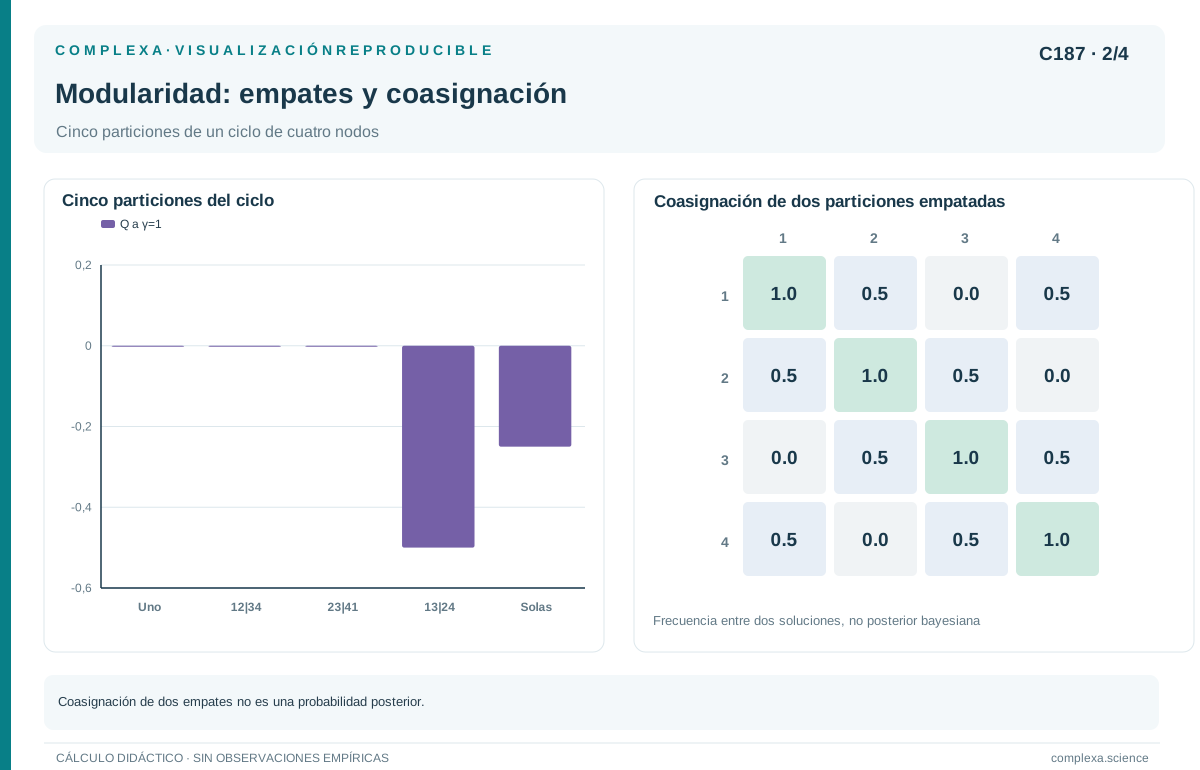
Tomemos un ciclo de cuatro nodos con enlaces , , y . Todos los grados valen dos y hay cuatro enlaces. Si agrupamos todos los nodos, la modularidad con resolución uno es cero. Si dividimos el ciclo en los pares adyacentes y , cada grupo contiene un enlace y suma cuatro grados. Su contribución es , por lo que la partición completa también obtiene cero.
La división alternativa y empata con las anteriores. En cambio, agrupar los pares opuestos y produce modularidad , porque no hay enlaces internos y se mantiene la penalización por los grados. Si cada nodo forma su propio grupo, el valor es . El cálculo descarta algunas particiones, pero deja otras empatadas.
Este ejemplo muestra una ambigüedad del propio objetivo, que persiste aunque la optimización sea exacta y la red esté observada por completo. Un programa que devuelve una sola de las particiones empatadas puede dar la impresión de que existe una respuesta privilegiada. La elección puede depender del orden de los nodos, de una regla de desempate o de una semilla aleatoria; ninguna de esas circunstancias indica una frontera real en el sistema.
Podemos resumir las dos divisiones en pares mediante una matriz de coasignación, que indica para cada pareja de nodos la fracción de soluciones en que ambos aparecen en el mismo grupo. Si damos igual peso a las dos particiones en pares, cada par adyacente tiene coasignación de un medio y los pares opuestos tienen cero. Si añadimos también la partición única, cambian todas esas frecuencias. El resumen depende del conjunto de soluciones y de cómo se pondera.
Por tanto, una frecuencia de coasignación obtenida de ejecuciones de un algoritmo no es automáticamente una probabilidad posterior de pertenencia. Para interpretarla de ese modo necesitamos un modelo probabilístico y un muestreo que represente su distribución posterior. Sin ellos, sigue siendo un resumen útil de estabilidad algorítmica, siempre que se nombre así.
El ciclo también distingue simetría de incertidumbre empírica. Sus nodos tienen posiciones intercambiables por rotaciones; ninguna información interna distingue una frontera preferente entre pares. Una etiqueta externa podría romper esa simetría, pero introducirla cambiaría el problema, porque combinaría la topología con otra fuente de información. Esa decisión puede estar justificada y debe quedar explícita.
187.4. El límite de resolución en un anillo de grupos
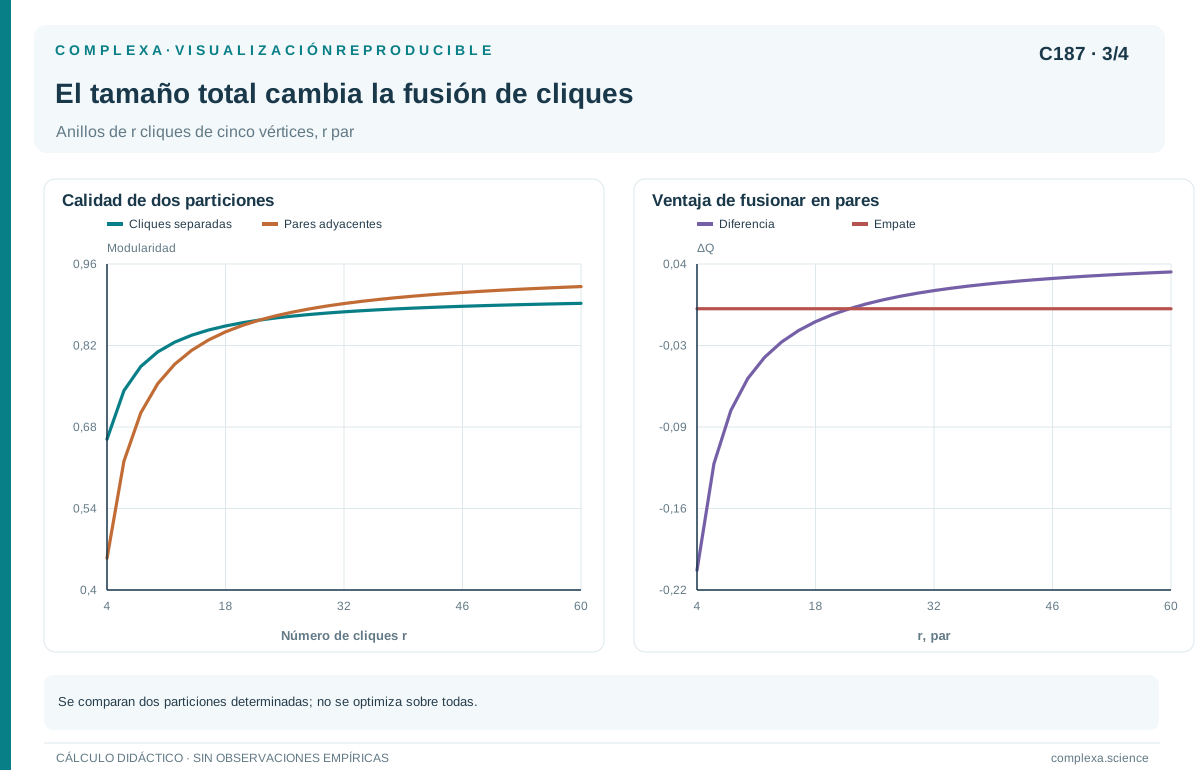
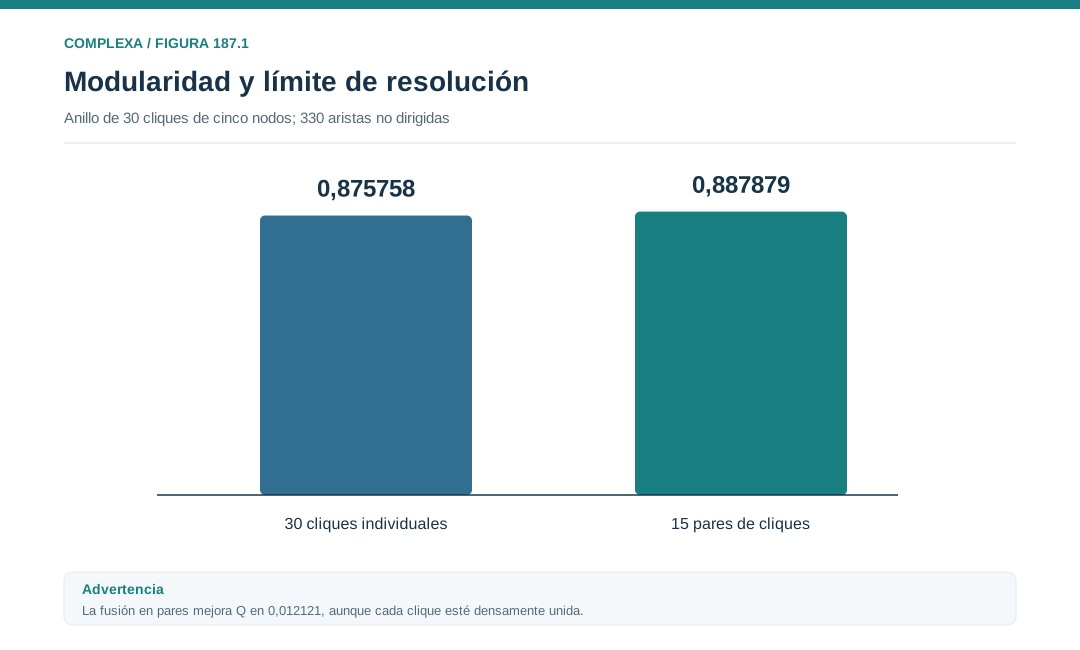
Construyamos ahora una red más grande y deliberadamente clara. Hay treinta cliques de cinco nodos; dentro de cada clique están presentes sus diez enlaces posibles. Conectamos las cliques en un anillo mediante un enlace entre cada pareja de cliques vecinas. Cada clique recibe dos enlaces externos y la red completa tiene ciento cincuenta nodos y trescientos treinta enlaces.
Una división natural asigna un grupo a cada clique. Cada grupo contiene diez enlaces internos y suma veintidós grados (veinte extremos proceden de sus diez enlaces internos y dos de los enlaces externos). La modularidad de esa partición es
Consideremos una alternativa que fusiona las cliques adyacentes de dos en dos. Hay quince grupos, cada uno con veintiún enlaces internos y suma de grados cuarenta y cuatro. El enlace que antes conectaba dos cliques pasa a contar como interno. Así obtenemos
La modularidad prefiere la segunda partición entre estas dos, pese a que cada clique es un conjunto completamente conectado y solo comparte un enlace con cada vecina. Esa preferencia procede del propio objetivo, que recompensa la fusión con independencia del algoritmo usado. No hemos demostrado que la partición en pares sea el máximo global; esta comparación basta, sin embargo, para demostrar que la división en cliques individuales no puede serlo.
El motivo se entiende al calcular el cambio provocado por fusionar dos grupos y . Si hay enlaces entre ellos, el incremento de modularidad es
La primera parte cuenta los enlaces que se convierten en internos y la segunda recoge el aumento de la expectativa de referencia. En nuestro anillo, y ambos grados agregados valen veintidós. Con resolución uno, cada fusión suma aproximadamente ; quince fusiones disjuntas producen la diferencia de aproximadamente entre las dos particiones calculadas.
Lo decisivo es que el número total de enlaces interviene en la comparación. Si mantenemos idénticas las cliques y su forma de conexión, pero cambiamos cuántas hay en el anillo, modificamos la preferencia local de fusión. Con cliques de cinco nodos, la fusión de dos vecinas mejora la modularidad estándar cuando . Lo que altera el resultado es el resto de la red.
Fortunato y Barthélemy (2007) analizaron este límite de resolución. En la práctica, implica que una partición puede ocultar grupos pequeños por una propiedad de la función objetivo. La ausencia de un grupo en el resultado no demuestra que sus enlaces carezcan de organización.
187.5. Elegir una resolución sin inventar una escala natural
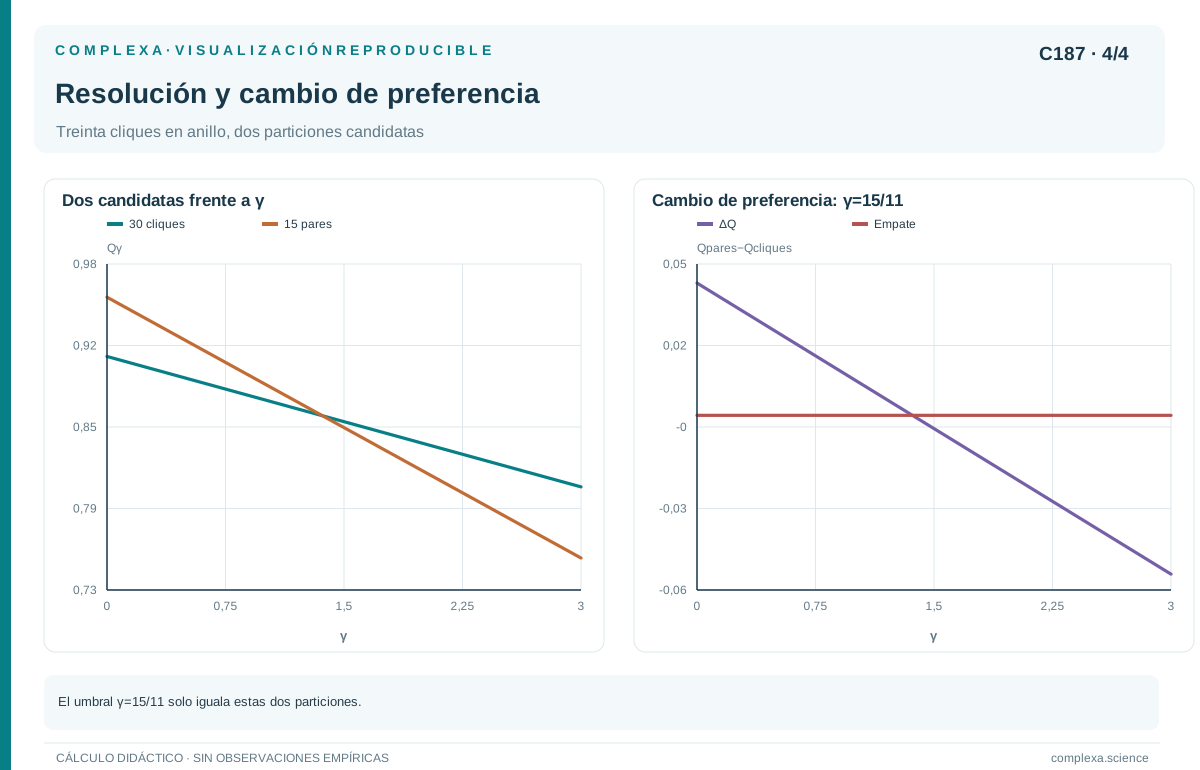
El parámetro modifica la penalización de referencia. En general, valores mayores favorecen divisiones más finas, aunque la trayectoria exacta de las particiones puede incluir reorganizaciones complejas. En el anillo anterior, la fusión de dos cliques vecinas deja de ser ventajosa frente a mantenerlas separadas cuando
La igualdad produce un empate para esa operación particular. El umbral no demuestra que, por encima de él, cualquier optimizador encuentre siempre las treinta cliques, ni que esa partición sea la única óptima, porque también deben compararse divisiones de otra forma, incluidas las que fragmentan cliques.
Explorar varias resoluciones permite identificar grupos persistentes y nodos que cambian de pertenencia con pequeñas variaciones. Conviene registrar tanto el número de grupos como su composición. Una meseta en el número de comunidades puede ocultar cambios importantes de miembros; a la inversa, una comunidad estable puede coexistir con divisiones cambiantes en otra parte de la red.
Tampoco cabe suponer que las particiones a distintas resoluciones forman un árbol. Una división más fina puede reunir en un mismo grupo nodos procedentes de varios grupos previos. Dibujar una jerarquía exige comprobar el anidamiento o usar un modelo que lo imponga. Forzar todas las soluciones dentro de un árbol puede ocultar precisamente las alternativas relevantes.
La escala de interés puede proceder del fenómeno. Si queremos comprender movimientos diarios, quizá sean apropiados grupos definidos por flujos de corto alcance. Si estudiamos coordinación institucional anual, puede interesar una agregación distinta. El horizonte temporal, los costos de comunicación y la unidad de intervención son criterios sustantivos para elegir una escala. Esos criterios deben formularse antes de seleccionar el resultado que mejor encaje con una historia.
Un análisis exploratorio puede presentar varias escalas sin elegir una única ganadora. Un análisis confirmatorio necesita un criterio más específico, como predicción fuera de muestra, recuperación de una propiedad funcional independiente o comparación con modelos alternativos. En ambos casos, la sensibilidad a la resolución indica cuánto depende el resultado de una decisión analítica.
En redes con grupos de tamaños y densidades muy diferentes, un único valor global puede funcionar bien para algunos grupos y mal para otros. Cambiar la función objetivo, introducir una estructura jerárquica o usar modelos generativos puede ayudar, pero cada alternativa trae nuevos supuestos. El límite de resolución lleva a examinarlos; declarar superior cualquier método que produzca más grupos no lo elimina.
El tamaño total puede afectar incluso comparaciones dentro de una componente, porque agregar a la base de datos otras componentes desconectadas aumenta el número total de enlaces de la referencia global, aunque no se modifique ninguna relación entre los nodos originales. Por ello, analizar una institución aislada y analizarla dentro de un registro nacional puede producir divisiones diferentes bajo modularidad. Esa diferencia puede proceder solo del alcance del conjunto usado para definir la expectativa. Documentar los límites de la red es tan necesario como documentar la resolución elegida.
187.6. Degeneración, algoritmos y estabilidad
Optimizar la modularidad suele requerir procedimientos aproximados en redes grandes. Algunos construyen comunidades por fusiones sucesivas; otros desplazan nodos entre grupos, exploran propuestas aleatorias o combinan varias escalas. Que dos implementaciones produzcan valores parecidos no garantiza que las particiones sean semejantes, porque la función puede tener muchas soluciones de calidad casi idéntica separadas por cambios amplios de composición.
Good, de Montjoye y Clauset (2010) estudiaron esta degeneración de la modularidad. El problema es más grave cuando se interpreta cada frontera como una división sustantiva. Una mejora diminuta del objetivo puede acompañarse de una reorganización considerable de los grupos. Presentar solo la solución con mayor puntuación oculta las alternativas compatibles con el mismo criterio.
Conviene distinguir tres fuentes de variación. La primera es el algoritmo, con sus semillas, su inicialización y sus rutas de optimización. La segunda es la muestra o el registro (enlaces omitidos, ventanas temporales, errores de medición). La tercera es la incertidumbre del modelo, que abarca diferentes referencias, resoluciones o definiciones de comunidad. Repetir muchas veces un único algoritmo aborda sobre todo la primera.
Si todas las ejecuciones coinciden, el procedimiento fue estable bajo las condiciones ensayadas. Aun así, podría estar encontrando de forma consistente una solución sesgada por el mismo modelo o por la misma pérdida de datos. Si las ejecuciones difieren, necesitamos estudiar si las discrepancias afectan a unos pocos nodos fronterizos o a la organización completa. Una cifra global de acuerdo puede esconder esas diferencias.
Las etiquetas numéricas de los grupos carecen de significado propio (el grupo uno de una ejecución puede ser el siete de otra). Para comparar particiones debemos usar medidas invariantes ante esa renumeración, como acuerdos de pares o medidas basadas en información. Si comparamos periodos con nodos distintos, además debemos especificar el conjunto compartido o un criterio que maneje incorporaciones y salidas.
La estabilidad frente a perturbaciones debe apoyarse en un modelo de error plausible. Eliminar enlaces uniformemente puede ser informativo si la omisión es aproximadamente uniforme. Si los enlaces interinstitucionales tienen menor probabilidad de registrarse, esa perturbación no reproduce el problema principal. Una comunidad aparentemente robusta a pérdidas aleatorias podría desaparecer al corregir el sesgo entre instituciones.
Cuando el resultado orienta decisiones, los nodos de pertenencia inestable merecen una representación explícita. Pueden ser interfaces entre grupos, casos con información insuficiente o posiciones mal descritas por una partición rígida. El análisis debe examinar esas posibilidades antes de convertir la etiqueta más frecuente en una clasificación definitiva. La ambigüedad localizada puede ser más útil que una frontera artificialmente precisa.
Hay además una comprobación estructural sencilla. En la modularidad no dirigida con pesos positivos y resolución positiva, separar un grupo compuesto por dos partes sin enlaces entre ellas aumenta la modularidad, siempre que ambas partes tengan grado agregado positivo. Al dividirlo, no se pierde ningún enlace interno y se reduce la penalización de referencia. La mejora es proporcional al producto de los grados agregados de las dos partes. Un grupo desconectado de ese tipo no puede pertenecer a un máximo global de la función.
Si un procedimiento devuelve tal grupo, conviene revisar sus pasos de agregación, sus restricciones o la calidad de la optimización. Esta comprobación no implica que toda comunidad conectada sea adecuada, porque la conectividad es una condición muy débil. Tampoco se traslada sin cambios a cualquier función con signos, a grupos definidos por roles o a modelos con otras penalizaciones. Sirve para detectar una incoherencia entre el resultado y el objetivo declarado con una propiedad demostrable sin conocer el óptimo.
187.7. Otras nociones de comunidad
Los métodos basados en flujos parten de un proceso que recorre la red. Si un caminante entra en una región y tarda en abandonarla, esa región puede ser una unidad dinámica. Rosvall y Bergstrom (2008) propusieron describir recorridos mediante códigos que aprovechan la permanencia dentro de los grupos. Una partición útil permite comprimir la descripción de los movimientos según el modelo de circulación elegido.
La interpretación depende de ese proceso. Un paseo que elige enlaces en proporción a sus pesos sigue una regla concreta de movimiento. Si los pesos son capacidades máximas, semejanzas o correlaciones, esa regla puede no corresponder al flujo real. En redes dirigidas, la distribución de visitas también depende de la conectividad y del tratamiento de nodos sin salida. Esas decisiones forman parte del método, aunque queden escondidas en opciones predeterminadas.
Una comunidad densa puede no retener un flujo que sigue fuertes enlaces salientes; una región menos densa puede retenerlo si sus salidas son escasas o débiles. Por eso el desacuerdo entre un método de densidad y uno de flujo puede revelar una diferencia sustantiva entre estructura y circulación. Para decidir cuál responde mejor, hacen falta observaciones del proceso o una justificación de la dinámica usada.
Los modelos de bloques son otra vía. Al comparar probabilidades de conexión bajo distintas asignaciones, pueden identificar grupos con conexiones preferentes hacia fuera, estructuras bipartitas o relaciones de núcleo y periferia. Si se usa el término comunidad para todos esos grupos, conviene aclarar que se ha ampliado su significado respecto de la noción de conjunto internamente denso.
Las representaciones solapadas permiten varios grupos por nodo, a veces con intensidades de pertenencia. Otras agrupan enlaces y derivan la participación de cada nodo a partir de sus relaciones. Estas opciones pueden ser razonables cuando distintas relaciones pertenecen a contextos diferentes. También son más flexibles y requieren controles para evitar que cualquier patrón pueda explicarse añadiendo pertenencias.
Ninguna taxonomía de métodos reemplaza la evaluación empírica. Una partición interpretable puede ser estadísticamente débil; una partición con buen ajuste puede ser irrelevante para la pregunta funcional. El método adecuado es el que convierte una definición pertinente en predicciones examinables y permite reconocer qué observaciones la pondrían en dificultad.
Los nodos aislados muestran un límite elemental de la modularidad. Si un nodo tiene grado cero, todos sus términos en la función son nulos, de modo que asignarlo a cualquier comunidad o dejarlo solo produce el mismo valor. Su etiqueta final puede ser una mera convención del algoritmo. Un informe debe distinguir estos casos de los nodos que tienen enlaces y se sitúan entre comunidades competidoras. La ausencia de enlaces produce una incertidumbre de pertenencia que el objetivo, por construcción, no puede resolver.
187.8. Dirección, pesos y referencias estructurales
En una red dirigida, los grados de entrada y salida tienen papeles distintos. Con la convención de que representa un enlace desde hacia , una referencia habitual usa el producto del grado de salida del origen y el grado de entrada del destino. La modularidad dirigida queda entonces
Aquí es el número de arcos. Cada uno se cuenta una vez, de modo que desaparece el factor dos de la versión no dirigida. Simetrizar una red antes del análisis cambia la pregunta, porque una cadena de derivaciones puede convertirse en una región aparentemente conectada en ambos sentidos. Esa transformación necesita una razón sustantiva.
Para pesos no negativos, una extensión sustituye grados por fuerzas y número de enlaces por peso total, con los factores correspondientes a la orientación. La unidad de los pesos no suele modificar el resultado si todos se multiplican por la misma constante y la fórmula se normaliza coherentemente. En cambio, transformar los pesos de manera no lineal sí puede cambiar la partición, porque altera la importancia relativa de los enlaces débiles y fuertes.
Con pesos positivos y negativos, sumar todos los pesos y aplicar sin cambios la misma expresión puede producir cancelaciones o denominadores problemáticos. Se requieren referencias que distingan ambos tipos de relación y una definición explícita de qué organización se busca. Agrupar nodos con enlaces positivos internos y negativos externos es una tarea diferente de buscar semejanza en patrones de correlación.
La referencia también debe respetar restricciones estructurales conocidas. En una red espacial, muchos enlaces locales pueden aparecer simplemente porque conectar nodos lejanos es costoso. Si la pregunta es qué grupos exceden esa organización espacial, un modelo basado solo en grados puede atribuir a comunidades lo que se debe a la distancia. La alternativa debe incorporar una función espacial defendible y conservar la incertidumbre de su estimación.
En redes bipartitas, solo ciertas parejas pueden conectarse. Proyectarlas sobre un único tipo de nodo crea enlaces entre quienes comparten vecinos y puede generar cliques por construcción. Detectar comunidades en la proyección sin modelar ese origen mezcla estructura observada con estructura introducida por la transformación. Analizar directamente la red bipartita o usar referencias compatibles con ella permite una interpretación más precisa.
Elegir una referencia más detallada no garantiza mejores conclusiones. Una referencia demasiado flexible puede absorber el patrón de interés; una demasiado simple puede convertir restricciones triviales en descubrimientos. La pregunta debe indicar qué factores se consideran explicación de base y qué organización residual se intenta estudiar.
187.9. Validar sin confundir concordancia con verdad
Las etiquetas externas pueden servir, con cautela, para evaluar una partición. Si los grupos inferidos coinciden con departamentos institucionales, hay concordancia con una clasificación conocida. Esa concordancia puede apoyar una interpretación organizativa. También puede reflejar que el registro de enlaces tuvo distinta intensidad dentro de los departamentos, o que las etiquetas se usaron para ajustar el método.
Una evaluación independiente reserva información que no intervino en la elección de resolución, parámetros o algoritmo. Si probamos numerosas configuraciones y escogemos la que más coincide con las etiquetas externas, esas etiquetas pasan a formar parte del ajuste y el acuerdo final deja de ser una validación independiente. Conviene separar exploración y evaluación, o reconocer expresamente ese uso compartido.
La predicción de enlaces puede ser otro criterio, siempre que se distinga entre ausencias conocidas y parejas no observadas. En redes muy dispersas, acertar muchas ausencias es fácil y puede ocultar una capacidad escasa para identificar enlaces. Las métricas deben considerar esa desproporción y compararse con modelos simples que usen grados, distancia o actividad. El reparto entre entrenamiento y evaluación debe representar el tipo de predicción que interesa.
Si el objetivo es anticipar enlaces futuros, una división aleatoria de los enlaces del mismo periodo puede ser demasiado favorable. La evaluación temporal introduce cambios de actividad, aparición de nodos y modificaciones institucionales que una prueba estática no captura. Una comunidad útil para describir el pasado puede perder capacidad predictiva cuando cambian las condiciones de interacción.
Los experimentos sintéticos permiten controlar una estructura generadora conocida, pero esa estructura no equivale necesariamente a la única partición razonable de cada realización. Con grupos poco diferenciados, el ruido puede borrar la señal. Si un algoritmo no recupera las etiquetas originales, puede deberse a información insuficiente o a limitaciones computacionales. El capítulo anterior mostró por qué la detectabilidad depende del régimen del modelo.
Finalmente, la utilidad para una intervención requiere evidencia adicional. Dividir una red en grupos puede ayudar a organizar la comunicación o asignar recursos, pero no demuestra que intervenir por comunidades mejore un resultado. La intervención modifica relaciones, conductas y oportunidades. Su evaluación debe estudiar esas consecuencias y los posibles costos de tratar fronteras analíticas como barreras operativas.
187.10. Cómo presentar una partición revisable
Un informe sobre comunidades empieza por definir nodos, enlaces, periodo y mecanismo de observación. Después formula qué entiende por comunidad y por qué esa noción responde a la pregunta. La función objetivo, la referencia y el tratamiento de dirección o pesos deben quedar claros para que otra persona pueda reconstruir el análisis.
La presentación debe incluir alternativas relevantes. En el anillo de cliques, mostrar solo la partición preferida por la modularidad ocultaría el límite de resolución. Mostrar ambas particiones, sus valores y el cálculo de fusión permite comprender el motivo del desacuerdo. En una red empírica, una comparación semejante puede centrarse en grupos que cambian con la resolución o con supuestos razonables de observación.
Es útil separar la calidad de ajuste de la estabilidad y de la interpretación funcional. Un resultado puede ser estable y poco predictivo, o predecir enlaces sin coincidir con categorías conocidas. Estas dimensiones responden a preguntas diferentes y reunirlas en una única etiqueta de calidad puede ocultar dónde está la evidencia favorable y dónde persiste la incertidumbre.
La figura final debe conservar esa información. Los colores pueden representar la partición principal, mientras que una tabla identifica nodos con asignación cambiante, grupos persistentes y regiones sensibles a la referencia. Si hay solapamiento modelado, debe representarse como tal. Si solo hay incertidumbre entre asignaciones exclusivas, conviene describirla sin atribuir participaciones múltiples que el modelo no contempla.
Una comunidad es científicamente útil cuando resume relaciones de una forma que puede examinarse, compararse y corregirse. Su valor está en las regularidades que ayuda a explicar y en las predicciones que permite evaluar. Mantener visibles las particiones alternativas evita que una decisión del procedimiento se convierta, por repetición, en una propiedad incuestionable del sistema.
Referencias
- Fortunato, S., y Barthélemy, M. (2007). Resolution limit in community detection. Proceedings of the National Academy of Sciences, 104(1), 36–41. DOI.
- Good, B. H., de Montjoye, Y.-A., y Clauset, A. (2010). Performance of modularity maximization in practical contexts. Physical Review E, 81, 046106. DOI.
- Newman, M. E. J., y Girvan, M. (2004). Finding and evaluating community structure in networks. Physical Review E, 69, 026113. DOI.
- Rosvall, M., y Bergstrom, C. T. (2008). Maps of random walks on complex networks reveal community structure. Proceedings of the National Academy of Sciences, 105(4), 1118–1123. DOI.