COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 19. Arquitecturas de redes y modelos generativos
190.1. La red disponible es el resultado de una observación
Una matriz de adyacencia suele presentarse como una descripción del sistema, pero cada entrada procede de un procedimiento. Alguien definió la población, decidió qué cuenta como relación, eligió un periodo y usó un instrumento para registrar enlaces. Las ausencias pueden significar que una relación no existe, que no se buscó o que el instrumento no consiguió detectarla. Una auditoría comienza por separar esas situaciones.
El problema no se resuelve calculando más indicadores sobre la misma matriz. Grados, comunidades, núcleos y distribuciones de cola pueden estar medidos con precisión computacional y describir una red incompleta de manera sesgada. Hay que reconstruir el camino entre el sistema de interés y el registro disponible, porque ese camino determina qué propiedades pueden estimarse y cuáles requieren supuestos adicionales.
Kossinets (2006) examinó cómo distintas formas de datos faltantes afectan propiedades de redes sociales. Handcock y Gile (2010) desarrollaron un marco para relacionar modelos de red y diseños de muestreo. Ambos enfoques ayudan a preguntar qué información sobre la red completa permanece identificable bajo el mecanismo que produjo los datos.
Trabajaremos con una red pequeña cuyo estado completo conocemos. Esta elección permite comprobar exactamente cómo cambian los resultados al omitir enlaces. En una aplicación empírica normalmente no tendremos esa verdad de referencia, así que el ejercicio sirve para evaluar procedimientos y reconocer hasta dónde puede reconstruirse una red incompleta.
La auditoría distinguirá resultados descriptivos del registro, estimaciones de la red completa y conclusiones sobre procesos. Cada nivel necesita evidencia diferente. Podemos describir con certeza el número de enlaces presentes en el archivo; estimar los enlaces reales exige un modelo de observación; atribuir una función a un núcleo o una comunidad requiere además información sobre la dinámica del sistema.
El objetivo final será un informe que permita actuar conociendo sus límites, es decir, que indique qué hallazgos son estables, cuáles cambian ante omisiones plausibles y qué datos adicionales reducirían más la incertidumbre. La transparencia del procedimiento forma parte de la calidad del resultado.
190.2. Una red de referencia completamente especificada
Consideremos ocho nodos numerados del uno al ocho. Los nodos uno, dos, tres y cuatro forman una clique, pues están presentes los seis enlaces posibles entre ellos. Añadimos los cinco enlaces , , , y . La red completa tiene once enlaces y es conexa. Todos los enlaces son no dirigidos, binarios y observados durante una misma ventana.
La lista completa, que permite reconstruir el ejemplo sin depender de un dibujo, es
Los grados, en orden de nodos, son cinco, cuatro, tres, tres, tres, uno, dos y uno. Su suma es veintidós, el doble del número de enlaces. Esta comprobación detectaría errores sencillos de transcripción o una confusión entre enlaces dirigidos y no dirigidos.
Hay cinco triángulos. Cuatro pertenecen a la clique (, , y ) y el quinto es . Los enlaces , y son puentes, porque eliminar cualquiera de ellos aumenta el número de componentes. Los otros ocho enlaces pertenecen a ciclos y su eliminación individual mantiene conectada la red.
El núcleo de orden tres está formado por los nodos uno a cuatro, cada uno de los cuales conserva tres vecinos dentro de ese conjunto. El nodo cinco pertenece al núcleo de orden dos, porque está conectado con uno y dos, pero su tercer vecino, el seis, no puede sostener una exigencia de tres conexiones internas. Los nodos seis, siete y ocho quedan fuera del núcleo de orden dos.
La transitividad global compara triángulos con ternas conectadas centradas en un nodo. Hay veintiséis ternas de ese tipo, que se obtienen sumando las combinaciones de dos vecinos de cada nodo, de modo que
La definición cuenta tres ternas por triángulo. No equivale al promedio de los coeficientes locales, que pondera de otra forma los nodos y necesita una convención para grados menores que dos. Una auditoría debe registrar cuál de estas cantidades se usa antes de comparar versiones del registro.
La red es deliberadamente pequeña. No pretendemos estimar una distribución asintótica ni detectar comunidades mediante significación estadística. Su ventaja es que cada enlace, triángulo y operación de eliminación puede revisarse de forma exacta, de manera que podremos atribuir los cambios a causas identificables.
190.3. Omitir un enlace cambia varias conclusiones
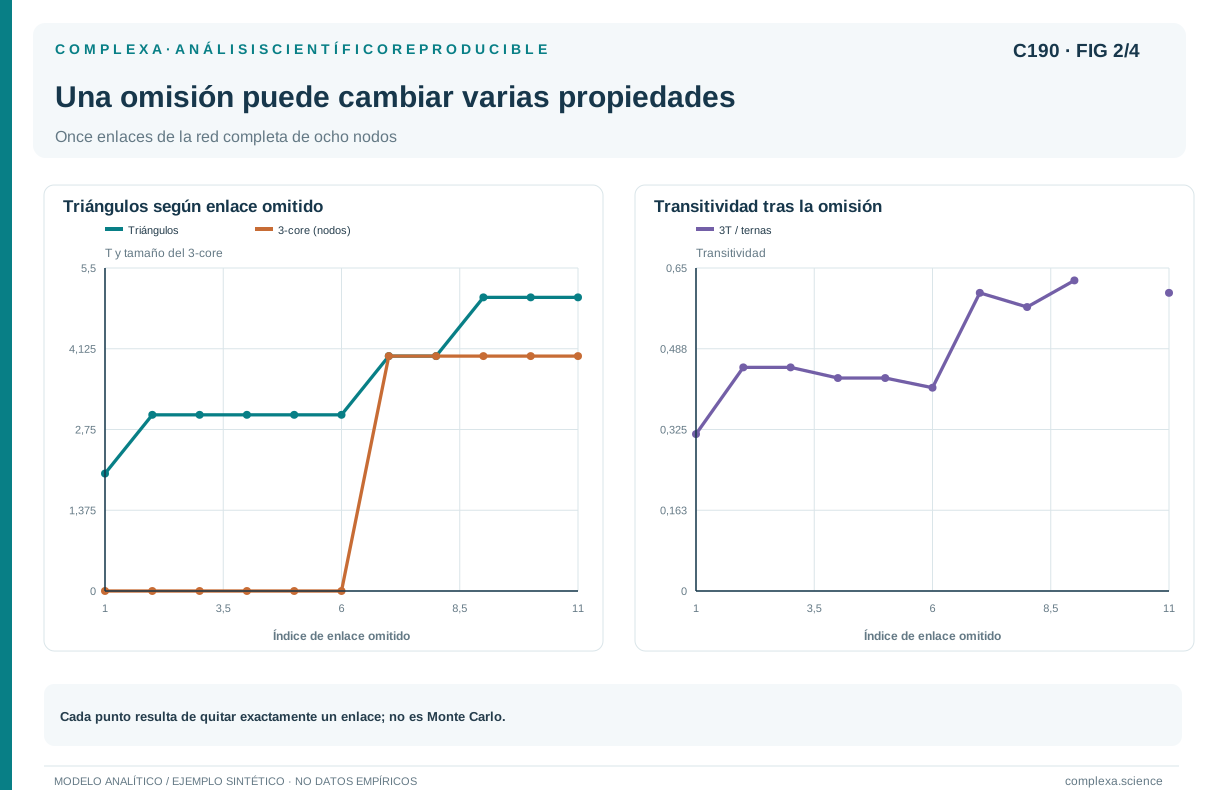
Supongamos que el instrumento no registra el enlace , aunque todos los nodos y los otros diez enlaces quedan observados. La red disponible sigue siendo conexa, porque hay caminos alternativos entre uno y dos. Si solo revisáramos conectividad y número de componentes, concluiríamos que esa propiedad no cambió.
Los grados de uno y dos disminuyen en una unidad; los demás permanecen iguales. La secuencia observada es cuatro, tres, tres, tres, tres, uno, dos y uno. El cambio agregado parece pequeño, pues falta uno de once enlaces y la suma de grados pasa de veintidós a veinte.
Sin embargo, desaparecen tres triángulos porque el enlace omitido participaba en , y . Solo permanecen y . Perder cerca de un nueve por ciento de los enlaces elimina, en esta realización, el sesenta por ciento de los triángulos. El efecto depende de dónde se ubica la omisión.
También cambia el denominador de la transitividad. La suma de ternas pasa de veintiséis a diecinueve y el coeficiente observado es
La reducción no puede corregirse multiplicando mecánicamente por el cociente entre enlaces completos y observados. Numerador y denominador dependen de conjuntos de enlaces de tamaños distintos y de su organización.
El núcleo de orden tres desaparece por completo. Al eliminar primero los nodos con menos de tres vecinos, salen seis y ocho, después siete y cinco. Los nodos uno y dos quedan con solo dos vecinos dentro del conjunto restante y también salen. Finalmente, tres y cuatro dejan de satisfacer el umbral y el algoritmo de poda termina sin nodos.
Esta desaparición no significa que el sistema haya perdido físicamente su organización de soporte; en el ejercicio solo cambió lo que observamos. La misma secuencia de cálculos podría interpretarse erróneamente como un colapso estructural si comparáramos registros con coberturas diferentes y olvidáramos el mecanismo de medición.
La conclusión descriptiva correcta es que la red registrada carece de núcleo de orden tres. La conclusión sobre la red completa queda abierta si no sabemos qué enlaces faltan. Si sabemos por una fuente independiente que estaba presente, podemos corregir el registro; si solo sospechamos omisiones, necesitamos expresar incertidumbre sobre las reconstrucciones compatibles.
190.4. Enumerar todas las pérdidas de un solo enlace
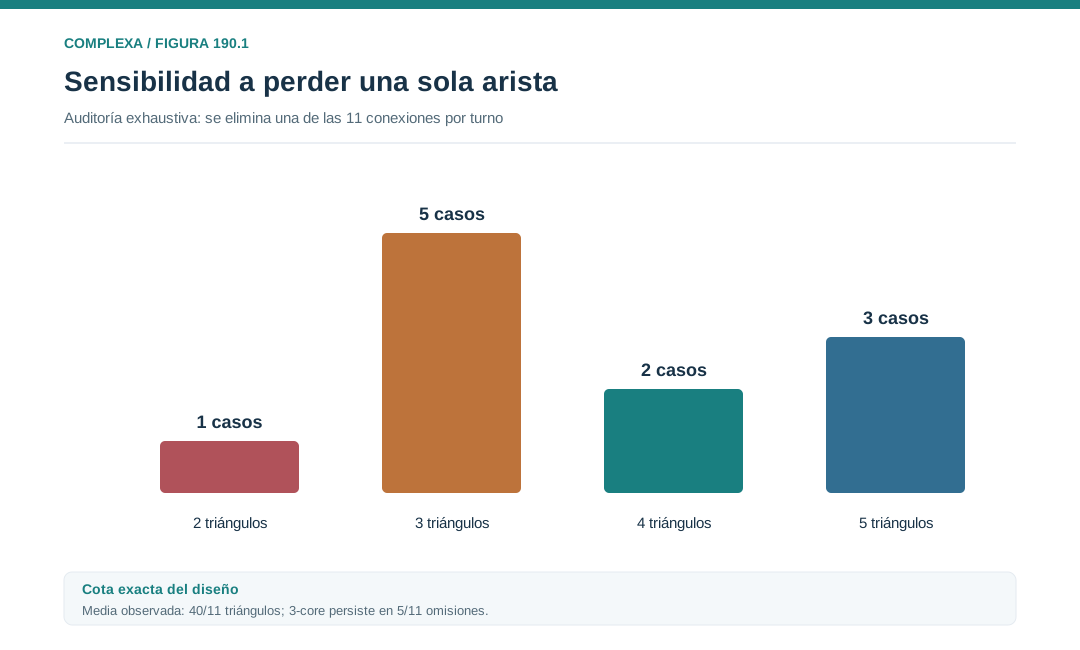
Podemos evaluar si la omisión anterior es típica bajo un diseño concreto que elimina exactamente un enlace, elegido uniformemente entre los once. Hay once resultados posibles y podemos calcularlos todos. Esta enumeración evita error de simulación y permite comparar propiedades con sensibilidad diferente.
Si se elimina , quedan dos triángulos. Si se elimina cualquiera de los otros cinco enlaces de la clique, quedan tres. Si se elimina o , quedan cuatro. Si se elimina uno de los tres puentes, los cinco triángulos permanecen. La esperanza exacta del número observado de triángulos es
Podemos obtener el mismo resultado considerando cada triángulo por separado. Sus tres enlaces deben sobrevivir; como se elimina solo uno de los once, la probabilidad de que no toque ese triángulo es ocho onceavos. Hay cinco triángulos, de modo que la suma de sus probabilidades de supervivencia vuelve a dar cuarenta onceavos. No hace falta que las supervivencias de distintos triángulos sean independientes para sumar sus esperanzas.
La red permanece conexa en ocho de los once resultados y se desconecta en tres. En cambio, el núcleo de orden tres sobrevive con sus cuatro nodos solo cuando la omisión afecta a uno de los cinco enlaces externos a la clique. Si se pierde cualquiera de sus seis enlaces internos, desaparece. El tamaño esperado del núcleo observado es veinte onceavos, aunque el tamaño verdadero sea cuatro.
Estas diferencias muestran que no existe una única medida de cobertura que garantice precisión para todas las propiedades. El porcentaje de enlaces retenidos es idéntico en las once versiones, pero la conectividad, los triángulos y el núcleo responden de maneras distintas. La auditoría debe evaluar las propiedades que interesan a la pregunta sustantiva.
También debemos distinguir este diseño de una retención independiente de enlaces con probabilidad diez onceavos. Ambos conservan el mismo número esperado de enlaces, pero el segundo permite perder cero, uno o varios. En la retención independiente, la probabilidad de conservar un triángulo sería el cubo de diez onceavos, diferente de ocho onceavos.
Confundir diseños con igual cobertura media produce correcciones incorrectas. La información necesaria incluye cómo se seleccionan las omisiones y si dependen unas de otras. Una caída del servidor durante un periodo, por ejemplo, puede eliminar muchos enlaces de un mismo proceso y generar dependencias que ninguna retención independiente representa.
190.5. Muestreo de enlaces y muestreo de nodos
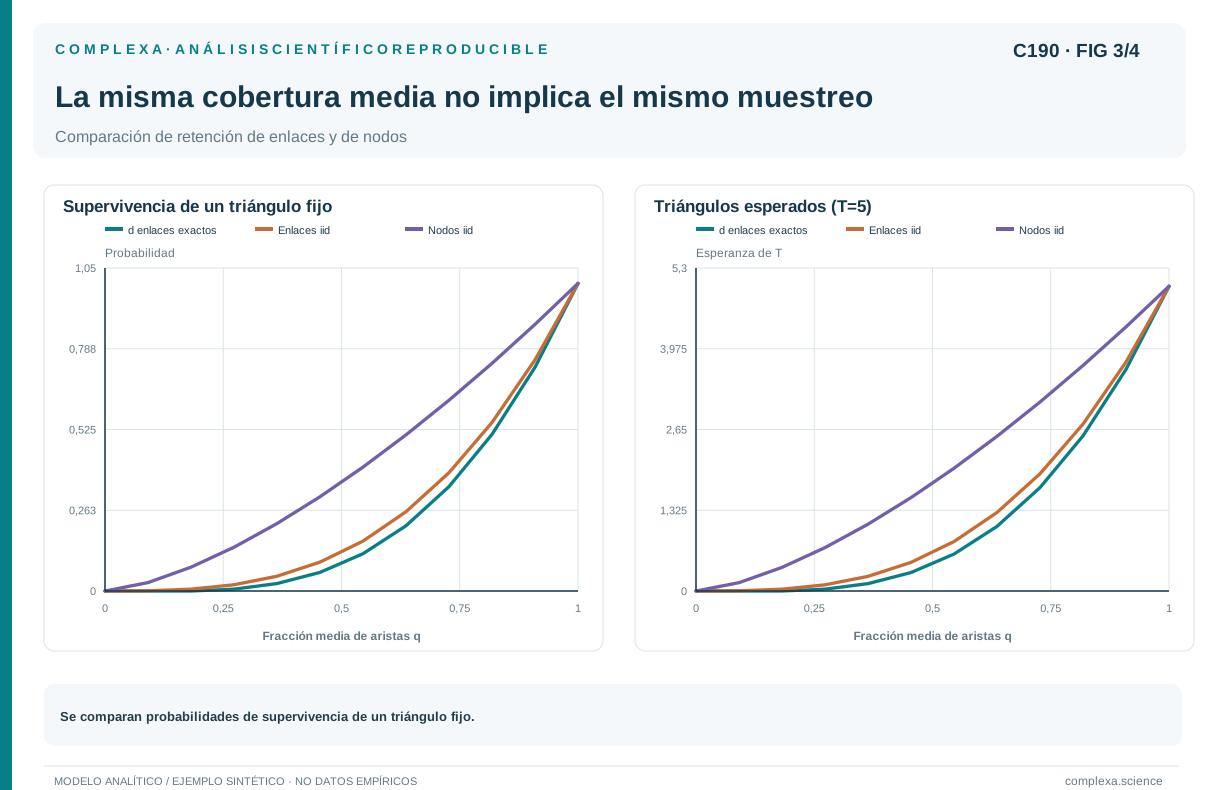
En un modelo sencillo de observación de enlaces, cada enlace real se registra independientemente con probabilidad , no aparecen falsos positivos y todos los nodos permanecen identificados. Condicionado al grado verdadero , el grado observado tiene distribución binomial
Por tanto, su esperanza es y su varianza es . Aunque cada grado observado tenga esta distribución marginal, los grados de nodos vecinos siguen siendo dependientes porque comparten la detección de su enlace.
Si es conocido, dividir el grado observado por da un estimador insesgado del grado verdadero en este diseño. El resultado puede ser no entero y no tiene por qué formar, junto con otros grados corregidos, una secuencia gráfica. Estimar cantidades marginales y reconstruir una red válida son tareas distintas.
En muestreo de nodos, se selecciona una parte de la población y se observa la subred inducida entre los seleccionados. Si cada nodo se retiene independientemente con probabilidad , un enlace aparece solo cuando se retienen ambos extremos, con probabilidad . Un triángulo requiere tres nodos retenidos y tiene probabilidad . No corresponde usar por contar seis extremos de enlaces, porque los tres enlaces comparten nodos.
Condicionado a que un nodo concreto haya sido seleccionado, su grado dentro de la subred inducida tiene esperanza bajo este diseño independiente. Si desconocemos los nodos no seleccionados, sin embargo, no podemos extender directamente una corrección individual a toda la población. Necesitamos un marco de muestreo que defina quiénes podían ser incluidos.
Stumpf, Wiuf y May (2005) mostraron que las propiedades de distribución de grados pueden alterarse al observar subredes. La selección de nodos y la selección de enlaces producen transformaciones diferentes, incluso con proporciones similares de datos retenidos.
Otros diseños comienzan desde semillas y siguen conexiones. En ellos, la probabilidad de inclusión puede depender del grado, de la distancia a las semillas y de la conectividad de la población. La muestra puede favorecer nodos visibles y excluir componentes enteras. Una corrección uniforme por cobertura no recoge esas oportunidades desiguales.
La auditoría debe identificar el diseño real o, cuando no se conoce, comparar escenarios plausibles. Elegir el modelo más cómodo sin examinar cómo se recogieron los datos puede producir intervalos precisos alrededor de una cantidad equivocada.
190.6. Qué puede corregirse mediante probabilidades de inclusión
Si conocemos la probabilidad de observar cada enlace real y esas probabilidades son positivas, podemos estimar el número total de enlaces mediante ponderación inversa
Cada término compensa la posibilidad de que un enlace semejante no haya aparecido. La esperanza de su contribución es uno, de modo que la suma estima el total sin sesgo bajo el diseño especificado. Para esa esperanza no hace falta independencia entre inclusiones, aunque la dependencia sí afecta a la varianza.
El procedimiento no descubre qué enlaces concretos faltan. Tampoco funciona para relaciones cuya probabilidad de inclusión es cero, porque nunca aparecen en los datos. Si una institución no registra enlaces externos bajo ninguna circunstancia, su base interna no identifica el volumen de esas conexiones.
Para triángulos necesitamos la probabilidad conjunta de que se observen sus tres enlaces o sus tres nodos, según el diseño. Bajo retención independiente de enlaces con probabilidad , la probabilidad es y es un estimador insesgado del total de triángulos. Bajo eliminación uniforme de exactamente un enlace en nuestro ejemplo, la probabilidad es ocho onceavos y el factor correcto es once octavos.
La corrección es válida en promedio sobre repeticiones del diseño. Si observamos la versión que perdió , tenemos dos triángulos y el estimador con el diseño de una omisión vale 2,75, mientras que el valor verdadero es cinco. Que el estimador sea insesgado no significa que cada resultado corregido coincida con la verdad, porque la variación entre posibles muestras sigue siendo considerable.
Los cocientes requieren especial cuidado. Si se corrigen por separado el número de triángulos y el de ternas, su cociente no es, en general, un estimador insesgado de la transitividad, pues la esperanza de una razón no suele ser la razón de las esperanzas. Puede ser útil como aproximación o como estimador consistente en determinados regímenes, pero necesita su propia evaluación.
Las propiedades no lineales, como la pertenencia a un núcleo o el número de componentes, no se corrigen en general mediante un único factor. Un enlace puede sostener una estructura completa o ser redundante. Para esas propiedades suelen hacer falta modelos de reconstrucción, cotas compatibles con la información o simulaciones del proceso de observación.
Las probabilidades de inclusión rara vez se conocen con exactitud. Si se estiman desde auditorías parciales o registros duplicados, su incertidumbre debe propagarse. Los pesos muy grandes, que corresponden a probabilidades pequeñas, pueden producir estimaciones de alta varianza dominadas por unos pocos enlaces. Informar solo el total corregido ocultaría esa fragilidad.
La inferencia basada en modelos asigna, en cambio, probabilidades a redes completas y suma sobre las completaciones compatibles con los datos. Handcock y Gile analizan las condiciones bajo las que el diseño de muestreo es ignorable, es decir, puede omitirse de esa verosimilitud para inferir parámetros de la red. Esa posibilidad depende de que la selección sea adaptativa a lo observado y de que los parámetros del diseño y del modelo sean distintos. Un diseño ignorable no implica que cualquier pérdida sea inocua ni que los enlaces faltantes queden identificados. Si la selección depende de relaciones no observadas de una forma no contemplada, debe modelarse conjuntamente. Las correcciones por falsos positivos requieren, además, un modelo de error de medición separado.
190.7. Falsos positivos, omisiones selectivas e identificación
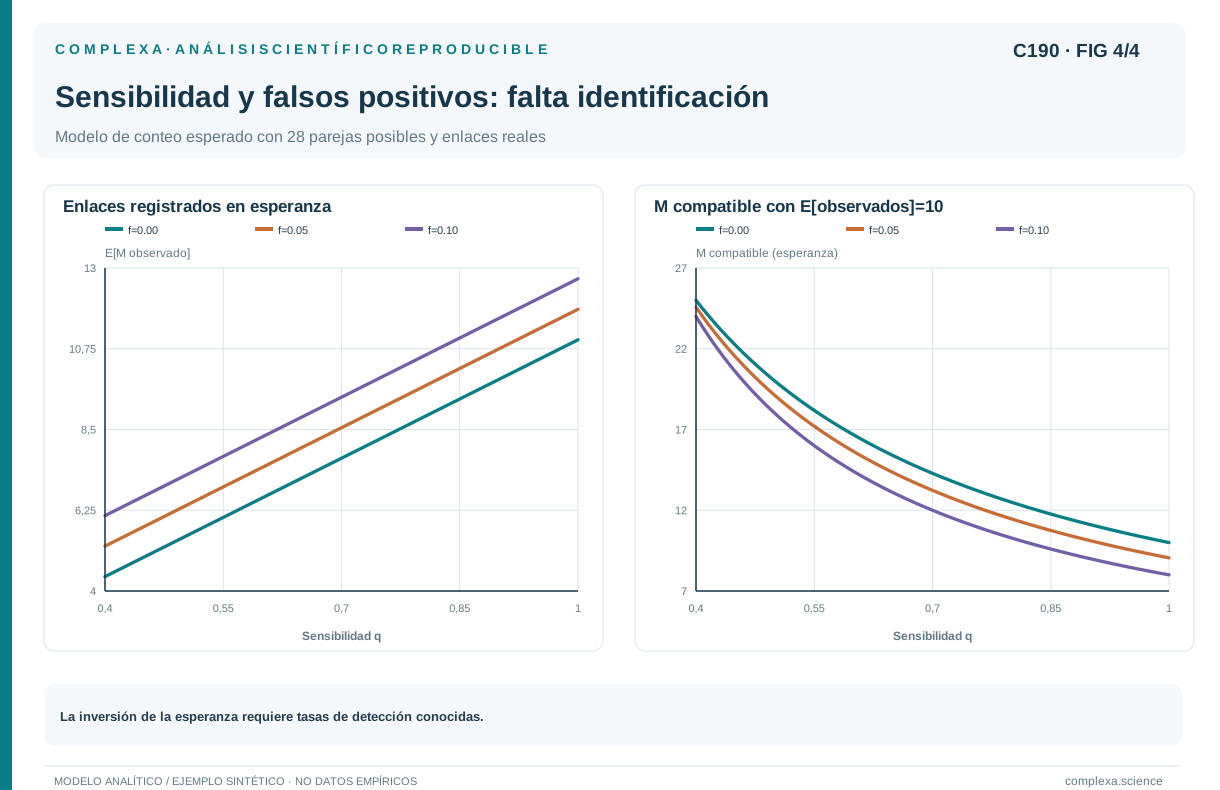
Hasta ahora solo desaparecían enlaces reales. Un instrumento también puede registrar enlaces inexistentes, por errores de vinculación, coincidencias de nombres o umbrales demasiado permisivos. En redes dispersas, incluso una tasa pequeña de falsos positivos puede añadir muchas conexiones porque el número de parejas sin enlace suele ser grande.
Supongamos que hay parejas elegibles, enlaces verdaderos, sensibilidad y probabilidad de falso positivo . Si las tasas son uniformes, el número esperado de enlaces registrados es
Si conocemos ambas tasas y , podemos despejar una estimación lineal de a partir del conteo observado. Si las tasas son desconocidas, el mismo conteo puede corresponder a muchas combinaciones de densidad y calidad de medición.
En una red simple de mil nodos hay casi medio millón de parejas posibles. Una tasa de falso positivo de una milésima puede generar del orden de cientos de enlaces espurios cuando la red es muy dispersa. La cifra debe compararse con el número de enlaces verdaderos y con su ubicación. Un enlace falso entre componentes puede alterar conectividad o distancias más que varios enlaces falsos dentro de una región densa.
Las tasas pueden depender del tipo de pareja. Si se registran mejor las relaciones dentro de una institución que entre instituciones, una red homogénea puede parecer modular. Si los enlaces débiles se omiten con mayor frecuencia, cambian fuerzas y grados de forma desigual. Si se observan mejor los nodos populares, la concentración aparente puede combinar organización y visibilidad.
Un modelo de observación debe distinguir parámetros del sistema y del instrumento. Si la probabilidad real de conexión es y la de detección es , sin falsos positivos la probabilidad observada es su producto. Sin información adicional, una conexión observada poco frecuente puede significar relaciones escasas, mala detección o ambas cosas.
Para separar esos componentes hacen falta datos de validación, como revisión manual de parejas, fuentes independientes, registros repetidos o conocimiento del procedimiento de captura. Los casos que se validan deben elegirse con cuidado, porque revisar solo enlaces ya detectados puede informar sobre falsos positivos, pero da poca información directa sobre los enlaces omitidos entre parejas registradas como ausentes.
La auditoría puede proponer un muestreo de validación que incluya presencias y ausencias, estratificado por tipos de nodos o instituciones cuando se sospechan diferencias. El objetivo es estimar los errores relevantes para la propiedad que se quiere conocer, con una precisión suficiente para evaluar sus consecuencias.
190.8. Comunidades, núcleos y colas bajo observación parcial
Ninguna de las descripciones de la red estudiadas en los capítulos anteriores está protegida de antemano frente al registro incompleto. Las comunidades dependen del contraste entre conexiones internas y externas; los núcleos, de grados sostenidos dentro de subconjuntos; las colas, de cómo se distribuyen pérdidas y falsas detecciones entre nodos.
En detección de comunidades, eliminar preferentemente enlaces entre grupos puede aumentar su separación aparente, mientras que eliminar enlaces internos puede difuminarla. Además, la pérdida modifica los grados que usa la referencia de modularidad. El cambio final resulta de ambos efectos, por lo que no siempre puede predecirse observando solo qué categoría de enlace disminuyó.
Una partición estable frente a semillas algorítmicas puede ser inestable frente a la cobertura. Para examinarlo hay que generar versiones compatibles con el mecanismo de observación y repetir el análisis. La matriz de coasignación resultante describe la sensibilidad bajo ese mecanismo. Si las reconstrucciones proceden de un modelo probabilístico posterior, la matriz puede tener una interpretación diferente de la obtenida mediante perturbaciones arbitrarias.
En los núcleos, la monotonicidad da una cota útil. Si solo faltan enlaces y conocemos todos los nodos, añadir relaciones puede aumentar o conservar la coreness de cada nodo, pero no reducirla. La coreness observada es entonces una cota inferior de la verdadera. Esta afirmación deja de ser válida si hay falsos positivos, errores de identidad o cambios en la definición de enlace.
La misma lógica indica que, entre nodos que permanecen conectados en la subred observada, las distancias mínimas observadas no pueden ser menores que las verdaderas si solo se han eliminado enlaces sin cambiar sus costos. Sin embargo, algunos pares pueden quedar desconectados y la media calculada únicamente sobre pares todavía alcanzables introduce una selección adicional.
Para distribuciones de grados, la pérdida independiente tiende a reducir cada grado, pero las consecuencias sobre la cola dependen del modelo original y del rango finito. La selección desigual puede alterar mucho más la forma. Un ajuste de potencia debe acompañarse de escenarios de observación, especialmente cuando las probabilidades de inclusión dependen del grado.
Estas cotas y sensibilidades son útiles aunque no reconstruyan una red única. Permiten distinguir afirmaciones que sobreviven a todas las completaciones admisibles de otras que dependen de decisiones adicionales. La incertidumbre estructural puede expresarse como un conjunto de resultados compatibles, además de un intervalo alrededor de una estimación puntual.
Podemos ilustrar esas cotas regresando al registro que carece del enlace entre uno y dos. Supongamos ahora que ignoramos cuál falta, pero una fuente fiable informa de que la red verdadera tiene exactamente once enlaces y que no hay falsos positivos. Entre ocho nodos hay veintiocho parejas posibles y el registro contiene diez enlaces. Quedan, por tanto, dieciocho parejas ausentes que podrían corresponder al único enlace omitido. Cada elección produce una completación compatible con esa información.
Al enumerarlas, encontramos que añadir el enlace entre uno y dos restituye el núcleo de cuatro nodos conocido. En cambio, añadir un enlace entre tres y cinco o entre cuatro y cinco produce un núcleo de orden tres con cinco nodos. En las otras quince completaciones, ese núcleo sigue vacío. La información disponible admite un tamaño entre cero y cinco; no identifica el valor cuatro, aunque nosotros lo conozcamos por haber construido la red de referencia.
Tampoco autoriza a afirmar que la probabilidad de existencia del núcleo sea tres dieciochoavos. Para interpretar esa fracción como probabilidad tendríamos que suponer, además, que todas las completaciones tienen el mismo peso. La omisión podría favorecer ciertos tipos de enlaces y las redes completas podrían tener probabilidades previas muy diferentes. La enumeración identifica posibilidades; una distribución sobre ellas necesita una justificación.
Este ejemplo distingue dos usos de una red controlada. Como prueba de un procedimiento, conocemos la verdad y medimos sus errores. Como ejercicio de inferencia, ocultamos esa verdad y preguntamos qué puede recuperarse de la información efectivamente disponible. Mezclar ambos usos llevaría a introducir en la reconstrucción el enlace correcto simplemente porque lo conocemos fuera del registro. Una auditoría rigurosa mantiene esa separación para evaluar con honestidad la capacidad del método.
190.9. Un protocolo de auditoría aplicado al caso
Primero fijamos qué queremos conocer de la red completa durante una ventana concreta, en este caso la conectividad, los triángulos y el núcleo de orden tres. Declaramos que los ocho nodos son conocidos y que, en la versión inicial del ejercicio, solo pueden faltar enlaces. Esta delimitación excluye por ahora problemas de población desconocida y falsos positivos, que se examinarían en escenarios separados.
Después verificamos en el archivo que las etiquetas sean únicas, que no haya bucles ni duplicados, que la matriz sea simétrica y que la suma de grados concuerde con el conteo de enlaces. Estas operaciones detectan errores de representación. No deben confundirse con una validación del contenido, ya que una matriz perfectamente simétrica puede omitir muchas relaciones reales.
Calculamos los resúmenes de la red registrada y conservamos las definiciones. En la versión que omite , hay diez enlaces, dos triángulos, transitividad de seis diecinueveavos y núcleo de orden tres vacío. Indicamos que esos resultados describen el registro. La conectividad permanece, pero esa estabilidad no se extiende a los demás indicadores.
Luego contrastamos escenarios de observación. La eliminación uniforme de un enlace tiene once resultados y admite enumeración exacta. La retención independiente requiere considerar múltiples pérdidas; las omisiones selectivas por región necesitan probabilidades específicas. No promediamos escenarios como si tuvieran igual credibilidad sin una razón para asignarles pesos.
Para cada escenario examinamos la distribución de propiedades y la sensibilidad de las conclusiones. En el diseño de una omisión uniforme, la conectividad sobrevive con probabilidad ocho onceavos y el núcleo de orden tres con probabilidad cinco onceavos. El enlace concreto perdido, que el porcentaje de cobertura no revela, determina cuál de esos resultados observamos.
Finalmente identificamos qué información adicional convendría obtener. En este caso, verificar los seis enlaces de la clique sería especialmente útil para determinar la presencia del núcleo de orden tres. Revisar los puentes sería más relevante si la pregunta principal fuera la conectividad. La prioridad de validación depende del resultado que queremos conocer.
Esta selección orientada puede ahorrar esfuerzo, pero el análisis debe reconocerla si después estima tasas generales de error. Una muestra concentrada en enlaces estructuralmente importantes no tiene por qué representar a todas las parejas. Podemos usarla para resolver una pregunta local o combinarla con un diseño probabilístico más amplio para estimar la calidad global.
Una reconstrucción basada en cierre de triángulos podría favorecer algunos enlaces ausentes porque tienen vecinos comunes. Esa elección incorpora una hipótesis sobre la generación de la red y puede ser útil para predecir relaciones. Sin embargo, usar después la red completada para demostrar un exceso de triángulos sería circular si no se considera cómo se imputaron los enlaces. La auditoría debe conservar los datos originales, marcar cada relación imputada y evaluar los resúmenes bajo alternativas de reconstrucción. La precisión de una predicción de enlaces y la validez de una inferencia sobre organización global requieren controles relacionados, pero diferentes.
190.10. Qué conclusión queda justificada
La auditoría del ejemplo permite concluir que una cobertura alta de enlaces puede coexistir con errores grandes en propiedades estructurales específicas. La omisión de conserva todos los nodos y la conectividad, pero elimina tres triángulos y destruye el núcleo observado de orden tres. Estos resultados son cálculos exactos sobre una red controlada y no indican con qué frecuencia aparece esa fragilidad en general.
El diseño de observación determina qué correcciones son válidas. Las probabilidades marginales de enlace permiten corregir ciertos totales, mientras que los triángulos y otras estructuras requieren probabilidades conjuntas. Los cocientes y los algoritmos de poda necesitan evaluaciones propias. El mismo porcentaje esperado de cobertura puede corresponder a diseños con distribuciones diferentes de resultados.
En una red empírica, el informe final debe separar el archivo observado, las hipótesis sobre pérdidas y las inferencias sobre la red completa. Las estimaciones deben acompañarse de incertidumbre y de análisis frente a mecanismos plausibles. Si los datos disponibles no identifican un aspecto, conviene señalar qué observación adicional permitiría distinguir las explicaciones.
La utilidad práctica de la auditoría está en orientar esa mejora de información. Podemos revisar enlaces decisivos, ampliar la cobertura entre instituciones, validar ausencias o conservar eventos temporales. Cada acción debe responder a una incertidumbre concreta. Repetir indicadores sobre la misma matriz no reemplaza esa tarea.
Con este caso se cierra el estudio de arquitecturas y modelos generativos. Las redes son una representación potente de relaciones, siempre que mantengamos visible cómo se construyó esa representación. En el siguiente módulo examinaremos procesos que se propagan, se coordinan o cambian de régimen sobre ellas. Sus conclusiones dependerán tanto de las reglas dinámicas como de la calidad con que conocemos la estructura que las sostiene.
Referencias
- Handcock, M. S., y Gile, K. J. (2010). Modeling social networks from sampled data. The Annals of Applied Statistics, 4(1), 5–25. DOI.
- Kossinets, G. (2006). Effects of missing data in social networks. Social Networks, 28(3), 247–268. DOI.
- Stumpf, M. P. H., Wiuf, C., y May, R. M. (2005). Subnets of scale-free networks are not scale-free: Sampling properties of networks. Proceedings of the National Academy of Sciences, 102(12), 4221–4224. DOI.