COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 19. Arquitecturas de redes y modelos generativos
184.1. Parecerse y estar conectado
En una red de colaboración es frecuente encontrar vínculos entre personas de la misma disciplina. Ese patrón puede reflejar afinidad intelectual, oportunidades de encuentro, requisitos de una tarea o una combinación de factores. Los investigadores de un departamento comparten espacios y proyectos; quienes trabajan en instituciones distintas pueden no tener ocasión de conocerse. Observar semejanza entre personas conectadas identifica una organización de la red, pero todavía no explica cómo se produjo.
La homofilia estructural describe una concentración de relaciones entre nodos semejantes según un atributo especificado. La semejanza debe definirse; puede consistir en pertenecer a una categoría, tener edades próximas, compartir idioma o estar cerca en un conjunto de características. Una misma red puede mostrar mezcla entre disciplinas y separación por institución. No hay un único valor de homofilia independiente de la variable elegida.
También importa la población de comparación. Si casi todos los posibles colaboradores pertenecen a una misma categoría, muchos vínculos dentro de ella serán esperables sin preferencia especial. Una persona de un grupo mayoritario puede tener una alta proporción de contactos semejantes y, al mismo tiempo, establecer más contactos entre grupos de los que haría esperar la distribución de oportunidades. El porcentaje bruto de relaciones internas es insuficiente.
McPherson, Smith-Lovin y Cook (2001) organizan la evidencia y las fuentes de homofilia en redes sociales. Para el análisis cuantitativo conviene mantener separadas la composición de la población, las oportunidades de contacto y los mecanismos de elección, porque cada uno de estos componentes requiere datos distintos y conduce a otra referencia para evaluar el patrón observado.
La mezcla puede ser heterofílica, con relaciones concentradas entre tipos distintos. En una red entre compradores y vendedores, esa organización puede estar incorporada a la definición de los papeles y no implica que las personas eviten a quienes se les parecen; el conjunto de conexiones permitidas ya excluye ciertas parejas. Comparar esa red con un modelo que permite todas las relaciones atribuiría a una preferencia lo que corresponde a una restricción del sistema.
Empezaremos por contar las aristas entre categorías. Después veremos cómo normalizar esa cuenta, cómo cambian las conclusiones con tamaños de grupo desiguales y por qué las propiedades de los nodos conectados no son observaciones independientes. Un ejemplo de instituciones segregadas mostrará cómo aparece una fuerte asociación agregada sin selección adicional dentro de cada entorno. La distinción entre estructura e influencia será necesaria para interpretar cualquier aplicación causal.
184.2. Construir una matriz de mezcla
Supongamos que cada nodo pertenece a una categoría . Para una red dirigida, definimos como la fracción de aristas cuyo origen pertenece al tipo y cuyo destino pertenece al tipo . La suma de todos los elementos es uno. Las sumas por fila indican qué fracción de aristas sale de cada tipo; las sumas por columna, qué fracción llega a cada tipo. En símbolos,
Aquí y son distribuciones marginales de extremos de aristas, distintas de las proporciones de nodos. Un grupo pequeño con nodos muy activos puede concentrar una fracción grande de los orígenes. Sustituir esas fracciones por el tamaño poblacional de cada grupo cambia el modelo de referencia y puede alterar la interpretación de la mezcla.
Para una red no dirigida, cada arista puede contarse en sus dos orientaciones. Una arista entre grupos diferentes suma una incidencia a cada entrada simétrica; una arista interna suma dos a la diagonal correspondiente. Al dividir por , la matriz queda simétrica y normalizada. Con esa convención, la fracción total de aristas internas es la traza de y la suma de los elementos fuera de la diagonal es la fracción entre grupos.
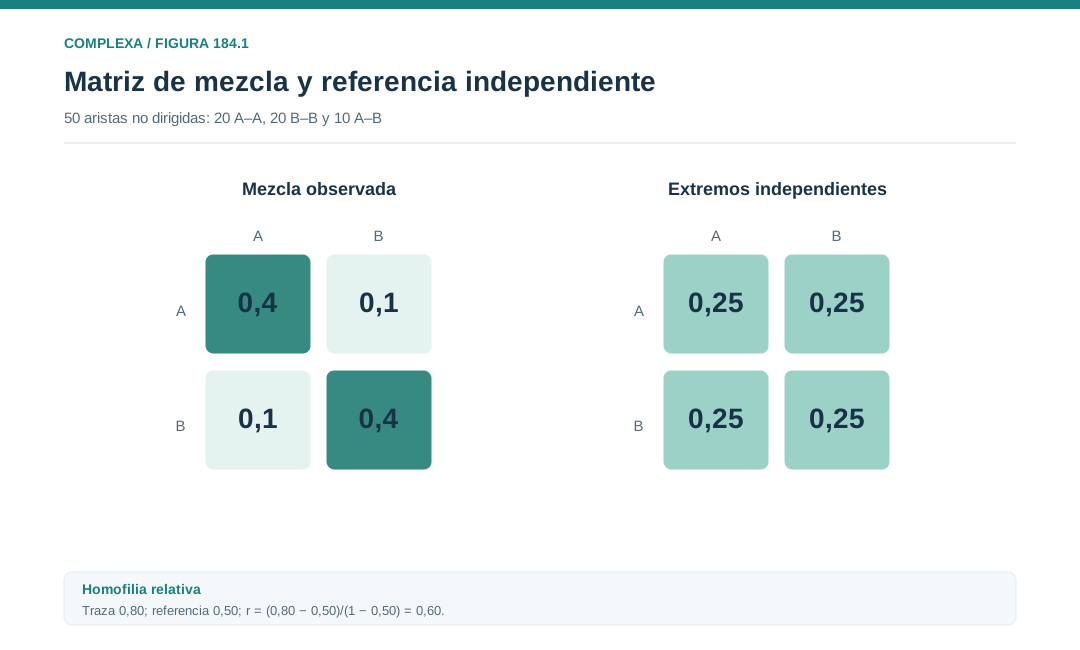
Consideremos cincuenta aristas. Veinte son internas del grupo A, veinte internas del grupo B y diez unen ambos grupos, de modo que la matriz de mezcla es
La traza, , indica que el ochenta por ciento de las aristas une nodos del mismo grupo. Cada grupo tiene la mitad de los extremos. Las entradas cruzadas valen una décima cada una, pero las aristas que conectan grupos distintos son el veinte por ciento, porque hay que sumar ambas. Este factor de dos es una fuente frecuente de errores al pasar de una tabla de conteos a una matriz normalizada.
En una red ponderada pueden sustituirse conteos por magnitudes de intercambio, siempre que los pesos sean no negativos y comparables. Entonces la matriz describe cómo se distribuye la actividad. Un pequeño número de enlaces intensos puede dominar la mezcla ponderada mientras la mayoría de los vínculos conecta otros tipos. Conviene conservar la descripción por conteos y la ponderada cuando número de relaciones y volumen de actividad responden a preguntas diferentes.
184.3. Comparar con la composición de los extremos
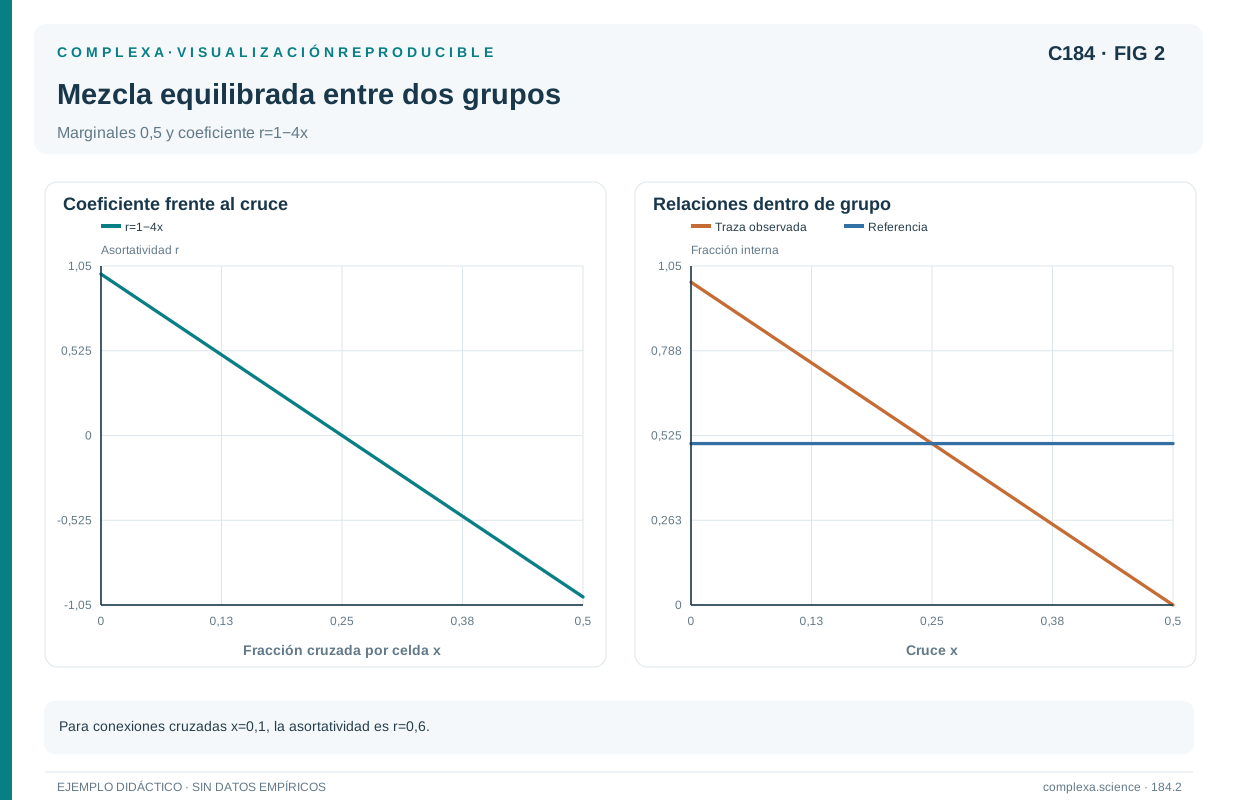
Si los tipos de origen y destino se combinaran independientemente manteniendo sus distribuciones marginales, la fracción esperada de aristas de tipo sería . La fracción interna de referencia sería la suma de esos productos sobre categorías iguales. Esta construcción elimina del contraste la parte atribuible a cuánto participa cada grupo en los extremos de aristas.
Newman (2003) formula un coeficiente de mezcla categórica que compara la traza observada con esa referencia y la normaliza respecto del máximo,
Un valor positivo indica más conexión interna que la referencia independiente; uno negativo indica menos. El valor cero expresa coincidencia en esa suma diagonal, aunque no garantiza que toda la matriz sea igual al producto de sus marginales cuando hay varias categorías. Diferentes patrones de conexión entre grupos pueden compartir el mismo coeficiente.
En el ejemplo de cincuenta aristas, la referencia interna es , porque cada grupo tiene la mitad de los extremos. El coeficiente vale y resume una concentración apreciable de aristas internas respecto de esa referencia. Leerlo como si el sesenta por ciento de las relaciones se debiera a preferencias homofílicas sería un error.
Cuando todos los extremos pertenecen a una sola categoría, el atributo no varía, el denominador es cero y el coeficiente queda indefinido. Asignarle cero escondería la falta de contraste; asignarle uno confundiría una composición uniforme con una preferencia demostrada. La ausencia de variación debe explicarse antes de comparar valores entre redes.
El límite inferior tampoco es siempre menos uno. Si un grupo tiene el noventa por ciento de los extremos y el otro, el diez, solo una fracción limitada de ellos puede emparejarse entre grupos. Aun maximizando las conexiones cruzadas, queda al menos un ochenta por ciento de aristas internas en la representación normalizada. Con esas marginales, el coeficiente mínimo es .
Esta restricción afecta a la comparación entre poblaciones con composiciones diferentes. Un valor cercano a menos una décima puede corresponder a la mezcla cruzada máxima en un caso y a una desviación pequeña en otro. El coeficiente da una escala útil, pero su rango factible depende de las marginales y de otras restricciones del grafo. La tabla completa ayuda a interpretar qué combinaciones estaban realmente disponibles.
184.4. Grupos desiguales y homofilia desde cada lado
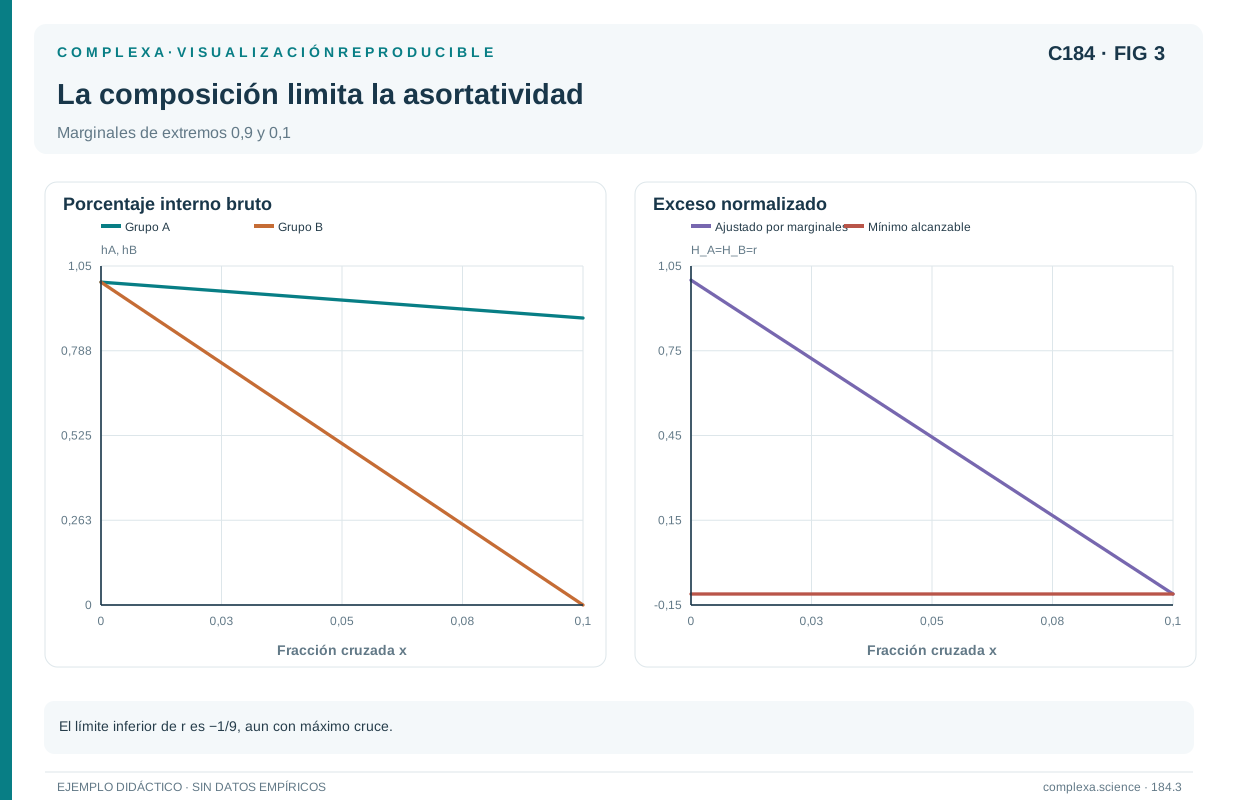
Consideremos ahora cien aristas no dirigidas (ochenta y cinco dentro del grupo A, cinco dentro del grupo B y diez entre grupos). La matriz tiene entradas diagonales y ; cada entrada cruzada vale . El grupo A tiene el noventa por ciento de los extremos y el B, el diez. La fracción total de aristas internas es del noventa por ciento.
Desde un extremo del grupo A, la probabilidad de que el otro extremo sea A es , aproximadamente . Desde B, la probabilidad de encontrar otro B es . Si se comparan únicamente esos porcentajes, el primer grupo parece mucho más encerrado, aunque las oportunidades de encontrar un extremo del mismo tipo son muy distintas en uno y otro.
Una normalización por grupo puede comparar la proporción interna con la fracción de extremos de ese tipo. Para una red no dirigida, una forma útil es , siempre que el denominador no sea cero. En este ejemplo, ambos grupos obtienen . Un mismo exceso relativo de conexión interna produce, así, proporciones brutas muy diferentes.
El coeficiente global también vale cuatro novenos, porque la referencia interna es y el exceso observado es de ocho centésimas. La igualdad entre los dos índices por grupo y el coeficiente global se cumple en toda matriz simétrica con exactamente dos categorías y marginales positivas. Para verlo, sea la marginal de la primera categoría y la de la segunda. Ambas diferencias entre diagonal observada y referencia valen ; al normalizar, los dos índices resultan , igual al coeficiente global. Con más categorías o con una matriz dirigida asimétrica, la identidad deja de cumplirse en general. En tales casos, un promedio puede ocultar que un grupo está muy conectado hacia fuera y otro apenas participa en relaciones cruzadas.
Si la pregunta trata de las oportunidades de una persona concreta, los extremos globales pueden no ser la referencia adecuada. Una persona puede interactuar solo dentro de su institución, su barrio o su turno; el grupo relevante es entonces el conjunto al que realmente pudo acceder. Usar la composición de toda la población puede exagerar o reducir su homofilia aparente según cómo se distribuyan esos entornos.
En poblaciones finitas, la referencia también cambia al excluir la conexión de un nodo consigo mismo. Si una categoría contiene de los nodos y todas las otras personas son igualmente accesibles, la proporción de candidatos semejantes para un miembro es . Sustituirla por es una aproximación. La diferencia es pequeña en grupos grandes y puede ser importante en grupos reducidos.
Elegir el denominador es una decisión sustantiva. El tamaño de la población mide la disponibilidad general, los extremos ponderan la actividad y el entorno local recoge oportunidades específicas. Ninguna de estas referencias es por definición la correcta para todas las preguntas; debe elegirse según la comparación que se quiere sostener y la información que permite el registro.
184.5. Un patrón agregado creado por oportunidades separadas
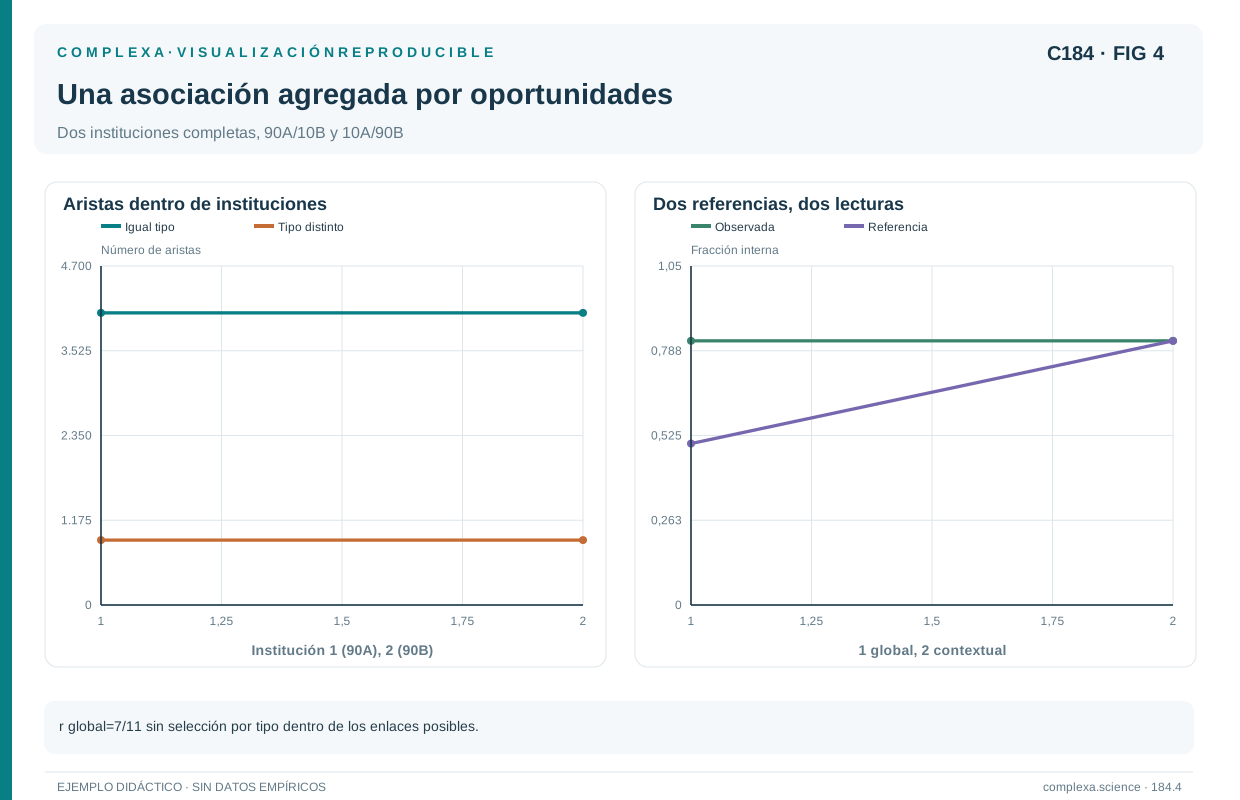
Imaginemos dos instituciones con cien integrantes cada una. En la primera hay noventa personas del tipo A y diez del tipo B; en la segunda, diez A y noventa B. Dentro de cada institución todas las parejas están conectadas y no hay aristas entre instituciones, de modo que la regla de conexión no distingue tipos.
Cada institución contiene 4.950 aristas, de las cuales 4.005 unen integrantes del grupo mayoritario, cuarenta y cinco unen integrantes del minoritario y novecientas conectan tipos distintos. La fracción de aristas entre nodos del mismo tipo es 4.050 sobre 4.950, es decir, nueve onceavos.
En la población completa hay cien integrantes de cada categoría y todos tienen grado noventa y nueve. Por tanto, los dos tipos tienen la misma cantidad de extremos de aristas y una referencia global independiente esperaría la mitad de las aristas dentro del mismo tipo. La fracción observada, nueve onceavos, produce un coeficiente de mezcla de siete onceavos, aproximadamente .
El valor es alto, pero el ejemplo se construyó sin preferencia por el tipo dentro de las oportunidades disponibles. La institución determina quién puede conectarse y, a la vez, está correlacionada con el tipo. Al condicionar la comparación a cada institución desaparece esa discrepancia, porque dentro de ella se observan todas las relaciones permitidas. El patrón agregado sigue siendo real; cambia la explicación que puede atribuírsele.
Este ejemplo usa instituciones completas para que la cuenta sea exacta. Con probabilidades de enlace iguales dentro de cada institución aparecería el mismo mecanismo en esperanza, acompañado de fluctuaciones. El resultado tampoco exige que la separación institucional sea inocua o accidental; puede tener una historia social que explique por qué los tipos quedaron distribuidos así, pero la tabla de relaciones del momento observado no la identifica.
En redes reales, algunas oportunidades pueden medirse mediante coincidencia espacial, horarios, pertenencia organizacional o exposición a un mismo recurso. Otras permanecen ocultas. Un modelo que incorpora unas pocas variables no garantiza eliminar toda la selección. La comparación puede mostrar que el patrón excede lo explicado por los contextos registrados, pero la incertidumbre sobre los contextos ausentes se mantiene.
Una asociación entre semejanza y enlace puede aparecer en distintos momentos de la construcción de la red. Puede originarse al distribuir personas entre entornos, al elegir contactos dentro de ellos o al mantener unas relaciones y abandonar otras. Un registro transversal mezcla esos procesos; separarlos requiere observar oportunidades y cambios, además del estado final de las conexiones.
184.6. Mezcla por variables numéricas y por grado
Cuando el atributo es numérico, como la edad o el tamaño de una organización, puede calcularse una correlación entre sus valores en los extremos de las aristas. En una red no dirigida se consideran ambas orientaciones, de modo que la distribución de origen y la de destino coinciden. Una correlación positiva indica que los valores grandes se conectan preferentemente con valores grandes y los pequeños con pequeños, respecto de la referencia implícita en ese cálculo.
La correlación de Pearson resume una relación lineal y puede pasar por alto patrones no monótonos. Una red en la que los valores intermedios se conectan entre sí y los extremos se relacionan de otra manera puede tener una correlación pequeña pese a una organización marcada. Conviene examinar la distribución conjunta o agrupar valores en intervalos razonables. La discretización facilita algunas comparaciones, pero también introduce fronteras que deben justificarse.
La mezcla por grado, habitualmente llamada asortatividad de grado, usa como atributo el número de conexiones del nodo. Al seguir una arista se llega con más frecuencia a nodos de grado alto, por lo que la medida se basa, por definición, en la distribución de los extremos de aristas. Calcular una correlación sobre una lista de nodos muestreados uniformemente respondería a otra pregunta.
En una estrella de seis nodos, el centro tiene grado cinco y cada hoja, grado uno. Todas las aristas unen un extremo de grado cinco con otro de grado uno, de modo que la correlación de grados en los extremos es menos uno. La disasortatividad es aquí una propiedad exacta de la arquitectura; del dibujo no puede deducirse una preferencia psicológica ni una regla de crecimiento.
En una red regular todos los nodos tienen el mismo grado, la varianza del atributo es cero y la correlación queda indefinida. Si una implementación devuelve un valor especial, debe indicarlo, porque ese valor no puede compararse como si fuera una estimación ordinaria. El mismo problema aparece si se analiza una variable que apenas cambia en el conjunto de extremos observado.
Para redes dirigidas hay varias correlaciones posibles (salida del origen con entrada del destino, salida con salida, entrada con entrada o entrada con salida) y cada combinación responde a una organización distinta. Una red puede conectar grandes emisores con grandes receptores y, al mismo tiempo, evitar enlaces entre grandes emisores. Informar un único coeficiente sin indicar qué grados se comparan deja indeterminado el resultado.
La simplicidad del grafo impone restricciones adicionales. Si solo se permite una arista por pareja, dos nodos muy conectados no pueden unirse mediante varias. Parte de una mezcla negativa de grados puede surgir de esas restricciones en secuencias muy heterogéneas. Una referencia que conserva los grados y la simplicidad ayuda a distinguir esa contribución de otras reglas de enlace.
184.7. Semejanza, selección e influencia
Dos personas conectadas pueden comportarse de forma similar porque se eligieron por rasgos previos, porque una modificó a la otra o porque comparten circunstancias que influyen en ambas. También pueden parecer similares por cómo se mide el resultado. Estas posibilidades producen asociaciones que una sola tabla de mezcla no distingue.
Hay selección por semejanza cuando atributos o comportamientos contribuyen a formar o mantener la relación; hay influencia cuando la exposición a otra persona cambia un resultado. Una causa compartida puede modificar a la vez la conducta y la probabilidad de contacto. Para hablar de influencia hay que definir qué exposición se considera, qué resultado cambiaría y qué comparación permitiría estimar ese cambio.
Shalizi y Thomas (2011) muestran problemas generales de confusión entre homofilia e influencia en estudios observacionales de redes. Su análisis deja abierta la posibilidad de estudiar la influencia, pero señala que la información relacional y temporal habitual puede ser compatible con mecanismos causales diferentes cuando hay características no observadas que afectan a los enlaces y a la conducta. En esos casos, la identificación necesita supuestos o diseños adicionales.
Supongamos una característica latente, como un interés compartido. Las personas con ese interés se relacionan con mayor frecuencia y tienen mayor probabilidad de adoptar una actividad. Si el interés no se mide, la adopción previa de un contacto puede predecir la adopción propia. El orden temporal da información, pero no descarta que ambos procesos estén impulsados por la misma característica y por oportunidades correlacionadas.
Incorporar medidas previas del resultado puede reducir algunas diferencias, aunque no garantiza medir todos los determinantes relevantes. Un atributo latente puede afectar a la velocidad de cambio, a la exposición futura o a la permanencia de la relación. Controlar un estado inicial no equivale a controlar toda la trayectoria que ese atributo produce. Por otra parte, seleccionar únicamente las relaciones que sobreviven durante el estudio puede introducir otra forma de sesgo.
Los experimentos y las variaciones exógenas de la exposición pueden permitir la identificación cuando sus condiciones son defendibles. También es posible diseñar comparaciones con información detallada sobre oportunidades y mecanismos de formación. La solidez de la inferencia depende del diseño concreto, de cómo se trate la interferencia entre participantes y de la plausibilidad de los supuestos. Un coeficiente alto de homofilia no sustituye ninguna de esas piezas.
Para un análisis descriptivo puede bastar afirmar que los nodos conectados se parecen según una medida y una referencia especificadas, una afirmación útil y verificable. Convertirla en «las personas imitan a sus contactos» añade una explicación que los datos deben sostener por otra vía. La precisión causal comienza por reconocer qué parte de la conclusión se calculó y qué parte requiere un mecanismo.
184.8. Qué aleatorización responde a cada pregunta
Una prueba por permutación puede mantener fija la red y reasignar las etiquetas de tipo entre nodos sin cambiar la cantidad de cada categoría. El procedimiento compara la asociación observada con una distribución en la que las etiquetas son intercambiables sobre las posiciones de la red. Si determinados tipos tienen sistemáticamente grados distintos u ocupan regiones específicas, la intercambiabilidad global puede no ser una hipótesis razonable.
Permutar dentro de instituciones mantiene su composición y pregunta por la organización adicional dentro de esos contextos. Permutar dentro de grupos de grado conserva aproximadamente la relación entre tipo y conectividad. Cada restricción cambia la hipótesis. Añadir demasiadas puede dejar pocas reasignaciones y reducir la capacidad de detectar diferencias; omitir restricciones relevantes puede producir una referencia inadecuada.
Otra estrategia mantiene los tipos y aleatoriza las aristas mediante un modelo de configuración. Así se conservan los grados y se examina si la mezcla excede lo esperado al redistribuir las conexiones. El resultado depende de si se permiten bucles, multiplicidades o relaciones entre cualquier pareja. Si la red contiene roles que prohíben ciertos enlaces, esas restricciones deben formar parte del conjunto de referencia.
También puede ajustarse un modelo probabilístico en el que la conexión dependa de la semejanza, la distancia y atributos de actividad. El coeficiente de semejanza resume la relación entre semejanza y enlace bajo esa especificación. Ese coeficiente estimado puede diferir de una preferencia causal, porque una variable omitida o una forma funcional equivocada puede atribuirle organización que procede de otro mecanismo.
Tratar todas las aristas como observaciones independientes para estimar la incertidumbre requiere una justificación, porque varias comparten nodos, contextos y acontecimientos. Una perturbación de un nodo puede modificar muchos enlaces a la vez. El método de remuestreo o la distribución del modelo deben respetar la dependencia pertinente para la pregunta. La cantidad de pares posibles puede ser enorme sin que haya otras tantas unidades independientes de información.
Conviene comparar la tabla completa además del coeficiente agregado. Un modelo puede reproducir la fracción total de aristas internas y fallar sistemáticamente en una categoría pequeña. La evaluación por grupos detecta esa discrepancia y permite ver si una aparente mejora del ajuste global se obtiene a costa de representar peor a una parte de la población.
184.9. Atributos inciertos y redes que cambian
Las categorías de nodos pueden tener errores, cambiar en el tiempo o reflejar decisiones administrativas. Si se asigna una etiqueta única a una persona con varias afiliaciones, la mezcla resultante depende de qué afiliación se eligió. Una red interdisciplinaria puede parecer más separada si se usan departamentos y más integrada si se usan proyectos. Ambas clasificaciones pueden ser útiles si queda claro qué dimensión describe cada una.
Las categorías muy amplias ocultan diferencias internas; las muy pequeñas producen tablas dispersas. Dividir una categoría puede aumentar o reducir la traza de mezcla sin que cambie una sola arista. Comparar coeficientes entre estudios exige conocer la resolución de la clasificación y las reglas para asignar casos ambiguos. Un índice adimensional no queda libre de esas decisiones.
Si los tipos cambian después de establecer la relación, una medición final puede atribuir semejanza inicial a nodos que se hicieron parecidos durante el seguimiento. También puede ocurrir que la etiqueta cambie porque ambos reciben una clasificación común al participar en la relación. Para estudiar la selección es necesario alinear temporalmente atributos y formación de enlaces; para estudiar la influencia, la secuencia de exposiciones y resultados requiere otra organización del registro.
La duración de las relaciones añade información. Una red agregada puede reunir contactos breves entre grupos y relaciones duraderas dentro de ellos. El conteo binario los trata a todos por igual; una ponderación por duración describe otra forma de mezcla. Ninguna versión es superior en abstracto; la elección depende de si interesa el acceso a contactos distintos, la cantidad de exposición o la estabilidad de los vínculos.
La detección desigual de enlaces también puede crear mezcla aparente. Supongamos una red de cien aristas, con veinticinco dentro de A, veinticinco dentro de B y cincuenta entre grupos. Sus extremos están equilibrados y el coeficiente de mezcla es cero. Imaginemos ahora un registro que conserva veinte aristas de cada categoría interna y solo diez de las cruzadas. La red registrada tiene un ochenta por ciento de aristas internas y su coeficiente sube a seis décimos, sin que haya cambiado ninguna relación real.
El ejemplo puede corresponder a un instrumento que registra bien las interacciones dentro de instituciones y pierde las que cruzan sus fronteras. Si se conocen las probabilidades de detección, las cantidades de aristas pueden estimarse ponderando cada observación por el inverso de su probabilidad de inclusión. Con probabilidades de ocho décimos para las relaciones internas y dos décimos para las cruzadas, los conteos ponderados del ejemplo recuperan veinticinco, veinticinco y cincuenta. Los cocientes calculados a partir de totales estimados tienen incertidumbre y pueden estar sesgados en muestras finitas.
La corrección requiere que las probabilidades pertinentes sean positivas y estén justificadas. Si una clase de vínculos nunca puede observarse, reponderar los enlaces disponibles no permite recuperar sus cantidades. Esa falta de información debe distinguirse de una preferencia negativa por relacionarse entre grupos. El diseño de observación forma parte de la explicación del patrón registrado.
Una auditoría puede repetir el análisis con clasificaciones justificadas, mantener los casos inciertos como tales y comparar redes construidas en ventanas compatibles. El objetivo es localizar qué resultados dependen de la resolución del atributo o del tiempo. Una conclusión robusta debe poder enunciarse junto con esas condiciones, sin convertir una clasificación particular en una propiedad esencial de las personas o del sistema.
184.10. Una lectura completa de la mezcla observada
Para interpretar una matriz de mezcla hay que empezar por sus conteos. Qué nodos se incluyeron, qué enlaces se registraron y cómo se definieron los tipos determinan el contenido de cada casilla. Después se calculan las marginales pertinentes, ya sean de población, de extremos de aristas o de oportunidades locales. Solo entonces puede establecerse qué significa un exceso de relación interna.
Los ejemplos del capítulo justifican ese orden. Una proporción interna del noventa por ciento puede corresponder a una desviación moderada cuando un grupo domina las oportunidades. Dos grupos con porcentajes internos muy diferentes pueden compartir el mismo exceso relativo respecto de sus marginales. Dos instituciones con composiciones opuestas pueden generar un coeficiente global alto aunque dentro de cada una no haya selección adicional por tipo.
La tabla observada también puede contener patrones que un solo coeficiente no conserva. Algunos grupos pueden intercambiar mucho entre sí y relacionarse poco con los restantes. Esa organización puede ser relevante para la circulación de información o el acceso a recursos, aunque la traza global coincida con una referencia. Examinar entradas específicas y su incertidumbre permite formular preguntas más concretas que clasificar toda la red como homofílica o heterofílica.
Cuando se busca explicar el patrón, deben distinguirse las oportunidades, la selección de relaciones y los cambios posteriores. El registro transversal informa principalmente del estado resultante. Los datos longitudinales, las medidas de contexto y los diseños de exposición amplían lo que puede evaluarse, pero necesitan hipótesis explícitas. La semejanza observada entre vecinos es el punto de partida de esa investigación; la explicación queda por construir.
Referencias
McPherson, M., Smith-Lovin, L. y Cook, J. M. (2001). Birds of a feather: Homophily in social networks. Annual Review of Sociology, 27, 415–444. DOI.
Newman, M. E. J. (2003). Mixing patterns in networks. Physical Review E, 67, 026126. DOI.
Shalizi, C. R. y Thomas, A. C. (2011). Homophily and contagion are generically confounded in observational social network studies. Sociological Methods & Research, 40(2), 211–239. DOI.