COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 19. Arquitecturas de redes y modelos generativos
186.1. Explicar una red mediante una distribución de posibilidades
Una red observada contiene una realización de relaciones; ciertos enlaces están presentes y otros no. Un modelo generativo especifica una distribución sobre redes posibles. Con ella pueden calcularse las estructuras frecuentes bajo ciertos supuestos, producirse realizaciones comparables y evaluarse qué aspectos del registro cuesta reproducir. El modelo convierte una descripción verbal en un conjunto de predicciones sobre enlaces y propiedades colectivas.
La palabra generativo no implica necesariamente una historia temporal. Un procedimiento que asigna probabilidades a todas las parejas y después sortea sus enlaces genera una red, aunque no describa cómo se formaron las relaciones. Una dinámica de crecimiento y una distribución estática pueden producir patrones parecidos. Distinguirlas requiere datos sobre el proceso, además de su resultado.
Algunos modelos usan atributos observados, como ubicación, tamaño o pertenencia institucional. Otros introducen variables latentes, como grupos, posiciones o propensiones, que no están registradas directamente y se infieren a partir de las conexiones. Esas variables resumen la organización, aunque su interpretación sustantiva necesita evidencia adicional, porque una partición que explica enlaces no identifica automáticamente categorías sociales, funciones biológicas o mecanismos causales.
El modelo de bloques estocásticos es una formulación especialmente útil. Propone que la probabilidad de conexión depende de los grupos a los que pertenecen los extremos. Los grupos pueden corresponder a comunidades densas, posiciones de núcleo y periferia o papeles complementarios. Cuál de esas estructuras describe un modelo concreto depende de la matriz de probabilidades entre grupos.
Holland, Laskey y Leinhardt (1983) formularon una base de estos modelos. Las extensiones posteriores incorporaron heterogeneidad de grados, jerarquías y criterios de selección. Veremos por qué esas modificaciones hacen falta para distinguir una organización real de una partición que solo acomoda nodos de grados muy distintos.
El problema completo incluye generación, inferencia y evaluación. Generar consiste en producir redes a partir de parámetros; inferir, en estimar parámetros o grupos desde una red; evaluar, en examinar si las predicciones reproducen aspectos pertinentes del sistema. Un buen ajuste a los enlaces usados durante la inferencia deja todavía abiertas las otras tareas. La comparación debe conservar resultados que puedan fallar si el modelo omite organización importante.
186.2. El modelo de bloques más sencillo
Consideremos un grafo simple no dirigido con matriz de adyacencia . A cada nodo se le asigna un grupo . Una matriz simétrica contiene las probabilidades de conexión entre grupos. Condicionados a esas etiquetas y probabilidades, los enlaces de parejas distintas se generan de manera independiente con probabilidades
La independencia es condicional. Si las etiquetas son desconocidas y se promedian sobre distintas asignaciones, los enlaces pueden resultar dependientes porque comparten información sobre los grupos. Dos conexiones que parten de un mismo nodo informan sobre su etiqueta y, por esa vía, sobre otras conexiones. No debe confundirse la factorización condicional con la independencia marginal de los datos observados.
La verosimilitud para una asignación conocida es el producto de las probabilidades de presencia o ausencia de cada enlace
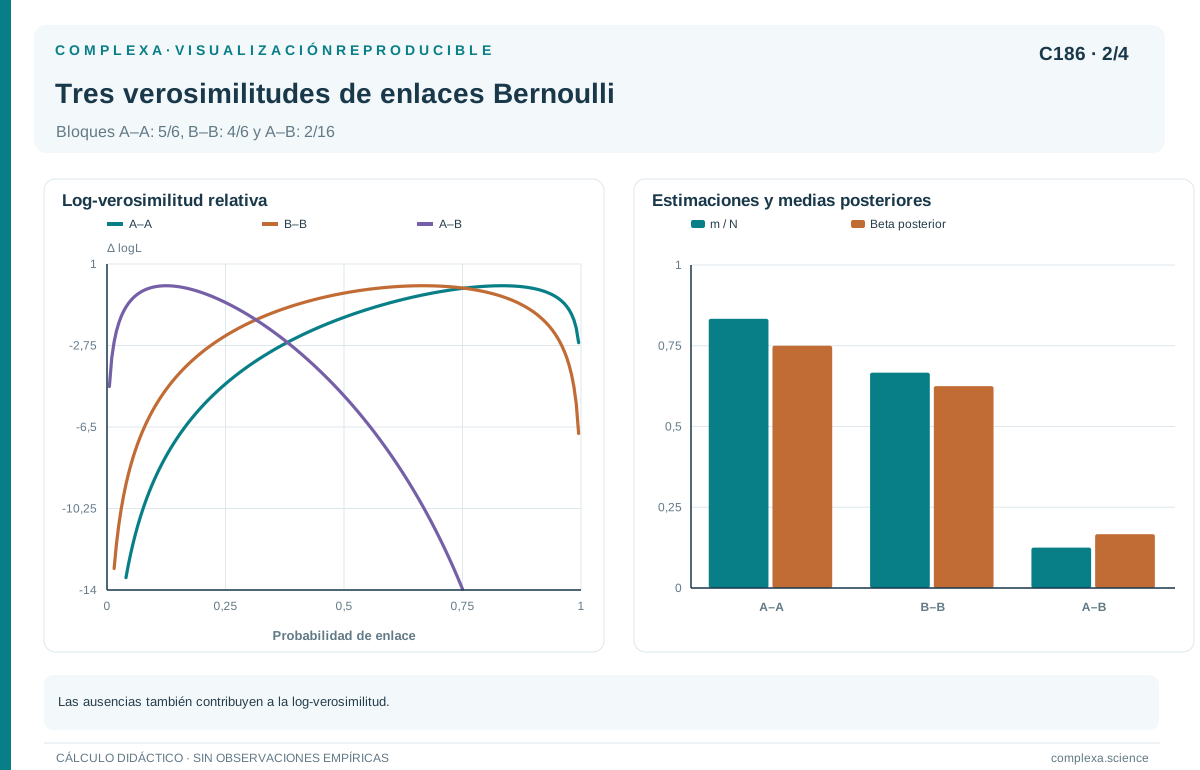
Las ausencias forman parte de la información. Si el modelo atribuye alta probabilidad interna a un grupo, los numerosos pares sin conexión dentro de él penalizan esa propuesta. Ajustar solo los enlaces presentes sin considerar las parejas que podían conectarse favorecería modelos demasiado densos y dejaría indeterminada la interpretación de las probabilidades.
Para grupos distintos, el número de parejas posibles es . Dentro de un grupo es . Si cuenta los enlaces observados entre esas parejas, la estimación de máxima verosimilitud de , con etiquetas fijas, es el cociente entre enlaces y oportunidades. El cálculo es una estimación binomial para cada bloque de pares.
Esta formulación supone homogeneidad dentro de los bloques. Dos nodos del mismo grupo tienen iguales probabilidades de conexión con los integrantes de otro, salvo restricciones como no conectarse consigo mismos. La hipótesis puede ser razonable para ciertos datos y demasiado restrictiva para otros. Si un grupo contiene nodos muy activos junto a otros casi aislados, el modelo básico debe explicar esa heterogeneidad mediante fluctuaciones o dividirlos en grupos diferentes.
La red generada no conserva necesariamente el número exacto de enlaces de cada bloque ni los grados de cada nodo. Conserva sus valores esperados según los parámetros. Si se necesitan cantidades exactas, puede definirse una versión condicionada a conteos. Esa elección modifica la distribución y algunas dependencias, aunque ambas versiones compartan una descripción verbal de organización por bloques.
186.3. Un ajuste con ocho nodos
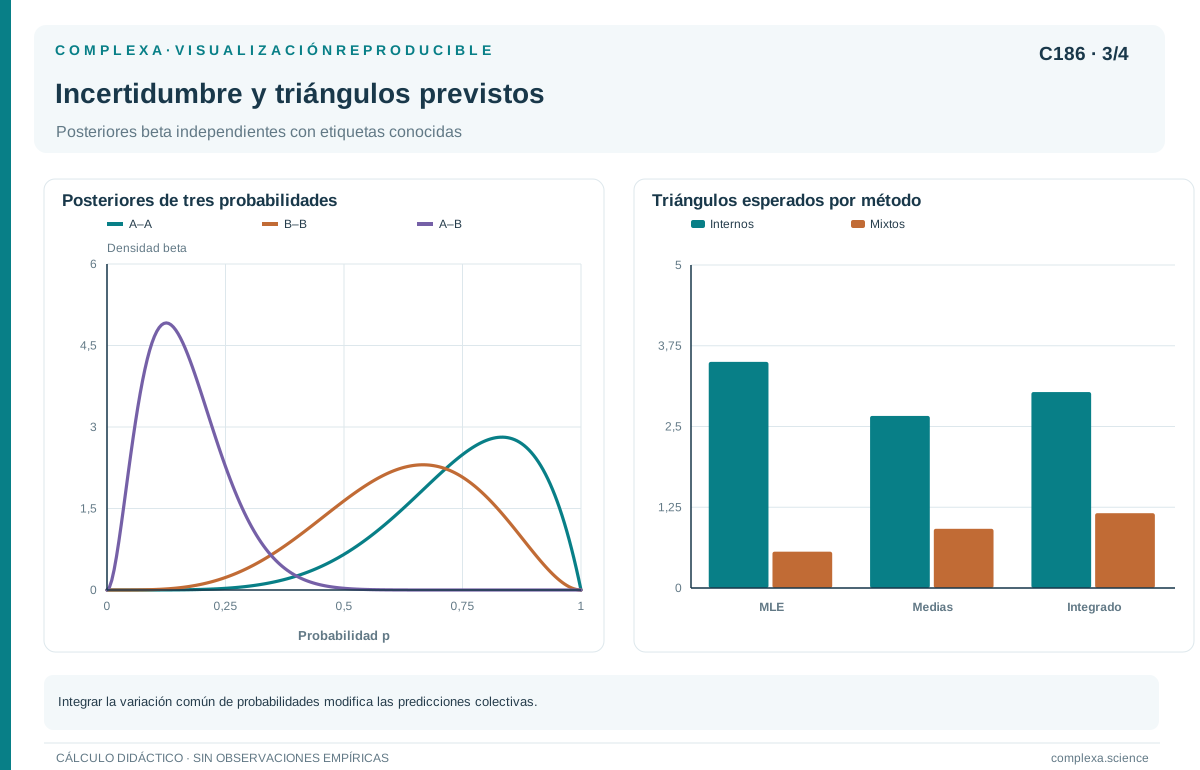
Supongamos que ocho nodos se dividen en dos grupos conocidos de cuatro. En el primero se observan cinco de las seis aristas internas posibles; en el segundo, cuatro de seis. Entre ambos grupos aparecen dos de las dieciséis relaciones posibles. Las estimaciones directas son cinco sextos, dos tercios y un octavo para las tres probabilidades correspondientes.
La estructura es asortativa, porque ambos grupos tienen mayor probabilidad de conexión interna que de intercambio entre sí. Esa descripción depende de las etiquetas usadas. Si se estimaran desde la misma red, la búsqueda de una partición que maximiza diferencias también debería incorporarse a la evaluación.
Bajo el modelo ajustado, el grado esperado de un nodo del primer grupo es . Para el segundo es . La suma de grados esperados es veintidós y el número esperado de aristas, once, igual al conteo usado para el ajuste. Esa coincidencia la impone la propia estimación y carece de valor como validación independiente.
Pueden calcularse otras predicciones que no quedan fijadas por esos conteos. Para un triángulo específico, la probabilidad condicionada a grupos y parámetros es el producto de las probabilidades de sus tres aristas. Hay cuatro ternas dentro de cada grupo y veinticuatro ternas con dos integrantes de un grupo y uno del otro, para cada orientación de la composición.
El número esperado de triángulos es . Para compararlo con la red observada necesitamos conocer cómo se distribuyen las aristas, porque los conteos de bloque no determinan sus triángulos. También hace falta la variabilidad predictiva; una diferencia respecto de la esperanza puede ser ordinaria bajo el modelo. El cálculo ilustra cómo pasar de parámetros ajustados a una propiedad colectiva comprobable.
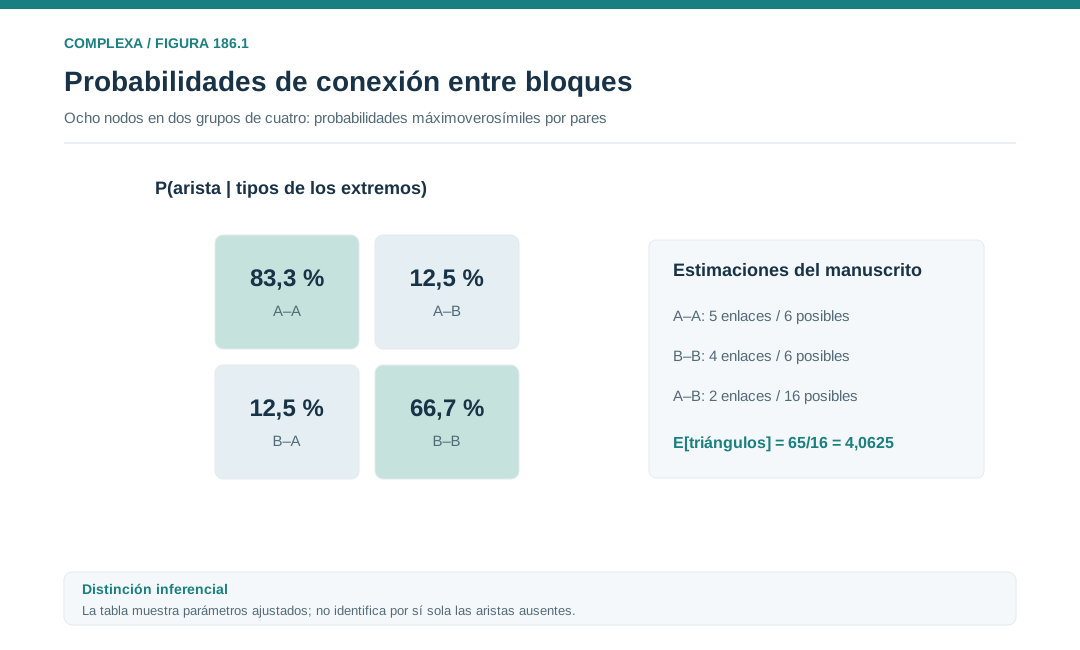
Con tan pocas parejas, las probabilidades son inciertas. Una distribución previa uniforme para cada probabilidad produce una distribución posterior beta con parámetros y . Sus medias son , y , respectivamente. La regularización evita estimaciones extremas cuando hay pocos casos, pero depende de la distribución previa. No convierte ocho nodos en una muestra abundante ni elimina la incertidumbre sobre las etiquetas.
La incertidumbre de parámetros cambia también las dependencias predictivas. Dos aristas distintas de una nueva realización del primer bloque son independientes si su probabilidad se mantiene fija. Si ambas comparten una probabilidad desconocida con distribución posterior beta de parámetros seis y dos, sus predicciones se vuelven dependientes, porque observar una informa sobre el parámetro común. La covarianza predictiva de sus indicadores es la varianza posterior de esa probabilidad, igual a un cuarenta y ochoavo en este caso.
Para un triángulo totalmente interno, integrar la incertidumbre exige calcular la esperanza del cubo de la probabilidad, que difiere del cubo de su esperanza. Con esa misma distribución beta se obtiene , mientras que . La diferencia procede de la variabilidad compartida del parámetro. Sustituirlo por su media puede subestimar determinados patrones conjuntos, incluso cuando las predicciones marginales de cada arista parecen bien resumidas.
En una exploración preliminar no siempre hace falta integrar toda la incertidumbre; el cálculo permite saber qué se aproxima al generar una red con una sola matriz estimada. Si la conclusión depende de eventos colectivos poco frecuentes, esa aproximación merece una comparación explícita con la predicción que promedia parámetros y particiones plausibles.
El ejemplo permite distinguir tres fuentes de variación (redes distintas bajo parámetros fijos, parámetros inciertos dado el registro y particiones alternativas cuando los grupos no se conocen). Una predicción que usa solo la matriz estimada trata las dos últimas como resueltas. Esa simplificación puede ser útil, siempre que se indique qué incertidumbre deja fuera.
186.4. Bloques que representan comunidades o papeles
Un modelo de bloques describe comunidades asortativas cuando las probabilidades internas son altas frente a las cruzadas. Si las probabilidades internas son pequeñas y las cruzadas grandes, el modelo describe una organización bipartita o heterofílica. Si un grupo conecta intensamente consigo mismo y con otro que tiene pocas relaciones internas, aparece un patrón de núcleo-periferia.
La pertenencia a un mismo bloque significa que los nodos comparten un perfil probabilístico de conexión, aunque no estén directamente conectados entre sí. Dos proveedores que atienden a los mismos tipos de clientes pueden ocupar un papel semejante sin relacionarse. Un algoritmo que solo busca grupos internamente densos puede separar esos nodos; un modelo de papeles los reúne por sus patrones de interacción.
En redes dirigidas, la matriz de probabilidades puede ser asimétrica, de modo que un bloque envíe conexiones hacia otro sin recibirlas. Esto permite representar emisores, intermediarios y receptores bajo una distribución estática. Los nombres funcionales deben apoyarse en el significado de las aristas; la asimetría matemática es insuficiente para atribuir autoridad, dependencia o transferencia de recursos.
Los modelos con pertenencia mixta permiten que un nodo participe en varios grupos. Por ejemplo, una persona puede colaborar como miembro de una disciplina en unas relaciones y como parte de una organización en otras. La asignación única resume esas participaciones en una sola etiqueta y puede ser demasiado rígida. La extensión mixta añade flexibilidad y exige más información para distinguir sus componentes.
Una jerarquía permite agrupar bloques en niveles superiores. Puede representar departamentos dentro de instituciones o subdivisiones de una arquitectura mayor. La jerarquía inferida no tiene por qué coincidir con una organización administrativa. Puede expresar regularidades de conexión que cortan las categorías conocidas o que aparecen solo a cierta escala. La comparación con atributos externos ayuda a interpretar el resultado sin imponerlos retrospectivamente.
Peixoto (2014) desarrolla modelos jerárquicos y criterios de selección que permiten evaluar estructuras a varias resoluciones. Aquí interesa que aumentar el número de bloques debe justificarse por la información que añade. Una jerarquía muy detallada puede describir cada particularidad de la muestra y predecir peor nuevas observaciones.
La elección del modelo debe empezar por decidir qué patrones se consideran plausibles. Si solo se permite organización asortativa, un resultado de comunidades es parcialmente consecuencia de esa restricción. Permitir matrices más generales amplía las alternativas y obliga a comparar qué estructura apoyan los datos. La flexibilidad es útil cuando está acompañada de un criterio que penaliza explicaciones innecesariamente complejas.
186.5. Separar actividad individual y organización de grupos
El modelo básico puede confundir heterogeneidad de grados con pertenencia estructural. Imaginemos dos comunidades reales, cada una con nodos muy activos y otros poco conectados. Una partición estimada podría agrupar los nodos de grado alto entre sí y los de grado bajo aparte, porque esa división explica fácilmente sus grados. El resultado reflejaría entonces la actividad de los nodos y ocultaría la organización entre comunidades que interesaba estudiar.
Karrer y Newman (2011) amplían el modelo de bloques con una corrección de grado. La idea es asignar a cada nodo una propensión individual y mantener parámetros que describen el patrón entre grupos. Así, dos integrantes de un mismo bloque pueden tener grados muy diferentes sin que el modelo deba separarlos solo por ese motivo.
Una versión binaria puede expresarse mediante probabilidades logísticas
Los parámetros miden la actividad individual y , las preferencias de conexión entre bloques. Esta es una formulación binaria posible; otras variantes usan distribuciones de Poisson o restricciones exactas sobre grados y conteos. No deben mezclarse sus verosimilitudes ni sus interpretaciones de multiplicidad.
La parametrización necesita restricciones de identificación. Aumentar todas las propensiones de un grupo y compensar el cambio en los parámetros de sus bloques puede dejar iguales las probabilidades. Una convención, como centrar las propensiones dentro de cada grupo, elimina parte de esa redundancia. Las restricciones fijan una escala de representación sin añadir evidencia nueva sobre la red.
La corrección de grado cambia la pregunta de inferencia. El modelo busca organización que permanece después de acomodar la heterogeneidad individual. Puede revelar una partición que el modelo básico confundía con niveles de actividad. También puede absorber una parte de la señal que tenía interés sustantivo si la actividad era precisamente el mecanismo que se quería explicar. La elección depende del objetivo; ninguna de las dos versiones es superior en todos los casos.
Conviene examinar qué propiedades quedan reproducidas casi por construcción. Si se ajustan grados esperados, acertar la distribución de grados añade poca evidencia. Resultan más informativos patrones de mezcla, triángulos, rutas o conexiones entre regiones que el modelo no haya fijado explícitamente. La comprobación debe incluir las características pertinentes al uso previsto, también las que la parametrización no favorece.
Una red muy pequeña puede no contener información suficiente para estimar simultáneamente muchas propensiones, grupos y probabilidades. La regularización, las distribuciones previas y la reducción de complejidad ayudan a expresar esa limitación, aunque no crean observaciones. Si varias especificaciones producen predicciones semejantes, puede ser más razonable conservar esa incertidumbre que atribuir a cada nodo un papel definitivo.
186.6. Posiciones latentes e invariancias de la representación
Otra familia de modelos asigna a cada nodo una posición latente en un espacio de pocas dimensiones. La probabilidad de conexión disminuye con la distancia entre posiciones, quizá modificada por atributos y propensiones individuales. La geometría resume afinidades que no necesariamente corresponden a una ubicación física observada.
Un ejemplo usa . Si todos los puntos se trasladan, rotan o reflejan simultáneamente, las distancias y las probabilidades permanecen iguales. Por tanto, las coordenadas absolutas no son identificables a partir de los enlaces. Interpretar el eje horizontal como una característica sustantiva requiere información externa o una convención adicional.
La misma dificultad aparece con las etiquetas de bloques. Intercambiar los nombres de dos grupos y permutar la matriz de probabilidades produce exactamente el mismo modelo. Al comparar ejecuciones hay que alinear etiquetas o usar cantidades invariantes, como la probabilidad de que dos nodos pertenezcan al mismo grupo. Un cambio de color en una figura no demuestra que la organización inferida haya cambiado.
La dimensión del espacio latente controla la flexibilidad. Un plano puede dar una representación clara y omitir relaciones que requieren más dimensiones. Aumentarlas facilita aproximar patrones, pero puede hacer difícil interpretar la geometría y favorecer el sobreajuste. La elección debe evaluarse con predicciones y criterios de complejidad, que informan más que la apariencia del mapa.
Los modelos por distancia tienden a representar transitividad; si dos nodos están próximos a un tercero, sus posiciones quedan restringidas y pueden estar próximos entre sí. Los modelos de bloques permiten otros perfiles, como conexiones intensas entre grupos que apenas se relacionan internamente. Ninguna familia contiene automáticamente toda arquitectura posible. La comparación debe considerar qué regularidad pretende capturar cada una.
Una posición latente puede integrar varias causas omitidas (intereses, instituciones, oportunidades y sesgos de observación). Un buen ajuste no permite descomponerlas. Si después se encuentra una correlación entre un eje alineado y un atributo conocido, esa relación ayuda a interpretar la representación, aunque no es una explicación causal de los enlaces.
Aparte de las invariancias geométricas conocidas, puede haber varias configuraciones latentes muy diferentes con probabilidades de enlace similares. Mostrar una sola disposición como si fuera una medición precisa oculta esa posibilidad. Pueden compararse distancias posteriores, agrupaciones estables o predicciones compartidas entre configuraciones, que suelen ser más defendibles que cada coordenada aislada.
186.7. Inferir grupos y reconocer límites de detectabilidad
Cuando las etiquetas no se conocen, la inferencia debe explorar particiones y parámetros. La cantidad de asignaciones crece rápidamente con el número de nodos. Se usan aproximaciones, búsquedas locales o procedimientos probabilísticos para encontrar regiones de alta verosimilitud o probabilidad posterior. Distintas inicializaciones pueden llegar a soluciones diferentes sin que ninguna sea un error de programación.
Una diferencia entre soluciones puede reflejar dificultades del algoritmo, pero también ambigüedad real de los datos. Si las probabilidades internas y cruzadas son casi iguales, los enlaces contienen poca información sobre las etiquetas. Un programa siempre puede devolver colores; esos colores no garantizan que exista una clasificación recuperable con precisión.
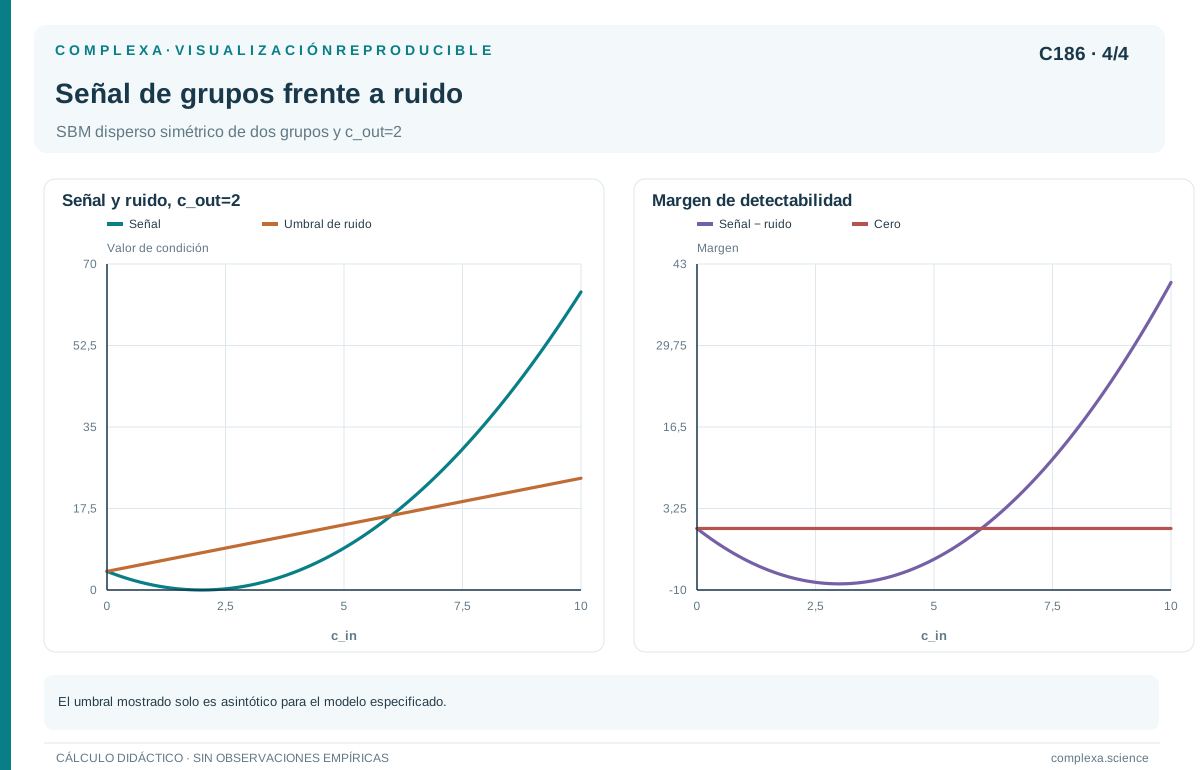
El modelo simétrico de dos grupos de igual tamaño es especialmente ilustrativo. En el régimen disperso, definamos probabilidades internas y cruzadas , con parámetros constantes al crecer . El grado medio tiende a . La recuperación parcial de las etiquetas depende de que se cumpla la condición
Esta expresión corresponde a ese modelo equilibrado, disperso y de dos grupos, sin ser un criterio universal para redes modulares. La recuperación parcial significa superar el azar en una fracción de etiquetas, después de permitir la permutación de nombres; puede dejar pertenencias mal asignadas.
Con parámetros ocho y dos, la diferencia cuadrática vale treinta y seis y el término de ruido, veinte. Con cuatro y dos, los valores son cuatro y doce. En el segundo caso hay mayor probabilidad interna que cruzada, pero la señal puede ser insuficiente para recuperar la partición desde una sola realización en el límite considerado. La existencia de grupos en el generador no garantiza que los datos permitan descubrirlos.
Decelle y colaboradores (2011) analizan estas transiciones de inferencia y el desempeño de los algoritmos. Para una aplicación empírica, sus resultados aconsejan distinguir estructura asumida, información disponible y desempeño computacional. Aumentar el esfuerzo de optimización no resuelve una ausencia de información. Incorporar atributos externos puede ayudar, aunque entonces la inferencia usa más que la topología observada.
Las redes finitas añaden fluctuaciones y los datos reales pueden incumplir el equilibrio de tamaños, la independencia condicional o la dispersión homogénea. El umbral teórico es útil para entender un mecanismo de pérdida de información y diseñar pruebas en datos sintéticos. Trasladarlo numéricamente a un sistema diferente requiere justificar la correspondencia entre sus parámetros y el modelo analizado.
El artículo de 2011 obtiene ese criterio mediante el método de cavidad y el análisis de estabilidad de un procedimiento de inferencia. Sus argumentos de física estadística no son una demostración rigurosa completa. La fórmula tampoco conserva su interpretación al cambiar libremente tamaños o grados medios de los grupos; si estos últimos difieren, el grado de un nodo ya puede aportar información sobre su pertenencia. Es necesario revisar el modelo antes de declarar una fase sin información detectable.
186.8. Comparar ajuste, complejidad y predicción
Si se permite asignar una probabilidad independiente a cada pareja, puede ajustarse una red observada casi perfectamente, con uno para los enlaces presentes y cero para los ausentes. Esa descripción se limita a almacenar el registro. Su capacidad predictiva sobre nuevos datos puede ser escasa. La comparación de modelos necesita valorar cuánto mejora el ajuste y cuánta flexibilidad se usó para conseguirlo.
El principio de longitud mínima de descripción expresa ese intercambio como la suma del costo de describir el modelo y el de describir los datos dados sus parámetros. Una estructura de bloques es útil si comprime regularidades suficientes para compensar la información necesaria para especificarla. Las formulaciones concretas dependen del conjunto de modelos y de cómo se codifican sus componentes.
La inferencia bayesiana integra la incertidumbre de parámetros y compara modelos mediante sus probabilidades y distribuciones previas. Esas elecciones influyen especialmente cuando hay pocos datos o muchas particiones posibles. Otros criterios aproximados pueden ser útiles, pero sus supuestos deben revisarse en modelos latentes y redes dispersas. Aplicar mecánicamente una penalización diseñada para observaciones independientes no garantiza una selección adecuada.
La evaluación predictiva puede reservar parejas de nodos y calcular la probabilidad asignada a sus enlaces o ausencias. Las parejas reservadas deben tratarse como no observadas durante el ajuste. Convertir todos sus enlaces ocultos en ceros informa al modelo de ausencias falsas y cambia la tarea. La máscara de observación es parte del procedimiento.
En redes dispersas, las ausencias dominan numéricamente. Un predictor que asigna probabilidades muy pequeñas a todas las parejas puede acertar una gran proporción de estados binarios y ser inútil para localizar conexiones. Conviene usar puntuaciones probabilísticas y medidas sensibles a la tarea e indicar cómo se muestrearon los pares negativos. Cambiar su proporción en la evaluación modifica la interpretación de varios indicadores.
Reservar enlaces entre nodos ya conocidos evalúa una forma de interpolación. Predecir conexiones de nodos nuevos, de otra región o de un período futuro plantea problemas distintos. Un modelo con muchos parámetros individuales puede rendir bien en la primera tarea y carecer de información para la segunda. El diseño de validación debe corresponder al uso que se pretende dar a la red generada.
Las comprobaciones predictivas pueden examinar también triángulos, distancias y distribución de componentes. Si el modelo reproduce enlaces individuales y falla en esas propiedades, quizá omite dependencias colectivas relevantes. Los resúmenes deben elegirse por su importancia científica, sin seleccionar después solo aquellos que el modelo ya reproduce bien.
186.9. Una organización latente no equivale a un mecanismo demostrado
Supongamos que un modelo de bloques identifica dos grupos con conexiones internas intensas. Una explicación posible es que sus integrantes prefieran relacionarse entre sí. Otra es que compartan espacios de trabajo separados. Una tercera combina oportunidades y mantenimiento diferencial de relaciones. El mismo patrón estático puede ser compatible con todas ellas.
El modelo generativo establece cómo se distribuyen redes bajo sus parámetros, pero la interpretación histórica necesita evidencia sobre formación y transformación de enlaces. Observar eventos en el tiempo, medir oportunidades o intervenir sobre condiciones de contacto puede discriminar mecanismos. Una buena reproducción de la matriz final no reemplaza esas observaciones.
La organización latente puede, aun así, ser útil para predecir o resumir. Un bloque puede ayudar a anticipar enlaces faltantes sin corresponder a una categoría conocida. Su valor debe evaluarse según esa finalidad. Exigir que toda variable latente tenga una interpretación causal inmediata es innecesario; atribuírsela sin evidencia es igualmente problemático.
Los datos ausentes pueden producir grupos aparentes. Si un instrumento registra bien relaciones dentro de ciertas instituciones y mal entre ellas, el modelo puede inferir bloques que reflejan la cobertura del instrumento. Hay que distinguir la ausencia observada de la pareja no medida. También conviene examinar si las particiones se alinean con cambios de instrumento, períodos de registro o fuentes de información.
La confusión puede escribirse como otro modelo generativo. Sea el enlace real y un indicador de detección; el registro contiene . Si, dados los grupos, la detección es independiente del enlace, la probabilidad observada es el producto de la probabilidad real y la de detección. Una red con probabilidad real cuatro décimos para todas las parejas, detección completa dentro de grupos y detección de un cuarto entre grupos produce probabilidades observadas cuatro décimos y una décima. El registro parece modular aunque la formación de enlaces no lo sea.
Sin información adicional, estimar ese producto no separa sus factores. Registrar qué parejas fueron efectivamente observadas, repetir mediciones o calibrar la detección permite formular otras comparaciones. Incorporar el proceso de observación cambia las predicciones que se atribuyen a la organización latente.
Un análisis sólido conserva alternativas razonables. Si un modelo con corrección de grado y otro con posiciones latentes explican las mismas regularidades, la comparación puede revelar qué predicciones los separan. La incertidumbre sobre la arquitectura latente es parte del resultado. Forzar una única narrativa a partir de una partición precisa en apariencia puede ocultar que los datos no distinguen las explicaciones disponibles.
186.10. De una red ajustada a una conclusión evaluable
El ejemplo de ocho nodos permite seguir todas las etapas. Se fijaron grupos y se contaron oportunidades y enlaces para estimar las probabilidades. El modelo reprodujo los conteos usados en el ajuste y produjo una predicción adicional sobre triángulos. Esa predicción tendría que compararse con su distribución y con la red concreta e incorporar la incertidumbre de parámetros si se quiere una evaluación completa.
Si los grupos fueran desconocidos, habría que añadir la búsqueda de particiones y reconocer equivalencias por cambio de etiquetas. Si los grados fueran muy heterogéneos, una corrección de grado podría mejorar la representación. Si las conexiones dependieran principalmente de la distancia, un modelo de posiciones latentes daría otra explicación. Cada extensión modifica qué regularidad se atribuye a los bloques.
La conclusión debería identificar qué aspectos reproduce el modelo, cuáles quedan fuera y para qué uso fue evaluado. Puede afirmarse que cierta estructura mejora predicciones de enlaces o resume patrones por encima de una referencia más simple. Atribuirle preferencias, funciones o causas requiere conectar los parámetros con observaciones adicionales del sistema.
Un modelo generativo es científicamente útil cuando permite formular resultados que podrían no cumplirse. La arquitectura latente adquiere contenido al restringir las redes posibles y producir diferencias observables frente a alternativas. Esa exigencia mantiene separadas la capacidad de dibujar grupos, la de ajustar una realización y la evidencia de que una organización propuesta ayuda a entender el fenómeno.
La reproducibilidad de estas comparaciones exige conservar las restricciones del modelo, las parejas observadas y los criterios usados para escoger su complejidad.
Referencias
Decelle, A., Krzakala, F., Moore, C. y Zdeborová, L. (2011). Asymptotic analysis of the stochastic block model for modular networks and its algorithmic applications. Physical Review E, 84, 066106. DOI.
Holland, P. W., Laskey, K. B. y Leinhardt, S. (1983). Stochastic blockmodels: First steps. Social Networks, 5(2), 109–137. DOI.
Karrer, B. y Newman, M. E. J. (2011). Stochastic blockmodels and community structure in networks. Physical Review E, 83, 016107. DOI.
Peixoto, T. P. (2014). Hierarchical block structures and high-resolution model selection in large networks. Physical Review X, 4, 011047. DOI.