COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 19. Arquitecturas de redes y modelos generativos
189.1. Una recta aparente no es una prueba
Una ley de potencia relaciona la frecuencia de un valor con una potencia de ese valor. En el estudio de redes suele proponerse que la probabilidad de grado disminuye aproximadamente como por encima de cierto umbral. La forma resulta atractiva porque permite representar una población con muchos nodos poco conectados y algunos nodos de grado muy elevado. También conecta con mecanismos de crecimiento como los del capítulo anterior.
La representación habitual usa escalas logarítmicas en ambos ejes. Si una función es exactamente proporcional a una potencia, su logaritmo es una función lineal del logaritmo del argumento. El problema aparece al invertir el razonamiento, porque un tramo aproximadamente recto no demuestra que la distribución generadora sea una ley de potencia.
Distribuciones lognormales, exponenciales estiradas y mezclas de poblaciones pueden producir segmentos visualmente parecidos en rangos limitados. La escasez de observaciones extremas añade fluctuaciones, mientras que la elección de intervalos del histograma puede suavizarlas o exagerarlas. La visión humana detecta alineaciones con facilidad y suele ignorar cuánto cambiaría el gráfico con otra representación.
Una evaluación completa debe separar tres tareas. Primero se estiman el modelo y el rango donde se propone que funciona. Después se examina si el ajuste es compatible con los datos bajo un procedimiento estadístico definido. Finalmente se compara el modelo con explicaciones alternativas. Un modelo puede superar la segunda tarea y perder en la tercera; también puede ser el mejor de un conjunto inadecuado y seguir ajustando mal.
Clauset, Shalizi y Newman (2009) sistematizaron un enfoque que combina máxima verosimilitud, elección de umbral, pruebas de ajuste y comparaciones de verosimilitud. Su trabajo es una referencia básica, pero aplicarlo exige considerar el tipo de variable y el mecanismo de muestreo. Los grados de una sola red no equivalen automáticamente a observaciones independientes de una distribución.
El propósito de este capítulo es convertir una afirmación gráfica en un argumento verificable. Al terminar, podremos precisar qué significa una cola compatible con potencia, qué incertidumbre acompaña a esa afirmación y por qué su interpretación mecanística necesita evidencia adicional.
189.2. Definir el modelo antes de estimarlo
Para una variable continua y un umbral fijo , una densidad de potencia normalizada puede escribirse como
La condición sobre el exponente garantiza que la integral de la densidad sea uno. La distribución por debajo del umbral queda fuera de esta formulación; podemos describirla por separado o usar un procedimiento semiparamétrico que no le imponga la misma forma.
La cola acumulada es
Su exponente difiere en una unidad del exponente de la densidad. Un estudio que estima pendientes sobre frecuencias y otro que usa probabilidades acumuladas deben convertir correctamente sus parámetros antes de compararlos. Como la cola también se parametriza a veces directamente mediante , la notación debe acompañarse de la fórmula.
Para grados, la variable es discreta. Si el modelo comienza en el entero , la probabilidad normalizada es
donde es la suma de desde el umbral hasta infinito. Sustituir esta normalización por una integral puede ser una aproximación razonable en ciertos regímenes, pero produce errores en grados pequeños. La estimación discreta exacta requiere la suma.
Una red simple de tamaño finito tiene un grado máximo limitado por su número de nodos menos uno. Si ese límite es relevante para el rango observado, podemos usar una distribución truncada superiormente, cuya normalización termina en el máximo admisible. La potencia con corte exponencial, en cambio, introduce una disminución gradual adicional y es un modelo distinto del truncamiento por soporte.
La definición debe especificar además si se estudia grado total, de entrada, de salida o fuerza. Las fuerzas pueden ser continuas o tomar múltiplos discretos según cómo se midan. Cambiar la variable cambia el modelo y sus posibles mecanismos; una distribución amplia de actividad no demuestra que la red binaria tenga una distribución de grados equivalente.
Antes de ajustar, conviene registrar unidades, ceros, límites de detección y redondeos. Los ceros quedan fuera de una potencia definida sobre valores positivos, pero pueden ser una parte sustantiva de la población. Excluirlos sin informar modifica el denominador y puede ocultar aislamiento o ausencia de actividad.
189.3. Máxima verosimilitud y un ejemplo calculado
Para observaciones continuas independientes que superan un umbral conocido, el estimador de máxima verosimilitud tiene la forma sencilla
La fórmula usa todas las observaciones de la cola y respeta la normalización del modelo. Si todos los valores coinciden exactamente con el umbral, el denominador es cero y no existe una estimación finita de esta forma. Esa situación suele señalar discretización extrema, un registro insuficiente o un modelo poco adecuado.
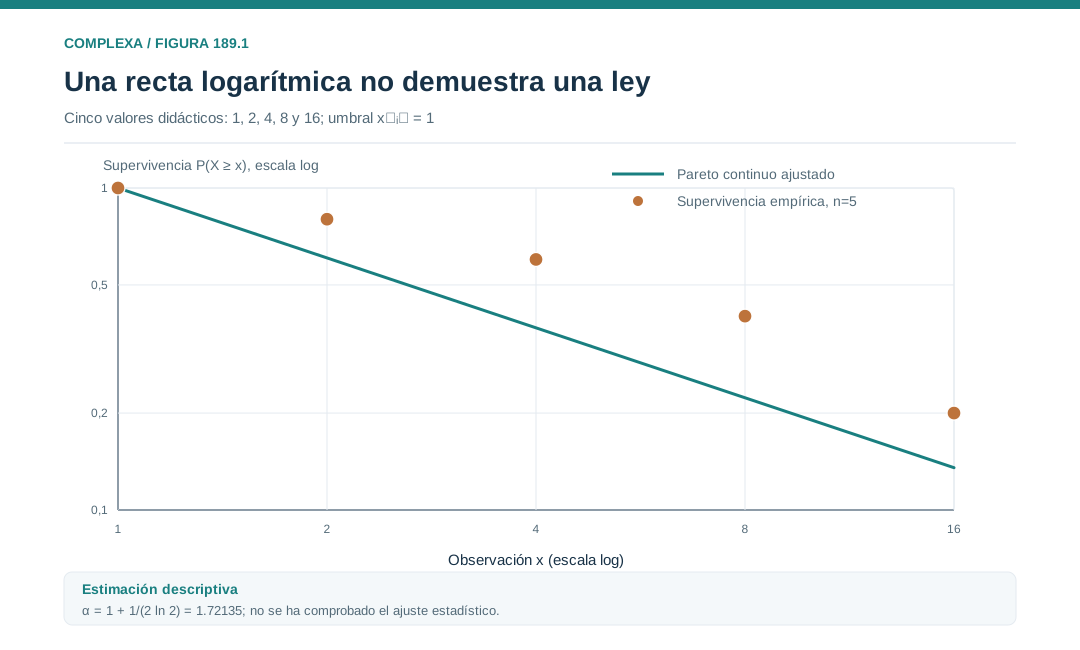
Para comprobar las operaciones, consideremos cinco valores continuos (uno, dos, cuatro, ocho y dieciséis) con umbral uno. No son grados ni una muestra empírica. La suma de logaritmos es diez veces el logaritmo de dos, de modo que
La media muestral es 6,2, perfectamente finita. Sin embargo, el modelo no truncado con ese exponente tiene media teórica infinita. No hay contradicción, porque toda muestra finita contiene valores finitos, mientras que la esperanza del modelo integra posibilidades arbitrariamente grandes. Con solo cinco observaciones no sería razonable convertir esa propiedad del modelo ajustado en una conclusión sólida sobre una población.
Si cambiamos el umbral a dos, quedan cuatro observaciones y la estimación pasa a aproximadamente 1,96180. Hemos cambiado a la vez el rango y la muestra usada. La diferencia ilustra por qué el exponente debe comunicarse junto con el umbral y el número de observaciones de cola; una cifra aislada con varios decimales oculta decisiones que pueden modificarla mucho.
En el caso discreto, la log-verosimilitud, que contiene el término de normalización de la zeta, es
El estimador se obtiene por optimización numérica. Existe una aproximación que reemplaza el umbral por en una fórmula semejante a la continua, pero su precisión depende del rango. Para grados bajos o decisiones sensibles al exponente, conviene usar la verosimilitud discreta.
La incertidumbre puede estimarse mediante métodos asintóticos, perfiles de verosimilitud o remuestreo compatible con el diseño. Los intervalos condicionados a un umbral fijo suelen ser más estrechos que los que incorporan la selección del umbral. Si este se eligió con los mismos datos, la evaluación debe reflejar esa decisión.
Las condiciones de existencia de momentos también se deducen de la densidad. Para el momento de orden positivo r, el integrando de la cola es proporcional a una potencia cuyo exponente es r menos alfa. La integral converge solo cuando alfa supera r más uno. En particular, la media requiere alfa mayor que dos y el segundo momento, alfa mayor que tres. En los valores frontera aparece una divergencia logarítmica. Estas propiedades pertenecen al modelo ideal sin límite superior; un corte físico cambia las integrales y puede volver finitos todos los momentos.
Al comunicar consecuencias, un intervalo de incertidumbre del exponente que atraviesa dos no permite clasificar con firmeza la media del modelo como finita o infinita. La incertidumbre sobre la familia distributiva puede ser, además, mayor que la del parámetro dentro de una sola familia. La revisión debe conservar ambos niveles, sobre todo si la aplicación depende de la frecuencia de valores muy grandes.
189.4. Elegir el comienzo de la cola
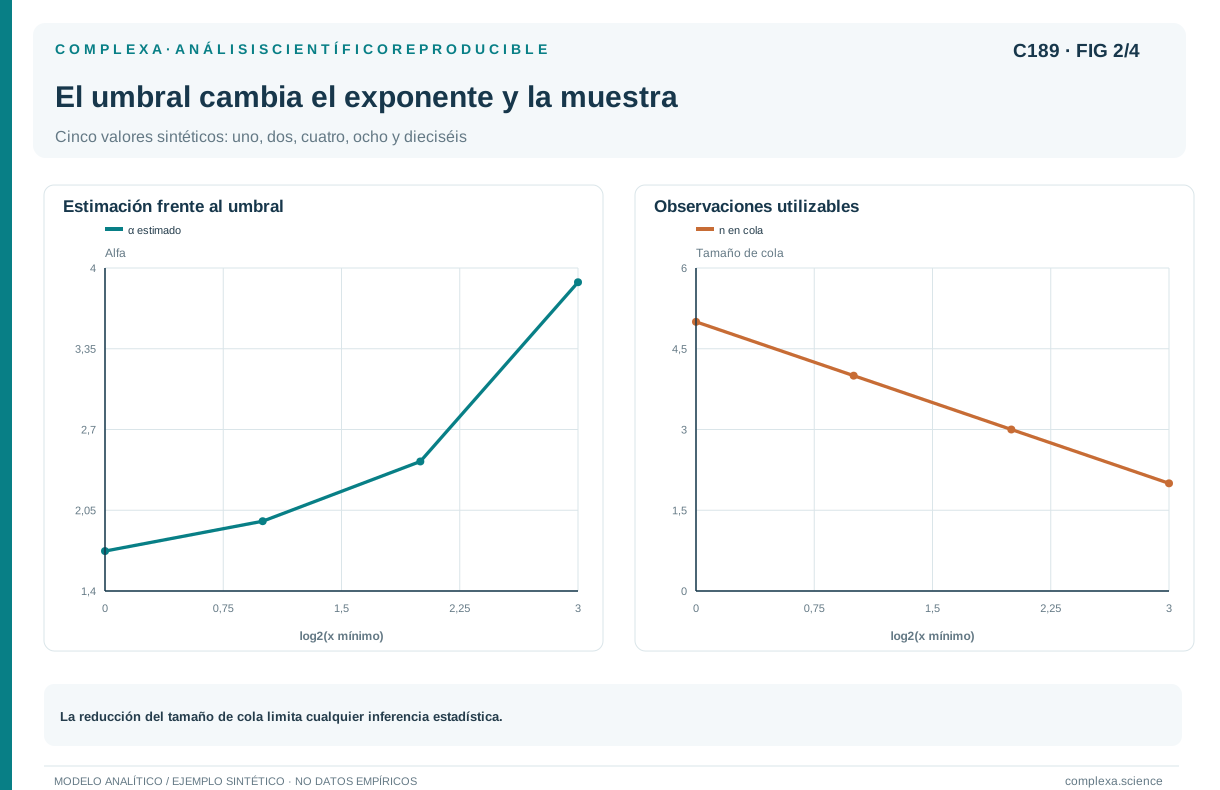
Una ley de potencia puede describir solo una fracción superior de la distribución. Incluir valores demasiado pequeños introduce regiones donde el mecanismo o la forma distributiva son distintos, mientras que elevar demasiado el umbral deja pocas observaciones y aumenta la incertidumbre.
Un procedimiento conocido estima el exponente para varios umbrales candidatos y calcula la distancia de Kolmogórov–Smirnov entre la distribución empírica de la cola y el modelo ajustado. Se elige el umbral que minimiza esa distancia, sujeto a restricciones de tamaño de muestra definidas de antemano. La distancia mide la mayor diferencia entre funciones de distribución acumulada.
El resultado depende del conjunto de candidatos y de las restricciones. Permitir colas con muy pocos datos puede producir ajustes aparentemente buenos sin capacidad para distinguir modelos. Un mínimo razonable debe justificarse según el objetivo y acompañarse de análisis de sensibilidad. No existe un número universal que convierta cualquier cola en evidencia suficiente.
La selección del umbral también introduce optimismo, porque entre varias opciones escogemos la que mejor se adapta a las fluctuaciones de la muestra. Por eso las tablas de una prueba que supone parámetros y umbral fijados de antemano no pueden aplicarse sin corrección; las simulaciones de evaluación deben repetir el mismo proceso de estimación y selección.
Es útil mostrar cómo cambian el exponente, el tamaño de cola y la discrepancia al variar el umbral. Una región relativamente estable aporta información diferente de un mínimo aislado. Esa estabilidad no demuestra una potencia, pero ayuda a reconocer si el resultado depende de excluir unas pocas observaciones o de un rango particularmente estrecho.
También debe informarse la amplitud de valores cubierta. Una cola con numerosos datos concentrados entre grados muy cercanos puede distinguir mal formas asintóticas. A la inversa, un rango amplio con poquísimas observaciones extremas puede tener enorme incertidumbre. Tamaño de muestra y rango son dimensiones complementarias.
En algunos problemas existe un umbral sustantivo anterior al análisis, como un límite de detección conocido o el inicio de un régimen operacional. Usarlo evita una fuente de selección estadística y puede simplificar la interpretación, pero no garantiza que la potencia sea adecuada por encima de él.
Cuando se analizan varias redes, elegir cada umbral con un procedimiento diferente dificulta la comparación. Conviene mantener reglas comunes o explicar por qué requieren adaptación, ya que la heterogeneidad de métodos puede producir diferencias de exponentes que no proceden de los sistemas estudiados.
189.5. Una prueba de ajuste mediante simulación
Después de ajustar el modelo calculamos una medida de discrepancia entre los datos y la distribución estimada. Para saber si esa discrepancia es grande necesitamos una referencia, que son los valores obtenidos al generar datos según el modelo y aplicarles el mismo procedimiento de análisis.
En una evaluación semiparamétrica, la parte inferior al umbral puede reproducirse mediante remuestreo empírico y la cola mediante la potencia ajustada. Se generan registros sintéticos del mismo tamaño que combinan ambas partes de la manera elegida. En cada registro se selecciona de nuevo el umbral y se reestima el exponente antes de calcular la discrepancia. Reutilizar los parámetros originales sin reajustar cambia la pregunta y distorsiona la comparación.
El valor de prueba se aproxima por la fracción de discrepancias simuladas al menos tan grandes como la observada. Con un número finito de réplicas puede usarse una corrección de conteo que evite informar un valor cero. En cualquier caso, deben comunicarse el número de simulaciones y el carácter aproximado del procedimiento, sobre todo porque los parámetros se estiman a partir del propio registro.
Un valor pequeño indica que la discrepancia observada es difícil de conciliar con el modelo y el procedimiento simulador. Un valor grande indica que esa prueba no ha detectado una incompatibilidad suficiente. El valor de prueba no es la probabilidad de que la ley de potencia sea verdadera ni la proporción de mecanismos posibles que la apoyan.
Con pocas observaciones de cola la prueba tiene poca potencia estadística; distribuciones muy diferentes pueden superarla porque el registro no contiene información suficiente para distinguirlas. La conclusión debe recoger esa limitación, ya que no rechazar un modelo no compensa una cola de tamaño mínimo.
El resultado depende también de la discrepancia elegida. La distancia de Kolmogórov–Smirnov enfatiza la mayor separación acumulada y puede ser poco sensible a algunas diferencias en extremos muy raros. Otras medidas ponderan de otra forma las regiones de la distribución. Elegir una medida después de ver cuál favorece al modelo añade otra selección que debería incorporarse a la evaluación.
La simulación debe representar el soporte correcto. Si se trabaja con grados enteros, generar datos continuos y redondearlos puede introducir una distribución distinta de la propuesta. Si existe un máximo por tamaño de red, debe decidirse si el contraste condiciona a ese límite o usa una aproximación no truncada. La decisión afecta a la estimación y a la referencia de la prueba.
Un informe reproducible conserva los datos procesados, el criterio de selección del umbral, el generador de réplicas y las semillas aleatorias. Con estos elementos puede revisarse la evidencia sin depender de la apariencia de una figura.
189.6. Comparar con distribuciones alternativas
Una potencia puede ser compatible con los datos y, aun así, recibir menos apoyo que una lognormal o una potencia con corte. La comparación exige ajustar cada alternativa sobre el mismo conjunto de observaciones y con la normalización que corresponde al mismo soporte. Comparar verosimilitudes calculadas sobre colas de distinto tamaño sin corregir esa diferencia carece de una interpretación directa.
Para dos modelos ajustados a las mismas observaciones, la razón logarítmica, que suma las diferencias entre log-probabilidades, es
El signo indica qué modelo asigna mayor probabilidad conjunta a esos datos bajo el ajuste. La magnitud necesita una evaluación de incertidumbre y, según la comparación, una corrección o criterio por complejidad. Un valor positivo pequeño puede deberse a fluctuaciones.
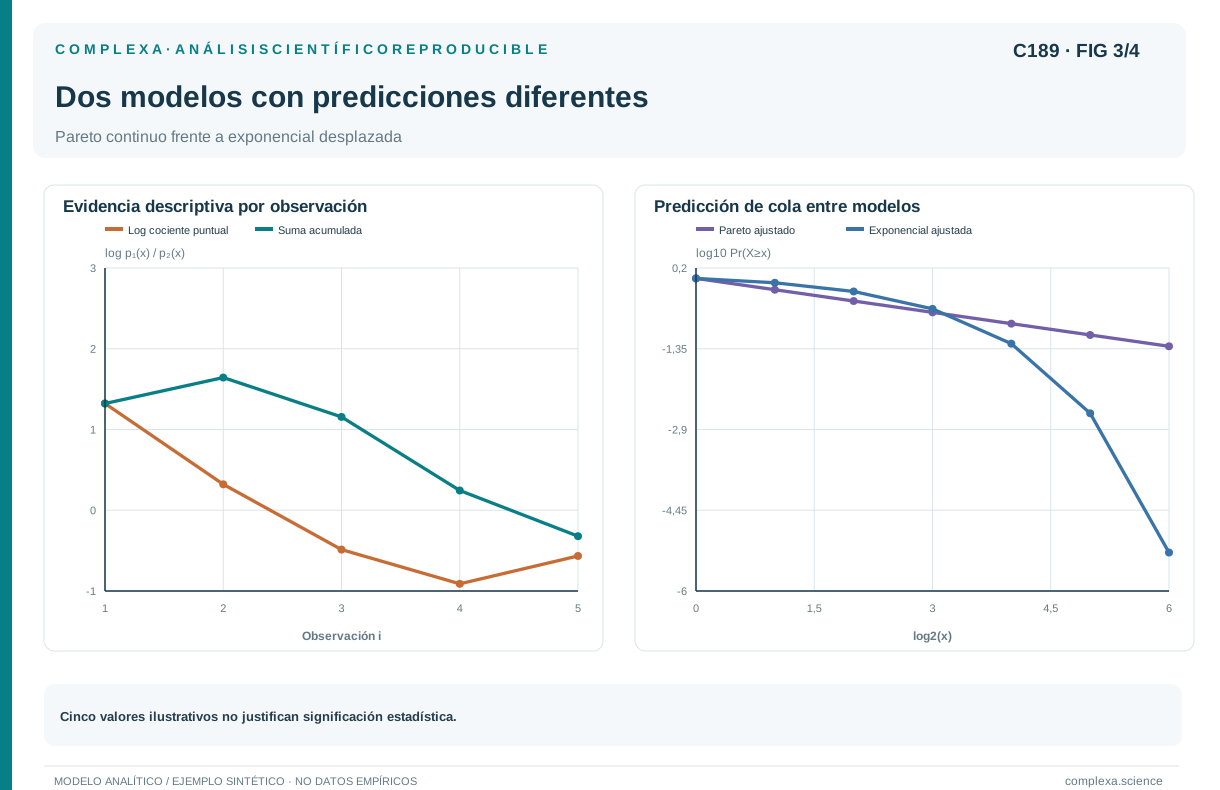
En el ejercicio de cinco valores podemos comparar la potencia continua con una exponencial desplazada cuyo soporte comienza en uno. La tasa de máxima verosimilitud de esta última es el inverso de la media de , aproximadamente 0,19231. La comparación puede calcularse exactamente, pero cinco observaciones elegidas artificialmente no sostienen una conclusión estadística sobre qué familia describe una población.
Las predicciones de cola difieren. La potencia ajustada asigna una probabilidad aproximada de 0,13534 a un valor de al menos dieciséis; la exponencial desplazada, de aproximadamente 0,05588. Ambas pueden dar probabilidad positiva a todos los valores del ejercicio y, sin embargo, anticipar frecuencias muy distintas de eventos futuros grandes. Esa diferencia predictiva es parte central de la comparación.
Las pruebas para modelos no anidados requieren condiciones que deben revisarse, entre ellas la forma de dependencia de las observaciones y la regularidad de la varianza de las diferencias. Los modelos anidados presentan otro problema. Una potencia sin corte puede aparecer como caso límite de una potencia con corte exponencial, con el parámetro del corte situado en una frontera. En ese caso no corresponde aplicar automáticamente cualquier distribución de referencia habitual.
La predicción fuera de muestra es otra alternativa, pero requiere suficientes datos y un reparto compatible con el problema. En redes temporales, reservar observaciones posteriores puede evaluar si la distribución se mantiene. En una única red, dividir grados aleatoriamente no elimina sus dependencias estructurales.
También podemos usar criterios de información o modelos bayesianos, siempre que se comuniquen sus supuestos. Ninguno transforma una colección incompleta de alternativas en una búsqueda exhaustiva. El mejor modelo de un conjunto puede omitir una mezcla de poblaciones, un límite de capacidad o un sesgo de registro.
La conclusión debe distinguir preferencia, equivalencia práctica e incertidumbre, de acuerdo con la capacidad real de discriminación del registro. Si varios modelos describen de manera similar el rango observado, es razonable conservarlos como explicaciones compatibles.
La diferencia de log-verosimilitud en el ejemplo es pequeña, de aproximadamente menos 0,321 al restar la exponencial a la potencia. La exponencial ajustada asigna mayor verosimilitud al conjunto, pero con cinco valores elegidos artificialmente, que no son una muestra aleatoria de ninguna población, esa ventaja numérica no es concluyente. El cálculo solo enseña el procedimiento de comparación.
La extrapolación hace más visibles las diferencias. Por encima del máximo observado, la cola de la potencia decae mucho más lentamente que la de la exponencial. Esa divergencia puede dominar una decisión sobre eventos raros aunque ambos modelos describan de forma parecida una región central. Cuanto más lejos se extrapola, más pesan los supuestos que los datos apenas informan. Por eso conviene mostrar predicciones bajo varias alternativas compatibles, junto con la distancia entre el rango observado y el rango donde se desea decidir.
189.7. Por qué los histogramas logarítmicos pueden engañar
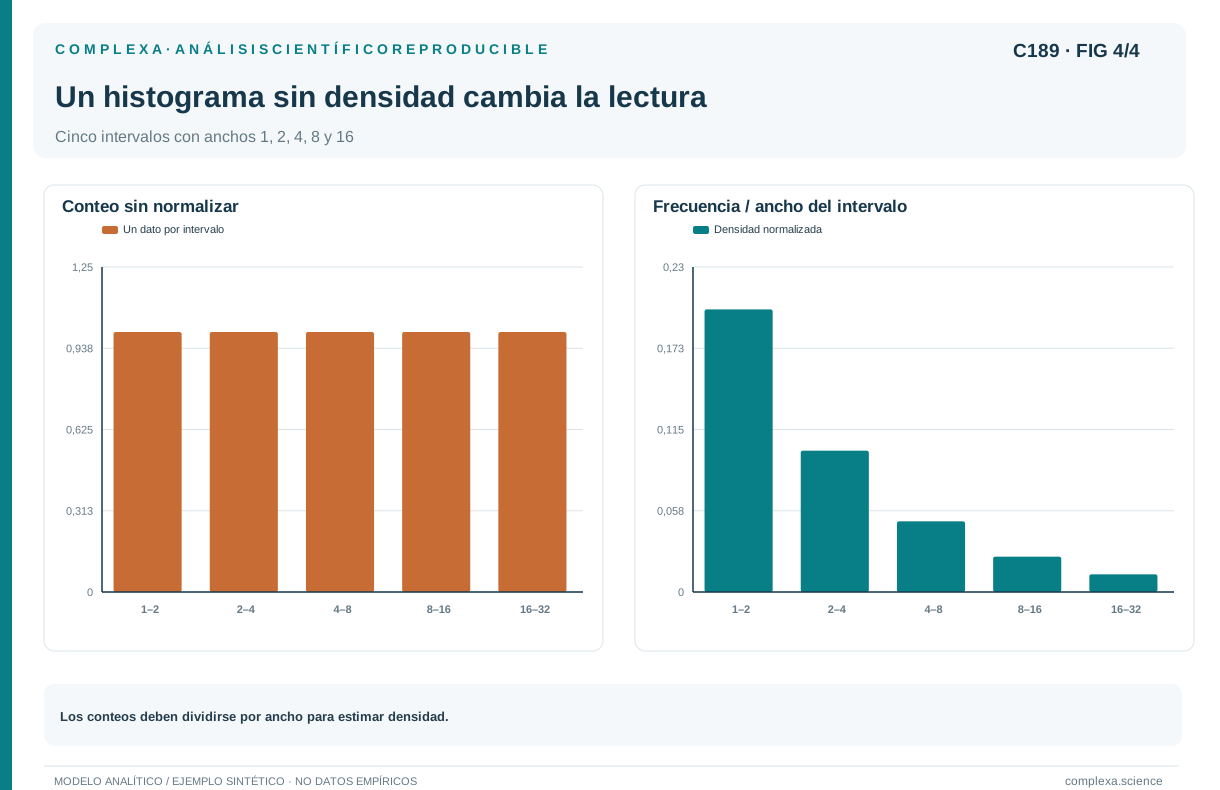
Un histograma agrupa observaciones en intervalos. Si los intervalos tienen anchos distintos, sus alturas deben normalizarse por esos anchos para representar una densidad comparable. En una escala logarítmica, los intervalos suelen ensancharse a medida que aumenta el valor. Graficar conteos sin corregir ese ensanchamiento modifica la pendiente y puede producir un exponente incorrecto.
Los intervalos vacíos añaden dificultades porque el logaritmo de cero no está definido. Eliminarlos selecciona precisamente las regiones donde no aparecieron observaciones. Sustituirlos por una constante arbitraria cambia la forma de la cola. Una regresión sobre los puntos restantes puede presentar una recta muy estable y una incertidumbre artificialmente pequeña.
Los errores de los conteos tampoco tienen varianza constante en la escala logarítmica. Los intervalos extremos suelen contener pocas observaciones y muestran fluctuaciones relativas grandes. Aplicar mínimos cuadrados ordinarios como si cada punto aportara la misma información ignora esa heterogeneidad. Un coeficiente de determinación alto solo mide la alineación en esa representación; la distribución probabilística queda sin validar.
La función acumulada complementaria evita elegir intervalos y suele ser útil para mostrar la cola. Sin embargo, sus puntos son fuertemente dependientes, porque una misma observación contribuye a todos los umbrales inferiores. Tratar cada punto acumulado como un dato independiente en una regresión subestima la incertidumbre.
Una visualización informativa puede mostrar observaciones acumuladas, modelos ajustados y bandas obtenidas mediante un procedimiento adecuado. Debe señalar el umbral y el número de datos que quedan por encima. Si se usa un histograma, conviene declarar la regla de agrupación y normalizar correctamente. Ninguna figura sustituye a la inferencia.
El rango del eje también afecta a la interpretación. Recortar el gráfico justo donde aparece una curvatura puede hacer que una distribución con corte parezca una potencia pura. Incluir todo el rango permite ver qué parte del registro describe el modelo. Si el análisis se limita a una cola, el resto de la distribución debe seguir visible o describirse claramente.
Los redondeos y límites de reporte pueden producir escalones o acumulaciones. Una base que agrupa todos los grados mayores que cierto valor en una categoría superior contiene datos censurados. Asignar a todos ellos el valor del límite los convierte en observaciones exactas ficticias. La verosimilitud debe usar la probabilidad del intervalo o de la cola censurada.
En la práctica, una figura persuasiva debe poder reconstruirse a partir de decisiones explícitas. Si cambiar una convención visual razonable altera la conclusión, hace falta volver al modelo probabilístico y a la información realmente disponible.
189.8. La dependencia entre grados y el muestreo de redes
Los grados de una red comparten restricciones. Su suma es dos veces el número de enlaces en el caso no dirigido; cada enlace modifica simultáneamente dos grados; la secuencia debe ser realizable por un grafo del tipo considerado. En modelos de crecimiento, además, los nodos compiten por enlaces y comparten una historia. Estas dependencias no aparecen en una muestra independiente de una distribución univariada.
Por ello, ajustar una potencia a los grados puede dar una descripción marginal útil, pero una prueba basada en generar grados independientes no reproduce necesariamente la variabilidad del sistema. La dirección y la magnitud del error dependen del modelo y del resumen. Las pruebas habituales pueden seguir siendo útiles, pero debe especificarse cuándo se usan como aproximación.
Una evaluación más cercana al proceso genera redes completas bajo modelos candidatos y aplica a cada una el mismo mecanismo de observación; después compara la distribución de grados y otros resúmenes con el registro. Este enfoque exige elegir modelos de red, pero permite conservar restricciones, dependencias y sesgos de muestreo relevantes.
El muestreo de nodos cambia los grados. Si retenemos una parte de la población y observamos solo los enlaces entre nodos retenidos, cada grado observado cuenta únicamente los vecinos presentes en la muestra. Los nodos de alta conectividad pueden seguir destacando, pero la forma de la distribución no se conserva automáticamente. La ausencia de una potencia clara en la subred tampoco demuestra su ausencia en la red completa.
La observación de enlaces puede depender de su tipo o intensidad. Si los enlaces débiles se pierden con mayor frecuencia, algunos nodos pierden una fracción mayor de sus conexiones. Si el registro comienza desde nodos muy visibles y se expande por sus contactos, los grados altos pueden quedar sobrerrepresentados. Un ajuste sofisticado sobre una muestra sesgada sigue describiendo la muestra, salvo que se modele la selección.
La agregación temporal introduce otra transformación. Sumar contactos durante un año produce grados mayores que observar una semana, pero también mezcla relaciones que nunca coexistieron. La cola puede cambiar con la duración de la ventana, de modo que antes de interpretar diferencias entre sistemas conviene igualar o modelar esos periodos.
En colecciones de varias redes, cada una puede tener tamaño, cobertura y significado de enlace diferentes. Una clasificación general debe conservar esa heterogeneidad y explicar los criterios usados. La frecuencia con que un procedimiento detecta potencias en una colección no equivale directamente a la frecuencia de un mecanismo causal en todos los sistemas posibles.
189.9. Qué significa decir que una red es libre de escala
La expresión «libre de escala» se usa con distintos sentidos. A veces designa una distribución de grados exactamente proporcional a una potencia por encima de un umbral. Otras veces alude a una cola asintótica más amplia, compatible con variación regular, que puede incluir factores que cambian lentamente. También se usa de manera informal para cualquier red con grandes diferencias de grado.
Estas definiciones no son equivalentes. Una distribución puede ser muy heterogénea y tener una escala característica; una cola de variación regular puede no parecer una potencia pura en un rango finito. Antes de evaluar la afirmación, debemos establecer qué propiedad se está proponiendo y qué evidencia puede identificarla en datos limitados.
Broido y Clauset (2019) estudiaron una amplia colección de redes y encontraron que el apoyo fuerte a estructuras libres de escala, según sus criterios estadísticos, era poco frecuente. Su resultado cuestiona la atribución automática de potencias a redes empíricas. La interpretación debe conservar el alcance de la colección, las representaciones analizadas y la definición operacional usada.
Voitalov y colaboradores (2019) examinaron la estimación de colas con herramientas de valores extremos y defendieron una definición asintótica basada en variación regular. Esa diferencia metodológica ayuda a entender por qué procedimientos distintos pueden clasificar de forma diferente los mismos tipos de datos. El debate no se resuelve contando artículos favorables y desfavorables sin revisar qué hipótesis evalúa cada uno.
Una auditoría rigurosa puede plantear por separado si una potencia pura ajusta bien en el rango observado, si otras familias predicen mejor, si hay evidencia de una cola pesada y si un modelo generativo concreto reproduce la estructura. Las respuestas pueden diferir sin contradicción, porque cada pregunta corresponde a una propiedad y a un nivel de explicación.
En una aplicación, conviene evitar que la etiqueta sustituya a los resultados cuantitativos. El exponente, el umbral, el tamaño de cola, el rango cubierto, las alternativas y la incertidumbre permiten evaluar la evidencia. Decir solo «libre de escala» encierra demasiadas decisiones en una expresión ambigua.
A ciertas colas se les atribuyen también consecuencias dinámicas, como cambios en umbrales o en la vulnerabilidad. Esas consecuencias suelen depender de límites de tamaño, correlaciones y supuestos del proceso. Una estimación marginal de grados no autoriza a trasladarlas sin examinar la red y la dinámica específicas.
Las garantías de los estimadores de valores extremos son asintóticas y descansan en condiciones de muestreo y regularidad. No certifican, con una secuencia finita, que su distribución generadora pertenezca a toda la clase de variación regular. Una función que cambia lentamente puede ocultar el régimen de cola durante un rango arbitrariamente largo. Los grados de una red, además, no satisfacen automáticamente los supuestos de independencia usados en muchas demostraciones. La coincidencia entre varios estimadores puede ser evidencia útil dentro de esas limitaciones, aunque una clasificación operacional no equivale a una prueba definitiva de la forma asintótica.
189.10. Redactar una conclusión proporcionada a la evidencia
Una conclusión sólida identifica la variable, el soporte, el umbral y el método de estimación. Informa cuántas observaciones sustentan la cola y qué incertidumbre acompaña al exponente. Después distingue el resultado de la prueba de ajuste del de las comparaciones con alternativas.
Si la potencia es rechazada, conviene describir dónde falla (curvatura sistemática, exceso de valores extremos, corte superior o discrepancia en el comienzo de la cola). Si no se rechaza, la conclusión debe indicar si el registro tenía suficiente información para distinguirla de modelos cercanos. Si una alternativa recibe más apoyo, debe evaluarse también su adecuación.
Los resultados mecanísticos requieren otro paso, ya que una cola compatible con potencia puede ser consecuencia de reglas diferentes. Para atribuirla a conexión preferencial, interesa contrastar eventos de crecimiento, exposición y heterogeneidad de destinos. Para atribuirla a un proceso crítico, hacen falta predicciones propias de ese proceso. La forma distributiva es una parte de la evidencia, de alcance definido.
En redes observadas parcialmente, el informe debe explicar cómo la selección puede alterar los grados y qué análisis de sensibilidad se hizo. Con esa cuestión se cerrará el módulo; una auditoría completa debe integrar la estructura, las decisiones estadísticas y el mecanismo que convirtió relaciones reales en datos disponibles.
Referencias
- Broido, A. D., y Clauset, A. (2019). Scale-free networks are rare. Nature Communications, 10, 1017. DOI.
- Clauset, A., Shalizi, C. R., y Newman, M. E. J. (2009). Power-law distributions in empirical data. SIAM Review, 51(4), 661–703. DOI.
- Voitalov, I., van der Hoorn, P., van der Hofstad, R., y Krioukov, D. (2019). Scale-free networks well done. Physical Review Research, 1, 033034. DOI.