COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 19. Arquitecturas de redes y modelos generativos
188.1. De una distribución observada a un proceso de formación
Una distribución de grados describe cuántos nodos tienen una, dos o muchas conexiones. Sin otra información, esa distribución no dice cómo se formaron los enlaces. Dos redes pueden compartir los mismos grados y diferir en comunidades, distancias, ciclos o capacidad de transporte. También pueden alcanzar una distribución parecida mediante historias distintas. Para estudiar el crecimiento necesitamos especificar qué cambia en cada paso y cómo se eligen los participantes.
Un modelo de crecimiento suele incluir la llegada de nodos, la creación de enlaces y una regla de selección. Puede incorporar además desaparición, envejecimiento o reconexión. Esas operaciones definen oportunidades diferentes, porque recibir conexiones nuevas requiere permanecer disponible, ser visible para quienes llegan y cumplir las restricciones del sistema. La popularidad observada combina el efecto de las reglas con el tiempo durante el que cada nodo ha estado expuesto a ellas.
La conexión preferencial propone que la probabilidad de recibir un enlace aumenta con el número de enlaces que ya se posee. Puede describir una ventaja acumulativa (una página más enlazada es más fácil de encontrar, un trabajo más conocido recibe más atención o una organización con más contactos accede a nuevas oportunidades). Estas interpretaciones son hipótesis sobre procesos concretos; que se describan con la misma fórmula no implica que todos operen mediante un mecanismo idéntico.
Barabási y Albert (1999) mostraron cómo combinar crecimiento y conexión preferencial para producir distribuciones amplias de grados. Su modelo se convirtió en una referencia porque deriva una regularidad colectiva de una regla local sencilla. Para usar esa referencia con rigor debemos distinguir el resultado asintótico, las fluctuaciones de una realización finita y las modificaciones necesarias para representar datos reales.
Este capítulo compara reglas que parecen cercanas y producen colas diferentes. Veremos qué cambia al elegir destinos uniformemente, al introducir una atracción inicial o al modificar la dependencia respecto del grado. Después examinaremos qué observaciones permiten identificar una regla de crecimiento. La pregunta final será qué evidencia respalda el mecanismo, además de la forma del histograma.
188.2. El modelo de conexión preferencial lineal
Partimos de una pequeña red inicial conectada. En cada paso llega un nodo y crea enlaces hacia nodos existentes. El parámetro permanece fijo y la red es no dirigida. La probabilidad de elegir un destino es proporcional a su grado
La definición completa necesita aclarar si los destinos deben ser distintos, si las probabilidades se actualizan después de cada enlace y qué ocurre durante los primeros pasos. Estas variantes pueden afectar propiedades finitas. Cuando la red es grande, en el modelo lineal habitual la suma de grados crece aproximadamente como , porque cada nuevo enlace tiene dos extremos.
Un nodo recién incorporado empieza con grado . Los nodos de grado cero no pueden recibir enlaces bajo la regla puramente proporcional al grado. Por eso la inicialización debe garantizar que los destinos potenciales tengan conexiones, o debe incorporarse otra fuente de atracción. Incluso una regla que se escribe en una sola línea necesita condiciones de operación.
La probabilidad es relativa. Duplicar el grado de un nodo duplica su peso de selección si todo lo demás permanece fijo, pero el denominador también crece a medida que se incorporan enlaces. Un nodo puede aumentar su grado absoluto mientras disminuye su proporción de todas las conexiones. La ventaja acumulativa no implica que cada nodo antiguo capture una fracción constante de los enlaces nuevos.
El número de nodos aumenta aproximadamente en una unidad por paso y el de enlaces, en . Por tanto, el grado medio tiende a . La distribución puede ensancharse y producir nodos de grado muy grande sin que el grado medio diverja con el tamaño de la red. La heterogeneidad y la densificación son propiedades distintas; aquí crece la primera mientras disminuye la densidad de enlaces entre todas las parejas posibles.
El modelo supone que los nuevos nodos pueden elegir entre todos los existentes y que el grado resume su atractivo. No incluye distancia, costos, afinidad temática ni capacidades máximas. En una aplicación, esas omisiones delimitan qué significa el resultado. Si la visibilidad se restringe a un vecindario, la probabilidad global puede ser una consecuencia aproximada de mecanismos locales o puede dejar de describir el proceso.
Cuando , cada nuevo nodo se une mediante un solo enlace. Si la semilla es un árbol, la red sigue siendo un árbol, sin triángulos ni ciclos. Esta propiedad es una predicción independiente de la distribución de grados y servirá para evaluar la suficiencia del mecanismo.
188.3. Cómo aparece el exponente tres
Una aproximación continua reemplaza los incrementos aleatorios por una tasa media. Para un nodo incorporado en el tiempo , la ecuación aproximada es
Con la condición inicial , la solución es
El crecimiento depende de la edad y del grado inicial. A un tiempo fijo, los nodos antiguos tienen mayor grado esperado bajo esta aproximación. Un nodo incorporado en el paso cien alcanza un grado aproximado de diez veces en el paso diez mil. Esto describe una tendencia media, de la que cada realización individual puede apartarse.
Para obtener una distribución, observamos que los tiempos de llegada están repartidos de manera aproximadamente uniforme entre el inicio y el tiempo actual. La condición de que un nodo tenga grado al menos corresponde, en esta descripción determinista, a que haya llegado suficientemente pronto
Al derivar esta cola acumulada respecto de se obtiene una densidad proporcional a . El exponente de la probabilidad por grado es tres; el de la cola acumulada es dos. Si se confunden, aparecen discrepancias aparentes entre estudios que representan cantidades diferentes.
La derivación explica el origen del resultado, pero usa varias aproximaciones. Trata el tiempo y el grado como variables continuas, sustituye trayectorias aleatorias por una trayectoria representativa y descuida los detalles de la semilla. Por ello, su coeficiente no coincide exactamente con el de la solución discreta, sobre todo en grados pequeños. Es más fiable para comprender la escala que para calcular cada frecuencia.
La red finita también impone un corte. En un grafo simple, el grado no puede superar el número de otros nodos. En el modelo lineal, el grado máximo tiene una escala característica que crece aproximadamente como la raíz del tamaño, con fluctuaciones y dependencia de la inicialización. No cabe esperar una recta perfecta que se extienda indefinidamente en una representación logarítmica.
El exponente tres es una predicción de un conjunto de supuestos. Si el ajuste empírico produce otro valor, puede indicar una modificación del mecanismo, un efecto de tamaño, un sesgo de observación o una estimación inadecuada. Si produce un valor cercano a tres, todavía hay que comparar explicaciones alternativas.
La misma aproximación permite distinguir crecimiento absoluto y concentración relativa. Para un nodo con tiempo de llegada fijo, el grado crece como la raíz del tiempo, mientras el total de grados crece proporcionalmente al tiempo. Su fracción del total disminuye, por tanto, como el inverso de la raíz del tiempo. El nodo puede seguir acumulando enlaces y conservar una posición destacada sin apropiarse de una proporción positiva del total en el límite. Esa propiedad separa el modelo lineal básico de una condensación macroscópica. En una red finita, observar un gran concentrador exige examinar cómo evoluciona su cuota al aumentar el sistema, además de su grado absoluto.
188.4. La distribución discreta y sus comprobaciones
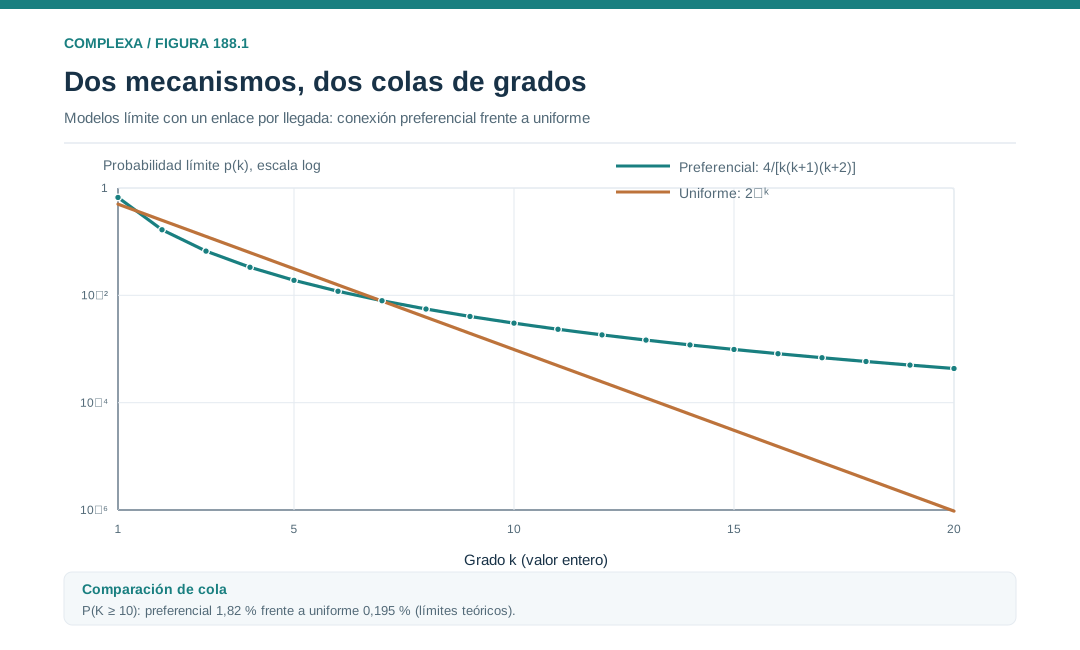
Podemos mejorar la aproximación siguiendo el número esperado de nodos con grado . En cada paso entran nodos de grado , algunos nodos de grado pasan a grado y algunos de grado pasan a grado . En el régimen asintótico, la ecuación de balance del modelo lineal conduce a una recurrencia para las proporciones
La solución estacionaria en proporciones, para , es
Es una distribución límite del modelo; una red finita no tiene necesariamente esas fracciones exactas. Para grados grandes, el denominador se comporta como , de modo que recuperamos el exponente de la aproximación continua. El coeficiente asintótico es ahora , mientras que la aproximación continua daba .
La fórmula permite comprobar la normalización y las medias. Usando la diferencia entre términos consecutivos
la suma de probabilidades se simplifica por cancelación y vale uno. La cola acumulada resulta
El grado medio es , coherente con el balance de enlaces. Esta coincidencia entre una propiedad global de la construcción y la media de la distribución es una comprobación interna; una fórmula que no respetara ese balance necesitaría revisión.
Para , las primeras probabilidades son , , y para grados uno a cuatro. La mayoría de los nodos son hojas, aunque unos pocos concentran muchas conexiones. La probabilidad límite de grado al menos diez es , aproximadamente un 1,82 %. Esa cifra corresponde al régimen límite del modelo; en una muestra pequeña, la proporción observada puede apartarse de ella.
El segundo momento de la distribución límite diverge, porque los términos de la suma correspondiente decaen como el inverso del grado. En cualquier red finita todos los momentos son finitos, así que la divergencia describe el comportamiento de una familia de redes cuando aumenta su tamaño.
La distribución de grados no incluye la estructura de dependencia entre nodos. Los grados comparten el presupuesto total de enlaces y la historia de las elecciones. Tratar cada grado como una observación independiente de la fórmula puede servir como aproximación descriptiva, pero no reproduce toda la probabilidad de la red. Esta distinción afectará a las pruebas estadísticas del capítulo siguiente.
188.5. Qué ocurre si todos los destinos tienen igual oportunidad
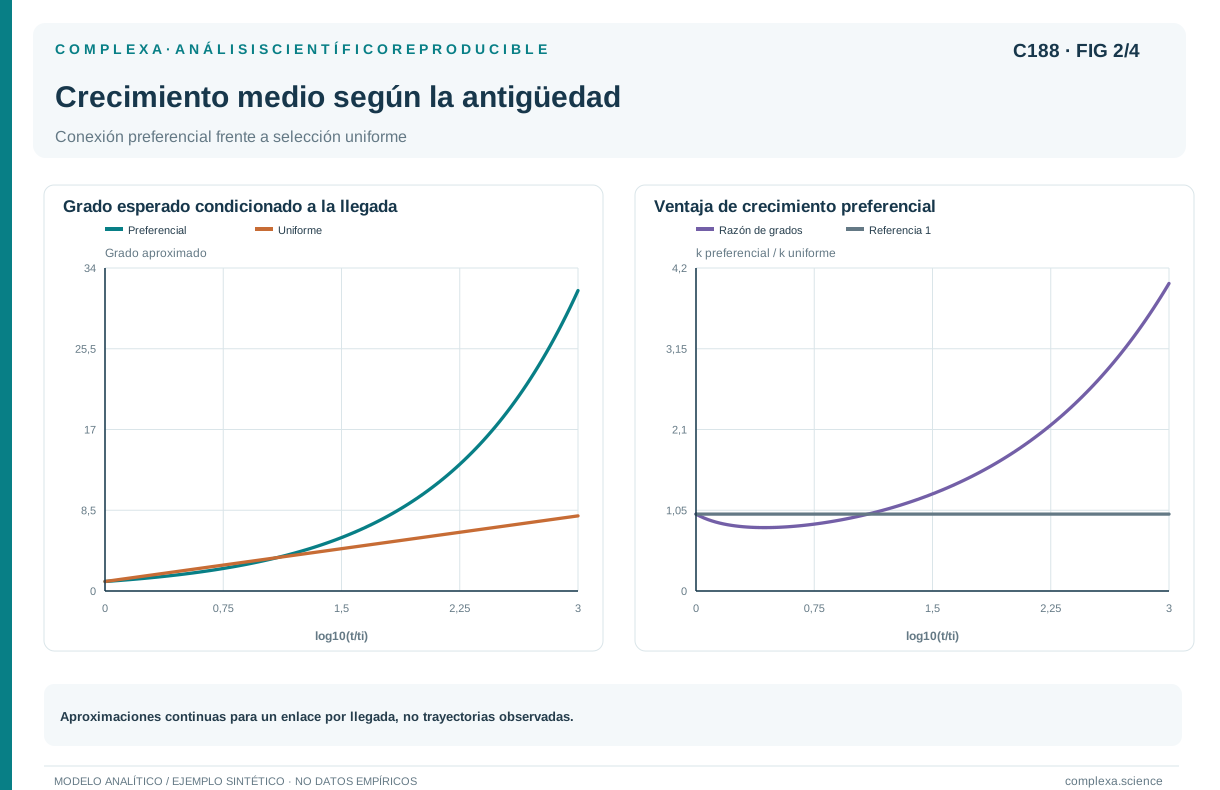
Cambiemos una sola regla. Cada nodo nuevo crea un enlace y elige uniformemente entre los nodos existentes. La red sigue creciendo y, si empieza como árbol, permanece como árbol. Conserva un grado medio cercano a dos, pero desaparece la preferencia directa por los grados altos. La edad continúa importando porque los nodos antiguos han participado en más sorteos.
La probabilidad de recibir el nuevo enlace es aproximadamente para cualquier nodo presente. Por ello, el grado esperado de un nodo incorporado en crece aproximadamente como
El crecimiento es logarítmico, frente a la raíz del cociente de tiempos en la conexión preferencial lineal. La ventaja de edad persiste, pero se acumula de otra manera. Observar que los nodos antiguos tienen más conexiones no basta para distinguir ambos mecanismos.
El balance de frecuencias es especialmente sencillo. La proporción límite satisface y, para grados mayores que uno, , de modo que
La distribución es geométrica y su cola disminuye exponencialmente con el grado. El grado medio sigue siendo dos. Esta comparación muestra que una misma media puede acompañarse de niveles muy diferentes de heterogeneidad.
En el crecimiento uniforme, la proporción límite con grado al menos diez es , aproximadamente un 0,195 %. En el modelo preferencial con un enlace por llegada era aproximadamente un 1,82 %. La diferencia supera un factor nueve para ese umbral. Ambos resultados proceden de modelos ideales y permiten comparar sus predicciones bajo condiciones iguales.
También cambia la abundancia de hojas, que son la mitad de los nodos en el modelo uniforme y dos tercios en el preferencial. La concentración de conexiones en unos pocos destinos deja a una fracción mayor de nodos con su único enlace inicial. Una cola más amplia solo redistribuye un presupuesto medio que permanece fijo.
Podemos comparar ambos modelos mediante datos de llegada. En cada evento interesa saber cuántos nodos eran elegibles y qué grados tenían antes de la elección. Si los nodos de grado alto reciben más enlaces, debemos dividir esa cantidad por su exposición como destinos posibles. Sin esa corrección, una categoría numerosa puede acumular muchos enlaces aunque cada uno de sus nodos tenga una probabilidad baja.
De ahí el interés de estudiar trayectorias. Una distribución final resume el resultado de muchas elecciones, mientras el registro de eventos permite examinar la regla directamente. Incluso entonces habrá que considerar visibilidad y restricciones, pero las hipótesis producen predicciones más específicas que una simple forma de cola.
188.6. Atracción inicial y preferencia no lineal
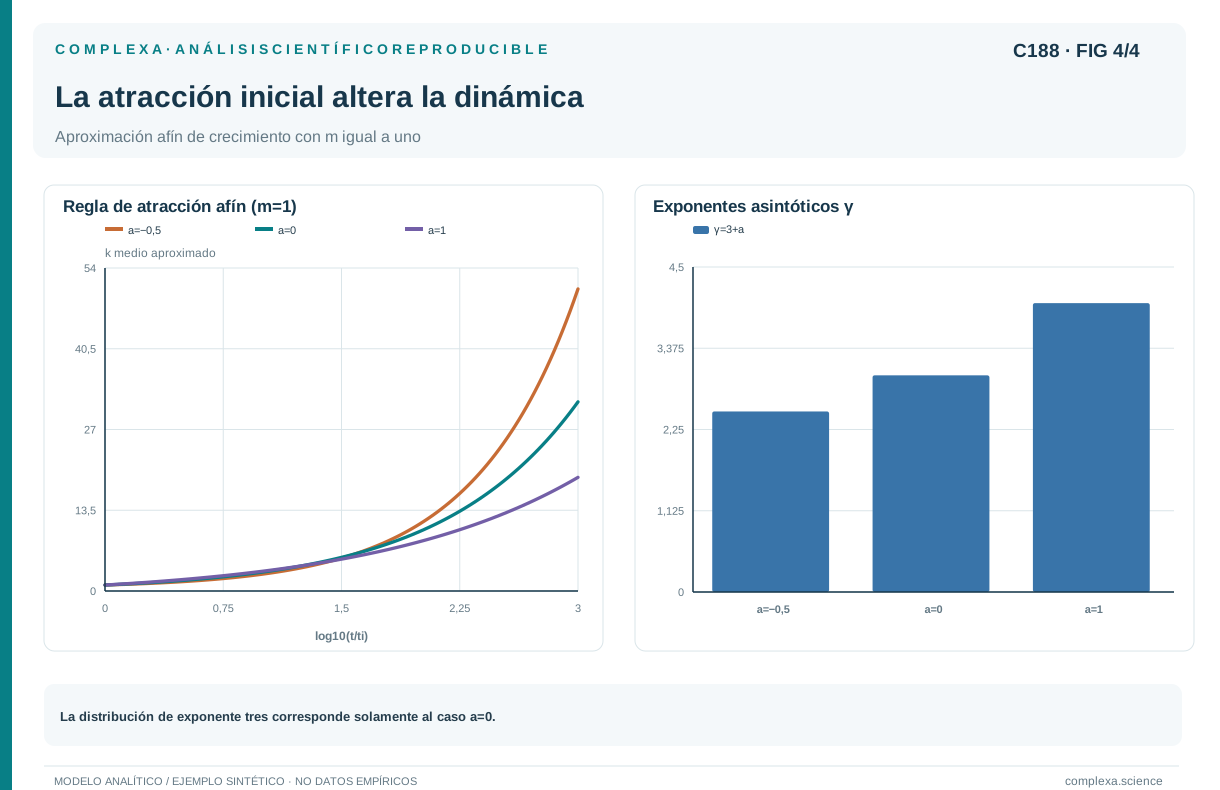
Una extensión asigna a cada nodo un peso , donde es una atracción inicial común. Para que el peso de un nodo recién llegado sea positivo, suponemos . Como el número de nodos crece aproximadamente como , la suma de pesos se aproxima a .
La ecuación continua pasa a ser
El exponente de la cola de la distribución por grado resulta
Una atracción inicial positiva reduce la ventaja relativa de poseer muchos enlaces y produce una cola más pronunciada. Con y , el exponente es cuatro. Con , los nodos recién llegados tienen menor peso relativo y el exponente es dos y medio. Estos resultados corresponden a la extensión lineal afín y a su régimen asintótico.
Un parámetro negativo no implica una probabilidad negativa. Los pesos siguen siendo positivos porque los grados no bajan de y se exige . Si añadimos eliminación de enlaces y permitimos grados menores, la misma condición deja de ser suficiente. Modificar una parte del modelo obliga a revisar el dominio válido de las demás.
Otra extensión usa un peso proporcional a . Krapivsky, Redner y Leyvraz (2000) estudiaron cómo cambia la organización al variar esa dependencia. En la clase básica de modelos que analizaron, una preferencia sublineal, con exponente entre cero y uno, produce colas que típicamente decaen como exponenciales estiradas. La preferencia lineal ocupa un régimen especial.
Cuando la preferencia es superlineal, la ventaja acumulativa puede ser tan fuerte que uno o pocos nodos capturan una parte macroscópica de los enlaces. Este comportamiento se describe como condensación o concentración extrema, con detalles que dependen del exponente y de la variante del proceso. No debe confundirse con la mera presencia de un nodo de grado grande en una red pequeña.
Las diferencias son cualitativas, pues una regla que parece una pequeña modificación algebraica puede cambiar la forma de la cola y la concentración de recursos. Por eso conviene estimar la dependencia funcional de la selección, sin asumir la linealidad solo porque conduce a una explicación conocida. Los datos pueden no bastar para distinguir exponentes cercanos; en ese caso, la incertidumbre debe conservarse.
188.7. Aptitud, envejecimiento y límites de capacidad
Los nodos pueden diferir en propiedades que no se resumen en su grado. Una extensión asigna a cada uno una aptitud y usa pesos proporcionales a . Un nodo reciente con aptitud alta puede atraer enlaces más deprisa que uno antiguo con aptitud baja. Así se debilita la correspondencia simple entre edad y grado.
La palabra «aptitud» designa un parámetro del modelo, sin equivalencia automática con la calidad objetiva, el mérito o el valor social. Puede resumir visibilidad, recursos, posición institucional o variables omitidas. Si se estima a partir de los mismos enlaces que intenta explicar, puede describir la heterogeneidad sin identificar su origen; su interpretación sustantiva requiere entonces datos independientes.
Bianconi y Barabási (2001) estudiaron una clase de modelos con aptitud y mostraron condiciones de condensación que dependen de su distribución. La presencia de aptitud no garantiza ese fenómeno en cualquier variante, porque intervienen la forma de la distribución, sus límites y la dinámica de crecimiento. La analogía con la condensación física es una correspondencia matemática específica, que no autoriza a trasladar todas las propiedades de un sistema físico a cualquier red social.
El envejecimiento introduce una función de la edad del nodo. Si el atractivo disminuye con el tiempo transcurrido desde la llegada, esa pérdida puede compensar la ventaja acumulativa. Un artículo antiguo conserva sus citas, pero puede dejar de recibir atención al cambiar el campo. Un dispositivo conectado puede permanecer en el registro aunque ya no participe en interacciones nuevas.
También hay capacidades máximas o costos crecientes, ya que mantener relaciones requiere tiempo, infraestructura o recursos. Una regla que reduce el crecimiento cuando el grado se aproxima a un límite produce cortes o saturación. Ese límite puede ser común o variar entre nodos. En ambos casos, ajustar una ley de potencia sin corte a todo el rango puede atribuir al azar una restricción estructural real.
La eliminación de nodos o enlaces altera el balance. Si las incorporaciones compensan las salidas, la red puede mantener un tamaño aproximadamente estable. Si los enlaces crecen más deprisa que los nodos, aumenta el grado medio y aparece densificación. Si las conexiones se redistribuyen entre nodos existentes, la historia ya no se reduce a elegir destinos para recién llegados. Cada operación requiere una ecuación de balance distinta.
En redes dirigidas hay que decidir qué grado determina la elección. En una red de citas, los enlaces nuevos suelen salir de trabajos recientes hacia anteriores; el grado de entrada cuenta las citas recibidas y el de salida, las referencias emitidas. Reutilizar sin cambios una fórmula para redes no dirigidas puede producir denominadores y exponentes incorrectos.
188.8. Cómo estimar una regla a partir de eventos
Supongamos que disponemos de un registro temporal de enlaces. Para cada llegada podemos reconstruir el conjunto de destinos elegibles y sus grados justo antes del evento. Una hipótesis de selección asigna un peso que puede depender del grado, de atributos observados y del tiempo. La probabilidad del destino elegido es su peso dividido por la suma de pesos de todos los destinos posibles.
La verosimilitud del registro se construye multiplicando esas probabilidades o sumando sus logaritmos. Así comparamos directamente reglas uniformes, lineales, afines o dependientes de atributos. Si faltan eventos intermedios, los grados previos pueden estar mal reconstruidos y la verosimilitud deja de corresponder al proceso supuesto. La calidad temporal del registro es parte central de la inferencia.
Una representación descriptiva agrupa destinos por grado y compara el número de enlaces recibidos con su exposición. La exposición debe sumar oportunidades a lo largo del tiempo, porque un nodo puede cambiar de categoría después de cada elección. Dividir solo por el número de nodos que tienen ese grado al final del periodo mezcla estados anteriores y posteriores al evento.
Los intervalos temporales demasiado amplios producen otro problema. Dentro de una ventana, un nodo puede recibir varios enlaces y cambiar de atractivo antes de que termine. Tratar todas las elecciones como si hubieran ocurrido con los grados iniciales simplifica el proceso y puede sesgar la forma estimada. Cuando no conocemos el orden, necesitamos un modelo de agregación temporal o un análisis de sensibilidad.
La elección también puede estar restringida por visibilidad. Si quien llega observa únicamente una parte de la red, el conjunto elegible es menor que el conjunto registrado. Un aparente efecto del grado podría proceder de que los nodos populares aparecen con más frecuencia en búsquedas, recomendaciones o contactos de segundo orden. El mecanismo de descubrimiento puede generar una selección efectiva proporcional al grado sin que nadie evalúe explícitamente ese grado.
Conviene comparar predicciones fuera del periodo de ajuste. Una regla estimada en una fase de expansión puede fallar después de cambios institucionales o tecnológicos. Además de la probabilidad de cada destino, pueden evaluarse la trayectoria del grado medio, la distribución por edad, la concentración de nuevos enlaces y la persistencia de posiciones dominantes.
Un cálculo local permite ver qué significa comparar las probabilidades de elección. Supongamos que la red actual es una estrella de cuatro nodos, con un centro de grado tres y tres hojas de grado uno. Bajo conexión preferencial, el centro recibe el siguiente enlace con probabilidad un medio y cada hoja con probabilidad un sexto. Bajo selección uniforme, cada destino tiene probabilidad un cuarto. Si el evento observado elige el centro, la razón de probabilidades entre ambos modelos es dos; si elige una hoja específica, es dos tercios.
Un solo evento da evidencia limitada. Bajo ambas reglas son posibles tanto la elección del centro como la de una hoja; las reglas difieren en cómo ponderan todos los resultados posibles. Si el mecanismo preferencial fuera correcto, el promedio esperado del logaritmo de esa razón, en este estado concreto, sería un medio del logaritmo de cuatro tercios, aproximadamente 0,144 unidades naturales de información. El valor positivo expresa una ventaja predictiva esperada, que no asegura acertar cada elección.
No podemos multiplicar esas mismas probabilidades a lo largo de toda la historia. Después de la llegada, aumenta el número de nodos y cambia el grado del destino escogido. En el siguiente paso debemos actualizar ambas distribuciones sobre el nuevo conjunto elegible. Mantener congelada la estrella inicial equivaldría a analizar repeticiones independientes del mismo estado e ignorar que el proceso se transforma con sus propios eventos.
Esta actualización es importante al comparar mecanismos adaptativos. Un error temprano en los datos puede alterar los grados reconstruidos de pasos posteriores y, por tanto, toda la secuencia de probabilidades. Revisar el registro de eventos y conservar una versión reproducible de su orden suele ser más informativo que aumentar la precisión decimal de un exponente estimado. El modelo temporal exige consistencia en cada transición, además de concordancia con la distribución final.
Los resultados deben separar asociación predictiva y efecto causal. Que el grado previo prediga enlaces posteriores no demuestra cuánto cambiarían esas llegadas si aumentáramos artificialmente el grado de un nodo. Tal intervención podría modificar la visibilidad o la reputación de otra manera. Identificar ese efecto requiere un diseño o supuestos adicionales sobre el proceso de selección.
188.9. Una auditoría comparativa de dos mecanismos
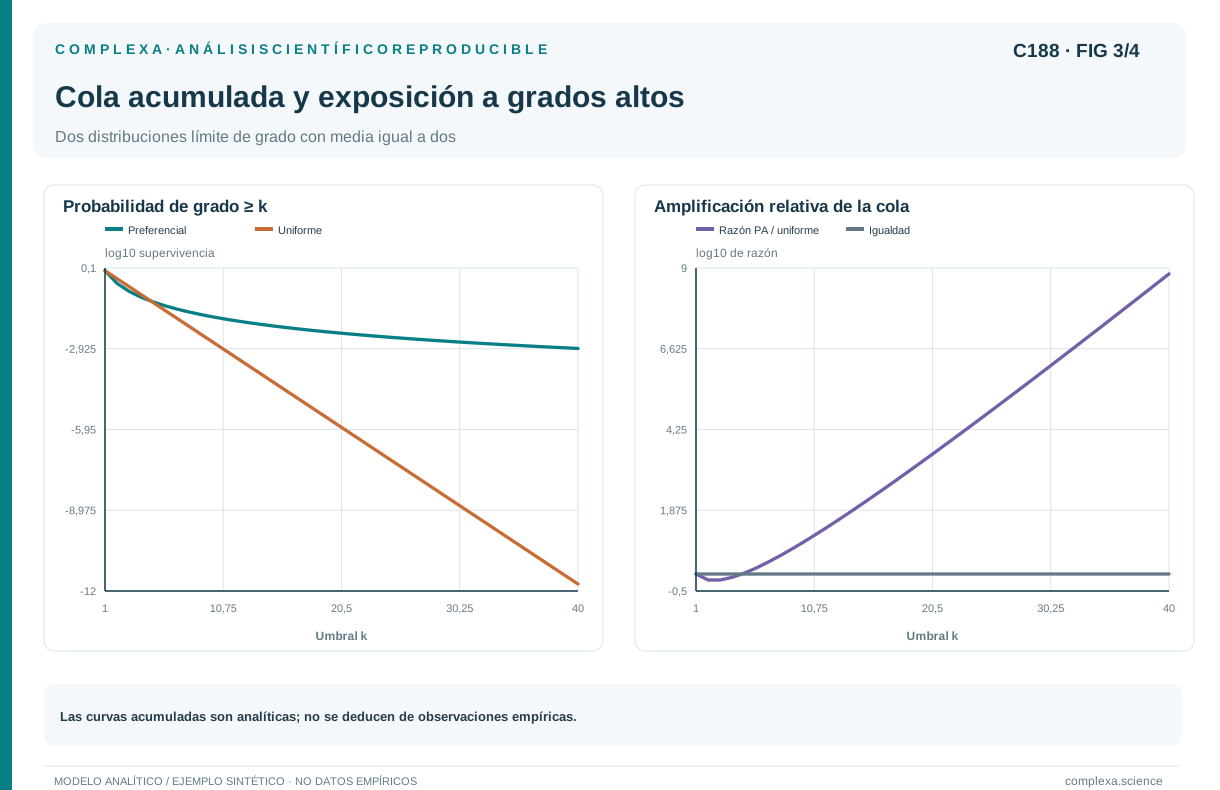
Imaginemos que debemos explicar una red de colaboración que incorpora participantes de manera continua. El registro final contiene muchos nodos con pocos contactos y algunos con muchos. Proponemos dos modelos iniciales, el crecimiento uniforme y la conexión preferencial lineal, ambos con un enlace nuevo por llegada. Los dos conservan un grado medio cercano a dos y generan árboles si la semilla lo es.
La primera comprobación examina el balance de eventos. Si una proporción importante de enlaces aparece entre participantes ya presentes, ambos modelos omiten una operación frecuente. Si muchos participantes llegan con varios contactos, también incumplen su condición inicial. Estas discrepancias pueden detectarse antes de ajustar una cola y afectan directamente a la interpretación.
La segunda comprobación usa la estructura. Si la red contiene numerosos triángulos nuevos, los modelos con un enlace por llegada y semilla arbórea no pueden producirlos. Una coincidencia excelente de grados no resolvería esa incompatibilidad. Haría falta incorporar cierre de triángulos, llegadas con varios enlaces u otras operaciones; después habría que examinar sus predicciones adicionales.
La tercera comprobación compara grados por cohortes. En el crecimiento uniforme esperamos un aumento aproximadamente logarítmico con el tiempo de exposición; en el preferencial lineal, una dependencia aproximada de raíz cuadrada. Las cohortes permiten controlar parte de la ventaja de edad. Si nodos de la misma antigüedad muestran diferencias persistentes según sus atributos, puede ser necesario incorporar heterogeneidad de aptitud o de oportunidades.
La cuarta comprobación considera el proceso de elección. Para cada enlace nuevo evaluamos la probabilidad que cada modelo asigna a su destino. Podemos reservar una secuencia posterior y comparar sus pérdidas logarítmicas. Un modelo que explica la distribución final pero predice mal los eventos individuales da una explicación incompleta del crecimiento.
Por último, simulamos redes completas con el tamaño y la ventana de observación del registro. La comparación debe incluir la variabilidad entre realizaciones. Si el dato cae fuera de lo habitual en varios resúmenes relevantes, habrá evidencia de insuficiencia. Si cae dentro, el modelo sigue siendo compatible con esos resúmenes, pero no queda demostrado como mecanismo único.
Este procedimiento convierte una historia atractiva en una serie de contrastes. Algunos pueden favorecer la conexión preferencial y otros señalar mecanismos faltantes. La revisión del modelo debe responder a discrepancias concretas, sin añadir parámetros solo para perseguir cada irregularidad de la muestra.
188.10. Lo que permite concluir una distribución amplia
Una distribución amplia puede surgir por crecimiento acumulativo, diferencias persistentes entre nodos, mezclas de poblaciones, restricciones espaciales o procesos de observación. La conexión preferencial es una explicación especialmente clara cuando se dispone de eventos y la probabilidad de recibir enlaces aumenta con el grado previo una vez consideradas las oportunidades relevantes.
Los modelos comparados muestran qué añaden las ecuaciones. El crecimiento uniforme y el preferencial pueden compartir grado medio y estructura arbórea, pero difieren en trayectorias y colas. La atracción inicial cambia el exponente; la preferencia no lineal puede modificar el tipo de distribución; el envejecimiento y la capacidad introducen otras escalas. Estas diferencias generan predicciones que van más allá del aspecto de un gráfico.
El informe de un análisis debe especificar qué operaciones están permitidas, qué información usa cada elección, cómo se inicializa el proceso y qué variables se han observado. También debe distinguir las aproximaciones continuas de las soluciones discretas y los resultados asintóticos de las predicciones para el tamaño concreto estudiado. Esa distinción evita exigir exactitud donde el modelo solo da una tendencia límite.
Cuando hay evidencia de una cola compatible con una ley de potencia, todavía queda la tarea estadística de estimar su rango, cuantificar la incertidumbre y comparar esa cola con alternativas. Esa será la cuestión del capítulo siguiente. La interpretación mecanística debe esperar a que tanto la forma distributiva como las predicciones temporales hayan recibido una evaluación adecuada.
Referencias
- Barabási, A.-L., y Albert, R. (1999). Emergence of scaling in random networks. Science, 286(5439), 509–512. DOI.
- Bianconi, G., y Barabási, A.-L. (2001). Bose-Einstein condensation in complex networks. Physical Review Letters, 86, 5632–5635. DOI.
- Krapivsky, P. L., Redner, S., y Leyvraz, F. (2000). Connectivity of growing random networks. Physical Review Letters, 85, 4629–4632. DOI.