COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 21. Teoría de la información: incertidumbre, dependencia y representación
203.1. Cuánto cambia una observación lo que sabemos
Dos variables pueden variar mucho y, sin embargo, contener casi la misma información. También pueden parecer poco relacionadas mediante una correlación lineal y conservar una dependencia fuerte. Para estudiar estas situaciones necesitamos medir cómo cambia la incertidumbre sobre una variable al conocer la otra.
La información mutua mide ese cambio bajo una distribución conjunta especificada. Compara la incertidumbre inicial con la que permanece, en promedio, después de observar otra variable. Su interpretación exige conservar el contexto probabilístico y distinguir dependencia estadística de causalidad.
Si un sensor copia exactamente un estado binario equiprobable, observarlo elimina un bit de incertidumbre sobre ese estado. Si produce un bit independiente, no elimina ninguna incertidumbre, aunque su salida tenga también un bit de entropía. La variabilidad de la señal y la información que contiene sobre un objetivo son cantidades distintas.
En ciencia de datos, una columna muy variable puede contener principalmente ruido, mientras que una columna casi constante puede identificar un evento raro de interés. La utilidad para una decisión requiere además considerar el objetivo y sus consecuencias.
La información mutua no presupone una relación lineal, una escala numérica particular ni una dirección de influencia. Puede definirse para categorías, números y objetos representados mediante variables aleatorias. Sin embargo, estimarla desde datos puede ser difícil, especialmente cuando el espacio conjunto es grande.
El capítulo anterior construyó las entropías y la regla de la cadena. Ahora usaremos esas identidades para cuantificar dependencia y reconocer sus límites mediante ejemplos. Trabajaremos primero con variables discretas finitas, donde cada expresión tiene una interpretación directa.
Buscaremos una relación precisa entre dos conjuntos de distinciones. El mismo sistema puede dar valores diferentes cuando cambiamos el objetivo, el contexto observado o la resolución de sus variables, de modo que esa relación no es una puntuación universal de complejidad.
203.2. Tres formas equivalentes de una misma cantidad
Para variables de alfabetos finitos, definimos la información mutua como
La primera entropía describe incertidumbre sobre sin observar . La segunda describe lo que permanece después de observarlo, promediando sobre sus posibles valores. La diferencia es una reducción promedio bajo el mismo modelo.
Por la regla de la cadena, también podemos escribir
La información mutua es simétrica; la de con es igual a la de con . Esa simetría no significa que las entropías condicionales sean iguales ni que las variables se influyan causalmente de forma simétrica.
Otra expresión compara la probabilidad conjunta con la que tendríamos si las marginales fueran independientes
Cuando la distribución conjunta coincide con el producto de marginales, cada cociente relevante es uno y la información mutua es cero. La cantidad completa es no negativa y se anula precisamente en la independencia, dentro de las condiciones indicadas.
La no negatividad puede demostrarse mediante la desigualdad del logaritmo o la desigualdad de Gibbs. Algunos términos individuales pueden ser negativos; la propiedad la satisface el promedio ponderado sobre la distribución conjunta.
En variables discretas, la información mutua no puede superar la menor de las dos entropías marginales, porque no podemos eliminar más incertidumbre sobre una variable que la que teníamos inicialmente sobre ella. Una variable constante comparte cero información con cualquier otra.
Si es una copia exacta e invertible de , la información mutua coincide con su entropía. Si conserva solo una agrupación determinista de sus valores, la información mutua es la entropía de esa agrupación, que puede ser menor.
Todas estas expresiones necesitan la misma distribución de referencia. Restar entropías obtenidas de poblaciones distintas no produce, en general, una información mutua válida. La compatibilidad de marginales y condicionales forma parte del cálculo.
En alfabetos infinitos, la definición mediante divergencia respecto del producto de marginales evita algunas restas indeterminadas. La información mutua puede estar bien definida aunque una expresión escrita como diferencia de dos entropías infinitas no lo esté. Las identidades de diferencia deben usarse solo cuando sus términos permitan esa operación.
203.3. Un cálculo completo y la información de una pareja
Retomemos una distribución binaria con probabilidades conjuntas , , y , en el orden de parejas cero-cero, cero-uno, uno-cero y uno-uno. Sus marginales son para y para .
La entropía de es aproximadamente bits. Su entropía condicionada a es aproximadamente . Por tanto, la información mutua es aproximadamente
El mismo resultado aparece al sumar las dos entropías marginales y restar la conjunta, de aproximadamente bits. Repetir el cálculo por rutas distintas permite comprobar su coherencia antes de interpretar la cifra.
Para cada pareja podemos definir una información puntual,
La pareja cero-cero aparece con probabilidad , mientras que el producto de sus marginales es . Su información puntual es positiva, porque esa combinación es más frecuente de lo que esperaría un modelo de independencia con las mismas marginales.
La pareja uno-cero tiene probabilidad , frente a un producto marginal de . Su información puntual es aproximadamente bits. Es una combinación menos frecuente bajo la relación real que bajo aquella referencia independiente.
Un valor puntual negativo describe una realización que contradice parcialmente la asociación habitual. No implica una entropía negativa de la fuente ni invalida la información mutua, ya que al promediar todas las parejas con sus probabilidades reales el resultado sigue siendo no negativo.
Esta distinción ayuda a interpretar secuencias de observaciones en las que algunas realizaciones concuerdan poco con el patrón general de dependencia. No debemos sustituir el promedio por el valor de una sola pareja ni ignorar los resultados raros porque tengan signo diferente.
La referencia independiente conserva las marginales. Si cambiamos esas marginales, también cambia el cociente. La información mutua mide dependencia en una población concreta y depende tanto de la regla de relación como de la distribución de sus entradas.
El valor calculado tampoco es un porcentaje universal de relación. Dividirlo por una entropía da una normalización posible, pero diferentes normalizaciones responden a criterios distintos. En particular, una fracción de incertidumbre resuelta no coincide necesariamente con una fracción de aciertos.
Hay una distinción adicional entre información puntual y cambio de entropía tras un resultado específico. Si fijamos un valor observado de y promediamos la información puntual con la distribución posterior de , obtenemos una divergencia entre esa posterior y la distribución previa. Ese promedio es no negativo.
No es, en general, la entropía previa menos la entropía de esa posterior particular. Para ver la diferencia, supongamos que inicialmente la probabilidad de un evento es y que una observación la eleva a . La entropía aumenta de aproximadamente a un bit.
Sin embargo, la divergencia de esa posterior respecto de la previa es aproximadamente bits. La observación cambió mucho nuestras probabilidades, aunque las dejó más equilibradas y, por tanto, con mayor entropía.
La diferencia procede de qué distribución pondera los logaritmos. En la divergencia posterior, incluso el término que contiene la distribución previa se promedia con las probabilidades posteriores. No podemos reemplazarlo por la entropía previa, que usa otros pesos.
Al promediar sobre todos los posibles resultados de , ambas rutas recuperan la información mutua. Mantener separados el resultado particular y el promedio evita atribuir signos contradictorios a cantidades que en realidad tienen definiciones distintas.
203.4. Dependencia no lineal y ausencia de correlación
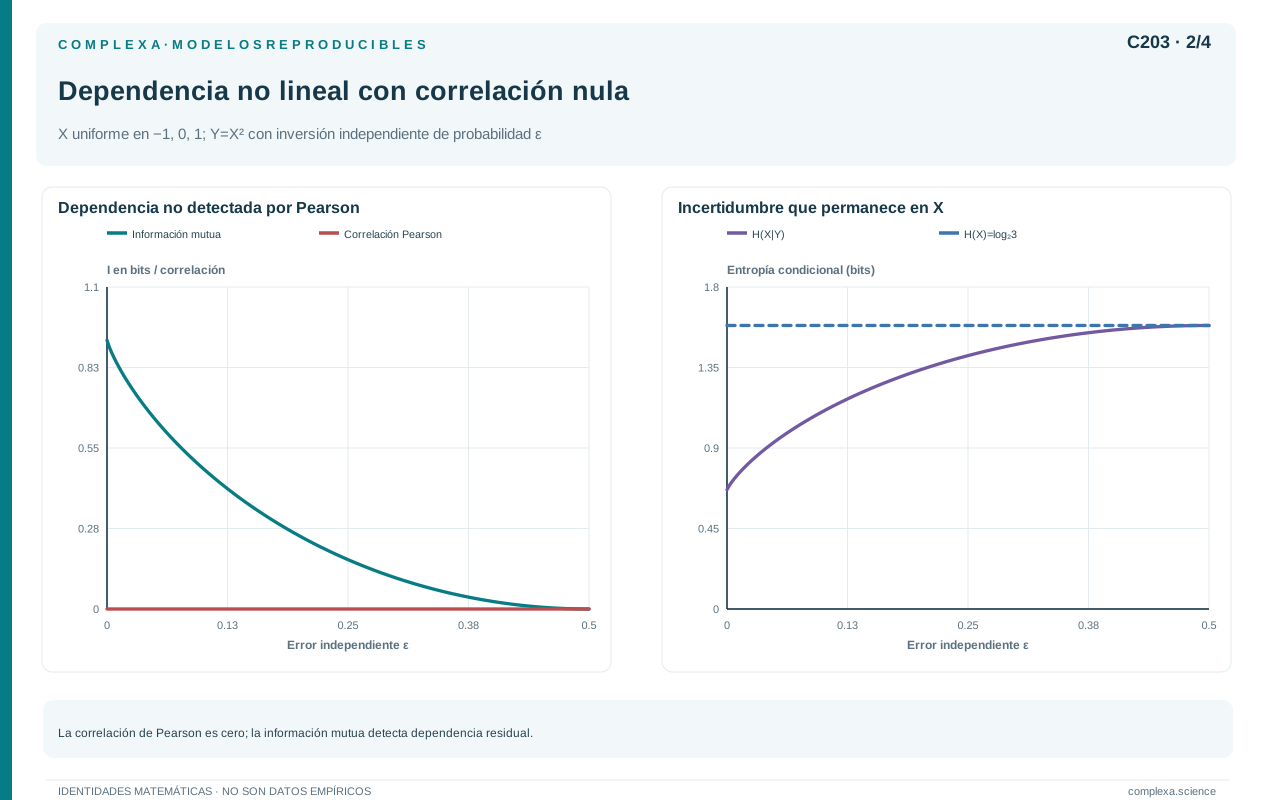
Sea uniforme sobre los valores menos uno, cero y uno; definamos . El resultado indica si la magnitud de es cero o uno. Su relación es determinista, aunque pierde el signo cuando la magnitud es uno.
La media de es cero. El producto es igual a , cuya media también es cero por simetría. Como ambas variables tienen varianza positiva, su correlación de Pearson es cero.
Sin embargo, las variables no son independientes. Si observamos , sabemos que . Si observamos , sabemos que es menos uno o uno.
Como es una función de , la entropía de condicionada a es cero. Su información mutua es entonces
La entropía inicial de es el logaritmo de tres, aproximadamente bits. La incertidumbre residual es dos tercios de bit, porque con probabilidad de un tercio queda resuelta por completo y con probabilidad de dos tercios permanece una elección equiprobable de signo.
La diferencia entre entropía inicial y residual reproduce la información mutua. El cálculo exacto identifica así una dependencia fuerte con correlación lineal nula.
La correlación sigue siendo útil, pues responde a una pregunta sobre asociación lineal y puede ser apropiada para ciertos modelos. La información mutua responde a una pregunta más general sobre cambios de distribución, pero suele exigir más datos y decisiones de estimación.
En una muestra finita, detectar cualquier dependencia imaginable tiene un costo, porque un estimador flexible puede adaptarse al ruido. Una medida teóricamente sensible a relaciones generales necesita una evaluación empírica que controle ese problema.
Kinney y Atwal analizan propiedades de medidas de asociación y de la información mutua, así como el papel de las transformaciones y las dificultades de estimación. Más allá del debate sobre cómo comparar relaciones distintas, cada aplicación debe declarar qué propiedad quiere medir.
El ejemplo cuadrático también muestra que una relación determinista no siempre permite recuperar la entrada, pues el cuadrado conserva la magnitud y pierde el signo. La información mutua cuantifica lo conservado bajo la distribución elegida; la invertibilidad responde a otra propiedad de la transformación.
Para una pareja conjuntamente gaussiana no degenerada hay una relación especial entre correlación e información mutua
donde es la correlación. Con un valor de , la información mutua es aproximadamente bits. En esa familia, conocer la correlación basta para determinar esta cantidad, aunque las medias y escalas individuales sean distintas.
La hipótesis de gaussianidad conjunta es esencial. El ejemplo del cuadrado no pertenece a esa familia y tiene dependencia con correlación cero. Aplicarle la fórmula gaussiana por conveniencia daría un resultado incorrecto.
Cuando la magnitud de la correlación se aproxima a uno dentro de la familia gaussiana, la información mutua crece sin límite. Ese comportamiento anticipa la singularidad de una relación continua exacta, que no debe confundirse con el máximo finito de un bit binario.
203.5. Información y ruido en una copia binaria
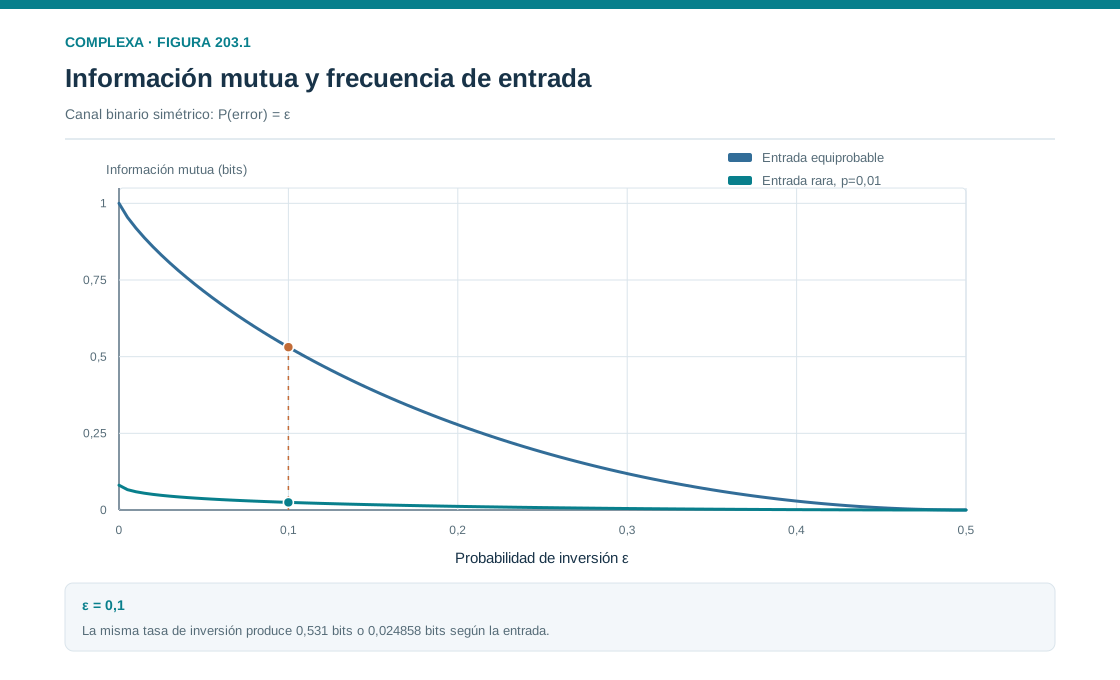
Consideremos un bit equiprobable que atraviesa una operación que cambia su valor con probabilidad , independientemente de la entrada. Llamamos al resultado. Es un modelo binario de error simétrico.
La salida sigue siendo equiprobable. Dada la entrada, su incertidumbre procede únicamente de si ocurrió el cambio, de modo que . La información mutua es
Con error de una décima, la información mutua es aproximadamente bits. Con error de un medio es cero, porque la salida no modifica las probabilidades de la entrada. Con error cero, la copia conserva un bit completo.
Si el error es uno, la salida siempre invierte la entrada y también conserva un bit. Un receptor que conoce la regla puede deshacer la inversión. Una discrepancia máxima entre valores literales no equivale a pérdida máxima de información.
Hay que distinguir, entonces, un error desconocido de una transformación conocida. Una inversión sistemática puede corregirse sin incertidumbre adicional, mientras que una modificación aleatoria desconocida destruye parte de la relación disponible en una observación.
Ahora cambiemos la distribución de entrada. Si la probabilidad de uno es y el error sigue siendo , la probabilidad de uno en la salida es . La información mutua pasa a ser
La regla de error no cambió, pero cambió cuánta incertidumbre tenía la entrada y cómo se distribuyen las salidas. Una relación no puede caracterizarse completamente mediante el porcentaje de errores sin considerar la población de entradas.
También podemos construir una predicción con exactitud de noventa y nueve por ciento que no use ninguna observación (declarar siempre cero para esa entrada rara). La predicción constante tiene información mutua cero con el estado, aunque acierte casi siempre.
La exactitud alta puede reflejar una categoría dominante. La información mutua pregunta cuánto modifica la observación las probabilidades del objetivo. Para una decisión sobre eventos raros, necesitamos además evaluar los errores específicos y sus costos.
Más adelante definiremos la capacidad de un canal como una optimización sobre distribuciones de entrada permitidas. Por ahora, el ejemplo muestra por qué la información mutua de una distribución concreta y la calidad intrínseca de un mecanismo de transmisión son preguntas relacionadas pero diferentes.
Podemos añadir un segundo sensor con la misma probabilidad de error, independiente del primero una vez conocido el bit verdadero. Sus informaciones individuales no pueden sumarse directamente, porque ambas observaciones reducen la misma incertidumbre inicial.
Los sensores coinciden con probabilidad . Cuando coinciden, la probabilidad posterior de que ambos estén equivocados es . Cuando discrepan, lo que ocurre con probabilidad , ninguna de las dos salidas tiene ventaja y la posterior vuelve a ser equiprobable.
La incertidumbre residual del estado es entonces
La información conjunta de los dos sensores supera la de uno solo, pero permanece por debajo de un bit. La suma ingenua de las dos informaciones individuales superaría un bit y contaría dos veces parte de la evidencia.
El error mínimo de clasificación, resolviendo al azar los empates, sigue siendo una décima (una centésima procede de coincidencias equivocadas y nueve centésimas, de la mitad de las discrepancias). La segunda observación mejora la descripción probabilística sin mejorar en este caso el error promedio bajo pérdida de cero o uno. El objetivo de evaluación determina qué aspecto consideramos una mejora.
La independencia de errores condicionada al estado verdadero es una hipótesis decisiva. Si ambos sensores comparten exactamente el mismo error, el segundo repite la salida del primero. Su información adicional es cero, aunque sus especificaciones marginales de error sigan siendo las mismas.
De ahí que adquirir dos instrumentos con idéntico rendimiento individual no determine cuánto mejora el conjunto. Necesitamos saber si sus errores proceden de fuentes independientes, de una perturbación común o de un procesamiento compartido. El costo de añadir una observación debe compararse con su aportación después de las ya disponibles.
La información conjunta tampoco puede obtenerse multiplicando probabilidades marginales de coincidencia sin considerar el estado oculto. En el ejemplo, los sensores son independientes dentro de cada valor verdadero, pero quedan asociados al promediar sobre ese valor, porque ambos tienden a reflejar el mismo bit de entrada.
Esta estructura reaparece en otros problemas; la independencia condicionada a una causa común no equivale a independencia marginal. El cálculo necesita conservar la variable que hace válida la factorización. Si la eliminamos, debemos promediar sobre ella la distribución conjunta completa de los sensores.
Al evaluar la fórmula del caso independiente, la incertidumbre residual es aproximadamente bits y la información conjunta, . El segundo sensor añade cerca de bits después del primero. Estas cifras cuantifican la ganancia sin atribuirle una mejora de exactitud que el ejemplo no produce.
203.6. Cambiar etiquetas y cambiar resoluciones
Si renombramos de manera invertible los valores de una variable, la información mutua no cambia. Podemos permutar etiquetas, invertir un bit o aplicar una transformación uno a uno sobre el soporte sin perder distinciones.
La razón es que la distribución conjunta conserva las mismas probabilidades en parejas equivalentes. El cociente entre conjunta y producto de marginales se reorganiza, pero su promedio permanece igual.
Una agrupación no invertible puede perder información. En el ejemplo del cuadrado, fusionar menos uno y uno descarta el signo. Sin embargo, si el objetivo solo depende de la magnitud, esa agrupación podría conservar toda la información pertinente sobre ese objetivo.
Debemos distinguir la información sobre la entrada completa de la información sobre una variable de interés. Una representación puede perder muchos detalles y conservar exactamente los necesarios para una predicción concreta. El capítulo de procesamiento de datos formalizará esta relación.
Añadir ruido independiente puede aumentar la entropía de un registro sin aumentar su información sobre el objetivo. Si adjuntamos un bit aleatorio a una observación existente, el archivo distingue más resultados, pero ese bit adicional no reduce la incertidumbre sobre el estado que queremos conocer.
En variables continuas, la información mutua tiene una invariancia frente a cambios de coordenadas invertibles que la entropía diferencial individual no tiene. Los factores que introduce la transformación se cancelan en el cociente de densidades, bajo las condiciones regulares pertinentes.
Esa invariancia no implica que toda información mutua continua sea finita. Una copia exacta de una variable continua no degenerada puede tener información mutua infinita, porque la distribución conjunta queda concentrada sobre una relación determinista y es singular respecto del producto de marginales.
Una medición con resolución finita o ruido cambia el problema. La cantidad estimada depende entonces del modelo observacional, aunque cambiar simplemente de unidades mediante una transformación invertible no deba alterar la información teórica.
Por ello, comparar estimaciones requiere distinguir el reescalado de la discretización. El primero puede conservar todas las distinciones; la segunda suele fusionarlas. Si un estimador cambia mucho al reescalar una variable sin pérdida, debemos examinar su procedimiento y sus parámetros.
La invariancia matemática es una propiedad de la cantidad definida, que un algoritmo aplicado a pocos datos puede aproximar de manera imperfecta. Confundir las propiedades de la medida con las de cualquier estimador disponible lleva a conclusiones injustificadas.
203.7. Información mutua condicionada y conocimiento compartido
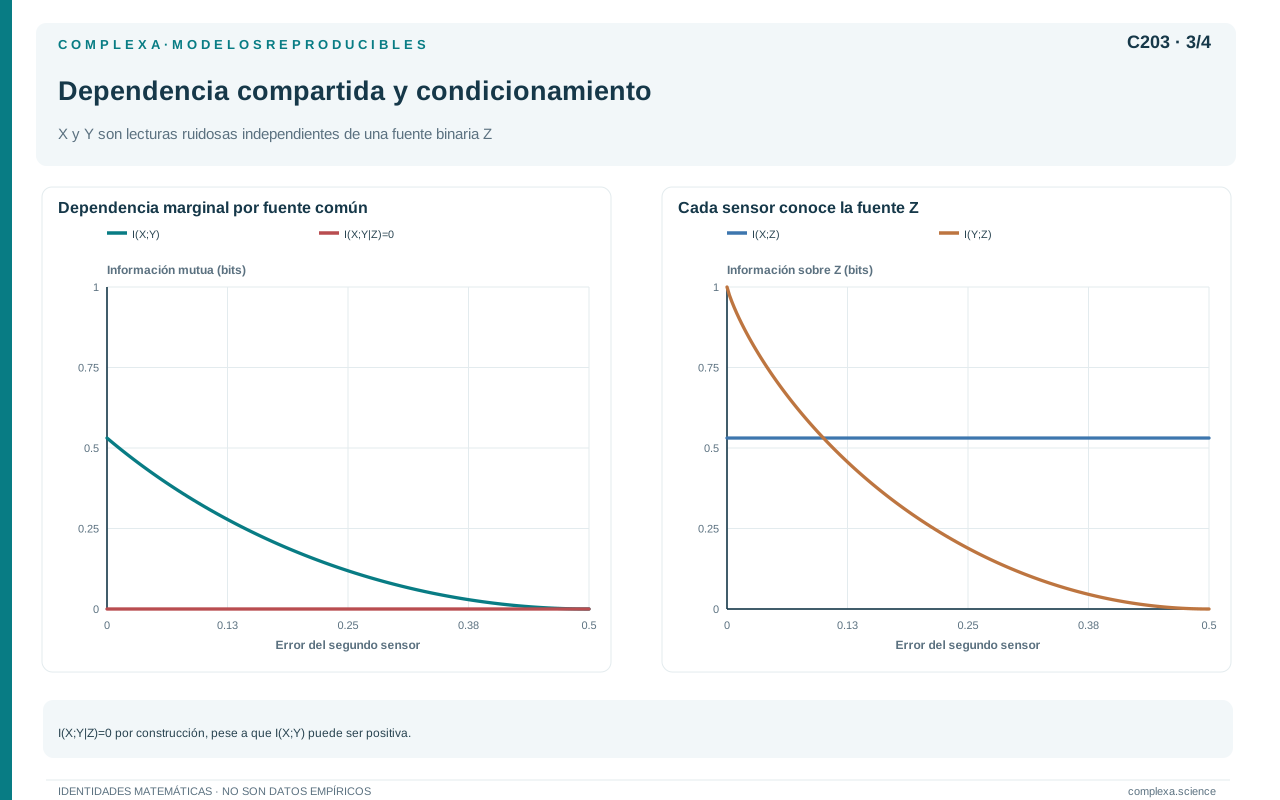
Podemos preguntar cuánto informa sobre cuando ya conocemos una tercera variable . Definimos
Equivale al promedio de la información mutua calculada dentro de cada grupo definido por , con sus probabilidades correspondientes. Es no negativa y se anula cuando e son condicionalmente independientes dado .
No hay una desigualdad general que obligue a que esta cantidad sea menor que la información mutua sin condicionar. El contexto puede eliminar una dependencia o revelar otra que no aparecía en las marginales.
Si dos variables son copias de una misma fuente , comparten información sin condicionamiento. Una vez conocida la fuente, conocer una no reduce la incertidumbre sobre la otra. En esa construcción, la información mutua condicionada es cero.
En cambio, tomemos dos bits independientes e y un tercero . Sin observar , la información mutua entre los dos primeros bits es cero. Dado , conocer uno determina el otro, de modo que la información mutua condicionada es un bit.
Condicionar aumentó la dependencia informacional en ese ejemplo, aunque los generadores originales siguen sin interactuar; observar el tercer bit solo cambió el contexto de probabilidades que estamos comparando.
La regla de la cadena para información mutua es
La información de las dos observaciones juntas se descompone en lo que da una y lo que añade la otra después. Invertir el orden cambia las contribuciones incrementales, aunque conserva el total.
En el ejemplo XOR, cada entrada por separado no informa sobre el resultado, pero juntas dan un bit. Con dos copias idénticas, la segunda no añade nada después de la primera. Estos patrones anticipan las nociones de sinergia y redundancia, cuyo tratamiento completo requiere definiciones adicionales.
La información mutua condicionada también permite evaluar si una observación añade información a la que ya dan otras variables disponibles. Su utilidad depende de que el condicionamiento esté bien estimado y de que la población usada corresponda a la pregunta.
203.8. Dependencia estadística y explicación causal
Consideremos una pareja de bits que siempre coinciden y son equiprobables. Su información mutua es un bit. Podemos producir esa distribución mediante un mecanismo en el que el primer bit causa una copia en el segundo.
También podemos producirla mediante una fuente oculta que genera ambos bits, sin influencia directa entre ellos. Las dos construcciones dan la misma distribución observacional de la pareja y, con ella, la misma información mutua.
Una intervención que cambie el primer bit tendría consecuencias diferentes en los dos mecanismos. En el primero puede cambiar la copia; en el segundo puede dejar intacta la otra salida de la fuente común. Con solo la distribución observada no podemos distinguir esas respuestas.
La información mutua, por ser simétrica, tampoco indica una dirección. Las diferencias entre entropías marginales o condicionales no resuelven, en general, esa limitación. Para estudiar causalidad necesitamos supuestos, diseño o información adicional sobre mecanismos.
Una dependencia temporal puede ser útil para predecir, pero tampoco demuestra transmisión directa. Una señal adelantada puede reflejar una causa común, una periodicidad compartida o un proceso de medición con demoras distintas.
Condicionar a variables conocidas puede ayudar a examinar alternativas, aunque no garantiza eliminar todas las variables omitidas ni evita sesgos de selección. La elección de qué controlar necesita una hipótesis causal, además de un cálculo informacional.
Conviene separar tres preguntas. La primera es si una observación cambia las probabilidades de otra; la segunda, si mejora una predicción bajo condiciones de uso; la tercera, qué ocurriría si interviniéramos sobre el sistema. Cada una requiere evidencia específica.
Un resultado informacional puede ser útil sin responder a la tercera, porque puede orientar la compresión, el diseño de sensores o la detección de relaciones que merecen estudio. Ser preciso exige presentar ese alcance sin convertirlo en una causalidad que no se identificó.
203.9. El problema de estimar dependencia con pocos datos
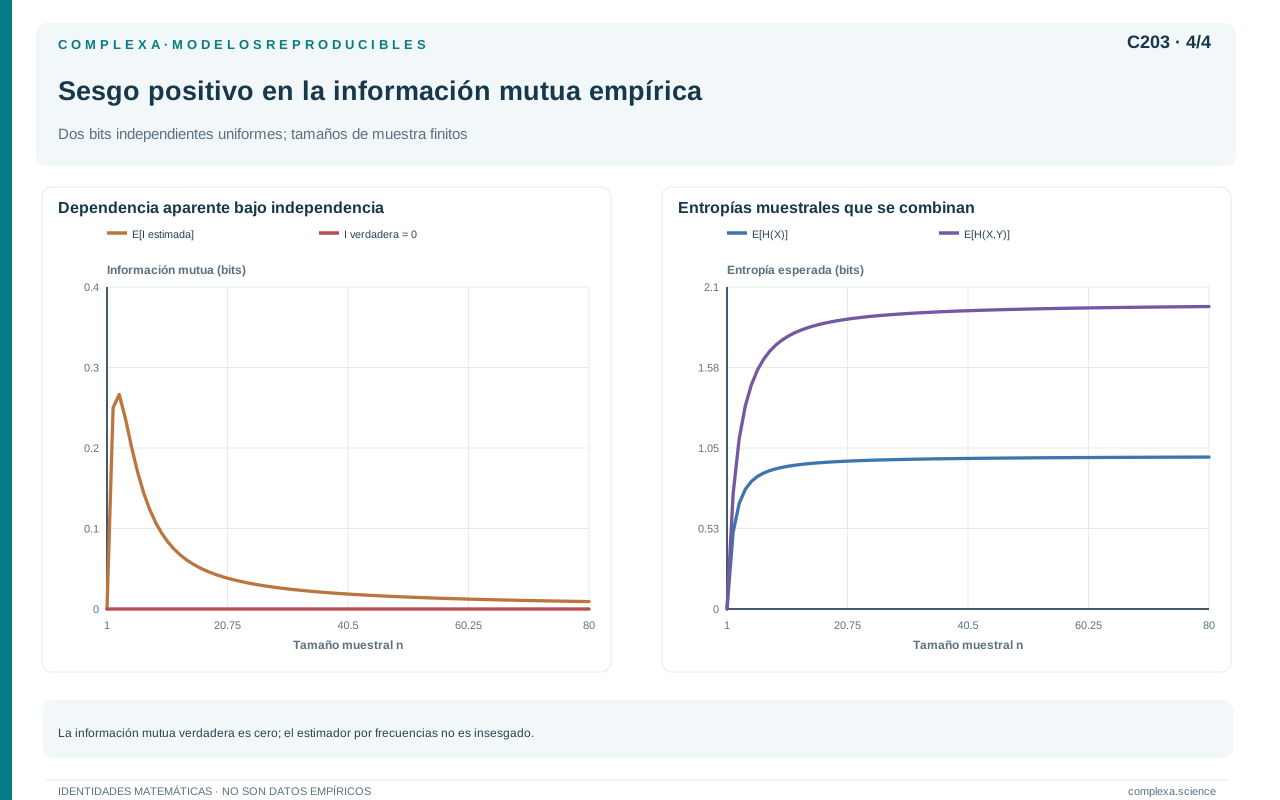
La información mutua verdadera es cero bajo independencia. Sin embargo, una estimación basada en frecuencias de una muestra finita suele ser positiva incluso cuando las variables son independientes. Las fluctuaciones de las celdas crean asociaciones aparentes.
Podemos calcular un ejemplo mínimo. Observamos dos parejas independientes de bits, cada una formada por dos bits independientes y equiprobables. La distribución poblacional tiene información mutua cero.
Si las dos observaciones difieren en ambos bits, la tabla empírica contiene dos parejas que forman una correspondencia perfecta. Las marginales empíricas tienen un bit y la entropía conjunta empírica también un bit, por lo que la información mutua estimada es uno.
Si las observaciones coinciden por completo o cambian solamente uno de los bits, al menos una marginal empírica es constante y la estimación es cero. La probabilidad de diferir en ambos bits es un cuarto.
Por tanto, la información mutua empírica esperada es un cuarto de bit aunque la verdadera sea cero. La cuenta exacta muestra el sesgo sin recurrir a simulaciones ni a estimadores avanzados.
Con más datos, el problema depende del número de categorías y de la complejidad de la distribución. Aumentar la resolución crea más celdas y puede aumentar el sobreajuste. Buscar entre muchas variables también incrementa la posibilidad de seleccionar una dependencia aparente.
Una prueba por permutación puede construir una referencia de independencia en diseños apropiados. Debe respetar la estructura de muestreo, porque permutar indiscriminadamente registros temporales o repetidos puede destruir dependencias que el modelo nulo necesitaba conservar.
La validación fuera de muestra ayuda a distinguir relaciones reproducibles de adaptaciones al conjunto observado. También conviene comparar estimadores, resoluciones y modelos alternativos cuando esas decisiones afectan la conclusión.
Un valor cercano a cero no demuestra ausencia de toda dependencia si los datos son insuficientes. Un valor positivo no demuestra una relación estable si carece de evaluación de incertidumbre. La inferencia requiere considerar potencia, sesgo, selección y contexto.
El módulo dedicado a estimación tratará estos problemas con detalle. Aquí basta conservar la diferencia entre una cantidad poblacional bien definida y un número producido por un procedimiento sobre una muestra particular.
La información mutua empírica también puede escribirse como una comparación de verosimilitudes. En una tabla de conteos, el modelo conjunto sin restricciones reproduce las frecuencias observadas. El modelo de independencia usa el producto de las marginales empíricas.
La diferencia entre sus logaritmos de verosimilitud, usando logaritmos naturales, es el número de observaciones multiplicado por la información mutua empírica y por el logaritmo natural de dos. Si duplicamos esa diferencia, obtenemos el estadístico habitual de razón de verosimilitudes para la tabla.
La identidad puede comprobarse sustituyendo cada probabilidad empírica por su conteo dividido por el total. También muestra por qué una información positiva indica que permitir dependencia mejora el ajuste de esos mismos datos.
Sin embargo, el modelo conjunto tiene más libertad, de modo que mejorar el ajuste dentro de la muestra no demuestra que su estructura adicional generalice. La interpretación inferencial necesita considerar tamaño, celdas escasas, restricciones y procedimiento de selección. Una prueba asintótica tampoco debe aplicarse sin justificación a la muestra mínima de dos observaciones.
Esta relación conecta información y aprendizaje sin confundirlos. La cantidad informacional describe una ganancia de ajuste bajo distribuciones especificadas; la elección de un modelo predictivo añade un problema de estimación, complejidad y validación.
203.10. Elegir el objetivo antes de interpretar la medida
La información mutua permite expresar cuánto cambia una observación la incertidumbre sobre otra variable. Su ventaja es una definición general de dependencia que no exige linealidad y que conserva relaciones precisas con entropías y distribuciones.
Los ejemplos mostraron que una señal variable puede no informar sobre un objetivo, una relación determinista puede perder parte de la entrada y una predicción casi siempre correcta puede no usar información alguna. También mostraron que el contexto puede revelar o eliminar dependencia.
Para interpretar un valor necesitamos declarar variables, población, resolución y conocimiento disponible. Si el objetivo es una decisión, debemos añadir una función de pérdida; si es causal, una estrategia que identifique intervenciones; si es compresión, un modelo de representación.
Esas decisiones siguen siendo necesarias; la información mutua las organiza. En particular, nos obliga a distinguir cuánto varía un registro de cuánto informa sobre algo concreto; también, cuánto informa una observación aislada de cuánto añade después de otras.
La expresión que compara una distribución conjunta con el producto de sus marginales introduce una idea más general, la de medir la discrepancia entre distribuciones mediante probabilidades relativas. El próximo capítulo desarrollará esa idea con la divergencia de Kullback–Leibler y su relación con aprendizaje y actualización de modelos.
Referencias
- Shannon, C. E. (1948). A mathematical theory of communication. The Bell System Technical Journal, 27(3), 379–423. DOI.
- Kullback, S., y Leibler, R. A. (1951). On information and sufficiency. The Annals of Mathematical Statistics, 22(1), 79–86. DOI.
- Kinney, J. B., y Atwal, G. S. (2014). Equitability, mutual information, and the maximal information coefficient. Proceedings of the National Academy of Sciences, 111(9), 3354–3359. DOI.