COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 21. Teoría de la información: incertidumbre, dependencia y representación
204.1. Comparar distribuciones que responden a la misma pregunta
Dos modelos pueden reconocer los mismos resultados posibles y asignarles probabilidades distintas. Uno puede concentrarse en un evento dominante; otro puede distribuir más incertidumbre entre alternativas. Para compararlos necesitamos una cantidad que conserve qué distribución genera o describe los resultados y cuál usamos como referencia.
La divergencia de Kullback–Leibler cuantifica una discrepancia orientada entre distribuciones. Aparece al evaluar predicciones probabilísticas, representar datos con un código inadecuado, actualizar creencias y aproximar modelos complejos. Su significado concreto depende de qué papel asignamos a cada argumento.
Preguntar cuánto cuesta usar una distribución de referencia cuando los resultados siguen otra no es lo mismo que intercambiar sus papeles. Por eso la divergencia no es una distancia geométrica ordinaria.
En este capítulo usaremos distribuciones discretas finitas y algunos ejemplos continuos explícitos. Distinguiremos identidad matemática, interpretación operacional y estimación desde datos. Que una fórmula sea exacta no elimina la incertidumbre sobre las distribuciones que introducimos en ella.
También separaremos actualización y mejora. Una observación puede cambiar mucho un modelo sin convertirlo en una explicación correcta del mundo. Una posterior muy concentrada puede reflejar supuestos restrictivos, datos mal representados o una familia que excluye alternativas relevantes.
El objetivo es comprender qué mide la divergencia y cómo usarla sin atribuirle propiedades que no tiene. La conexión con la información mutua será directa, porque allí comparamos una distribución conjunta con el producto de sus marginales; ahora permitiremos referencias más generales.
204.2. Definición, orientación y soporte
Para dos distribuciones y sobre las mismas categorías, definimos
El promedio se toma bajo . Esa distribución determina qué resultados pesan más en la comparación. La referencia aparece dentro del cociente y es la alternativa con la que contrastamos esas probabilidades.
Si una categoría tiene probabilidad cero bajo , su contribución se toma como cero. Si tiene probabilidad positiva bajo y cero bajo , la divergencia es infinita. La referencia ha declarado imposible un resultado que la distribución evaluada considera posible.
Por tanto, para que la divergencia sea finita en un alfabeto finito, debe asignar probabilidad positiva a todos los resultados que pueden ocurrir bajo . Puede asignar masa a categorías adicionales, pero esa masa reduce lo disponible para las demás.
Consideremos una distribución que produce siempre cero y otra que produce cero o uno con igual probabilidad. La divergencia de la primera respecto de la segunda es un bit. La divergencia inversa es infinita porque la segunda produce unos que la primera excluye.
El infinito del ejemplo procede de una incompatibilidad específica de soporte. En modelos de datos, esa incompatibilidad puede introducirse artificialmente al tratar frecuencias no observadas como imposibilidades.
La base del logaritmo determina la unidad. Con base dos hablamos de bits; con logaritmos naturales, de nats. Cambiar de unidad multiplica por una constante y no modifica qué distribuciones minimizan una divergencia.
El orden de los argumentos debe escribirse y explicarse. Expresiones como «la KL entre dos modelos» son incompletas si no indican cuál ocupa cada papel. Dos análisis pueden usar los mismos modelos y obtener resultados distintos porque optimizan orientaciones diferentes.
La divergencia compara distribuciones completas. Dos modelos con medias y varianzas semejantes pueden asignar probabilidades muy distintas a eventos específicos y producir una discrepancia informacional importante.
204.3. No negatividad sin convertirla en distancia
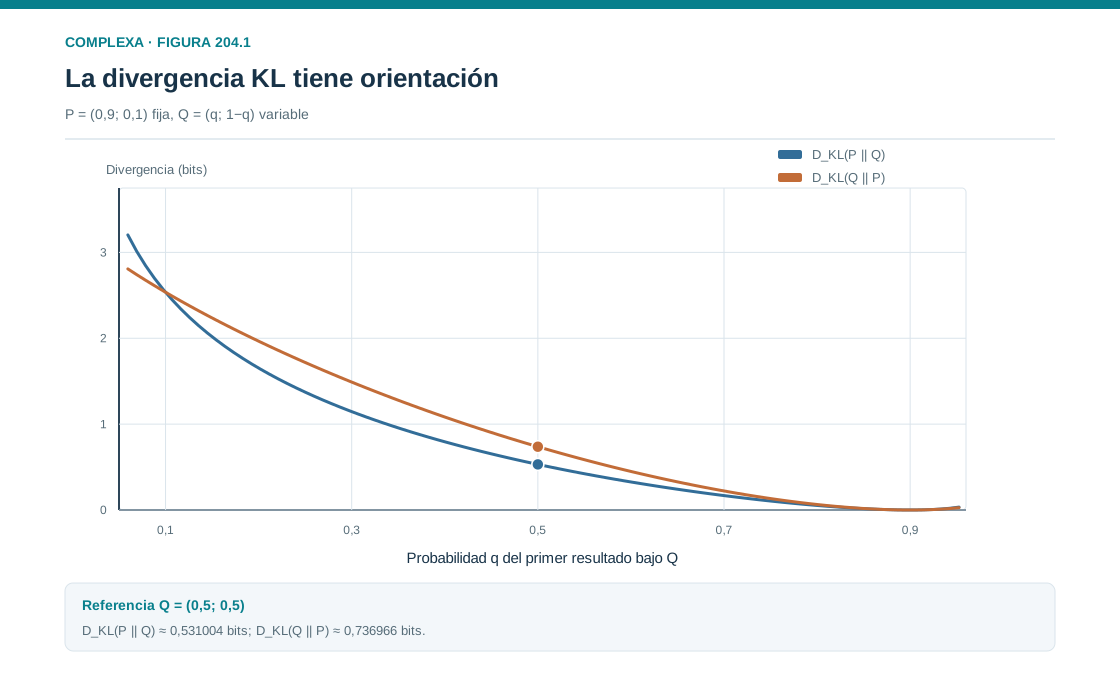
La divergencia de Kullback–Leibler es no negativa y se anula cuando ambas distribuciones coinciden, salvo diferencias en conjuntos de probabilidad nula pertinentes. Esta propiedad no exige que cada término de la suma sea positivo.
Si una referencia asigna más probabilidad que a una categoría, el logaritmo del cociente en esa categoría es negativo. Otras categorías compensan esa contribución cuando promediamos con la distribución completa.
Una demostración usa la desigualdad . Aplicándola al cociente en el soporte de , sumando con pesos y cambiando el signo, obtenemos una cota inferior no negativa. La igualdad exige coincidencia de las probabilidades correspondientes y ausencia de masa adicional incompatible.
La no negatividad no convierte la divergencia en una métrica, ya que en general no es simétrica ni satisface la desigualdad triangular.
Para una variable binaria, tomemos y . La divergencia de respecto de es aproximadamente bits. En sentido inverso es aproximadamente bits.
Las categorías son las mismas y las diferencias de probabilidad tienen las mismas magnitudes, pero cambia la ponderación. La dirección que espera resultados equiprobables penaliza de otra manera la concentración de la referencia en una de las categorías.
También podemos comprobar que falla la desigualdad triangular. Para distribuciones binarias con probabilidades de uno de , y , la divergencia directa de la primera a la tercera es aproximadamente bits.
La suma de las divergencias pasando por la segunda es aproximadamente bits, menor que la divergencia directa. Por tanto, sería incorrecto leer la divergencia como la longitud de un trayecto geométrico que cumple aquella desigualdad.
Hay otras cantidades simétricas y otras geometrías informacionales, pero deben definirse por separado. Simetrizar una divergencia no garantiza todas las propiedades de una distancia. La elección depende de la comparación que necesitamos hacer.
204.4. Entropía cruzada y evaluación probabilística
Definimos la entropía cruzada de respecto de como
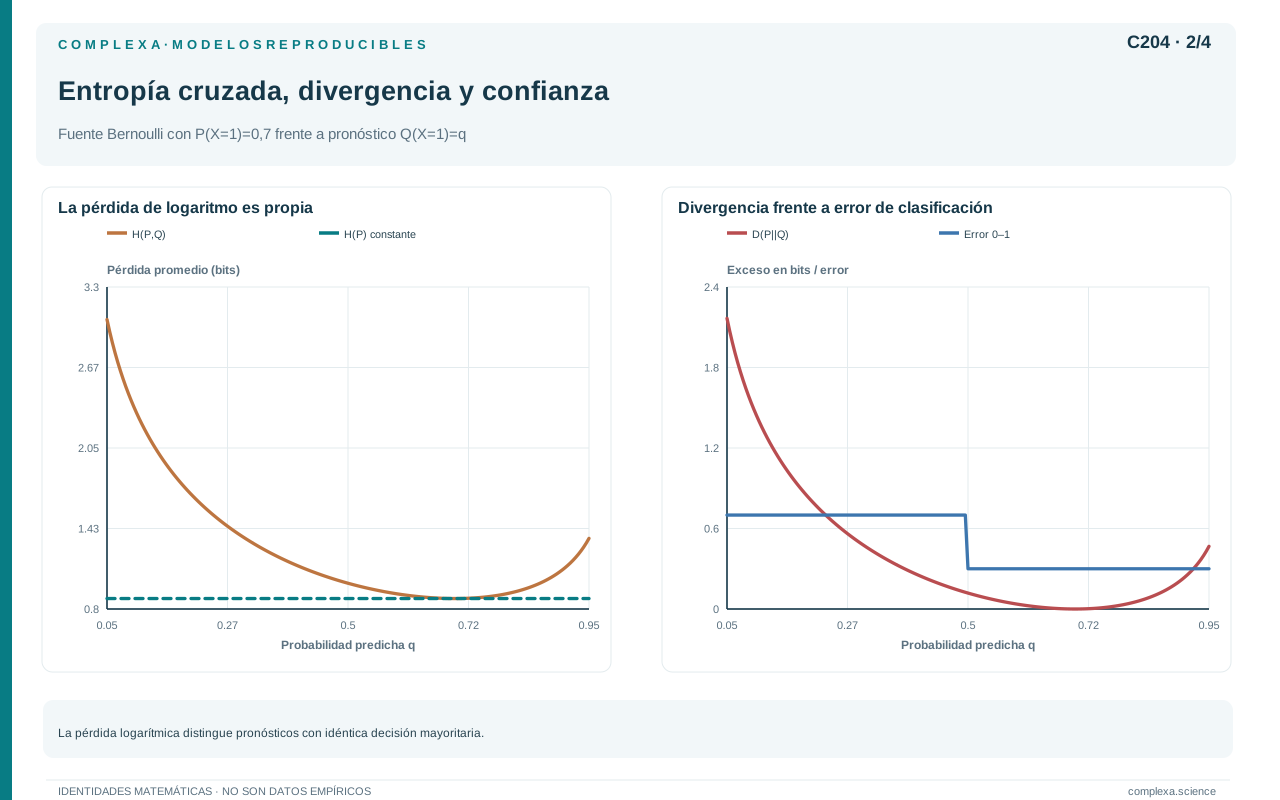
Es la sorpresa promedio que asigna el modelo a resultados distribuidos según . Al separar el logaritmo del cociente, obtenemos
La entropía propia de es el componente que permanece incluso si usamos las probabilidades correctas. La divergencia mide el exceso que produce usar la referencia bajo esa evaluación.
Si está fija, minimizar la entropía cruzada equivale a minimizar su divergencia respecto de . El mínimo ideal se alcanza en , siempre que esa distribución esté disponible en la familia de modelos.
Esta relación justifica la evaluación mediante pérdida logarítmica. Un pronóstico que asigna poca probabilidad a lo que ocurre recibe una pérdida grande. Bajo las condiciones pertinentes, comunicar las probabilidades verdaderas minimiza en promedio esa pérdida esperada.
Gneiting y Raftery estudian las reglas de puntuación propias y su uso para predicción y estimación. Que una regla sea propia significa que incentiva una declaración probabilística coherente bajo una distribución; no garantiza que un modelo concreto conozca esa distribución.
Podemos comparar dos pronósticos para una fuente con probabilidades y . El pronóstico correcto tiene pérdida promedio de aproximadamente bits. El pronóstico uniforme tiene un bit. El exceso coincide con la divergencia de aproximadamente bits.
El error de clasificación puede ocultar esa diferencia. Tanto un pronóstico de como otro de para la categoría dominante eligen la misma categoría bajo una decisión de máximo, aunque expresan niveles de confianza distintos y reciben puntuaciones logarítmicas diferentes.
La regla logarítmica penaliza especialmente asignaciones extremas equivocadas. Eso puede ser apropiado para evaluar distribuciones, pero no sustituye una función de costos específica de una decisión. Pasar de un buen pronóstico a una buena decisión exige resolver un problema adicional.
En codificación, las longitudes ideales de un código basado en son el logaritmo negativo de sus probabilidades; su costo promedio bajo es la entropía cruzada. La interpretación exacta requiere códigos realizables, bloques y costos de descripción, que desarrollaremos después.
La interpretación de exceso de pérdida se extiende a bloques independientes. Si tanto la distribución evaluada como la referencia son productos de la misma distribución individual, la divergencia del bloque es el número de posiciones multiplicado por la divergencia de una posición.
Para cien resultados independientes de la fuente con probabilidades y , usar una referencia uniforme añade aproximadamente bits de pérdida esperada respecto del modelo correcto. Esa cifra es un promedio sobre muestras; la diferencia en cada archivo o experimento varía.
Una realización puede favorecer al modelo que, en promedio, es peor. Si ocurren muchos resultados que la fuente verdadera considera raros, la referencia uniforme puede asignarles mayor probabilidad. La razón de verosimilitudes de esa muestra puede apuntar en sentido contrario al de su esperanza.
La no negatividad de la divergencia, que es una propiedad de un promedio bajo una distribución especificada, no prohíbe esas realizaciones. Para interpretar una única diferencia de puntuaciones hay que considerar cuánta variación cabe esperar entre muestras y cómo se seleccionó la muestra observada.
204.5. De muestras a modelos ajustados
Supongamos observaciones independientes provenientes de una misma distribución y una familia de modelos . La verosimilitud de una muestra es el producto de las probabilidades que el modelo asigna a sus resultados.
El logaritmo convierte ese producto en una suma. Dividir el logaritmo negativo por el tamaño de la muestra produce la pérdida logarítmica empírica, que puede escribirse como entropía cruzada entre la distribución de frecuencias observadas y el modelo.
Como la entropía de la distribución empírica no depende del parámetro del modelo, maximizar verosimilitud equivale a minimizar
La identidad es exacta para esa formulación. Su interpretación como aproximación a la divergencia poblacional requiere condiciones de muestreo, tamaño y regularidad. No debemos sustituir la distribución verdadera por la empírica y olvidar que la segunda fluctúa.
Una familia muy flexible puede reproducir perfectamente los datos observados y asignar probabilidades demasiado pequeñas a resultados futuros. Reducir divergencia dentro de la muestra no garantiza mejorar predicción fuera de ella.
Las restricciones y la regularización buscan controlar ese problema, aunque introducen otras decisiones. La familia puede ser demasiado simple y no representar dependencias reales, o demasiado flexible para la información disponible. La evaluación debe considerar ambos riesgos.
Si la familia no contiene la distribución verdadera, el mejor modelo según esta orientación es una proyección informacional sobre el conjunto permitido, bajo condiciones apropiadas. No se convierte por ello en una descripción exacta del mecanismo generador.
Las muestras dependientes o las distribuciones que cambian en el tiempo requieren otra formulación de la verosimilitud. Multiplicar marginales como si las observaciones fueran independientes puede fabricar un criterio distinto del que corresponde al proceso.
Para comparar modelos conviene conservar datos de evaluación y registrar cómo se eligieron variables, transformaciones e hiperparámetros. Si todas esas decisiones se adaptan al mismo conjunto, la pérdida observada puede reflejar selección adicional que una cifra de ajuste no muestra.
La divergencia da una interpretación clara de ciertas funciones objetivo, pero no resuelve el problema del diseño estadístico ni convierte automáticamente una optimización numérica en conocimiento del sistema.
La aditividad para productos tiene una extensión condicionada. Si comparamos distribuciones de una pareja, la divergencia conjunta se descompone en la divergencia de la primera marginal más la divergencia entre las condicionales de la segunda, promediada con la primera marginal de .
La identidad procede de factorizar ambas distribuciones conjuntas y separar los logaritmos. Los pesos del segundo término son los de . Cuando las condicionales coinciden, toda la discrepancia conjunta reside en la marginal.
Aplicar repetidamente esta regla a una secuencia produce una suma de discrepancias predictivas condicionadas al pasado. Si hay memoria, cada término necesita la historia pertinente y su distribución bajo el modelo evaluado. Sustituir esas condicionales por marginales elimina precisamente la estructura que podría diferenciar a los modelos.
Esta suma no contradice la falta de aditividad de cambios entre distribuciones posteriores que veremos después. En un caso descomponemos una misma comparación de distribuciones conjuntas; en el otro comparamos sucesivamente objetos probabilísticos distintos.
La divergencia permite separar errores marginales y omisión de dependencia. Para una distribución conjunta y una referencia independiente , se cumple
La demostración introduce el producto de las marginales verdaderas dentro del cociente y separa tres logaritmos. El primer término mide la dependencia ignorada; los otros miden discrepancias de las marginales.
Si comparamos la tabla binaria del capítulo anterior con una referencia uniforme sobre cuatro parejas, obtenemos aproximadamente bits. De ellos, corresponden a dependencia y cerca de a que la marginal de no es uniforme.
Por tanto, una divergencia respecto de una referencia uniforme no equivale en general a la información mutua. Para aislar esta última, la referencia independiente debe conservar las marginales de la distribución conjunta. Elegir otra referencia mezcla preguntas diferentes en una sola cifra.
204.6. Actualización bayesiana de probabilidades sobre hipótesis
En una actualización bayesiana distinguimos una variable de hipótesis o parámetros, una distribución previa y una verosimilitud de los datos bajo cada hipótesis. Al observar un resultado, la posterior es proporcional al producto de previa y verosimilitud.
Podemos medir cuánto cambió la distribución mediante la divergencia de la posterior respecto de la previa. El promedio se toma entonces sobre la posterior, mientras que en el ajuste de frecuencias de la sección anterior se tomaba sobre la distribución de los datos.
Consideremos dos hipótesis sobre una fuente binaria; según una, produce unos con probabilidad y, según la otra, con probabilidad . Asignamos a ambas hipótesis probabilidad previa de un medio. La probabilidad predictiva inicial de observar uno es también un medio.
Si observamos un uno, las probabilidades posteriores de las dos hipótesis son y . La divergencia de esa posterior respecto de la previa uniforme es aproximadamente bits.
Ese valor cuantifica un cambio probabilístico sobre la hipótesis y es distinto de la sorpresa del dato, que vale un bit bajo la predicción inicial. Un resultado puede ser sorprendente por variación inherente a las hipótesis sin permitir distinguirlas completamente.
Si observamos dos unos, condicionalmente independientes dada la hipótesis, las verosimilitudes son y . La posterior queda en proporción uno a dieciséis, con probabilidades y .
La divergencia respecto de la previa inicial es entonces aproximadamente bits. La repetición de un resultado favorece más fuertemente a la hipótesis que lo hace probable, bajo la independencia condicional especificada.
Una previa que asigna probabilidad cero a una hipótesis no puede darle masa posterior mediante una actualización ordinaria con verosimilitudes finitas.
Si todos los modelos admitidos asignan probabilidad cero al dato observado, la normalización bayesiana falla. Necesitamos revisar la familia o el modelo de observación.
La fórmula de Bayes permite expresar el cambio de distribución de otra manera. El cociente entre posterior y previa es la verosimilitud del dato bajo cada hipótesis dividida por la probabilidad predictiva del dato. Al tomar logaritmos y promediar con la posterior,
La sorpresa predictiva del dato aparece en el segundo término, pero se combina con el promedio posterior de su verosimilitud. No toda sorpresa distingue hipótesis; parte de ella puede corresponder a variación que todas consideran igualmente improbable.
En el ejemplo de una observación igual a uno, el promedio de logaritmos de verosimilitud es aproximadamente menos bits y la sorpresa predictiva es un bit. La diferencia da la divergencia de bits.
Para un par de resultados diferentes, ambas hipótesis asignan probabilidad . Ese par puede ser relativamente poco probable, pero no discrimina entre las hipótesis. Los términos de la identidad se cancelan y la posterior permanece igual a la previa inicial.
204.7. Aprender en promedio no significa avanzar igual en cada trayectoria
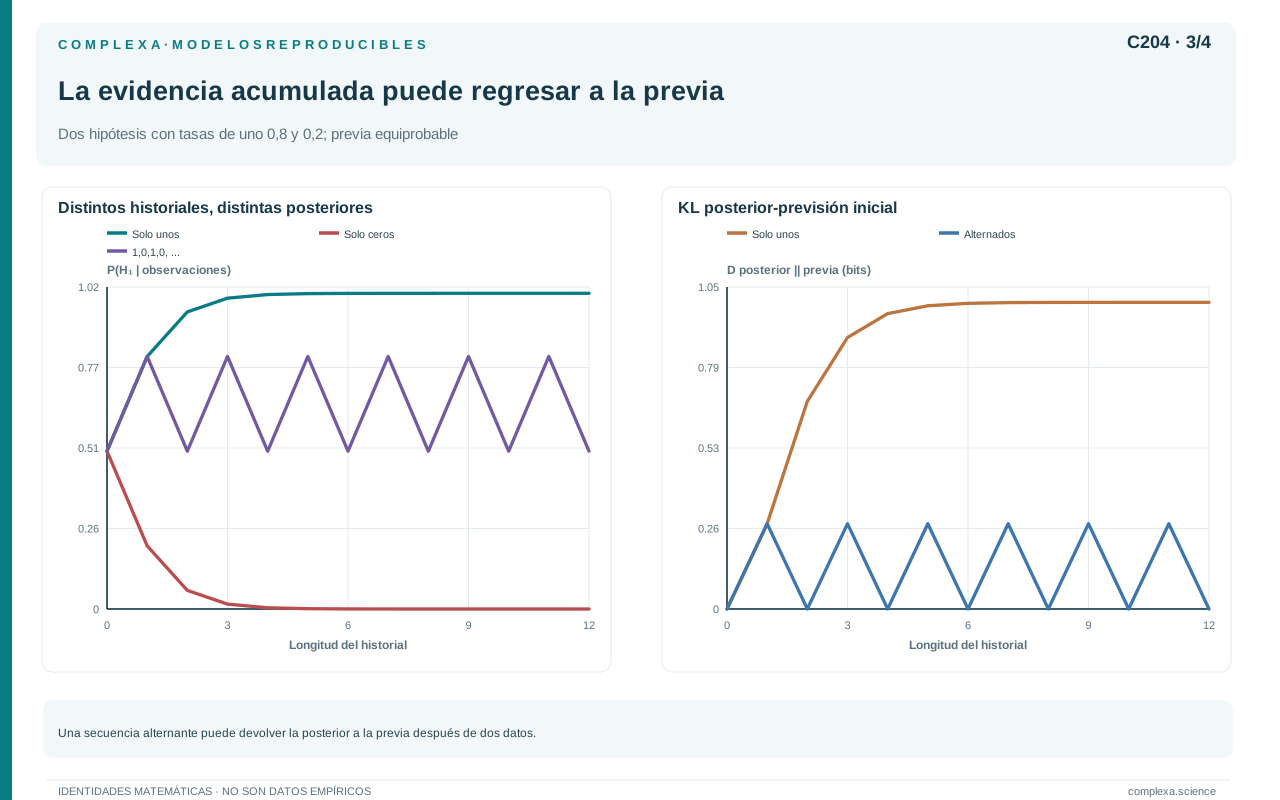
Volvamos a las dos hipótesis de probabilidades y . Si después de un uno observamos un cero, ambas hipótesis asignan al par ordenado la misma probabilidad, , y la posterior vuelve a ser uniforme.
La divergencia respecto de la previa inicial es ahora cero, aunque la primera observación la había elevado. Esto es compatible con una ganancia esperada de información al ampliar el experimento, porque se trata de una sola realización, en la que la evidencia acumulada no discrimina entre esas dos hipótesis simétricas.
La divergencia entre la posterior final y la intermedia vale, en cambio, aproximadamente bits. De ahí que sumar cambios de divergencia entre actualizaciones no reproduzca en general la divergencia entre el comienzo y el final.
En la falta de aditividad intervienen la orientación y el cambio, de una etapa a otra, de la distribución que pondera la comparación. La divergencia no mide una distancia recorrida que pueda sumarse como longitud de un camino.
El promedio sobre resultados posibles tiene otra estructura. La divergencia posterior-previa esperada coincide con la información mutua entre la hipótesis y los datos, bajo el modelo conjunto formado por previa y verosimilitud.
La ausencia de discriminación del par diferente es propia de la familia de dos hipótesis elegida. Si incorporáramos una tercera fuente con probabilidad de uno igual a un medio, ese par tendría verosimilitud de un cuarto bajo la nueva alternativa, frente a bajo las anteriores, y podría entonces modificar las probabilidades relativas. Decir que un dato no da información requiere especificar sobre qué alternativas se está aprendiendo.
En el ejemplo, los dos resultados iguales tienen probabilidad total y producen la divergencia de aproximadamente . Los resultados diferentes tienen probabilidad total y producen divergencia cero. La ganancia esperada con dos observaciones es aproximadamente bits.
Con una sola observación, la ganancia esperada era aproximadamente bits. El experimento más largo da más información en promedio, aunque algunas trayectorias concretas regresen a la distribución previa.
Lindley formuló el valor informacional esperado de un experimento en un contexto bayesiano. Esa perspectiva permite comparar diseños que podrían distinguir hipótesis, siempre bajo las probabilidades y costos que el análisis especifica.
Maximizar información esperada sobre un parámetro no siempre maximiza utilidad práctica. Un experimento puede precisar un parámetro que apenas modifica una decisión, mientras otro aclara una alternativa de consecuencias importantes. La elección del objetivo sigue siendo parte del diseño.
204.8. Divergencia en variables continuas y modelos aproximados
Para densidades compatibles, la divergencia se escribe mediante una integral del cociente de densidades. Una formulación más general usa distribuciones como medidas y exige que la primera no asigne masa a conjuntos imposibles bajo la segunda.
La divergencia conserva su valor bajo transformaciones invertibles aplicadas a ambas distribuciones, con las condiciones pertinentes. Los factores del cambio de coordenadas se cancelan. Esto contrasta con la dependencia de unidades de una entropía diferencial individual.
Para dos distribuciones gaussianas unidimensionales, con medias y desviaciones positivas , la divergencia en nats es
Si ambas varianzas son uno y las medias difieren en una unidad, la divergencia es medio nat, aproximadamente bits. En este caso particular la expresión es simétrica porque solo cambia una diferencia de medias al cuadrado con igual escala.
Si cambian las varianzas, reaparece la asimetría. Una distribución estrecha evaluada con una referencia amplia y la comparación inversa ponderan de manera distinta los resultados alejados del centro.
Las aproximaciones de modelos pueden minimizar diferentes orientaciones de divergencia. No debemos asumir que todas seleccionan la misma distribución ni describir sus comportamientos mediante una regla universal sobre cubrir o ignorar modos.
El resultado depende de la familia permitida, las restricciones y el soporte. Si una aproximación excluye regiones donde el objetivo tiene probabilidad positiva, una orientación puede ser infinita mientras la inversa sea finita. Cambiar la orientación cambia el problema de optimización.
Otra cuestión es si podemos calcular las densidades y sus constantes de normalización. Una expresión formal para la divergencia puede contener integrales o esperanzas difíciles. La elección de un método computacional añade aproximaciones que deben distinguirse de la definición matemática.
En datos continuos, discretizar puede facilitar cálculos pero modifica la comparación. Una divergencia entre histogramas no equivale en general a la divergencia entre las densidades originales. La resolución y el tratamiento de regiones poco observadas necesitan evaluación.
Podemos calcular la asimetría gaussiana con medias iguales a cero y varianzas uno y cuatro. La divergencia de la distribución estrecha respecto de la amplia es aproximadamente nats, equivalentes a bits.
En sentido inverso es aproximadamente nats, equivalentes a bits. La referencia estrecha penaliza más los valores alejados que la distribución amplia produce con mayor frecuencia. La comparación incorpora toda esa ponderación, que una simple diferencia entre varianzas no recoge.
La orientación también puede cambiar qué aproximación preferimos dentro de un conjunto finito. Tomemos una distribución binaria objetivo con probabilidad de uno de y dos candidatos con probabilidades y .
Al minimizar la divergencia del objetivo respecto del candidato, resulta preferible el candidato de . Al minimizar la orientación inversa, resulta preferible el de . Con los mismos candidatos y el mismo objetivo, solo cambió la distribución con la que ponderamos los resultados.
El ejemplo da al contraste entre orientaciones un contenido preciso, que puede comprobarse sustituyendo cuatro pares de probabilidades en la misma fórmula. Una función objetivo distinta puede conducir a una solución distinta aun en el problema binario más elemental.
204.9. Ceros, eventos raros y evaluación fuera de muestra
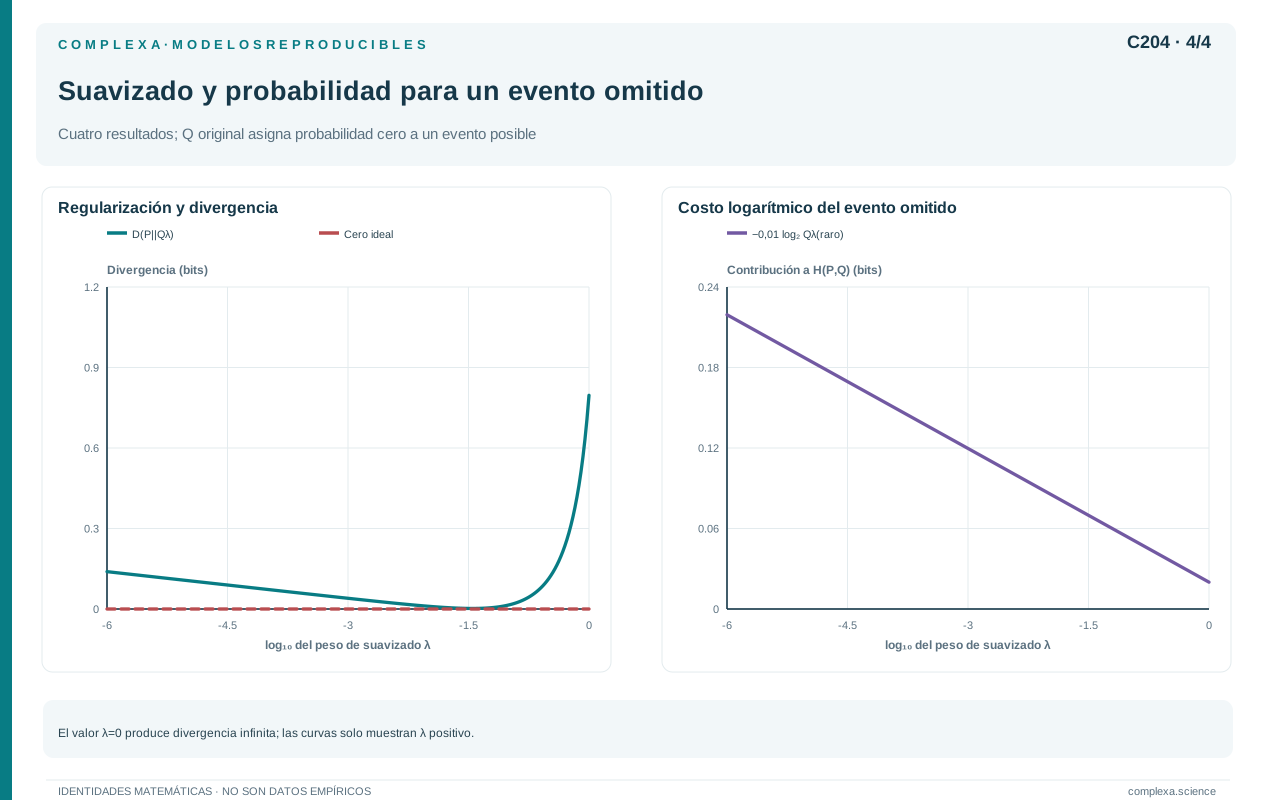
Asignar probabilidades extremadamente pequeñas puede dominar la pérdida cuando ocurre un resultado raro. Esa sensibilidad, que es parte de la definición logarítmica, convierte el tratamiento de los ceros en una decisión sustantiva.
Añadir una pequeña cantidad a todos los conteos evita algunos ceros, pero modifica la distribución y supone una regularización. Su magnitud debe justificarse o examinarse mediante un análisis de sensibilidad. Una constante elegida solo para que el programa no falle puede alterar comparaciones importantes.
El soporte debe definirse con conocimiento del problema. Algunas combinaciones son imposibles por construcción y otras simplemente no aparecieron en la muestra. Tratar ambos casos de la misma manera puede desperdiciar estructura conocida o producir una confianza injustificada.
Una divergencia promedio pequeña tampoco garantiza buen comportamiento en todos los subgrupos. Los eventos de baja probabilidad reciben poco peso en el valor esperado, aunque sus consecuencias sean grandes. Si esos eventos importan, necesitamos analizarlos explícitamente y considerar una función de decisión.
La evaluación fuera de muestra compara probabilidades asignadas antes de conocer los resultados de prueba. Reajustar el modelo después de observarlos y presentar la nueva pérdida como si fuera predictiva elimina esa separación.
También debemos comprobar que la distribución de evaluación corresponda a las condiciones de uso. Un modelo puede rendir bien sobre una mezcla de grupos y mal cuando cambia su composición. La divergencia se calcula respecto de una distribución concreta y fuera de ella no da garantías.
Las diferencias de pérdida entre modelos deben acompañarse de incertidumbre que respete el muestreo. Resultados repetidos, series temporales y agrupaciones pueden producir dependencias que una cuenta ingenua de observaciones no recoge.
Una comparación es más útil cuando muestra dónde difieren los modelos. Una cifra global puede resumir el rendimiento; las contribuciones por resultados o condiciones ayudan a identificar sesgos y fallos de soporte.
Un modelo bayesiano sencillo permite interpretar una forma concreta de suavizado. Para una probabilidad binaria desconocida, una previa uniforme sobre el intervalo de cero a uno y observaciones independientes producen una probabilidad predictiva de uno igual a , donde es el número de unos observados.
Si observamos diez ceros, la predicción para un uno futuro es un doceavo. La regla expresa una hipótesis previa y una verosimilitud concretas; aplicarla a otro registro exige que esos supuestos también valgan allí.
Otra previa o un modelo temporal producirían otra predicción. Cuando presentamos un valor regularizado, conviene explicar su procedencia y evaluar la sensibilidad si afecta a la conclusión. Evitar infinitos numéricos es una consecuencia útil, pero la justificación principal debe ser probabilística.
La sobreconfianza puede evaluarse sin cambiar la categoría predicha. Si una fuente produce el evento dominante con probabilidad y un modelo anuncia , ambos eligen la misma categoría bajo decisión de máximo. Sin embargo, cuando ocurre la alternativa, el modelo sobreconfiado asigna una sorpresa de aproximadamente bits, frente a bajo la probabilidad correcta.
La pequeña mejora de puntuación en resultados frecuentes no compensa esa penalización en promedio. El exceso de pérdida respecto del modelo correcto es la divergencia, de aproximadamente bits. La cuenta separa la exactitud de las decisiones de la calidad de las probabilidades.
Para comparar dos modelos sobre datos de prueba, tampoco es necesario estimar por separado la entropía de la distribución verdadera. Al restar sus entropías cruzadas, ese término común se cancela. Podemos promediar directamente el logaritmo de la razón de las dos probabilidades asignadas a cada resultado.
La simplificación no elimina la incertidumbre de muestreo, que pesa más si algunos cocientes son extremos, pero permite formular una comparación predictiva concreta sin introducir un estimador adicional de entropía que podría ser difícil o innecesario para esa pregunta.
204.10. Una discrepancia con una pregunta definida
La divergencia de Kullback–Leibler compara distribuciones mediante un promedio orientado de probabilidades relativas. Su no negatividad permite relacionarla con exceso de pérdida logarítmica, ajuste de modelos e información esperada de experimentos.
Los ejemplos mostraron por qué no debe tratarse como una distancia ordinaria. La orientación cambia resultados, el soporte puede producir infinitos y las actualizaciones sucesivas no suman una longitud de aprendizaje. Una ganancia esperada no exige crecimiento monótono en cada realización.
Para usarla debemos identificar las variables sobre las que se distribuye la probabilidad y el papel de cada argumento. Una divergencia entre distribuciones de datos, otra entre hipótesis y otra entre una posterior y su aproximación pueden usar la misma fórmula y responder a preguntas distintas.
La actualización conserva además los límites de la familia elegida. Ninguna fórmula sustituye la revisión de supuestos cuando los datos quedan fuera del modelo. La precisión probabilística necesita una representación adecuada de posibilidades y observaciones.
El próximo capítulo estudiará qué ocurre cuando transformamos o reducimos los datos. Las relaciones entre divergencia, condicionamiento y representación permitirán demostrar límites sobre la información que una transformación puede conservar o perder.
Referencias
- Kullback, S., y Leibler, R. A. (1951). On information and sufficiency. The Annals of Mathematical Statistics, 22(1), 79–86. DOI.
- Lindley, D. V. (1956). On a measure of the information provided by an experiment. The Annals of Mathematical Statistics, 27(4), 986–1005. DOI.
- Gneiting, T., y Raftery, A. E. (2007). Strictly proper scoring rules, prediction, and estimation. Journal of the American Statistical Association, 102(477), 359–378. DOI.