COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 21. Teoría de la información: incertidumbre, dependencia y representación
209.1. Inferir cuando la información es incompleta
Conocer algunas propiedades de un sistema rara vez determina una distribución completa. Podemos conocer los estados posibles y una media, pero desconocer las probabilidades individuales, o conocer las frecuencias marginales de varias variables sin conocer sus dependencias. El principio de máxima entropía propone construir una distribución que respete las restricciones declaradas y tenga la mayor entropía entre las alternativas admisibles.
La propuesta no convierte la ignorancia en un hecho del mundo. La distribución obtenida es una inferencia condicionada por una representación y un conjunto de restricciones. Puede ser útil como modelo de referencia, como aproximación o como componente de un procedimiento más amplio, pero no demuestra que el sistema real haya sido producido por una dinámica que maximiza entropía.
La idea adquirió una formulación influyente en los trabajos de Jaynes sobre teoría de la información y mecánica estadística. En este capítulo su papel será metodológico, el de usar restricciones explícitas para no introducir estructura adicional sin justificación. El alcance de esa pretensión depende de cómo se hayan elegido los estados, la medida de referencia y las restricciones.
Pensemos en un dado. Si solo declaramos que sus resultados posibles son los enteros del uno al seis, la distribución uniforme maximiza la entropía. Esa conclusión, sin embargo, depende de haber tratado las seis caras como estados básicos equivalentes. Si sabemos que cierta cara es más probable, la uniformidad deja de respetar toda la información disponible.
Supongamos ahora que conocemos una media de cuatro y medio. Hay muchas distribuciones con esa media; algunas asignan probabilidad únicamente a dos caras y otras mantienen probabilidad positiva para las seis. La restricción no determina cuál es correcta. Máxima entropía selecciona una distribución particular según un criterio adicional explícito.
El procedimiento exige separar tres niveles, que son los resultados que distinguimos, las relaciones probabilísticas que aceptamos como conocidas y la regla que usamos para completar lo que falta. Confundirlos puede hacer que una elección de modelado aparezca disfrazada de conclusión empírica.
La transparencia consiste en mostrar esa dependencia. Si otra persona cambia una restricción o incorpora un estado antes excluido, debería poder reconstruir cómo cambia la solución. Un buen modelo de máxima entropía permite esas modificaciones porque presenta su conocimiento de partida como parte del argumento.
209.2. El problema matemático y sus condiciones
Sea un conjunto finito de estados y una distribución desconocida sobre ellos. Podemos imponer normalización, probabilidades no negativas y valores esperados de varias funciones. Esas funciones son las características que deseamos conservar, como la energía, la puntuación, el número de elementos activos u otras cantidades definidas sobre los estados.
El problema es
Usaremos logaritmos naturales en la derivación. Cambiar a base dos multiplica la entropía por una constante positiva y no cambia la distribución que la maximiza, aunque sí el valor numérico de los multiplicadores si los escribimos sin ajustar esa constante.
Antes de optimizar hay que comprobar que existe alguna distribución compatible con las restricciones. Un dado con resultados del uno al seis no puede tener media siete, ni asignar a la vez cuatro quintas partes de probabilidad al uno y otras cuatro quintas partes al dos. Un optimizador no puede reparar una especificación contradictoria sin modificarla.
Con un número finito de estados, el conjunto de distribuciones es compacto. Las restricciones lineales de igualdad y la no negatividad de las probabilidades definen un subconjunto cerrado y convexo. Si ese conjunto no está vacío, la continuidad de la entropía garantiza que alcanza un máximo. Su concavidad estricta implica que la distribución maximizadora es única en ese conjunto.
La unicidad de la distribución no garantiza la de todos los multiplicadores. Si dos restricciones expresan la misma información o una es combinación de otras, distintos valores de los multiplicadores pueden dar la misma solución. Conviene eliminar o reconocer esas redundancias para no confundir una indeterminación paramétrica con una falta de identificación de las probabilidades.
Algunas soluciones están en la frontera y asignan probabilidad cero a estados que serían posibles sin las restricciones. Si la media del dado debe ser exactamente seis, toda la probabilidad debe concentrarse en esa cara. Una expresión exponencial con multiplicadores finitos y soporte completo no puede producir esa distribución; la obtenemos como límite o resolviendo directamente sobre el soporte permitido.
En espacios continuos o infinitos, las garantías anteriores requieren más cuidado. El conjunto admisible puede dejar de ser compacto y el máximo puede no existir; incluso la entropía puede no estar bien definida. Por eso, una fórmula obtenida mediante derivadas debe acompañarse de una comprobación de normalización, factibilidad y optimalidad dentro del problema concreto.
209.3. Por qué aparece una familia exponencial
Para una solución interior, introducimos multiplicadores que incorporan las restricciones a la función que se optimiza. Derivar respecto de cada probabilidad conduce a una relación entre su logaritmo y las características del estado. Con una convención de signos habitual se obtiene
La función de partición normaliza las probabilidades. Los multiplicadores se obtienen resolviendo el sistema que iguala las medias calculadas bajo esta distribución con las restricciones, de modo que no pueden fijarse después por conveniencia.
La forma exponencial no implica que las probabilidades disminuyan necesariamente con cada característica, porque el signo del multiplicador determina la dirección. También podríamos escribir un signo positivo ajustando la definición de los multiplicadores; es una convención de notación que nada afirma sobre el sistema.
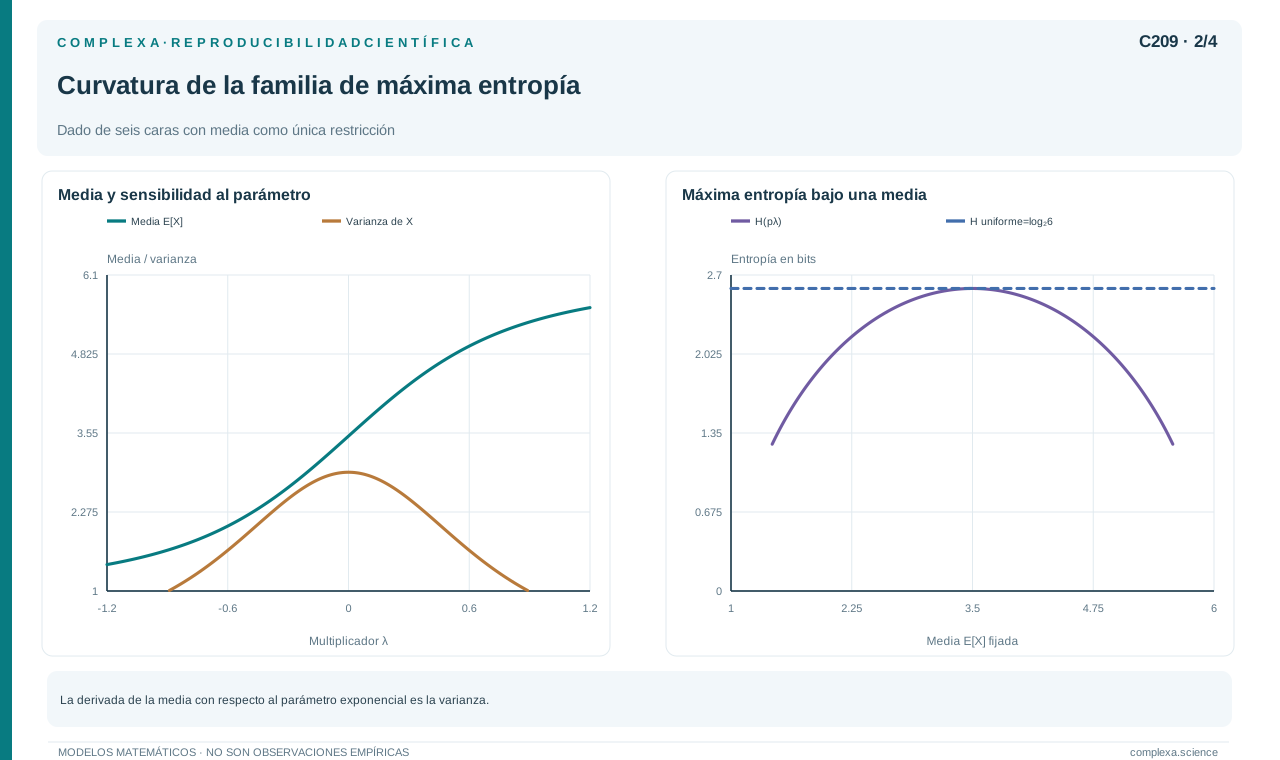
La derivada del logaritmo de la función de partición da, con el signo correspondiente, el valor esperado de la característica; la segunda derivada da las covarianzas
Así, la curvatura del problema mide las fluctuaciones de las cantidades restringidas. Si una combinación de características es constante en todos los estados admitidos, su varianza es cero y aparece una dirección redundante en los multiplicadores.
Hay además una demostración directa de optimalidad que ayuda a revisar el cálculo. Para cualquier otra distribución que satisfaga las mismas restricciones, la divergencia respecto de la solución exponencial puede escribirse como la diferencia entre la entropía máxima y la entropía candidata. Como la divergencia es no negativa, la candidata no puede tener mayor entropía.
Esa comprobación es más fuerte que observar una derivada nula. Conecta la solución con una desigualdad global y permite identificar cuándo se alcanza la igualdad. También revela qué parte del argumento depende de conservar exactamente los mismos valores esperados; si cambiamos las restricciones, los términos ya no se cancelan de la misma manera.
En aplicaciones grandes, calcular la función de partición puede resultar costoso porque exige sumar sobre numerosos estados. La forma compacta de la distribución no elimina esa dificultad computacional. Si aproximamos el cálculo, tenemos que evaluar sus errores para obtener probabilidades numéricas fiables.
209.4. Un dado con media conocida
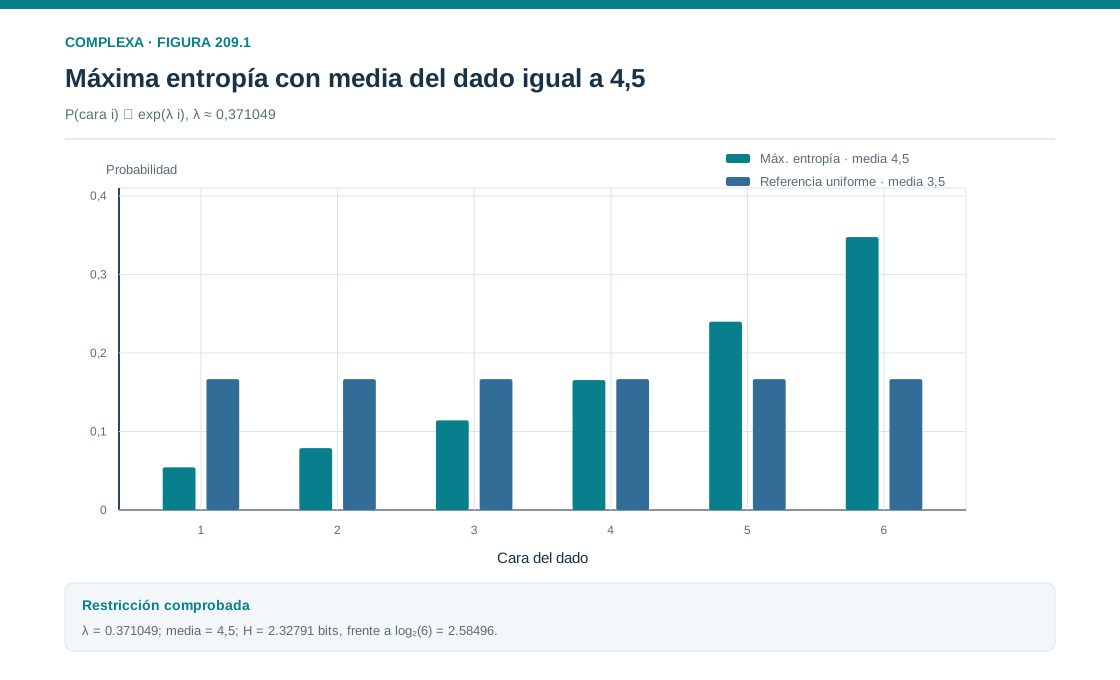
Resolvamos el ejemplo del dado con media cuatro y medio. Para facilitar la interpretación escribiremos probabilidades proporcionales a una exponencial con parámetro positivo multiplicado por la cara. Al aumentar ese parámetro, los resultados altos reciben más peso; cuando vale cero, recuperamos la distribución uniforme y una media de tres y medio.
Buscamos el parámetro que hace coincidir la media con la restricción. Puede encontrarse mediante bisección, porque la derivada de la media respecto del parámetro es la varianza y, mientras la distribución no sea degenerada, resulta positiva. La media crece de manera continua hacia seis cuando el parámetro aumenta sin límite.
El valor aproximado del parámetro es 0,371049. Las probabilidades resultantes, de la cara uno a la seis, son aproximadamente 0,054353, 0,078772, 0,114160, 0,165447, 0,239774 y 0,347494.
Salvo el redondeo mostrado, las probabilidades suman uno y su media ponderada es cuatro y medio. Su entropía, de unos 2,328 bits, es menor que la entropía uniforme, que ronda 2,585 bits, porque la nueva restricción descarta parte de la incertidumbre inicialmente permitida.
La relación entre probabilidades de caras consecutivas es constante. Esa regularidad es una propiedad del modelo, consecuencia de usar únicamente una restricción lineal sobre la puntuación y maximizar la entropía. Si las frecuencias medidas muestran una relación diferente, el modelo podría ser insuficiente.
Comparemos una alternativa que asigna la mitad de la probabilidad a la cara tres y la otra mitad a la seis. También tiene media cuatro y medio, pero su entropía es un bit. Con solo la restricción de media, esa alternativa es admisible. Máxima entropía la descarta como elección por defecto porque concentra la probabilidad de una manera adicional que no se ha justificado.
La solución exponencial es la más entrópica dentro del conjunto especificado, pero eso no demuestra que describa el mecanismo físico del lanzamiento; un dado real podría tener una distribución concentrada por razones que todavía no hemos medido.
Para evaluar el modelo podemos predecir una cantidad que no fue impuesta, como la probabilidad de obtener al menos cinco, que según la solución anterior es aproximadamente 0,58727. Esa predicción puede compararse con nuevas observaciones, pero no conviene presentarla como confirmación si esa misma frecuencia se usó antes para escoger las restricciones.
Sin reunir datos nuevos, tomemos cualquier distribución alternativa con la misma media y calculemos su divergencia respecto del modelo exponencial. Como el logaritmo de las probabilidades del modelo es una constante más el parámetro multiplicado por la cara, su promedio depende únicamente de la media ya fijada. La diferencia de entropías coincide entonces con la divergencia. Para la alternativa concentrada en tres y seis, esa diferencia es aproximadamente 1,328 bits y cuantifica la reducción adicional de incertidumbre que incorpora esa alternativa. La cifra compara dos modelos dentro del conjunto permitido; no indica cuánto se aleja la alternativa del dado real, porque todavía no conocemos su distribución. Esta distinción evita convertir una demostración de optimalidad matemática en una validación empírica.
También podemos examinar la sensibilidad. Si la media conocida cambia, el parámetro y todas las probabilidades cambian. Cerca de una distribución muy concentrada, pequeñas modificaciones de ciertas restricciones pueden exigir grandes variaciones paramétricas. Informar únicamente un vector de probabilidades oculta esa dependencia; documentar el dato que lo determina permite interpretarlo.
209.5. Dependencias que se introducen y que se omiten
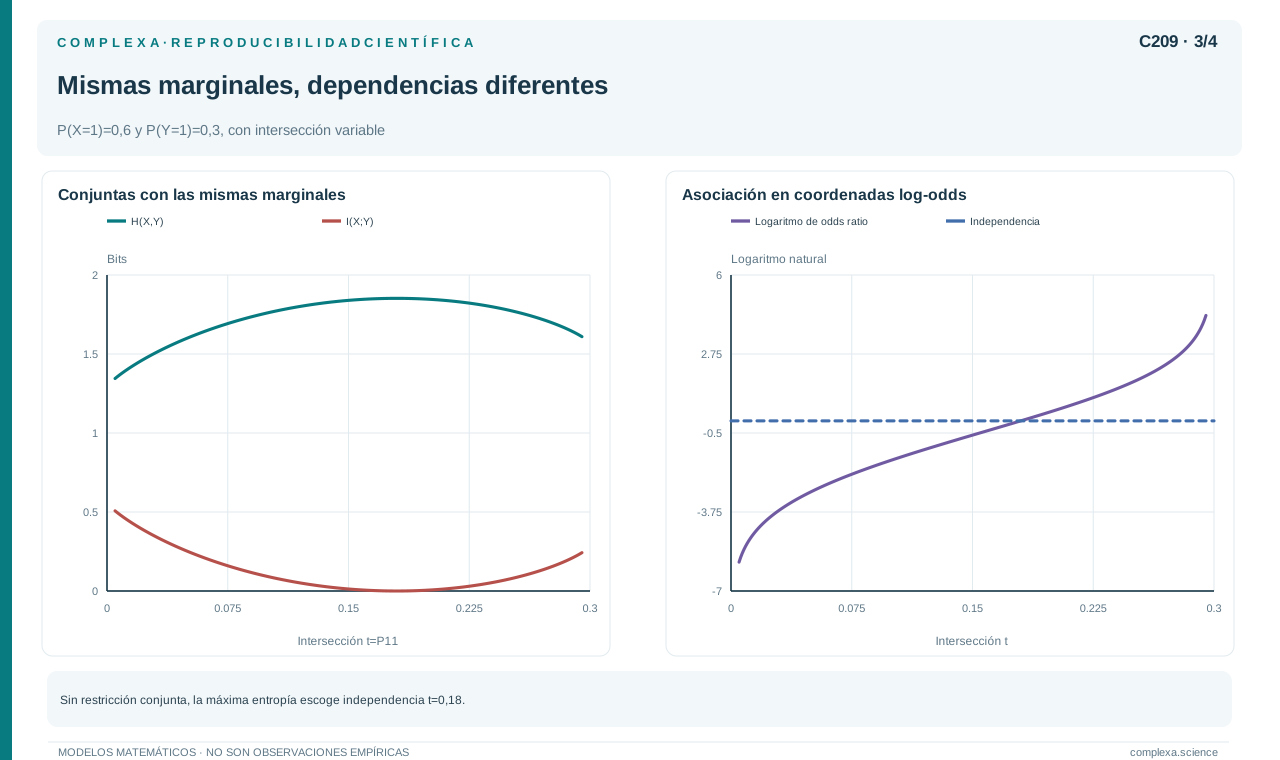
Supongamos que conocemos las probabilidades de activación de dos variables binarias, seis décimas para la primera y tres décimas para la segunda. Sin información adicional sobre su dependencia, máxima entropía produce la distribución independiente. La razón es que la entropía conjunta es la suma de las entropías marginales menos la información mutua.
Las restricciones ya fijan ambas entropías marginales, de modo que maximizar la entropía conjunta equivale a minimizar la información mutua, cuyo mínimo es cero. La solución tiene probabilidades conjuntas de 0,28, 0,12, 0,42 y 0,18 para los estados cero-cero, cero-uno, uno-cero y uno-uno, respectivamente.
Su entropía conjunta ronda 1,852 bits. Hay, sin embargo, muchas distribuciones dependientes con las mismas frecuencias marginales. Por ejemplo, asignar probabilidades 0,4, cero, 0,3 y 0,3 también respeta las dos restricciones, con una entropía de aproximadamente 1,571 bits. Que el modelo de referencia sea independiente se debe solo a que no impusimos ninguna restricción sobre la dependencia; de ello no se sigue que las variables reales lo sean.
Añadamos ahora que la probabilidad de activación simultánea es una cuarta parte. Con dos variables binarias, las marginales y esa probabilidad determinan toda la tabla, que asigna 0,35, 0,05, 0,35 y 0,25 a los estados cero-cero, cero-uno, uno-cero y uno-uno, respectivamente.
Podemos representar esta distribución mediante una exponencial que contiene términos individuales y un producto entre variables. Si las variables toman cero o uno, una parametrización con signo positivo tiene un coeficiente individual nulo para la primera, un coeficiente igual a menos el logaritmo de siete para la segunda y un coeficiente de interacción igual al logaritmo de cinco.
El coeficiente de interacción es el logaritmo de la razón de productos cruzados de la tabla. Su valor positivo expresa asociación según esa parametrización, pero no demuestra que activar una variable cause la activación de la otra. Una causa común, una selección de observaciones u otro mecanismo podrían producir la misma distribución.
En sistemas con muchas variables, imponer todas las frecuencias individuales y algunas asociaciones puede generar un modelo de máxima entropía con términos de pares. La distribución resultante también puede mostrar regularidades de orden superior. Esas regularidades son consecuencias del ajuste global, pero su presencia no prueba que se hayan identificado interacciones causales físicas.
El contraste empírico consiste en evaluar propiedades que no fueron ajustadas. Que el modelo reproduzca las restricciones verifica su calibración interna; si además predice patrones nuevos, tenemos evidencia adicional de su utilidad. Si falla, podemos revisar las restricciones, los datos o la representación, sin concluir por ello que todo uso de máxima entropía haya quedado refutado.
209.6. Conservar una distribución de referencia
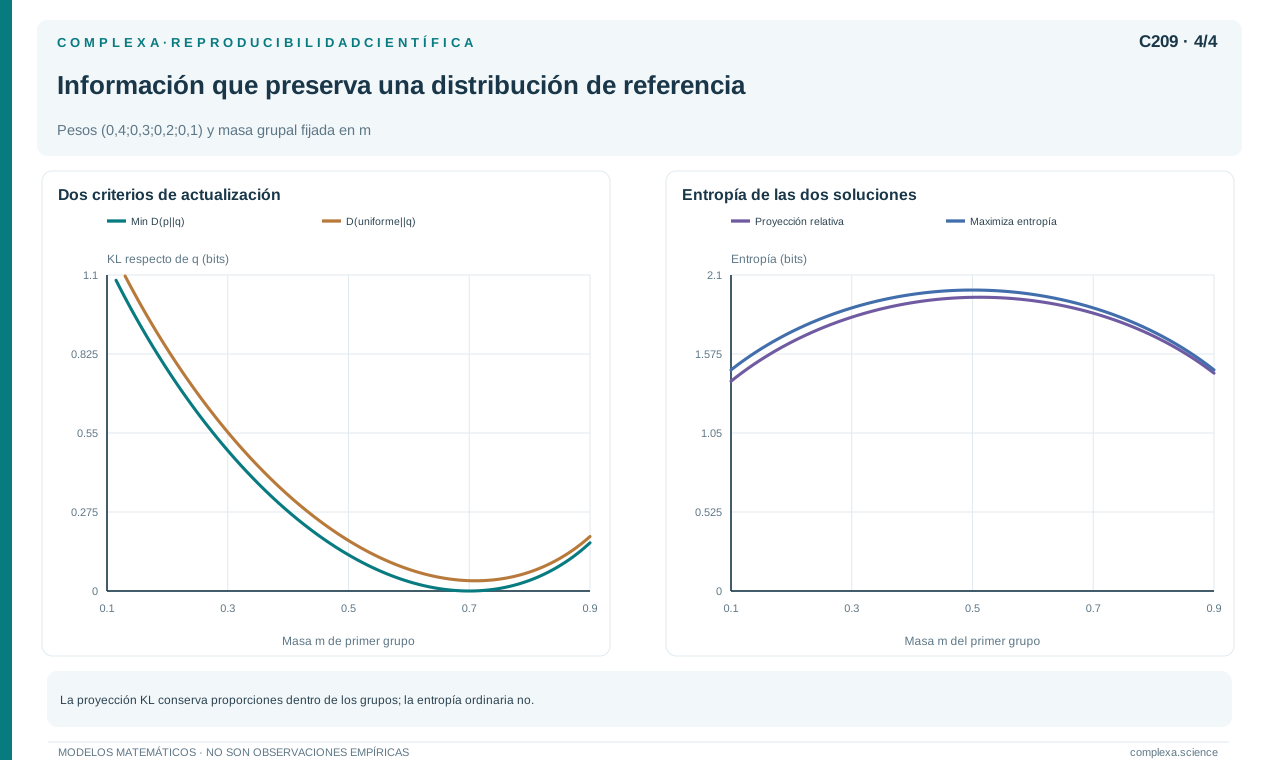
Maximizar la entropía ordinaria sobre estados finitos equivale a minimizar la divergencia respecto de una distribución uniforme sobre esos mismos estados. Esta equivalencia muestra que la uniformidad, aunque a veces pase inadvertida, es una referencia particular.
Si tenemos una distribución previa de referencia que no es uniforme, puede ser más adecuado buscar la distribución compatible con las restricciones que minimice la divergencia respecto de ella
Con soporte apropiado y restricciones de momentos, la solución interior es una modificación exponencial de la referencia. Cada estado conserva su peso de partida multiplicado por factores que dependen de las nuevas restricciones; después, el resultado se normaliza.
Consideremos cuatro estados con probabilidades de referencia 0,4, 0,3, 0,2 y 0,1. La nueva restricción exige que los dos primeros estados tengan en conjunto probabilidad de una mitad, cuando antes tenían siete décimas. Los dos restantes deben aumentar su masa conjunta de tres décimas a una mitad.
La solución de mínima divergencia conserva las proporciones internas de cada grupo. Dentro del primero, la relación sigue siendo cuatro a tres; dentro del segundo, dos a uno. Las probabilidades actualizadas son dos séptimas partes, tres catorceavas partes, una tercera parte y una sexta parte.
Podemos comprobar que los grupos tienen las masas requeridas. La optimalidad se explica con la regla de la cadena para la divergencia, que la descompone en una parte que mide el cambio de probabilidades entre grupos y otra que promedia los cambios condicionales dentro de ellos. La primera está fijada por la nueva restricción; la segunda se minimiza dejándola en cero.
Si hubiéramos maximizado entropía ordinaria con esa única restricción grupal, obtendríamos cuatro probabilidades iguales. Las dos soluciones responden a problemas distintos, pues la primera conserva la información relativa contenida en una referencia y la segunda adopta una referencia uniforme sobre los cuatro estados.
Los ceros de la referencia requieren especial atención. Asignar probabilidad positiva a un estado que la referencia considera imposible produce divergencia infinita en esta orientación. Si las nuevas restricciones exigen hacerlo, hay que revisar el soporte o la referencia. Un cero usado solo por comodidad numérica puede convertirse accidentalmente en una prohibición absoluta.
La actualización por mínima divergencia y la actualización bayesiana coinciden solo en algunos casos. Condicionar en un evento conocido puede formularse de esta manera con una restricción de soporte, pero otras observaciones requieren especificar una verosimilitud. Una restricción sobre una media y un conjunto de datos individuales no contienen necesariamente la misma información.
209.7. Qué cambia con variables continuas
En una variable continua, maximizar entropía diferencial exige fijar una medida de referencia y atender al dominio. La entropía diferencial cambia cuando transformamos las coordenadas. De ahí que la expresión «distribución menos informativa» carezca de un significado universal si no especificamos cómo representamos los estados.
Sobre un intervalo de longitud finita y respecto de la coordenada usual, la distribución uniforme maximiza la entropía diferencial sin otras restricciones. Si cambiamos de variable mediante una transformación no lineal, esa misma distribución generalmente deja de ser uniforme. Maximizar de nuevo en la otra coordenada puede producir un modelo diferente.
Por ejemplo, sobre valores entre uno y el número de Euler, una distribución uniforme en el valor original no coincide con una distribución uniforme en su logaritmo; la segunda es una densidad proporcional al inverso del valor original. Ninguna elección puede declararse indiferente a la representación sin un criterio adicional.
La divergencia entre dos distribuciones transformadas conjuntamente sí conserva su valor bajo un cambio invertible apropiado. Por ello, trabajar con una referencia explícita ayuda a mantener una interpretación coherente. No elimina la necesidad de justificar esa referencia, pero evita ocultarla detrás de la palabra «uniformidad».
Para una variable no negativa con media positiva conocida, la distribución exponencial maximiza la entropía diferencial respecto de la medida usual, bajo las condiciones que permiten comparar esas entropías. Su densidad es
Su entropía diferencial en unidades naturales es uno más el logaritmo de la media. La optimalidad puede comprobarse comparando cualquier densidad admisible con esa exponencial mediante la divergencia, porque la restricción de media hace constante el término de entropía cruzada.
En toda la recta, conocer solo la media no produce una distribución de máxima entropía diferencial, porque podemos aumentar indefinidamente la dispersión sin mover el centro. Si conocemos también una varianza positiva, la gaussiana resulta maximizadora. El soporte y las restricciones determinan, por tanto, los parámetros, la forma de la solución e incluso su existencia.
La entropía diferencial puede ser negativa y depende de las unidades. Esto no afecta a la comparación entre distribuciones expresadas con la misma medida y las mismas restricciones, pero impide interpretar su valor aislado como un número universal de bits necesarios para representar un dato continuo con precisión infinita.
En mediciones reales, la resolución y el rango suelen ser finitos. Una discretización puede facilitar el cálculo, pero el resultado depende de cómo se elijan los intervalos. Antes de comparar entropías obtenidas con discretizaciones distintas, debemos comprobar si realmente responden a la misma pregunta y usan la misma medida de referencia.
209.8. Restricciones conocidas y restricciones estimadas
En los ejemplos anteriores tratamos las medias y probabilidades como restricciones exactas. En una investigación suelen estimarse a partir de un número finito de observaciones. Una media muestral no coincide necesariamente con el valor esperado verdadero. Introducirla como igualdad exacta puede transmitir al modelo una certeza que los datos no justifican.
Podemos distinguir dos objetivos. Uno es construir la distribución de máxima entropía que reproduce exactamente los resúmenes de una muestra; otro, inferir una distribución poblacional teniendo en cuenta la incertidumbre de esos resúmenes. El primer problema está bien definido, pero resolverlo deja abierto el segundo.
Una alternativa es trabajar con intervalos de restricciones, penalizaciones o un modelo probabilístico de cómo se obtuvieron los datos. Cada enfoque añade decisiones propias. Un intervalo muy ancho admite más distribuciones; una penalización fuerte favorece ciertas desviaciones; una verosimilitud describe el proceso de observación. Estos ajustes no son intercambiables sin consecuencias.
En una familia exponencial regular, el ajuste por máxima verosimilitud a observaciones independientes conduce a ecuaciones que igualan momentos del modelo y promedios de características observadas. Son las mismas condiciones que impone máxima entropía cuando las restricciones son esos promedios. Sin embargo, máxima verosimilitud optimiza los parámetros de una familia ya elegida, mientras que máxima entropía completa una distribución sujeta a restricciones.
La relación puede escribirse directamente. El logaritmo de la verosimilitud contiene una suma de parámetros por estadísticas observadas y un término de normalización. Al derivarlo aparecen las diferencias entre momentos empíricos y momentos del modelo; anular esas diferencias produce las ecuaciones de ajuste, si existe una solución interior.
Si las observaciones están correlacionadas, tratarlas como independientes puede exagerar la cantidad de evidencia. El ajuste de momentos aún podría calcularse, pero su incertidumbre no se obtiene contando cada registro como una réplica independiente. La unidad de observación y la estructura temporal deben mantenerse visibles.
También puede ocurrir que las estadísticas empíricas estén en una frontera, por ejemplo cuando nunca se observa determinada combinación. Los parámetros de una familia con soporte completo pueden crecer sin límite para aproximarse al ajuste exacto. Regularizar o introducir una referencia positiva puede ser útil, pero cambia el problema y debe documentarse.
Para evaluar el modelo, conviene reservar observaciones o cantidades que no hayan servido para elegir las restricciones. Si modificamos repetidamente esas restricciones hasta reproducir todos los resultados conocidos, una concordancia final sobre los mismos datos dice poco de su capacidad de generalización. El procedimiento de selección forma parte del modelo que debemos revisar.
209.9. Inferencia, dinámica y explicación
Una distribución de máxima entropía describe probabilidades bajo determinadas restricciones; una dinámica describe cómo cambian los estados o las distribuciones en el tiempo. Ambas pueden relacionarse en problemas específicos, pero una no determina automáticamente la otra.
Distintos procesos pueden tener la misma distribución estacionaria. Uno puede recorrer los estados rápidamente y otro permanecer largos intervalos en cada uno, aunque sus frecuencias de largo plazo coincidan. Ajustar una distribución estática no identifica tiempos de relajación, trayectorias típicas ni respuestas a intervenciones.
Tampoco la forma exponencial demuestra equilibrio termodinámico. En mecánica estadística, ciertas restricciones y condiciones físicas justifican distribuciones conocidas. En otros dominios, una expresión formalmente similar puede ser un modelo estadístico sin temperatura física, intercambio de calor ni conservación de energía. Los nombres de los parámetros no crean esas propiedades.
Un ejemplo sencillo usa dos estados equiprobables. Una cadena que cambia de estado con probabilidad una décima por paso y otra que lo hace con probabilidad nueve décimas tienen la misma distribución estacionaria uniforme y, con ella, la misma entropía marginal. Sin embargo, la primera presenta persistencia y la segunda alternancia frecuente.
Incluso sus tasas de entropía coinciden en este ejemplo, porque la entropía binaria de ambas probabilidades de cambio es la misma. Aun así, sus correlaciones temporales tienen signos opuestos. Una medida resumida puede no distinguir estructuras que son esenciales para una pregunta dinámica.
Si queremos modelar trayectorias, debemos declarar restricciones sobre trayectorias y el espacio de procesos admisibles. La representación y la información disponible vuelven a determinar qué problema estamos resolviendo.
En estudios de sistemas complejos, máxima entropía puede usarse como referencia para preguntar cuánta estructura adicional requiere una explicación. Un modelo que conserva frecuencias individuales permite examinar qué asociaciones quedan sin reproducir; uno que añade pares permite investigar qué patrones quedan fuera de su alcance. Esta progresión es útil si las comparaciones tienen en cuenta también la complejidad del ajuste y los datos disponibles.
La interpretación causal necesita evidencia adicional. Que un coeficiente de interacción sea grande puede indicar que cierta dependencia es necesaria para reproducir las restricciones elegidas, pero no demuestra que exista una conexión directa entre los componentes. Variables omitidas, mezclas de poblaciones y mecanismos de observación pueden generar dependencias semejantes.
209.10. Cómo revisar una solución de máxima entropía
Una revisión comienza por el espacio de estados. Debemos saber qué posibilidades se incluyeron, cuáles se excluyeron y qué significa cada variable. Un resultado puede parecer muy preciso y, sin embargo, depender de una discretización que omite distinciones decisivas.
Después comprobamos las restricciones. Cada una debería tener una interpretación, una procedencia y un grado de incertidumbre. Las restricciones incompatibles deben detectarse antes del ajuste; las redundantes deberían reconocerse para interpretar correctamente los multiplicadores.
Hay que verificar que la solución está normalizada y reproduce los valores exigidos. En el dado, sumar las probabilidades y recalcular la media es una comprobación directa. En una distribución conjunta, reconstruir las marginales y las asociaciones impuestas permite localizar errores de índices o de parametrización.
La optimalidad también debe justificarse. En problemas pequeños podemos comparar con alternativas admisibles; para la familia exponencial, la identidad con la divergencia da una demostración general. En problemas aproximados, debemos separar el error de optimización del error estadístico y del posible desajuste de representación.
Las unidades también deben mantenerse consistentes. Cambiar una característica de metros a centímetros modifica su multiplicador, aunque la distribución resultante pueda ser exactamente la misma.
Una buena revisión cambia además restricciones razonables y observa qué conclusiones se mantienen. Si una predicción depende fuertemente de un valor incierto, esa dependencia es parte del resultado y no debe quedar escondida tras una distribución presentada con demasiados decimales.
Finalmente, contrastamos propiedades que no fueron impuestas. La concordancia con una restricción demuestra que el ajuste la respetó; la capacidad de anticipar otros resultados evalúa una utilidad más amplia. Si el modelo falla, podemos aprender qué información faltaba, siempre que evitemos introducirla retrospectivamente y después describirla como predicción original.
Máxima entropía es una regla clara para completar una distribución bajo información parcial. Su utilidad está en hacer explícito qué se conserva y qué se deja sin estructura adicional dentro de una representación. Cuanto más visibles sean esas elecciones, más fácil será revisar el resultado.
En el próximo capítulo relacionaremos estas ideas con la codificación y la compresión. Partiremos de un registro concreto y compararemos representaciones según las preguntas que permiten responder. La dificultad central será reconocer cuándo una reducción conserva la evidencia necesaria y cuándo convierte una pregunta todavía abierta en una suposición incorporada al archivo.
Referencias
- Jaynes, E. T. (1957). Information Theory and Statistical Mechanics. Physical Review, 106(4), 620–630. https://doi.org/10.1103/PhysRev.106.620.
- Jaynes, E. T. (1957). Information Theory and Statistical Mechanics. II. Physical Review, 108(2), 171–190. https://doi.org/10.1103/PhysRev.108.171.
- Kullback, S., y Leibler, R. A. (1951). On Information and Sufficiency. The Annals of Mathematical Statistics, 22(1), 79–86. https://doi.org/10.1214/aoms/1177729694.