COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 21. Teoría de la información: incertidumbre, dependencia y representación
208.1. Elegir qué diferencias importan
Una compresión sin pérdida permite recuperar exactamente el objeto que recibió el codificador. Una compresión con pérdida conserva una representación que puede diferir del original. Esa diferencia no vuelve necesariamente inútil el resultado. Una imagen reducida puede servir para identificar una forma; una señal redondeada puede conservar las variaciones necesarias para determinada comparación. La utilidad, sin embargo, depende de la pregunta. La misma representación puede ser adecuada para estimar una media e insuficiente para detectar un máximo breve.
Por eso, antes de preguntar cuánto puede reducirse un archivo, debemos establecer qué modificaciones estamos dispuestos a aceptar. Llamaremos fuente a la variable original y reconstrucción a la variable producida por el decodificador. Entre ambas introduciremos una función de distorsión, es decir, una regla que asigna un costo a cada pareja de valores original y reconstruido. Esa función convierte una preferencia sobre fidelidad en un problema matemático explícito.
La palabra distorsión no implica necesariamente una distancia geométrica. El costo puede ser asimétrico, porque omitir un evento y declarar un evento inexistente pueden tener consecuencias distintas. Tampoco necesita satisfacer la desigualdad triangular. Si las categorías son nombres, el error puede depender de una tabla de confusiones permitidas. Si los datos son números, pueden importar los cuadrados de las diferencias, sus valores absolutos o el cruce de un umbral.
Supongamos que registramos un estado binario, donde uno indica una condición poco frecuente. La distorsión de Hamming asigna costo cero a una reconstrucción correcta y costo uno a cualquier equivocación, de modo que los dos tipos de error pesan igual. Un criterio alternativo podría asignar costo veinte a transformar un uno en cero y costo uno a transformar un cero en uno. El registro es el mismo; lo que cambia es el significado de preservarlo satisfactoriamente.
Toda afirmación sobre compresión con pérdida debería identificar la distribución de los datos, el conjunto de reconstrucciones admisibles y el costo de sus discrepancias. Decir que un método conserva el noventa y nueve por ciento de la información es ambiguo si no se especifica qué cantidad representa ese porcentaje. La teoría de tasa y distorsión da un lenguaje preciso, pero no decide por nosotros qué consecuencias son aceptables.
208.2. La función de tasa y distorsión
Consideremos una fuente discreta que produce símbolos independientes con una distribución fija. El codificador observa un bloque de símbolos, selecciona uno de varios mensajes posibles y transmite su índice. El decodificador usa ese índice para reconstruir el bloque. Si hay como máximo una potencia de dos de mensajes, el exponente determina el número de bits necesarios para identificar cualquiera de ellos.
La tasa expresa los bits por símbolo original. La distorsión del bloque será el promedio de los costos de sus posiciones; después podremos promediar también sobre los bloques que produce la fuente. Conviene distinguir ambos promedios, porque una restricción sobre distorsión esperada no equivale a exigir que cada bloque, sin excepción, respete el mismo límite.
Para alfabetos finitos y la formulación habitual de distorsión aditiva, la función informacional se escribe
La distribución de la fuente permanece fija; lo que se modifica en la optimización es la relación probabilística entre el original y su reconstrucción. Buscamos la menor información mutua compatible con el costo tolerado. Esta definición se conecta con un resultado operacional, según el cual, con bloques suficientemente largos, pueden aproximarse las tasas y distorsiones permitidas por la curva dentro de las condiciones del teorema correspondiente.
Shannon desarrolló esa conexión para fuentes y criterios de fidelidad especificados. Aquí usaremos el resultado como límite de referencia y construiremos nuestros propios ejemplos, sin interpretar la curva como una promesa de rendimiento para cualquier programa, tamaño de archivo o distribución desconocida. La existencia asintótica de buenos códigos y el diseño de un compresor rápido son problemas relacionados, pero diferentes.
Si aumentamos la distorsión tolerable, ampliamos el conjunto de soluciones admisibles. Por tanto, la tasa mínima no puede aumentar. Si exigimos reconstrucción exacta de una fuente discreta y solo la igualdad tiene costo cero, el extremo de distorsión nula corresponde a su entropía. Sin embargo, si el costo declara equivalentes distintos símbolos originales, una distorsión nula podría admitir su fusión. El significado de cero también depende de la regla elegida.
La función puede llegar a tasa cero cuando basta una reconstrucción que no depende del dato recibido. Un archivo concreto puede seguir necesitando algunos bits para convenciones, longitud o metadatos; la tasa cero indica que, una vez fijadas esas condiciones, no hace falta comunicar información nueva sobre cada símbolo de la fuente para satisfacer el criterio promedio.
208.3. Un caso binario que puede resolverse
Sea una fuente de ceros y unos equiprobables, independientes entre posiciones. Mediremos la distorsión como fracción de símbolos reconstruidos incorrectamente. En este caso, la función de tasa y distorsión es
Para distorsiones toleradas mayores o iguales que un medio, la tasa mínima es cero. Basta reconstruir siempre cero, con lo que se acierta en promedio la mitad de las veces. Una reconstrucción constante no descubre nada sobre los símbolos particulares, aunque cumpla ese objetivo relativamente permisivo.
Podemos entender el límite sin confundirlo con una receta de implementación. Si conocemos la reconstrucción y sabemos si hubo error, conocemos también el símbolo original, porque el alfabeto es binario. La incertidumbre residual del original no puede superar la entropía del indicador de error. Con una probabilidad de error no mayor que un medio, obtenemos una cota inferior para la información mutua mediante la entropía binaria.
Para alcanzar esa cota en la optimización informacional, podemos construir una distribución conjunta en la que el original sea la reconstrucción más un cambio binario independiente de probabilidad igual a la distorsión. Ambos marginales son uniformes y la incertidumbre condicional coincide exactamente con la entropía del error. Como esta construcción alcanza la cota inferior, la curva queda determinada.
Con una distorsión de una décima, la tasa límite es aproximadamente 0,531 bits por símbolo. Con una distorsión de una cuarta parte, desciende a aproximadamente 0,189. Estas cifras son promedios por símbolo obtenidos al codificar bloques, cuya representación total usa una cantidad entera de bits; ningún símbolo aislado se almacena con una fracción física de bit.
La curva tampoco indica que el codificador deba cambiar al azar una décima parte de los bits y transmitir el resto sin otra operación. Ese procedimiento no especifica cómo comunicar una reconstrucción con la tasa prometida. El canal probabilístico empleado para caracterizar la curva describe una relación conjunta óptima; el teorema de codificación explica por qué existen familias de representaciones por bloques que se aproximan a ella.
La tolerancia al error debe interpretarse literalmente. Si el registro tiene un millón de posiciones, una distorsión media de una décima permite alrededor de cien mil discrepancias en valor esperado. Eso puede ser aceptable para una tarea muy agregada y completamente inadecuado para una pregunta que dependa de posiciones exactas. Una cifra pequeña de bits no tiene valor científico independiente del criterio de fidelidad que la hizo posible.
208.4. Cuando los unos son infrecuentes
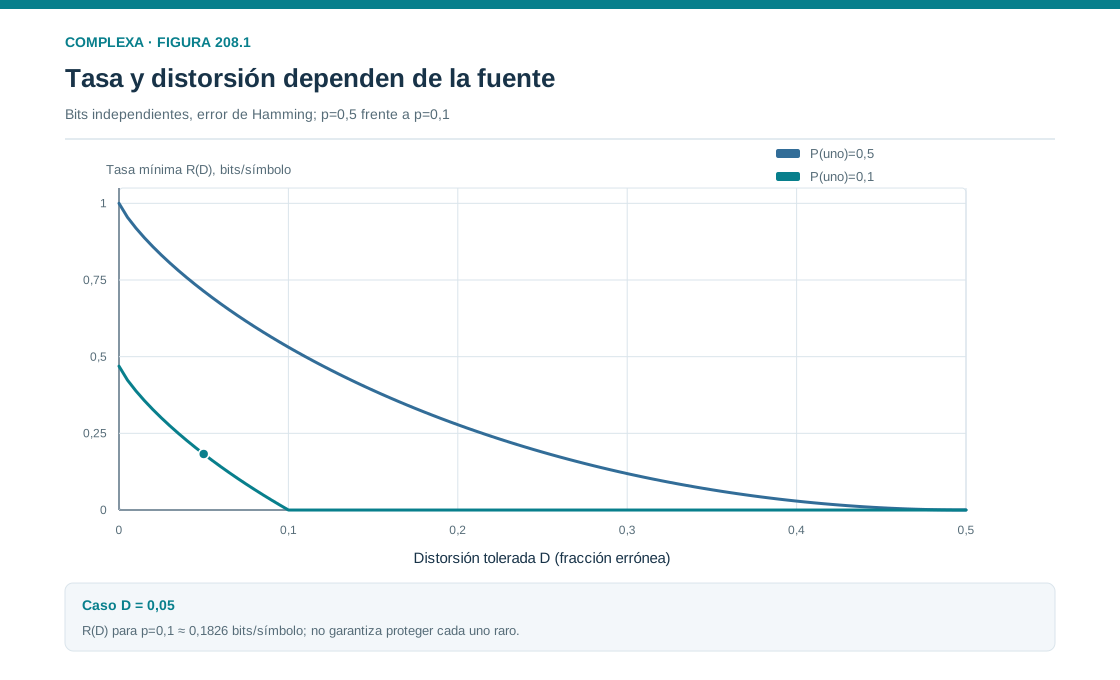
Ahora la probabilidad de uno será una décima. La fuente tiene menos entropía que la fuente equilibrada; reconstruir siempre cero ya produce una distorsión de una décima. Bajo Hamming, esa es la distorsión mínima alcanzable sin transmitir información sobre los símbolos individuales.
Para una fuente de Bernoulli de parámetro cualquiera, con reconstrucciones binarias y distorsión de Hamming, la expresión en el intervalo pertinente es
Para distorsiones mayores, fuera de ese intervalo, la tasa mínima se mantiene en cero. La misma idea de incertidumbre residual da la cota inferior. Para construir una distribución que la alcance, conviene pensar desde la reconstrucción hacia el original.
Sea la reconstrucción un bit con probabilidad de uno igual a
Añadamos, mediante suma binaria, un error independiente de probabilidad de cambio igual a la distorsión. Entonces la probabilidad de uno del original es la deseada. Esta construcción funciona en el intervalo señalado; los extremos degenerados se interpretan por continuidad cuando es necesario.
Tomemos una fuente con probabilidad de uno de una décima y una distorsión de cinco centésimas. La probabilidad de uno de la reconstrucción es una dieciochava parte. La distribución conjunta asigna aproximadamente 0,05278 a original y reconstrucción iguales a uno; al original uno reconstruido como cero le corresponden unos 0,04722. Las otras dos probabilidades son aproximadamente 0,00278 y 0,89722.
Al sumar las dos celdas incorrectas recuperamos la distorsión de cinco centésimas. Los errores condicionales, sin embargo, son muy diferentes; se omite aproximadamente el 47,22 por ciento de los unos originales y se convierte en uno aproximadamente el 0,31 por ciento de los ceros. La tasa correspondiente ronda 0,183 bits por símbolo.
Este ejemplo muestra por qué una baja distorsión global puede convivir con una mala conservación de una categoría infrecuente. La optimización responde al costo promedio declarado y, si todas las posiciones incorrectas cuestan lo mismo, puede resultar conveniente sacrificar una proporción considerable de los símbolos raros.
Conviene reconocer que el criterio responde una pregunta particular. Si necesitamos conservar los unos por su importancia, debemos introducir esa exigencia mediante costos asimétricos, restricciones separadas por categoría o reconstrucción exacta de un campo protegido. La función óptima cambiará porque el problema científico y operativo también cambió.
208.5. Cuantizar números y calcular el error
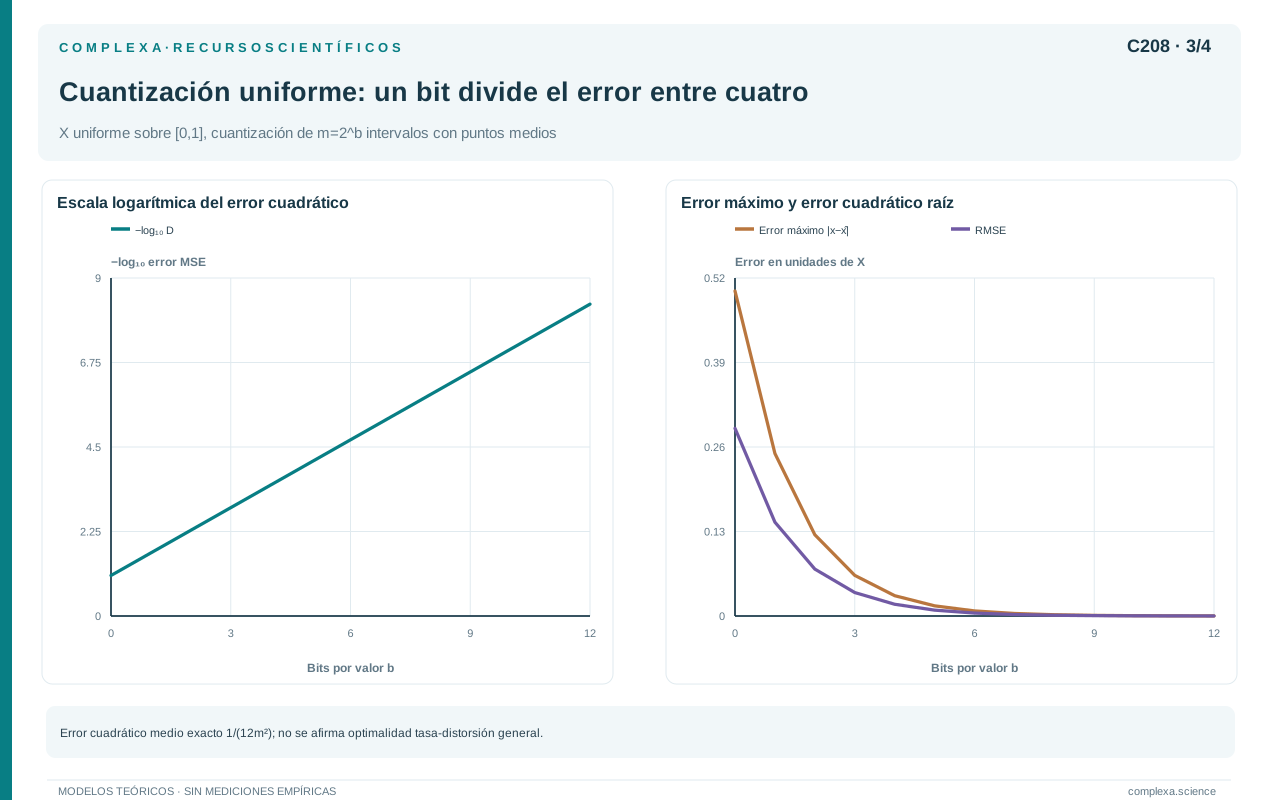
Consideremos una variable uniforme entre cero y uno y reemplacemos cada valor por uno de dos representantes. Dividimos el intervalo en dos mitades y usamos sus centros, un cuarto y tres cuartos. Para elegir el representante basta indicar en qué mitad cayó la observación (un bit por muestra en una representación fija).
Dentro de cada mitad, la diferencia respecto de su centro varía entre menos un cuarto y un cuarto. Al integrar su cuadrado sobre ambas mitades obtenemos un error cuadrático medio de uno dividido por cuarenta y ocho. Si no transmitimos nada y reconstruimos siempre un medio, el error cuadrático medio es una doceava parte. El bit transmitido reduce el error a una cuarta parte del valor inicial.
La misma construcción con un número arbitrario de intervalos iguales produce
Cada intervalo tiene anchura inversa al número de intervalos. El error cuadrático medio dentro de él es su anchura al cuadrado dividida por doce. Como todos los intervalos son equiprobables y tienen la misma anchura, el promedio global conserva esa expresión.
Con cuatro intervalos necesitamos dos bits por muestra y obtenemos un error de uno dividido por ciento noventa y dos. Con ocho intervalos usamos tres bits y el error cae a uno dividido por setecientos sesenta y ocho. Cada bit adicional duplica el número de intervalos y, en esta construcción uniforme, divide el error cuadrático por cuatro.
El cálculo anterior da exactamente el desempeño de una familia concreta para una distribución concreta. Que cualquier cuantizador práctico alcance la función de tasa y distorsión de cualquier fuente es otra cuestión, que aquí no hemos demostrado. La distinción es útil, porque una curva teórica marca posibilidades generales, mientras que un diseño explícito permite comprobar costos, reconstrucciones y errores sin esconderlos en una afirmación asintótica.
Conviene precisar también cómo se cuentan los bits. Si usamos tres intervalos y asignamos una palabra fija a cada uno, hacen falta dos bits, aunque uno de los cuatro patrones disponibles quede sin usar. La codificación conjunta de muchos índices puede reducir la tasa media. Separar cuantización y codificación ayuda a identificar dónde se pierde fidelidad y dónde queda redundancia.
El centro de cada intervalo minimiza el error cuadrático cuando la distribución condicional es uniforme. Con otra distribución, el representante óptimo para ese criterio sería su media condicional; si medimos error absoluto, ese papel lo cumple una mediana condicional. Cambiar la función de costo puede cambiar el mejor representante aun sin modificar las fronteras de los intervalos.
Una cuantización tampoco garantiza conservar umbrales. Un valor apenas superior a una frontera de decisión puede reconstruirse por debajo de ella, aunque su error numérico sea pequeño. Si la pregunta depende de esa frontera, conviene incorporarla al diseño o almacenar por separado el indicador de cruce. El tamaño del error y su consecuencia son objetos distintos.
208.6. La fuente gaussiana y una confusión frecuente
Para una fuente gaussiana independiente de varianza conocida y una distorsión cuadrática media, el límite tiene una forma especialmente sencilla
Cuando toleramos una distorsión igual o mayor que la varianza, basta reconstruir la media y la tasa mínima es cero. Cuando exigimos distorsión exactamente nula para valores continuos de precisión ilimitada, la tasa diverge. Este extremo no debe confundirse con comprimir sin pérdida un archivo digital que ya contiene números representados con precisión finita.
Una manera de entender la cota usa el hecho de que, dada una varianza, la distribución gaussiana maximiza la entropía diferencial. La incertidumbre residual asociada al error queda limitada por su segundo momento. Restar esa cota de la entropía de la fuente conduce al cociente entre varianza original y distorsión tolerada.
La construcción que alcanza la expresión puede formularse hacia atrás, escribiendo el original como la suma de una reconstrucción gaussiana y un error gaussiano independiente. La reconstrucción tiene varianza igual a la diferencia entre la varianza original y la distorsión; el error tiene varianza igual a la distorsión. La suma recupera exactamente la distribución de la fuente.
Esto es diferente de tomar el original y añadirle un ruido independiente para producir la reconstrucción. Ese procedimiento hacia adelante también puede tener el error cuadrático deseado, pero su información mutua es
si el ruido gaussiano independiente tiene varianza igual a la distorsión. En general, esa cantidad es mayor que la tasa mínima. Añadir ruido de manera sencilla no equivale a diseñar una representación óptima.
Con varianza original igual a uno y distorsión de una cuarta parte, la función óptima da un bit por muestra. La construcción que añade ruido independiente hacia adelante conserva aproximadamente 1,161 bits de información mutua. Ambas producen el mismo error cuadrático, pero corresponden a relaciones estadísticas distintas entre original y reconstrucción.
La distribución óptima hacia adelante puede obtenerse de la construcción conjunta anterior. La media condicional de la reconstrucción, dado el original centrado, es el original multiplicado por uno menos el cociente entre distorsión y varianza. Su varianza condicional también queda determinada por esa distribución conjunta. La reconstrucción óptima contrae, pues, el original y le añade una aleatoriedad coordinada con esa contracción.
Estos resultados descansan en gaussianidad, independencia temporal y distorsión cuadrática. Una señal con correlación entre instantes puede permitir una asignación diferente de recursos entre componentes; una señal con colas distintas o eventos discretos superpuestos requiere revisar el modelo. No debemos aplicar la fórmula gaussiana solo porque los datos estén expresados como números reales.
208.7. Promedios, eventos raros y costos desiguales
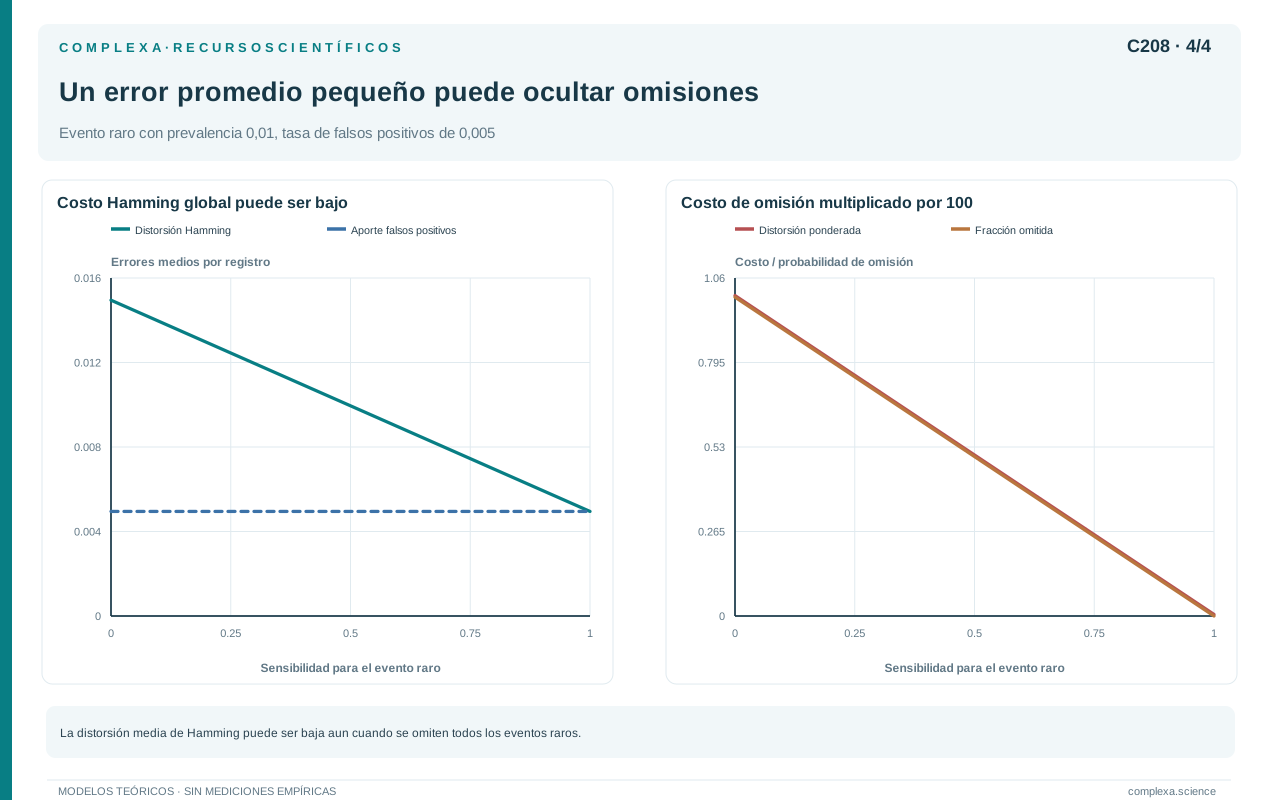
Una restricción de error promedio permite distribuir el daño de maneras muy diferentes. Dos compresores pueden tener el mismo error cuadrático global aunque uno produzca pequeñas discrepancias frecuentes y el otro pocas discrepancias grandes. Si los errores grandes coinciden con los eventos de interés, el promedio puede ocultar una pérdida decisiva.
Imaginemos mil registros, de los cuales novecientos noventa valen cero y diez valen diez. Reconstruir todo como cero produce un error cuadrático medio de uno. Una reconstrucción alternativa que desplazara cada valor original exactamente una unidad también tendría error cuadrático uno, si tal representación estuviera disponible. Sus consecuencias para detectar los diez eventos serían muy distintas. El ejemplo solo compara el criterio de evaluación; nada dice sobre la tasa que costaría cada alternativa.
La distribución completa de errores, sus cuantiles y los errores por categoría dan información adicional. Si tenemos una exigencia fuerte sobre una clase, podemos imponer una restricción condicional. Si hay valores que nunca deben modificarse, pueden protegerse de forma exacta mientras se comprimen con pérdida otros campos. El diseño deja entonces de ser una única restricción promedio uniforme.
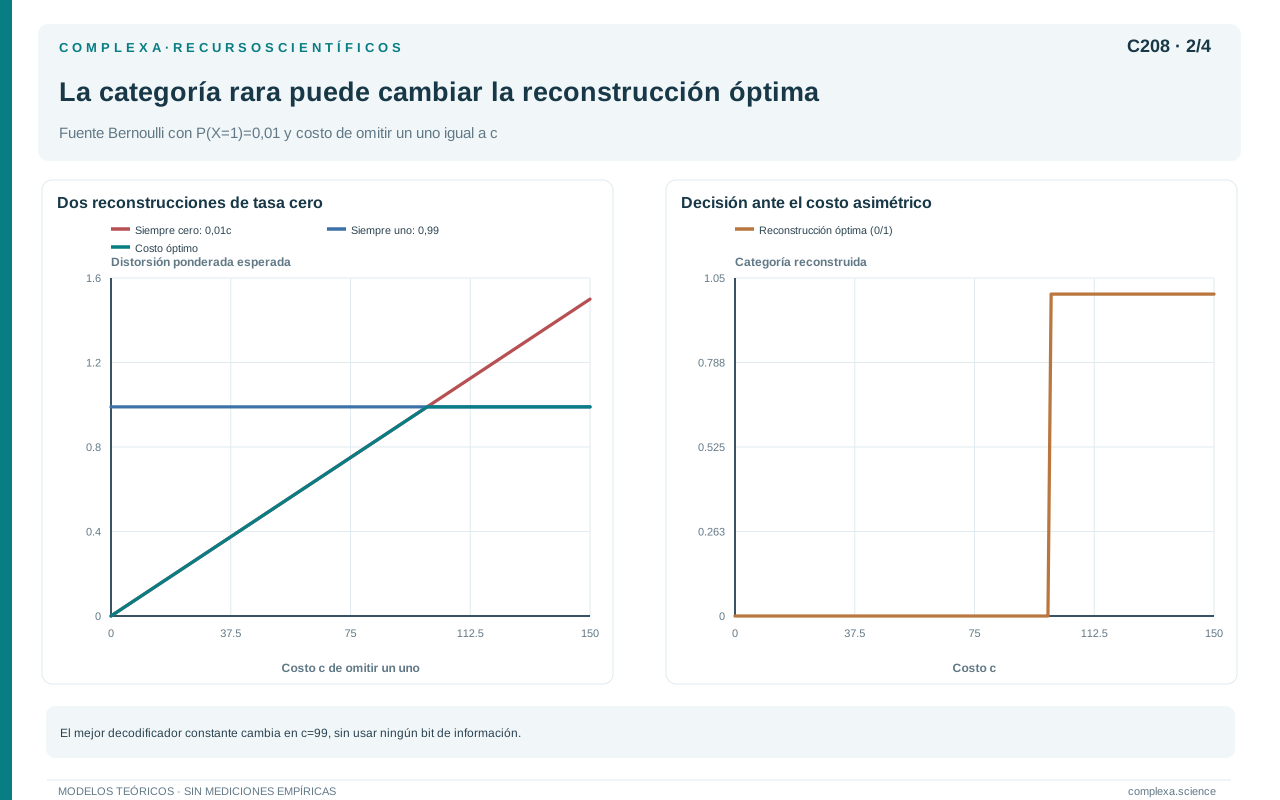
Volvamos a una fuente binaria cuya probabilidad de uno es una centésima. Supongamos que omitir un uno cuesta cien unidades y declarar un uno inexistente cuesta una. Si no transmitimos nada, reconstruir siempre cero tiene costo esperado uno. Reconstruir siempre uno tiene costo esperado 0,99. Según esta función, la segunda decisión es ligeramente mejor pese a equivocarse en la inmensa mayoría de las posiciones.
No hay contradicción, ya que el objetivo declarado es minimizar el costo esperado. Si el costo de omisión fuera cincuenta, reconstruir siempre cero costaría 0,5 y pasaría a ser preferible. El punto de cambio depende de la probabilidad de la categoría y de la relación entre costos.
Una mezcla aleatoria de las dos reconstrucciones constantes no puede superar al mejor extremo bajo este costo esperado, porque su rendimiento es una combinación de ambos costos. Esta observación explica por qué el extremo de tasa cero puede encontrarse buscando una reconstrucción constante óptima, siempre que no existan otras restricciones que obliguen a aleatorizar.
Los costos deberían justificarse por el propósito del registro. Elegir pesos grandes después de observar el resultado, para obtener el deseado, no los justifica. Una auditoría debe documentar qué consecuencia representa cada peso y cómo cambia la decisión al variar supuestos razonables. La teoría describe el intercambio, pero especificarlo sigue siendo responsabilidad de quien plantea el problema.
208.8. Convexidad y cálculo de la curva
La función de tasa y distorsión es convexa bajo las condiciones habituales del problema discreto. Una interpretación operacional reparte el trabajo entre dos estrategias. Podemos aplicar un código a una fracción de los bloques y otro código al resto, con un calendario conocido por emisor y receptor. La tasa y la distorsión promedio se combinan según esas fracciones.
Por ello, la mejor tasa para la distorsión intermedia no puede ser mayor que el promedio de tasas de esa estrategia combinada. La curva óptima queda por debajo de la recta que une ambos puntos, o coincide con ella, según la desigualdad de convexidad
Esta interpretación requiere contabilizar la selección del código cuando no esté acordada. Si el decodificador desconoce qué estrategia se aplicó, hay que comunicarla o diseñar una estructura que permita identificarla. Los costos de cabecera pueden ser pequeños para bloques largos, pero no desaparecen automáticamente en archivos breves.
Para alfabetos finitos, la curva puede calcularse mediante optimización. Una forma útil es minimizar la información mutua más un multiplicador no negativo por la distorsión. El multiplicador expresa cuánto penalizamos un incremento del error respecto del uso de bits. Variarlo permite recorrer puntos de la frontera.
En el esquema de Blahut, una actualización de las probabilidades condicionales tiene una forma exponencial
Después se actualiza el marginal de reconstrucción sumando sobre la distribución de la fuente. Estas operaciones se alternan hasta satisfacer un criterio de convergencia adecuado. La base dos corresponde a expresar información en bits; usar exponenciales naturales exige ajustar el multiplicador.
Para explorar todo el alfabeto de reconstrucción conviene inicializar su marginal con probabilidades positivas, porque una componente inicialmente nula permanece nula en esta actualización y puede excluir una solución mejor. Además, un multiplicador no siempre identifica una distribución óptima única; un tramo lineal de la frontera puede compartir pendiente entre varios puntos. Que las iteraciones se estabilicen no prueba la unicidad, de modo que debemos comprobar costo, información y consistencia del marginal obtenido.
La fórmula muestra dos influencias. Un representante recibe más peso si ya es frecuente en la distribución reconstruida, pero pierde peso cuando su costo respecto del original es elevado. La solución debe equilibrar ambas condiciones de manera consistente. Un marginal propuesto no puede darse por válido sin revisar el marginal que inducen las nuevas probabilidades condicionales.
En el caso binario equilibrado y simétrico, el marginal reconstruido permanece uniforme. La probabilidad de cambio es el inverso de uno más dos elevado al multiplicador; si el multiplicador es dos, obtenemos distorsión de una quinta parte. Este caso permite comprobar la actualización directamente, sin atribuir a un algoritmo una precisión que todavía no se ha medido.
La tasa correspondiente a ese punto es aproximadamente 0,278 bits por símbolo. Si una implementación devuelve otra cifra, revisaríamos primero la base del logaritmo, la normalización de las filas y el cálculo del marginal reconstruido. Comprobaríamos después que la distorsión se pondera por las probabilidades originales y que ninguna distribución uniforme las ha reemplazado por accidente. Finalmente, repetiríamos las iteraciones con una tolerancia más estricta para distinguir un error de programación de una aproximación todavía insuficiente. Estas comprobaciones son pequeñas, pero conectan cada salida numérica con una identidad que podemos verificar. Una gráfica suave no sustituye esa conexión, ni el nombre de un algoritmo certifica que su implementación resuelva el problema especificado.
208.9. Parecer plausible y ser fiel no son lo mismo
Una reconstrucción puede parecer natural y, sin embargo, no conservar los detalles del original. También puede minimizar el error cuadrático y tener un aspecto poco convincente. El trabajo de Blau y Michaeli formaliza un intercambio entre distorsión y semejanza de distribuciones en problemas de reconstrucción. Su criterio de percepción es una propiedad estadística especificada, que no abarca toda la experiencia humana de calidad.
Un ejemplo elemental permite separar los objetivos. Supongamos que el original vale cero o uno con igual probabilidad y que el receptor no recibe ninguna observación informativa. Permitamos reconstrucciones reales. Si queremos minimizar el error cuadrático, la mejor salida constante es un medio, con un error medio de una cuarta parte.
El original, sin embargo, nunca toma ese valor, de modo que la distribución de reconstrucciones no se parece a la distribución de originales. Si, para reproducir exactamente el marginal original, el receptor genera un cero o un uno equiprobable e independiente del dato real, el error cuadrático medio aumenta a un medio. La salida tiene la distribución correcta, aunque no identifica cuál de los dos valores ocurrió.
Ninguna de las dos estrategias usa información sobre el original particular. El segundo procedimiento introduce variabilidad nueva, pero no recupera información perdida. La coincidencia marginal no garantiza fidelidad por caso. La diferencia se vuelve decisiva cuando una reconstrucción generativa produce detalles plausibles que los datos transmitidos no determinaban.
Si existe una observación parcial, el mismo problema puede aparecer dentro de cada conjunto de originales compatibles con ella. Una media condicional favorece el error cuadrático; una muestra de la distribución condicional favorece otras propiedades distributivas. Elegir entre ambas exige conocer la tarea y explicitar qué parte del resultado es evidencia y qué parte es una realización compatible.
En un archivo destinado a análisis científico, conviene evitar que la reconstrucción borre esa distinción. Un valor generado puede ser útil para visualización, simulación o integración de incertidumbre, pero no debe presentarse como si hubiera sido observado exactamente. La documentación del formato debería identificar qué campos son originales, cuáles son aproximados y cuáles dependen de un modelo.
Según la teoría de procesamiento de datos, una transformación de la representación recibida no añade información sobre el original que no estuviera disponible en esa representación y en las fuentes auxiliares usadas. Puede mejorar la apariencia, facilitar una decisión o incorporar conocimiento previo. Esos beneficios deben describirse por su función concreta, sin convertirlos en recuperación garantizada de detalles ausentes.
208.10. Diseñar una compresión que responda a la pregunta
El diseño comienza por identificar la unidad que se quiere reconstruir, sea un símbolo, una muestra, un episodio o un registro completo. Después se define qué diferencias importan. Si la pregunta depende de duración, orden o coincidencias entre variables, un costo aplicado por separado a cada número quizá no represente bien el objetivo. Puede ser necesario evaluar bloques o características derivadas.
A continuación se fija el alcance del promedio. Un error agregado sobre todos los datos puede estar dominado por la categoría más frecuente. Un promedio por persona, por instrumento o por episodio puede responder otra pregunta. La ponderación forma parte de la especificación científica, aunque en el programa aparezca como una operación aritmética sencilla.
También debemos separar el límite teórico del formato implementado. Un resultado sobre bloques infinitamente largos no garantiza baja latencia. Un resultado para una distribución conocida no asegura buen comportamiento tras un cambio de población. Un esquema que ahorra bits en los valores puede perder la ventaja si necesita transmitir diccionarios, parámetros o máscaras extensas.
La validación debe reconstruir el registro y repetir las preguntas que motivaron su conservación. Es útil calcular, además del costo usado para optimizar, otras cantidades sensibles, como los errores máximos, las pérdidas por categoría y los cambios en decisiones relevantes. Si aparece una discrepancia importante que el costo no penaliza, quizá el problema esté en la especificación más que en el optimizador.
En una serie de observaciones, conservar la media no garantiza conservar las transiciones. Mantener una distribución marginal tampoco asegura mantener la asociación entre variables. Proteger una etiqueta no garantiza preservar la evidencia que permitió asignarla. Estos ejemplos aconsejan sustituir la promesa general de conservar lo esencial por preguntas verificables.
La compresión con pérdida siempre establece una frontera entre diferencias retenidas y diferencias descartadas. Esa frontera puede ser transparente y evaluable, o permanecer oculta bajo una cifra de tamaño final. La función de tasa y distorsión ayuda a hacer visible el intercambio, siempre que recordemos qué fuente, qué costo y qué condiciones describen sus símbolos.
El siguiente capítulo abordará otro uso de la entropía, la construcción de distribuciones a partir de restricciones conocidas. Allí la elección de restricciones determinará qué estructura introducimos en una inferencia; aquí, la elección de distorsión determina qué estructura aceptamos perder en una representación. En ambos casos, la matemática resulta más informativa cuando la pregunta se declara antes de optimizar.
Referencias
- Shannon, C. E. (1959). Coding Theorems for a Discrete Source With a Fidelity Criterion. IRE International Convention Record, 7, parte 4, 142–163. Reimpresión del artículo.
- Blahut, R. E. (1972). Computation of channel capacity and rate-distortion functions. IEEE Transactions on Information Theory, 18(4), 460–473. https://doi.org/10.1109/TIT.1972.1054855.
- Blau, Y., y Michaeli, T. (2018). The Perception-Distortion Tradeoff. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 6228–6237. https://doi.org/10.1109/CVPR.2018.00652.